【大模型学习必备】Transformer架构原理详解,建议收藏学习

Transformer模型架构的原理和工作方式 Transformer 是一种基于注意力机制的模型架构,最早由 Vaswani 等人在 2017 年的论文《Attention Is All You Need》中提出。它的设计彻底改变了序列数据的处理方式,特别是在自然语言处理(NLP)领域。与传统的循环神经网络(RNN)和长短期记忆网络(LSTM)相比,Transformer 在捕捉长距离依赖和训练效率方面具有明显的优势。 阅读详情

花了一点时间来学习和研究经典的transformer架构及原理,这个是2017年谷歌的一个论文,开拓了AI的新时代,尽量通俗易懂的解释一下,做好笔记把它记录下来。

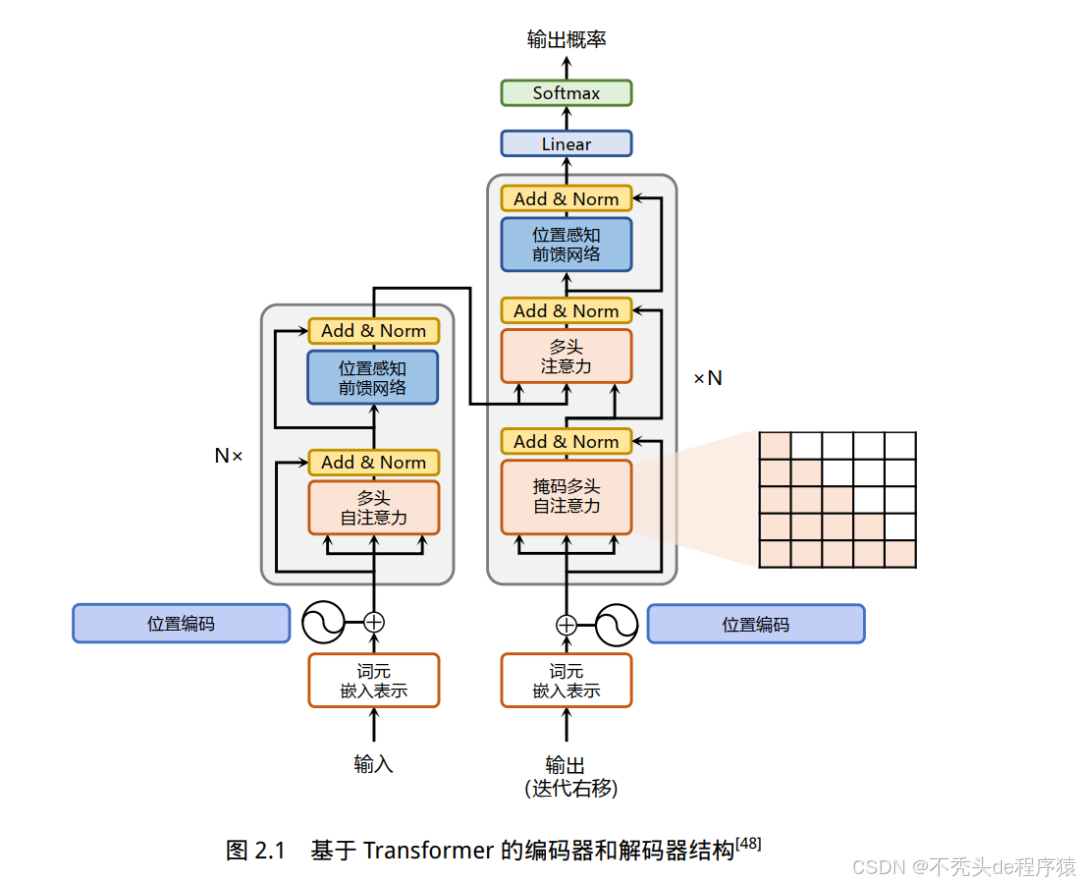
先看下整体的架构图:
在这里插入图片描述

有几个部分,举个例子来说,比如“请介绍一些《孙子兵法》这本”,这13个词,咱们先暂定26个token哈。主要用于后面举例说明。咱们分开来理解,先看左边部分。

1、tokenization原理,对应的是token化,在输入的语句中进行token化,一般而言,一个100token个对应50给汉字,100个token对应75给英文单词,是一个分词拆分法,大家有没有想过,为什么不是一个汉字或者一个英文单词对应一个token呢?如果一个字或者一个单词对应一个token,那么这个token词表会一直变大,因为有一些新的字出现,其次,像,河,海,英文happy,unhappy,happiness,可以复用token的,最后,分词拆分法也是可以增加一些语义的理解。像上面例子一看就知道一些意思。

2、词元嵌入表示,embedding模型,就是将token进行向量化,计算机的世界是识别数字的,万事万物皆可向量化。向量空间即是特征,我们可以从向量中提取特征,所谓的特征工程。向量化里有一个one-hot编码,一个token对应是一个512维的向量(transfomer是512维的向量),一个1和其他维度都是0,这种编码也是有问题的,就是在整个向量空间里第一是太稀疏了,第二没有距离,第三没有数量关系或逻辑关系。

3、位置编码positional Encoding,就是定义一个向量表示词的位置,有了这个向量是增加语义的理解,比如“狗咬了猫”,“猫咬了狗” 字是一样的,但是位置不一样,他们的含义也是不同的。这个向量也是512维。

4、这时候看图才进入编码器Encoding,编码器包含2个部分,一个是多头自注意力机制,另外一个是位置感知前馈神经网络

多头注意力机制,公式是Attention(Q,K,V)=softmax(Q*K(T)/开根号dk)*V 不会弄就中文解释下,这公式的意思是,请把注意力放到重要的信息上。咱们先了解什么是注意力机制?什么是自注意力机制?什么是多头注意力机制?

看如下图来理解注意力机制
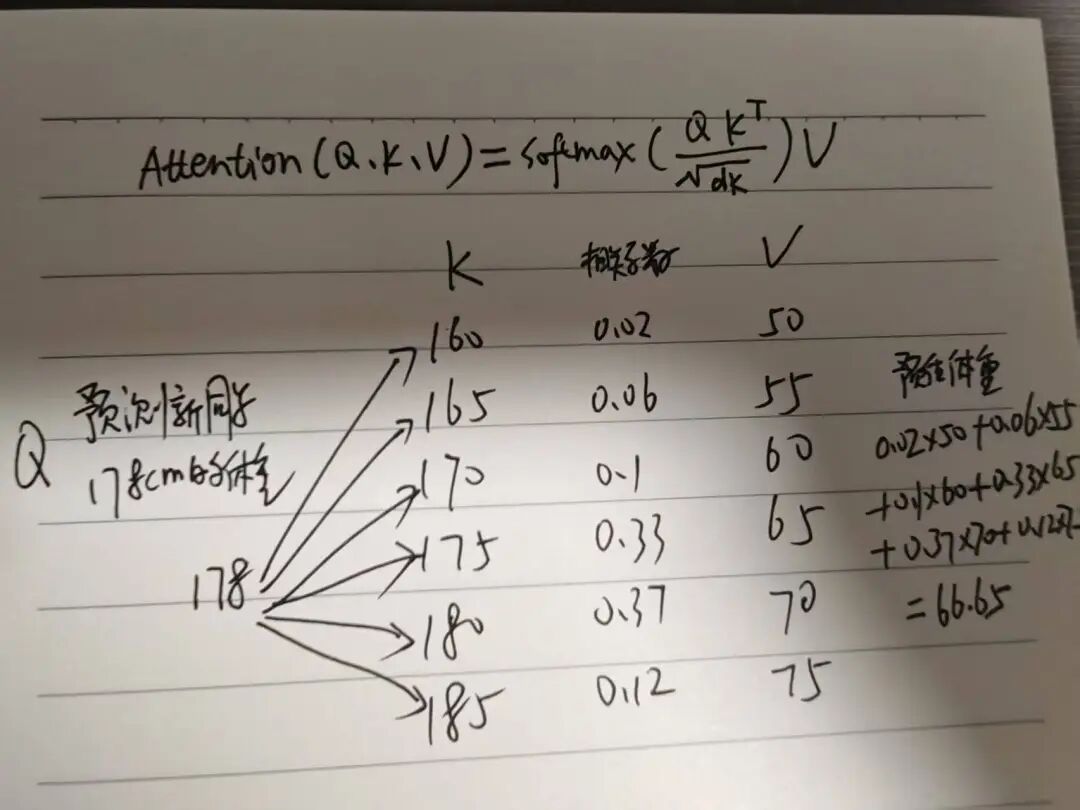
这个图是理解为一维的,也增加二维(身高178,腰围38),对应的K也要是二维的(身高,腰围),V值也加,比如预测(体重,腿长),还可以是多维的,大脑里细品哈,只要有数据,任何东西都可以预测。

自注意力机制,核心是做信息的聚合,就是自己跟自己去比较计算,想像一下,前面例子26个token,对应26个向量,对应是26个512维的向量空间,结合上面的图,把所有的数据替换成26个512维的向量值,然后按照图的计算公式进行计算,得到的值也是一个26个的512维向量。(V中智是每个向量的加权求和)

多头自注意力机制,引入多个专家去关注不同的注意点,然后再进行自注意力机制的计算,但是transformer里面引入了神经网络进行了向量的线性的变换。比如原始的26*512维向量,进行向量变换,生成3个不同的Wq,Wk,Wv向量,这个经过神经网络的线性变换后,从而突出某些需要突出的,弱化某些需要弱化的。
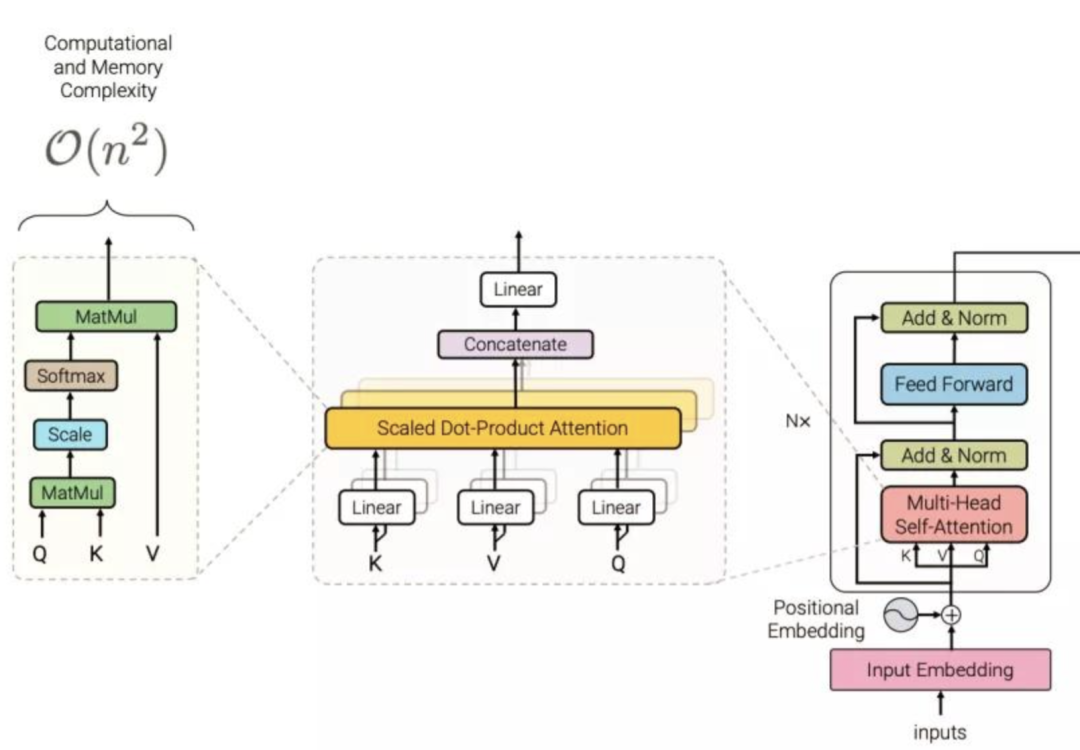
纯写文字,可能不太好理解,结合上面图来理解一下。上图分左/中/右

中间输入是26*512维的向量,经过linear线性变换后,看左边的图,Q和K和V变换成26*(512/8=64)维的向量了,通过Scale缩放点积和softmax。后面的concatenate将8个26*64的向量合并,最后输出是26*512维的向量。

然后再说下位置感知前馈神经网络,就是一个全连接的神经网络,输入的26*512维向量 经过线性变换,激活函数变成26*2024维的向量,再转换变成26*512的向量进行输出。

5、右边部分是解码器,从下往上看,前面的输出、token化、词元嵌入表示、位置编码这4部分跟编码器是一样的。不一样的是掩码多头自注意力机制、多头注意力机制
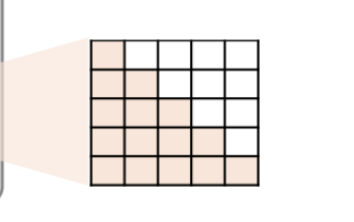
掩码多头注意力机制,原理跟自注意力机制一样,区别在于,可以理解为一个把答案遮住的,看上图,对角线的右边全为白色,对应向量里全部为0.

6、编码器与解码器的区别是编码器输出的是向量,解码器输出的是概率,编码器一般用来做分析,解码器一般用来做生成。

7、linear和softmxa概率函数,一个26*512维的向量经过linear后,形成跟最后一个向量的相关度系数,得到的相关系数后进行softmax进行计算到概率,按概率最高的词去预测下一个字。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

Transformer架构深度解析:从原理到实战的全面指南(附架构图与代码图解) 会用:能调用现成模型解决业务问题会改:能修改模型结构适配需求会优:能进行性能调优和部署会创:能研发新型Attention机制- [ ] 能徒手写出Attention公式- [ ] 能解释多头注意力的优势- [ ] 能实现位置编码的可视化- [ ] 能进行模型轻量化改造- [ ] 能处理超长文本输入掌握Transformer技术,就是握住了开启AI新时代的钥匙。现在就开始构建你的第一个Transformer模型吧!🚀。 阅读详情

相关推荐

OS实验xv6 6.S081 开坑

OS实验xv6 6.S081 开坑 终于把xv6 2019 6.S081做完了,网络部分没有写,因为有计网实验了。怎么说呢,xv6的坑有点多,能做完多亏了:和我同学ljj交流,参考RedemptionC老哥的博客(他写的非常详细,遗憾的是,他好像没有写mmap),再者就是参考这位老哥的做法(没有源码,写得不是特别详细,不过有借鉴作用,mmap就是借鉴了他的思想)……废话不多说了,直接开始。 实验指导 首推RedemptionC的博客 这位老哥的个人博客 xv6 6.S081官网(后面的实验都要参考官网

不定期更新系统使用、编程小技巧,哔哩哔哩账号:https://space.bilibili.com/399455629,欢迎关注 4493

神经网络算法 - 一文搞懂 Transformer(总体架构 & 三种注意力层)

本文将从三个方面,带您一文搞懂**输入嵌入:将输入的文本转换为向量,便于模型处理。位置编码:给输入向量添加位置信息,因为Transformer并行处理数据而不依赖顺序。多头注意力:让模型同时关注输入序列的不同部分,捕获复杂的依赖关系。残差连接与层归一化:通过添加跨层连接和标准化输出,帮助模型更好地训练,防止梯度问题。带掩码的多头注意力:在生成文本时,确保模型只依赖已知的信息,而不是未来的内容。前馈网络:对输入进行非线性变换,提取更高级别的特征。

xxue345678的博客 3万+

【学习笔记】《基于φ-OTDR的分布式扰动传感系统定位算法研究-北交-通信与信息系统-吴》重点笔记

一、绪论 1.1 引言 光纤传感器的优点:跟电子传感器相比较,光纤传感器有诸多独特的优势:对电磁干扰免疫;具有很好的绝缘性和耐腐蚀性;灵敏度高,可测量微弱信息;可实现大范围监测和分布式传感,仅需一根传感光纤,更为经济便捷;传感光纤体积小、重量轻、可形变,适用于一些特殊应用场所;还有无需供电、耐高温、便于组网等等优点 光纤传感器的感知信号的方法:当探测光入射到光纤中时会发生散射并产生各种散射光...

qq_36045093的博客 2万+

神经网络算法 —— 一文搞懂Transformer !!

本文将从Transformer的本质、Transformer的原理 和 Transformer架构改进三个方面,搞懂Transformer。一、Transformer的本质1. Transformer架构主要由输入部分(输入输出嵌入与位置编码)、多层编码器、多层解码器以及输出部分(输出线性层与Softmax)四大部分组成。Transformer架构(1)输入部分将源文本中的词汇数字表示转换为向量表示,捕捉词汇间的关系。为输入序列的每个位置生成位置向量,以便模型能够理解序列中的位置信息。

不要给自己设限,尝试更多可能(思所向 皆可往) 1万+

Dr_can Kalman Filter学习笔记(一)

本文是在b站Dr_can的卡尔曼滤波课程学习过程中的学习笔记

苏大侠的博客 1051

《Sigrity SystemSI 2023+LPDDR4仿真自学笔记》(一)创建工程(Part1)

为了加强SystemSI 2023软件的熟悉度,咱们完整的走一个仿真全流程。

weixin_45199544的博客 6334

【原理篇】小白入门Transformer!一文了解Transformer架构

BART、PEGASUS 模型用于生成新闻摘要。✅。

m0_60302377的博客 8690

CAPL编程的催化剂——CAPLdll的实现

CANoe作为一款功能强大的总线开发及测试工具,不仅仅是因为其丰富的库函数,最重要的是其兼容了多种编程语言,可以实现灵活的开发,极大的解决了纯CAPL编程所带来的限制,如通过动态链接库(DLL)来实现复杂函数的编写,使其能够在CAPL中可以调用,下面将对DLL的实现进行分析。capldll.cpp这个文件初看相当复杂,从整体上来说,这段代码主要包含了两部分:自定义函数实现和回调函数定义,今天的主要任务是实现自定义函数,这里的函数定义与普通函数定义差不多,只是利用了CAPL的格式。在VS2017工程中打开。

车载控制器AutoSAR软件开发工程师 4648

掌握Transformer架构:大模型开发必备技能(建议收藏学习)

Transformer是Google于2017年提出的神经网络架构,现已成为大模型的基础。它摒弃传统循环结构,通过多头注意力机制、位置编码、前馈网络、残差连接和层归一化等核心组件,有效建模序列的全局依赖关系,解决长程依赖问题。该架构包含嵌入层、注意力层、前馈层等模块,采用正弦余弦函数位置编码和残差连接+层归一化技术,提升模型稳定性和训练效率。Transformer凭借其优异性能,已成为几乎所有大型语言模型的基础架构。

优快云_430422的博客 2367

Unity ECS 之 Entitas 的简单介绍,插件下载、导入,和简单使用(一篇文入门搞懂ECS是什么)

Unity ECS 之 Entitas 的简单介绍,插件下载、导入,和简单使用(一篇文入门搞懂ECS是什么) 目录 Unity ECS 之 Entitas 的简单介绍,插件下载、导入,和简单使用(一篇文入门搞懂ECS是什么) 一、简单介绍 二、一些专有项简介 Entity Context Group Collector Matcher System Feature 三、注意实现 四、ECS 的下载 Github 上下载 Unity Asset Store 中下载 U...

仙魁XAN 7780

DeepSeek掘金——用DeepSeek模型构建AI 代理

在本综合指南中,我们将探讨如何利用 DeepSeek 的功能构建能够以有意义的方式理解、推理和交互的复杂 AI 代理。人工智能领域正在迅速发展,DeepSeek 的模型代表了智能 AI 代理开发的重大进步。在本综合指南中,我们将探讨如何利用 DeepSeek 的功能构建能够以有意义的方式理解、推理和交互的复杂 AI 代理。

3859

【强烈收藏】一文读懂Transformer架构原理,AI时代必备知识

本文深入浅出地解析了Transformer架构的核心原理,涵盖从输入预处理到模型输出的完整流程。重点讲解了token分词、词嵌入、位置编码等关键技术,详细剖析了编码器的多头自注意力机制和位置感知前馈网络,以及解码器特有的掩码机制。通过生动的示例和图示,阐明Transformer如何处理序列数据、捕捉语义关系和生成预测结果,帮助读者理解这一革命性AI架构的工作机制。文章还提供了大模型学习资源,适合AI从业者和爱好者系统掌握Transformer原理。

2301_76168381的博客 1486

200Gb/s以上速率的通道信号完整性设计和优化经验(二)

为满足200Gb/s信号完整性需求,需综合优化PCB、连接器、封装及SERDES架构。关键措施包括:采用低粗糙度铜箔与低损耗材料降低传输线损耗(200G目标0.55–0.6dB/cm);通过背钻工艺控制残桩长度至4±2mil;缩减连接器焊盘残桩至600μm以内以消除谐振;封装层面推进跳层走线、低Dk/Df材料与可控SMT工艺;采用PAM4调制与基于ADC/DSP的混合信号架构实现高效均衡。先进CMOS工艺(如纳米片器件)支撑复杂数字处理,协同设计是突破速率瓶颈的核心。

小孟同学的博客 148

【收藏必备】Transformer架构深度解析:一文掌握大模型核心原理

Transformer架构通过自注意力机制(QKV)和多头注意力实现并行化长距离依赖捕捉,解决了传统RNN/CNN的顺序处理瓶颈。其核心组件包括:1)自注意力模块计算词间关联度;2)多头机制从多维度分析语义;3)残差连接保留原始信息;4)层归一化稳定训练。相比传统模型,Transformer具有三大优势:任意词距直接关联、全序列并行计算、跨领域通用性强。该架构通过简单组件的高效组合,成为大模型时代的核心基础。

libaiup的博客 1022

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Transformer架构深度解析:大模型开发必备知识点(收藏)

本文系统介绍了Transformer神经网络架构的核心模块及其PyTorch实现。作为现代大模型的基础,Transformer通过多头注意力机制建立词间全局依赖,摆脱了传统循环结构的限制。文章详细解析了输入嵌入层(含位置编码)、自注意力层、前馈网络层等关键组件,以及残差连接和层归一化两项提升训练稳定性的技术。每个模块都配有数学公式说明和PyTorch实现代码,其中位置编码采用正弦余弦函数实现词序感知,自注意力机制通过查询-键-值三元组建模上下文关系。全文通过模块化拆解和代码示例,为理解Transformer

优快云_224022的博客 2110

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【必学收藏】Transformer详解:大模型的核心架构

Transformer是什么?一种神经网络架构(设计图纸)基于自注意力机制可以并行处理,速度快Transformer和大模型的关系Transformer = 架构设计大模型 = 用这个架构训练出来的成品GPT、BERT都是基于Transformer神经网络基础模仿人脑神经元由输入层、隐藏层、输出层组成通过权重和偏置进行计算激活函数的作用引入非线性让网络能学习复杂模式不同场景选择不同的激活函数架构:Transformer隐藏层激活函数:GELU。

xxue345678的博客 1430

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

学习大模型必备,你一定要搞清楚Transformer架构原理

开头先给大家上一个Transformer架构图,非常经典的图,所有学习大模型的同学都是从它开始的。Transformer的经典架构图看起来复杂,其实核心就两个部分:左边是编码器(处理输入),右边是解码器(生成输出)。就像两个人合作写作文——左边的人负责理解题目要求,右边的人根据左边的理解来写文章。

2401_84495872的博客 873

大模型底层原理全解析:从Transformer到训练流程,程序员必备收藏

本文系统解析了大语言模型(LLM)的基础原理,基于Transformer架构,通过词嵌入、自注意力机制和前馈神经网络处理文本输入。大模型采用"预训练+微调"范式,包括自监督预训练、指令微调和人类反馈强化学习三阶段。模型参数规模庞大,实际运行需考虑并行计算和硬件适配。多模态扩展和AI体应用是当前发展方向。理解这些原理有助于开发者更好地应用和优化大模型技术。

2401_85373691的博客 1522

【收藏必备】一文读懂Transformer架构:大模型核心原理与垂直应用策略

本文以通俗易懂方式解析Transformer架构在大模型中的应用,揭示其工作流程与三大瓶颈:计算量平方增长、专业知识稀释和AI幻觉。文章指出,这些局限恰恰为垂直领域应用提供了机会。通过差异化规则设计、强化专业模块和合理切分上下文等策略,可在特定行业打造不可替代的AI应用。将通用模型作为基础,结合垂直领域定制化能力,是AI时代获取持久竞争优势的关键路径。

2401_84815887的博客 1218

大模型必备知识:Transformer三大架构深度解析与实战应用(建议收藏)

文章详细解析了Transformer架构的三大类型:仅编码器模型(如BERT)擅长双向上下文理解,适用于分类和问答;仅解码器模型(如GPT)专注自回归文本生成,适合创意写作和对话;编码器-解码器模型(如T5)处理序列到序列转换,用于机器翻译等任务。每种架构的核心机制、工作流程和应用场景均被清晰阐述,帮助读者理解现代AI语言模型的基础架构及其区别。

2401_84815887的博客 1119

收藏必备:从零开始掌握Transformer大模型核心架构,小白程序员必学指南

收藏必备:从零开始掌握Transformer大模型核心架构,小白程序员必学指南

大模型研究中心 2758

收藏必备:Transformer架构详解:从零开始理解大模型的核心技术

Transformer是2017年提出的革命性深度学习架构,其核心特点是并行处理和注意力机制。注意力机制通过查询、键和值组件计算注意力分数,自注意力机制允许模型权衡同一序列中不同位置的重要性。结合多头注意力机制和位置编码,Transformer能有效捕获长距离依赖关系,高效处理序列数据,已成为NLP和其他任务的基础架构。想象一下,你正在努力理解一个用你不熟悉的语言写成的故事。你无法一次性读完整个故事,所以你只能逐句阅读。但有些句子会回溯到之前的句子,你需要记住这些细节才能理解整个故事。

优快云_430422的博客 1104

【收藏必备】大模型原理解析:从Transformer架构到训练流程,一文彻底搞懂LLM核心技术

文章系统解析了大语言模型(LLM)的核心原理,重点介绍了基于Transformer架构的工作机制,包括词嵌入、自注意力机制、前馈神经网络等关键组件。详细阐述了GPT系列模型的"预训练+微调"训练流程,以及模型参数计算、部署推理等工程实现。同时补充了位置编码、激活函数等技术细节,帮助读者全面理解大模型从输入到输出的完整处理流程。当前几乎所有主流的大语言模型(LLM,Large Language Model)都基于 2017 年 Google 团队发表的一篇论文《注意力就是一切》(Attention Is Al

大模型教程的博客 1694

大模型必备基础知识:Transformer、BERT和GPT大模型,建议收藏!

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85325726的博客 1225

程序员必看!Transformer核心原理详解(建议收藏),大模型开发必备知识

本文以通俗易懂的方式解析了Transformer的核心原理,包括其与大模型的关系、自注意力机制、多头注意力机制、位置编码、Encoder和Decoder组成等内容。通过生活化比喻和详细图解,帮助读者理解这一支撑现代AI语言模型的基石,是学习大模型的必备基础知识。

datian1234的博客 717

从零到全栈AI工程师:大模型应用开发必备技能与学习路径(建议收藏)

本文系统介绍了AI大模型应用开发者所需的技能体系,包括Python编程、机器学习基础、大模型专项技术(如Prompt工程、RAG、微调等)以及数据处理能力,并强调问题分解、持续学习等软技能的重要性。文章提供了从入门到进阶的学习路径和常用工具栈,帮助开发者成为"全栈AI工程师",抓住AI大模型时代的发展机遇。 ---

2401_84815887的博客 1748
上一篇: 【收藏必备】从零开始学RAG:嵌入模型如何提升大模型应用效果
下一篇: 【必藏】HiChunk:RAG系统的分层分块框架与评估基准,提升检索生成效果的利器
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值





