


- 论文标题: HiChunk: Evaluating and Enhancing Retrieval-Augmented Generation with Hierarchical Chunking
- 论文链接: https://arxiv.org/pdf/2509.11552v2
- 代码链接: https://github.com/TencentCloudADP/HiChunk.git
- 发表会议: arxiv
一、研究背景
RAG的作用是通过整合外部知识源提升大语言模型的响应质量,有效减少幻觉、适配实时信息与专业领域知识,而文档分块作为RAG的核心环节,直接决定检索知识的质量与最终生成效果。当前RAG领域存在两大关键问题:
- 现有RAG评估基准无法有效评估分块质量:现有RAG基准(如Qasper、OHRBench、GutenQA)一般为了检验系统对于证据稀疏性问题的处理情况,无法评估分块对证据密集型任务(如枚举、总结)的适配能力,而真实场景中,用户的查询常常需要完整语义片段作为回答依据,现有基准的局限性无法指导分块方法的迭代优化。
- 现有分块方法与检索策略存在明显缺陷:
- 分块结构单一:传统分块方法(如固定长度分块、语义分块、LumberChunker)仅考虑文档的线性结构,无法处理多语义粒度的需求。例如,用户查询可能涉及“章节级”的宏观信息与“段落级”的细节信息,线性分块难以自适应匹配。
- 检索粒度固定:现有检索策略多采用固定粒度的分块(如统一使用固定大小词块),无法根据查询动态调整,若分块过粗可能丢失细节,过细则导致信息碎片化,影响检索内容的完整性。
二、核心方法
为解决上述问题,论文提出两大核心创新:HiCBench评估基准与HiChunk分层分块框架,形成“评估-优化”的完整闭环。
2.1 HiCBench——面向分层分块的RAG评估基准
HiCBench是基于OHRBench文档库构建的,通过人工标注与LLM辅助生成,解决现有基准“证据稀疏”的痛点,可全面评估分块对RAG全流程(分块器、检索器、生成器)的影响。其核心设计如下:
- 文档分层标注:筛选大于等于4000词且小于等于50页的文档,人工标注多级别分块点(如“章节级”L1、“子章节级”L2、“段落级”L3),明确不同语义粒度的边界,用于评估分块器的准确性。对标注后的文档生成各层级摘要,帮助LLM理解文档结构,为后续QA生成提供更为全面的视角。
- 证据密集型QA生成:
- 定义三类任务以覆盖不同分块需求:
- T₀(证据稀疏QA):证据仅涉及1-2个句子,对应现有基准的任务类型,用于对比验证。
- T₁(单块证据密集QA):证据占单个完整语义块的大部分(块长度512-4096词),需分块器准确保留语义连续性。
- T₂(多块证据密集QA):证据分布在多个语义块(块长度256-2048词),需分块器与检索器协同处理跨块关联。
- QA生成流程:
-
基于文档分层摘要与随机选择的语义块,用DeepSeek-R1-0528生成候选QA对。
-
证据筛选:使用大语言模从与问答对相关的文本中提取证据,该过程会重复5次,在5次提取中,仅保留出现次数大于等于4次的句子作为最终证据,确保被保留的证据句在多次提取中具有较高的稳定性和可靠性;计算筛选出的证据在整个文本中的占比(证据占比是指证据句的字数或句子数量在上下文总字数或总句子数量中的比例),过滤证据占比<10%的样本,保证证据密度;
-
事实一致性验证:用Fact-Cov指标(重复5次取平均)过滤样本,仅保留平均得分>80% 的QA对,确保可回答性。
- 基准构成:包含130份文档、1200个QA对(T₁:659个,T₂:541个),每份文档平均298句、8.5k词,证据平均长度达560词/20.5句,远超现有基准(如OHRBench证据仅39.1词/1.7句),可有效区分分块方法优劣。
2.2 HiChunk——分层分块框架与Auto-Merge检索算法
基于合成的高难度问答数据,构建“推理-工具调用-环境交互”的多轮训练框架,让模型学会结合内部推理与外部搜索工具。
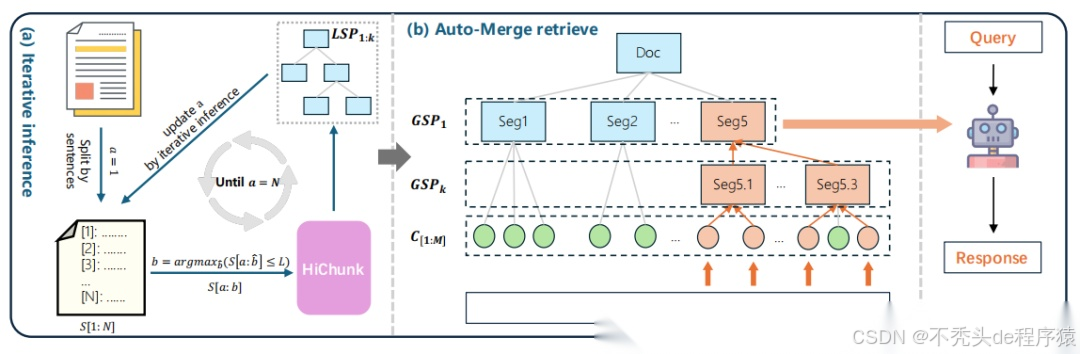
- 分层分块模型:
- 训练数据:采用Gov-report、Qasper、Wiki-727等含明确结构的公开数据集,通过随机打乱章节、删除内容等方式扩充训练集,让模型学习“语义边界识别”与“层级判断”。
- 训练与推理设计:
-
核心目标:通过微调LLM,让模型理解文档的层级关系(如“章节-子章节-段落”),输出多级别分块点,解决传统分块“单粒度”缺陷。
-
任务转化:将“分块点识别”与“层级判定”转化为文本生成任务——输入句子化的文档,输出分块点的“起始行号-层级-是否为标题”;
-
长文档迭代推理:针对超模型输入长度的文档,采用“局部推理-全局合并”策略。
- Auto-Merge检索算法:
- 核心问题:HiChunk生成的分层分块语义粒度差异大,固定粒度检索易导致“信息冗余”或 “细节丢失”,需动态调整检索粒度。
- 算法逻辑:根据查询相关性与token预算,自适应合并分块,既保留关键细节(低层级分块),又避免碎片化(合并为高层级分块)。
三、实验结果
3.1 实验设置
- 数据集:
- 分块准确性评估:Qasper、Gov-report、HiCBench;
- RAG全流程评估:LongBench、Qasper、GutenQA、OHRBench、HiCBench;
- 对比方法:
- 规则分块:FC200(固定200词块);
- 语义分块:SC(基于BGE-large-en-v1.5计算相邻段落相似度)、LC(LumberChunker,用DeepSeek-R1-0528预测分块点);
- 分层分块:HC200(HiChunk+固定200词块)、HC200+AM(HC200+Auto-Merge);
3.2 核心结果
- 分块准确性:HiChunk(HC)显著优于传统方法。
- 域内数据集(Qasper、Gov-report):HC的L₁-F1分别达 0.6742、0.9505,L_all-F1达0.9441、0.9882,远超SC的L_all-F1最高0.1507与LC的L_all-F1最高0.6657。
- 域外数据集(HiCBench):HC的L₁-F1=0.4841、L_all-F1=0.5450,仍大幅优于SC的L_all-F1最高0.1507与LC的L_all-F1最高0.4858,证明其泛化能力;
- 关键差异:HC支持多级别分块(输出L₂分块点),而SC、LC仅能处理单级别分块,无法满足复杂文档的语义结构需求。
- RAG全流程:HC200+AM在证据密集任务中优势显著。
- 证据稀疏数据集(GutenQA、OHRBench):各分块方法性能接近。
- 证据密集数据集(Qasper、HiCBench):HC200+AM 表现最优。
- LongBench平均性能:HC200+AM在Llama3.1-8B、Qwen3-8B、Qwen3-32B下的平均得分分别为42.90、44.41、46.92,均为最优或次优,证明其跨任务泛化性。
四、优缺点及改进方向
4.1 优点
- 评估基准创新性:首次提出“证据密集型”RAG基准HiCBench,解决现有基准“证据稀疏” 无法评估分块质量的痛点,提供分块点标注、证据来源等细粒度信息,可全面衡量分块对RAG全流程的影响。
- 分块框架突破:HiChunk通过分层分块模型,首次将文档的多级别语义结构引入RAG,解决传统分块“单粒度”的缺陷;迭代推理策略,有效处理超长篇文档,适配真实场景中的长文本需求。
- 检索策略自适应:Auto-Merge算法根据查询相关性与token预算动态合并分块,平衡“语义完整性”与“检索效率”,避免固定粒度检索的冗余或碎片化问题。
4.2 缺点
- HiCBench难度上限不足:HiCBench的文档平均长度为8.5k词,虽远超Qasper(4.2k词),但仍短于GutenQA(146.5k词)等超长篇文档基准,对“超长篇文档分层分块”的评估能力有限。
- Auto-Merge阈值依赖经验:算法中的θ*阈值(父节点合并的长度条件)依赖len§/3的经验设定,缺乏自适应学习机制,可能在不同领域文档(如技术手册、文学作品)中表现不稳定。
- 多语言与多模态适配缺失:当前HiChunk与HiCBench仅支持英文,未考虑中文等其他语言的语义结构差异(如中文无段落首字母大写等格式提示);且未涉及PDF中的表格、图片等多模态内容,无法处理真实场景中多模态文档的分块需求。
- 训练数据依赖结构化文档:HiChunk的训练依赖Gov-report、Qasper等含明确章节结构的文档,对无固定格式的非结构化文本(如社交媒体长文、聊天记录)的分块能力较弱。
4.3 改进方向
- 扩展HiCBench至超长篇与多语言:增加超长篇文档与多语言样本,补充多模态内容标注,提升基准的覆盖范围;引入“分块效率”指标(如分块耗时、检索延迟),更全面评估分块方法的实用性。
- 优化Auto-Merge的自适应能力:用强化学习训练θ*阈值,基于“检索准确率-token 消耗”的权衡动态调整,替代经验设定;增加“语义相关性”权重,让合并决策在依赖长度的同时,还考虑子节点与查询的相关性,进一步提升检索质量。
- 增强非结构化文本分块能力:引入预训练语言模型的句嵌入、辅助语义边界识别,减少对结构化格式的依赖;增加“领域自适应训练”,针对技术、文学、医疗等不同领域优化分块策略,提升跨领域泛化性。
- 融合多模态分块:扩展HiChunk处理PDF中的表格、图片标题、公式等内容,将多模态元素的语义关联纳入分块判断(如表格应与相关描述段落分为同一块);结合OCR技术提取图片中的文本信息,确保多模态内容的分块完整性。
五、总结
本文针对RAG系统中“分块质量难评估”与“分块-检索适配性差”的核心问题,提出了一套完整的解决方案:
- 基准层面:构建HiCBench评估基准,通过人工标注分层分块点与生成证据密集型QA对,首次实现对分块方法的细粒度评估,解决现有基准“证据稀疏”的缺陷;
- 方法层面:提出HiChunk分层分块框架,通过微调LLM生成多级别分块点,结合Auto-Merge动态检索算法,平衡分块的语义完整性与检索适配性;
- 实验验证:在多个公开数据集与HiCBench上,HiChunk在分块准确性、RAG全流程性能(证据召回、生成质量)与时间成本上均优于传统方法,在证据密集任务中优势显著,证明其有效性与实用性。
、
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容

-
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)

07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 1874


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


