最详细的DeepSeek-R1:7B+RAGFlow本地知识库搭建教程,建议收藏起来慢慢学!!

RAG关键痛点及解决方案 当实际答案不在知识库中时,RAG系统往往给出一个貌似合理却错误的答案,而不是承认无法给出答案。这导致用户接收到误导信息,造成错误的引导。如何解决:1、优化数据“输入什么,输出什么”如果源数据质量差,比如充斥着冲突信息,那么无论你如何构建RAG流程,都不能从杂乱无章的数据中得到有价值的结果;2、改进提示方式在知识库缺乏信息,系统可能给出错误答案的情况下,改进提示方式可以起到显著帮助。 阅读详情

一、准备环境

个人笔记本电脑Windows11硬件配置参考:

  • CPU:AMD Ryzen 5 4600H with Radeon Graphics 3.00 GHz
  • 内核:6
  • 逻辑处理器:12
  • 内存:16GB
  • GPU:512MB
  • 操作系统:Windows 11

二、安装步骤

1.1 安装Ollama服务

ollama: 一个模型管理工具,可下载并运行不同的模型。

1.1.1 下载ollama

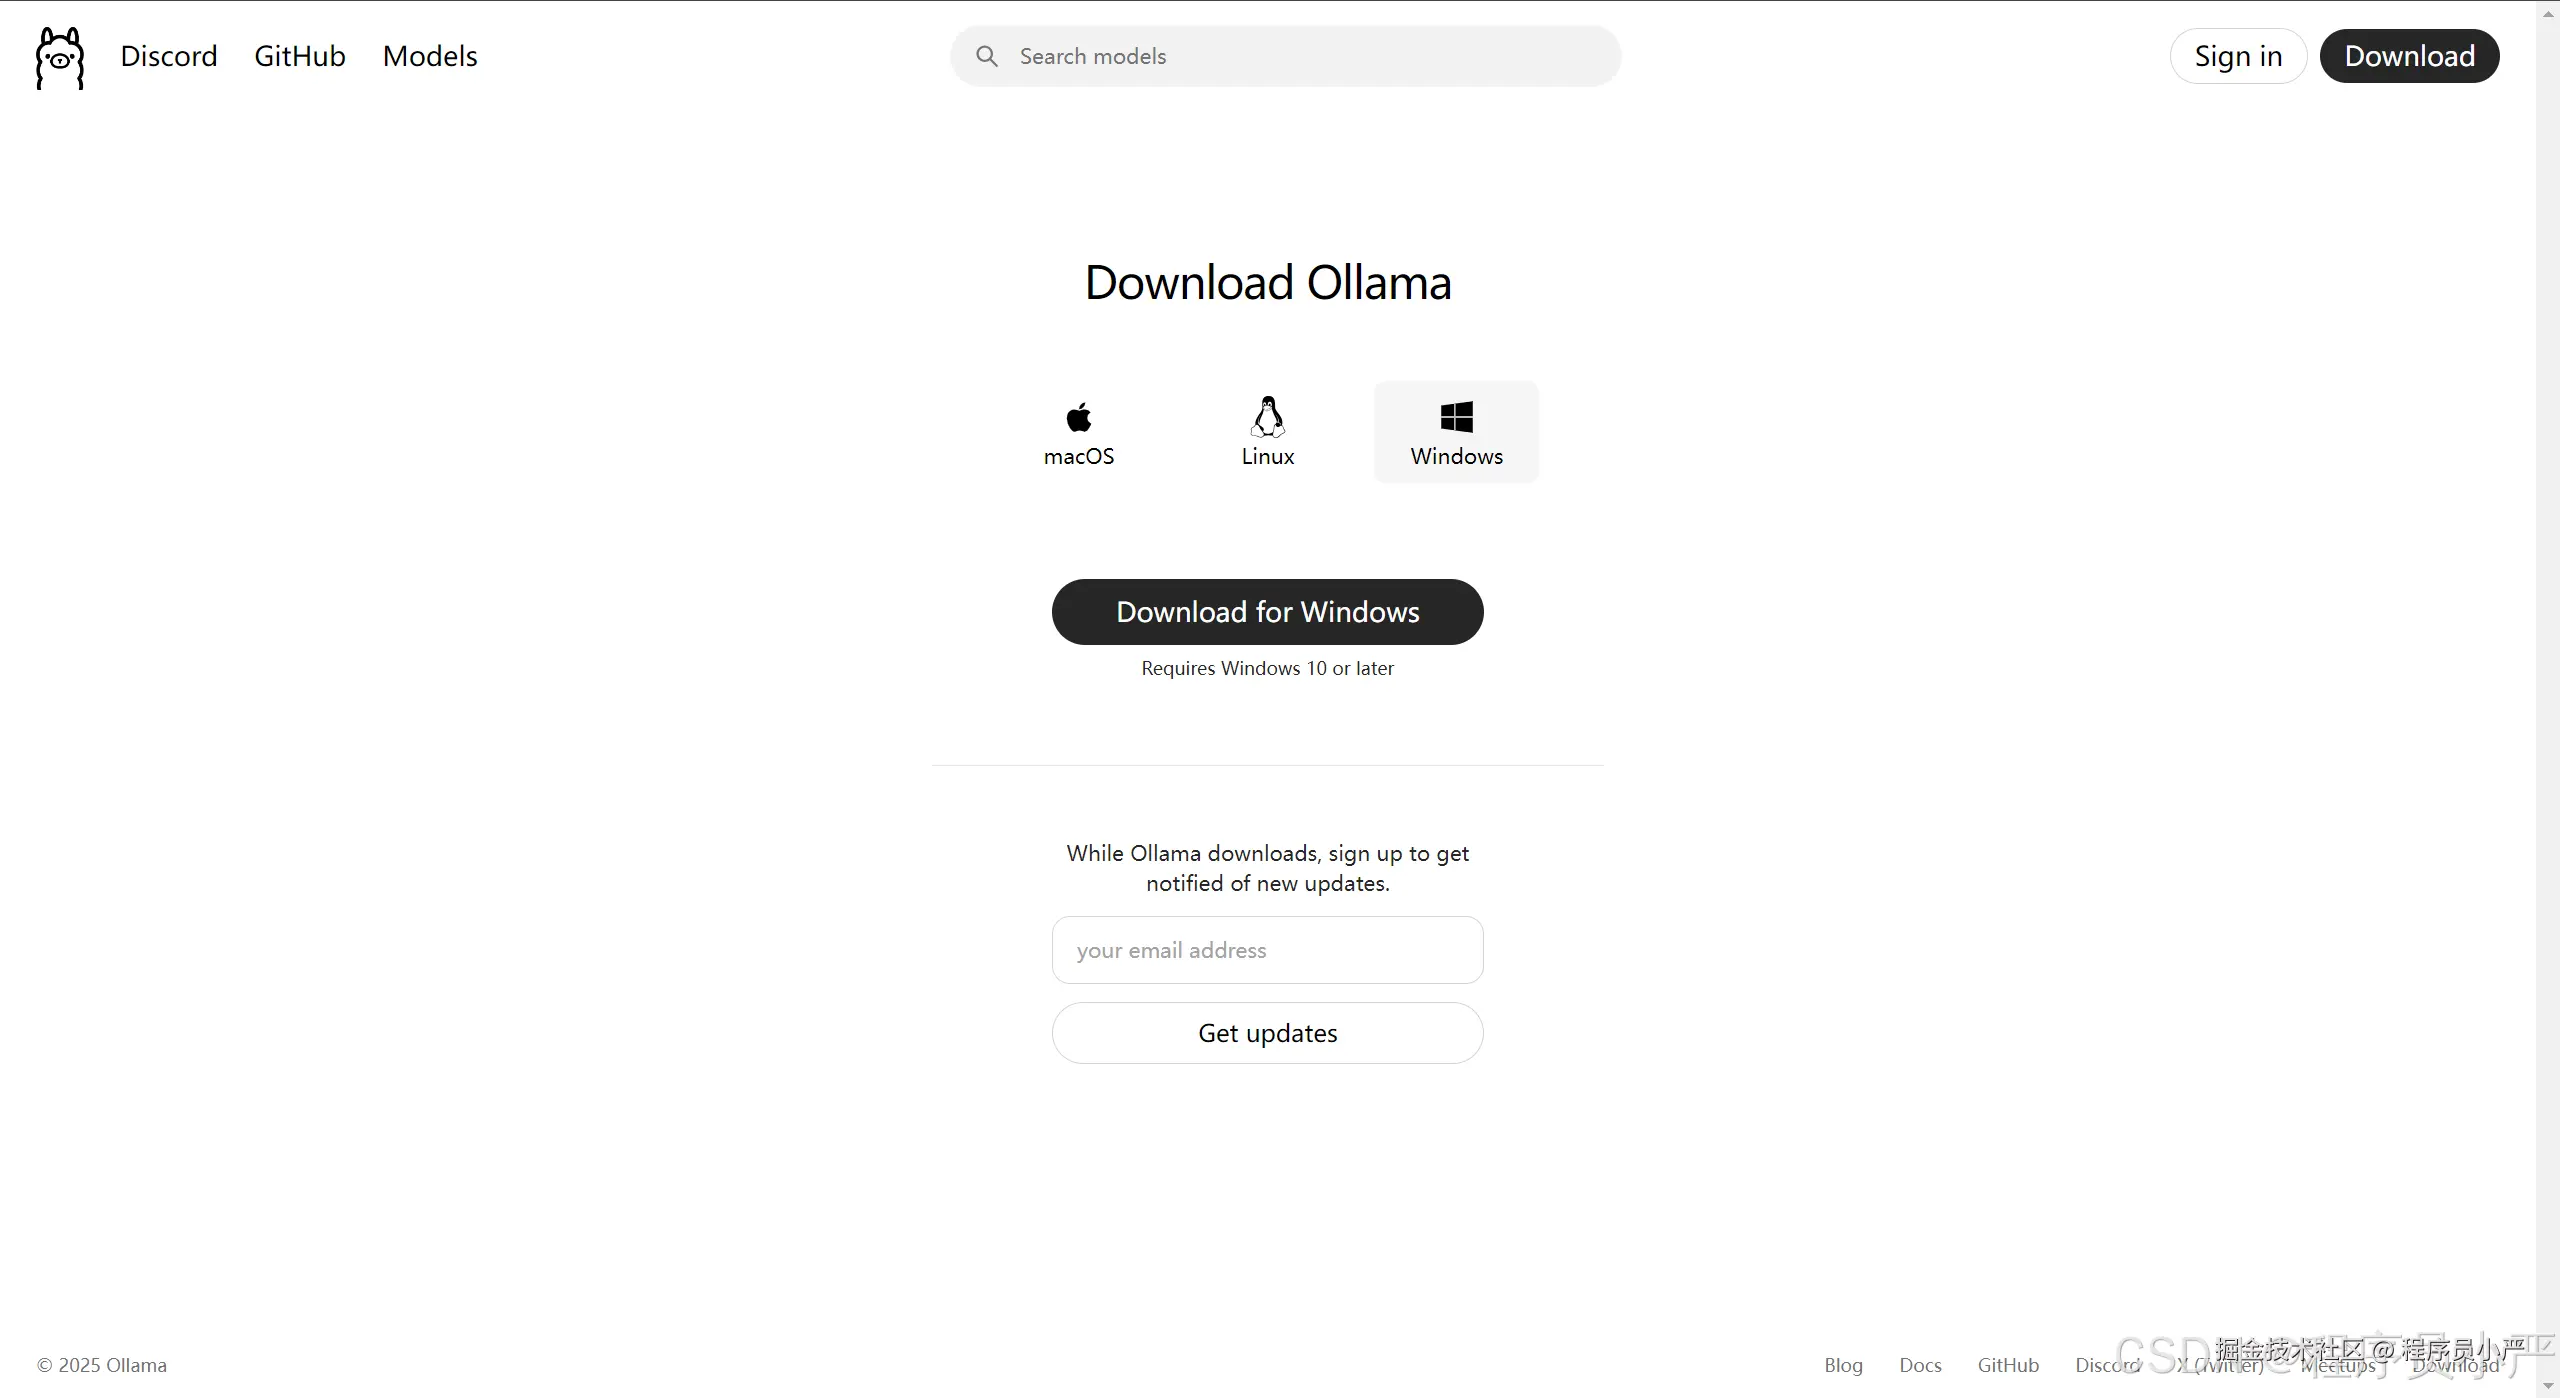
官网:ollama.com 下载windows版本
在这里插入图片描述

1.1.2 检验ollama

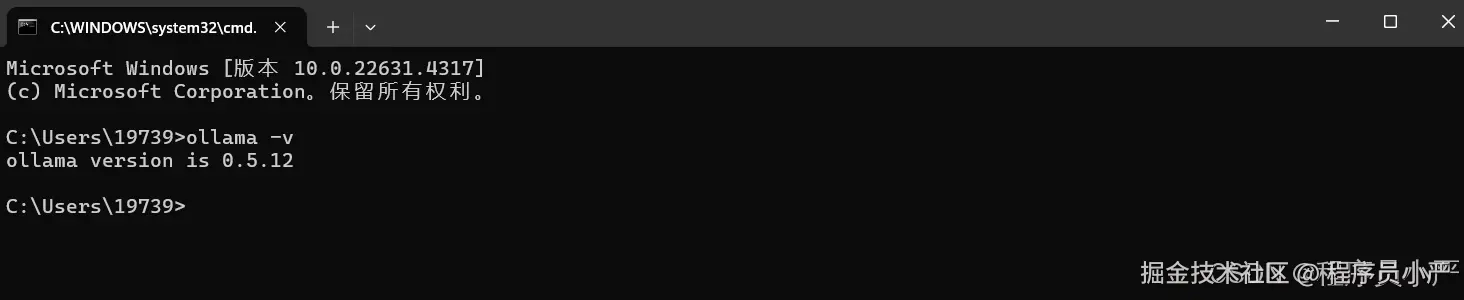
查看ollama是否安装成功:命令行输入 ollama -v 命令,出现如下版本号说明安装成功
在这里插入图片描述
注:常用ollama命令如下

# 运行模型
ollama run 模型名称

# 列出模型
ollama list

# 拉取模型
ollama pull 模型名称

# 删除模型
ollama rm 模型名称

# 显示模型信息
ollama show

# 启动ollama服务
ollama serve

1.1.3 修改ollama的环境变量

可根据自己的需求,修改ollama的环境变量,一般本地部署修改OLLAMA_HOST和OLLAMA_MODELS即可

  • OLLAMA_HOST:Ollama 监听的网络接口,设置OLLAMA_HOST = 0.0.0.0,可以让 Ollama 监听所有可用的网络接口,从而允许外部网络访问:0.0.0.0:11434,否则在RagFlow中,模型url无法使用本地IP进行注册。

  • OLLAMA_MODELS:指定模型镜像的存储路径。默认存储在C盘:C:\Users%username%.ollama\models。例如,设置OLLAMA_HOST = D:\ollama,可节约内存。

  • OLLAMA_KEEP_ALIVE:控制模型在内存中的存活时间。例如,设置OLLAMA_KEEP_ALIVE=24h可以让模型在内存中保持 24 小时,提高访问速度。

  • OLLAMA_PORT:允许更改 ollama 的默认服务端端口(11434)。例如,设置OLLAMA_PORT=8080。

  • OLLAMA_NUM_PARALLEL:决定了 Ollama 可以同时处理的用户请求数量。例如,设置OLLAMA_NUM_PARALLEL=4可以让 Ollama 同时处理两个并发请求。

  • OLLAMA_MAX_LOADED_MODELS:限制了 Ollama 可以同时加载的模型数量。例如,设置OLLAMA_MAX_LOADED_MODELS=4可以确保系统资源得到合理分配。

1.2 部署DeepSeek

1.2.1 获取下载命令

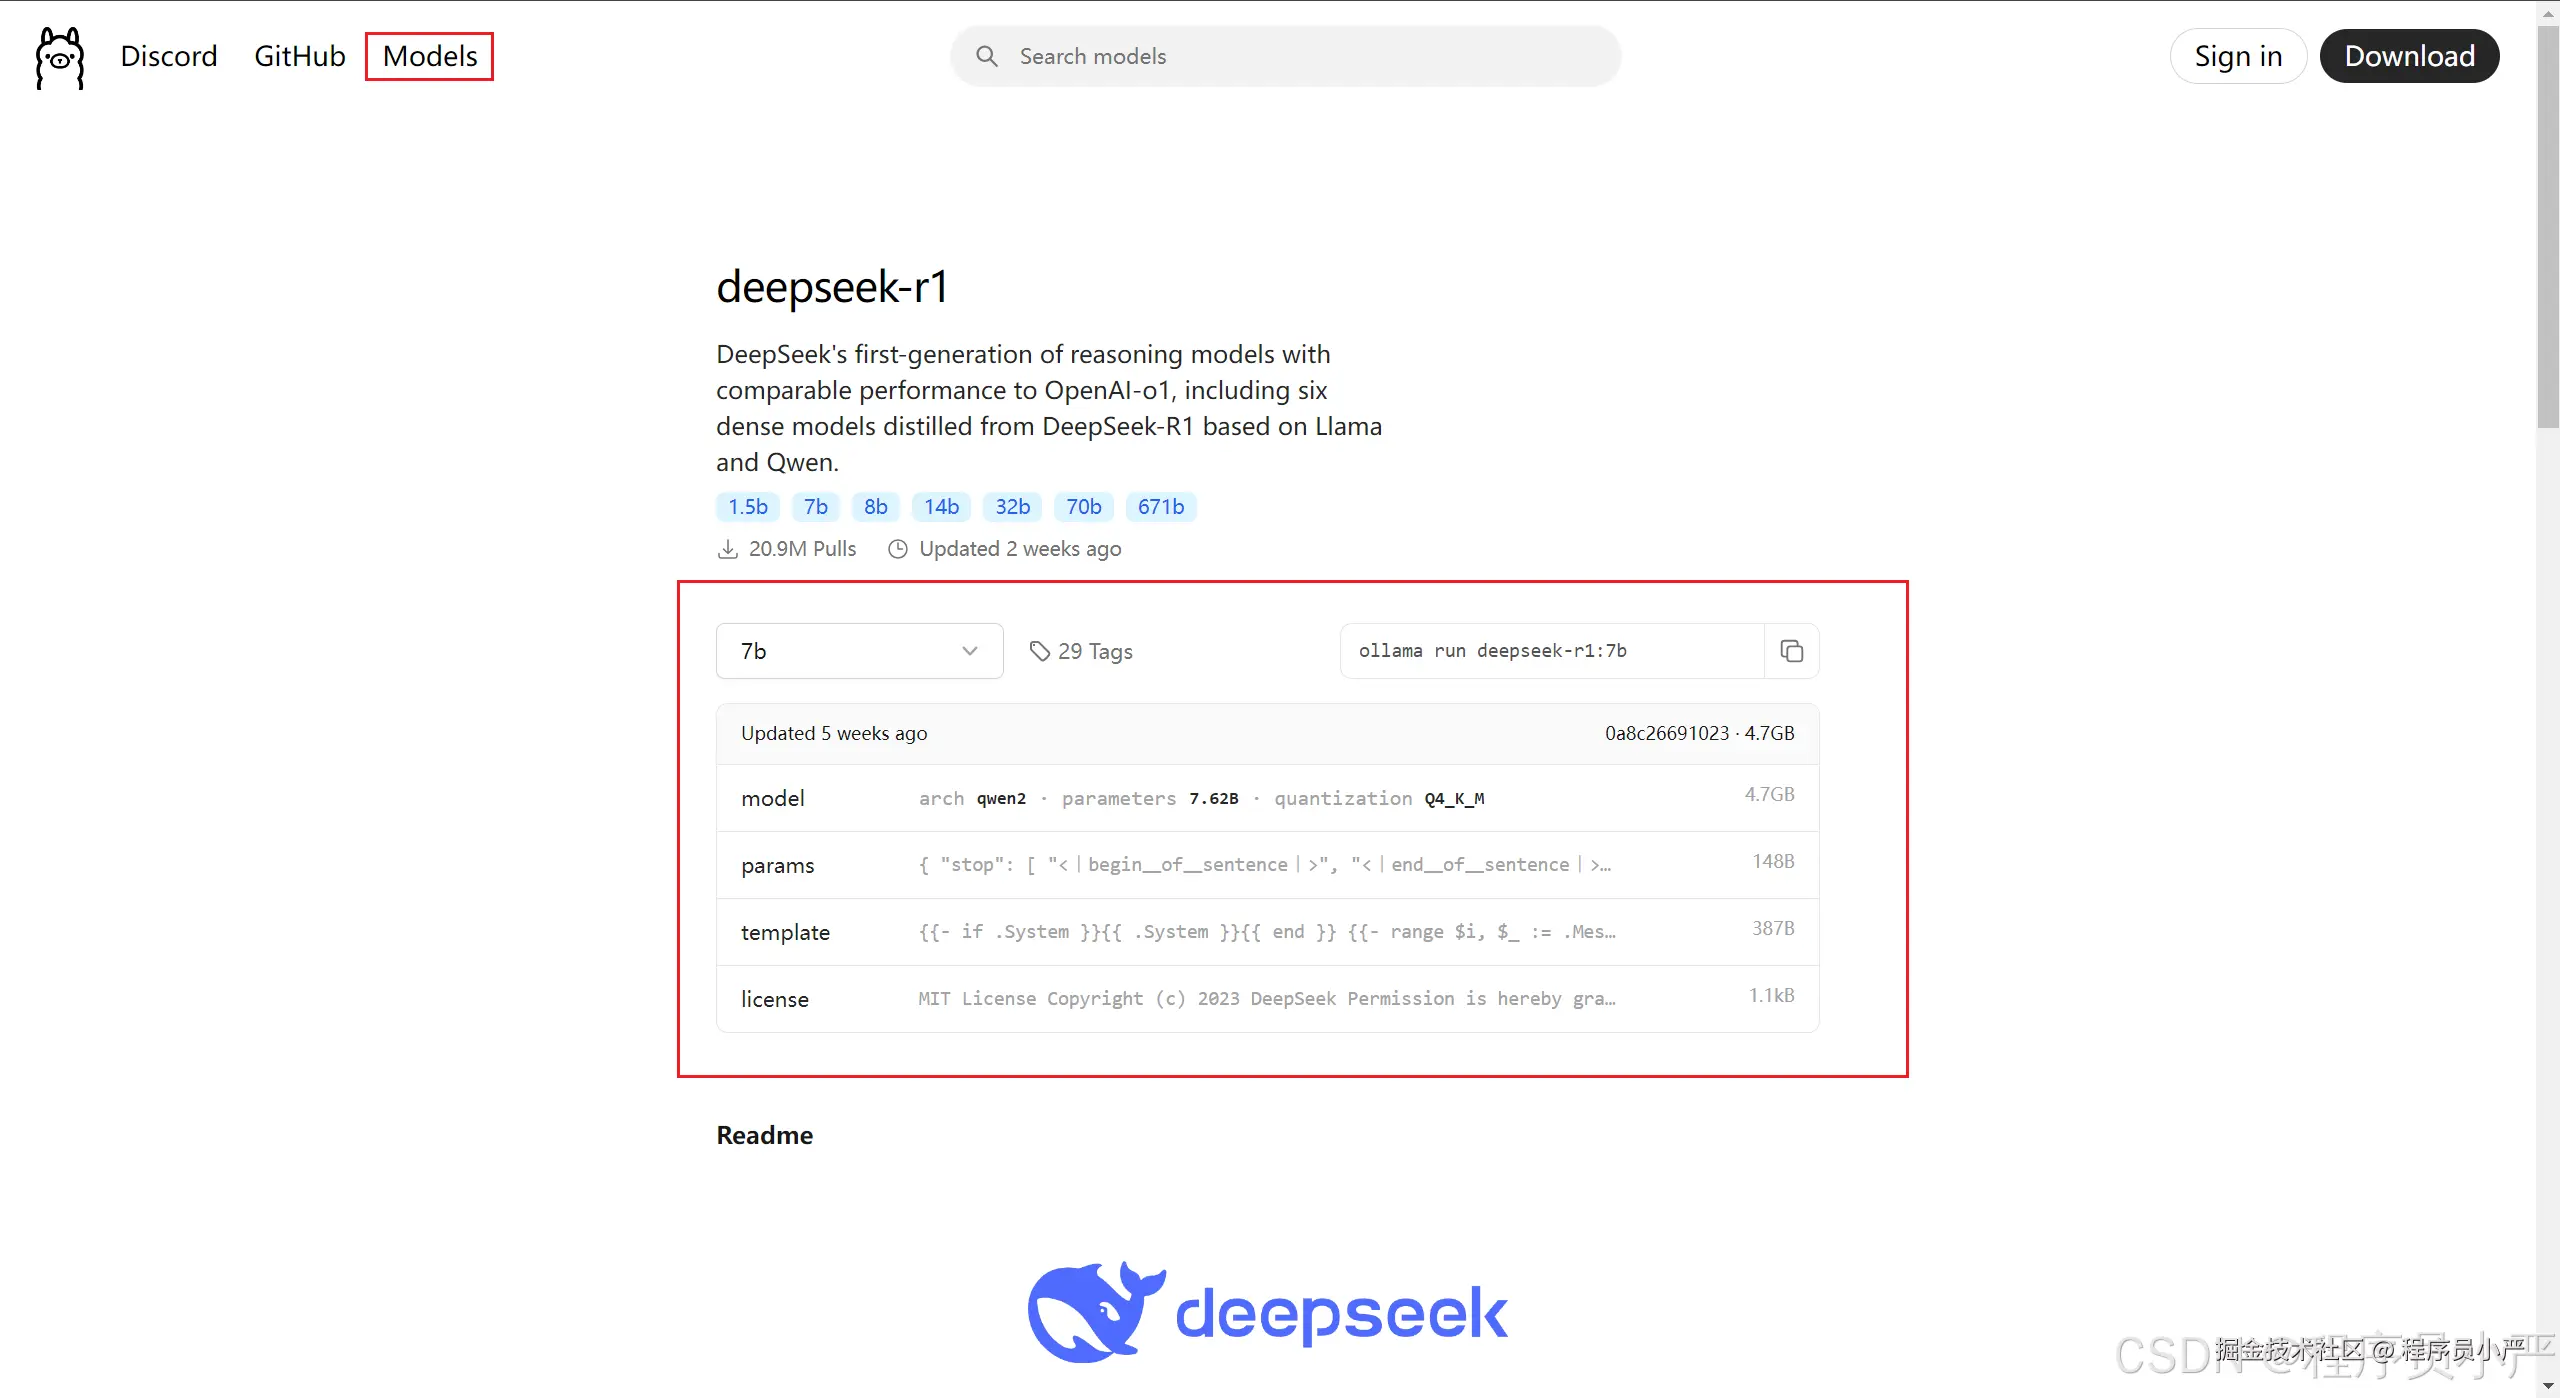
在ollama模型页面选择需要下载的DeepSeek参数规模,然后点击右侧的“复制”按钮,复制下载模型的命令。

ollama run deepseek-r1:7b
1.2.2 安装运行模型

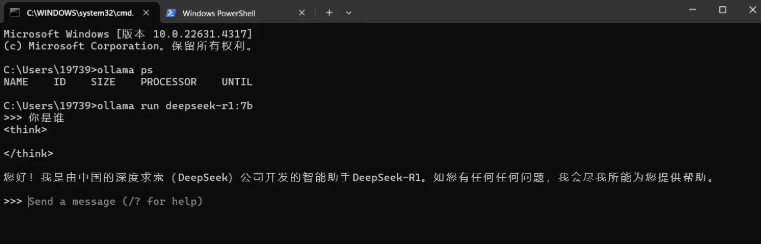
打开windows命令提示符工具(WIN + R快捷键,然后输入cmd,回车)。输入安装运行命令ollama run deepseek-r1:7b,ollama会自动下载模型,成功之后,如下页面所示:
在这里插入图片描述

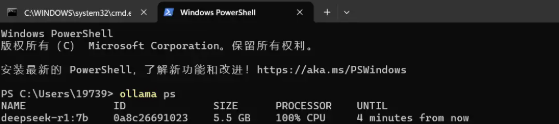
可查看当前加载的模型、所占的内存大小以及使用的处理器类型:

在这里插入图片描述

注意:运行过程中会出现以下问题

1)内存不够:需要释放本地内存,保证本地内存充足。

在这里插入图片描述

1.3 安装Docker桌面端

目的:RagFlow相关组件依赖于Docker运行。

1.3.1 下载Docker Desktop

下载Windows桌面端,官网下载地址:www.docker.com

1.3.2 配置镜像源

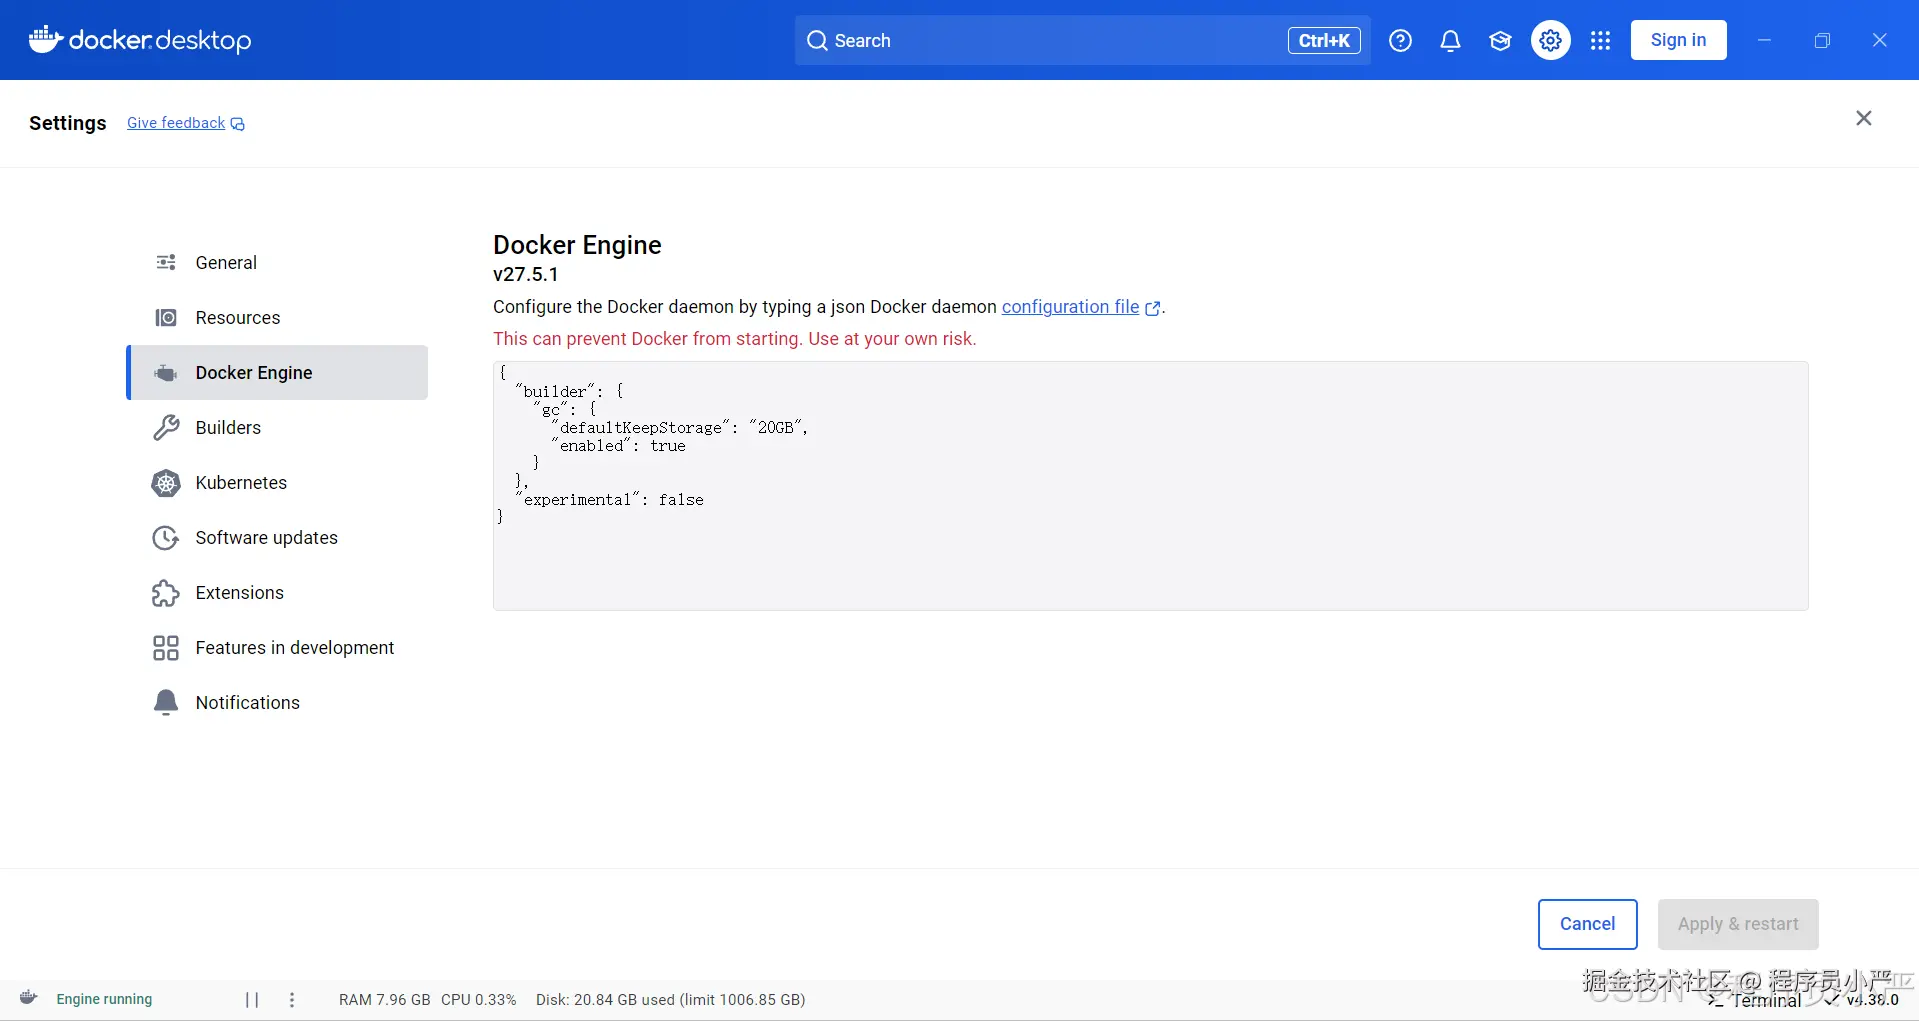
如下图所示:打开Docker Desktop->点击设置->Docker Engine
在这里插入图片描述

配置如下json镜像源,点击应用并重启 Docker。

"registry-mirrors": [
    "https://docker.1ms.run"
  ]

1.4 安装RagFlow

官方环境要求如下:

CPU >= 4 核 RAM >= 16 GB Disk >= 50 GB Docker >= 24.0.0 & Docker Compose >= v2.26.1

1.4.1 下载

下载或者克隆官方仓库至本地:

git clone https://github.com/infiniflow/ragflow.git

1.4.2 修改基础配置(按需)
  1. 镜像下载完整发行版 修改ragflow/docker/.env文件,设置RAGFLOW_IMAGE=infiniflow/ragflow:v0.16.0 来下载 RAGFlow 镜像的 v0.16.0 完整发行版 在这里插入图片描述

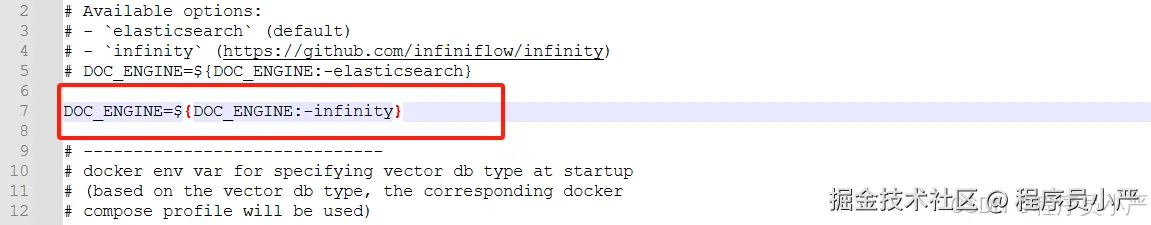
  2. 文档引擎修改 修改ragflow/docker/.env文件,设置DOC_ENGINE=infinity 切换文档引擎。 在这里插入图片描述
    注意:Infinity 目前官方并未正式支持在 Linux/arm64 架构下的机器上运行.

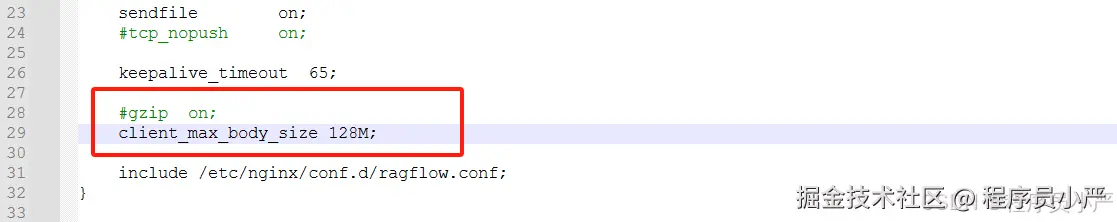
  3. 上传文件大小修改 修改/ragflow/docker/nginx/nginx.conf文件,设置client_max_body_size大小 在这里插入图片描述
1.4.3 运行
cd ragflow/docker
docker compose -f docker-compose.yml up -d

这个下载过程本地如果没有搭建梯子会很慢,镜像下载容易失败,ragflow镜像大概有10个G,最好搭个梯子。

镜像拉取失败,如下:
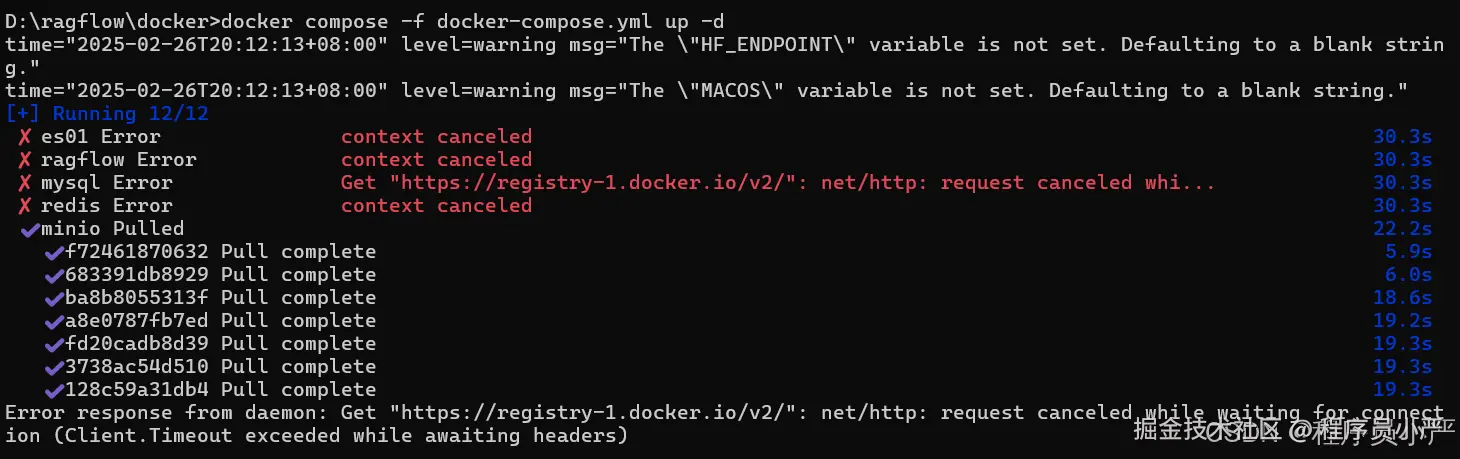
在这里插入图片描述
镜像拉取失败之后,先停止并删除容器,重新配置好docker镜像源,如果你搭建了梯子(科学上网),就不需要配置镜像源了:

docker compose -f docker-compose.yml down

镜像拉取成功之后,会自动启动ragflow,查看Docker Desktop控制台包含如下六个运行中的容器:
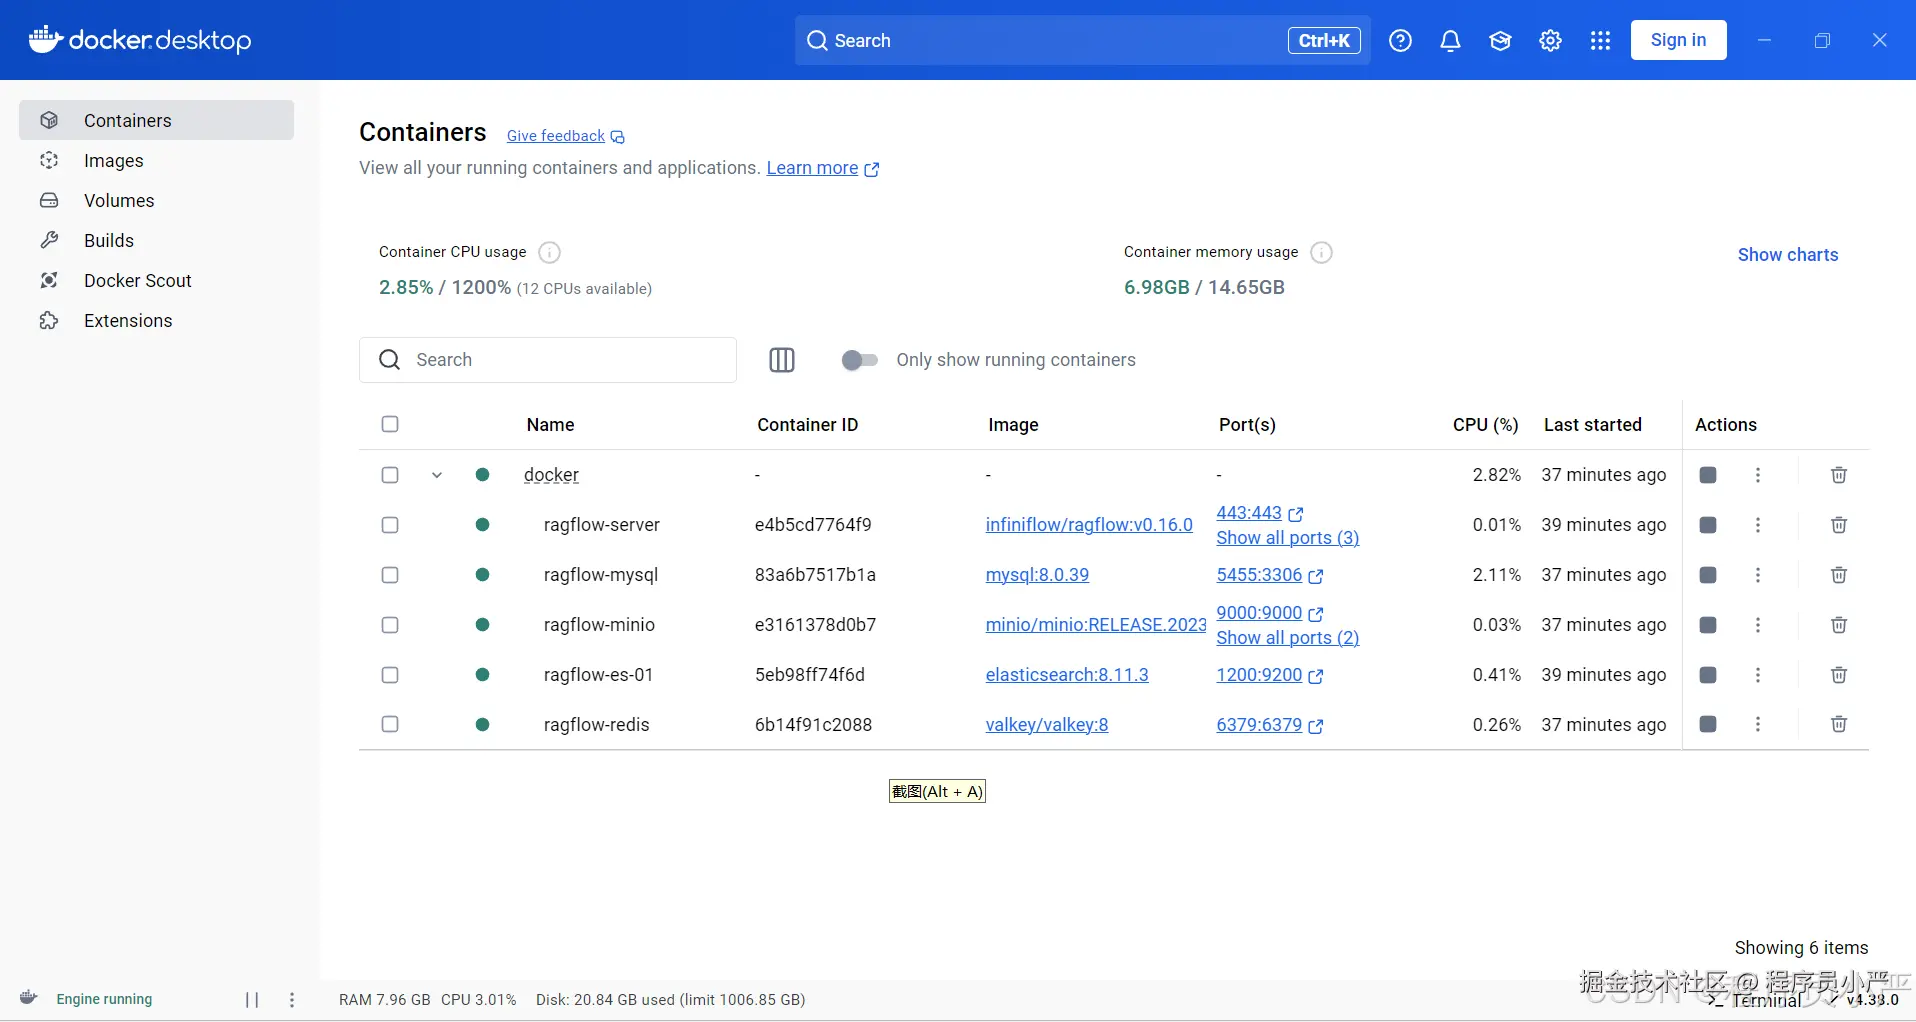
在这里插入图片描述

Minio:文件上传到此文件服务器。

Redis:文件解析度时候需要使用redis消息队列进行暂存,方便异步执行。

Elasticsearch:存储向量数据、任务信息。

MySql:存储用户信息、系统配置信息(比如配置知识库名称)、任务定义、执行状态、结果等。

1.5 知识库使用

1.5.1 登陆注册

在浏览器输入127.0.0.1,默认端口号是80,使用QQ邮箱注册登陆即可。
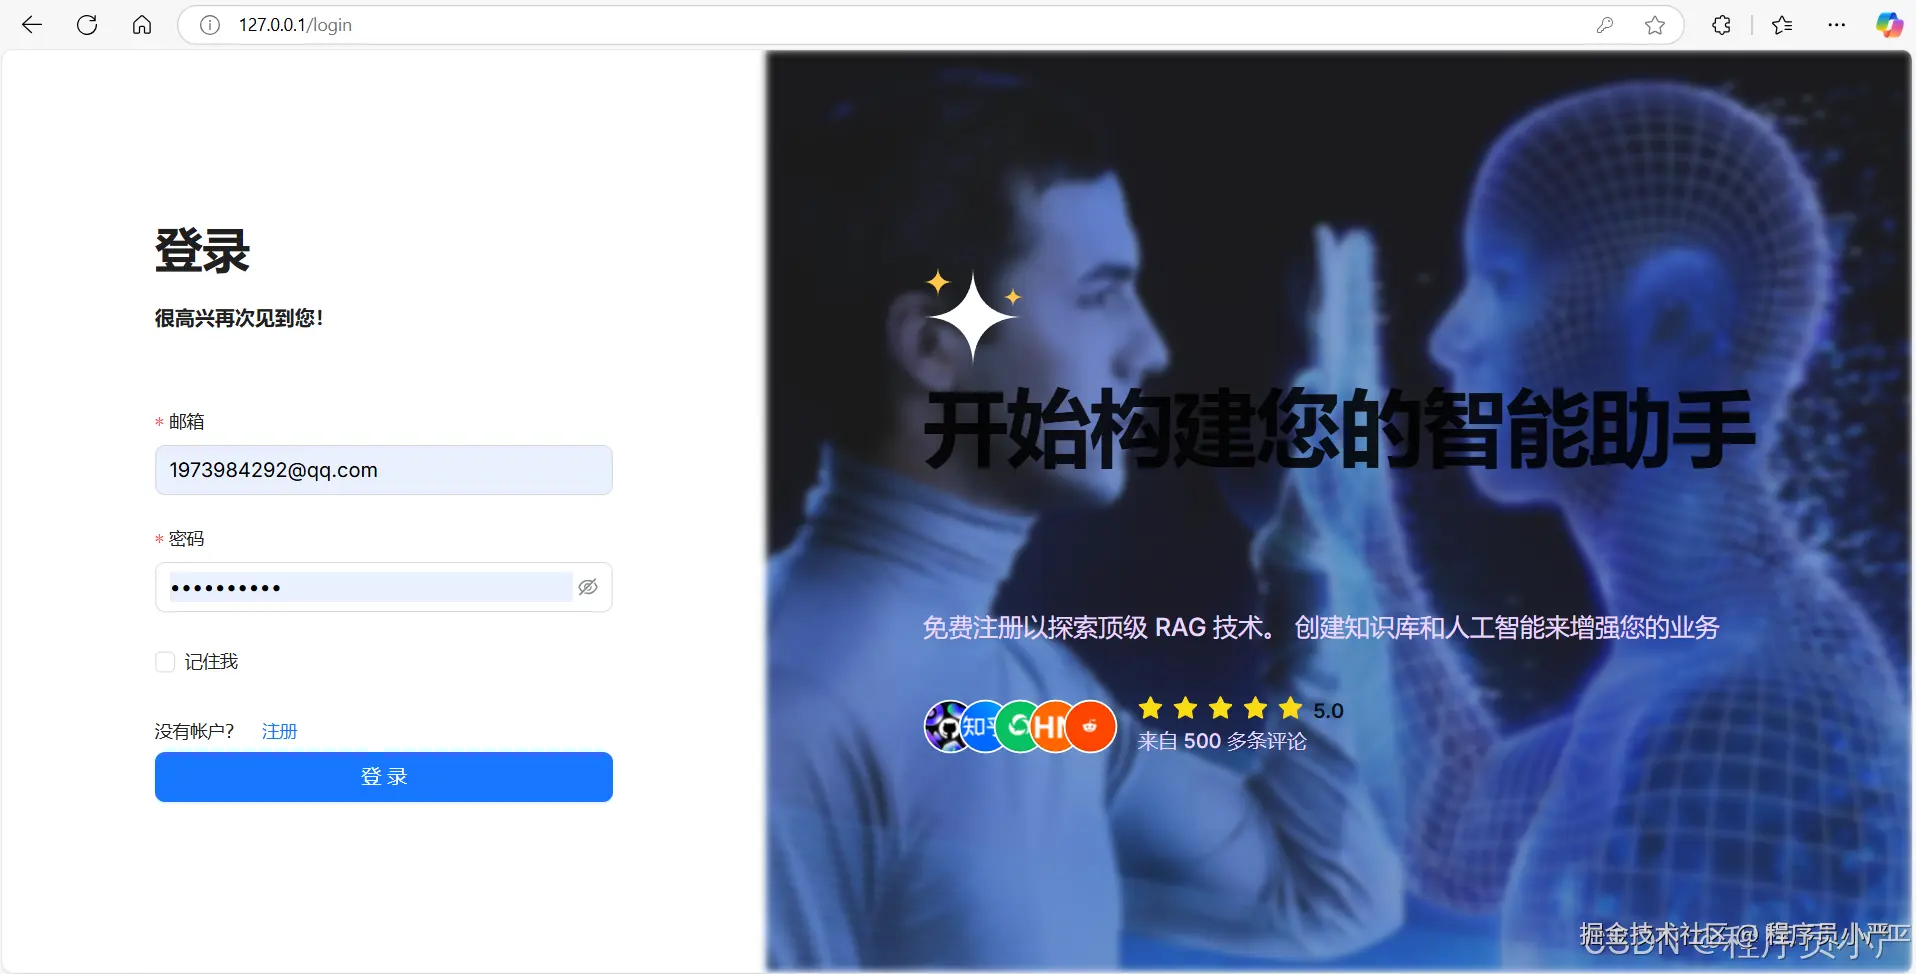
在这里插入图片描述

1.5.2 配置模型LLM

点击个人中心-》模型提供商-》在此设置模型参数
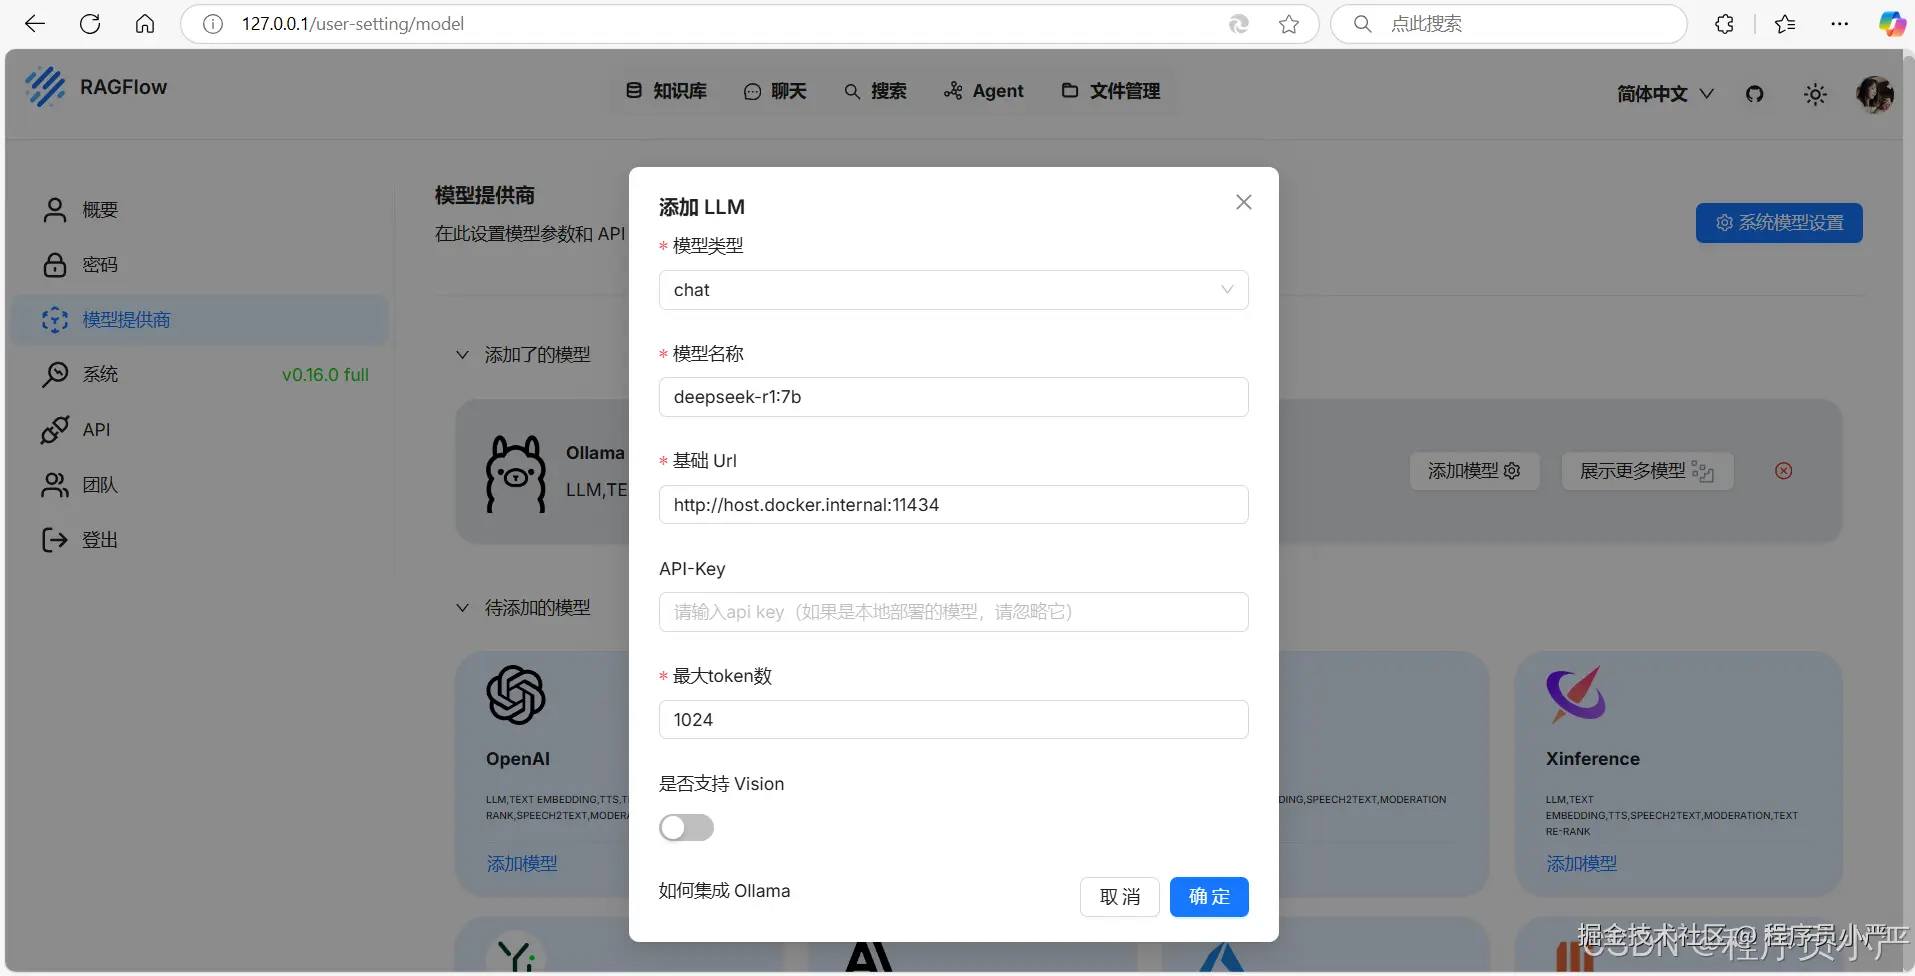
在这里插入图片描述

1)模型类型:DeepSeek 模型选择chat,bge-m3 模型选择 embedding

2)模型名称:Ollama -list命令中列出的模型名称填写(建议在列表中复制),如:deepseek-r1:7b

3)基础Url:http://host.docker.internal:11434

4)最大token数:可随便填写(本地部署不消耗在线 token),如:1024

1.5.3 系统模型设置

还是点击个人中心-》模型提供商-》系统模型设置 在这里插入图片描述
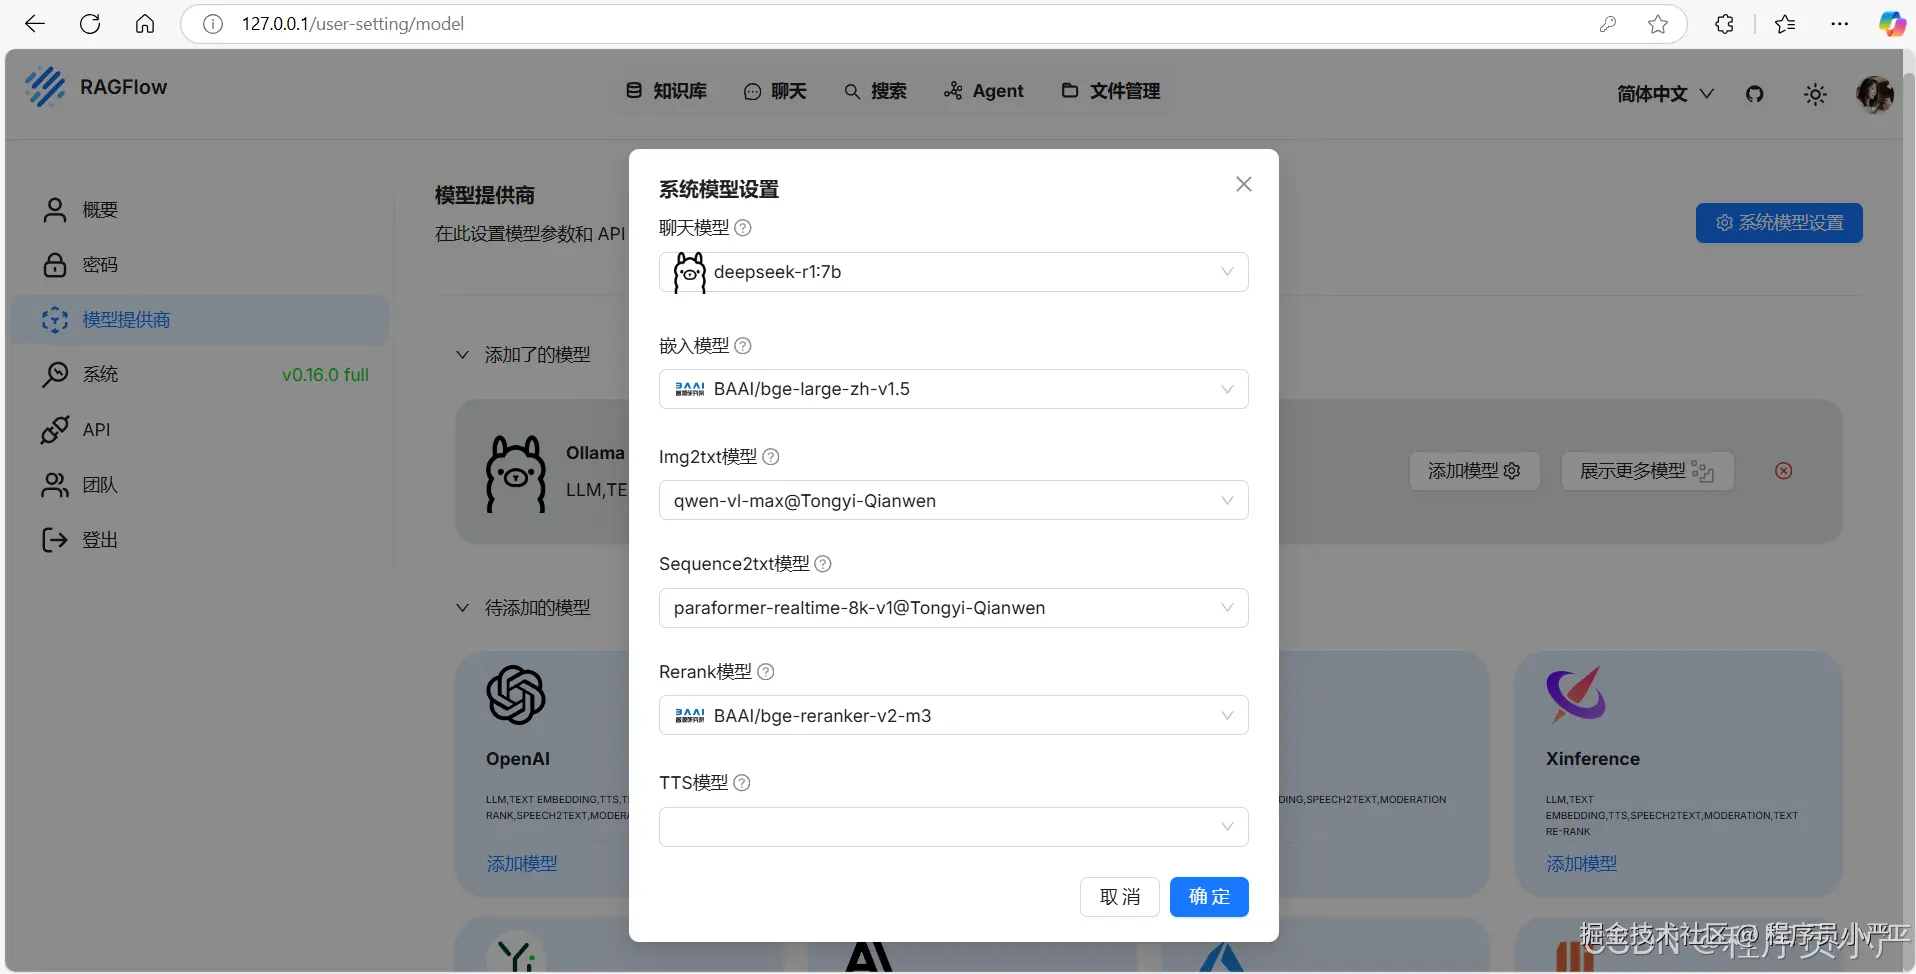
聊天模型选择:本地部署的deepseek-r1:7b

嵌入模型,Img2txt模型、Sequence2txt模型、Rerank模型、都是RagFlow默认的

这里简单说一下这几个模型之间的联系:

嵌入模型提供数据表示,Img2txt和Sequence2txt模型生成文本,Rerank模型优化结果,聊天模型生成最终回复,TTS模型将文本转为语音。

1.5.4 创建知识库
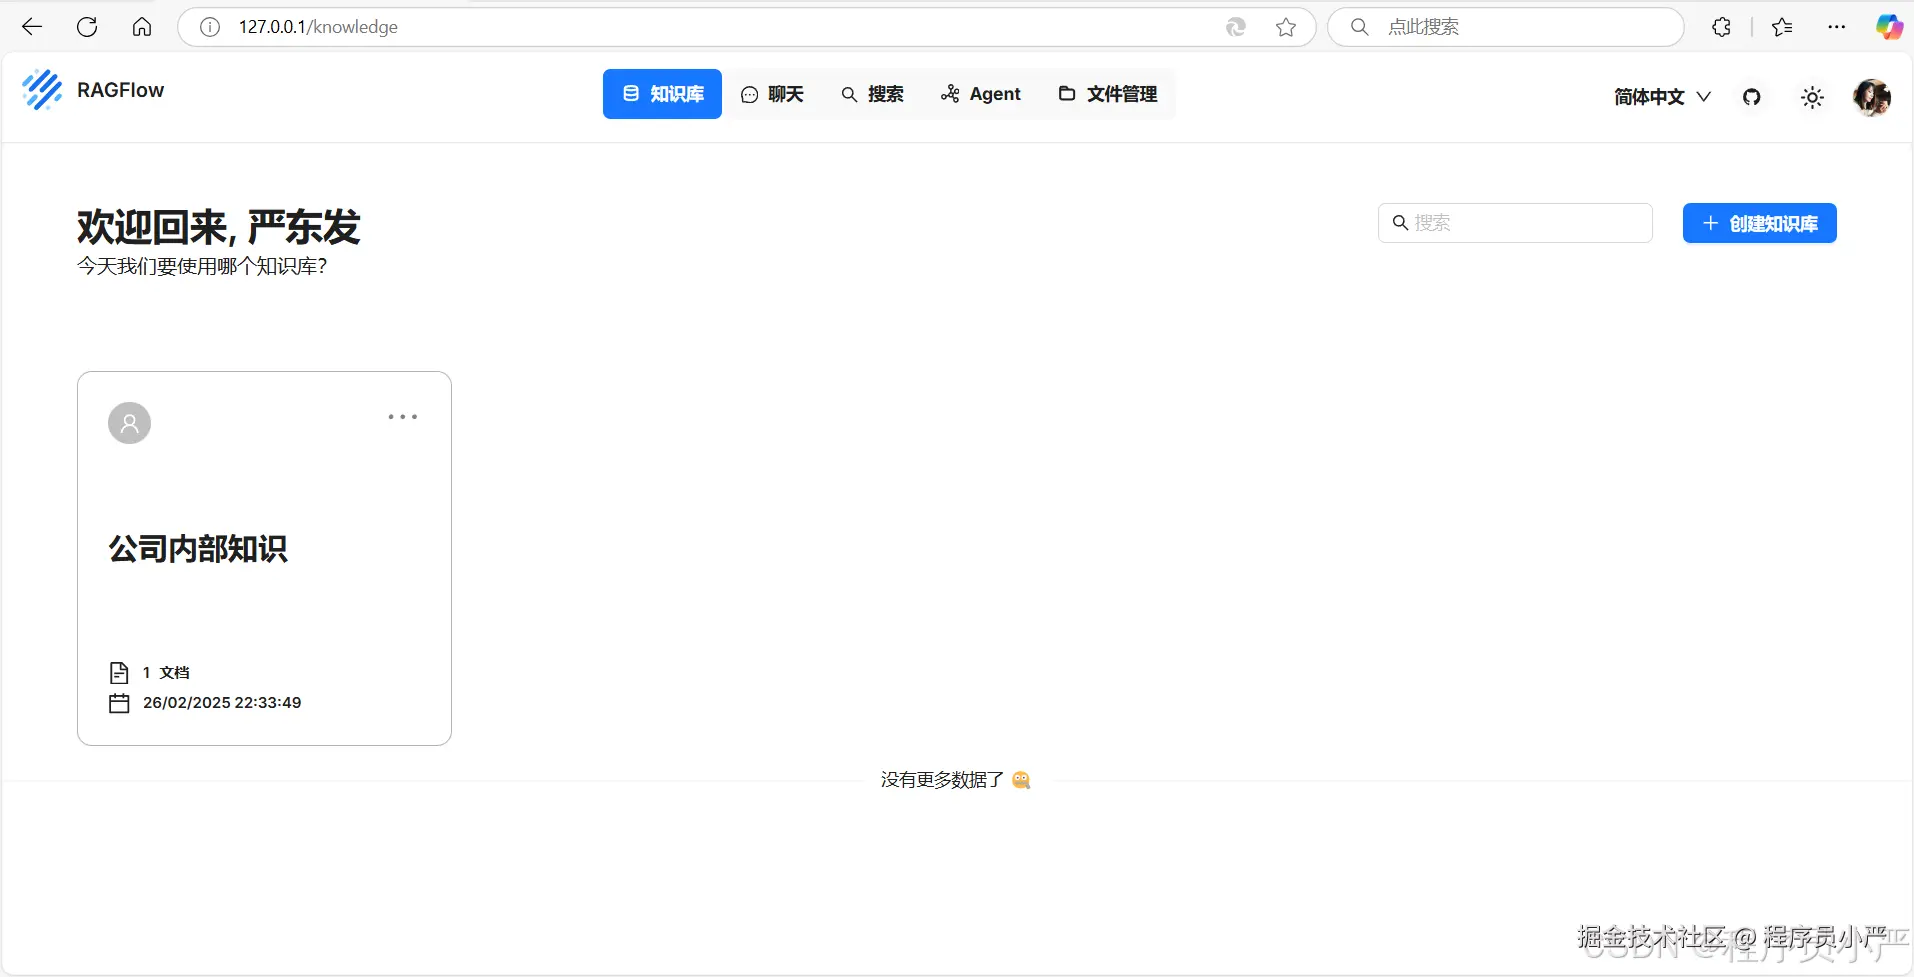
在这里插入图片描述

1.5.5 上传文件并解析

知识库的内容检索回答,需要先将文件解析成块后才能问答。
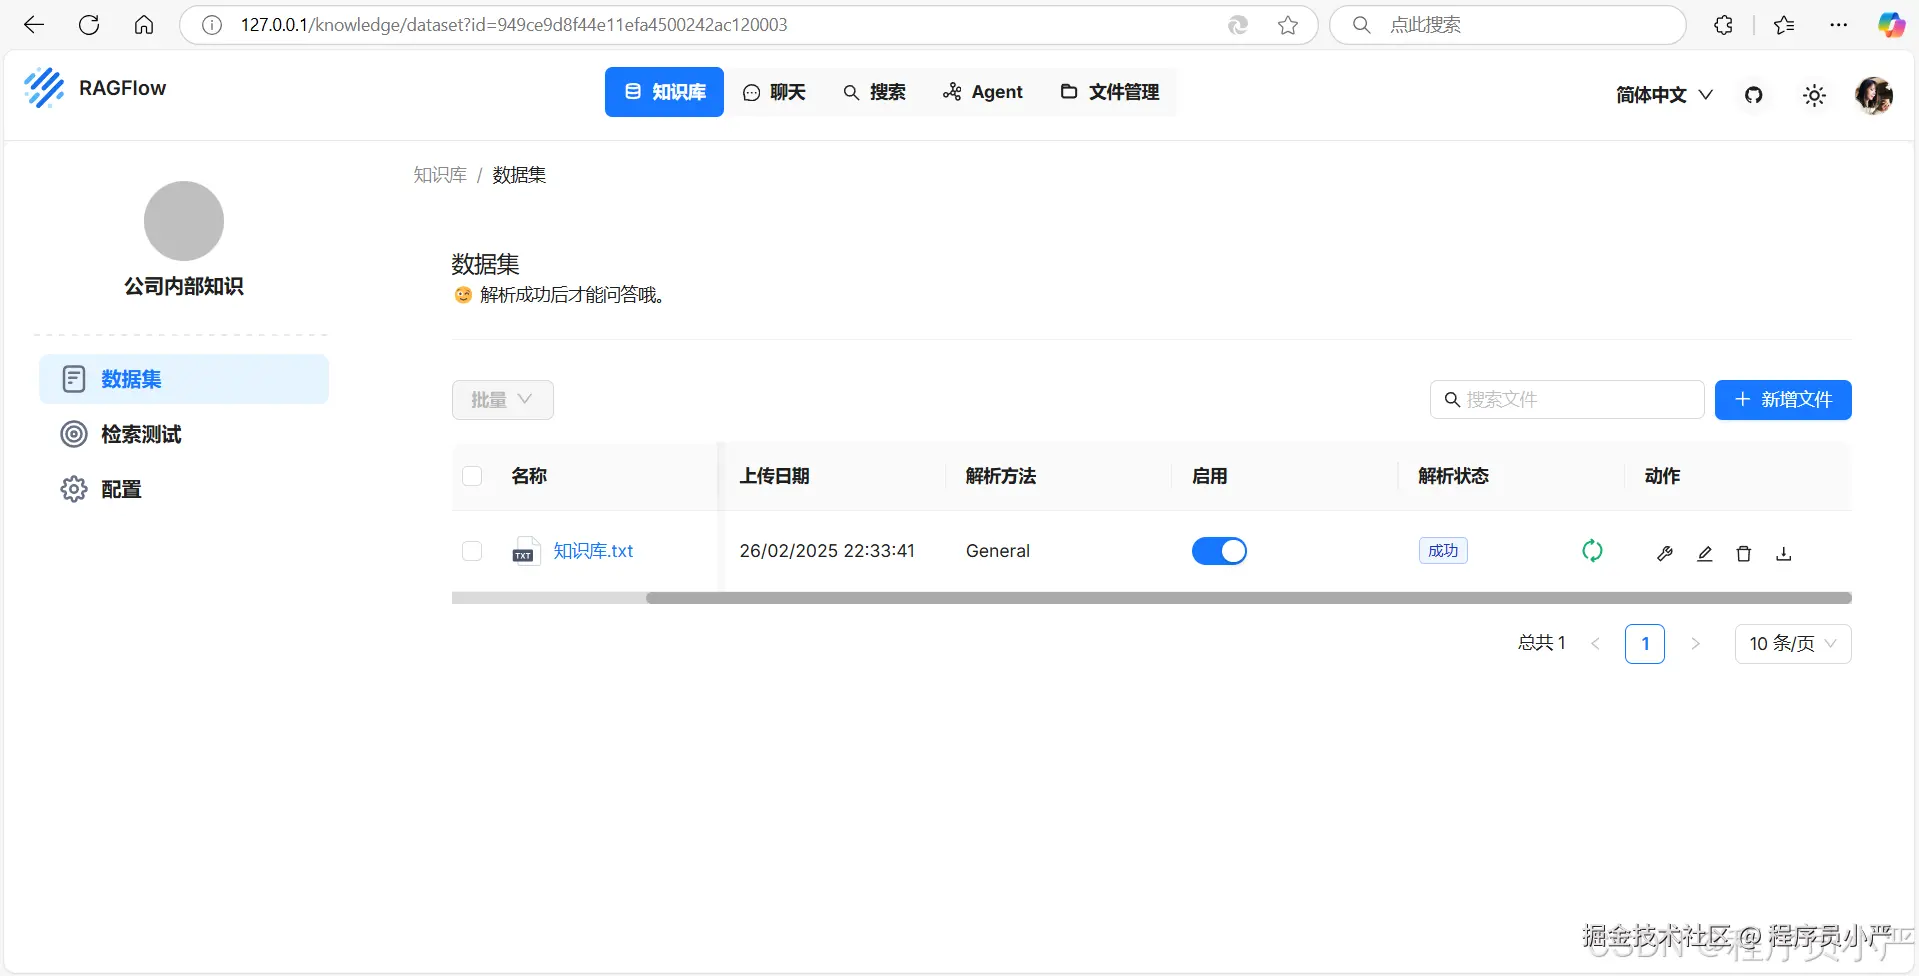
在这里插入图片描述

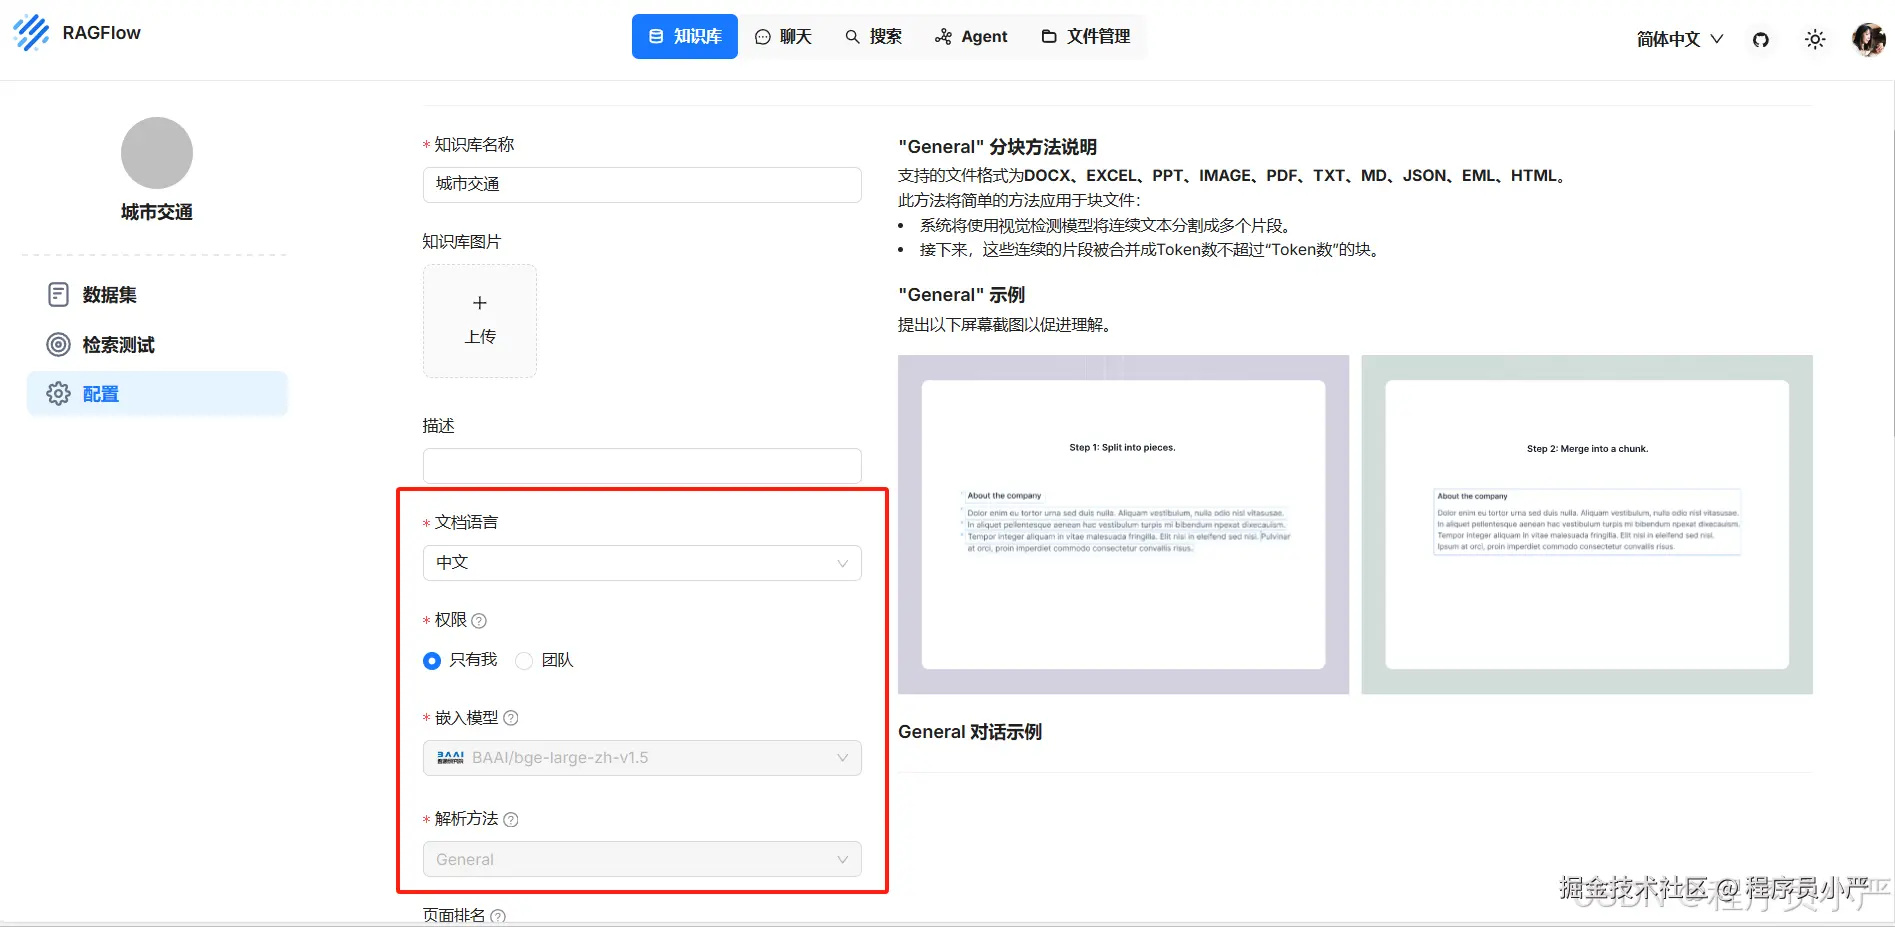
1.5.6 配置知识库模型

配置创建好的知识库模型,就可以进行检索了。

在这里插入图片描述

1.5.6 聊天助手知识问题

添加聊天助手做知识问答。

在这里插入图片描述

1.6 使用问题

1.6.1 docker运行ragflow内存不足的问题

检索出错:

ERROR: Connection error caused by: ConnectionError(Connection error caused by: NewConnectionError(<urllib3.connection.HTTPConnection object at 0x7fead7596a40>: Failed to establish a new connection: 【Errno 111】 Connection refused))

解决方案:

调整windows对docker desktop的内存分配。

win + r,调出运行,输入 %UserProfile%,进入用户文件夹

在用户文件夹下创建一个新的文件,改名为 .wslconfig,内容如下:

[wsl2]
memory=16GB          # 分配的内存
processors=12        # 处理器核心数量,考虑超线程
swap=0
localhostForwarding=true

保存文件后,重启docker和WSL。

  1. 退出docker,任务管理器中确保无docker相关进程
  2. win+r调出运行,输入cmd并回车,在命令提示符中,输入以下内容并回车
wsl --shutdown

重新打开docker,确保容器中所有的程序都运行,重新在浏览器中连接ragflow进行尝试

1.6.2 长文本回复中断问题:ERROR: Tenant not found

目前在官方发布的最版本v0.16.0中,还是会存在长文本回复中断问题这个问题,并且Github官方仓库中有很多关于此问题的issuse,后续看ragflow官方团队发布最新版本时是否会解决这个问题。

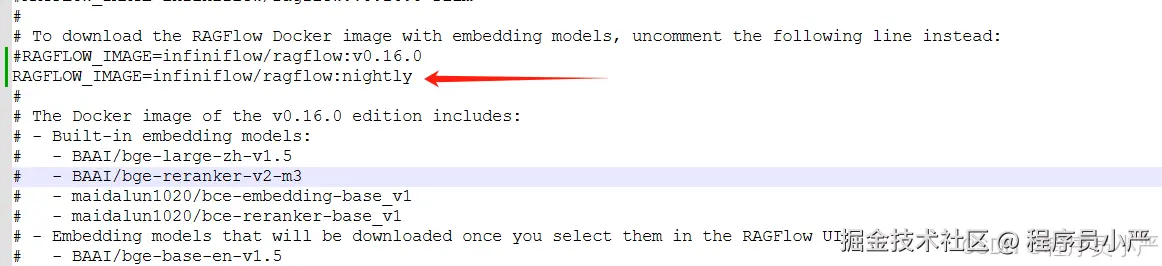
解决方案:升级到最新的经过测试的版本nightly,这里我查了一下官方升级文档如下:
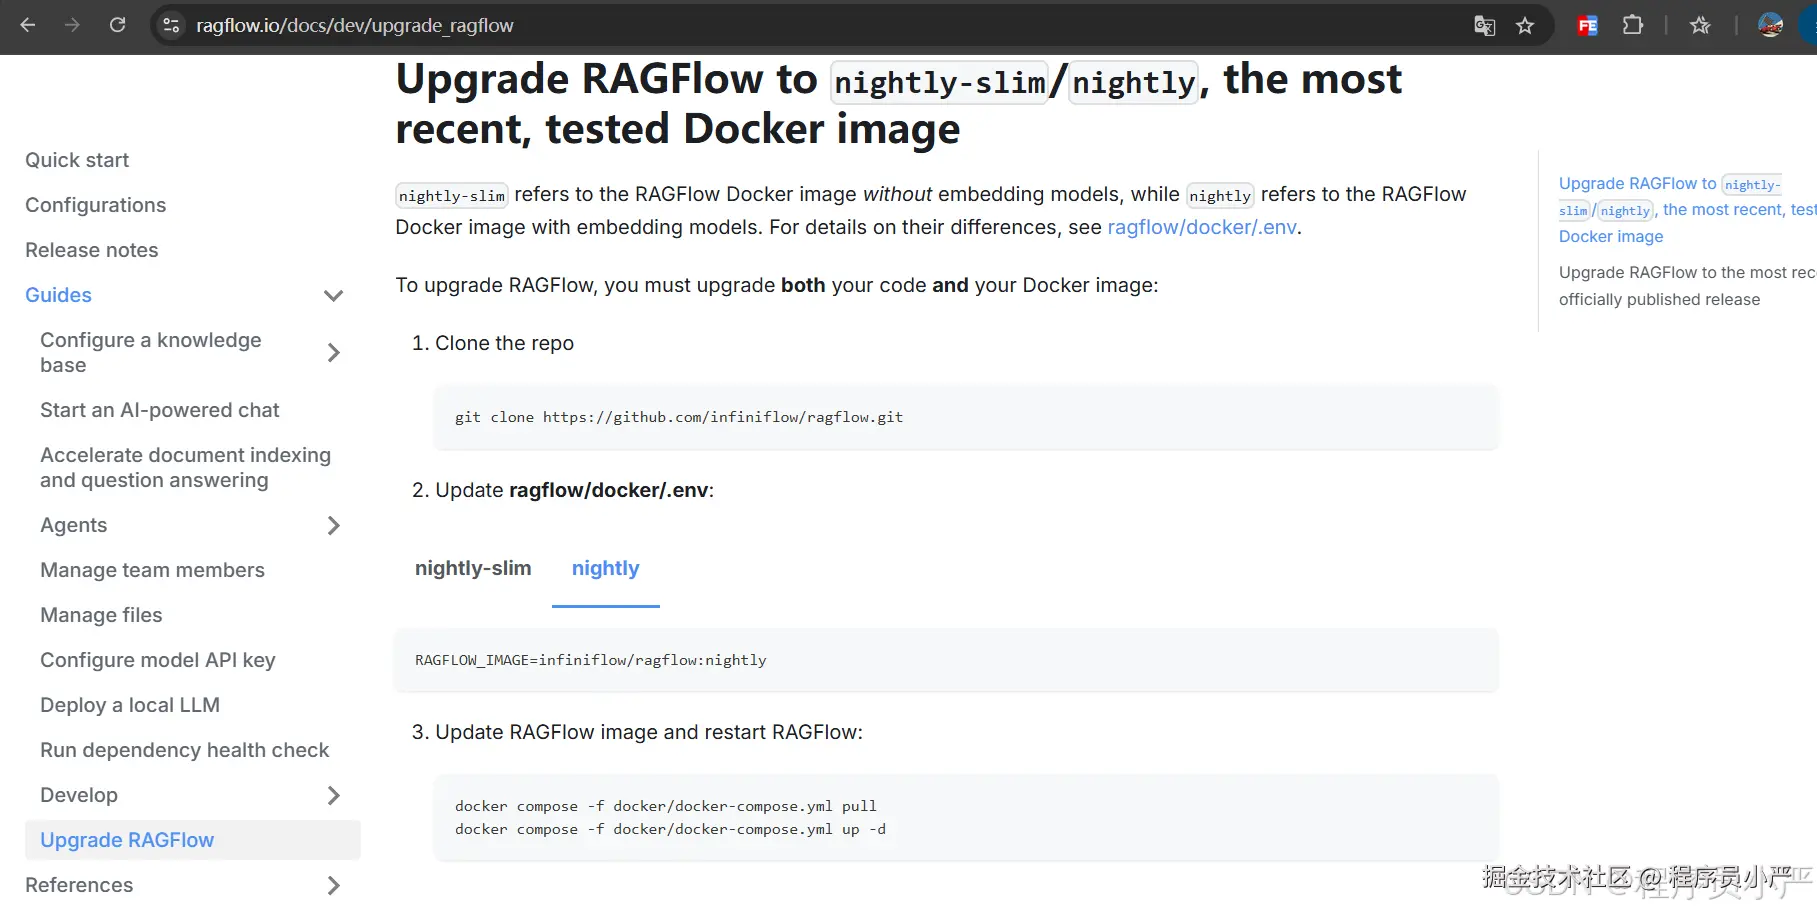
ragflow.io/docs/dev/up…

在这里插入图片描述
第一:修改/docker/.env文件,设置RAGFLOW_IMAGE=infiniflow/ragflow:nightly
在这里插入图片描述

第二:重新更新RagFlow镜像

# 停止所有容器运行,并且删除挂载卷
docker compose -f docker-compose.yml down -v
# 重新拉去RagFlow相关镜像
docker compose -f docker-compose.yml pull
# 运行
docker compose -f docker-compose.yml up -d

最后

为什么要学AI大模型

当下,⼈⼯智能市场迎来了爆发期,并逐渐进⼊以⼈⼯通⽤智能(AGI)为主导的新时代。企业纷纷官宣“ AI+ ”战略,为新兴技术⼈才创造丰富的就业机会,⼈才缺⼝将达 400 万!

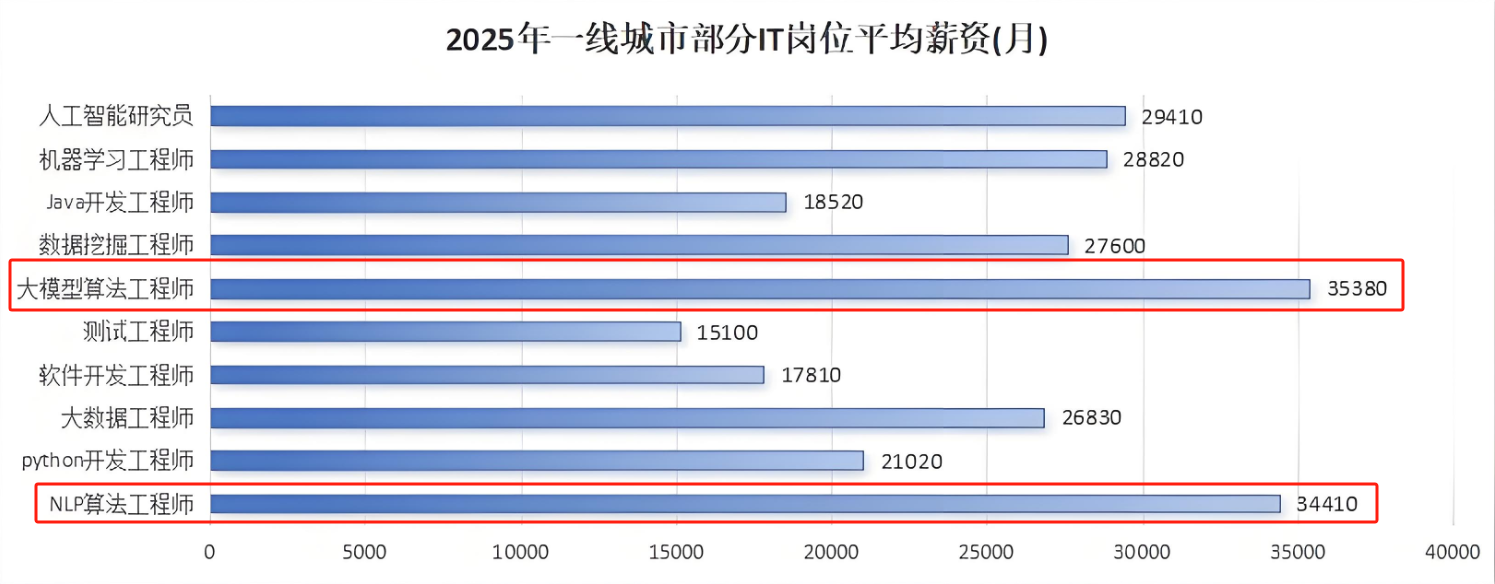
DeepSeek问世以来,生成式AI和大模型技术爆发式增长,让很多岗位重新成了炙手可热的新星,岗位薪资远超很多后端岗位,在程序员中稳居前列。
在这里插入图片描述

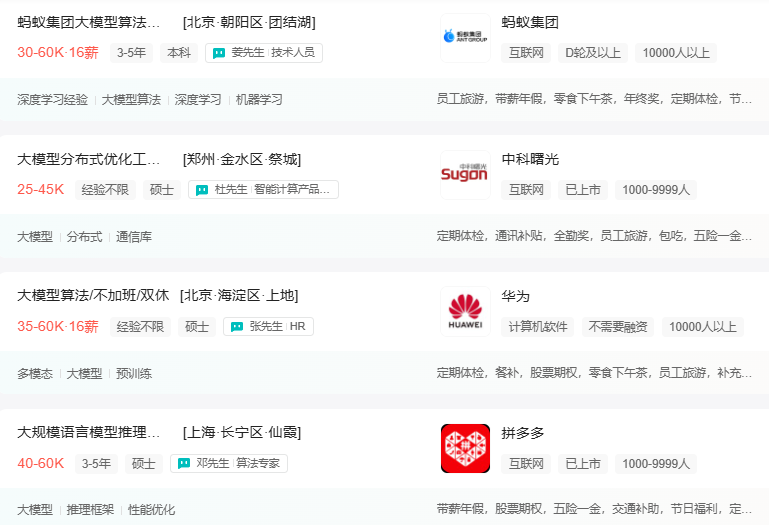
与此同时AI与各行各业深度融合,飞速发展,成为炙手可热的新风口,企业非常需要了解AI、懂AI、会用AI的员工,纷纷开出高薪招聘AI大模型相关岗位。
在这里插入图片描述
最近很多程序员朋友都已经学习或者准备学习 AI 大模型,后台也经常会有小伙伴咨询学习路线和学习资料,我特别拜托北京清华大学学士和美国加州理工学院博士学位的鲁为民老师给大家这里给大家准备了一份涵盖了AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频 全系列的学习资料,这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

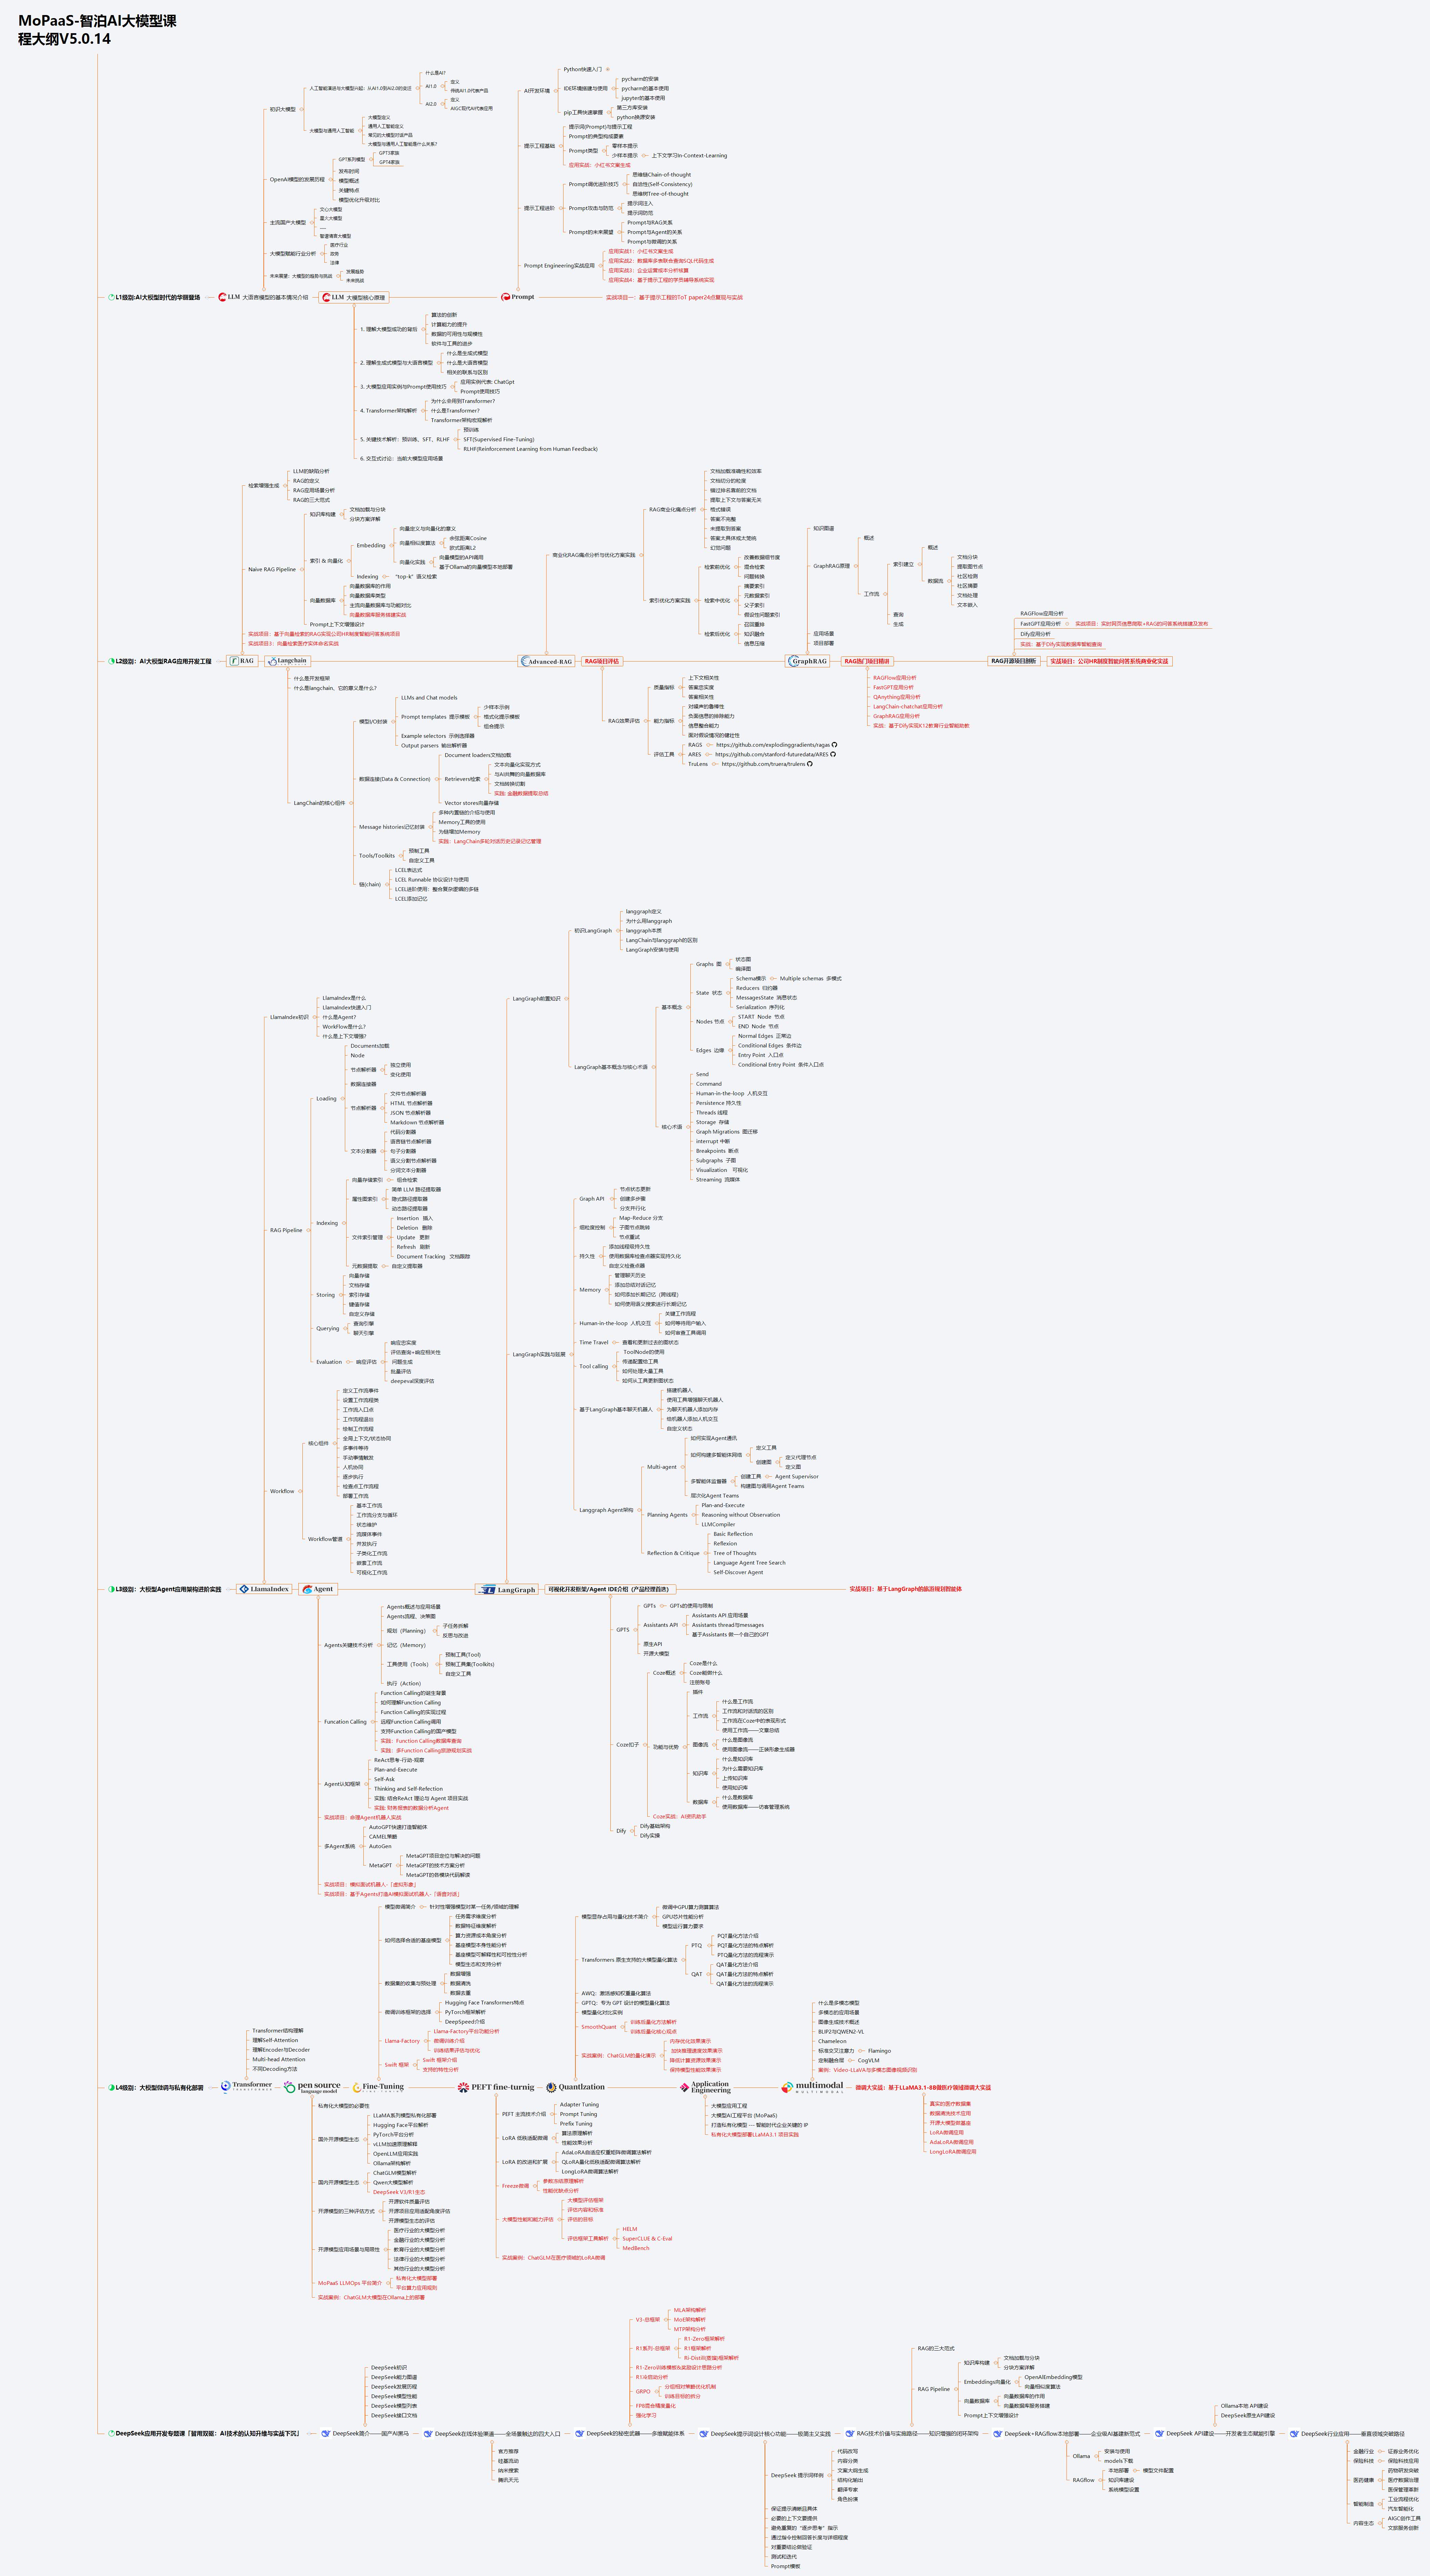
AI大模型系统学习路线

在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。
img

但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。

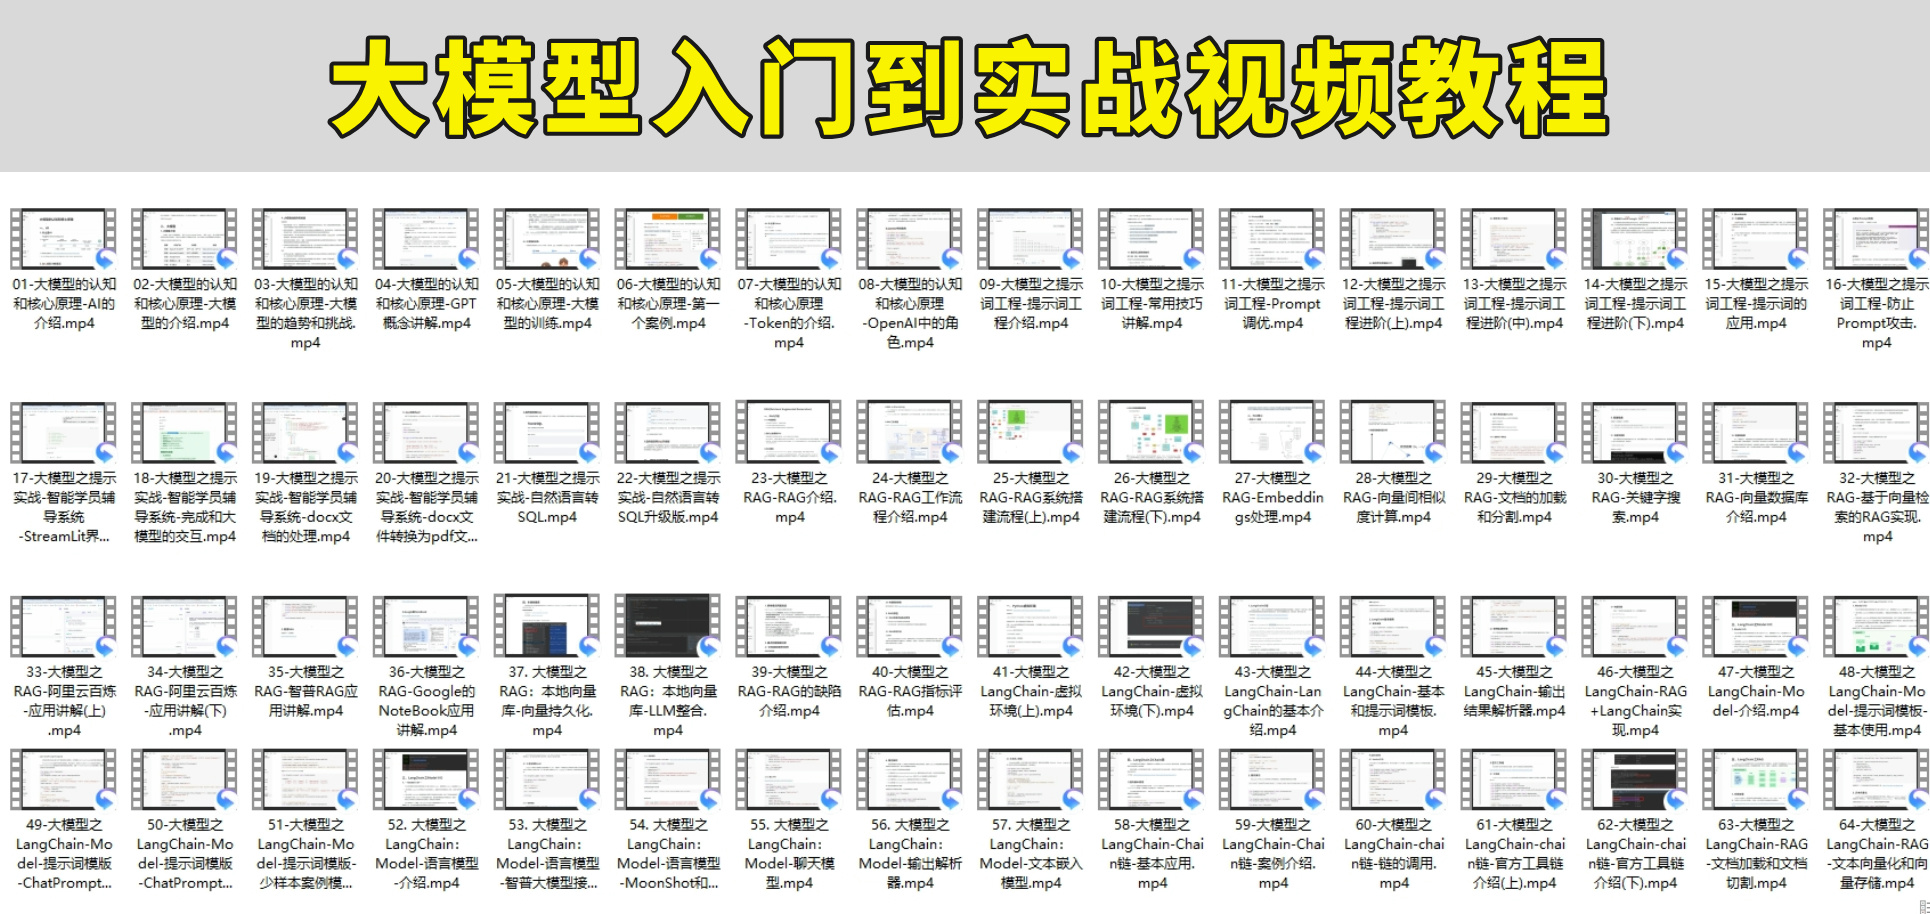
AI大模型入门到实战的视频教程+项目包

看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
在这里插入图片描述
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述

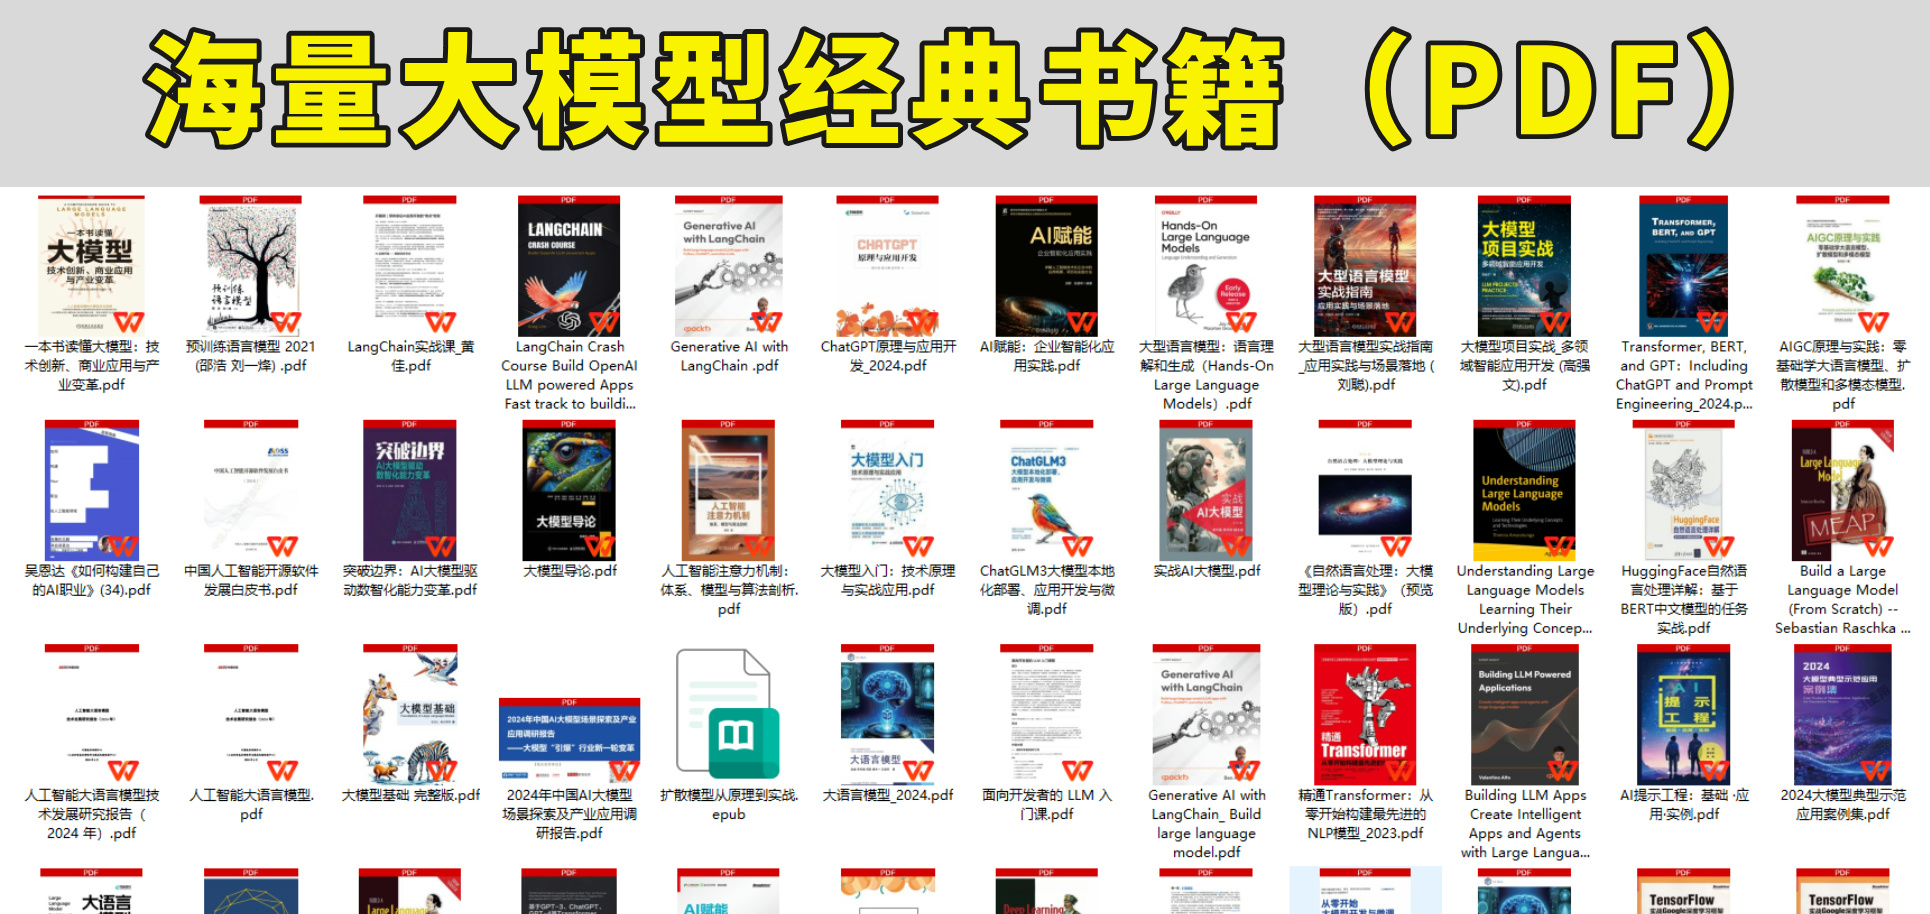
海量AI大模型必读的经典书籍(PDF)

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
在这里插入图片描述

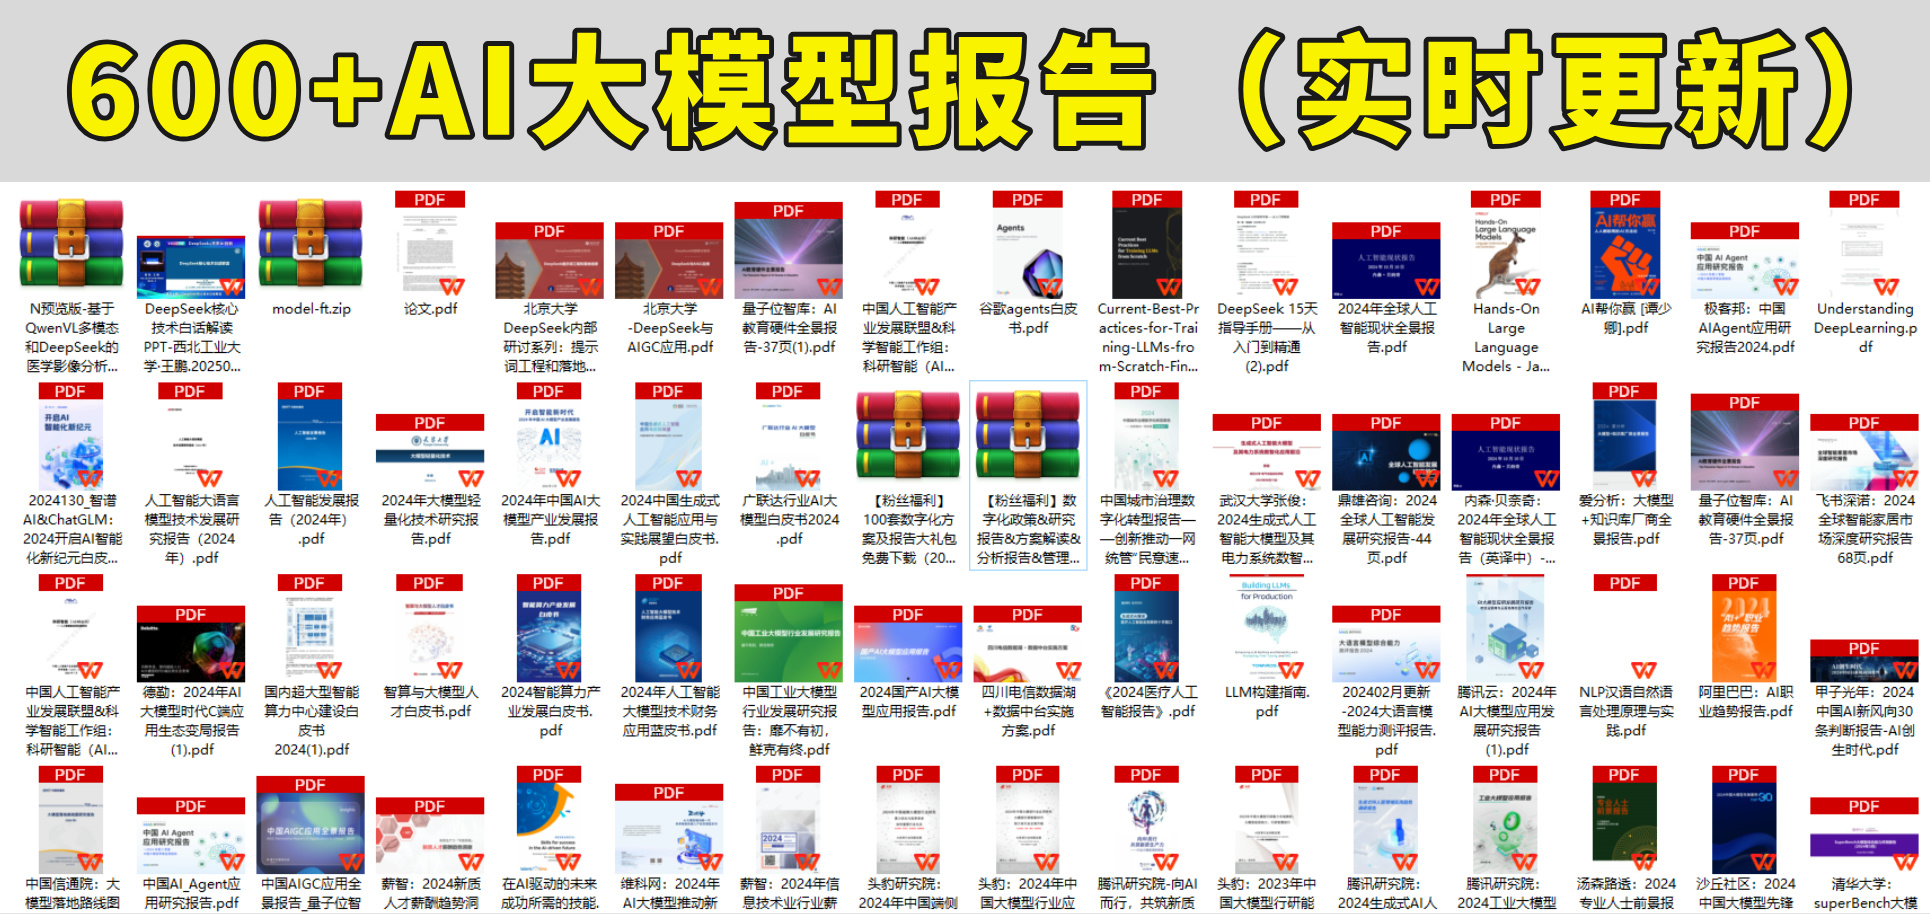
600+AI大模型报告(实时更新)

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
在这里插入图片描述

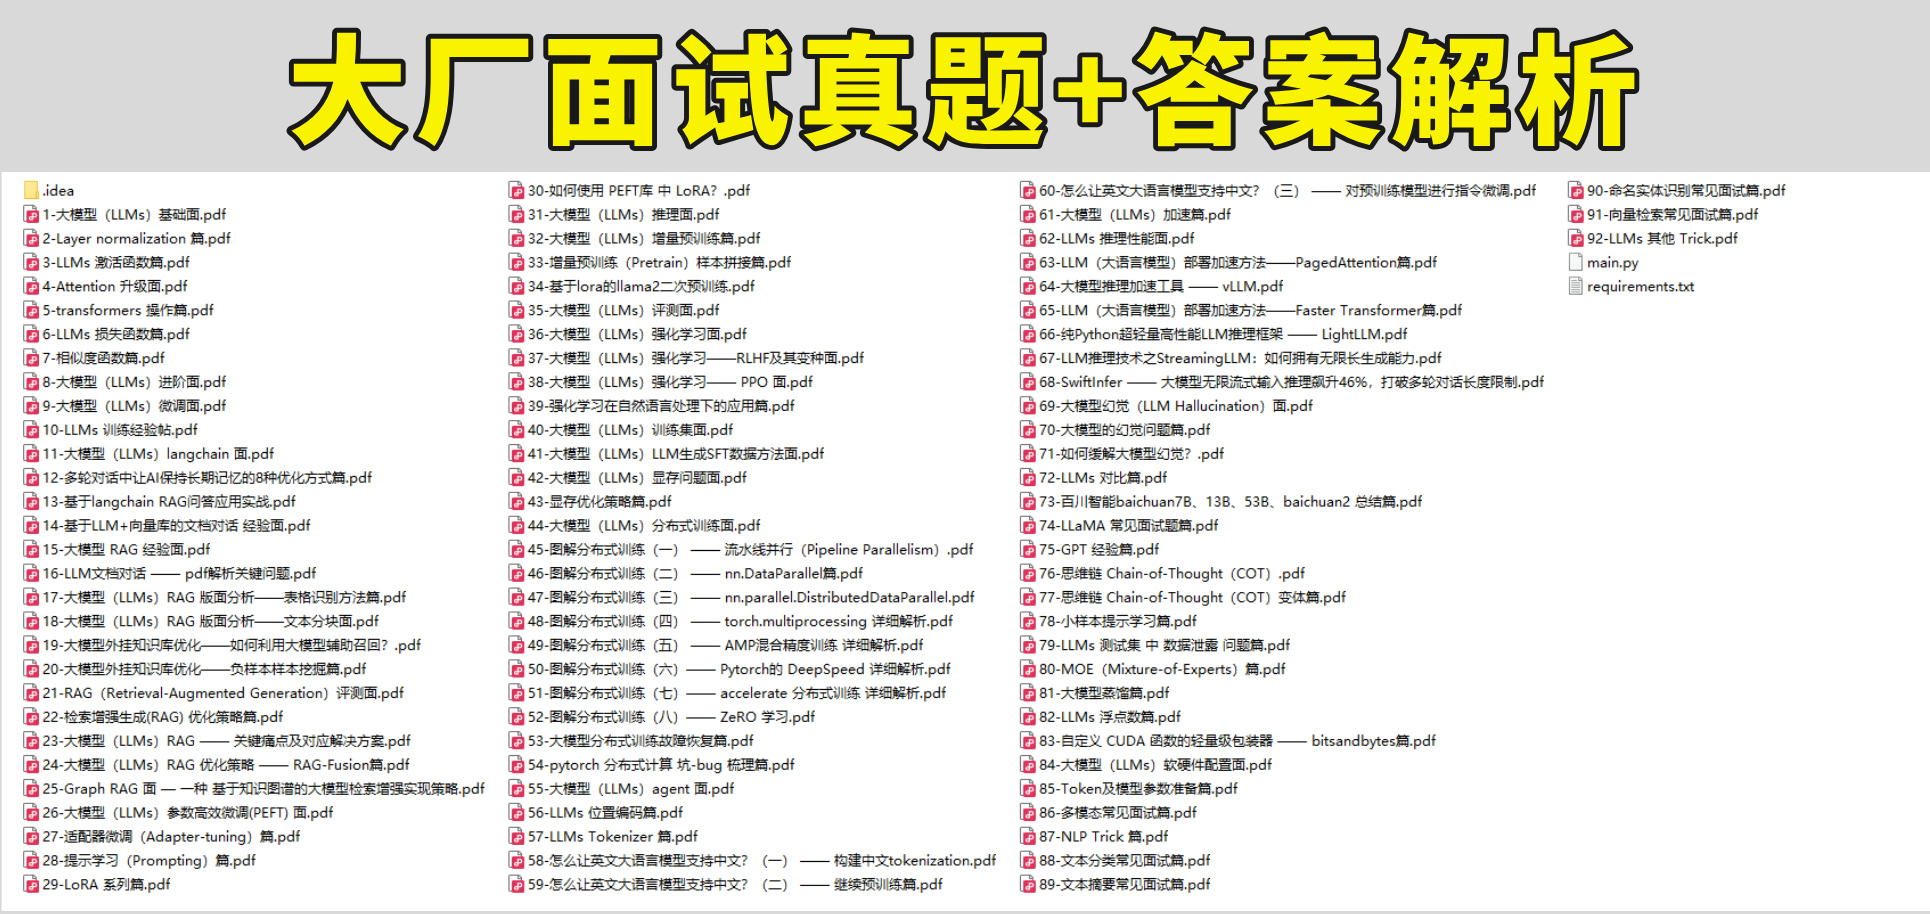
AI大模型面试真题+答案解析

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

最详细的deepseek-r1:7b+RagFlow本地知识库搭建教程 目前在官方发布的最版本v0.16.0中,还是会存在长文本回复中断问题这个问题,并且Github官方仓库中有很多关于此问题的issuse,后续看ragflow官方团队发布最新版本时是否会解决这个问题。,可以让 Ollama 监听所有可用的网络接口,从而允许外部网络访问:0.0.0.0:11434,否则在RagFlow中,模型url无法使用本地IP进行注册。嵌入模型提供数据表示,Img2txt和Sequence2txt模型生成文本,Rerank模型优化结果,聊天模型生成最终回复,TTS模型将文本转为语音。 阅读详情

相关推荐

WINDOWS安装RAGFLOW完整流程

2:上面的命令大概需要2个小时完成,docker的命令大概有11G左右,命令执行完成后RAGFLOW就启动成功了。关键点2:硬盘容量一定不能小于50G,否则RAGFLOW的ES组件不能正常工作,最好定义为100G以上。关键点3:帖子中第5点切ROOT不是必选操作,如果不切ROOT,输入命令的时候前面加sudo。1:上面的命令的第三步RAGFLOW_VERSION,可以不修改,默认会使用dev版本。虚拟机开机完成后,开始安装Docker,首先需要修改ubuntu的docker源。即可安装docker。

wuhoufatian的博客 6079

2024-11-6 ragflow Windows11 安装过程

小白安装ragflow,踩了很多坑,网上有些资料是早期版本的,有些步骤没有讲到,我尽量还原我的安装过程,里面的代码可以如果复制有问题可以在kimi找一下。

mamamilulu的博客 6858

Docker+Ollama+RAGFlow本地部署DeepSeek R1并构建本地知识库

本文详细记录了通过Ollama安装DeepSeek R1:7B模型,通过Docker加载Open-WebUI,RAGFlow框架,并以RAGFlow为基础搭建本地知识库,其中embedding模型选择了比较受欢迎的nomic-embed-text。通过对通用大模型融合本地知识库进行推理的亲自体验,形成对于DeepSeek等AI大模型利用方式的新认识。

F8_11的博客 2437

DeepSeek+Ragflow搭建个人知识库

利用Deepseek+Ragflow搭建的知识库过程还是比较简单,正常跟着流程走不容易出错。如果投喂的数据经过整合处理,那么反馈的结果还是有一定的实际意义。当前个人能部署的模型参数太少,尚处于体验阶段。相信不久的将来,大模型不断发展,个人能部署性能更强大的模型。

m0_63171455的博客 7093

DeepSeek部署及ragflow知识库问题汇总

普通的AI大模型:基于训练好的数据回答,知识库+AI:基于知识库和训练数据回答,网络Tools+知识库+AI:再加上网络数据回答,涉及到agent等知识,后续如果需求的朋友多会考虑出一期。A:仍然是镜像源的问题,设置镜像源后建议重启docker,截至视频发布,视频内镜像源仍可访问,如果还是不行,可以增加镜像源,配置如下。,如果不太熟悉git,一键安装包中已经下载好了,ragflow文件夹中就是,跳过下载,按照步骤操作即可。4.启动模型:也可以启动快捷图标ollama 即可在CMD模式下 使用交互窗口交互。

qq_40358970的博客 8881

Linux部署DeepSeek r1 模型训练

Ollama是一个开源软件,主要用于在本地电脑设备上下载、部署和使用大模型(LLM)。它提供了丰富的LLM库,如llama、qwen、mistral以及DeepSeek R1等,并且支持不同参数规模的模型,以适配不同性能的电脑设备‌。Ollama虽然支持直接使用LLM,但仅能在命令行中进行对话,交互功能有限,因此需要配合其他工具使用‌。通俗理解为用于方便本地部署大模型使用的工具,实现离线使用和数据得到安全保护。Cherry Studio 是一个用于创建和部署桌面应用程序的开发框架,特别适用于开发跨平台应用。

运维老生常谈 7246

【喂饭教程】最详细的DeepSeek-R1:7B+RAGFlow本地知识库搭建教程,建议收藏起来慢慢学!!

嵌入模型提供数据表示,Img2txt和Sequence2txt模型生成文本,Rerank模型优化结果,聊天模型生成最终回复,TTS模型将文本转为语音。

嘴巴吃糖了 1295

从零构建智能监控系统:ZLMediaKit与SpringBoot的RTSP流处理实战

本文详细介绍了如何从零构建智能监控系统,结合ZLMediaKit与SpringBoot实现RTSP流处理。通过多协议支持、高性能架构设计及工业级部署优化,解决传统监控方案的兼容性差、延迟高等问题,适用于物联网和智能安防领域。

weixin_29002209的博客 373

【AI大模型】Ollama部署本地大模型DeepSeek-R1,交互界面Open-WebUI,RagFlow构建私有知识库

DeepSeek官网DeepSeek(深度求索)是一家专注于实现通用人工智能(AGI)的中国科技公司,致力于通过技术探索与创新,推动智能技术的广泛应用。Ollama 是一个强大的工具,旨在简化大型语言模型的部署和推理过程。它通过模型压缩和优化技术,使得在本地或边缘设备上运行 AI 模型变得高效且易于管理。无论是开发者、研究人员还是企业用户,Ollama 都能提供灵活和支持,满足多种应用场景的需求。

专注上位机开发、机器视觉、机器学习、嵌入式软硬件开发 9万+

SRAM:SRAM入门指南与工作原理

SRAM(Static Random Access Memory),即静态随机存取存储器,是一种能够读取和写入数据的内存(RAM)。它使用由晶体管组成的触发器来存储数据,只要有电源供应,数据就可以稳定地保存。与动态随机存取存储器(DRAM)不同,SRAM 不需要周期性地刷新来保持数据。

weixin_42896509的博客 1万+

反激开关电源变压器设计实例讲解(定明芳)

内容来自《反激变压器的设计》(定明芳主讲)。 定名芳老师主要讲了10步,最后应该还有一步,线径的选择已经绕制方式。这里进行了记录整理,把一些公式来源进行了推导。所有的设计都是基于理论计算。 1.确定电源规格 2.确定工作频率和最大占空比 3.计算匝比(利用伏秒平衡原则) 此处插入解释一下伏秒平衡,根源是磁通量平衡。该原则可以用来检查MOS管耐压是否够。 4.计算初级线圈峰值电流 基于CCM模式计算的。ip1是开关管要关闭时的峰值电流,ip2是开关管开始导通时的起始电流。因为时CCM模式,所以,ip

ydgd118的博客 5万+

手把手教你DeepSeek-R1本地部署和企业知识库搭建(Ollama+DeepSeek+RAGFlow)【保姆级教学】

手把手教你如何搭建企业知识库!速来

**My Coding Family** 23万+

USRP B210 运行gnuradio时 FPGA固件版本冲突错误解决方法

事情起源于昨天拿到USRP后开始调试,结果整了一个下午都没解决这个问题。 昨天晚上自己思考了一下,觉得还是版本问题。 首先,uhd_find_devices和uhd_usrp_probe均可以正常运行,没有报错,固件正常加载,序列号也可看到。 teray@teray-X550JK:~$ uhd_find_devices [INFO] [UHD] linux; GNU C++ version 7.5...

斯哈研究所 4249

在笔记本电脑上用DeepSeek搭建个人知识库

本文尝试在个人笔记本电脑上部署DeepSeek并使用开源工具搭建一套个人知识库,实现完全在本地环境下使用本地文档搭建个人知识库。操作过程共享出来,供大家参考。

陈喆小博 2万+

青岛鼎信Java开发面试题及参考答案(3万字长文,多张原理图)

MySQL 的事务特性有哪些? MySQL 事务具有四个重要特性,被称为 ACID 特性。 原子性(Atomicity):事务是一个不可分割的工作单位,事务中的操作要么全部执行,要么全部不执行。例如,在银行转账场景中,从账户 A 转账到账户 B,包括扣减账户 A 的金额和增加账户 B 的金额这两个操作必须作为一个整体来完成。如果在执行过程中发生错误,比如系统崩溃或者数据库出现故障,那么已经执行的部分必须全部回滚,就好像整个转账操作从未发生过一样。 一致性(Consistency):事务必须

大模型大数据攻城狮的专栏 1092

OpenHarmony深度定制:从系统到模块的全景剖析与自定义模块实战

目标:在中新增一个算法库,让产品可直接调用。关闭不用的 20+ 系统部件,ROM 缩小 50 %;为自家芯片新增专用驱动模块,快速点亮开发板;内将核心算法库以部件形式集成,实现商业闭源。万物互联时代,差异化才是护城河。

m0_67505153的博客 1048

DeepSeek-R1 + RAG搭建本地知识库,建议收藏!

利用DeepSeek-R1与RAG(Retrieval-Augmented Generation,检索增强生成)技术可以快速搭建本地知识库。为确保本地知识库的高效搭建,需先准备DeepSeek-R1模型、相关文档/数据集及部署工具(如Ollama), 随后安装Ollama并部署DeepSeek-R1 ,同时选择并配置文本嵌入模型,最后收集/整理文档并确保其唯一标识符和文本内容, 利用文本嵌入模型转换文档为向量以构建快速检索的索引。检索增强生成(Retrieval-Augmented Generation,R

2401_85373691的博客 2990

手把手教你学 NPU 驱动开发--第一部分:基础准备 开发环境搭建:Linux 内核编译与 NPU 仿真平台配置

摘要:本文详细介绍了搭建Linux内核编译与NPU仿真平台的完整流程。主要内容包括:1) 准备ARM64交叉编译工具链;2) 编译支持KGDB调试的Linux内核;3) 构建最小根文件系统;4) 使用QEMU模拟自定义NPU设备;5) 配置KGDB调试环境。文章重点讲解了如何通过修改设备树添加虚拟NPU设备,并提供了开源NPUIP Gemmini作为实验对象。最后展示了简单的"Hello NPU"驱动验证方法,为后续NPU驱动开发奠定了基础。文中还附有常用命令速查表,方便开发者快速搭建调

MHD0815的博客 386

基于 DeepSeek LLM 本地知识库搭建开源方案(AnythingLLM、Cherry、Ragflow、Dify)认知

博文内容涉及 基于 Deepseek LLM 的本地知识库搭建使用 ollama 部署 Deepseek-R1 LLM知识库能力通过 Ragflow、Dify 、AnythingLLM、Cherry 提供理解不足小伙伴帮忙指正 😃,生活加油我站在人潮中央,思考这日日重复的生活。我突然想,如果有一天,垂老和年轻都难以惊起心中涟漪,一潭死水的沉闷,鲜花和蛋糕也撼动不了。如果人开始不能为微小事物而感动,那么地震山洪的噩耗想必也惊闻不了。如果活着和死亡的本质无异,那便没有了存在的意义。

山河已无恙 4409

SAP-MM-采购过账接口(与WMS集成)-代码

1、判断传入值非空检验; 2、判断过账日期是否允许在当前期间; 3、判断是否为集采订单业务,是否审批完成; 4、判断是否发布标准成本发布(此业务场景与价格控制3+S有关) 5、保存日志表; 6、判断业务公司订单审批状态; 7、创建STO交货单、集采公司订单过账、STO公司间创建交货单、交货单过账(两步法)、过账失败回滚(冲销交货、删除交货单、冲销集采入库)

qq_32198063的博客 422

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

本地部署DeepSeek-R1,并搭建自己的知识库!

本地部署DeepSeek-R1,并搭建自己的知识库

weixin_57699105的博客 2435

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

DeepSeek-R1 + RAG搭建本地知识库

*为确保本地知识库的高效搭建,需先准备DeepSeek-R1模型、相关文档/数据集及部署工具(如Ollama),,同时选择并配置文本嵌入模型,最后收集/整理文档并确保其唯一标识符和文本内容,************?****大型语言模型(LLMs)虽然功能强大,。********如何使用DeepSeek-R1 + RAG搭建本地知识库?******

m0_70486148的博客 2453

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

DeepSeek-R1 + RAG搭建本地知识库,收藏这一篇就够了!!

利用DeepSeek-R1与RAG(Retrieval-Augmented Generation,检索增强生成)技术可以快速搭建本地知识库。 为确保本地知识库的高效搭建,需先准备DeepSeek-R1模型、相关文档/数据集及部署工具(如Ollama), 随后安装Ollama并部署DeepSeek-R1 ,同时选择并配置文本嵌入模型,最后收集/整理文档并确保其唯一标识符和文本内容, 利用文本嵌入模型转换文档为向量以构建快速检索的索引。

Gaga246的博客 2472
上一篇: Neo4j + LangChain:如何构建基于知识图谱的最强RAG系统?看完这一篇你就懂了!!
下一篇: 99%开发者不知道的细节:一文读懂DeepSeek R1训练过程!
Agent学习路线
博客等级 码龄6年 1万+粉丝 1909原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值