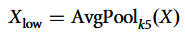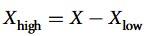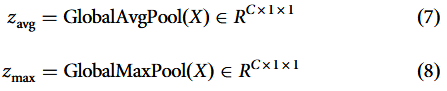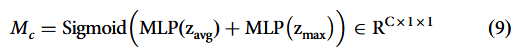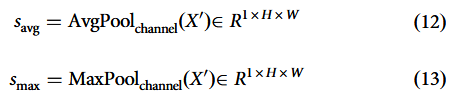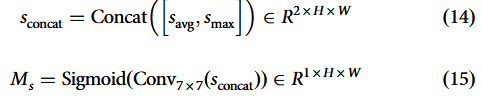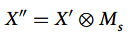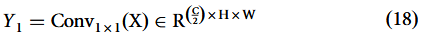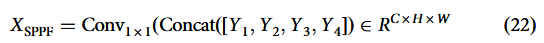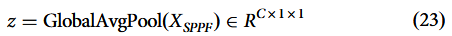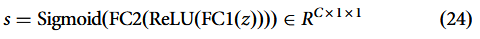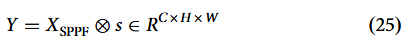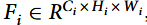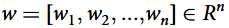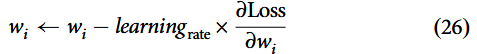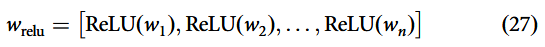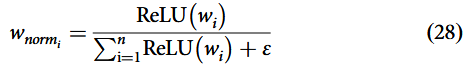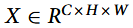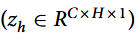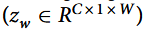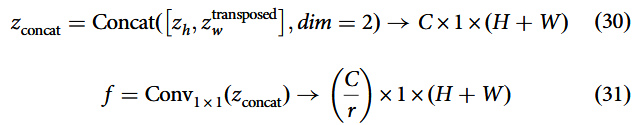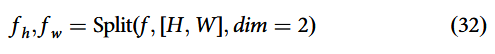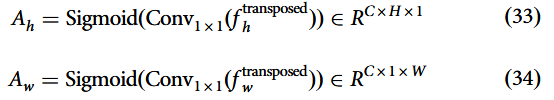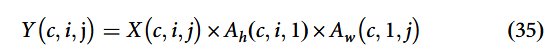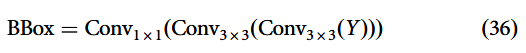Prism-OBI: a novel framework for OBI recognition via visual perception and and feature decoupling

转载:YOLOv8改进全新Inner-IoU损失函数:扩展到其他SIoU、CIoU等主流损失函数,带辅助边界框的损失 目标检测是计算机视觉中的基本任务,包括目标分类和定位。边界框回归损失函数是检测器定位分支的重要组成部分,检测器的定位精度在很大程度上取决于边界框回归,在当前的检测器中发挥着不可替代的作用。在BBR中,IoU损失可以准确描述预测边界框与GT框之间匹配的程度,确保模型在训练过程中可以学习到目标的位置信息。作为现有主流边界框回归损失函数的基本部分,IoU定义如下:B和分别代表预测框和GT框。定义IoU之后,相应的损失可以定义如下:至今,基于IoU的损失函数逐渐成为主流并占据主导地位。 阅读详情

论文链接:https://www.nature.com/articles/s40494-026-02493-9

拜读了这篇论文,感悟良多!我们也做过类似的工作,但是没有形成文字记录,没有进行方法的创新和深挖,没有形成成果,追悔莫及。

一、研究背景与挑战

  • 甲骨文的重要性:是中国已知最早的文字系统,对研究古代历史、文化、社会活动具有极高价值。

  • 识别难点:

    • 拓片存在严重退化:笔画模糊、背景裂纹、地质噪声。

    • 字形多变、结构复杂,与现代汉字差异大。

    • 传统OCR和端到端深度学习模型难以区分“语义笔画”与“背景噪声”。


二、核心创新:Prism-OBI 框架

Prism-OBI 是一个两阶段、解耦式框架,将“空间定位”与“语义分类”显式分离。
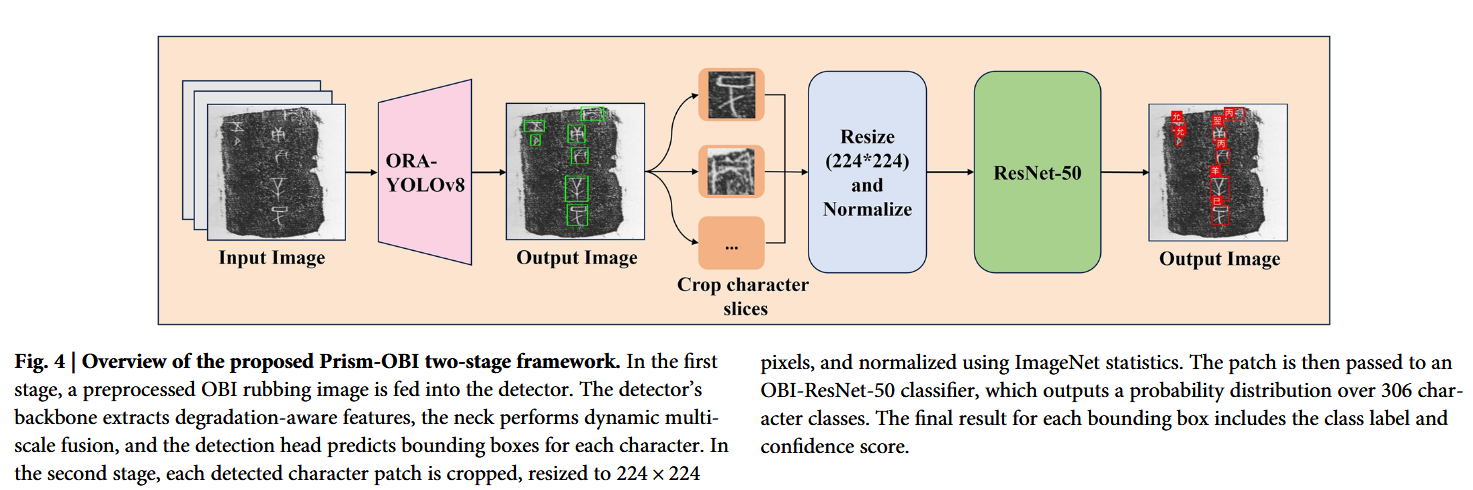
阶段一:检测器 OBI-YOLOv8(负责定位)
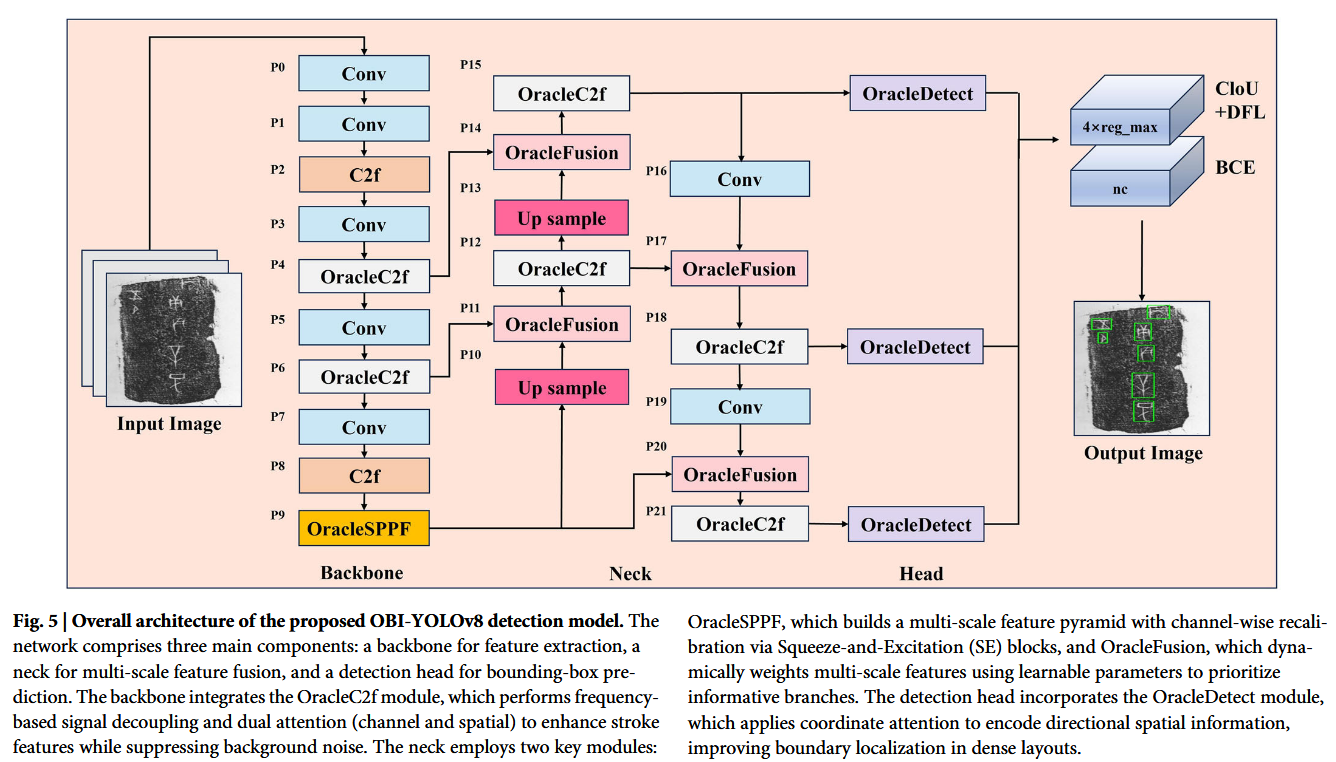
在YOLOv8基础上,集成了四个定制模块:

模块功能
OracleC2f信号解耦:将高频(笔画边缘)与低频(整体结构)分离,结合通道-空间双注意力机制,增强笔画特征、抑制背景噪声。
OracleSPPF多尺度特征提取 + SE通道注意力,适应字符尺寸剧烈变化(20×20 到 100+×100+)。
OracleFusion自适应加权融合多尺度特征,提升信噪比,防止低质量分支干扰。
OracleDetect引入坐标注意力(Coordinate Attention),显式编码方向与空间位置信息,解决密集布局下的边界混淆问题。

2.1 OracleC2f 模块 —— 信号解耦与语义增强

解决的问题:原始 YOLOv8 的 C2f 模块对甲骨文拓片进行无差别特征处理,无法区分语义笔画(如文字)和背景噪声(如龟甲裂纹),导致特征提取被干扰。

核心创新:信号解耦 + 双注意力机制
  1. 频率分解

    • 通过 5×5 平均池化提取低频分量(保留字符整体轮廓)。

    • 通过残差连接得到高频分量(包含笔画边缘、纹理细节)。

    • 这样将字符结构与细节分离,分别输入后续注意力模块。

  2. 级联双注意力(应该源自CBAM)

    • 通道注意力:使用全局平均池化和全局最大池化并行生成通道描述符。再通过共享 MLP 生成通道权重,增强关键特征通道(如笔画通道),抑制无关通道。

    • 空间注意力:沿通道维度进行平均/最大池化,得到空间特征图,再通过 7×7 卷积生成空间权重图,聚焦字符区域,抑制裂纹等背景噪声。

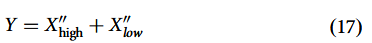
  3. 特征重组
    将增强后的高频细节和低频结构相加,得到同时包含精细笔画和完整结构的输出特征。
效果:

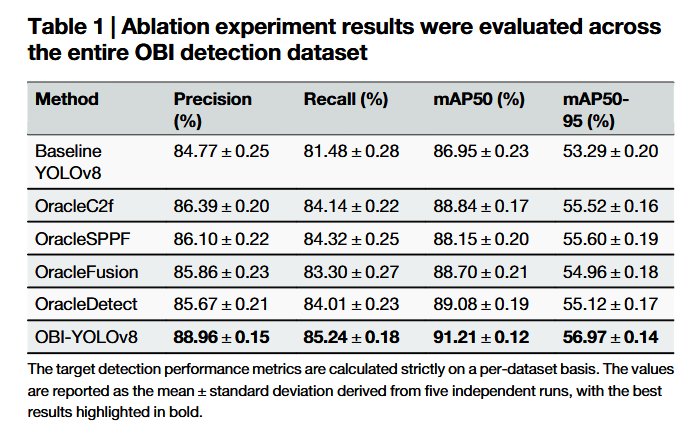
  • 精度提升 1.62%,mAP50-95 提升 2.23%,召回率提升 2.66%。

  • 有效提取模糊或复杂笔画的字符特征。


2.2 OracleSPPF 模块 —— 动态尺度自适应

解决的问题:原始 SPPF 对所有特征通道和尺度一视同仁,无法根据通道重要性加权,且对极端尺度变化(20×20 到 100+×100+ 像素,OBI长尾现象和image尺寸差异非常大)适应能力弱。

核心创新:多尺度金字塔 + SE 通道注意力
  1. 标准 SPPF 多尺度提取

    • 输入通道的1/2 经 1×1 卷积降维(减少计算量)。

    • 串联三次 5×5 最大池化,得到四个不同等效感受野的特征图:Y1​(原始细节)、Y2(等价~5×5)、Y3(等价~9×9)、Y4(等价~13×13)。
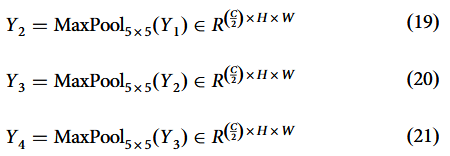
    • 拼接后通过 1×1 卷积恢复通道数,得到融合多尺度特征 ​。

  2. SE 通道注意力

    • 对X_{SPPF}进行全局平均池化,得到每个通道的全局响应描述符 z。

    • 通过两层全连接网络(先降维后升维)学习通道间的非线性依赖,生成权重 s。

    • 将权重 s乘回 X_{SPPF}​,实现通道重标定:增强关键尺度/结构的通道,抑制冗余信息。

效果:

  • 召回率提升 2.84%,mAP50-95 提升 2.31%。

  • 对不同大小、密集分布、边界模糊的字符检测更鲁棒。


2.3 OracleFusion 模块 —— 自适应加权特征融合

解决的问题:原始 YOLOv8 使用静态拼接进行多尺度特征融合,无法反映不同分支的质量差异,易受低质量或噪声分支干扰,稀释有效信息。

核心创新:可学习的加权融合
  1. 可学习权重
    为每个输入特征分支 F_{i} 分配一个可训练的标量权重 \omega _{i},通过梯度下降更新。

  2. 权重归一化

    • 使用 ReLU 保证权重非负。

    • 通过 使所有权重之和为 1,引入竞争机制。where ε is a small constant to prevent division by zero。

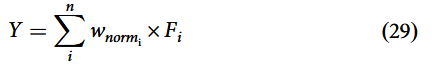
  3. 加权求和
    ,网络自适应学习各分支的重要性。

效果

  • 精度提升 1.09%,mAP50 提升 1.75%,mAP50-95 提升 1.67%。

  • 对小目标分支自动提高权重,对噪声分支抑制权重,提高融合特征的信号噪声比。


2.4 OracleDetect 模块 —— 显式空间编码

解决的问题:原始 YOLOv8 检测头使用位置无关卷积,忽略空间位置信息,导致:

  • 无法区分拓片中央主文字与边缘辅助文字;

  • 密集排列时字符边界混淆;

  • 对极端长宽比字符的定位不准确。

核心创新:坐标注意力(Coordinate Attention)
  1. 方向感知编码

    • 将输入特征 X 沿水平方向进行 1D 全局池化,得到 。

    • 沿垂直方向进行 1D 全局池化,得到 。

    • 这保留了精确的位置信息,不同于全局池化完全丢失空间结构。

  2. 交互与分离

    • 拼接z_{h}与转置后的z_{w}​,经 1×1 卷积降维(通道缩减 r 倍)。

    • 再分离回f_{h} 和 f_{w},分别通过 1×1 卷积恢复通道数,经 Sigmoid 生成水平注意力 A_{h}​ 和垂直注意力A_{w}​。

  3. 双方向调制

    两个方向注意力同时作用,增强对水平/垂直笔画边界的敏感度。

  4. 预测
    增强后的特征 Y 输入分类和回归分支(3×3 + 3×3 + 1×1 卷积),输出边界框和类别。

效果

  • mAP50 提升 2.13%。

  • 显著改善密集布局下的边界区分能力,对复杂背景中的真实目标定位更准。


整体协同效应

当四个模块集成使用时(OBI-YOLOv8),性能提升超过各自单独贡献之和:

  • 精度提升 4.19%,召回率提升 3.76%,mAP50 提升 4.26%,mAP50-95 提升 3.68%。

协同原理:

  1. OracleC2f 从源头分离笔画与噪声,为后续模块提供干净特征。

  2. OracleSPPF 建立多尺度金字塔,并通过通道重标定增强关键尺度。

  3. OracleFusion 动态加权融合不同分支,保证高信噪比。

  4. OracleDetect 在检测头注入空间坐标信息,实现精准边界回归。

这四者形成了从特征提取 → 多尺度融合 → 自适应加权 → 空间感知定位的完整退化感知流水线,有效解决了甲骨文识别的核心瓶颈。

2.5 检测总结表

模块原始问题核心机制主要效果
OracleC2f无法区分笔画与噪声频率分解 + 通道/空间双注意力增强笔画特征,抑制裂纹
OracleSPPF多尺度处理僵化SPPF + SE 通道注意力动态适应尺度变化
OracleFusion静态拼接,易受噪声分支干扰可学习加权融合自适应平衡多分支贡献
OracleDetect忽略空间位置信息坐标注意力(水平+垂直编码)精确边界定位,解决密集混淆

阶段二:分类器 OBI-ResNet(负责识别)

  • 使用 ResNet-50 对裁剪出的单字图像进行分类(306类)。

  • 输入尺寸:224×224,经ImageNet统计归一化。

  • 输出:字符类别 + 置信度。


三、数据集与预处理

  • OBI检测数据集OBCD:带标注的拓片图像,用于训练检测器。

  • OBC306数据集:309,551张单字图像,306个类别,用于训练分类器。

  • 预处理流程:

    1. CLAHE(对比度受限自适应直方图均衡):增强局部对比度。

    2. 中值滤波(3×3):去除椒盐噪声和随机点噪声,保留笔画边缘。


四、实验结果

1. 消融实验(检测任务)

方法Precision (%)Recall (%)mAP50 (%)mAP50-95 (%)
基线YOLOv884.7781.4886.9553.29
OBI-YOLOv8(完整)88.9685.2491.2156.97
  • 所有模块组合后性能提升显著,超过各自单独贡献之和,说明协同效果好。

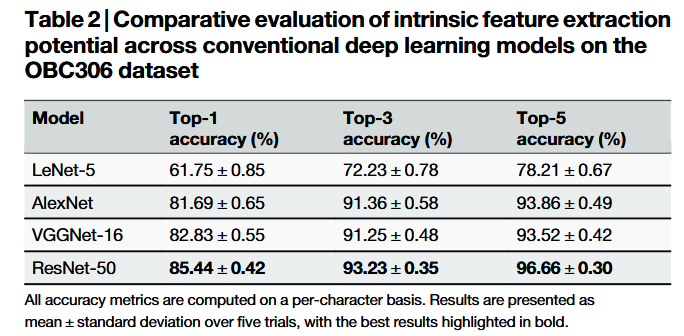
2. 分类器对比(OBC306数据集)

模型Top-1 (%)Top-3 (%)Top-5 (%)
LeNet-561.7572.2378.21
AlexNet81.6991.3693.86
VGGNet-1682.8391.2593.52
ResNet-5085.4493.2396.66
  • ResNet-50 因其残差结构和跨层特征复用能力,最适合细粒度甲骨文分类。

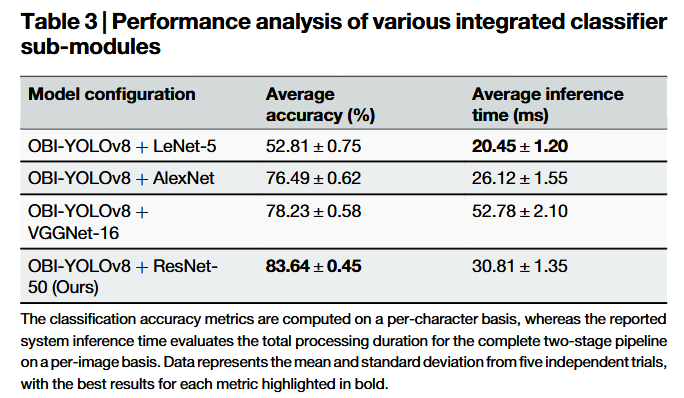
3. 两阶段完整系统对比

配置平均准确率 (%)推理时间 (ms/图)
+ LeNet-552.8120.45
+ AlexNet76.4926.12
+ VGGNet-1678.2352.78
+ ResNet-5083.6430.81
  • 达到约32 FPS,满足实时处理需求。

  • 准确率略低于纯分类器(85.44%),是因为检测阶段引入的微小定位误差。


五、跨域泛化实验(零样本)

  • 直接应用于青铜器铭文、石鼓文、古代印章、秦石权文字等未见过的历史文档。

  • 结果:

    • 能有效定位大部分字符候选区域。

    • 但对结构松散的字(如左右结构)可能分裂为多个框。

  • 表明该框架可作为通用笔画提取器,对拓扑结构差异大的文字需微调。


六、主要贡献

  1. 提出解耦范式:将视觉感知(去噪+定位)与语义分类显式分离,解决端到端模型的定位-分类权衡问题。

  2. 设计专用视觉感知模块:针对古代拓片的退化特征,提出OracleC2f、OracleSPPF、OracleFusion、OracleDetect。

  3. 模块化与可迁移性:检测器可作为通用笔画提取器,分类器可替换为更先进的网络,适用于多种历史文档。

  4. 实验充分:包括消融、对比、跨域、效率分析,结果稳健。


七、局限性 & 未来方向

  • 局限性:

    • 对松散结构或极简拓扑的字仍可能错分或分割错误。

    • 极端退化场景下仍存在噪声残留。

    • 依赖有限标注数据,跨域泛化需微调。

  • 未来方向:

    • 引入图神经网络(GNN) 捕捉字符的结构不变性。

    • 使用自监督学习(如掩码图像建模) 从海量未标注历史档案中学习鲁棒表示。


八、个人评价

这是一篇工程与考古深度融合的高质量论文,具有以下亮点:

  • 问题定义清晰:直指甲骨文识别的核心瓶颈(噪声 vs 笔画)。

  • 方法设计系统:不是堆砌模块,而是围绕“解耦”思想构建完整感知系统。

  • 实验设计严谨:消融、对比、跨域、效率分析齐全,结果可复现。

  • 可迁移性强:框架不仅适用于甲骨文,也为其他古代文字识别提供了通用技术路径。

windows环境下anaconda+tensorflow+pycharm安装和配置过程 参考博文: 1、windows环境下tensorflow安装过程详解https://blog.youkuaiyun.com/laobai1015/article/details/84580243 我的私有博客anaconda+python安装过程 因为涉及到破*一直没通过 2、清华镜像网站:https://mirrors.tuna.tsinghua.edu.cn/tensorflow/windows/cpu/ 3、Tensorflow在win10下的安装(CPU版本)https://www.cnblogs... 阅读详情

相关推荐

Plot3d 网格数据格式

PLOT3D是一个计算机图形程序,旨在可视化计算流体力学的网格和解决方案。PLOT3D文件可以是ASCII, 也可是Fortran unformatted 或 C binary形式。PLOT3D文件分为网格文件(XYZ 文件), 空气动力学结果文件 (Q 文件)和通用结果文件(函数文件 + 函数名称文件)。网格文件中可加入所谓的IBlank参数。

weixin_62592231的博客 3720

Gabor滤波学习总结(资料来源网络)

matlab学习:图像频域分析之Gabor滤波   来源一 gabor详解 Gabor变换是D.Gabor 1946年提出的。为了由信号的Fourier变换提取局部信息,引入了时间局部化的窗函数,得到了窗口Fourier变换。由于窗口Fourier变换只依赖于部分时间的信号,所以,现在窗口Fourier变换又称为短时Fourier变换,这个变换又称为Gabor变换。  Gabor优点 G

wuling129的专栏 5549

CCF CSP历年题解(python)

菜鸡一枚,没参加过算法竞赛,单纯为了抵研究生考试复试才刷题,通过写博客记录下来,希望能和大家互相交流,代码质量不高,大家见谅。 因为考研等原因,题目不定期更新… 第一题 201312-1出现最多次数的数 ...

weixin_44690402的博客 5004

Improving Few-Shot Part Segmentation using Coarse Supervision学习笔记

1、摘要 鉴于部件分割中训练网络详细标注的开销巨大瓶颈问题,论文提出一个可利用诸如图像背景Mask、关键点位置信息等易获得的粗粒度标签信息的框架,借此优化部件分割模型。框架面临的第一个挑战是粗粒度标记来自不同的任务并且具有不同的标记类型,很难直接映射到部首标记。为此,我们提出联合训练部首分割模型和粗粒度标记类型,深度学习他们之间的依赖关系,从而可以利用现有的粗粒度信息。为了评估方法的优劣,我们在加州理工大学UCSD鸟类和OID飞机数据集上开发了一个基准。实验证明我们的方法优于基于多任务学习、半监督...

wuling129的专栏 3392

ACL访问控制列表详解:原理、配置与应用

如果发现ACL规则没有达到预期效果,需要检查ACL规则配置是否正确,是否在正确的接口和方向上应用,以及规则顺序是否合理(ACL规则按顺序匹配,匹配到即停止)。其中,rule-id是规则的编号,用于确定规则的匹配顺序;例如,应该先配置针对特定主机和特定端口的规则,再配置针对整个网段的规则,最后配置允许所有流量的规则,这样才能确保ACL按照预期工作,避免因规则顺序不当导致的访问控制失效。例如,应该先配置针对特定主机的规则,再配置针对整个网段的规则,最后配置允许所有流量的规则,这样才能确保ACL按照预期工作。

彭大帅的博客 1045

WPS Office JS宏实现文件和数据的上传及下载

WPS Office JS宏下载、上传文件;通过加载项实现数据的获取和上传。

学点笔记 4298

转载:DAS: A Deformable Attention to Capture Salient Information in CNNs解读

卷积神经网络(CNNs)在局部空间模式识别方面表现出色。对于许多视觉任务,如物体识别和分割,显著信息也存在于CNN核边界之外。然而,由于CNN的受限制的感受野,它们在捕获这种相关信息时感到力不从心。自注意力机制可以提高模型获取全局信息的能力,但同时也增加了计算开销。作者提出了一种快速简单的全卷积方法DAS,它有助于将注意力集中在相关信息上。该方法使用了可变形卷积来表示相关图像区域的位置,并使用了可分卷积来实现效率。DAS可以插入到现有的CNN中,并使用门控机制传播相关信息。

wuling129的专栏 3070

R语言中的summarise函数和mutate函数用于计算分组占比。下面是关于这两个函数的详细介绍以及相应的源代码示例:

R语言中的summarise函数和mutate函数用于计算分组占比。

CodeByte的博客 1180

Sigmoid 函数

Sigmoid 函数: ​ 求导详细过程参考博文:Sigmoid 函数的求导过程 是 (,)到[0,1]的映射,通常用来进行概率分布运算。 其他 Sigmoid 函数:

wuling129的专栏 2163

YOLOv8 交通流量监测详解

本文介绍了一个基于YOLOv8的交通流量监测系统,该系统通过深度学习技术实现车辆实时检测、跟踪和分类。系统核心功能包括:1)使用YOLOv8模型检测道路车辆并进行持续跟踪;2)按方向和车型统计车流量;3)支持多区域流量监测和数据可视化。文章提供了完整的代码实现示例,涵盖基础车辆检测、视频流处理和高级数据分析功能。系统还可进一步优化性能,如使用轻量级模型、GPU加速等,并建议扩展车速估算、密度分析等功能。该方案为交通管理提供了有效的实时监测和决策支持工具。

u010117029的博客 345

Agentic-Desktop-Pet:构建本地智能桌面助手的架构与实践

智能体(Agent)作为人工智能领域的重要概念,是指能够感知环境、自主决策并执行任务以实现目标的软件实体。其核心原理在于结合感知、决策与执行模块,通过大语言模型(LLM)等推理引擎处理信息并驱动行动。这种架构的技术价值在于将AI的认知能力与具体的操作系统环境深度融合,从而创造出能主动理解用户上下文、提供个性化服务的智能伙伴。在应用场景上,智能体技术正从云端对话机器人向本地化、场景化的桌面助手演进,旨在解决传统自动化工具缺乏智能、而纯聊天机器人脱离操作环境的问题。本文探讨的Agentic-Desktop-Pe

weixin_27210125的博客 621

论文解读:Splicing ViT Features for Semantic Appearance Transfer

Splicing ViT Features for Semantic Appearance Transfer论文解读

wuling129的专栏 1917

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

转载:卷积神经网络结构组成与解释

卷积神经网络结构组成与解释

wuling129的专栏 1795

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Semi-Supervised Semantic Image Segmentation with Self-correcting Networks基于自校正网络的半监督图像语义分割

本文参考了: https://blog.youkuaiyun.com/NCEPUDJ/article/details/105118699 https://blog.youkuaiyun.com/Cloris_Sue/article/details/105099992 有些翻译的部分直接照搬,在此表示感谢。 Abstract 建立一个大型的具有高质量的对象masks图像数据集来进行语义分割是非常昂贵和耗时的。 在本文中,介绍了一种有原则的半监督框架,该框架的训练数据是:一个小型的全监督数据集(具有语义分割标签和检..

wuling129的专栏 1763

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

YOLOv13: Real-Time Object Detection withHypergraph-Enhanced Adaptive Visual Perception解读

YOLOv13:基于超图增强的实时目标检测新突破 摘要: YOLOv13针对现有目标检测模型在复杂场景下的性能瓶颈,提出三项创新:1)引入HyperACE机制,通过自适应超图结构动态建模多顶点高阶视觉相关性,突破传统手工阈值设定的局限;2)设计FullPAD范式,实现全流程特征聚合与分发,提升跨尺度特征融合能力;3)采用深度可分离卷积等轻量化设计,在保持性能的同时显著降低计算复杂度。实验表明,YOLOv13在MSCOCO数据集上较前代模型提升0.4%-1.5%的mAP,Tesla T4 GPU上推理延迟低于

wuling129的专栏 1575

SCOPS: Self-Supervised Co-Part Segmentation学习

论文作者博文讲解:图像分块分割 参考博文:论文学习 SCOPS: Self-Supervised Co-Part Segmentation 论文代码:https://github.com/marcelomata/SCOPS 1、问题描述 提出问题 •分块提供了对象的良好中间表示,该表示对于摄影机、姿势和外观变化而言是稳健的。 •现有的分块分割方法大多采用有监督的方法,这些方法依赖于大量的人工标注,不能推广到不可见的对象类别。 本文方案 •本文提出了一种自监督的分块分割深度学习方法。 •该方

wuling129的专栏 1434

Pixel-Adaptive Convolutional Neural Networks论文阅读

Pixel-Adaptive Convolutional Neural Networks CODE:https://suhangpro.github.io/pac/ 基础部分: 1、双边滤波算法 高斯滤波是以距离为权重,设计滤波模板作为滤波系数,只考虑了像素间的空间位置上的关系,因此滤波的结果会丢失边缘的信息。在高斯基础上,进一步优化,叠加了像素值的考虑,因此也就引出了双边滤波,一种非线性滤波,滤波效果对保留边缘更有效。 2、CNN步长卷积计算公式和strided convolution 3、双边滤波思想在

wuling129的专栏 1380

timm 库介绍

PyTorchImageModels,简称 timm,是一个巨大的 PyTorch 代码集合,旨在将各种 SOTA 模型整合在一起,并具有复现 ImageNet 训练结果的能力。虽然模型架构是 timm 的重点,但它还包括许多数据增强 (data augmentations)、正则化技术 (regularization techniques)、优化器 (optimizers) 和学习率策略 (learning rate schedulers) 的实现。

wuling129的专栏 1335

Investigating the effectiveness of data augmentation from similarity and diversity: An empirical stu

数据扩充已成为一种广泛采用的技术,用于提高深度神经网络的泛化能力。然而,仅基于模型训练来评估数据增强方法的有效性在计算上要求很高,并且缺乏可解释性。此外,缺乏定量标准阻碍了我们对数据增强方法的潜在机制和新技术的发展的理解。。所提出的相似性度量描述了原始数据集和增强数据集之间的总体相似性,而多样性度量则根据类别量化了原始数据集中和增强数据集中固有复杂性的差异。重要的是,我们提出的措施与模型训练无关,确保了计算的效率。

wuling129的专栏 1324

YOLOv10解析

摘要:清华大学团队2024年提出的YOLOv10是YOLOv9后的最新实时目标检测模型,具有多项创新:1)首创NMS-Free架构,通过一致性双重分配训练策略实现端到端检测;2)优化模型设计,包括轻量级分类头、空间-通道解耦下采样和等级引导块;3)引入大核卷积和部分自注意力模块增强特征提取;4)改进模型缩放策略。实验表明,相比传统YOLO,YOLOv10在保持实时性的同时显著提升了精度,参数量减少35%,计算量降低46%。该研究为实时目标检测提供了新的技术方向。

wuling129的专栏 1218

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 267

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 1万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 216

在Codex 让AI模型 拥有长期智能记忆

本文介绍Claude-Mem V15新功能——智能记忆召回,解决AI遗忘、重复提示、执行不一致等问题。通过本地部署claude-mem,实现自动记录决策(如数据库选型)、跨会话智能召回,支持记忆写入、检索、遗忘全流程闭环。相比传统记忆方案,其基于Hooks自动捕获工具调用,结构化存储,可追溯、可共享、可清理,显著提升工程效率与协作一致性,是长期项目中理想的“工作黑匣子”与“工程脑”。

米莱虾 249

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 187
上一篇: 解读:OracleNet: enhancing OBS recognition with Adaptive Deformation and Texture-Structure Decoupling
下一篇: [转载]用UMAP进行特征可视化
wuling129
博客等级 码龄23年 486粉丝 263原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值