英特尔年底推AI芯片,内存散热成本低,欲扭转命运挑战英伟达、AMD!

后摩尔时代芯片设计:Chiplet与AI芯片的架构革命 在摩尔定律趋缓的背景下,半导体产业正经历从单一制程微缩向系统级创新的范式转变。其核心原理在于通过架构创新来持续提升算力,技术价值体现在显著优化成本、良率与能效。当前,Chiplet(芯粒)技术通过先进封装将大芯片分解为模块化单元,实现了工艺灵活性与设计复用;而AI芯片则针对机器学习负载进行专用架构设计,如支持稀疏计算与BFLOAT16数据格式。这些技术广泛应用于数据中心AI训练、自动驾驶及边缘推理等场景,共同推动着以异构集成和开放生态为特征的下一代计算平台发展。 阅读详情

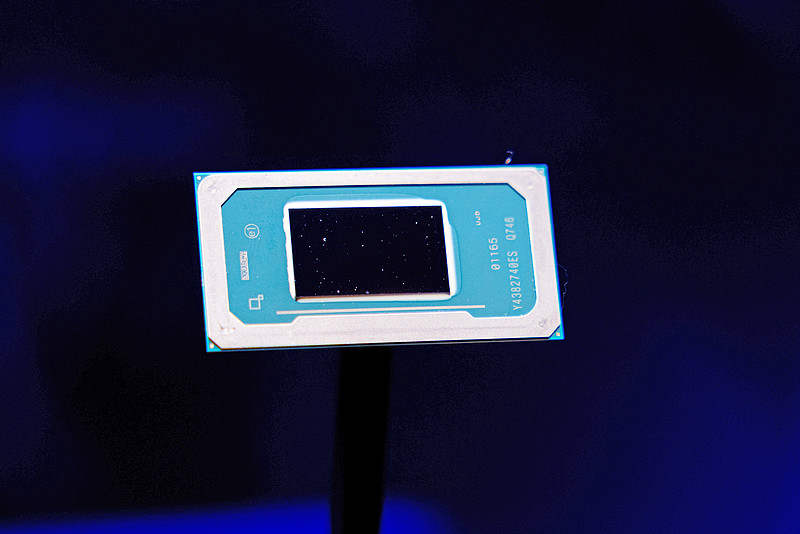
【导语:英特尔计划在今年年底前推出一款AI芯片“新月岛”,采用的内存和散热技术比竞品更具成本优势,试图借此扭转命运,挑战英伟达和AMD等竞争对手。】


序号1

英特尔发力AI芯片,欲扭转自身命运

英特尔正试图在蓬勃发展的AI半导体市场挑战竞争对手,数据中心部门负责人凯沃尔克·凯奇奇安表示公司正“从基础做起”。英特尔首席执行官陈立武领导下首次进军利润丰厚的AI基础设施市场,此前因外界担忧帕特·基辛格的扭亏战略失败,他被罢免,陈立武随后接任。

序号2

“新月岛”聚焦推理任务,避开训练市场

英特尔新推出的“新月岛”图形处理器(GPU)旨在加速“推理”任务,即用户提出请求的阶段,而非模型训练阶段。在模型训练领域,英伟达的处理器占据主导地位,英特尔此前尝试推出用于AI模型训练的“高迪”GPU,销售情况不佳,原计划的后续产品也于去年取消。

序号3

内存散热技术具成本优势

英特尔希望利用英伟达和AMD面临的限制因素,“新月岛”是一款风冷芯片,采用LPDDR5内存,这是一种比英伟达“布莱克威尔”等芯片中使用的高带宽内存(HBM)便宜得多的内存类型,在内存和散热技术方面比竞品更具成本优势。

编辑观点:英特尔推出“新月岛”芯片是其在AI领域的重要尝试,成本优势或助其在推理任务市场分得一杯羹,但在英伟达主导的训练市场仍面临挑战。

别只看游戏卡了!聊聊英伟达Tesla、AMD Instinct和英特尔数据中心GPU,它们才是AI算力的幕后主角 本文深入解析了英伟达Tesla、AMD Instinct和英特尔数据中心GPU在AI算力领域的技术优势与应用场景。通过对比三巨头的架构设计、软件生态和实际性能,揭示了专业级GPU如何成为AI计算的幕后主角,为开发者提供采购决策的关键参考。 阅读详情

相关推荐

AI芯片核心技术解析:从并行架构到应用实践

并行计算作为现代计算架构的核心概念,通过同时执行多个计算任务大幅提升处理效率。其技术原理基于分布式计算单元协同工作,特别适合处理矩阵运算等密集型计算任务。在人工智能领域,这种架构展现出巨大技术价值,能够将大型语言模型的训练时间从数月缩短到数天。AI芯片作为并行计算的硬件载体,通过GPU、NPU等专用处理器在自动驾驶、大语言模型训练等场景实现高效计算。随着ChatGPT等应用的普及,AI芯片的并行处理能力和能效比优化成为支撑AI技术落地的关键因素。本文深入探讨AI芯片的技术特性及其在实际工程中的应用实践。

weixin_34416754的博客 537

英伟达、英特尔和AMD芯片同台竞技:CES 2026各自都展示了怎样的实力

黄仁勋在CES 2026上带来的是基于全新计算哲学的Rubin计算平台。游戏显卡的单点硬件思维已经靠边站,极端协同设计为AI而生正当时。在这种设计理念下,整个服务器机架不再是零部件的堆叠,而是被视作一台独立的超级电脑来设计。为了实现这一目标,英伟达一口气发布了六款核心芯片,每一款都针对AI工厂的需求进行了极致优化。这六款芯片的核心是Rubin GPU。作为Blackwell架构的继任者,Rubin GPU集成了3360亿个晶体管,相比Blackwell的2080亿个晶体管有了质的飞跃。

SuaniCommunity的博客 1729

GWAS与eQTL相结合,进一步筛选疾病相关基因

欢迎关注”生信修炼手册”!在GWAS分析结果中,大部分显著的SNP位点都位于非编码区,很难直接挖掘这些位点的调控机制。通常假设与疾病关联的SNP位点通过调控基因表达来发挥作用,而eQTL...

庐州月光的博客 1万+

三大巨头GPU产品对比解析:英伟达、AMD与英特尔的市场布局与优势盘点

**GeForce系列**:性能卓越,产品线丰富,兼容DirectX和OpenGL,适合游戏和图形处理。- **Jetson系列**和**DGX系列**针对特定领域提供高度整合的解决方案,满足AI和边缘计算需求。- **Quadro系列**:专业级GPU,适用于商业和专业应用,如图形设计、视频编辑、3D建模。- **Quadro系列**:专业级性能,广泛应用,驱动和软件支持完善,提供更高精度和稳定性。- **Tesla系列**:强大的计算能力,高效的内存带宽,灵活扩展,适合HPC和大数据分析。

存储随笔 7802

从驱动编译到数据传输:RK3588与FPGA的PCIe通信实战解析

本文详细解析了RK3588与FPGA通过PCIe通信的实战过程,涵盖驱动编译、数据传输及性能优化等关键步骤。通过XDMA驱动实现高效DMA传输,适用于视频处理、数据采集等高性能场景,帮助开发者快速掌握嵌入式系统中的PCIe通信技术。

weixin_29214691的博客 528

永不消逝的电波 -GSM空口信号的接收与解码

一开始接触软件无线电应该是从很早之前对RFID洗衣卡的解密开始的,后来接触人员定位,慢慢的打开了这样一扇大门。。。。 翻到之前做的GSM信号的接收解码,今天就对其过程做一个记录,也不是什么新颖的内容,权当是记录和回忆了。 对于GSM网络的相关内容,不是非常的熟悉,如有不正确的,欢迎批评指正。

Jack.Xu 专栏 1万+

2020人工智能Ai芯片前言解读

芯片的概念:(半导体元件产品的统称)集成电路,缩写作 IC;或称微电路、微芯片、晶片/芯片,在电子学中是一种把电路(主要包括半导体设备,也包括被动组件等)小型化的方式,并时常制造在半导体晶圆表面上。 专业地讲就是:将电路制造在半导体芯片表面上的集成电路又称薄膜(thin-film)集成电路。另有一种厚膜(thick-film)集成电路(hybrid integrated circuit)是由独立...

wsq_zqfl的博客 3058

中国大学MOOC-翁恺-C语言程序设计习题集-解答汇总

中国大学MOOC-翁恺-C语言程序设计习题集 PAT 习题集 02-0. 整数四则运算(10) 时间限制 400 ms 内存限制 65536 kB 代码长度限制 8000 B 判题程序 Standard 作者 乔林(清华大学) 本题要求编写程序,计算2个正整数的和、差、积、商并输出。题目保证输入和输出全部在整型范围内。 输入格式: 输入在一行中给出2...

weixin_30691871的博客 3万+

【人工智能】一篇文章读懂什么是“AI算力”!揭秘AI背后的超级引擎!

AI算力,即人工智能计算能力,是指执行人工智能算法所需的计算资源和处理能力。它是衡量计算设备或系统在处理AI任务时性能高低的关键指标。AI算力不仅取决于硬件设备的性能,如CPU、GPU等处理器的运算速度和内存容量,还涉及软件框架、算法优化等多个层面的因素。AI算力作为人工智能的核心驱动力,正在以惊人的速度推动着技术和行业的变革。从硬件设备到软件框架,从算法优化到算力基础设施,AI算力的每一个环节都在不断演进,为AI应用的广泛普及和深入发展提供了坚实的支持。

万物皆有灵 5961

RK3568平台YOLO11模型部署实战:从环境搭建、模型转换到板端性能优化全解析

摘要: 本文详细介绍了在RK3568平台上从零部署YOLO11模型的完整流程。主要内容包括:1) 基于Conda搭建Python 3.8开发环境并安装RKNN-Toolkit2工具链;2) 使用LabelImg工具标注数据并构建YOLO格式数据集;3) 基于Ultralytics框架进行YOLO11模型训练及参数优化;4) 实现PyTorch→ONNX→RKNN的完整模型转换链。文章特别针对RK3568平台的NPU特性提供了关键参数配置建议,并分享了实际开发中的经验总结,最终可达到30FPS的稳定推理性能。

LXY_LOVE36的博客 282

Juniper SRX PPPoE配置

set interfaces pp0 unit 1 ppp-options chap default-chap-secret 拨号用户名密码。set interfaces pp0 unit 0 ppp-options chap default-chap-secret 拨号密码。set interfaces pp0 unit 0 ppp-options chap local-name 拨号用户名。6号口接运营商进行拨号。

Jian Sun_的博客 753

人工智能英伟达越来越“大”的GPU

英伟达:让我们遇见越来越“大”的GPU

1273

光学测量仿真软件:Zygo_(5).Zygo的数据处理与分析方法

通过上述综合案例,我们可以看到Zygo中的数据处理与分析方法是如何一步一步应用于实际数据的。从数据导入到预处理,再到滤波、表面分析、缺陷检测和数据可视化,每一步都至关重要,最终确保了数据的准确性和可靠性。处理后的数据还可以导出为多种格式,便于在其他软件中进行进一步的处理或报告。希望这个案例能够帮助您更好地理解和应用Zygo中的数据处理与分析方法。

kkchenjj的博客 947

海力士研究3D堆叠内存破端侧AI瓶颈,英特尔、AMD经历或成手机厂商前车之鉴!

近日,海力士在美国挂出两个新岗位,欲研究“3D堆叠内存”设计,从封装层面解决端侧AI性能瓶颈,合作客户可能是苹果。而海力士的3D堆叠DRAM,是拆掉内存部分封装,让裸片压在处理器上,建立垂直数据通道。前两年英特尔在酷睿Ultra 200V系列将LPDDR5X内存塞进处理器封装,通道距离缩短,内存速度快、延迟短、功耗低,电脑内部更紧凑。AMD的X3D处理器将额外L3高速缓存叠在CPU核心上方,增加缓存,减少读取内存次数,提升游戏帧数和稳定性,但带来了散热问题,AMD基本无有效解决方案。

IT界那些事儿 26

手把手教你学 Simulink (1.3):探索Simulink模块库的奇妙世界

Simulink模块库按照功能分为多个类别,每个类别包含专门用于特定任务的模块。% 打开Simulink库浏览器% 或者以编程方式获取库列表disp('可用的库列表:');end常用模块(Simulink):最基础和最常用的模块信号处理模块(DSP System Toolbox):专业信号处理工具通信模块(Communications Toolbox):通信系统设计控制系统模块(Control System Toolbox):控制系统设计与分析% 创建自定义模块库。

QQ_778132974的博客 386

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

算力迭代提速!全球AI训练与推理芯片行业格局、机遇与趋势解析

综合行业技术、政策、市场走势,未来12-24个月AI芯片行业将呈现“更多推理、更强系统、更深垂直”的核心发展趋势,大模型参数规模化扩张不再是行业核心竞争方向,综合算力效率与场景落地能力成为核心胜负手。技术层面,FP4/FP8低精度推理、高速互联技术将持续优化单位功耗算力产出,HBM与先进封装仍是行业核心供给约束;产业层面,主权AI、行业专属AI工厂加速落地,市场采购模式从单一芯片采购转向整柜算力、散热供电、运维软件一体化采购;

2603_95348957的博客 199

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

AI芯片三大架构范式:编译器驱动、运行时重构与内存中心

AI芯片已超越单纯算力堆叠,进入架构哲学分野期。从确定性编译到动态硬件重构,再到内存-计算融合,本质是不同‘软硬契约’的技术实现:Gaudi3将编译逻辑固化进硬件,强调编译期优化与静态调度;Versal以FPGA为基座实现毫秒级运行时电路重构,支撑算法快速演进;MI300X则通过Chiplet与HBM3堆叠突破内存墙,转向内存中心编程模型。这些路径共同指向一个核心命题——AI加速效能不再取决于峰值TFLOPS,而取决于编译器、运行时系统与硬件原语的协同深度。当前开发者面临的真实挑战,正是在不同契约下重构代码

weixin_33904756的博客 359

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

AMD与英特尔处理器竞争:高核心数、AI加速与混合架构的技术演进

在处理器技术领域,多核架构与并行计算已成为现代计算的核心基础。其原理是通过将任务分解为多个线程,由多个处理核心同时执行,从而大幅提升计算效率。这一技术价值在于能够有效应对日益复杂的软件生态,如视频渲染、科学计算等重负载场景。随着AI应用普及和边缘计算兴起,处理器不仅需要通用计算核心,还需集成专用AI加速单元(如NPU)以优化本地AI推理。当前,AMD凭借小芯片(Chiplet)设计灵活堆叠核心,英特尔则通过混合架构(P-core+E-core)平衡性能与能效,双方在AI指令集(如AVX-512)、高并发处理

weixin_30727835的博客 426

# 英伟达AI实验室财经分析报告(2026)

第一季度营收指引780亿美元(±2%),预计毛利率维持74.9%-75.0%高位 Blackwell与Vera Rubin平台2027年前采购订单预期已从5000亿美元上调至1万亿美元 年度研发预算将突破200亿美元,持续巩固技术代际优势 供应链布局向美国、拉丁美洲拓展,提升供应链韧性 数据来源:英伟达2026财年财报、行业公开报告、券商分析资料(截至2026年4月) 你可以直接复制以上内容保存为.md文件使用,若需要调整报告结构、补充特定章节内容,随时可以告诉我。

[Blog][Domain] programb.blog.youkuaiyun.com 491

最高 512 个核心,Ampere最新服务器CPU登场,将集成AI加速!

目前,超大规模公司和云厂商都在设计他们自己的CPU和AI加速器,这让那些向这些公司销售计算引擎的厂商倍感压力,这些厂商包括英特尔、AMD和英伟达。同时,也包括ARM服务器芯片新贵Ampere公司,它正在CPU领域与这些公司竞争,而且很快也将加入AI处理器领域的竞争。目前的服务器CPU市场,“云巨头”占服务器收入的一半以上,...

weixin_33692177的博客 233

科技云报道:“存算一体”是大模型AI芯片的破局关键?

大算力下的新需求

科技云报道 1596

谷歌Frozen v2芯片放弃CoWoS转向片上SRAM,AI芯片技术路线生变

在AI芯片设计中,内存架构是决定性能的关键因素。传统上,CoWoS等先进封装技术通过整合HBM内存提供高带宽,但面临延迟和成本挑战。片上SRAM作为集成在处理器内部的高速缓存,以其极低延迟和高能效优势,正成为解决AI计算内存墙问题的新方向。这种技术通过优化数据局部性,显著提升推理场景的能效比,特别适合大模型部署需求。随着谷歌在Frozen v2芯片中采用片上SRAM方案,AI芯片行业可能迎来从追求峰值带宽向注重实际能效的技术转型,为边缘计算和云端推理服务带来新的优化空间。

weixin_42465332的博客 235

2025版AI服务器产业链全景:AI大模型领域从业人员必读指南!

当前国内外厂商加速布局大模型,同步带动算力需求爆发式增长,驱动AI服务器行业高景气。根据TrendForce数据,2023年AI服务器出货量近120万台,占据服务器总出货量的近9%,年增长达38.4%;预计2026年AI服务器出货量为237万台,占比达15%,2024-2026年复合年增长率约25.50%。价格方面,通用服务器价格一般为几千美金/台,而主流AI服务器价格多在10-15万美金/台,单价也呈现指数型提升。

2401_84495872的博客 2143

“存算一体”是大模型AI芯片的破局关键?

“编译墙”隐于二者之中,极短时间下的大量数据搬运使得编译器无法在静态可预测的情况下对算子、函数、程序或者网络做整体的优化,手动优化又消耗了大量时间。过去,凭借先进制程不断突破,这三座“大山”的弊病还能通过快速提升的算力来弥补。但一个残酷的现实是,过去数十年间,通过工艺制程的提升改善芯片算力问题的“老办法”正在逐步失效——摩尔定律正在走向物理极限,HBM、3D DRAM、更好的互联等传统“解法”也“治标不治本”,晶体管微缩越来越难,提升算力性能兼具降低功耗这条路越走越艰辛。

weixin_43769323的博客 1117

英伟达 GeForce RTX 5090 市场预测

据传闻,RTX 5090 显卡在图形技术上有重大飞跃。英伟达 GeForce RTX 5090 显卡作为预期的 RTX 5000 系列的一部分,一直是科技界相当大的猜测和期待的主题。一项由市场调研公司 GHI 进行的调查显示,超过 75% 的受访游戏玩家对 RTX 5090 表现出了高度的兴趣,特别是对 4K 游戏和光线追踪性能的提升。根据市场分析公司 MNO 的预测,RTX 5090 的发布时机可能会影响 RTX 4000 系列的销售,但预计新产品的推出将刺激市场需求,抵消任何短期的负面影响。

2401_84266183的博客 1366
上一篇: 佛罗里达州首诉 OpenAI:ChatGPT 被指多次协助犯罪,OpenAI 坚称无责
下一篇: OpenAI模型证伪80年数学猜想,AI与人类数学家将中期互补
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值