


StyleCLIP: Text-Driven Manipulation of StyleGAN Imagery
摘要
受StyleGAN在各种领域中生成高质量逼真的图像的能力的启发,许多新工作集中在理解如何使用StyleGAN的潜在空间来操作生成的和真实的图像。然而,发现语义上有意的潜在操作通常涉及人类对多个自由度的仔细检查,或者为每个所需操作的图像的注释集合。在这项工作中,我们探索利用最新引入的对比语言-图像预训练(CLIP)模型的功能,以便为StyleGAN图像的处理开发基于文本的界面,而无需进行此类人工操作。我们首先介绍一种优化方案,该方案利用基于CLIP的算了来修改输入潜在矢量,以响应用户提供的文本提示。接下来,我们描述一个潜在映射器,该映射器针对给定的输入图像推断文本知道的潜在操作步骤,从而实现更快更稳定的基于文本的操作。最后,我们提出了一种在StyleGAN样式空间中将文本提示映射到与输入无关的方向的方法,从而实现交互文本驱动的图像处理。广泛的结果和比较证明了我们方法的有效性。
介绍
生成对抗网络彻底改变了图像合成,最近基于样式的生成模式拥有一些迄今为止最逼真的合成图像。此外,已经证明StyleGAN的学习中间潜在空间具有求解特征,这使得利用预训练的模型对合成图像和真实图像执行各种图像处理。
利用StyleGAN的表达能力需要开发简单直观的界面,以便用户轻松的实现他们的意图。现在的语义控制发现方法要么涉及手动检查,大量带注释的数据,要么涉及预训练的分类器。通过沿一个潜在空间中的方向移动来执行后续操作。使用参数模型如StyleRig中的3DMM或StyleFlow中的训练归一化流。
因此,现有控件智能沿预设的语义方向进行图像操作,从而严重限制了用户的创造力和想象力。每当需要附加的、未映射的方向时,就需要进一步的人工操作和/或大量的注释数据。
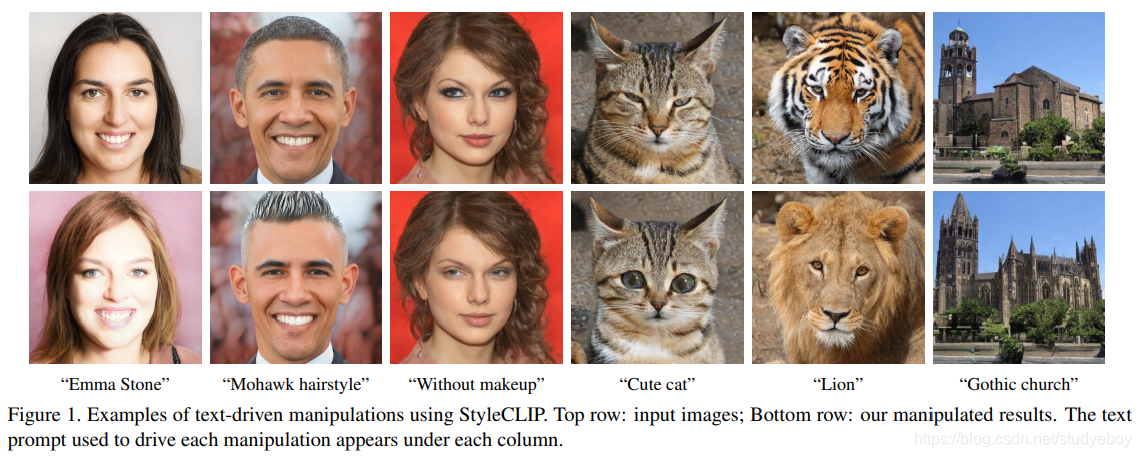
在这项工作中,我们将探索利用最新引入的对比语言-图像预训练(CLIP)模型的功能,以实现基于文本的直观语义图像操作,该操作不仅限于预设的操作方向,也不需要额外的人工来发现新空间。CLIP模型在从Web上获取的4亿个图像文本对上进行了预训练,并且由于自然语言能够表达更广泛的视觉概念,因此将CLIP与StyleGAN的生成功能相结合将为图像处理提供有趣的途径。图1显示使用我们的方法产生的独特操作的几个示例。具体而言,在本文中,我们研究了将CLIP与StyleGAN相结合的三种技术:
- 文本引导的潜在优化,其中CLIP模型用作损失网络。这是最通用的方法,但是需要几分钟的优化才能进行操作。
- 潜在残差映射器,针对特定的文本提示进行了训练,给定潜在空间中的起点(要处理的输入图像),映射器会在潜在空间中产生局部步长。
- 一种将文本提示映射到StyleGAN样式空间中的输入不可知(全局)方向的方法,可控制操纵强度和解开程度。
本文和补充材料中的结果展示了对人脸、动物、汽车和教堂图像的广泛语义操纵。这些操作的范围从抽象到特定,从广泛到细化。他们中的许多都没有通过以前的StyleGAN操作工作所证明,并且所有这些都是使用预先训练的StyleGAN和CLIP模型的组合很容易获得。
相关工作
视觉和语言
- 联合表示
多种工作学习跨模式的视觉和语言(VL)表示形式以完成各种任务,例如基于语言的图像检索,图像字幕和视觉问题解答。即BERT在各种语言任务中取得成功之后,最近的VL方法通常使用变换啦学习联合表示。一个基于对比语言-图像预训练的最新模型,学习了一种多模式嵌入空间,该空间可用于估计给定文本和图像之间的语义相似性。CLIP是在4一个文本图像对上进行训练的,这些文本图像对是从互联网上各种公开源收集的。CLIP所学的表示方法非常强大,可以对各种数据集进行最新的零镜头图像分类。可以参考OpenAI的Distill文章,其以广泛阐述和讨论CLIP所学的视觉概念。 - 文本引导的图像生成和处理
Reed等人的开拓性工作,通过训练条件GAN来处理文本引导的图像,条件GAN由从预训练的编码器获得的文本嵌入进行调节。张等人通过使用多尺度GAN改善了图像质量,AttnGAN在文本和图像特征之间纳入了一种注意力机制。其他工作中使用了额外的监督,以进一步提高图像质量。
一些研究集中在文本引导的图像处理上。一些方法使用基于GAN的编码器-解码器体系结构来解开输入图像和文本描述的语义。ManiGAN引入了一种新颖的文本-图像组合模块,可以产生高质量的图像。与上述工作不同,我们提出了一个单一框架,该框架将StyleGAN生成的高质量图像与CLIP所学的丰富的多域语义相结合。最近,DALL·E是GPT-3的120亿参数版本,其精度为16位,需要超过24GB的GPU内存,它在生成转换并将其应用于文本引导的图像时显示了多种功能。 相反,我们的方法甚至可以部署在单个商用GPU上。
与此同时TediGAN也使用StyleGAN进行文本引导的图像生成和操作。通过训练编码器将文本映射到StyleGAN潜在空间中,可以生成与给定文本相对应的图像。为了执行文本引导的图像处理,TediGAN将图像和文本都编码到潜在空间中,然后执行样式混合以生成相应的图像。在第7节中,我们演示了使用我们的方法实现的操作更好地反映了驱动文本的语义。
在最近的一篇在线文章中,Perez描述了一种文本到图像的方法,它以类似于第4节中潜在优化器的方式将StyleGAN和CLIP结合起来。我们的优化方案,以及本文中描述的其他两种方法,都侧重于图像处理,而不是从零开始合成图像。尽管文本到图像的生成是一个有趣且具有挑战性的问题,但我们认为,我们提供的图像处理功能对于创意艺术家的典型工作流程而言,是一种更有用的工具。
潜在空间图像处理
许多工作探索了如何利用预训练生成器的潜在空间进行图像处理。特别地,StyleGAN中的中间潜在空间已经被证明能够实现许多分离的和有意义的图像操作。一些方法通过训练将给定图像编码为潜在表示的网络来学会以端到端的方式执行图像操纵。其他方法旨在找到潜在路径,以便沿它们遍历会导致所需的操作。此类方法可以分类为:(i)使用图像注释查找有意义的潜在路径的方法,和(ii)在没有监督的情况下查找有意义的方向并且需要针对每个方向进行手动注释的方法。
虽然大多数作品在W或W +空间中执行图像处理,但Wu等人。 建议使用StyleSpace S,并表明它比W和W +更好地求解。 我们潜在的优化器和映射器在W +空间中工作,而我们检测到的与输入无关的方向是在S中。在这三个方面,操纵都是直接从文本输入中得出的,而我们唯一的监督来源是预先训练的CLIP模型。 由于CLIP已针对数亿个文本图像对进行了培训,因此我们的方法是通用的,可以在多个域中使用,而无需特定于域或特定于操作的数据注释。
StyleCLIP文本驱动的操作
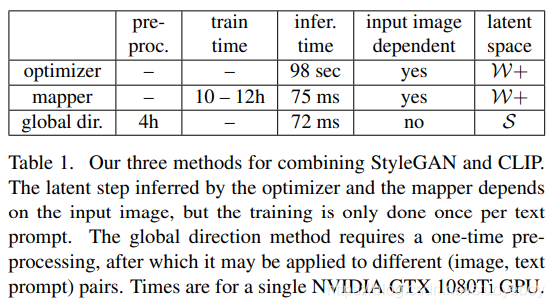
在这项工作中,我们探索了文本驱动的图像处理的三种方法,所有这些方法将StyleGAN的生成能力与CLIP所学的丰富的联合视觉语言表示形式相结合。我们从第4节开始,介绍一个简单的潜在优化方案,通过最小化CLIP空间中计算的损失来优化StyleGAN W +空间中图像的给定潜在代码。针对每个(源图像,文本提示)对执行优化。因此,尽管用途广泛,但一次操作仍需花费几分钟,因此该方法可能难以控制。在第5节中介绍了一种更稳定的方法,训练映射网络以推断潜在空间中的操作步骤,一次向前通过。训练需要几个小时,但每个文本提示只能进行一次。操作步骤的方向可能会根据W +中的开始位置(对应于输入图像)的不同而有所不同,因此我们将此映射器称为“局部”。
我们在本地映射器上进行的实验表明,尽管起点不同,但对于各种各样的操作,操作步骤的方向通常彼此相似。此外,由于操作步骤是在W +中执行的,因此难以以解的方式获得细粒度的视觉效果。因此,在第6节中,我们探讨了第三种文本驱动的操作方案,该方案将给定的文本提示转换为不可知的输入(即,潜在空间中的全局)映射方向。全局方向是在StyleGAN的样式空间S中计算的,与W +相比,该样式空间更适合细粒度和非整齐的视觉处理。
表1总结了上述三种方法之间的差异,而以下部分介绍了可视化结果和比较结果。
潜在优化
利用CLIP指导图像处理的一种简单方法是直接进行潜在代码优化。具体来说,给定源潜在代码
w
s
∈
W
+
w_s \in W +
ws∈W+,并使用自然语言的指令或文本提示
t
t
t,我们解决了以下优化问题:
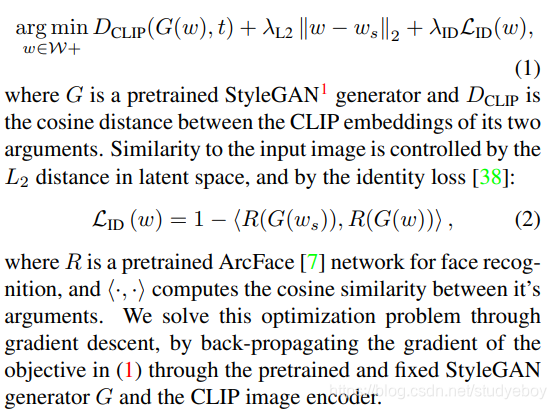
在图3中,我们提供了200-300次迭代后使用此优化方法获得的一些编辑。输入图像被e4e反转。 请注意,视觉特征可以通过指示真实或虚构的人(碧昂丝,特朗普,艾尔莎)来显式控制(胡须,金发)或隐式控制。
λ
L
2
λ_{L2}
λL2和
λ
I
D
λ_{ID}
λID的值取决于所需编辑的性质。 对于转向另一个标识的更改,将
λ
I
D
λ_{ID}
λID设置为较低的值。

潜在映射器
上面描述的潜在优化是通用的,因为它对每个(源图像,文本提示)对都执行了专门的优化。不利的一面是,需要花费几分钟的时间才能编辑单个图像,并且该方法对其参数值有些敏感。下面,我们描述一种更有效的过程,其中针对特定的文本提示 t t t训练映射网络,以针对任何给定的嵌入 w ∈ W + w \in W + w∈W+的潜像推断 W + W + W+空间中的操作步骤 M t ( w ) M_t(w) Mt(w)。
-
架构
我们的文本引导映射器的体系结构如图2所示。如图所示,不同的StyleGAN层负责生成的图像中不同级别的细节。因此,通常将图层分为三组(粗,中,细),并为每组提供(扩展的)潜矢量的不同部分。我们相应地设计了映射器,它具有三个完全连接的网络,每个组/部分一个。这些网络的每个架构与StyleGAN映射网络的架构相同,但是层数较少(在我们的实现中为4层而不是8层)。将输入图像的潜在代码表示为 w = ( w c , w m , w f ) w =(w_c,w_m,w_f) w=(wc,wm,wf),映射器定义为:

请注意,您可以选择只训练三个映射器的一个子集。 在某些情况下,保留某些属性级别并固定相应条目中的样式代码很有用。 -
损失
我们的映射器经过训练,可以操作文本提示t所指示的图像的所需属性,同时保留输入图像的其他视觉属性。CLIP损失 L C L I P ( w ) L_{CLIP}(w) LCLIP(w)引导映射器最小化CLIP潜在空间中的余弦距离:

其中G再次表示预训练的StyleGAN生成器。为了保留原始输入图像的视觉属性,我们最小化了潜在空间中操作步骤的L2范数。最后,对于需要身份保存的编辑,我们使用等式(2)中定义的身份丢失。 我们的总损失函数是这些损失的加权组合:

和以前一样,当编辑需要更改标识时,我们不使用标识丢失。我们在本文示例中使用的参数值为λL2= 0.8,λID= 0.1,我们在本文示例中使用的参数值为 λ L 2 = 0.8 , λ I D = 0.1 λ_L2= 0.8,λ_ID= 0.1 λL2=0.8,λID=0.1,除了图9中的“ Trump”操作外,其中我们使用的参数值为 λ L 2 = 2 , λ I D = 0 λ_L2=2,λ_ID= 0 λL2=2,λID=0。在图4中,我们提供了一些发型编辑示例,其中每列中使用了一个不同的映射器。在所有这些示例中,映射器成功保存了身份以及与头发无关的大多数其他视觉属性。注意,所产生的头发外观适合个人。 这在“卷发”和“鲍勃剪的发型”编辑中尤为明显。

应当注意,文本提示一次不限于单个属性。 图5显示了四种不同的头发属性组合,直发/卷发和短发/长发,每种组合都能产生预期的效果。 我们知道,以前没有任何方法可以证明这种控制程度。

由于潜在映射器会为每个输入图像推断出定制的操作步骤,因此研究潜在空间中步骤方向在不同输入上变化的程度非常有趣。为了对此进行测试,我们首先使用e4e反转CelebA-HQ 的测试集。接下来,我们将反演的潜在代码输入几个训练有素的映射器中,并计算所有成对的操纵方向之间的余弦相似度。表2报告了每个映射器的余弦相似度的平均值和标准偏差。该表显示,即使映射器推断出适合输入图像的操作步骤,但实际上,对于给定的文本提示,这些步骤的余弦相似度很高,这意味着它们的方向没有人期望的那样不同。

全局方向
虽然潜在映射器允许快速的推理时间,但我们发现,当需要进行细粒度的解操作时,它有时会不足。此外,正如我们所看到的,给定文本提示的不同操作步骤的方向趋于相似。基于这些观察,在本节中,我们提出了一种在StyleGAN的样式空间S中将文本提示映射到单个全局方向的方法,该方法已显示出比其他潜在空间更有解。
令s∈S表示样式代码,而G(s)表示相应的生成图像。给定一个文本提示,指示所需的属性,我们寻求一个操纵方向∆s,以使G(s + α∆s)产生一个图像,在该图像中该属性被引入或放大,而不会显着影响其他属性。操纵强度由α控制。我们的高级想法是,首先使用CLIP文本编码器在CLIP的联合语言-图像嵌入中获得矢量∆t,然后将此矢量映射到S中的操作方向∆s。如下所述,使用快速工程从自然语言获得稳定的∆t。然后,通过评估每个样式通道与目标属性的相关性来确定相应的方向∆s。
更正式地说,由I表示CLIP联合嵌入空间中的图像嵌入流形,由T表示其文本嵌入中的流形。我们区分这两个流形,因为它们之间没有一对一的映射:图像可能包含大量的视觉属性,很难用一个文本语句来全面描述; 相反,给定的句子可能描述许多不同的图像。在CLIP训练期间,所有嵌入都被归一化为一个单位范数,因此只有嵌入的方向包含语义信息,而范数可能会被忽略。因此,在CLIP空间训练有素的区域中,我们期望与相同语义变化相对应的T和I流形上的方向大致是共线的(即,具有较大的余弦相似度),并且在归一化之后几乎相同。
给定一对图像G(s)和G(s + α∆s),我们分别用i和i + ∆i表示它们的I嵌入。因此,CLIP空间中的两个图像之间的差异由∆i给出。给定以Δt编码的自然语言指令,并假定∆t和∆i之间存在共线性,我们可以通过评估S中每个通道与∆i方向的相关性来确定操纵方向∆s。
-
从自然语言到∆t
为了减少文本嵌入的噪声,Radford等人利用了一种称为提示工程的技术,该技术向文本编码器提供了几个具有相同含义的句子,并对它们的嵌入求平均。例如,对于ImageNet零镜头分类,使用了80个不同的句子模板库,例如“ {}的不良照片”,“ {}的裁剪照片”,“ {}的黑白照片”和“ {}的绘画”。在推断时,目标类会自动替换为这些模板,以构建具有相似语义的句子库,然后对它们的嵌入进行平均。与使用单个文本提示相比,此过程将零镜头分类准确性提高了3.5%。同样,我们还采用了快速工程(使用相同的ImageNet提示库)来计算T中的稳定方向。具体来说,应该为我们的方法提供目标属性和相应中性类的文本描述。例如,当操纵汽车的图像时,目标属性可能被指定为“跑车”,在这种情况下,对应的中性类别可能是“汽车”。然后应用及时工程来生成目标和中性类别的平均嵌入,并将这两个嵌入之间的归一化差异用作目标方向Δt。
-
通道相关性
接下来,我们的目标是构造一个样式空间操纵方向∆s,该方向将产生与目标方向∆t共线的变化∆i。为此,我们需要评估CLIP联合嵌入空间中S的每个通道c与给定方向∆i的相关性。我们生成样式代码s∈S的集合,并通过添加负值和正值来仅扰动每个样式代码的c通道。用 ∆ i c ∆i_c ∆ic表示结果图像对之间的CLIP空间方向,将通道c与目标操作的相关性估计为 ∆ i c ∆i_c ∆ic在∆i上的平均投影:

在实践中,我们使用100对图像来估计均值。
我们生成的图像对由 G ( s ± α ∆ s c ) G(s±α∆s_c) G(s±α∆sc)给出,其中 ∆ s c ∆s_c ∆sc是零矢量,但其c坐标除外,该c坐标设置为通道的标准偏差。 扰动的大小设置为α= 5。在估算了每个通道的相关性Rc之后,我们忽略Rc低于阈值β的通道。此参数可用于控制操作中的纠缠程度:使用较高的阈值会导致更多的操作纠缠,但同时会降低操作的视觉效果。由于诸如年龄之类的各种高级属性涉及多个较低级属性(例如,白发,皱纹和肤色)的组合,因此涉及多个渠道,在这种情况下,降低阈值可能是可取的, 如图6所示。据我们所知,以这种方式控制解缠程度的能力是我们方法所独有的。

总而言之,给定CLIP空间中的目标方向∆i,我们设置:

图7和8显示了沿文本驱动的操纵方向进行的各种编辑,这些方向如上所述确定的在人脸,汽车和狗的图像上。图7中的操作是使用在FFHQ上预训练的StyleGAN2执行的。输入是真实图像,使用e4e编码器嵌入W +空间。该图演示了文本驱动的18种属性的操纵,包括复杂的概念,例如面部表情和发型。图8中的操作使用了在LSUN汽车上预训练的StyleGAN2(在真实图像上)以及在AFHQ狗上预训练的来自StyleGAN2-ada的图像。


比较与评估
现在,我们将前面各节中介绍和分析的三种方法与其他方法进行比较。 我们处理的所有真实图像都使用e4e编码器进行了反转。
-
文本驱动的图像处理方法
我们首先比较图9中的几种文本驱动的面部图像处理方法。我们比较了我们的潜在映射器方法(第5节),全局方向方法(第6节)和TediGAN 。对于TediGAN,我们使用作者的官方实现,最近对它进行了更新,以利用CLIP进行图像处理,因此与他们论文中介绍的方法有所不同。我们不包括第4节中介绍的优化方法的结果,因为它对超参数的敏感性使其非常耗时,因此无法扩展。
 我们使用三种属性进行比较,这些属性的范围从复杂但特定(例如“特朗普”),较不复杂和较不特定(例如“ Mohawk”)到更简单和更常见(例如“无皱纹”)。复杂的“特朗普”操纵涉及多个属性,例如金发、,眼,张开嘴巴,面部有些肿胀和特朗普的身份。尽管全局潜在方向能够捕获并非特朗普特有的主要视觉属性,但它无法捕获特定的身份。相反,潜在映射器更为成功。“莫霍克发型”是一种不太复杂的属性,因为它只涉及头发,而且不那么具体。因此,我们的两种方法都能够产生令人满意的操作。由于CLIP空间中的方向是平均方向,因此由全局方向生成的操作稍微不太明显。最后,对于“无皱纹”提示,全局方向成功地消除了皱纹,同时使其他属性大部分不受影响,而映射器失败了。我们将其归因于W +的纠缠程度较小。我们在另一组属性(“奥巴马”,“愤怒”,“胡须”)上观察到了类似的行为。我们得出结论,对于复杂和特定的属性(尤其是涉及身份的属性),映射器能够产生更好的操作。对于更简单和/或更常见的属性,全局方向就足够了,同时提供了更多分散的操作。我们注意到,TediGAN产生的结果在图9所示的所有三种操作中均失败。
-
其他StyleGAN操作方法
在图10中,我们比较了全局方向方法和几种最新的StyleGAN图像处理方法:GANSpace,InterFaceGAN和StyleSpace。比较仅检查所有比较方法能够操纵的属性(性别,灰色头发和唇膏),因此不包括我们的方法所能实现的许多新颖操纵。由于所有这些都是通用属性,因此在此比较中我们不包括映射器。继吴等,选择操纵步长强度,以使其在相应分类器的对数值上引起相同量的变化(在CelebA上进行预训练)。

可以看出,在GANSpace中,操纵与皮肤颜色和光照纠缠在一起,而在InterFaceGAN中,身份可能发生显着变化(操纵唇膏时)。我们的操作非常类似于StyleSpace,它只更改目标属性,而所有其他属性保持不变。在补充材料中,我们还展示了与StyleFLow [1](一种最新的非线性方法)的比较。尽管StyleFlow同时使用了几个属性分类器和回归器(来自Microsoft Face API),但我们的方法仍能产生类似质量的结果,因此可以处理一组有限的属性。相反,我们的方法不需要额外的监督。
-
局限性
我们的方法依赖于预训练的StyleGAN生成器和CLIP模型进行联合的语言视觉嵌入。因此,不能期望将图像操纵到它们位于预训练的生成器的域之外(或保留在该域的内部,但在生成器覆盖范围较小的区域中)的程度。同样,映射到CLIP空间中没有很好填充图像的区域的文本提示,不能期望产生如实反映提示语义的可视化操作。我们还观察到,很难在视觉上多样化的数据集中进行激烈的操作。例如,虽然老虎很容易变成狮子(参见图1),但如补充材料所示,当将老虎变成狼时,我们取得的成功并不那么大。
结论
我们介绍了三种新颖的图像处理方法,这些方法将StyleGAN的强大生成能力与CLIP出色的视觉概念编码能力结合在一起。我们已经证明,这些技术可以实现各种独特的图像处理,其中某些操作无法通过依赖于注释数据的现有方法来实现。我们还证明了CLIP提供了细粒度的编辑控件,例如指定了所需的发型,而我们的方法能够控制操纵强度和松开程度。总而言之,我们认为文本驱动的操作是功能强大的图像编辑工具,其功能和重要性将继续增长。


 8955


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


