Kaggle(九)深度学习 k近邻学习

[kaggle实战] Digit Recognizer -- 从KNN,LR,SVM,RF到深度学习 之前看了很多入门的资料,如果现在让我来写写,我觉得我会选择”数字识别(digit recognizer)”作为例子,足够有趣,而且能说明很多问题。kaggle是个实践的好地方,python是门方便的语言,sklearn是个不错的库,文档很适合学习。那就用sklearn来实践一下机器学习,加深理解吧! 阅读详情

k近邻算法


参考:K-近邻算法(KNN)_自动化所副盐的博客-优快云博客

任务九 深度学习 K近邻学习_Heihei_study的博客-优快云博客

概述

K Nearest Neighbor算法又叫KNN算法K最近邻(k-Nearest Neighbor,KNN),是一种常用于分类的算法,是有成熟理论支撑的、较为简单的经典机器学习算法之一。该方法的基本思路是:如果一个待分类样本在特征空间中的k个最相似(即特征空间中K近邻)的样本中的大多数属于某一个类别,则该样本也属于这个类别,即近朱者赤,近墨者黑。显然,对当前待分类样本的分类,需要大量已知分类的样本的支持,因此KNN是一种有监督学习算法。

原理 

如图所示,有两类不同的样本数据,分别用蓝色的小正方形和红色的小三角形表示,而图正中间的那个绿色的圆所标示的数据则是待分类的数据。这也就是我们的目的,来了一个新的数据点,我要得到它的类别是什么?好的,下面我们根据k近邻的思想来给绿色圆点进行分类。
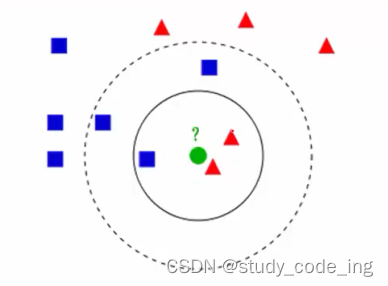
如果K=3,绿色圆点的最邻近的3个点是2个红色小三角形和1个蓝色小正方形,少数从属于多数,基于统计的方法,判定绿色的这个待分类点属于红色的三角形一类。
如果K=5,绿色圆点的最邻近的5个邻居是2个红色三角形和3个蓝色的正方形,还是少数从属于多数,基于统计的方法,判定绿色的这个待分类点属于蓝色的正方形一类。
从上面例子我们可以看出,k近邻的算法思想非常的简单,也非常的容易理解,该算法的原理大概意思就是怎么给新来的点如何进行归类,只要找到离它最近的k个实例,哪个类别最多即可。

三个要素

  • 距离度量
  • 分类决策规则
  • K值的选取

k近邻算法实例实现分类(CIFAR-10)

这是一个经典的小彩色图像集,具有50000个训练数据,10000个测试数据,大小均为32*32,有10类标签(类别鲜明),目的是预测图片属于什么样类别的

CIFAR-10https://www.cs.toronto.edu/~kriz/cifar.html
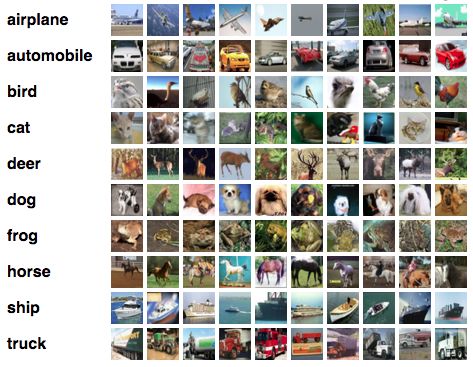
计算选取点与当前点的距离(将图像对应像素点相减,最后求累加和)

深度学习(八)-CIFAR-10分类_未名湖畔的落叶的博客-优快云博客_cifar10 分类

数据处理

在处理时,因为是彩色图片,由 [R, G, B] 组成,需要使用三维,将图片转化为三维像素表示

	transform = transforms.Compose([
	    transforms.ToTensor(),   # 将数据转为 tensor
	    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))   # 标准化
	])
	
	trainset = torchvision.datasets.CIFAR10(root="./data", train=True, download=False, transform=transform)
	testset = torchvision.datasets.CIFAR10(root="./data", train=False, download=False, transform=transform)
	
	trainloader = torch.utils.data.DataLoader(trainset, batch_size=4, shuffle=True, num_workers=2)
	testloader = torch.utils.data.DataLoader(testset, batch_size=4, shuffle=False, num_workers=2)

看图片信息 

	classes = ("airplane", "automobile", "bird", "cat", "deer", "dog", "frog", "horse", "ship", "truck")
	(data, label) = trainset[100]
	
	print(classes[label], "\t", data.shape)
	show((data+1)/2).resize((100, 100))

模型构建

个参数可以自己设置

	class Net(nn.Module):
	    def __init__(self):
	        super(Net, self).__init__()
	        self.player1 = nn.Sequential(   # [3, 32, 32]
	            nn.Conv2d(3, 6, 5),      # 卷积层 [6, 28, 28]
	            nn.ReLU(),     # 激活函数
	            nn.MaxPool2d(2)   # 池化  [6, 14, 14]
	        )
	        
	        self.player2 = nn.Sequential(   # [6, 14, 14]
	            nn.Conv2d(6, 16, 5),  # [16, 10, 10]
	            nn.ReLU(),
	            nn.MaxPool2d(2)   # [16, 5, 5]
	        )
	        
	        self.player3 = nn.Sequential(   # 全连接层
	            nn.Linear(16*5*5, 120),
	            nn.Linear(120, 84),
	            nn.Linear(84, 10)
	        )
	        
	    def forward(self, x):   # 传播过程
	        x = self.player1(x)
	        x = self.player2(x)
	        x = x.view(x.size()[0], -1)   # 平面展开
	        output = self.player3(x)
	
	        return output

 各层权重与偏置信息

	for name, parameters in model.named_parameters():
	    print(name, ": ", parameters.size())

效果测试

	dataiter = iter(testloader)   # 显示4张图片
	images, labels = dataiter.next()
	print("实际类别: ", "  ".join("%11s"%classes[labels[j]] for j in range(4)))
	show(torchvision.utils.make_grid((images+1)/2)).resize((400, 100))   # resize: 图片缩放    make_grid:将多个图片拼到一个网格

预测

	outputs = model(Variable(images))
	_, predicted = torch.max(outputs.data, 1)
	print("预测类别: ", "  ".join("%11s"%classes[predicted[j]] for j in range(4)))

Python深度学习手势识别的项目介绍 该项目使用了Kaggle上的手语字母数据集,包含了26个手语字母的图像数据,总计约27,000张图片。最后,我们需要将数据集划分为训练集和测试集,一般采用80%的数据作为训练集,20%的数据作为测试集。本项目使用了Kaggle上的手语字母数据集,该数据集包含了26个手语字母的图像数据,总计约27,000张图片。- 两个全连接层,第一个全连接层包含128个神经元,第二个全连接层包含26个神经元(对应26个手语字母),最后使用softmax激活函数输出各个类别的概率。QQ录屏20231104154518。 阅读详情

相关推荐

《机器学习算法分类讲解与Kaggle实战》专栏概述

分类讲解机器学习算法原理,深度解析决策树、贝叶斯算法、逻辑回归、梯度下降、集成学习、k最近邻、支持向量机等,并给出Python实现源程序,同时分享以实战为导向的Kaggle进阶指南,将机器学习应用于Kaggle实际项目中。

迈微AI研习社 · 号主 2064

深度学习—KNN算法

KNN算法简介及代码应用

qq_59332194的博客 5523

Kaggle猫狗图像分类项目:数据集与算法实战

本文还有配套的精品资源,点击获取 简介:本项目是Kaggle竞赛中的猫和狗图像分类任务,要求使用机器学习和深度学习技术区分图像中的猫和狗。数据集已被处理为CSV格式,包含了图像信息和标签。参赛者将面对二分类问题,需要进行数据预处理、构建深度学习模型(如CNN),选择损失函数和优化器,并进行模型训练、评估和集成。最终目标是提交一个准确的预测结果CSV文件。项目的实战将加深对计...

weixin_42598278的博客 3100

【20210922】【机器/深度学习】KNN (K近邻) 算法详解

一、算法概念 KNN, K-near neighbor,即最近邻算法。它是一种分类算法,算法思想是:一个样本与数据集中的 k 个样本最相似,如果这 k 个样本中的大多数属于某一个类别,则该样本也属于这个类别,即每个样本都可以用它最接近的 k 个邻居来代表。 KNN 算法的关键点有两个:k 值的选择和点距离(通常使用欧氏距离)的计算。 KNN是一种非参的、惰性的算法模型。 二、基本流程 第一步:计算已知类别数据集中的点与当前点之间的...

诗小葵的博客 8735

Kaggle黄金价格预测:时间序列分析与机器学习实践

滚动窗口统计(Rolling Window Statistics)是一种利用时间窗口内的数据计算统计量的方法,常见的统计量包括平均值、最大值、最小值、标准差等。在时间序列分析中,滚动窗口统计能够揭示数据在特定时间窗口内的趋势和波动性,对于捕捉非平稳时间序列的局部特征尤为有效。

weixin_28729843的博客 1357

Knn分类器java代码

这个代码可以用于多维数据的特征选取进行分类。运行速度快,准确度高。

经典深度学习算法【1】:K-近邻算法(KNN)概述

KNN是通过测量不同特征值之间的距离进行分类。它的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别,其中K通常是不大于20的整数。最简单最初级的分类器是将全部的训练数据所对应的类别都记录下来,当测试对象的属性和某个训练对象的属性完全匹配时,便可以对其进行分类。但是怎么可能所有测试对象都会找到与之完全匹配的训练对象呢,其次就是存在一个测试对象同时与多个训练对象匹配,导致一个训练对象被分到了多个类的问题,基于这些问题呢,就产生了KNN。

豫州刺史 314

手把手教你用Apollo Dreamview调试自动驾驶感知模块(附数据包下载)

本文详细介绍了如何使用百度Apollo平台的Dreamview工具调试自动驾驶感知模块,包括环境配置、数据加载、感知问题定位和多传感器融合调试等关键步骤。通过实战案例和参数调整技巧,帮助开发者快速掌握自动驾驶感知模块的调试方法,提升开发效率。

weixin_29084111的博客 138

深度学习第二次笔记-KNN算法

深度学习第二次笔记-KNN算法

coshyou的博客 608

oVirt 4.4.10超详细安装指南:从零搭建企业级虚拟化环境(附常见错误排查)

本文提供了oVirt 4.4.10企业级虚拟化平台的超详细安装指南,涵盖环境规划、系统准备、Engine安装配置、计算节点部署、存储系统集成及高级运维技巧。通过实战操作手册和常见错误排查方法,帮助用户从零搭建稳定高效的虚拟化环境,特别适合企业IT管理员参考实施。

wasm7browser的博客 351

ego-planner启动参数深度解析:从配置到实战避障应用

本文深入解析EGO-Planner启动参数的配置与实战应用,重点探讨无人机自主导航中的避障性能优化。通过环境感知、运动约束和算法控制三类参数的详细说明,结合ROS和RViz工具,提供从基础配置到高级调优的完整指南,帮助开发者提升无人机在复杂场景下的规划效率和安全性。

rum55的博客 246

深度学习与图像识别-原理与实践1【图像分类之KNN算法】

本文章将讲解一种最简单的图像分类算法,即K-最近邻算法(K-NearestNeighbor,KNN)。主要包括KNN算法的算法逻辑以及代码的实现。对于KNN算法,我们需要理解算法的原理,掌握距离度量的规则,以及归一化的影响。

weixin_45977237的博客 2408

微信支付开发之平台给用户转账到零钱的功能

请求消息中应包含商家批次单号、转账名称、appid、转账总金额、转账总笔数、转账openid、收款用户姓名等信息。批次已受理成功,若发起批量转账的30分钟后,转账批次单仍处于该状态,可能原因是商户账户余额不足等。【转账场景ID】 该批次转账使用的转账场景,如不填写则使用商家的默认场景,如无默认场景可为空,可前往“商家转账到零钱-前往功能”中申请。【转账总笔数】 一个转账批次单最多发起一千笔转账。【商家批次单号】 商户系统内部的商家批次单号,要求此参数只能由数字、大小写字母组成,在商户系统内部唯一。

程序员weixin_sodomany的博客 3450

利用k-近邻算法实现facebook签到位置预判

该项目是根据员工的坐标x,y以及员工过去的签到位置来预测下一次签到位置 1. 准备数据库. 数据下载地址:grid_knn | KaggleExplore and run machine learning code with Kaggle Notebooks | Using data from Facebook V: Predicting Check Inshttps://www.kaggle.com/navoshta/grid-knn/data 一共有三个数据集,样本包sample,训练集train

weixin_64001701的博客 1769

【Simulink教程案例19】基于simulink的扩频通信系统建模与仿真

扩频是一种应用于数字调制信号的调制技术,可以提高传输信号的带宽。扩频通信具有抗干扰能力强,扩频增益越大,抗干扰能力越强。而且扩频通信具有很强的保密性,扩频后信号近似白噪声,功率谱密度也很低。扩频通信可用于多址通信。扩频调制有如下三个特点:① 扩频后信号的带宽远大于信号所需的带宽② 使用扩频码进行扩频调制,扩频码与信号中的数据相互独立③ 在接收端,通过将接收信号与扩频码的同步副本进行相关,实现解扩。

FPGA/MATLAB学习教程/源码/项目合作开发 2197

从零到精通:BLDC电机驱动电路详解与设计思路

这套电机驱动电路从核心控制器到反馈采集模块,涉及了BLDC电机驱动的方方面面。每一个模块的设计和选择都需要综合考虑系统需求和实际使用环境。在实际应用中,很多细微的设计改进都会显著影响电机的运行性能。

weixin_43199439的博客 3100

从零开始完整学习机器学习和深度学习,包括理论和代码实现,主要用到scikit和MXNet,还有一些实践(kaggle上的)

从零开始完整学习传统机器学习和经典深度学习,只需要python基础,最好有线性代数基础,没有也问题不大

闵行小鱼塘 889

STM32(HAL库)驱动HC-SR04测距模块

本文介绍通过STM32F103C8T6单片机对HC-SR04测距模块进行驱动,并且通过串口对数据进行打印。

weixin_44597885的博客 2203

深度学习设计-基于机器学习的心血管疾病分析与预测

对心血管疾病数据的来源进行了介绍,并且介绍了数据集中一些数据属性。最后对收集来的数据进行了预处理操作。本文数据从Kaggle平台获取,该平台是一个主要为数据科学家进行学习竞赛、代码分享的平台。发布者可以在该平台上提供一些数据、发布一些任务,来寻找解决问题的方法。参赛者可以以组队的形式来参与项目,优秀的方案可获得奖金,所以对于参赛者来说,不仅可以锻炼自己的实际操作能力,还有可能获得丰厚的奖金。除此以外,Kaggle平台每年还会举办大规模的竞赛,奖金高达一百万美金,从而吸引了许多人参与其中。

m0_73484725的博客 3427

OpenClaw进阶实战(二十一):工作流6:跨平台舆情监控与自动响应

摘要: 本文介绍基于OpenClaw构建自动化舆情监控系统,实现多平台数据采集、AI情感分析与智能预警。系统架构包含数据采集(微博/小红书/抖音)、消息队列、情感分析(SnowNLP/大模型API)、分级预警和自动响应模块。通过技能化开发(如微博API采集、小红书模拟登录)实现7×24小时监控,结合情感强度与传播速度分级处理负面舆情,形成"采集-分析-预警-处置"闭环,适用于企业私有化部署。

PeterPan的博客 299

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

学习计划2019H1

1-3月 1. 机器学习理论与实践 1月 1)classfication (K近邻,决策树,支持向量机,朴素贝叶斯,逻辑回归,adaboost) NLP number K近邻 KNeighborsClassifier -> K-D Tree, Ball Treeic LogistRegression DecisionTreeClassifier ...

amy_1217的博客 173

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

机器学习 深度学习资料 资源machine learning

Kaggle入门,看这一篇就够了 - 知乎 (zhihu.com)入门机器学习是一个逐步的过程,涉及学习基础概念、数学基础、编程技能、理解算法和模型,以及实践和项目经验的积累。

生信小博士的博客 1318

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

零基础入门人工智能学习路线:数学、编程、机器学习、深度学习和实践项目

编程语言 编程语言是实现人工智能算法的工具。深度学习 深度学习是一种机器学习的进阶技术,它可以自动地从原始数据中学习特征,不需要手动进行特征工程。机器学习 机器学习是人工智能的一个分支,它是通过算法和统计学方法来让计算机自动地学习和改进性能。初学者应该了解机器学习的基本概念和方法,并掌握常见的算法(如决策树、随机森林、K-近邻算法、朴素贝叶斯等)和数据处理技巧。如果你想开始学习人工智能,但是对于如何开始感到困惑,那么这里有一些零基础入门学习路线的建议,可以帮助你更好地理解和掌握人工智能的基础知识。

m0_74693860的博客 1395

深度学习auc_机器学习集成学习与模型融合

在上一次的分享中,我们给大家分享了机器学习模型是怎么进行调参与优化的。那这一次的分享,我们想给大家分享在Kaggle或者阿里天池上面大杀四方的数据科学比赛利器---集成学习。我们也对比过kaggle比赛上面的top10的模型,除了深度学习以外的模型基本上都是集成学习的产物,包括我们接下来给大家分享的集成学习,以及下期给大家介绍的树模型及其集成方法(Xgboost,RandomForest,Ligh...

weixin_29280657的博客 716

Kaggle竞赛丨入门手写数字识别之KNN、CNN、降维

引言 这段时间来,看了西瓜书、蓝皮书,各种机器学习算法都有所了解,但在实践方面却缺乏相应的锻炼。于是我决定通过Kaggle这个平台来提升一下自己的应用能力,培养自己的数据分析能力。 我个人的计划是先从简单的数据集入手如手写数字识别、泰坦尼克号、房价预测,这些目前已经有丰富且成熟的方案可以参考,之后关注未来就业的方向如计算广告、点击率预测,有合适的时机,再与小伙伴一同参加线上比赛。 数据集 介绍 MNIST ("Modified National Institute of Standards a...

ElegantHedgehog的博客 751
上一篇: Kaggle(七)贝叶斯算法
下一篇: 生物基础-多组学联合分析
study_code_ing
博客等级 码龄5年 41粉丝 9原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值