Kaggle 入门(Kaggle网站使用及项目复现)

用Kaggle竞赛项目提升数据科学简历可信度 数据科学简历的核心痛点不是技术不足,而是缺乏可验证的实战证据链。Kaggle作为全球公认的数据科学‘练兵场+公证处’,通过公开提交记录、实时排行榜和可复现Notebook,天然支撑能力的透明化表达。其本质是将模糊的技能描述(如‘熟悉特征工程’)转化为具象的技术动作(如‘构建多层级JSON解析器解决时序标识缺失’),从而建立招聘方信任。这种基于真实问题求解、带量化结果与决策日志的项目表达,正成为中高级岗位筛选的关键信号。本文聚焦Kaggle项目如何系统性重构为高转化率简历素材,覆盖竞赛筛选、Notebook脱 阅读详情
AI摘要

本文详细介绍了如何在Kaggle上利用Titanic数据集进行项目复现,包括Python环境配置、pycharm使用、网页在线运行以及本地离线运行步骤。重点讲解了代码编辑、运行结果下载和环境准备技巧。

目录

一、简介

二、前期准备

1、python环境

2、pycharm

三、网页运行

1、网址:kaggle.com

2、注册账号

3、打开一个项目

 4、进入后可以看到项目的代码

 5、点Edit可以进入编辑模式

 6、此处可以更改名字并保存

7、选择run all可以运行 

8、在output处下载运行结果

三、本地运行

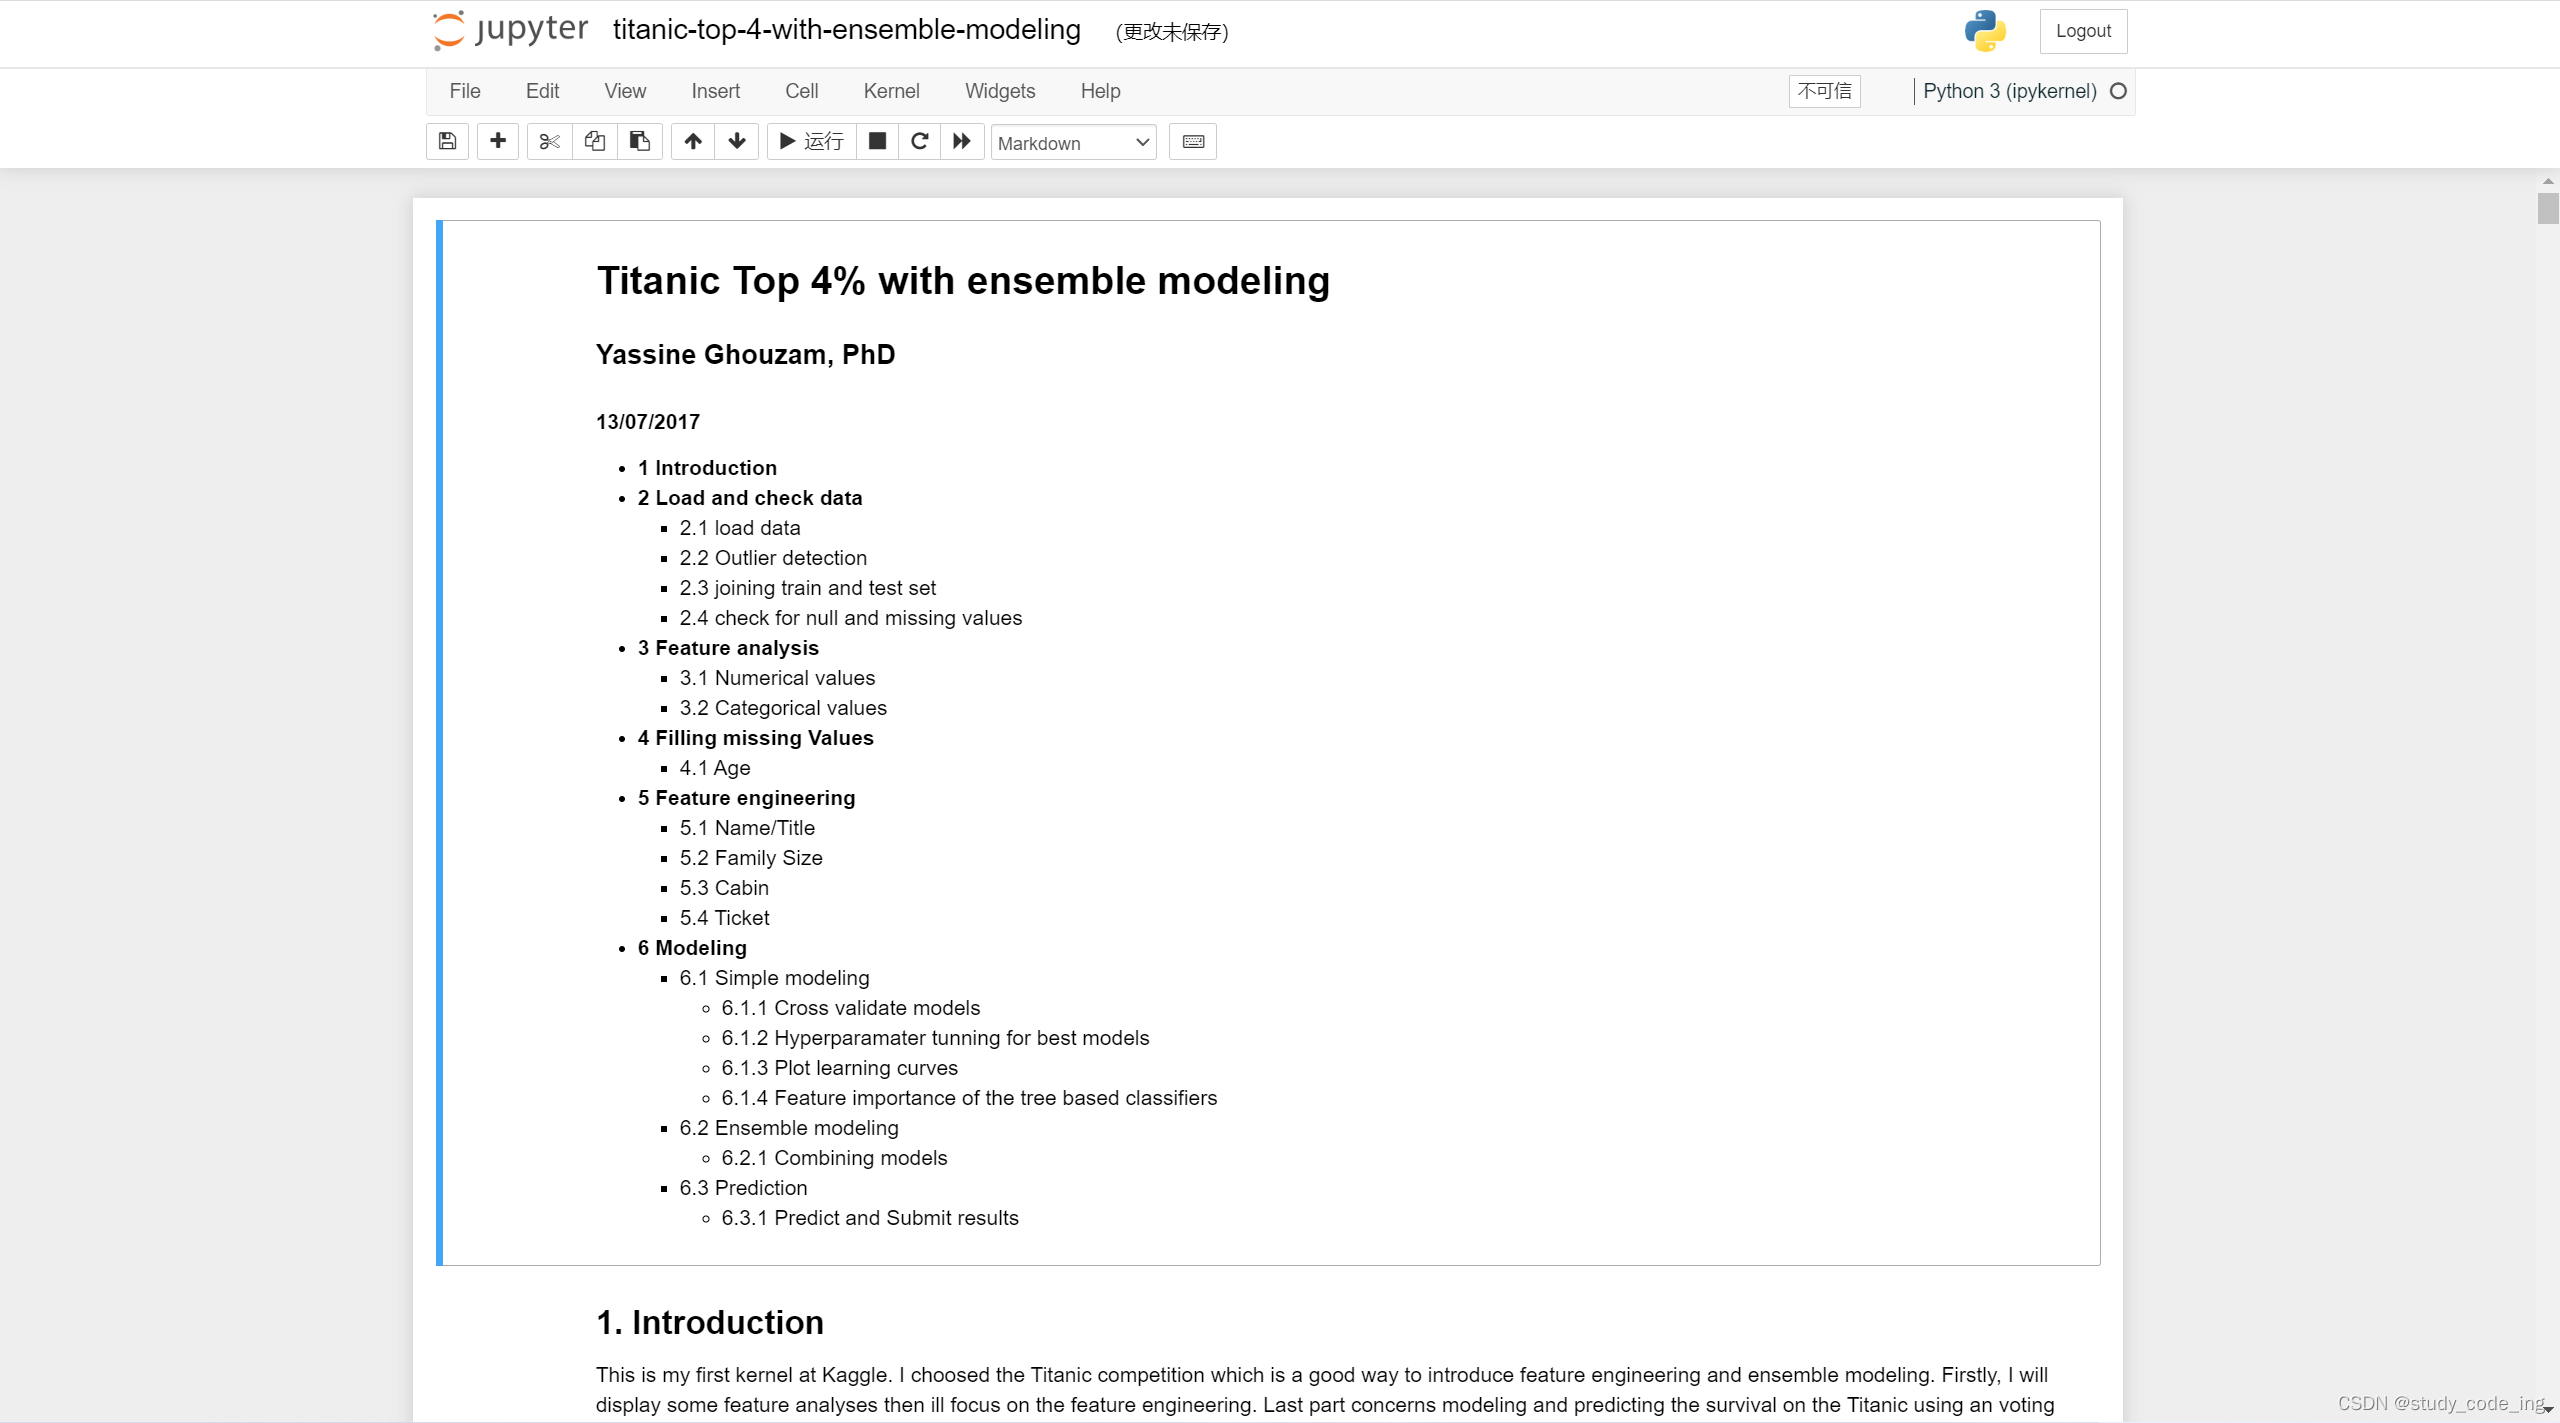
1、在编辑模式下载源代码

 2、下载数据集

3、创建一个文件夹放置数据集及源代码

4、准备环境

四、温馨提示


一、简介

以Titanic Top 4% with ensemble modeling为例,熟悉使用Kaggle网站及项目复现。

二、前期准备

1、python环境

官网下载python(我使用的是3.8.10版本),搭建python环境

2、pycharm

pycharm :  http://www.jetbrains.com/pycharm/download/#section=windows(社区版)也可以下载专业版

三、网页运行

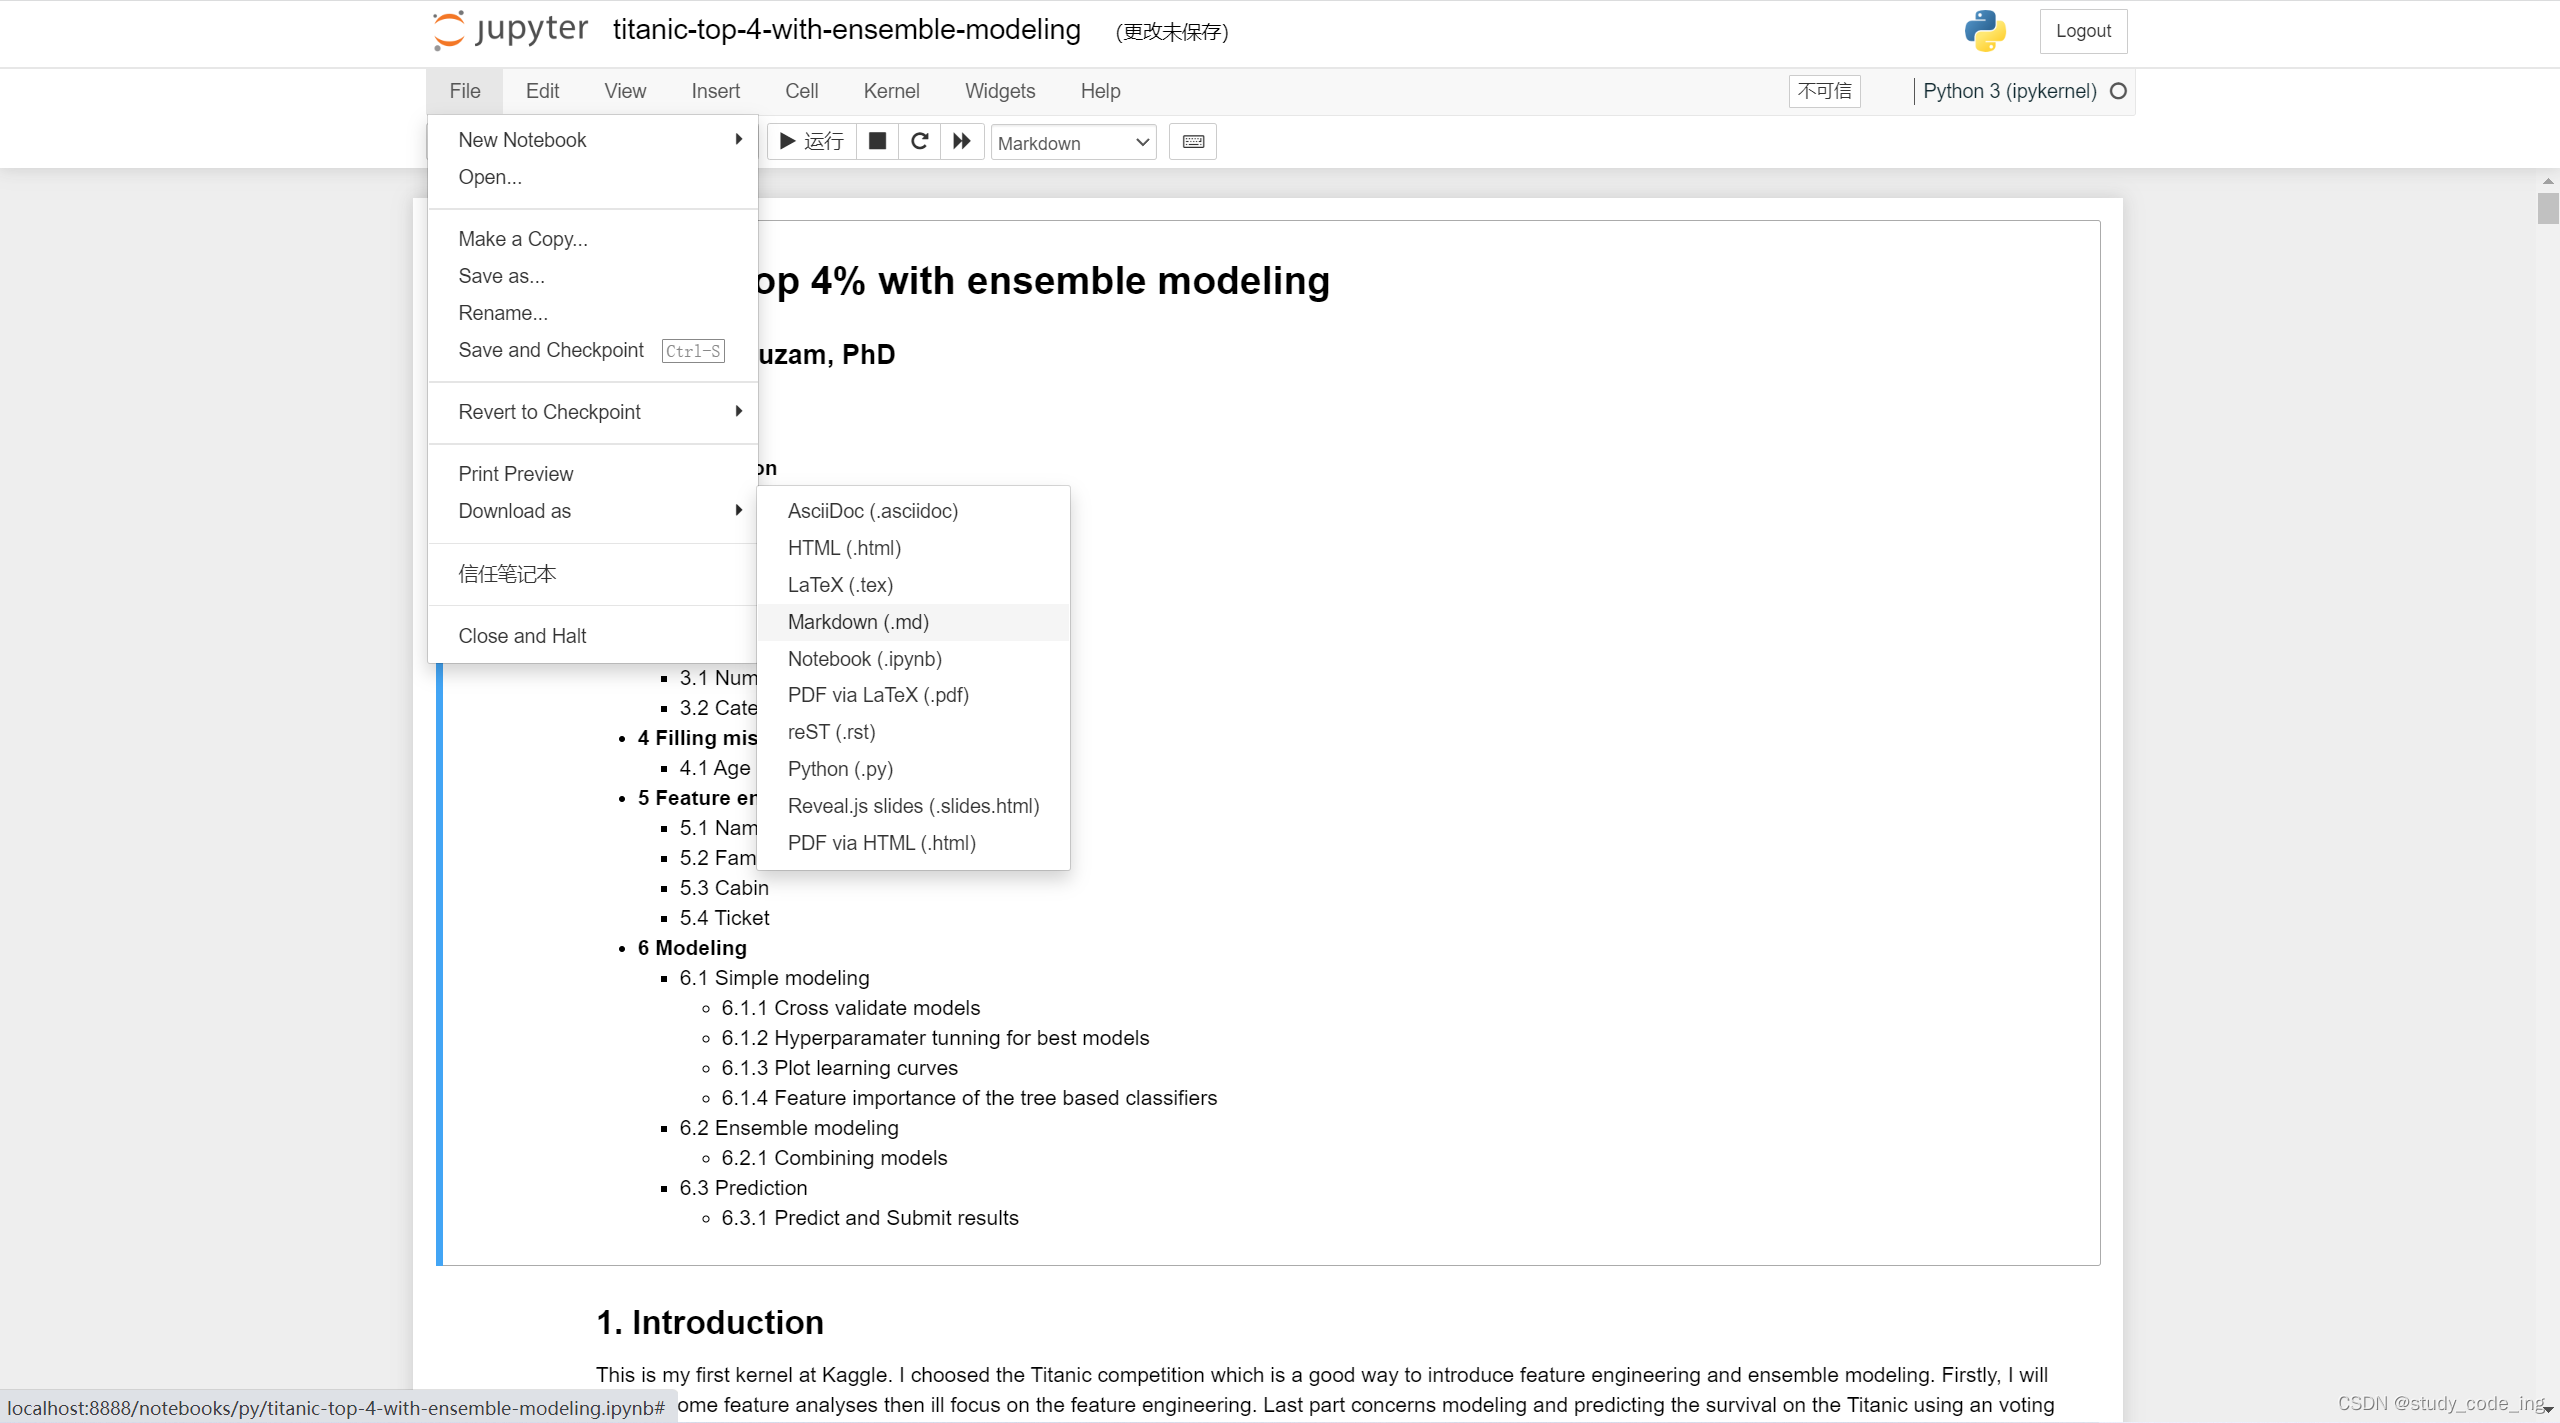
1、网址:kaggle.com

2、注册账号

3、打开一个项目
 4、进入后可以看到项目的代码

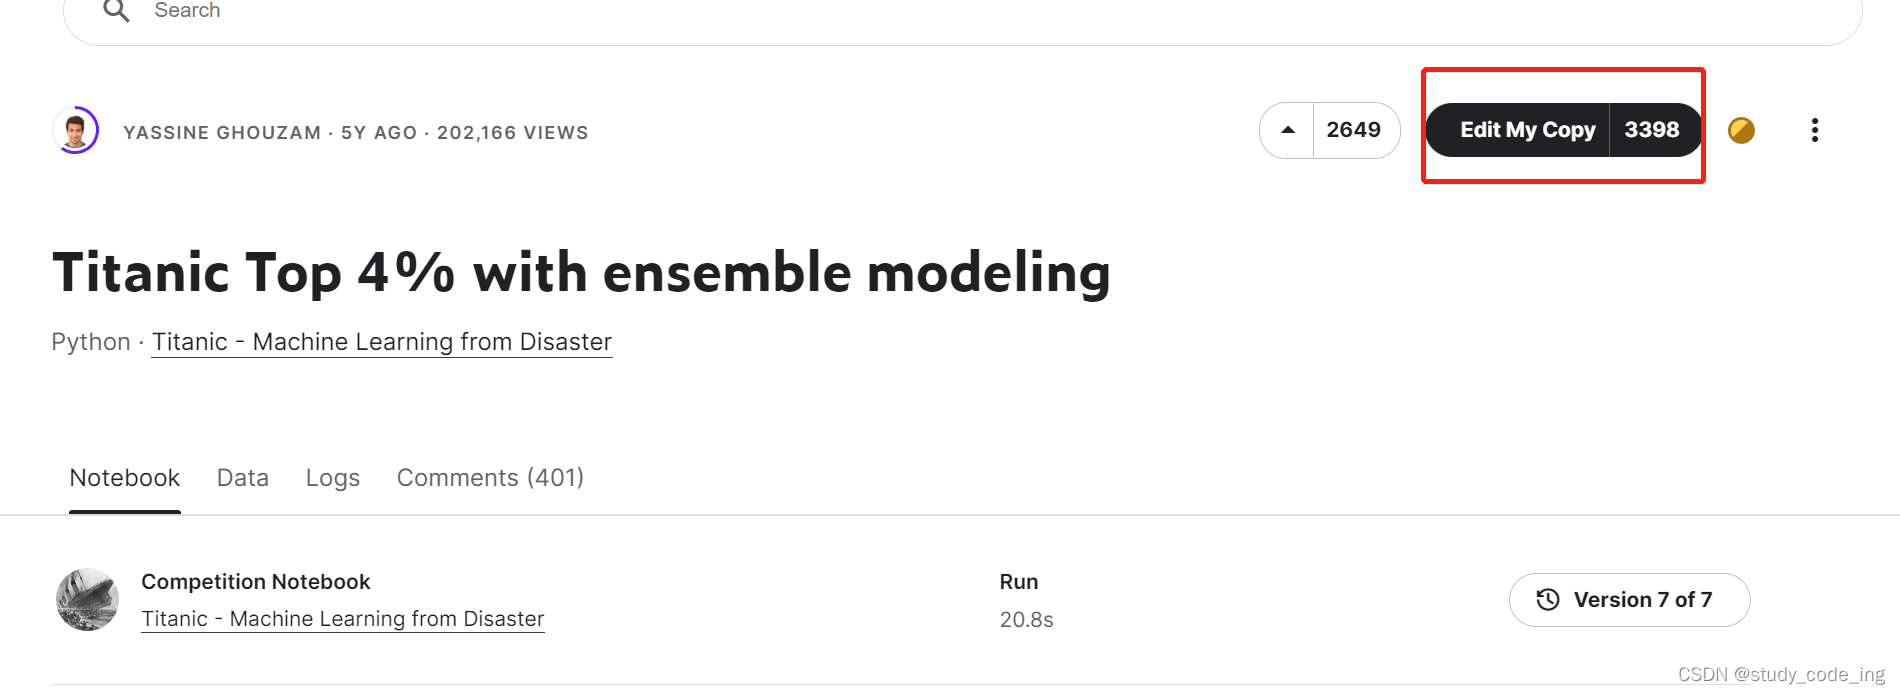
 5、点Edit可以进入编辑模式
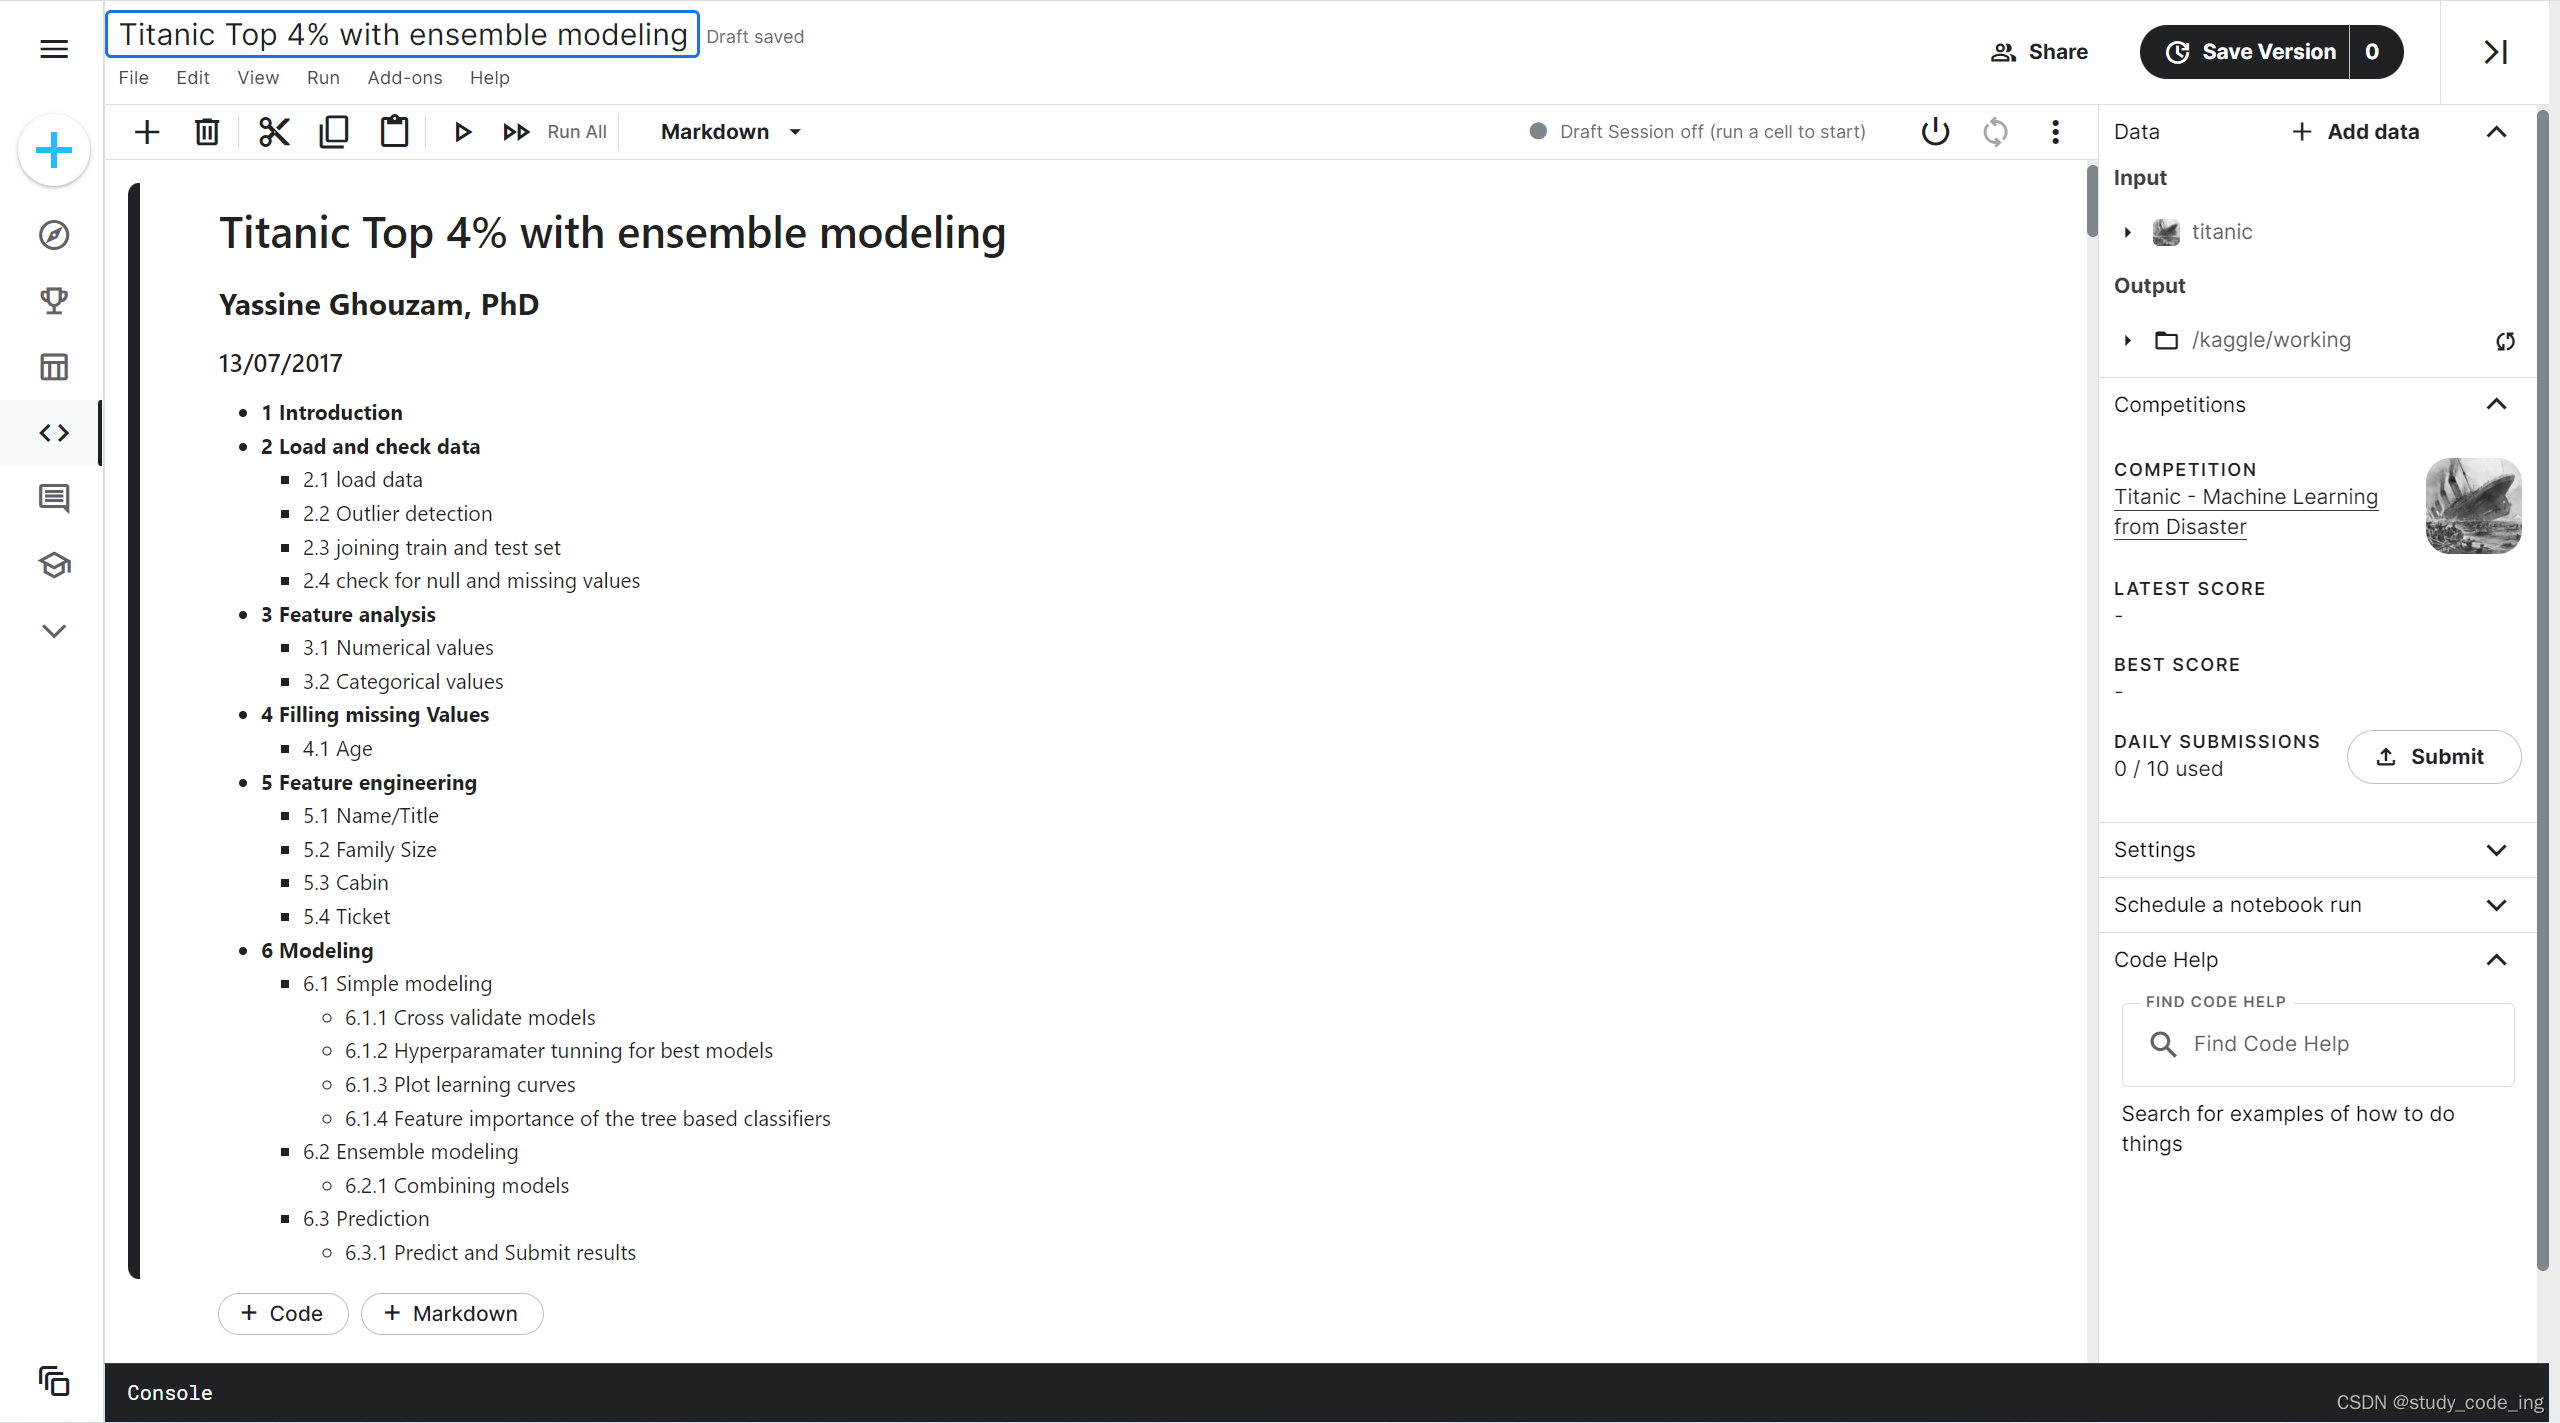
 6、此处可以更改名字并保存

后面可在左侧任务栏your work找到
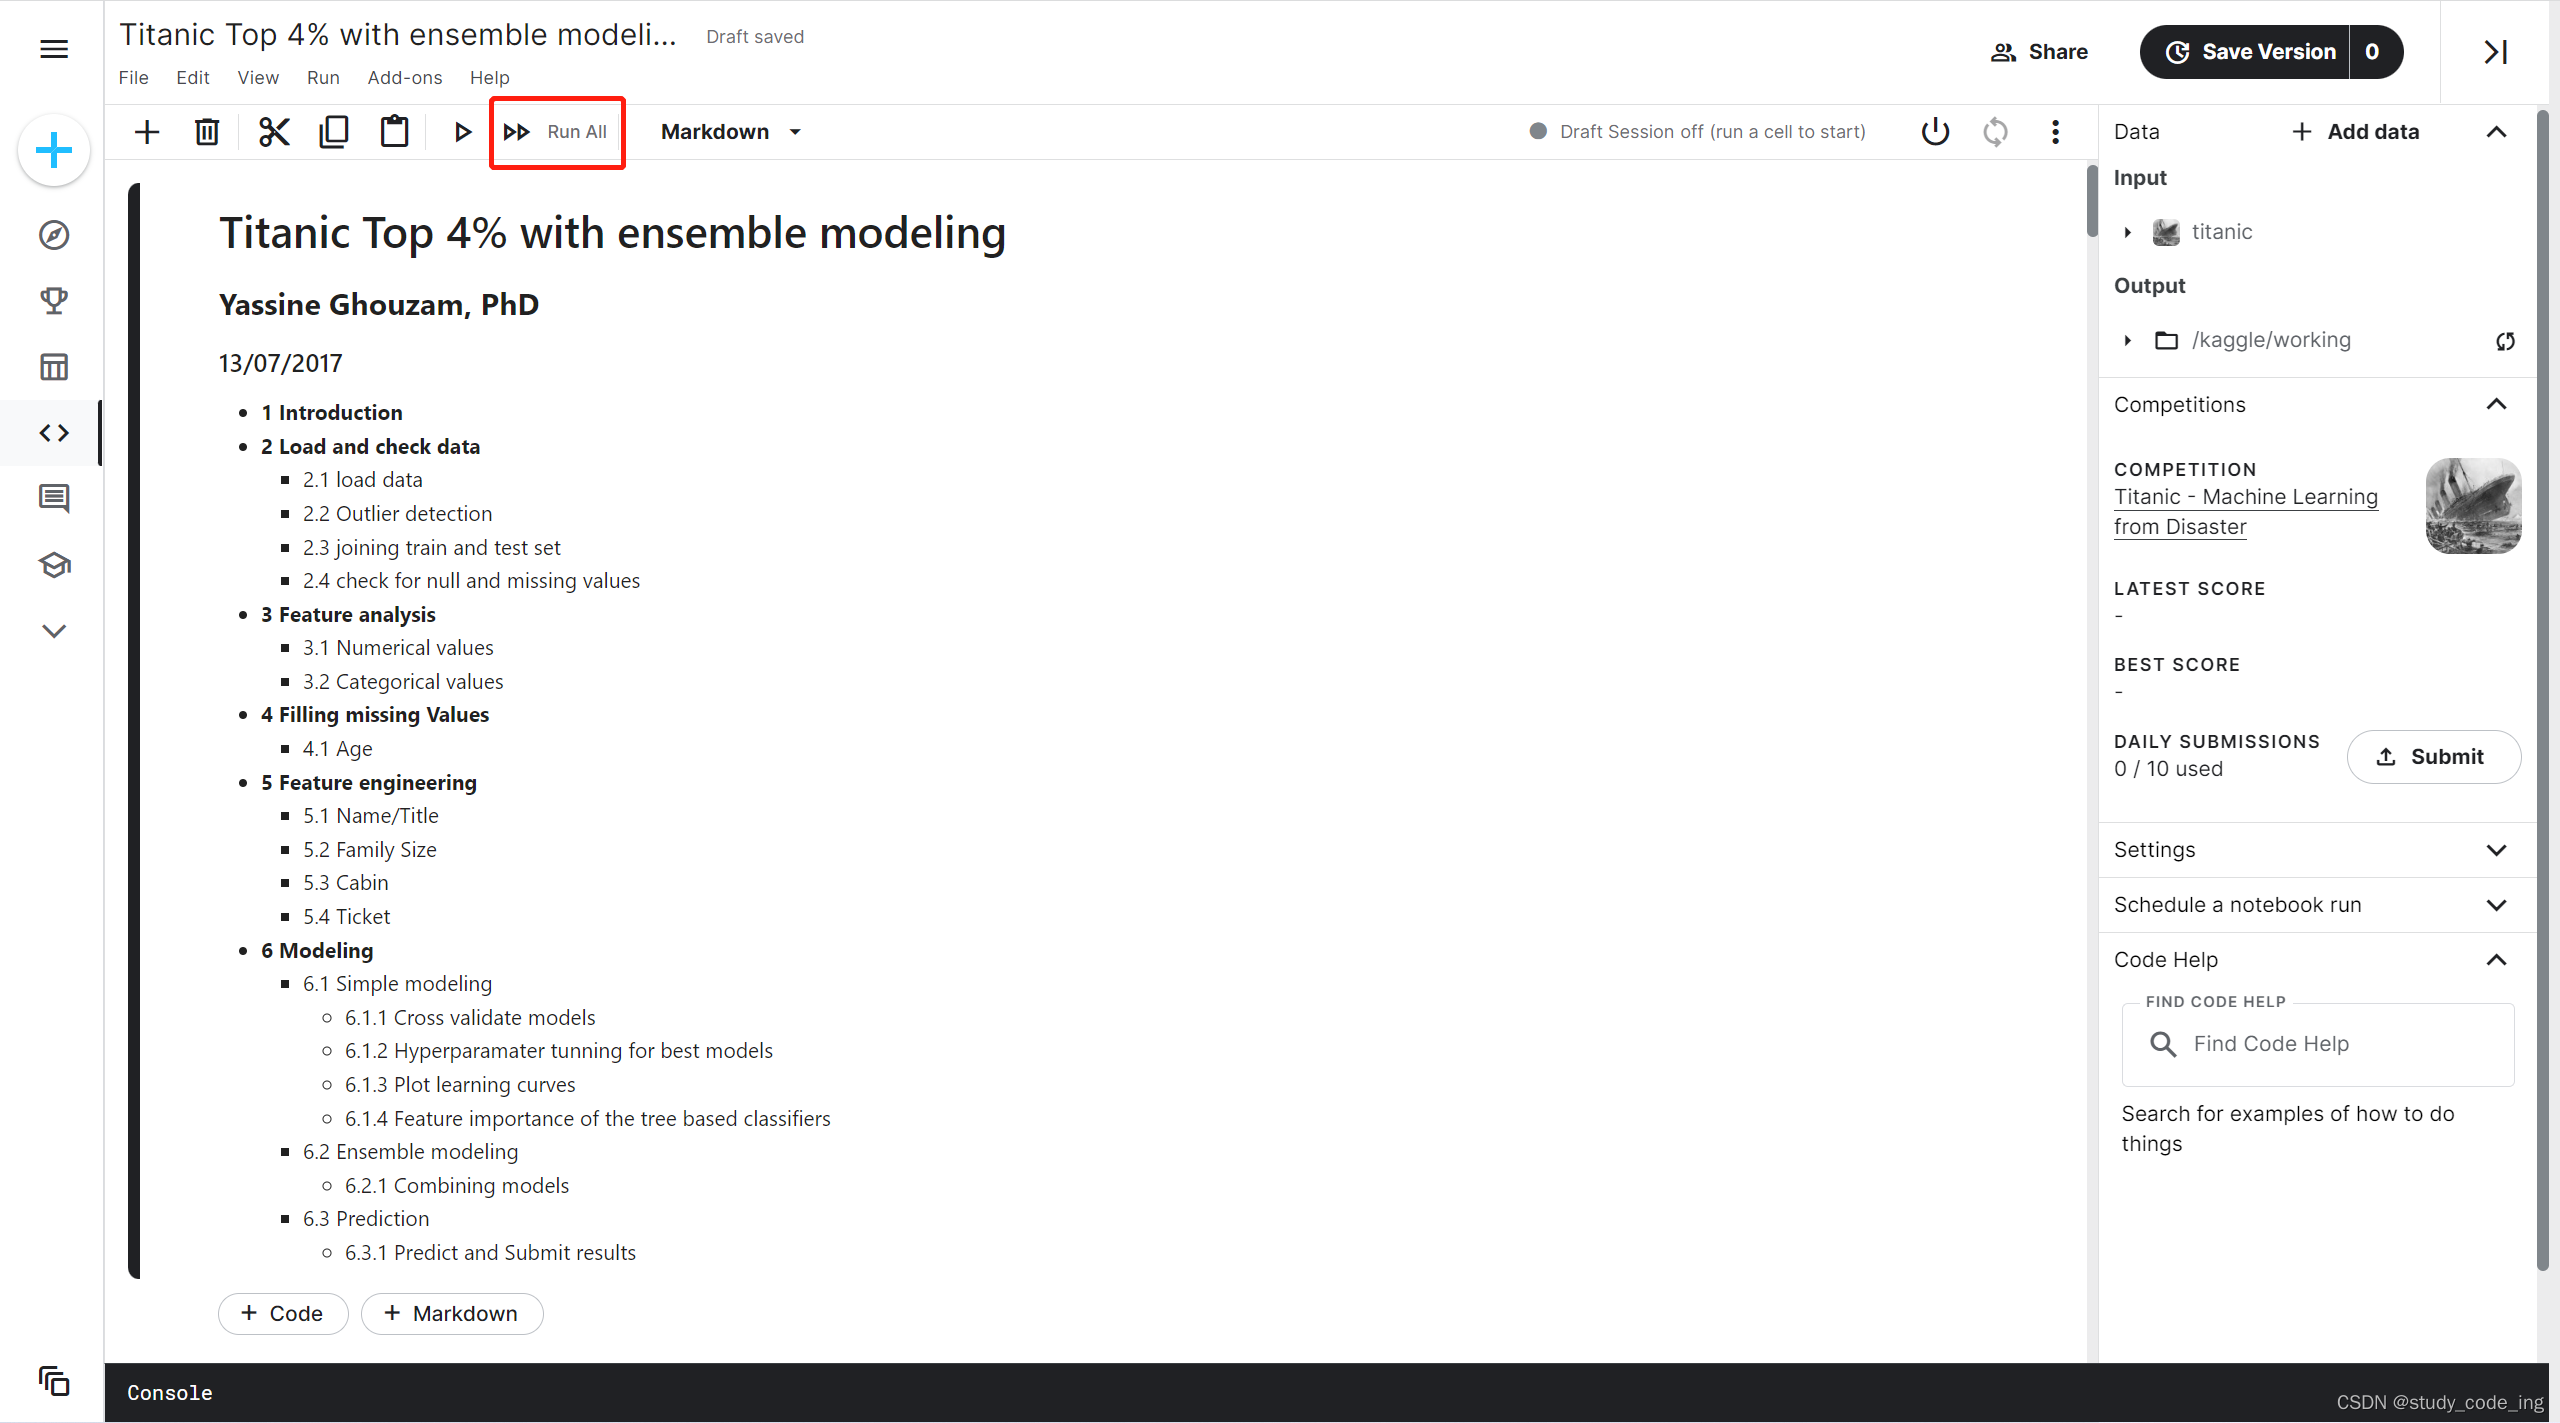
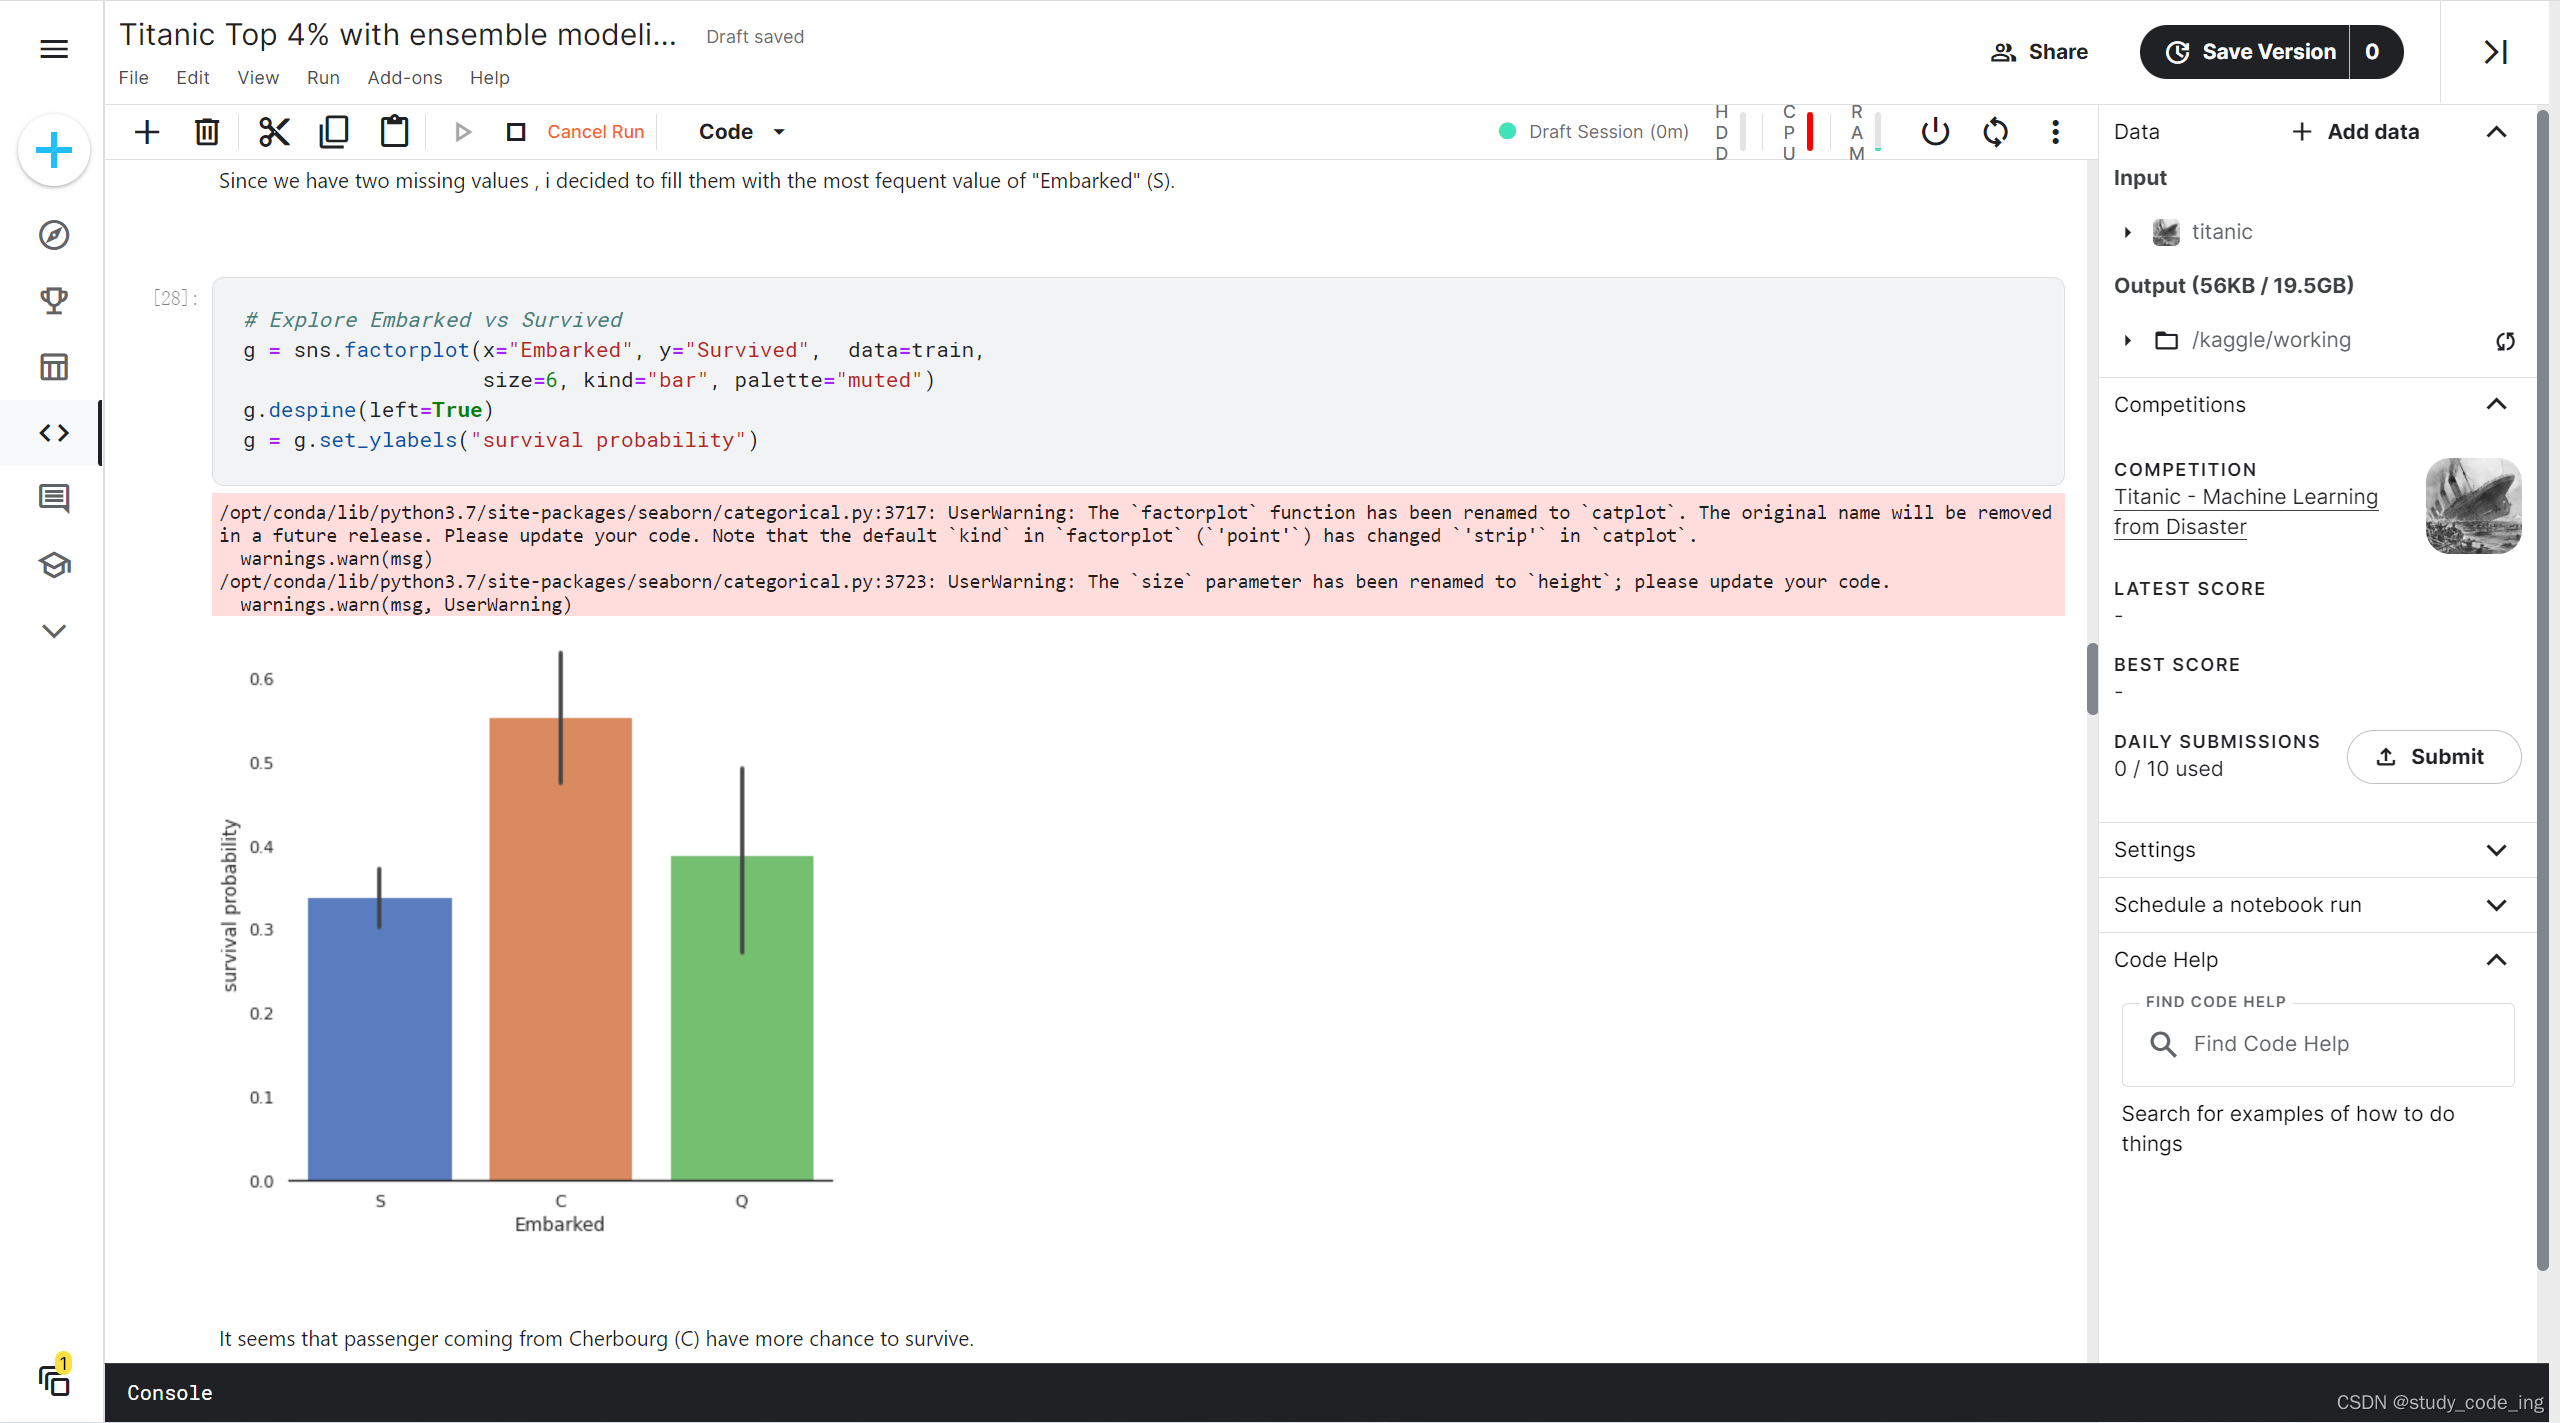
7、选择run all可以运行 
运行过程如下可参考 
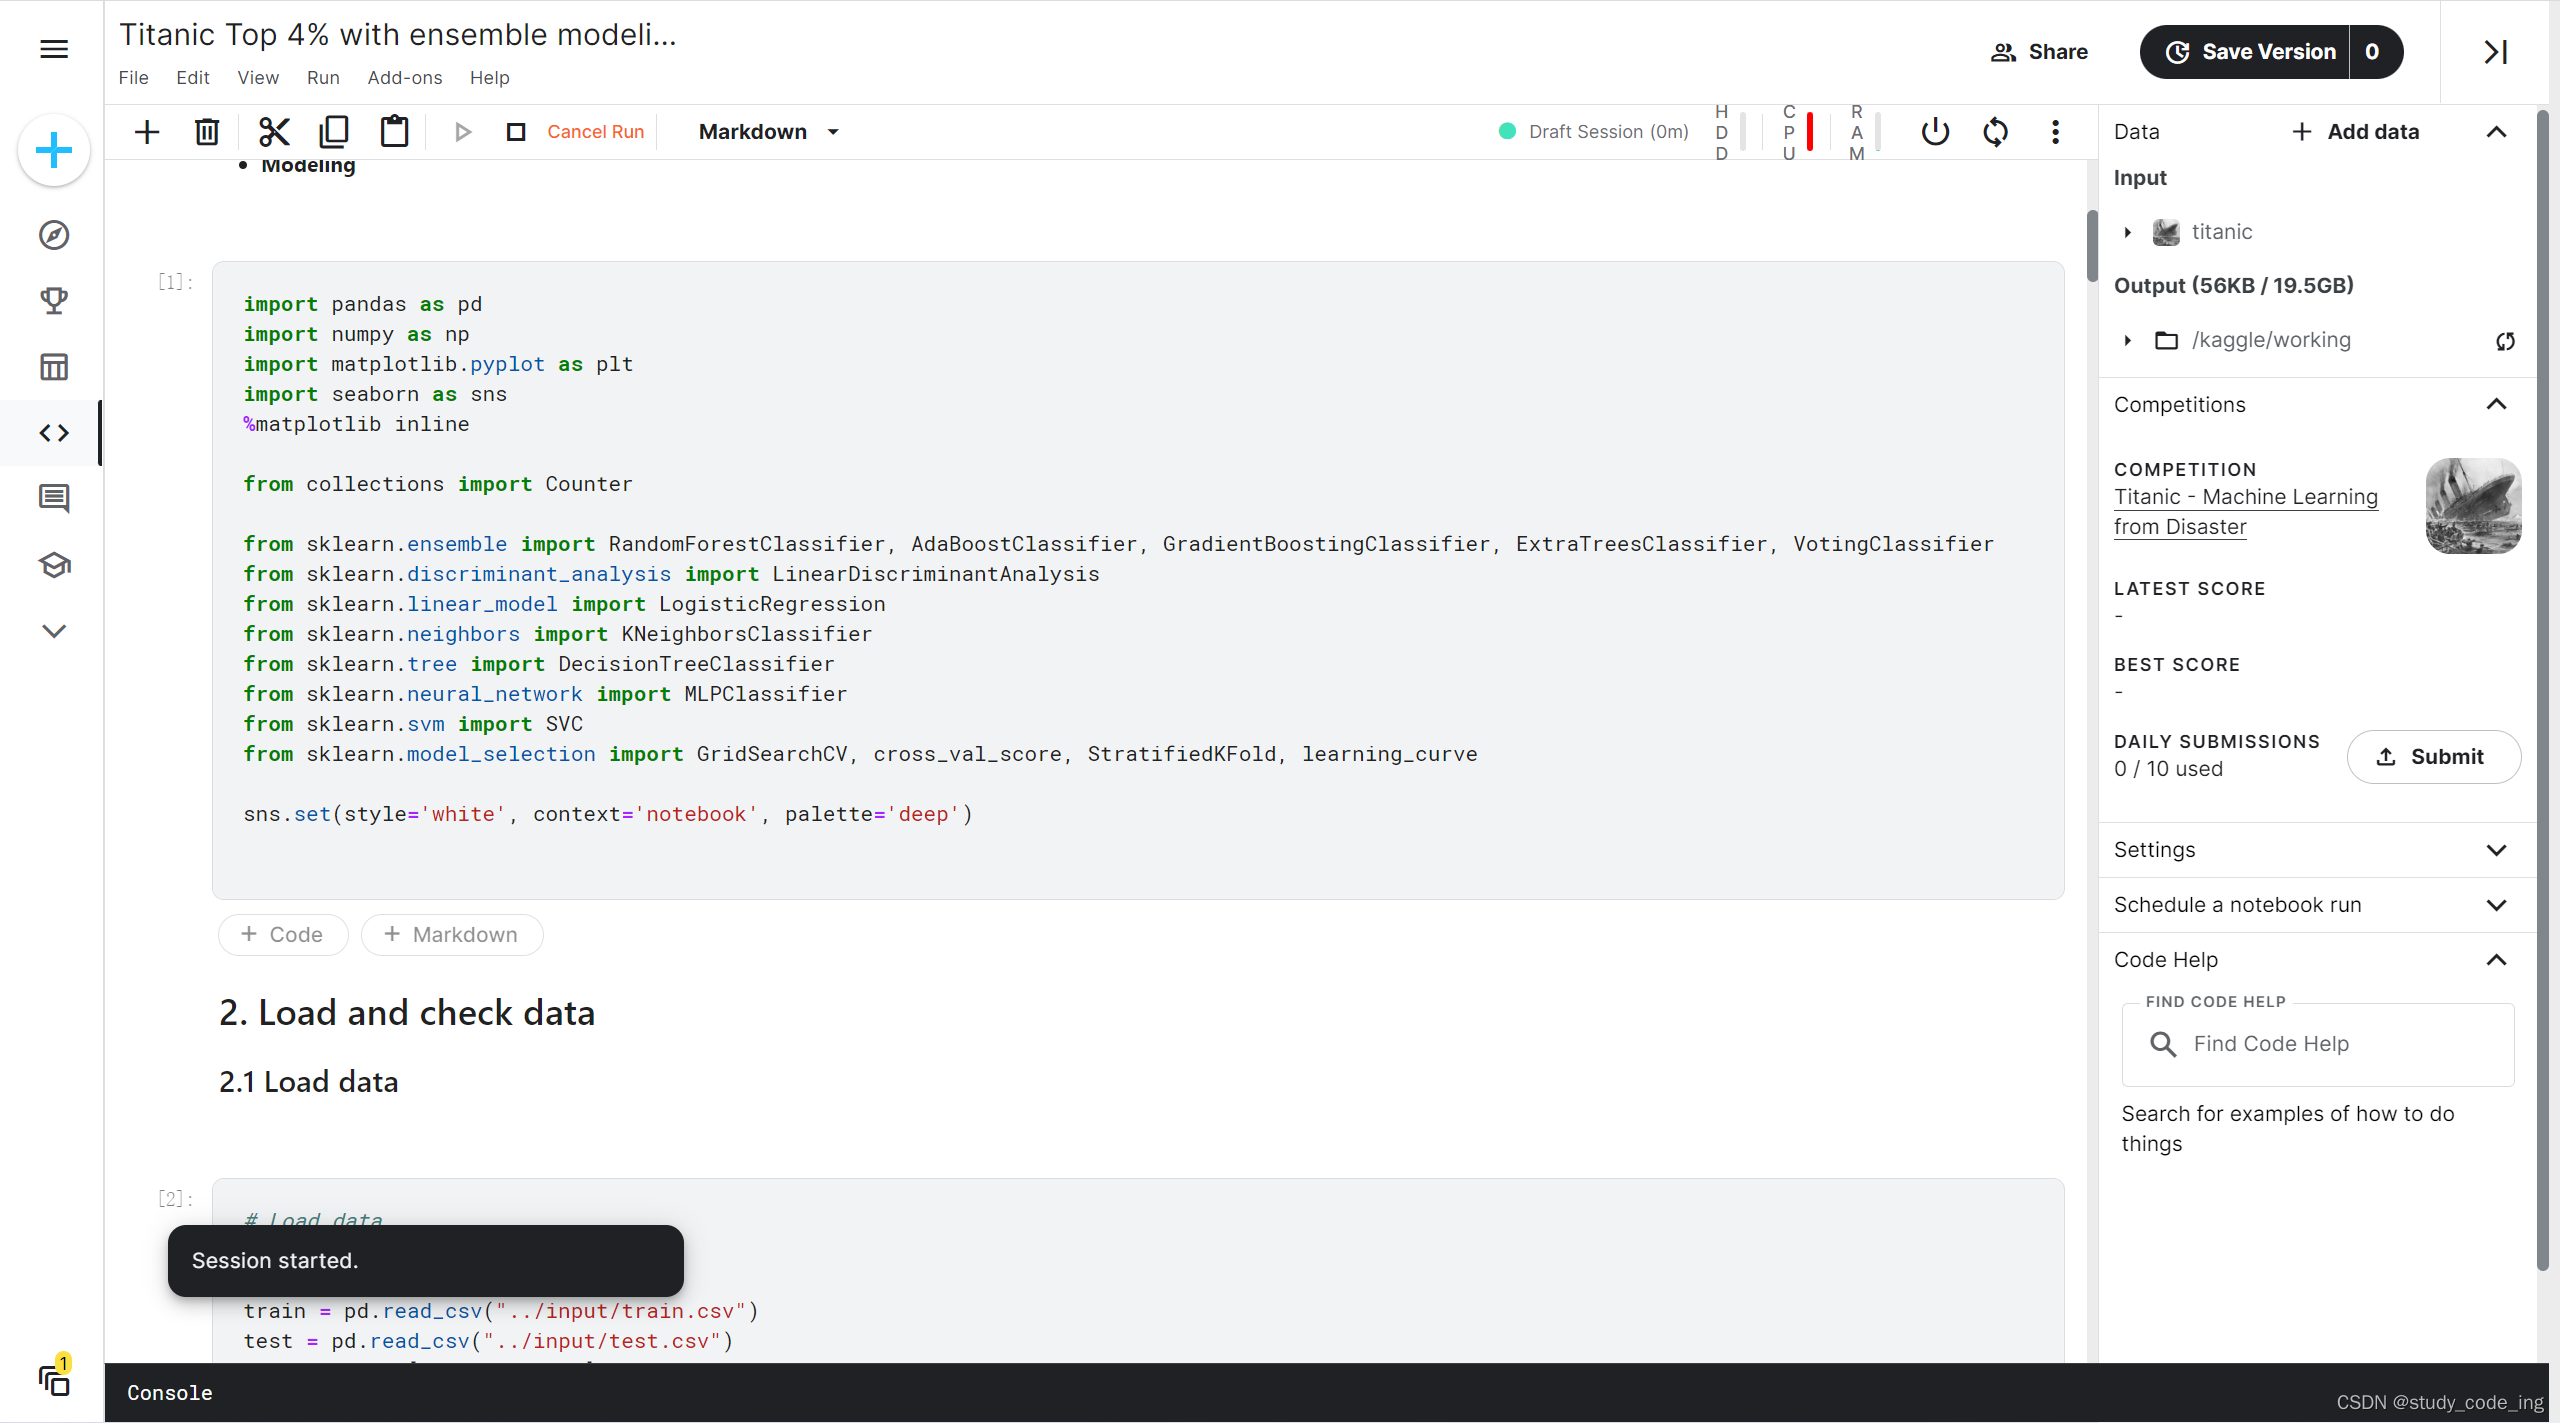
可以看到运行到的位置、结果和报错
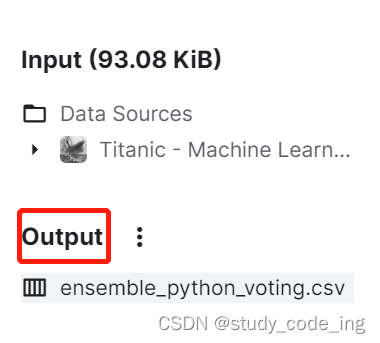
8、在output处下载运行结果

下载结果为压缩包解压即可
三、本地运行

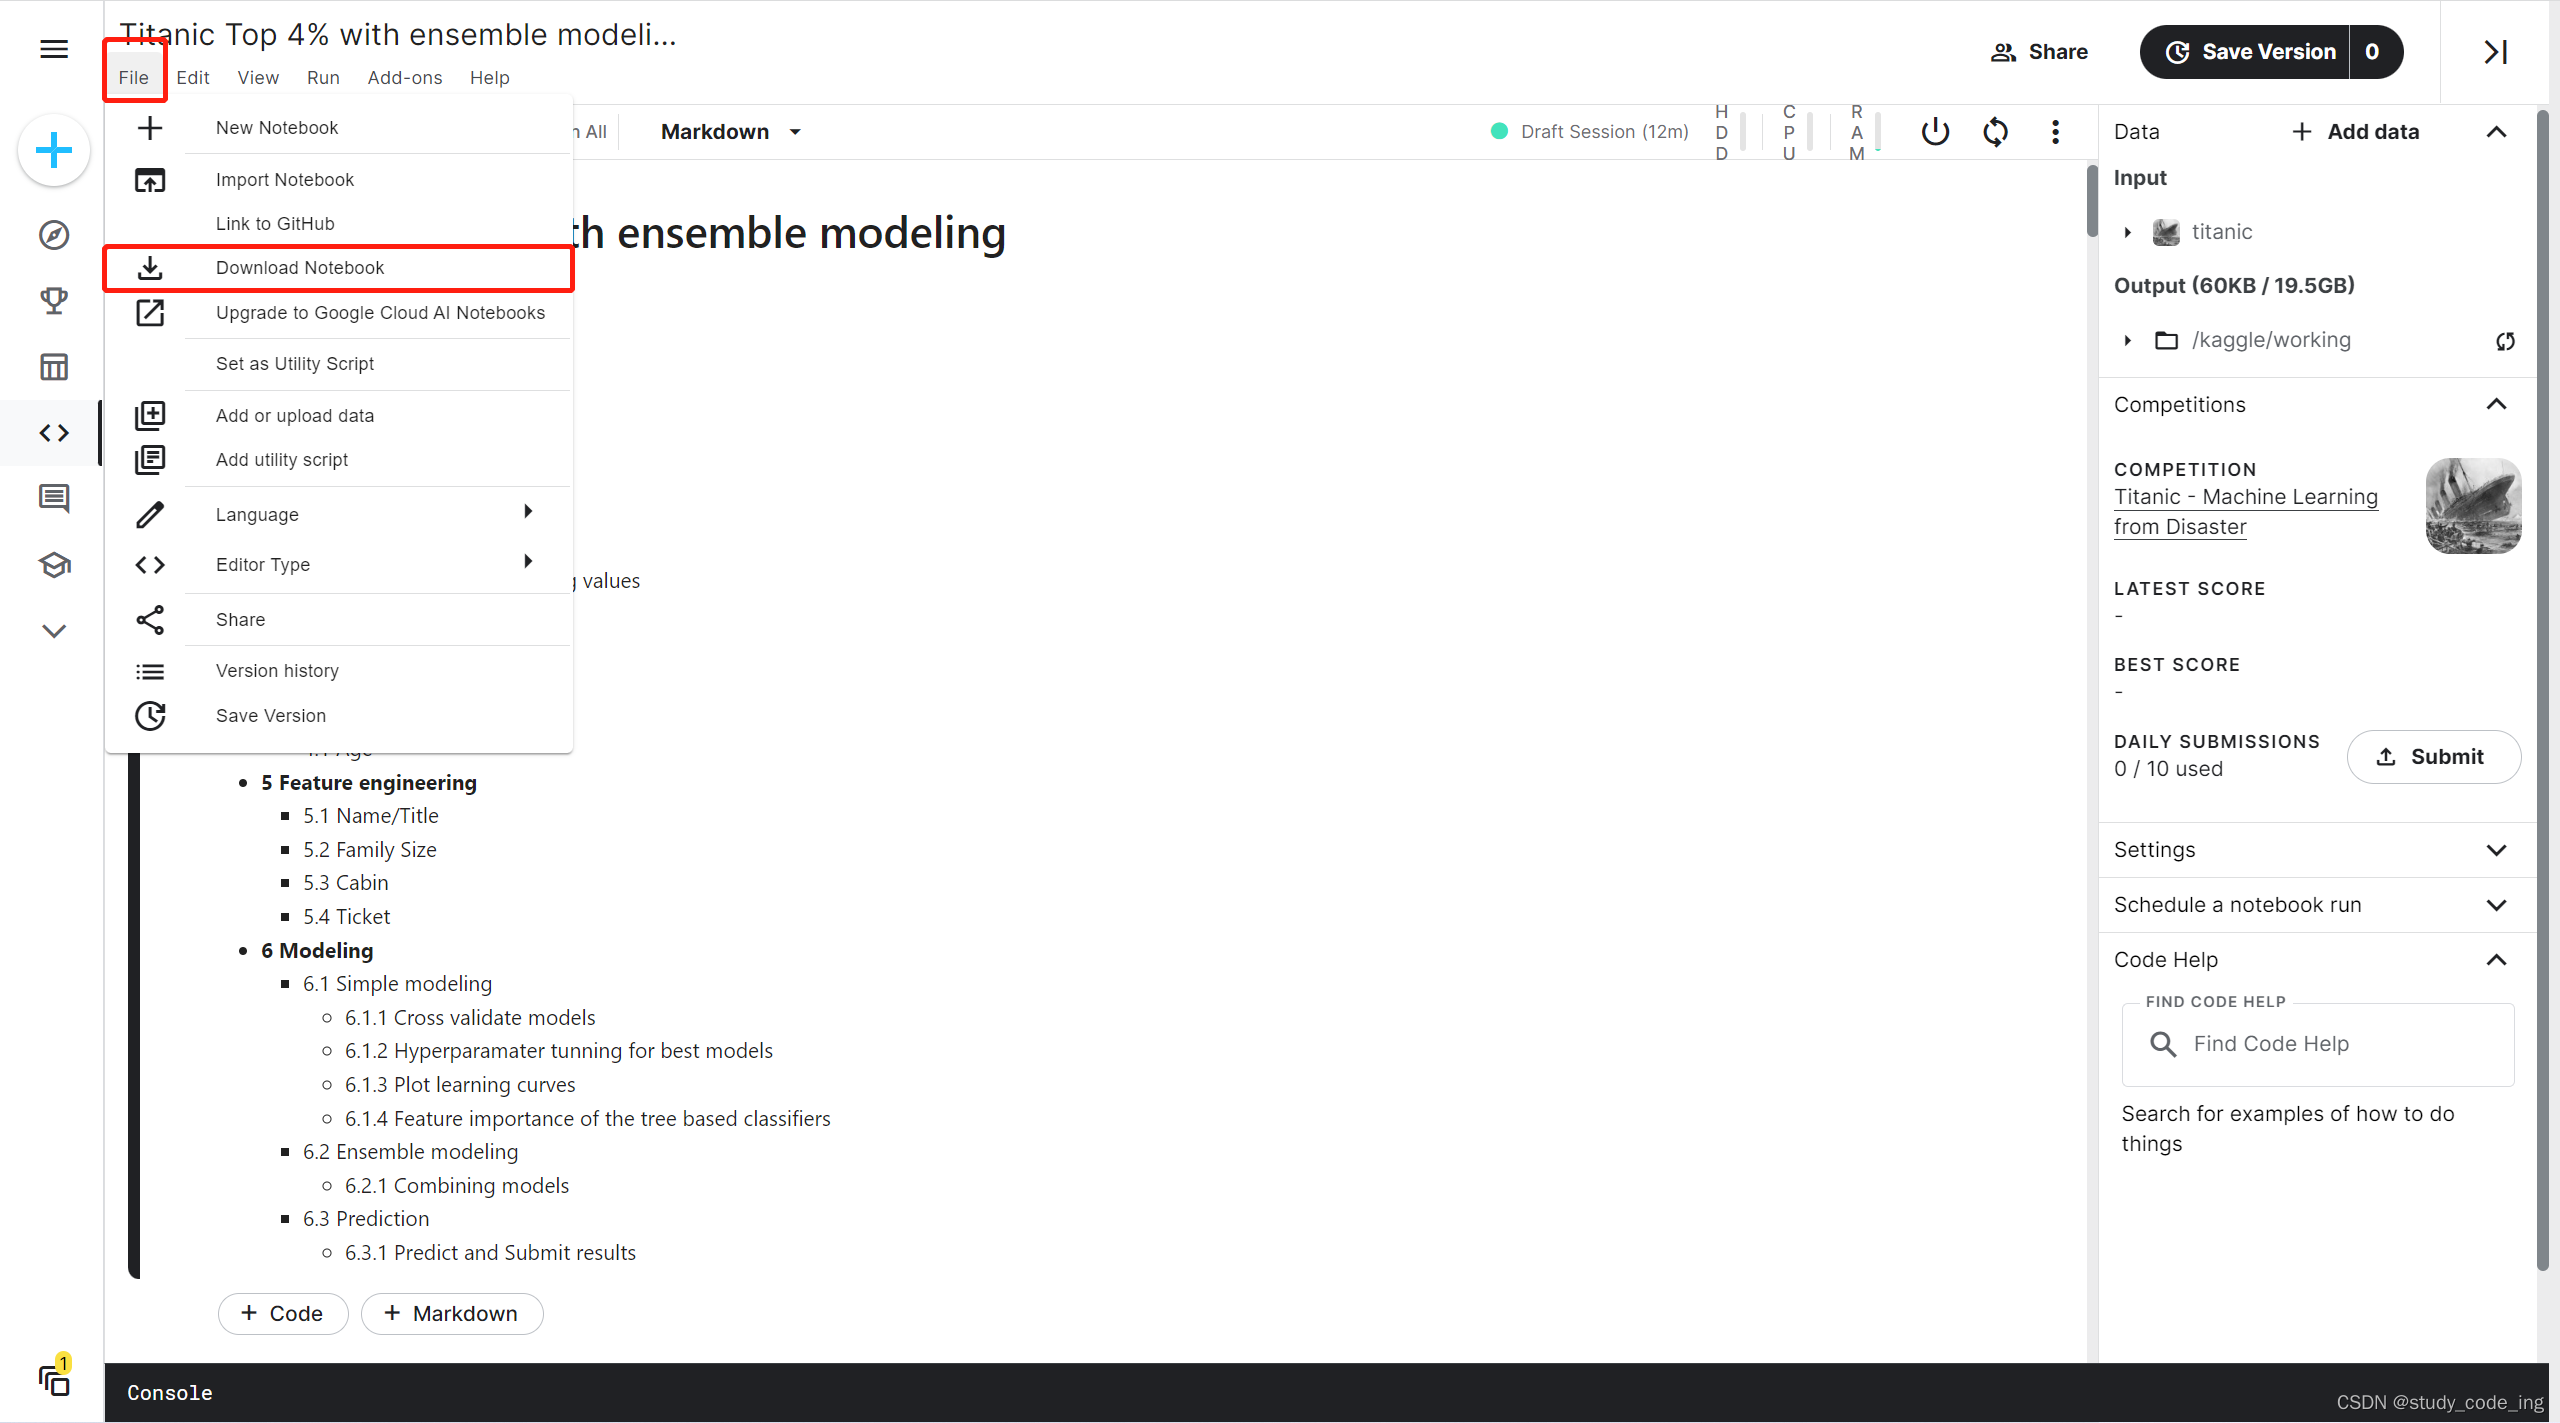
1、在编辑模式下载源代码
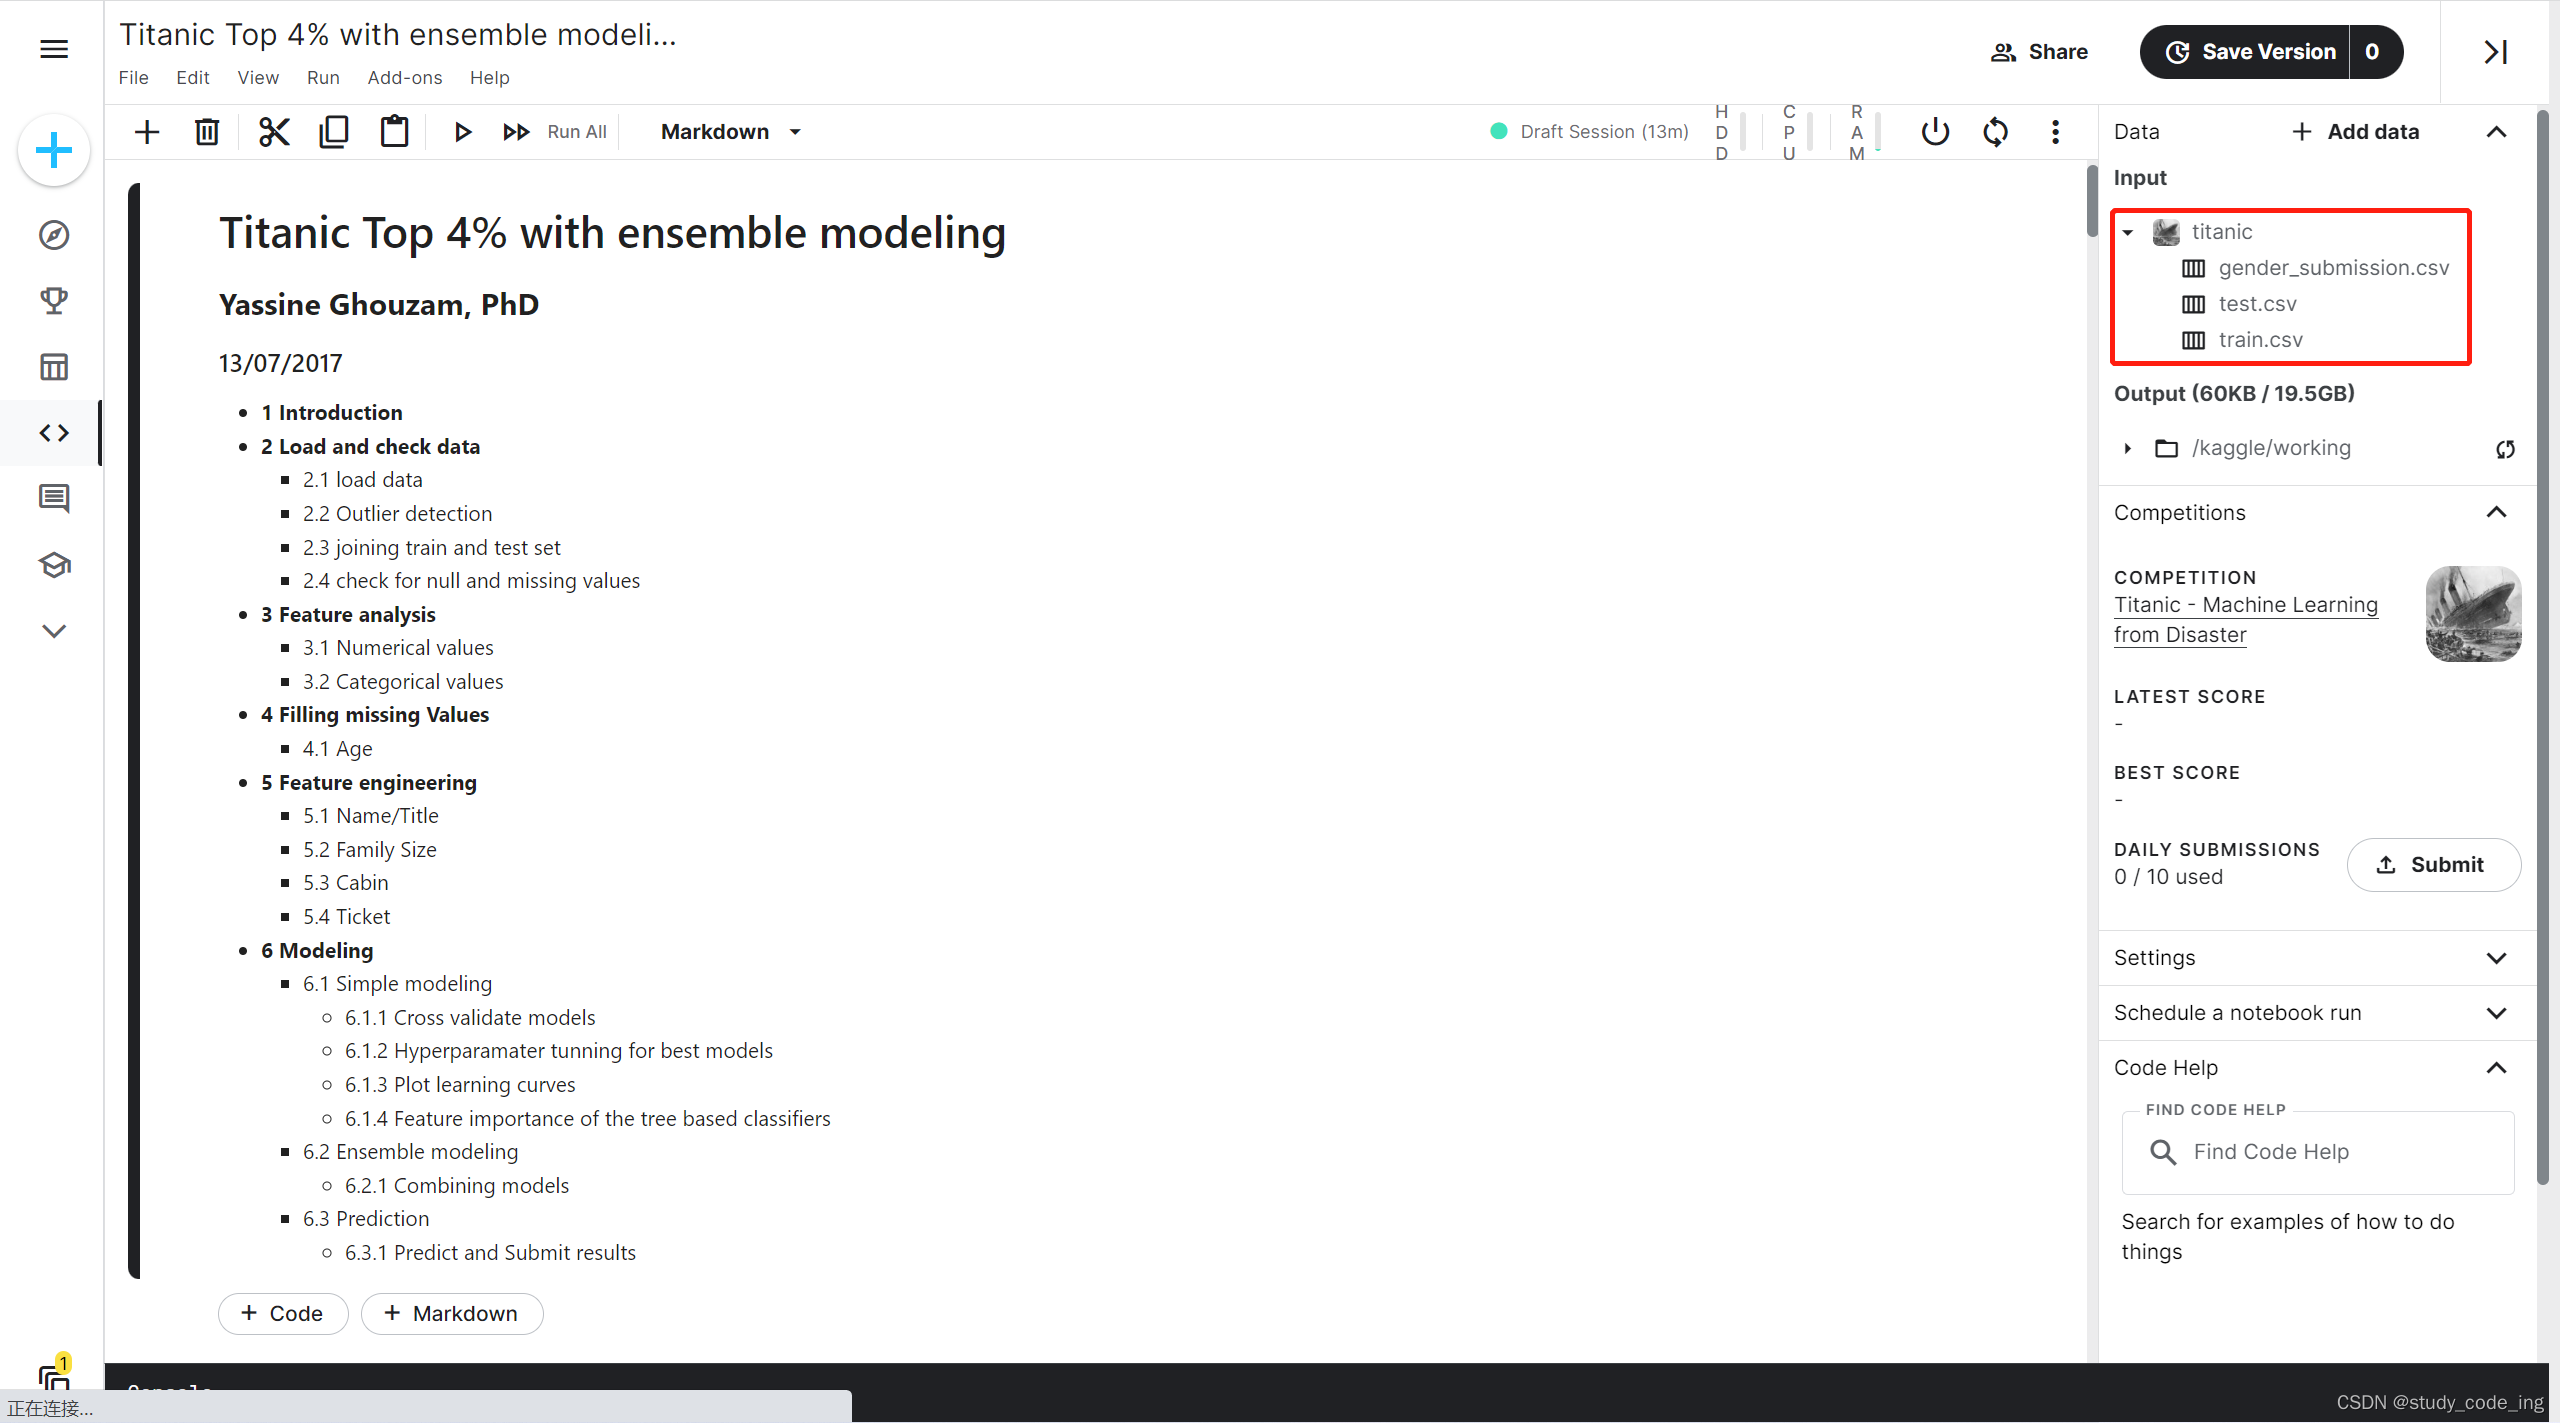
 2、下载数据集
3、创建一个文件夹放置数据集及源代码

4、准备环境

1)确保python环境和pycharm安装完成

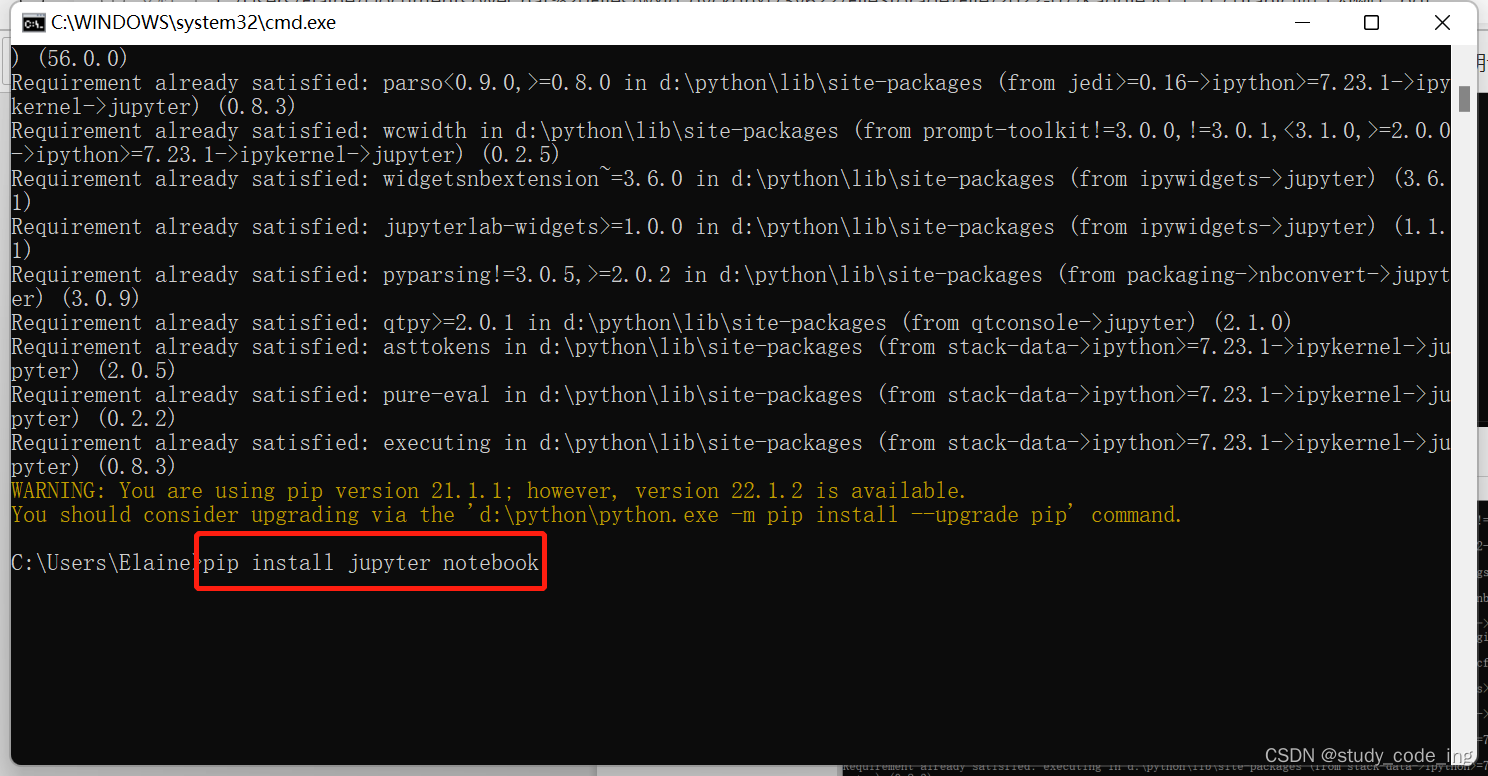
2)下载jupyter

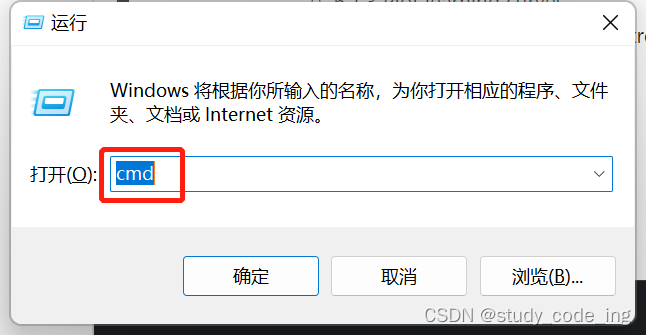
window+R,然后输入cmd,enter回车 
输入以下命令
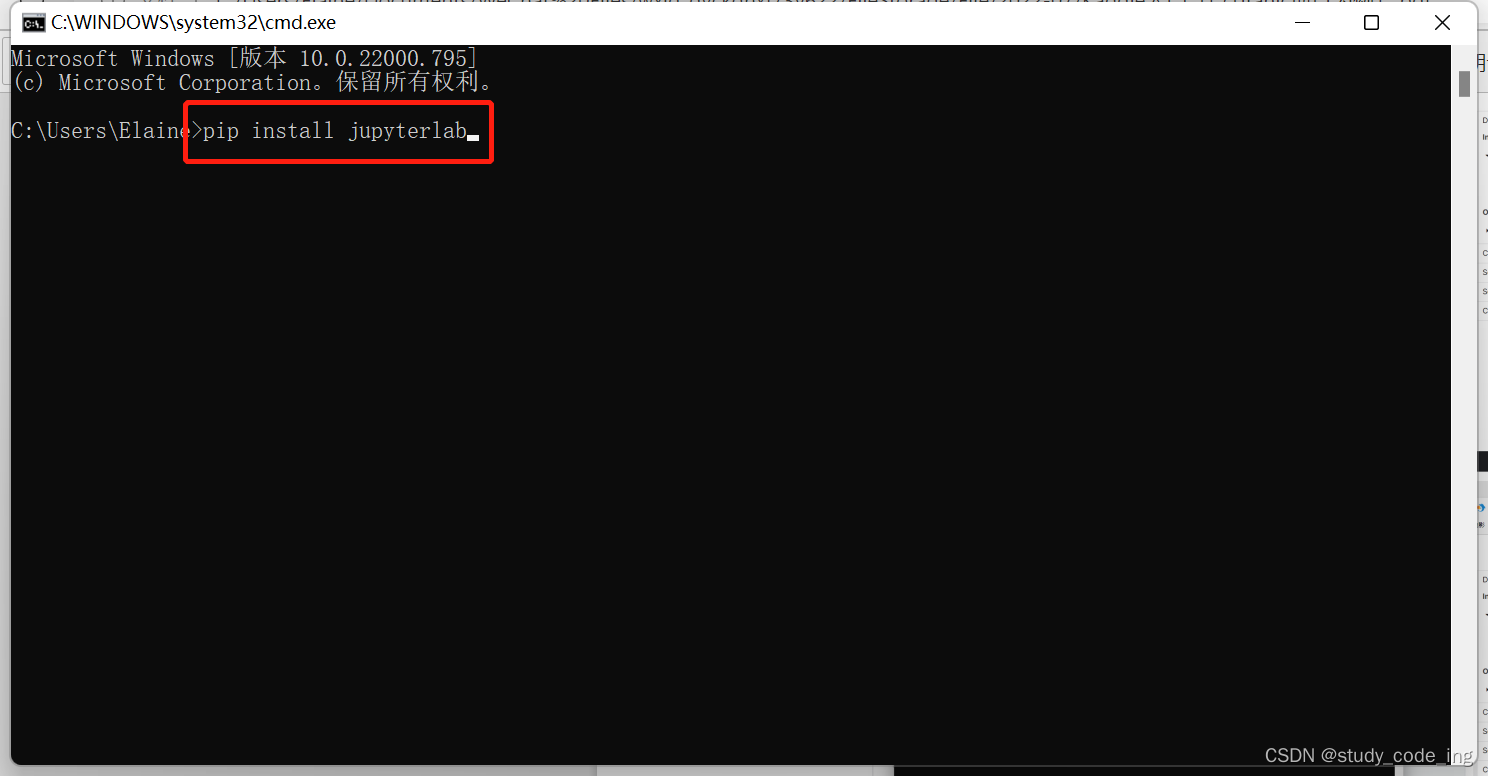
显示successful即为安装成功

3)在pycharm中打开项目文件(文件你刚刚下载新建的文件夹)
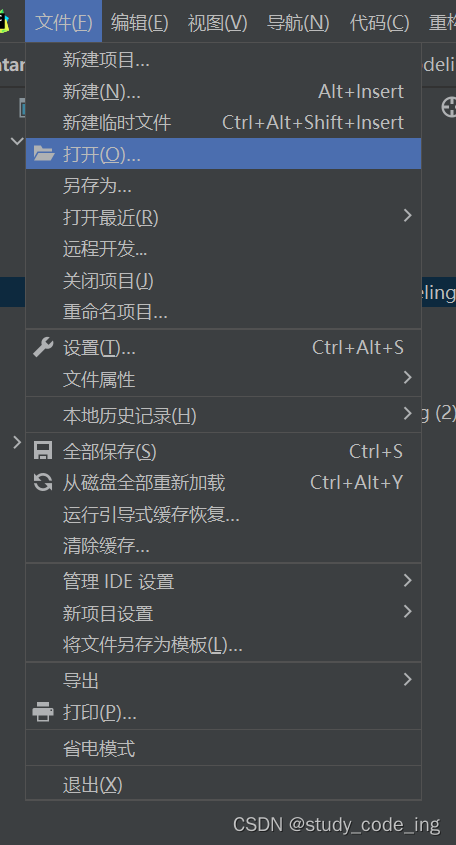
 

4)点击下载的源代码即可打开下载的代码 
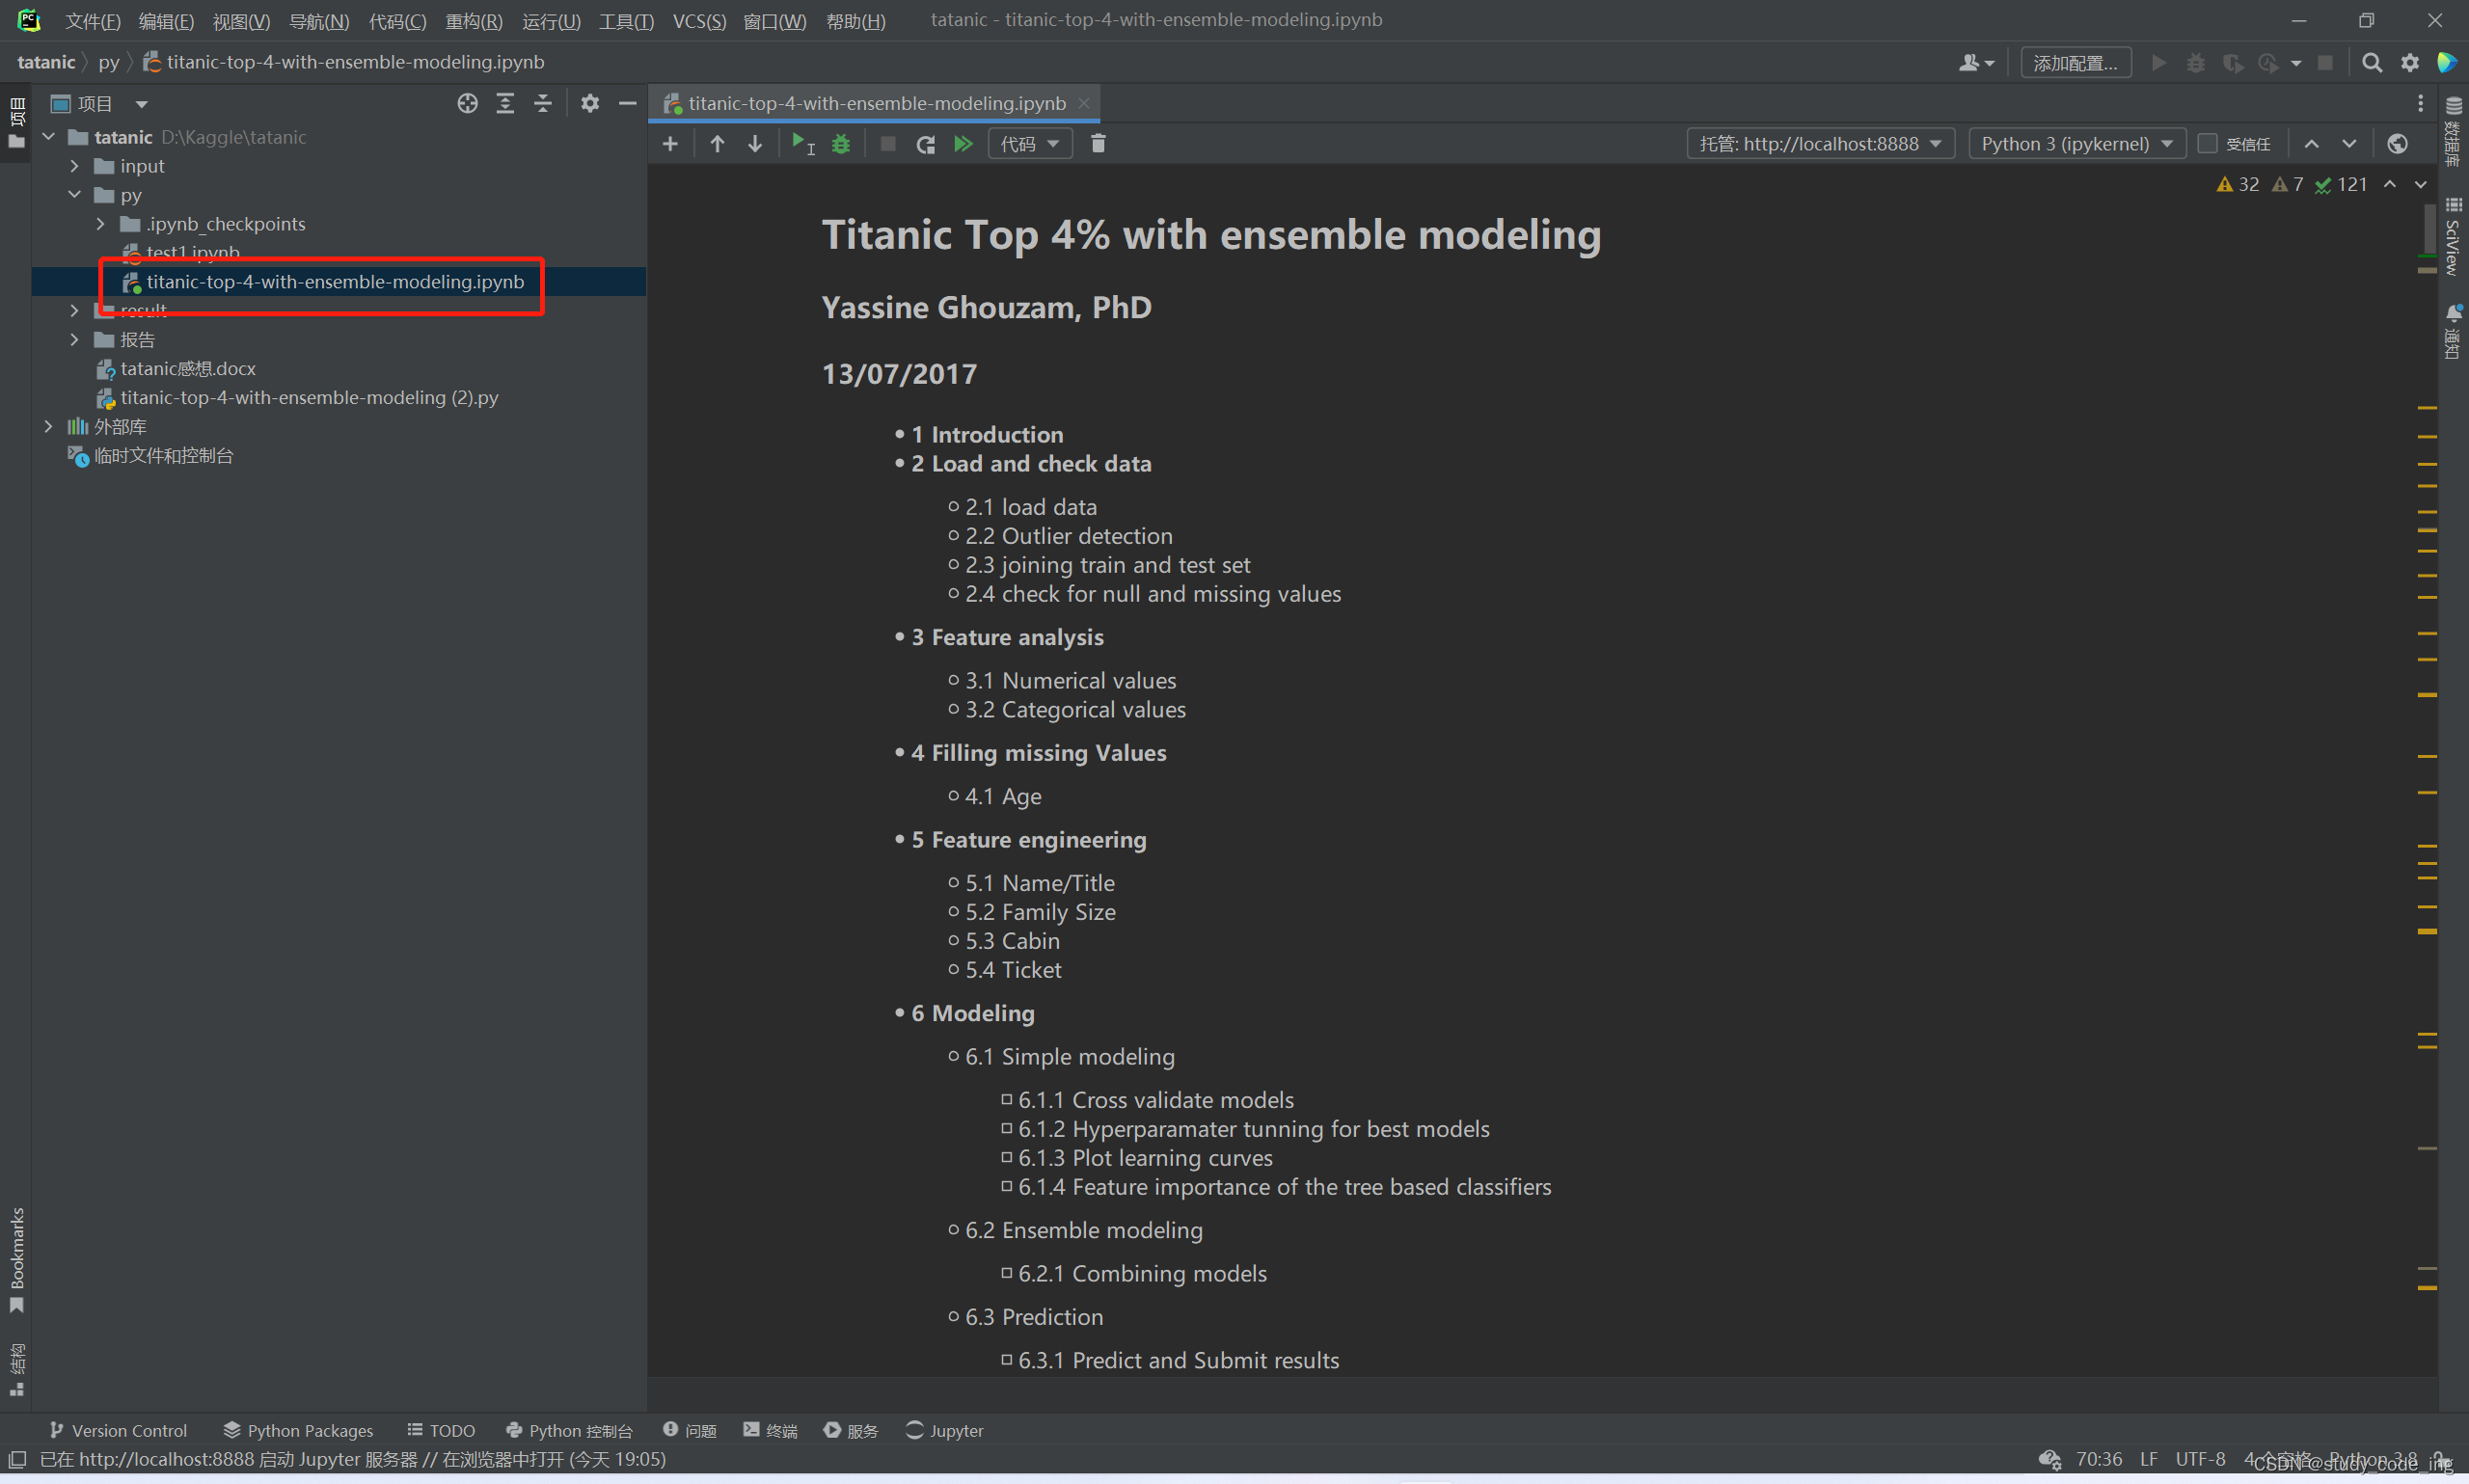
5)下载需要的库

如果库下面带有红色波浪线是没有下载的原因
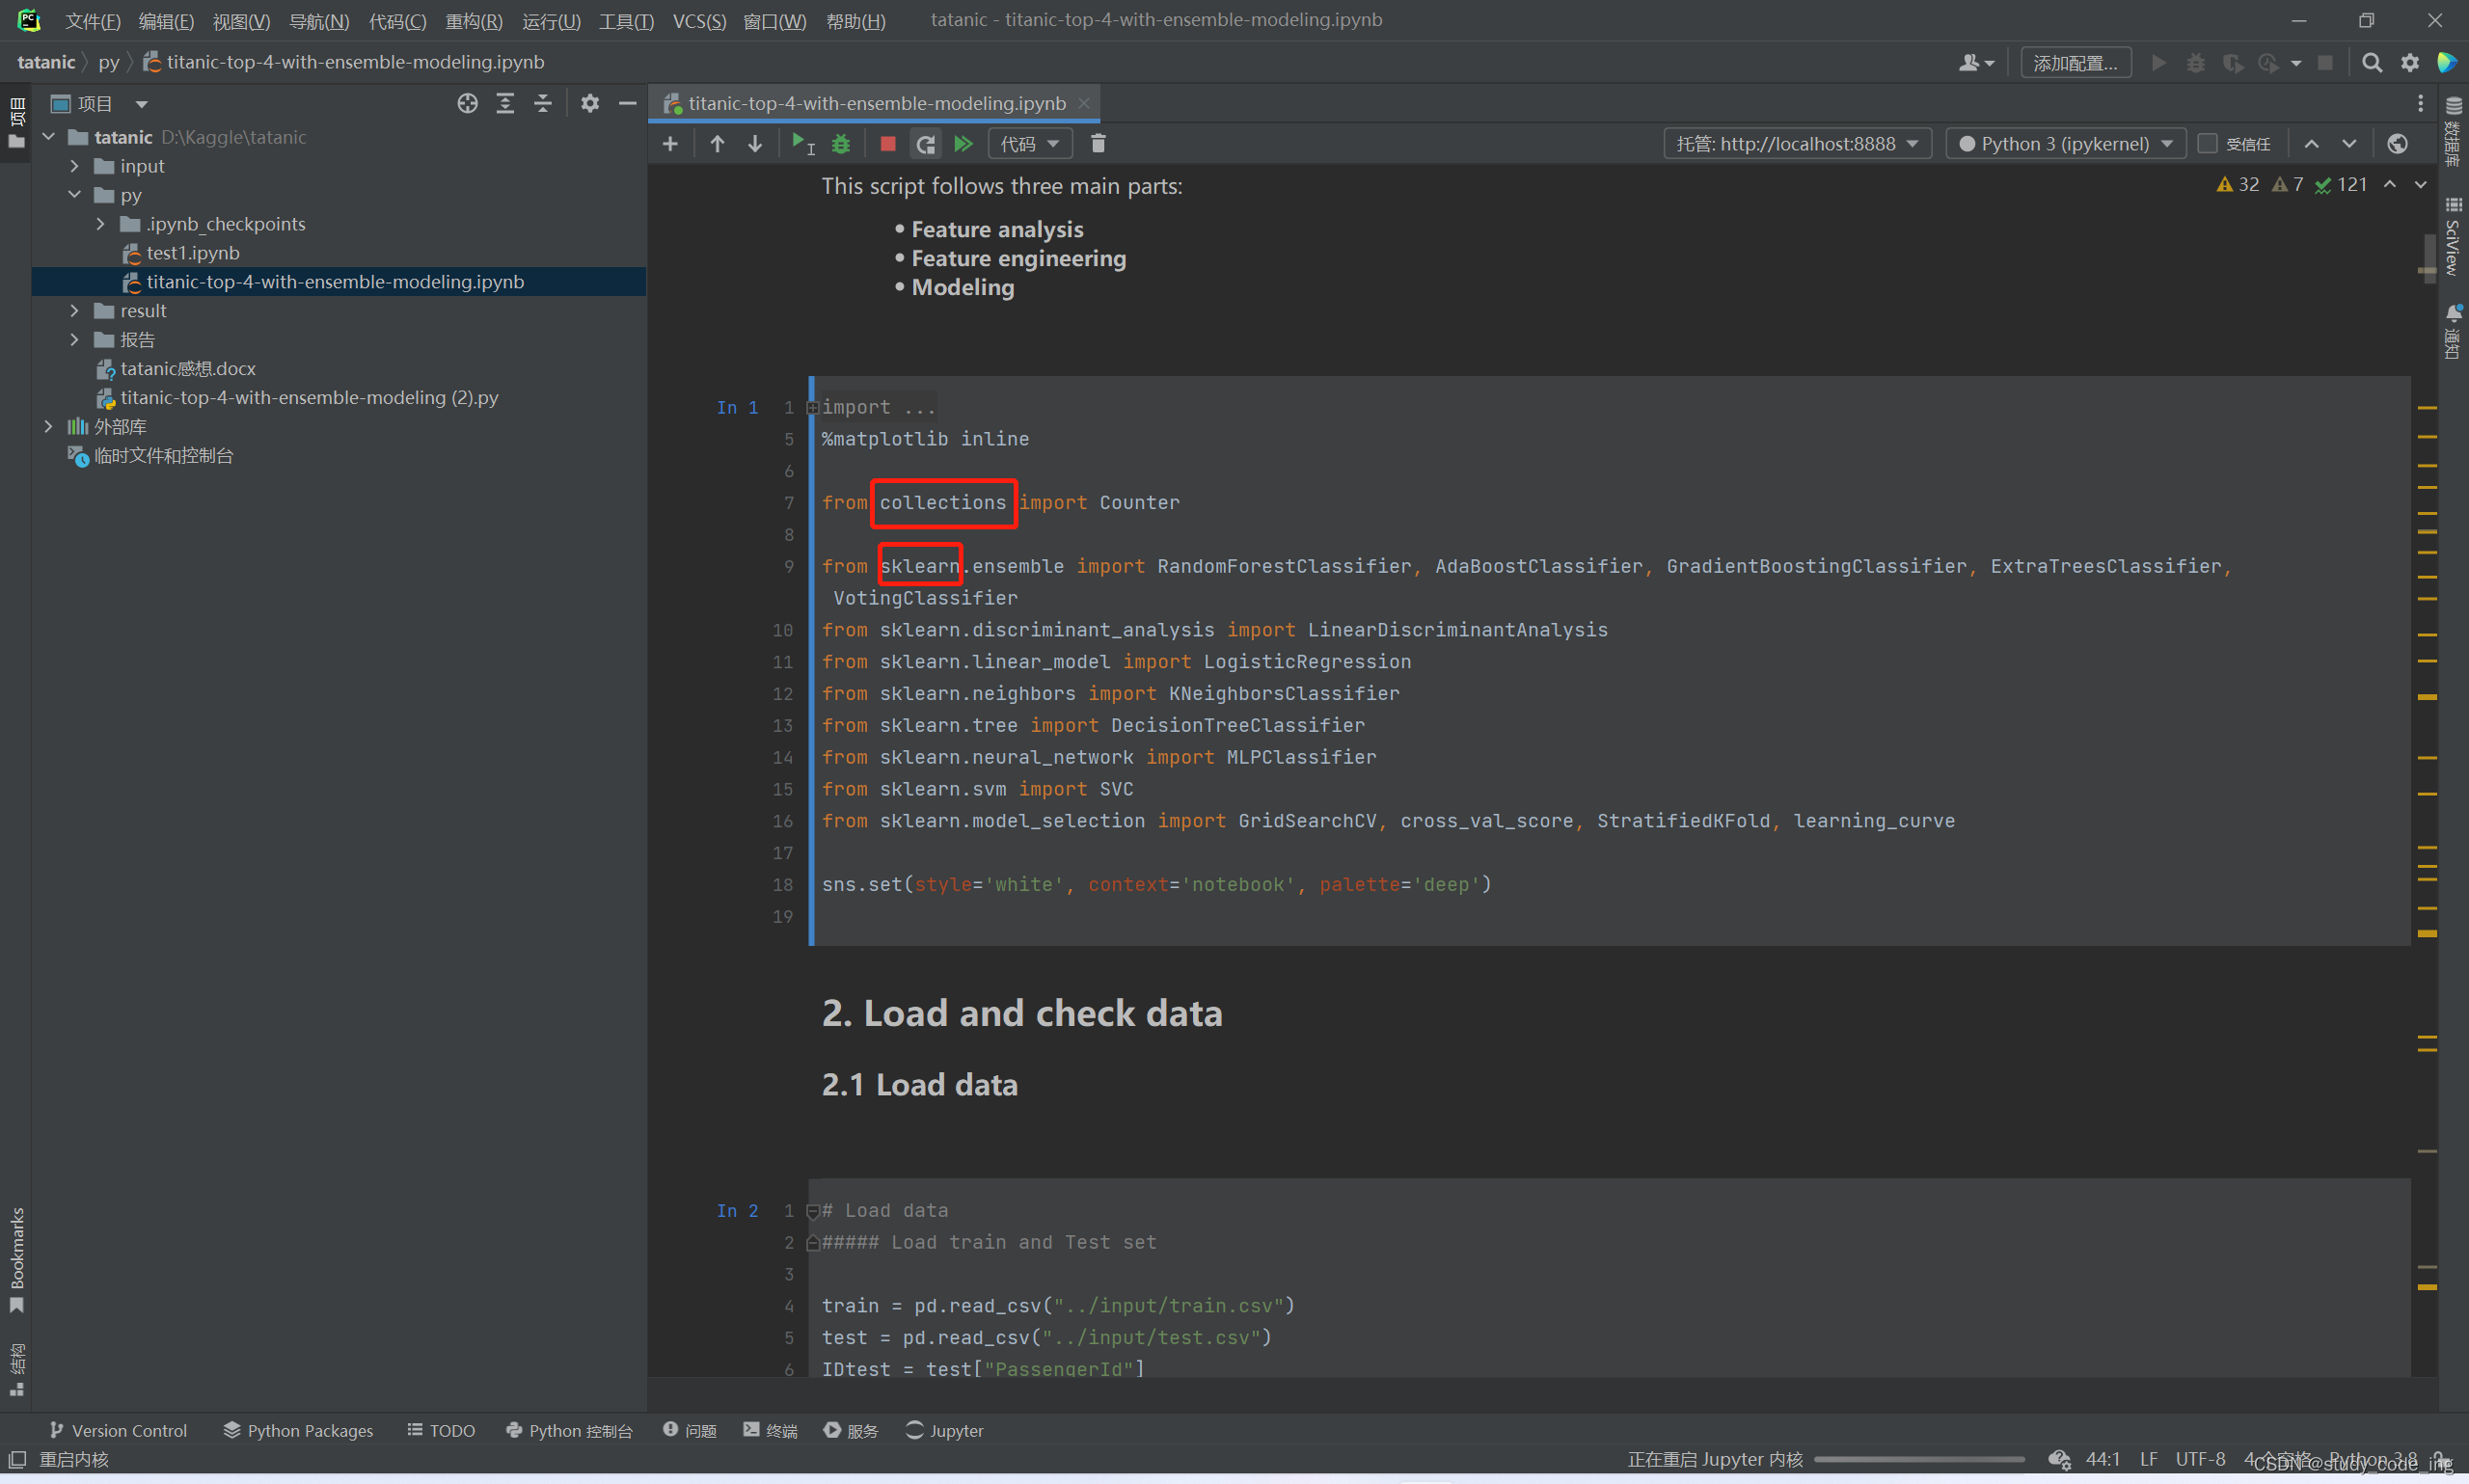
下载方法如二:

第一,鼠标放过去会显示安装,点击安装即可(一次好像只能安装一个,一起安装好像会安装失败)

第二、点文件设置
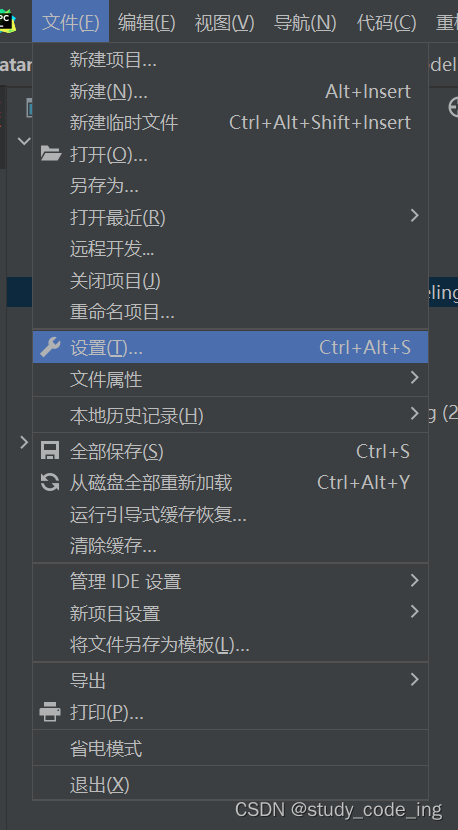
点对应的项目(此处tatanic打错,应为titanic)后带你python编辑器 
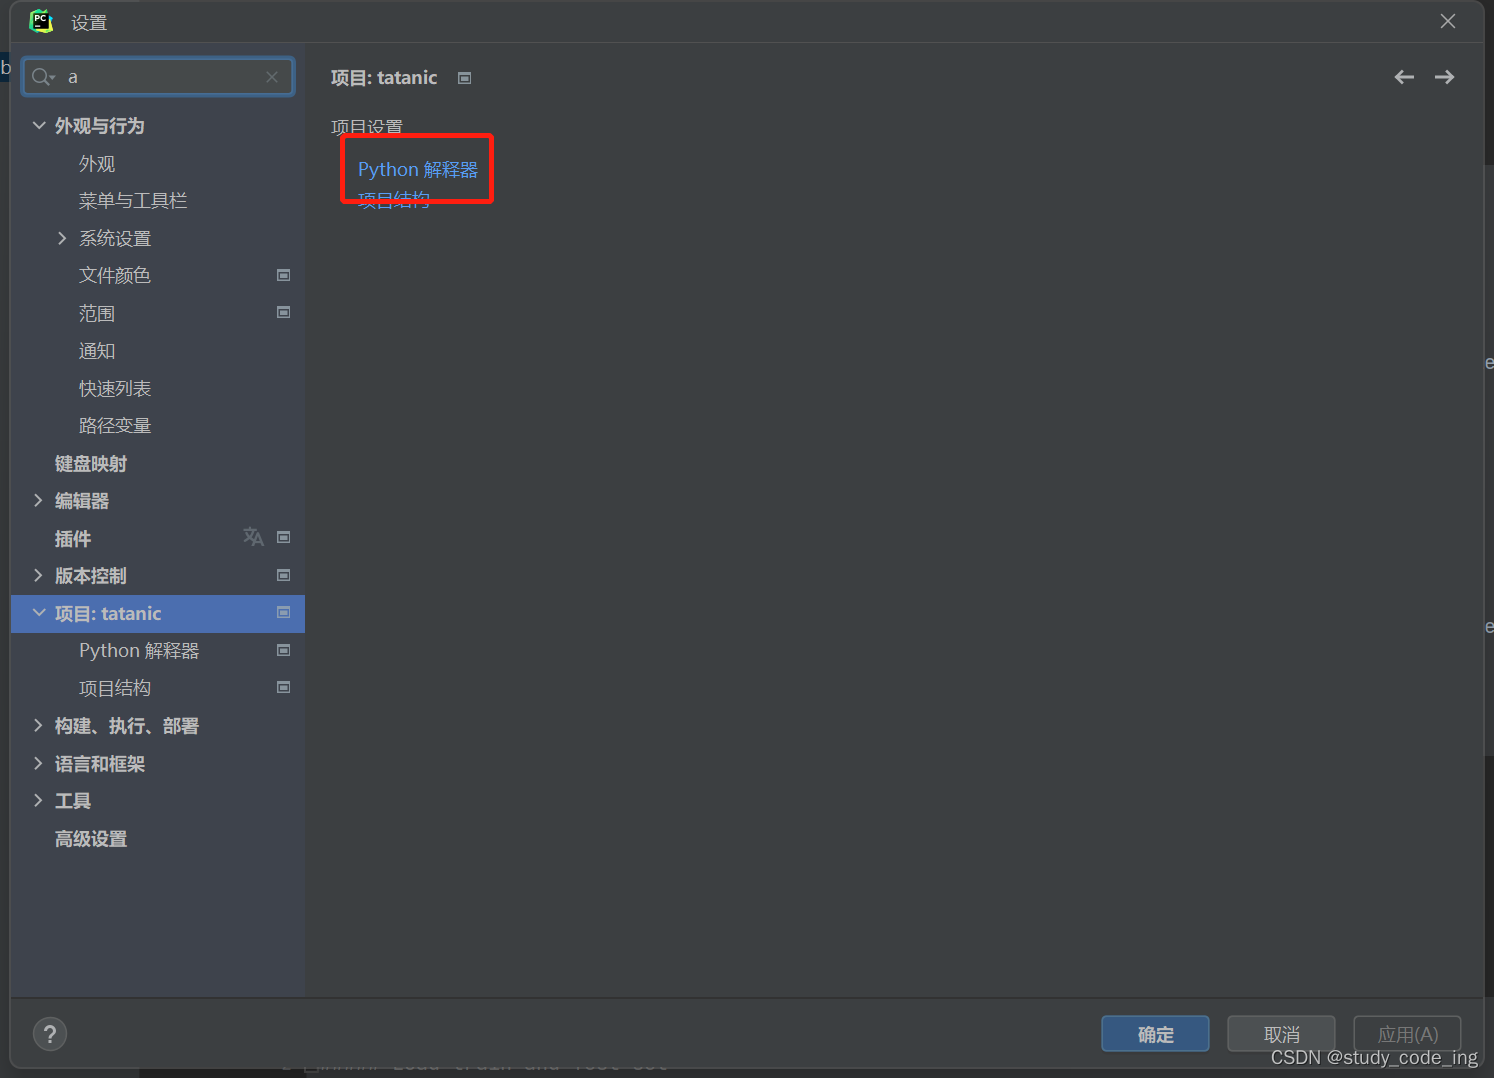
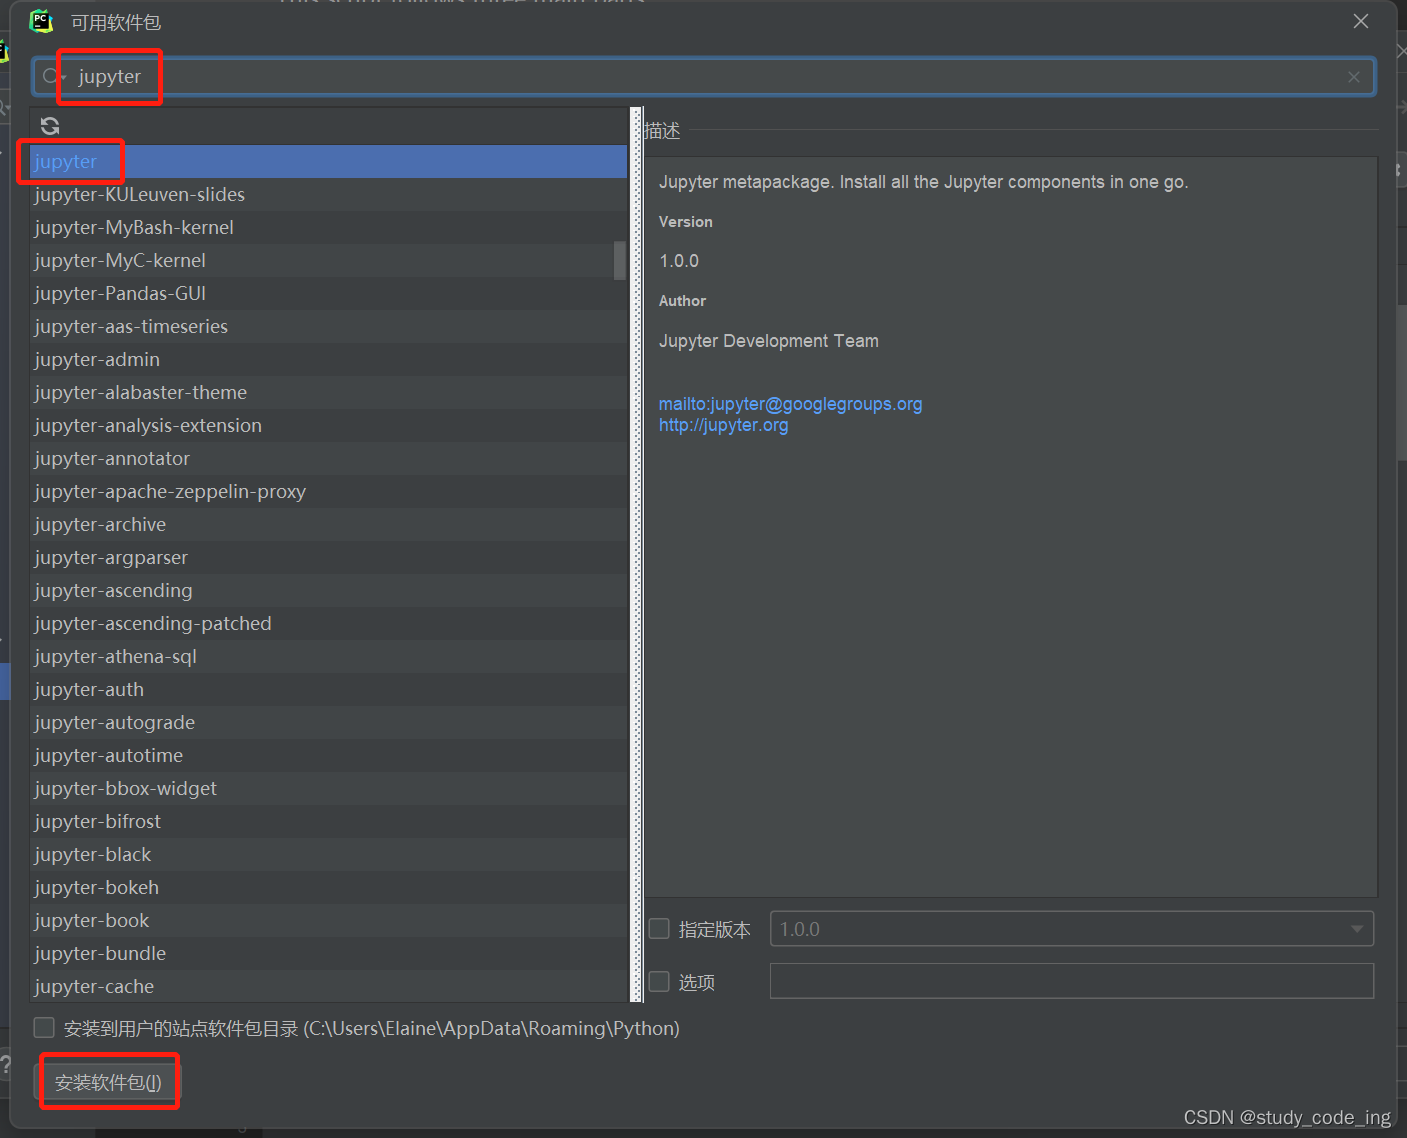
点+号
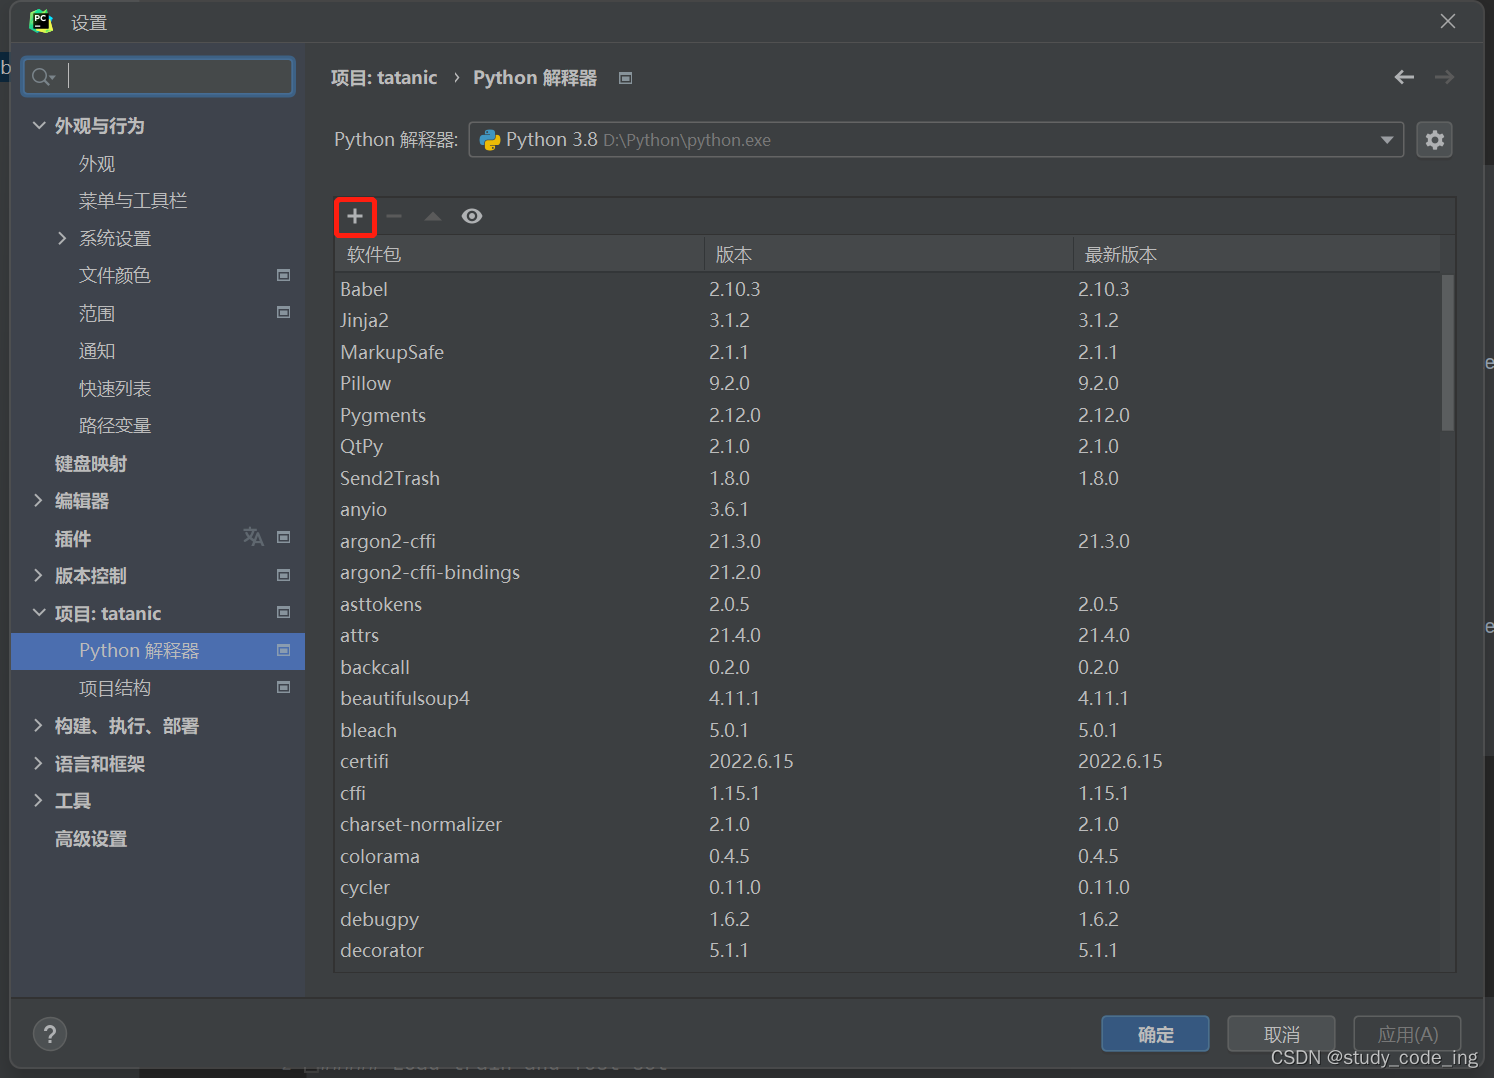
搜索需要安装的库的名称,找到对应的安装即可
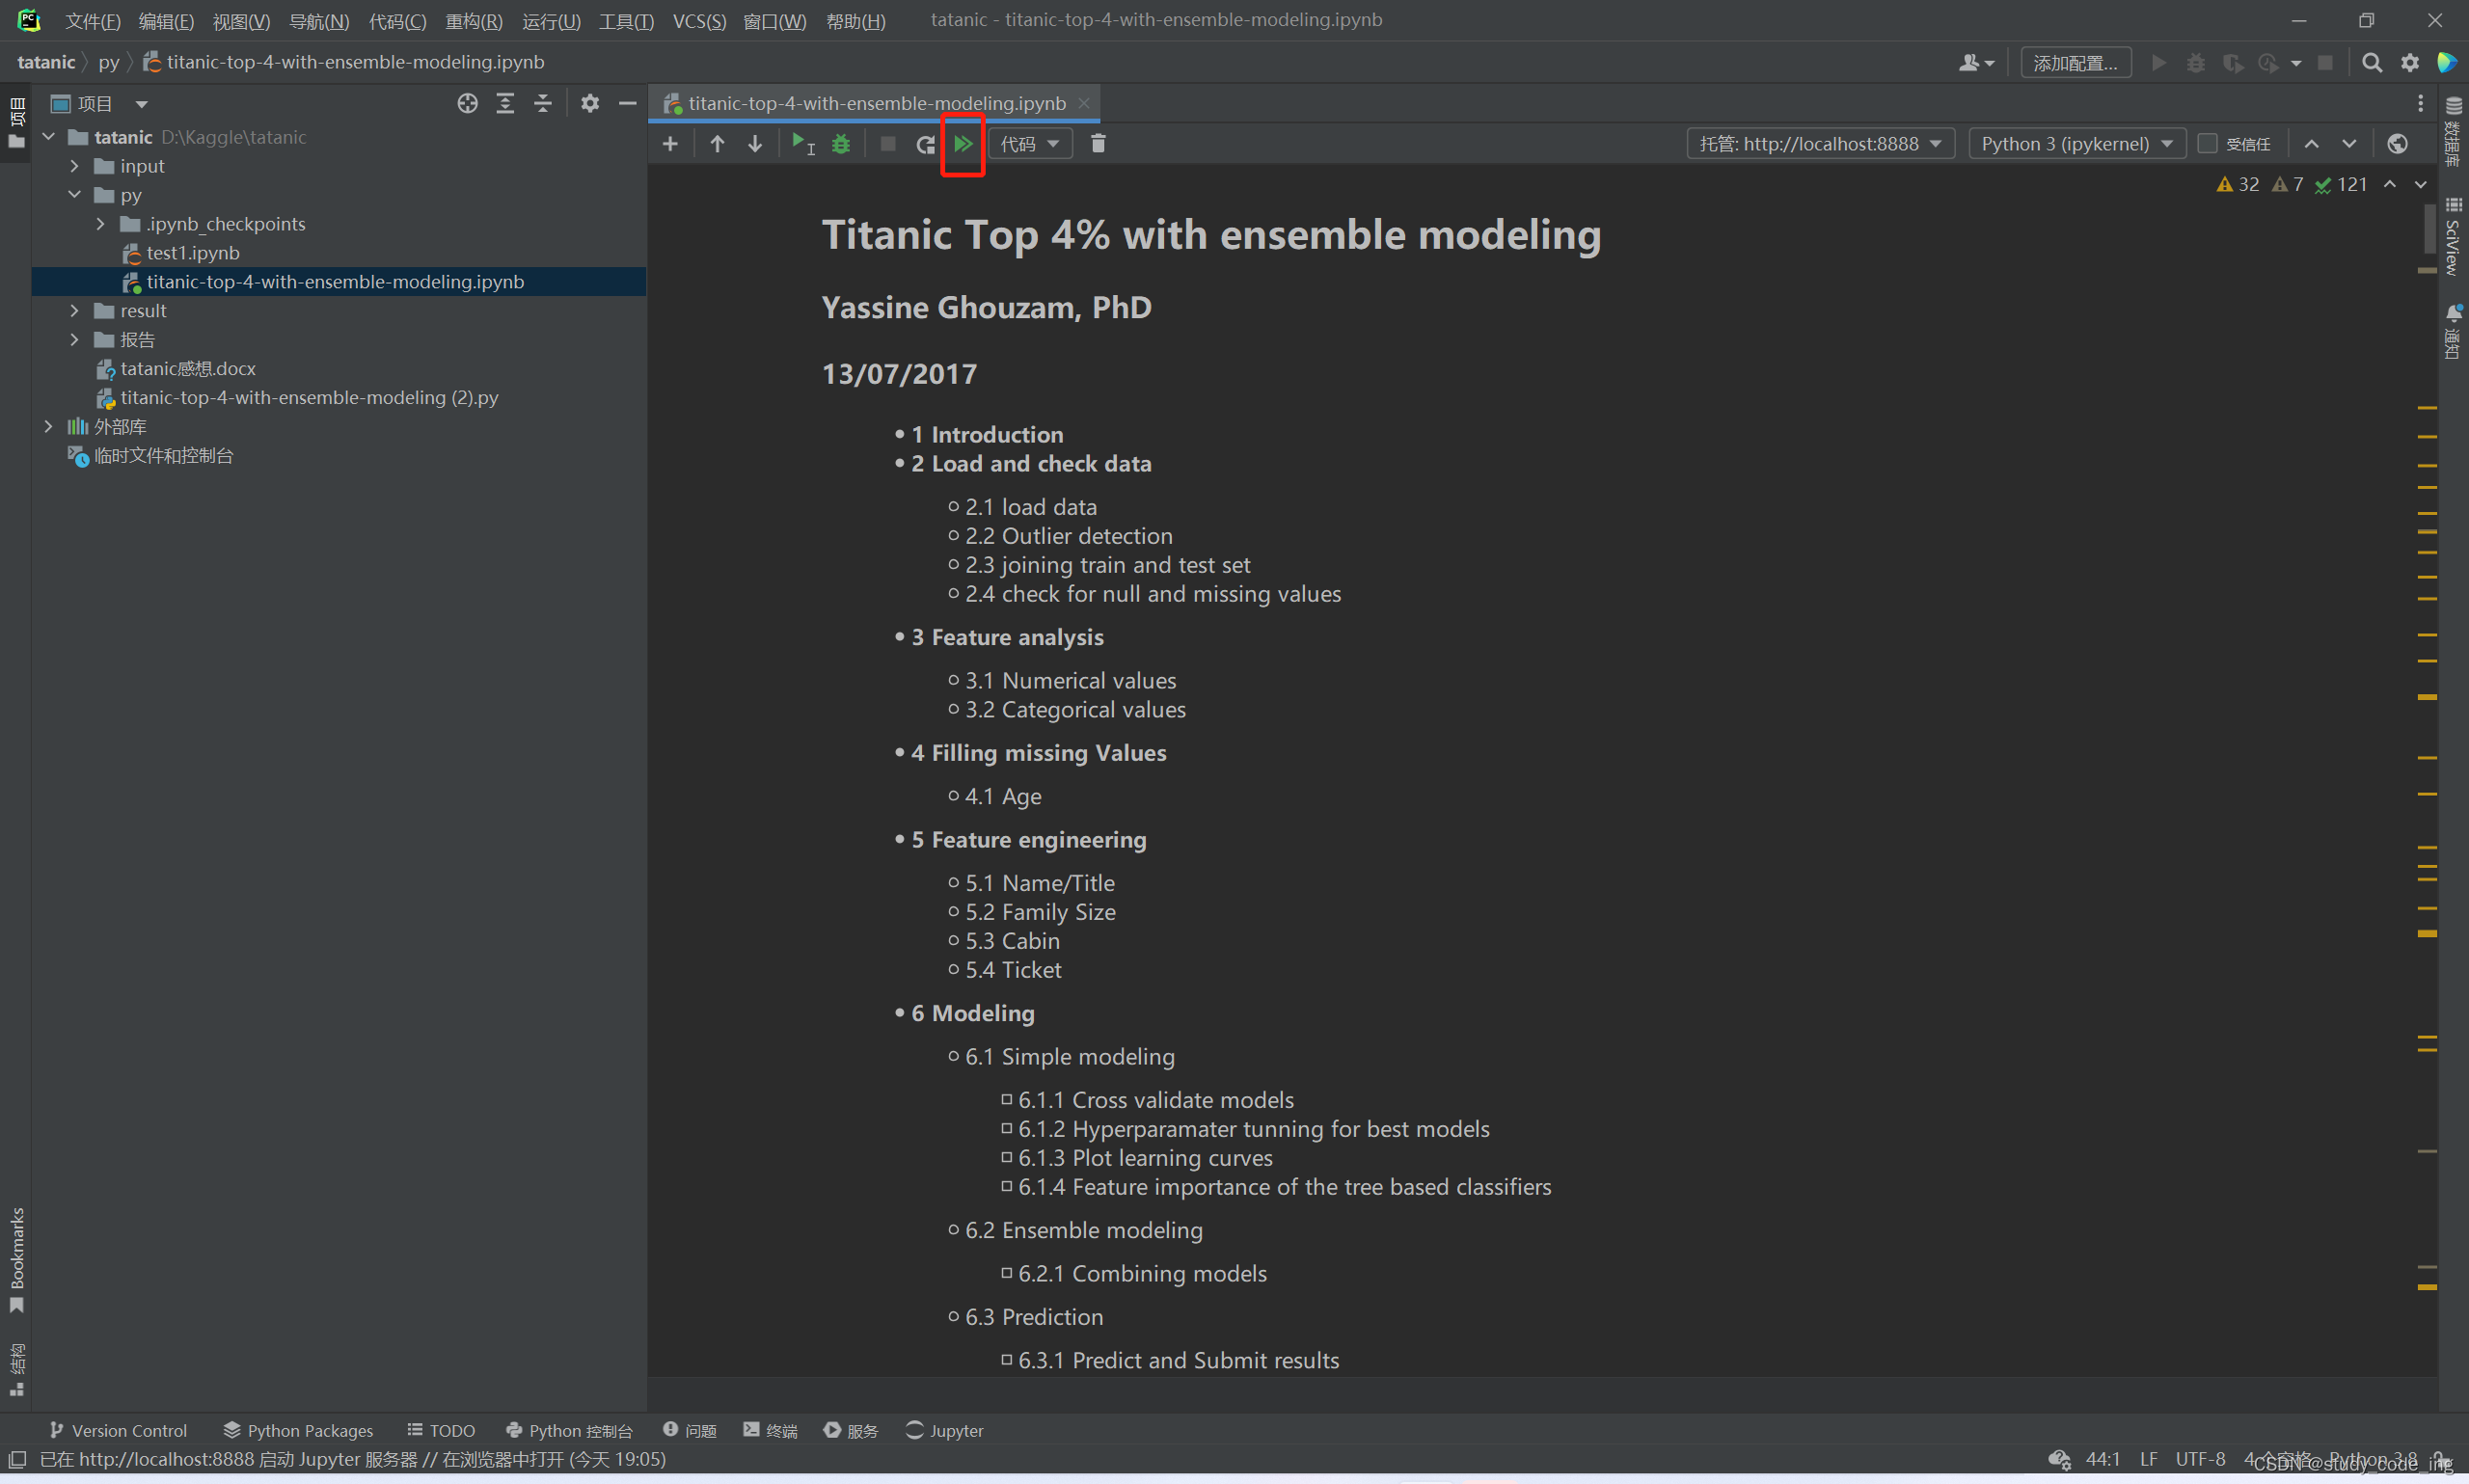
6)点击此可全部运行 

也可以点击此左侧三角分布运行(shift+enter 为下一步),运行完成后可看到运行结果
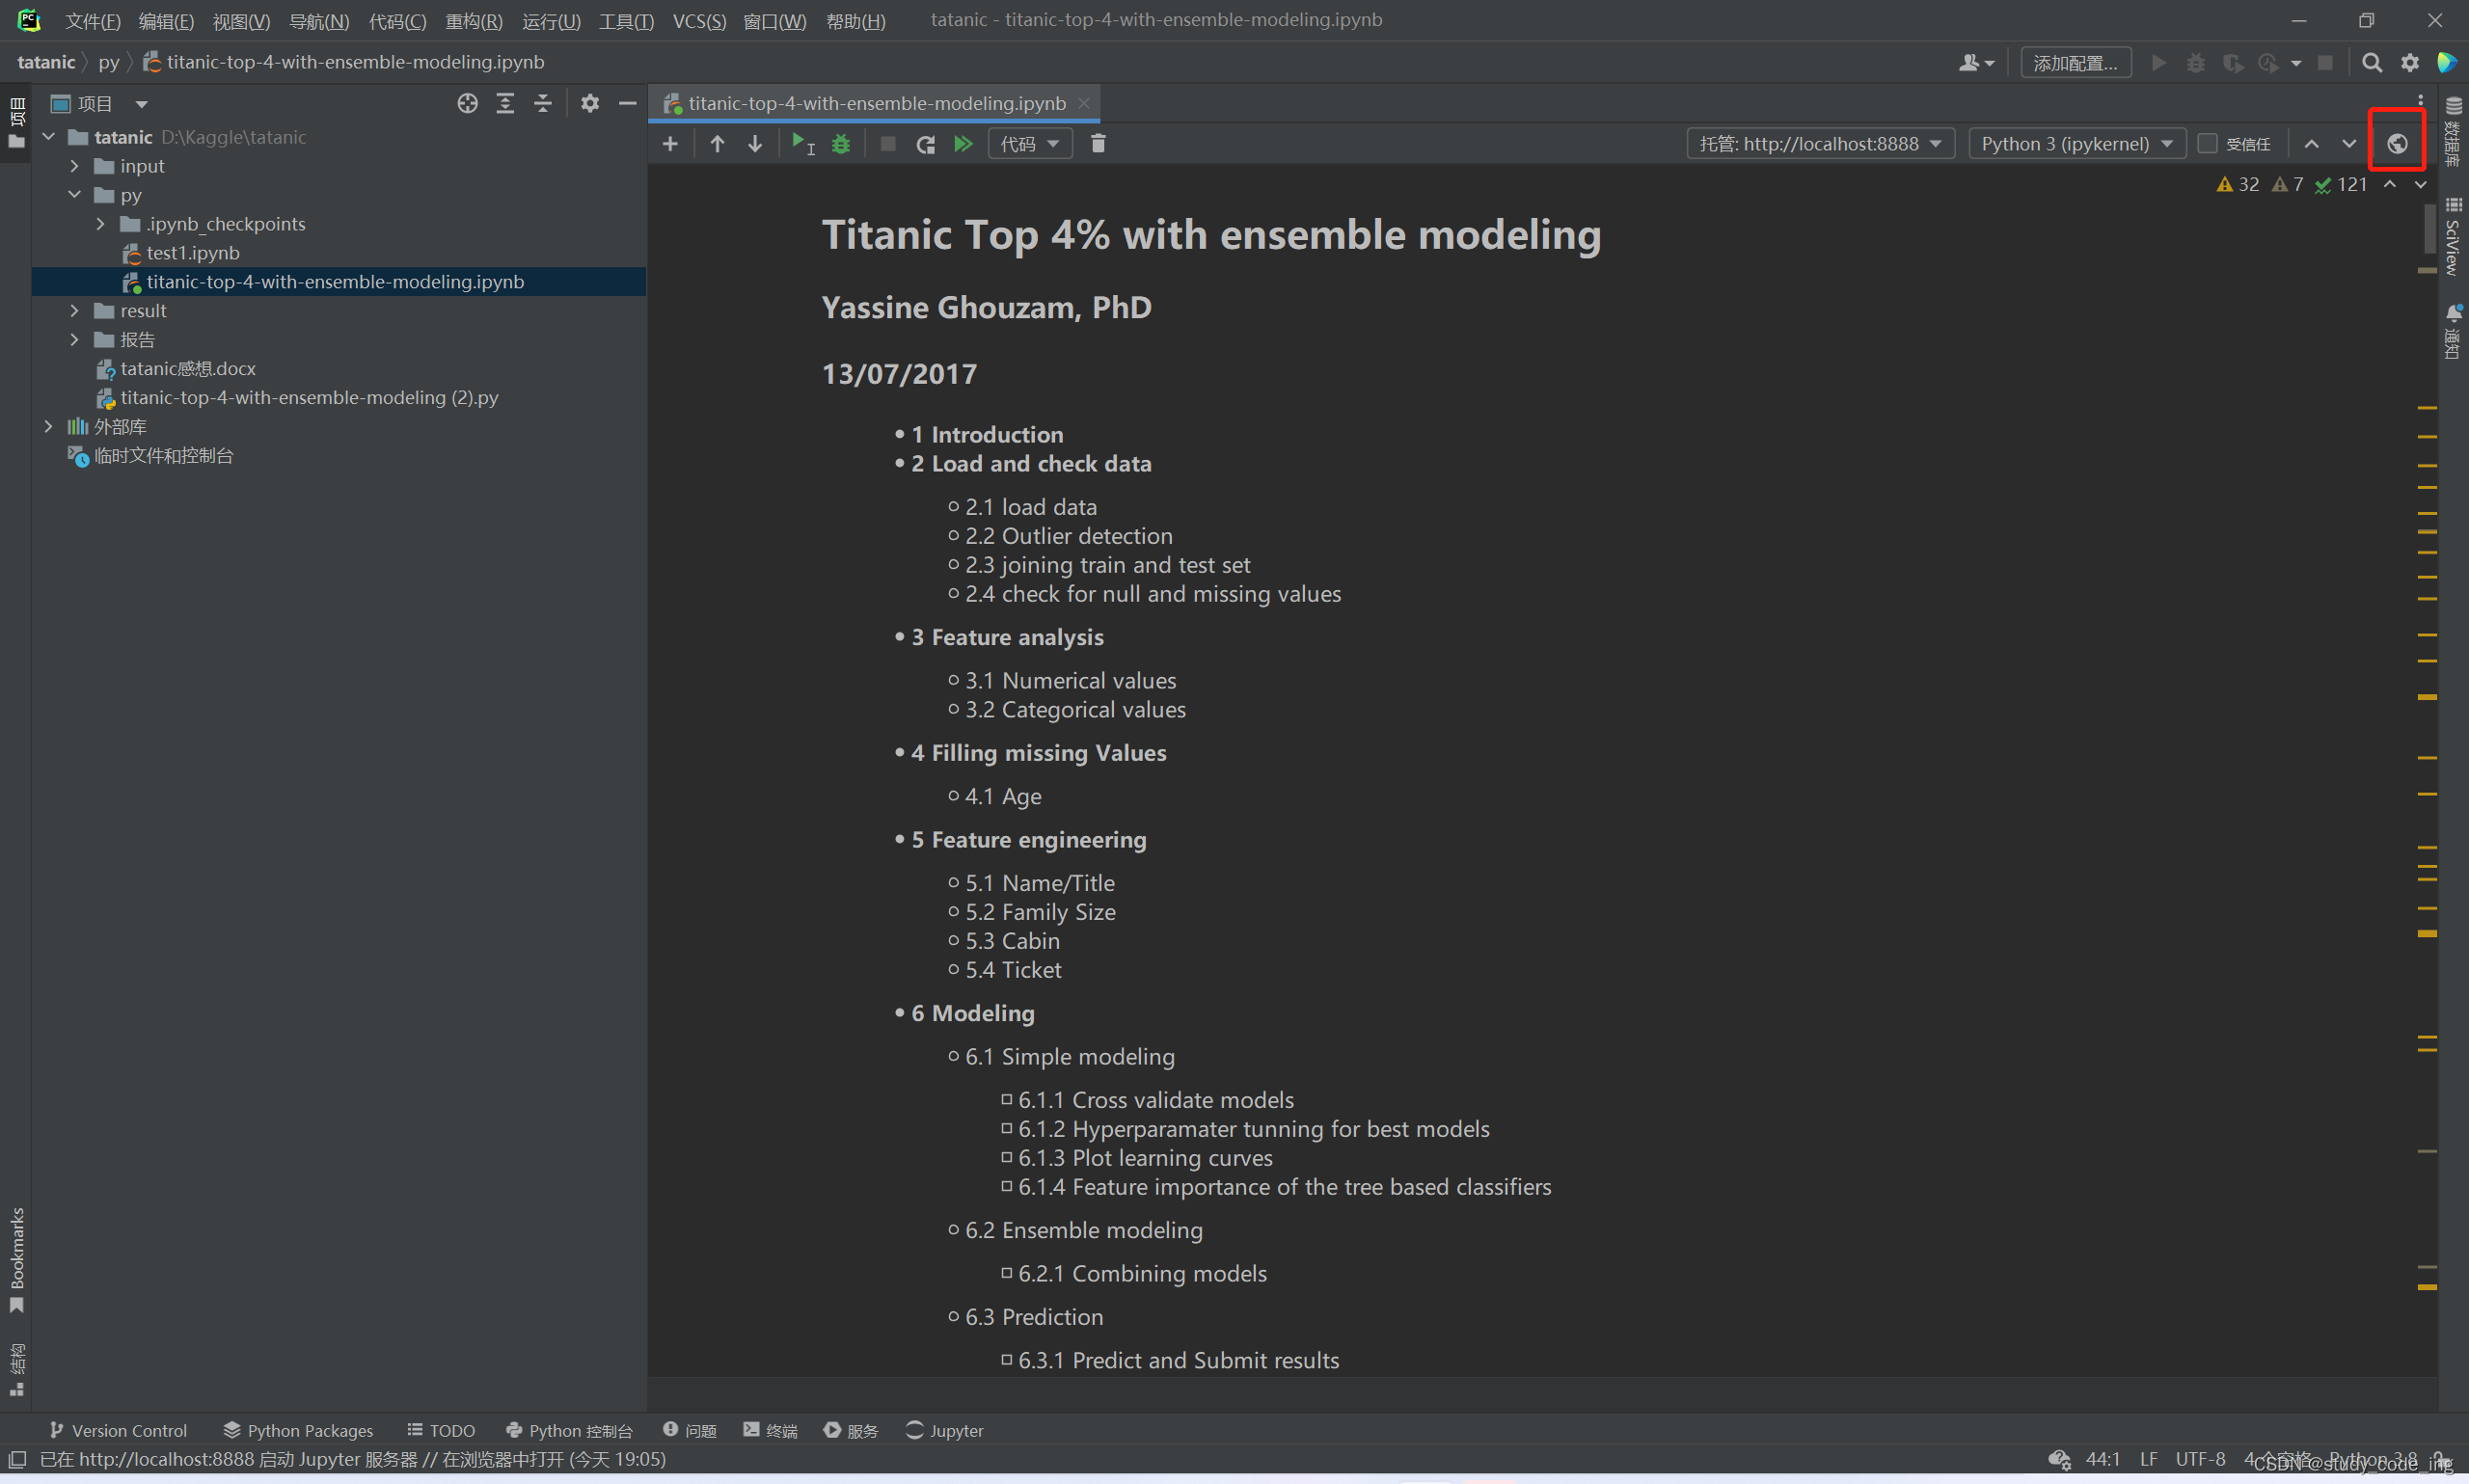
当然,这里还有一种运行方式

点击此图标,可跳转到jupyter网页运行(或者打开cmd,输入jupyter notebook也可跳转,运行完成后下载结果
四、温馨提示

1、如果运行时没有运行结果可以检查一下python的运行环境是否有问题

kaggle竞赛平台上数据集下载详解 从kaggle 网站上下载数据集既保证了速度又避免了网络的不稳定造成下载失败问题。该平台也可以上传代码作为自己的代码库,不过本人更习惯将代码上传到github上。希望本人整理的kaggle库使用技巧能够帮助到正在阅读本博客的你。此外还有一篇博客针对kaggle数据集下载问题的几个问题的相关文章进行了整理【博客链接】。 阅读详情

相关推荐

kaggle注册以及数据集下载全流程

kaggle注册,数据集下载及常见问题

Arriteey的博客 2万+

kaggle平台free使用GPU

选择【ACCELERATOR】,在下拉框中可以选择你想使用的GPU,如【GPU P100】,(建议把【Internet】打开【Internet on】在使用中可能下载数据,安装库会使用到,默认是打开的)回到主界面,点击【头像】进入【Settings】,下划至【Quotas】,如下可以看到,总时长为30小时,已经使用7分钟(每周30小时免费时长)输入【邮箱】、【密码】和【用户名】后,勾选【进行人机身份验证】,【Next】下一步。创建成功后界面默认如下,点击左上角【运行】按钮,初始化会话环境。

zqx1473的博客 1万+

Kaggle入门——泰坦尼克之灾

PassengerID—ID,具有唯一标识的作用,一个人员对应一个IDSurvived -- 是否幸存,1表示是,0则表示否Pclass -- 船舱等级,1:一等舱,2:二等舱,3:三等舱(较为重要)Name -- 姓名(可提取出更多信息)Sex -- 性别,female女性,male男性(较为重要)Age -- 年龄(较为重要)SibSp – 旁系亲友Parch – 直系亲友Ticket -- 船票Fare -- 票价Cabin -- 舱位Embarked -- 登船港口编号。

m0_73624760的博客 3728

大数据竞赛平台——Kaggle 入门

大数据竞赛平台——Kaggle 入门篇 这篇文章适合那些刚接触Kaggle、想尽快熟悉Kaggle并且独立完成一个竞赛项目的网友,对于已经在Kaggle上参赛过的网友来说,大可不必耗费时间阅读本文。本文分为两部分介绍Kaggle,第一部分简单介绍Kaggle,第二部分将展示解决一个竞赛项目的全过程。如有错误,请指正! 1、Kaggle简介 Kaggle是一个数据分析的竞赛平台,网址:ht

wepon的专栏 30万+

Kaggle GPU资源高效利用:本地项目上传与运行全指南

本文详细介绍了如何高效利用Kaggle的免费GPU资源,将本地深度学习项目上传并运行的全流程指南。内容涵盖项目打包、数据集上传、GPU加速器配置、环境依赖安装以及核心代码运行等关键步骤,并分享了优化显存使用、管理大型数据和保存训练结果等实用技巧,帮助开发者和学生克服算力限制,加速模型实验。

weixin_29038537的博客 517

不写一行代码?在Kaggle Notebook里直接运行GitHub项目并查看实时日志的懒人方法

本文详细介绍了如何在Kaggle Notebook中无需编写代码即可一键运行GitHub项目并实时监控日志文件。通过配置GPU环境、克隆仓库、安装依赖和优化运行设置,用户可以快速验证AI项目效果,特别适合研究者和竞赛选手。

weixin_30706691的博客 329

史诗级干货-教你如何打Kaggle

手把手教你如何打Kaggle(Kaggle入门比赛Digit Recognizer数字识别 Pytorch实现) 搜索微信公众号:‘AI-ming3526’或者’计算机视觉这件小事’ 获取更多XXX干货 csdn:https://blog.youkuaiyun.com/baidu_31657889/ github:https://github.com/aimi-cn/AILearners Kaggle 是...

小明的博客 7338

Kaggle数据集在Colab零配置加载的最简方案

Kaggle数据集是机器学习项目中常用的基础数据源,其加载本质依赖于安全认证与API调用机制。传统方式需手动配置kaggle.json密钥、处理OAuth令牌或绕过沙箱限制,极易因环境变量丢失、JWT密钥格式变更或权限冲突导致403/404错误。而Google Colab与Kaggle深度集成的隐式OAuth认证机制,可自动注入临时KAGGLE_TOKEN,实现免文件、免环境变量、免重启重配的稳定访问。该方案技术价值在于降低新手门槛、提升实验复现效率,并天然适配Jupyter式快速迭代场景。本文聚焦Kagg

图灵教育官方博客 357

一个人,没有学过机器学习这么开始搞kaggle呢?

开始 Kaggle 竞赛没有机器学习基础是完全可行的,关键在于分阶段学习、利用社区资源,并通过实践快速成长。

2501_91798322的博客 1290

Colab中用PySpark高效读取Kaggle大文件的实战指南

PySpark是一种面向大规模数据处理的分布式计算框架,其核心优势在于内存外(out-of-core)执行、惰性求值和JVM级内存管理,特别适合突破单机内存瓶颈。在资源受限但开箱即用的Google Colab环境中,PySpark可替代pandas处理远超RAM容量的Kaggle数据集(如5–10GB CSV/Parquet),通过合理配置spark.sql.files.maxPartitionBytes与spark.sql.adaptive.enabled等关键参数,实现稳定、可复现、低内存占用的数据加载

452

Kaggle数据集下载全攻略:从注册到API配置的保姆级教程

本文提供了一份详尽的Kaggle数据集下载指南,涵盖从注册、Python虚拟环境搭建、API密钥配置到高效下载命令使用的完整流程。重点解析了如何通过Kaggle CLI工具精准定位并下载所需数据集,并分享了集成到自动化工作流的最佳实践,帮助数据科学从业者快速获取数据,提升工作效率。

z2a3b4c5d的博客 351

Kaggle入门实战指南:从零到一掌握数据科学竞赛核心技巧

数据科学竞赛是机器学习实践的重要场景,其核心在于通过结构化流程解决实际问题。竞赛平台如Kaggle提供了从数据探索到模型部署的完整环境,参赛者需要掌握特征工程、模型验证等关键技术。特征工程决定了模型性能的上限,涉及缺失值处理、特征交叉和聚合等操作;而可靠的交叉验证策略则是评估模型泛化能力的基础,能有效防止过拟合。这些技术在实际业务中具有广泛应用价值,例如金融风控、推荐系统等场景。本文以Kaggle平台为例,系统介绍了如何避开常见陷阱、高效利用公开Notebook资源,并构建从数据预处理到模型集成的完整工作流

weixin_34411563的博客 390

Kaggle数据科学竞赛:完整项目资源包

Kaggle自2010年成立以来,已经发展成为全球最大的数据科学竞赛平台。最初,它作为一个机器学习竞赛网站启动,聚集了一批对数据科学充满热情的专业人士和爱好者。随着时间的推移,Kaggle逐渐成为了数据科学领域内公认的技能竞技场,它不仅是学习和实践数据科学技能的好地方,还是企业和研究机构寻求创新解决方案的重要场所。在Kaggle上,参赛者可以访问开放的数据集,这些数据集包括了从金融市场预测、医疗诊断到图像识别等多个领域的实际问题。Kaggle对数据科学社区的影响是深远的。

weixin_36464343的博客 725

Kaggle大数据竞赛平台入门

大数据竞赛平台,国内主要是天池大数据竞赛和DataCastle,国外主要就是Kaggle.Kaggle是一个数据挖掘的竞赛平台,网站为:https://www.kaggle.com/.很多的机构,企业将问题,描述,期望发布在Kaggle上,以竞赛的方式向广大的数据科学家征集解决方案,体现了集体智慧这一思想.每个人在网站上注册后,都可以下载感兴趣项目的数据集,分析数据,构造模型,解决问题提交结果.按

jjddss的专栏 1233

IsaacLab从入门到精通(二) 导入自定义机器人

IsaacLab系列第二讲,导入自定义的机器人及设置

DejaWu33的博客 8466

新版本大疆智图4.5 永久许可摄影测量建模软件

大疆智图支持常见格式的成果输出,包括 TIFF 正射影像和高程模型、LAS 格式点云,以及 B3DM、OSGB、OBJ 等六种常用格式的三维模型,还包括 DXF 和 SHP 等格式的等高线。大疆智图 DJI Terra是领先的三维重建软件,提供先进的技术和简单的操作,一站式解决方案,从航线规划到数据的获取,以及模型重建、数据分析等都提供独一无二的支持,优化项目工程,提供自动化优势,获得更有效智能的决策和行动,最终用户可以获得理想的结果,减轻工作压力,提高作业效率。质量报告和剖面查看功能有助于分析点云质量。

qq_62821232的博客 6891

Kaggle等5大AI竞赛平台实战能力图谱

机器学习竞赛平台不仅是刷分场所,更是数据工程、模型部署与跨团队协作的微型工业现场。从数据清洗的噪声处理、GPU资源调度的算力约束,到Leaderboard跳变背后的测试集漂移与评分逻辑变更,这些平台将工业界真实痛点高度具象化。尤其在Kaggle、DrivenData、AIcrowd等主流平台中,‘数据侦探能力’与‘需求翻译能力’已成为区分参赛者与工程落地者的关键分水岭。它们训练的不是孤立算法技巧,而是面向生产环境的数据血缘分析、可复现环境构建、系统可观测性调试及本地化时区/编码适配等不可替代技能。本文基于3

weixin_34183910的博客 393

3D Slicer5.7在win11下的源码编译安装

本博客主要参考官方安装文档以及部分优快云的博客,部分内容的书写会直接参考官方文档的内容。

Topsort的博客 4760

从零开始掌握Kaggle竞赛:机器学习模型解析与实战进阶指南

想要在Kaggle竞赛中脱颖而出,从新手成长为数据科学高手吗?这个项目正是为你量身打造的终极学习资源!🚀 ## 什么是Kaggle-solutions项目? **Kaggle-solutions**是一个精心整理的机器学习竞赛解决方案宝库,汇集了来自全球顶级选手的实战经验和创新思路。无论你是初学者还是有一定经验的数据科学家,这里都能为你提供宝贵的学习素材和灵感源泉。项目收录了超过600个竞赛

gitblog_00131的博客 886

buildozer

/home/chenyang/new_kivy/.buildozer/android/platform/build/build/other_builds/hostpython3/desktop/hostpython3/Lib

东方佑 16万+

解决 maven编译项目-Fatal error compiling: 无效的目标发行版: 21 -> [Help 1]

惊奇的发现,maven没有用环境变量中设置好的JAVA_HOME目录,至此发现错误原因,原来执行java -version默认使用系统环境变量JAVA_HOME,而maven优先使用了windows的用户变量JAVA_HOME(这里之前忘记修改,仍然指向java8路径),修改用户变量JAVA_HOME指向java21或删除该用户变量JAVA_HOME(如无它用)后即可。打开maven包所在的目录,在maven的配置文件 mvn.cmd 文件中,设置java_home的目录。

litlit023的专栏 1799

Kaggle数据分析/挖掘实战:二分类问题 Titanic 数据集,四种模型 Train AUC均分84 kaggle Score 均分77 ,从泰坦尼克号的灾难中学习机器学习

Kaggle 数据分析挖掘实战,二分类问题,四种模型 Kaggle Score 均分77。本专栏内容如果有新的更好的方法会不断更新,如果有友友有更好的处理方式得到更高的分,也同样欢迎评论。

小阳的博客 2823

目标跟踪与视频时序分析基础

两帧均有目标,却因快速移动导致检测框无重叠,仅靠交并比(IoU)无法维持身份关联。本文通过手算与纯Python实现最小跟踪流程,揭示IoU仅为位置线索,不能应对快速位移或遮挡。实验表明,即使目标真实存在,低重叠也会触发新编号。强调跟踪需结合运动预测、外观特征与阈值验证,避免误判。

Mr数据杨 2335
上一篇: 数据分析 第一篇
下一篇: Kaggle(四)Scikit-learn
study_code_ing
博客等级 码龄5年 41粉丝 9原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值