OCR告别付费!分享两款可部署的开源项目

828华为云征文|部署开源超轻量中文OCR项目 TrWebOCR TrWebOCR 是开源易用的中文离线OCR,识别率媲美大厂,并且提供了易用的web页面及web的接口,方便人类日常工作使用或者其他程序来调用。 阅读详情

01 引言

OCR文字识别已经基本覆盖我们的日常的聊天工具,如微信、QQ等都有截图识别文字甚至直接从图片可以复制文字。开发项目中使用OCR图片识别、文案提取等经常用到。大多数小型企业都会选择云厂商的文字识别,如阿里云、百度云、腾讯云等的识别功能。

那有没有白嫖的OCR呢?当然有,但是很多的识别率并不高。今天介绍两款识别率较高的OCR项目,关键是可以部署,应用到业务项目中。

02 Umi-OCR
2.1 简介

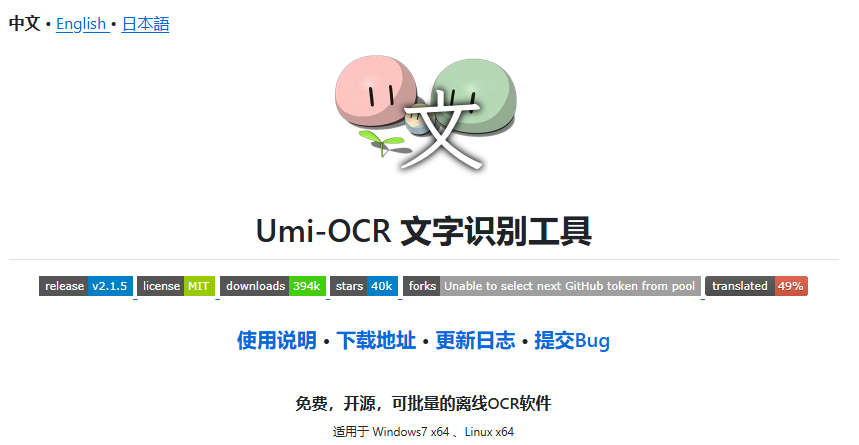
Umi-OCR 是一个免费、开源、可离线的 OCR 文字识别工具,由开发者 hiroi-sora 使用 Python 编写。它的名字中 “Umi” 在日语里是“海”的意思,寓意着其“海纳百川”的特性。

该项目是基于百度开源的PaddleOCR开发,对中文和英文的识别准确率非常高,同时支持多国语言。它的主要目标是提供一个简单易用、功能强大且完全离线的图片文字识别解决方案,完美保护用户隐私,因为所有识别过程都在本地计算机上完成,无需连接任何外部服务器。

不仅支持本地部署,还支持windows系统:
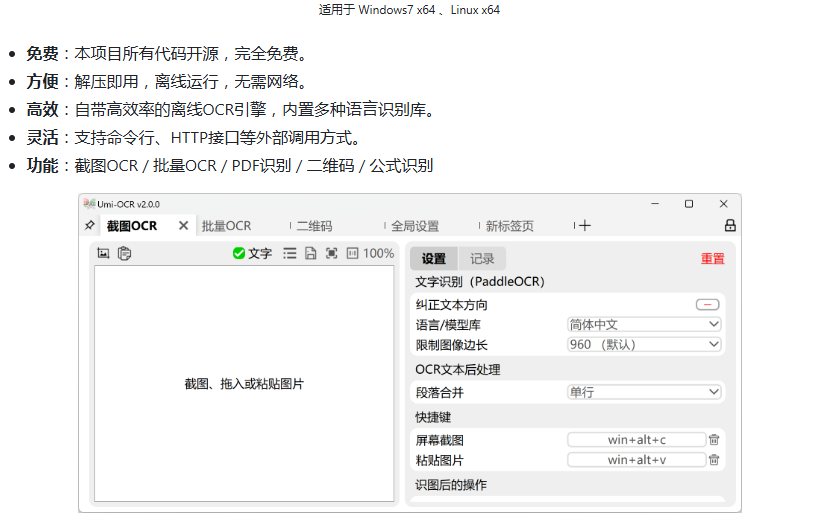
windows版本作为日常使用的工具大家可以自行探索。为了接入项目开发,我们主要了解一下本地部署的方式。

GitHub地址:https://github.com/hiroi-sora/Umi-OCR

2.2 部署

linux部署是新的项目:https://github.com/hiroi-sora/Umi-OCR_runtime_linux
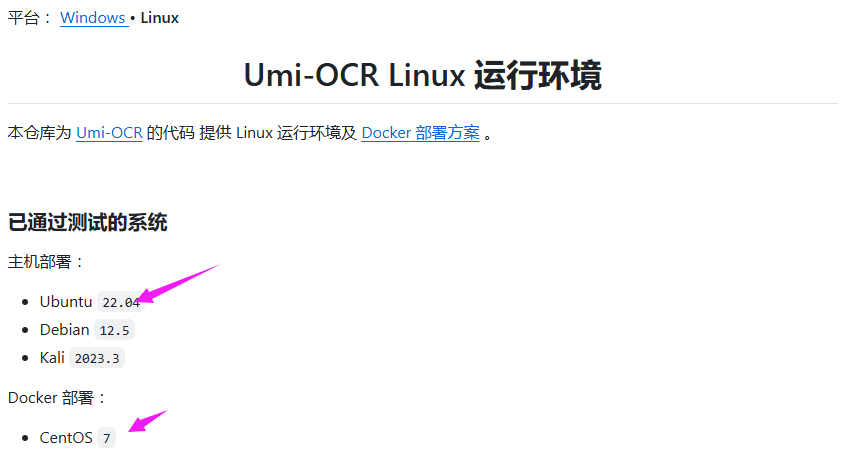
由于官方给出的测试的系统类型并没有Centos。尝试通过Centos8部署,结果失败:缺少一些基本组件,升级不成功。
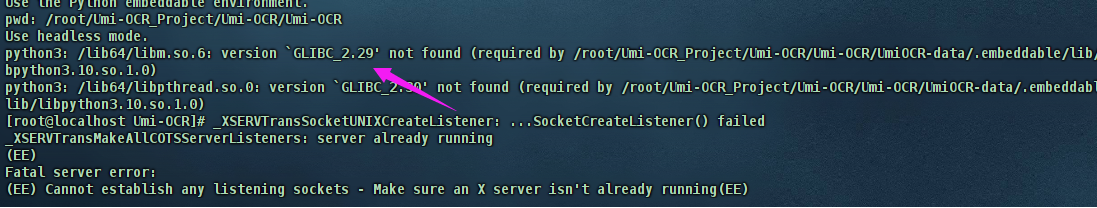
所以这里我们使用Docker部署。

Docker部署的地址:https://github.com/hiroi-sora/Umi-OCR_runtime_linux/blob/main/README-docker.md

官方文档介绍的很明白了。

检查主机CUP

因为目前主机的CPU只支持AVX指令集。

lscpu | grep avx

如果输出了类似如下的结果,那么可以继续部署。如果没有则无法部署

Flags:          ... avx ... avx2 ...

所以小编的机器是可以部署的。

构建镜像

由于远程镜像仓库里面没有上传,需要使用Dockerfile自行构建。

# 拉取Dockerfile文件
wget https://raw.githubusercontent.com/hiroi-sora/Umi-OCR_runtime_linux/main/Dockerfile

# 构建镜像
docker build -t umi-ocr-paddle .

umi-ocr-paddle表示构建的镜像名称。

启动容器

容器的运行支持无头模式和GUI模式。因为我们是为了项目的调用,所以这里我们使用悟透模式。

docker run -d --name umi-ocr \
    -e HEADLESS=true \
    -p 1224:1224 \
    umi-ocr-paddle

说明:

  • 设置容器名称为 umi-ocr 。你也可以设置为任意名称。
  • 设置环境变量 -e HEADLESS=true 启用无头模式。
  • 设置端口转发 -p xxxx:1224 ,将容器内的1224端口转发给主机xxxx端口。
  • 使用的镜像为 umi-ocr-paddle 。

2.3 接口调用

官方提供了HTTP接口手册:

https://github.com/hiroi-sora/Umi-OCR/blob/main/docs/http/README.md
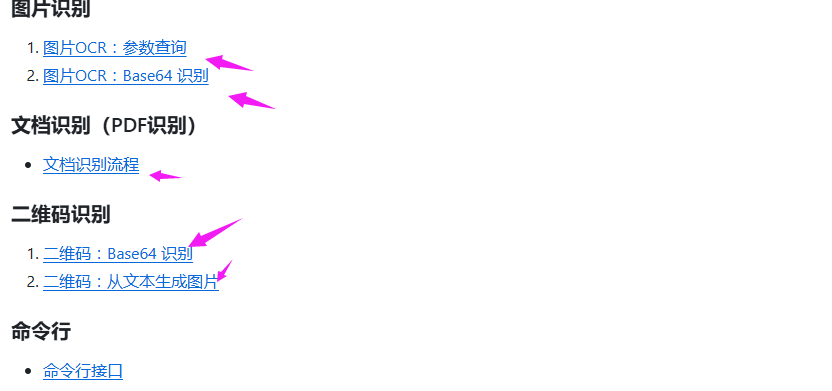
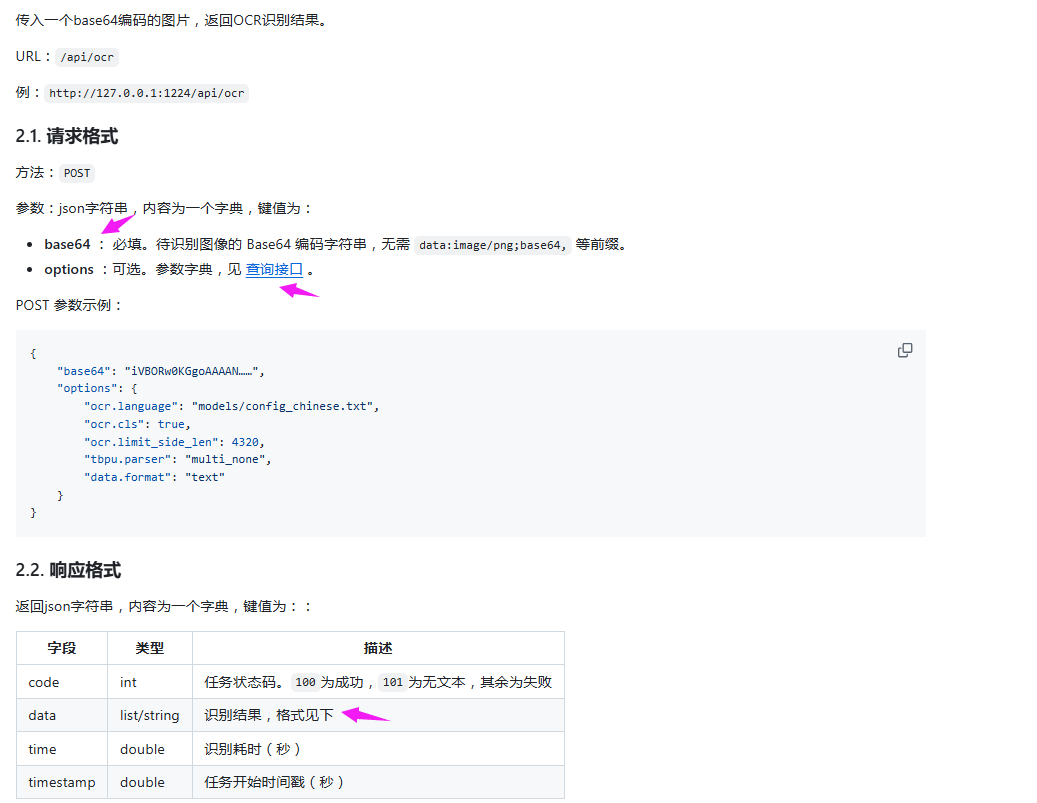
我们这里以图片OCR:Base64识别为例:
Java案例

 @Test
void test04() throws Exception {
    File file = new File("C:\\Users\\ws\\Desktop\\00.jpg");
    String encode = Base64.encode(Files.toByteArray(file));

    JSONObject jsonObject = new JSONObject();
    jsonObject.put("base64", encode);

    JSONObject item = new JSONObject();
//        item.put("ocr.language", "models/config_chinese.txt");
//        item.put("ocr.cls", true);
//        item.put("ocr.limit_side_len", 4320);
//        item.put("tbpu.parser", "multi_none");
    item.put("data.format", "text");
//        item.put("data.format", "dict");
    jsonObject.put("options", item);

    String post = HttpUtil.post("http://127.0.0.1:1224/api/ocr", JSON.toJSONString(jsonObject));
    System.out.println(post);
    System.out.println("----------------------------------------------");
    System.out.println(UnicodeUtil.toString(post));
}

结果
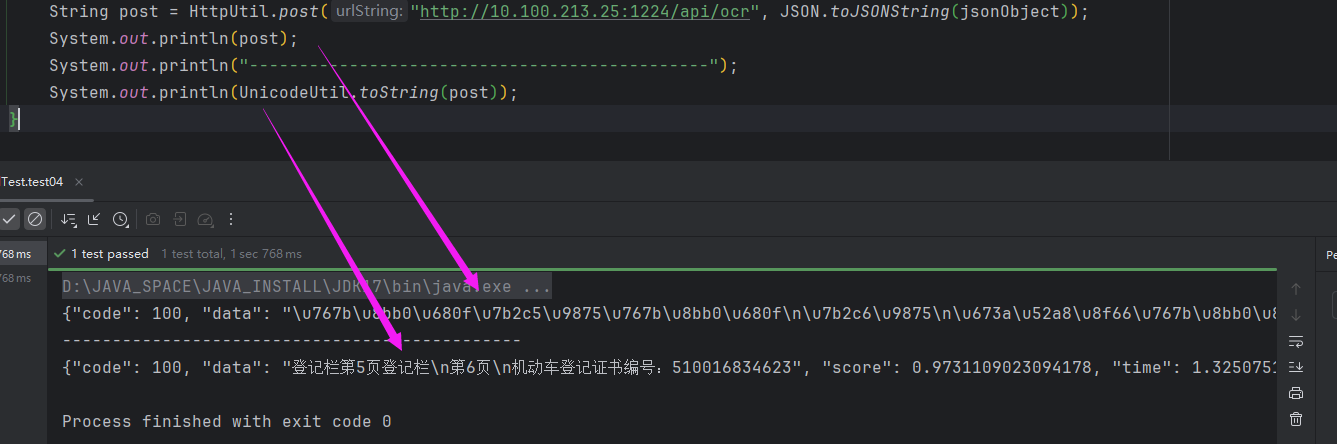
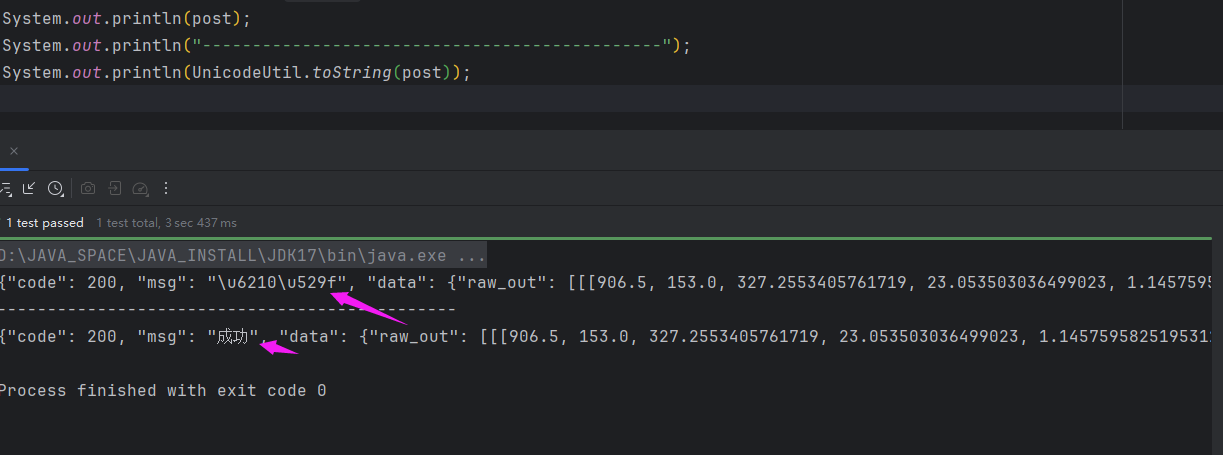
结果是识别出来了,但是有个小问题。第一行输出是unicode,需要我们将unicode转成中文。

03 TrWebOCR

3.1 简介

TrWebOCR基于开源项目 Tr 构建,目前已经停更了,tr官方说了项目转为研究性项目:
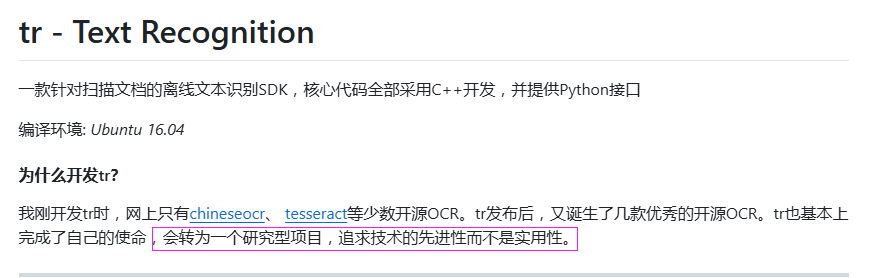
但是它仍然是一款好用的OCR工具。支持的平台比较多:
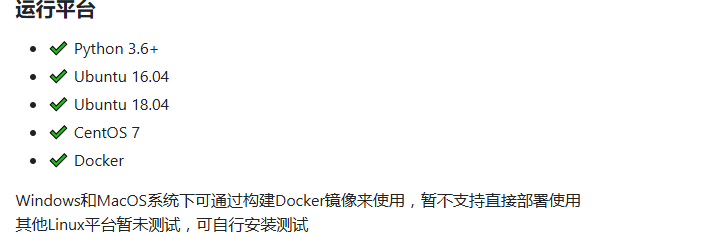
GitHub地址:https://github.com/alisen39/TrWebOCR

3.2 部署

我们同样以Docker的形式部署。这个就比较简单了,可以自行构建镜像,也可以拉取镜像。

构建镜像

# dockerfile 构建
docker build -t trwebocr:latest .

# 运行镜像
docker run -itd --rm -p 8089:8089 --name trwebocr trwebocr:latest 

远程镜像

# 从 dockerhub pull
docker pull mmmz/trwebocr:latest

# 运行镜像
docker run -itd --rm -p 8089:8089 --name trwebocr mmmz/trwebocr:latest 

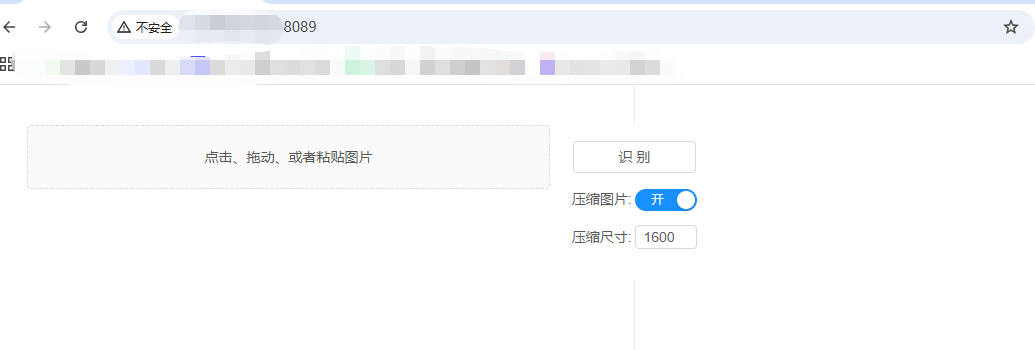
访问IP+端口,提供了网页端:
3.3 接口调用

我们先试试网页端:
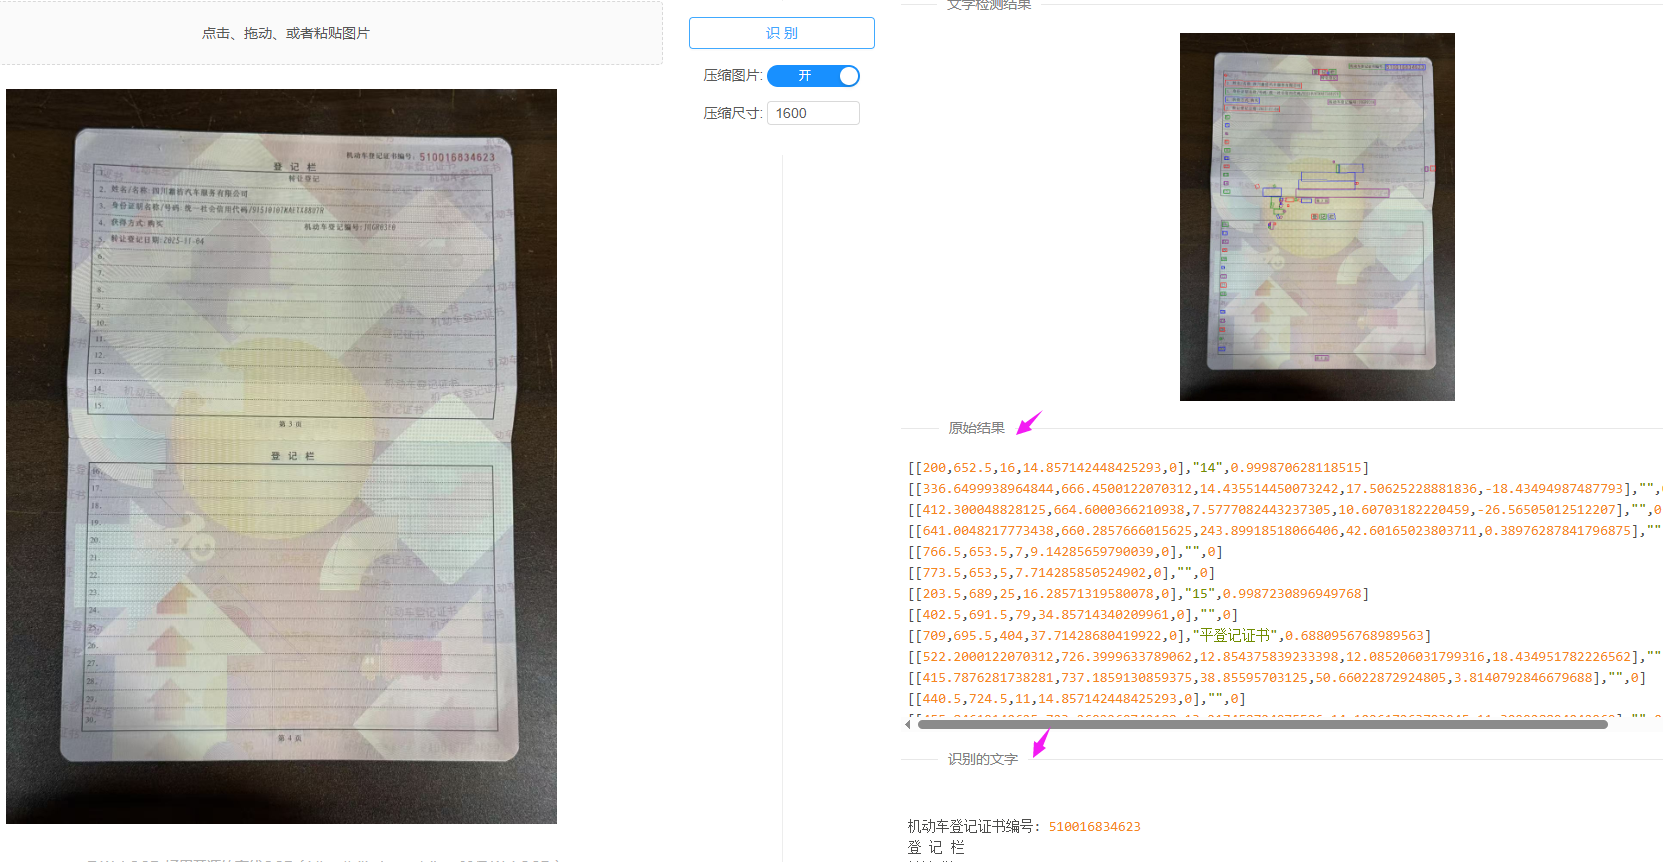
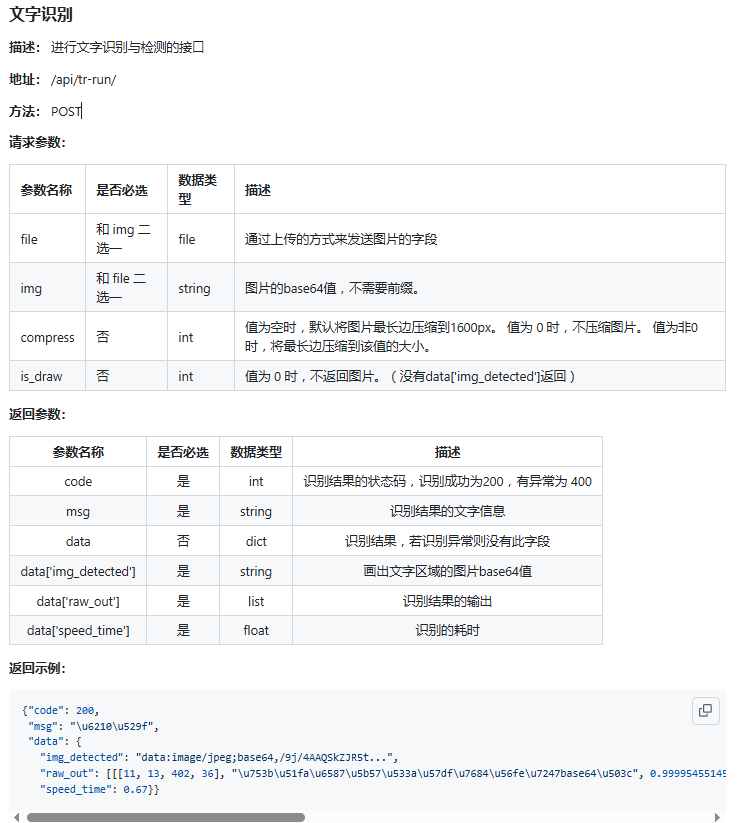
接口文档地址:

https://github.com/alisen39/TrWebOCR/wiki/%E6%8E%A5%E5%8F%A3%E6%96%87%E6%A1%A3
Java案例

@Test
void test07()  {
    File file = new File("C:\\Users\\ws\\Desktop\\34.png");

    JSONObject item = new JSONObject();
    item.put("file", file);
    item.put("is_draw", 0);

    String post = HttpUtil.post("http://127.0.0.1:8089/api/tr-run/", item);
    System.out.println(post);
    System.out.println("----------------------------------------------");
    System.out.println(UnicodeUtil.toString(post));
}

结果
04 小结

第二款虽然停更,但是已有的功能可以满足常用的OCR识别。而第一款一直活跃在GitHub上,是一款非常值得关注的项目,不断的迭代新的功能。有特殊要求的OCR可以利用开源模型自行训练。

centos7离线部署trwebocr 1.制作trwebocr镜像,找一个已安装trwebocr的docker镜像;打包trwebocr。由于客户环境是内网,无法连接外网安装依赖,所以下面都是使用内网进行安装;4.将docker注册为service服务;注意此步骤在已有外网环境中安装。3.移到 /usr/bin;2.上传内网服务器,加载镜像。5. 启动docker。 阅读详情

相关推荐

GLM-5技术深度解析:中文语义解耦与轻量化部署实践

大语言模型(LLM)的核心能力不仅取决于参数规模,更在于其对特定语言和场景的深度适配能力。中文作为高歧义、强语境依赖的语言,对模型的语义理解、长文本结构化推理及边缘部署效率提出独特挑战。GLM系列模型以‘中文语义解耦’和‘动态稀疏注意力’为关键技术路径,突破传统Transformer在法律、政务、制造等垂直领域的落地瓶颈。其分层语义解耦器(HSD)实现从字面匹配到意图重构的跃迁,图谱化长文本编码器(GLE)支持可导出、可审计的知识建模,而混合精度动态量化(HPDQ)与语义感知KV缓存(SAKC)则让32B级

weixin_34378767的博客 436

TrWebOCR开源的离线OCR

什么是 OCR ? OCR(optical character recognition)文字识别是指电子设备(例如扫描仪或数码相机)检查纸上打印的字符,然后用字符识别方法将形状翻译成计算机文字的过程;即,对文本资料进行扫描,然后对图像文件进行分析处理,获取文字及版面信息的过程。【百度百科】 什么是 Tr ? TR(Text Recognition)是一款针对扫描文档的离线文本识别 SDK,核心代码全部采用 C++ 开发,并提供 Python 接口。 什么是 TrWebOCR ? TrWebOCR.

wbsu2004的博客 6233

大语言模型人性化理解:从指令执行到场景化意图建模

大语言模型(LLM)正经历从‘文本生成’到‘意图理解’的关键演进。其核心原理在于突破传统关键词匹配范式,通过长上下文建模、多模态对齐训练与双轨反馈优化(RLHF+RHLF),实现对用户身份、使用场景与隐含诉求的动态推演。这一技术跃迁显著提升了指令遵循率、上下文承接稳定性与风格适配准确性,直接支撑智能客服单轮解决率、报告关键字段完整率等可量化业务指标。在制造业合规审查、医疗文档解析、教育作文批改等垂直场景中,‘人性化理解’已不再依赖黑箱能力,而是可通过最小理解单元(MUU)、结构化提示工程(如SCORP法)与

dieqiao8331的博客 470

探索高效文本识别利器:TrWebOCR

探索高效文本识别利器:TrWebOCR 项目地址:https://gitcode.com/gh_mirrors/tr/TrWebOCR 在这个数字化的时代,自动文本识别(OCR)技术已经变得至关重要,无论是文档扫描、图片文字提取还是屏幕内容捕捉。今天,我们要介绍一个开源的Web OCR项目——,它以其强大的功能和易用性脱颖而出。 项目简介 TrWebOCR是一个基于Python开发的在线文本识别工...

gitblog_00078的博客 726

TKOCR 一款Windows端离线ocr识别系统部署的简化辅助集成工具

离线ocr识别系统辅助简化部署调用工具,运行环境windows7及以上X64位系统, 绿色免安装,软件简化开源ocr系统在windows服务器的部署敲命令安装的过程,同时集成了ocr识别模板制作可视化编辑测试工具(无需抠字符),后端调用方面集成了ocr识别代理接口(可自行设置ip和端口),默认使用了了开源的识别库(可自行替换)可进行日常的中英文识别 识别效果还不错

TrWebOCR,基于开源项目 Tr 构建的开源易用的中文离线OCR

TrWebOCR,基于开源项目 Tr 构建。开源易用的中文离线OCR,识别率媲美大厂,在其基础上提供了http调用的接口,便于你在其他的项目中调用。并且提供了易于使用的web页面,便于调试或日常使用。

UDOP-large开源可部署:无需API调用,本地私有化文档理解方案

本文介绍了如何在星图GPU平台上自动化部署UDOP-large 文档理解模型(模型内置版)v1.0,实现本地私有化的文档智能处理。该方案无需API调用,用户可通过简洁的Web界面,上传英文文档图片并提问,模型即可自动理解版面与文字,完成如从发票中提取关键信息等典型的信息抽取任务。

weixin_35815766的博客 690

信息隐藏 数字图像空域隐写与分析技术的实现

【代码】信息隐藏 数字图像空域隐写与分析技术的实现。

Yungoal的博客 470

图片转可编辑PPT:识别、还原与工程化落地的真相

‘图片转PPT’是办公自动化中的高频技术概念,但真正具备生产价值的是‘图片转可编辑PPT’——它要求AI不仅完成OCR文字识别,更要理解视觉结构并映射为PowerPoint原生对象(如Connector、Round Rectangle Shape、母版绑定文本框)。其技术原理涉及计算机视觉分割、Office Open XML深度解析与OLE Automation集成,核心价值在于支持真实工作流中的修改、重排、主题联动与旧版本兼容。典型应用场景包括手绘架构图数字化、会议纪要批量转化及合规汇报初稿生成。本文聚焦

weixin_33834628的博客 427

基于PLC智能立体车库控制系统设计

摘要 本系统设计以三层立体车库为研究对象,通过对立体车库的原理分析、动作流程设计和一系列的软硬件设计,达到立体车库自动化控制的目的。系统采用可编程控制器作为立体车库控制系统的控制单元,实现该系统的工艺要求,通过程序仿真调试,完成系统的各种动作要求,达到自动控制的目的。系统设计分为总体设计、硬件设计以及软件设计。按照立体车库控制系统的控制策略进行图纸设计;重点分析工艺流程图,对立体车库控制系统进行程序编译和MCGS上位机调试,通过系统的调试和修改,达到了基本控制的要求。系统设计明确了工艺要求,确定

DX884164131的博客 3601

通俗理解Xgboost

为了简化计算,XGBoost采用了一阶导数(梯度)和二阶导数(Hessian)来近似损失函数的变化,从而推导出叶子节点值的更新公式。其中 z 就是所有树的叶子节点分数之和。通过这两个正则化项,XGBoost能够在优化目标函数时,不仅考虑损失函数的最小化,还考虑了模型的复杂度,从而达到更好的泛化性能。正则化项通常包括两个部分:一个是与叶子节点数量相关的项,另一个是与叶子节点输出值大小相关的项。通过这种方式,XGBoost能够有效地计算出每个叶子节点的值,同时通过正则化项来平衡模型的复杂度和泛化能力。

金融风控笔记 755

Qwen3.6-Plus:面向开发者工作流的Agentic Coding实践

Agentic Coding 是一种以执行闭环为核心的新型编程范式,强调模型不仅能生成代码,更能理解意图、自主诊断、动态修复并验证结果。其技术基础在于长程逻辑锚定、视觉语义直译与多阶段沙箱执行能力,显著区别于传统提示工程或代码补全工具。在真实工程场景中,它支撑从错误修复、UI草图转可运行组件,到百万级Token上下文下的全栈逻辑追踪,大幅提升开发效率与交付确定性。本文聚焦 Qwen3.6-Plus 在 Agentic Coding 与视觉驱动编程两大维度的落地实践,解析其如何重构前端与全栈开发者的日常协作方

weixin_30291791的博客 395

第四章 自定义组件、动画

第三章 自定义组件、动画 (一)自定义View 1.1) onMeasure:对当前View的尺寸进行测量 protected void onMeasure(int widthMeasureSpec, int heightMeasureSpec) widthMeasureSpec和heightMeasureSpec包含测量模式和尺寸大小 int widthMode = MeasureSpec....

Stay Hungry Stay Foolish 求知若饥 虚心若愚 8134

部署一个在线OCR工具

【代码】部署一个在线OCR工具。

好好学电脑 2055

LS-Dyna模态分析实战:从模型构建到结果解读的全流程指南

本文提供了一份详尽的LS-Dyna模态分析实战指南。文章系统讲解了如何利用LS-Dyna内置的隐式求解器进行特征值求解,从模型构建、几何清理、材料与连接设置,到核心的边界条件与隐式求解控制(如*CONTROL_IMPLICIT_EIGENVALUE),最后完成计算并解读频率与振型结果。旨在帮助工程师在熟悉的环境中高效完成结构振动特性分析,为后续动态响应分析奠定基础。

info6的博客 264

intel-VROC raid卡驱动 centos7.9

u盘进入系统,按e,在出现下面在quiet前面输入inst.dd initcall_blacklist=vmd_drv_init 后按Ctrl和x,开始引导。进入系统,按e,在出现下面在quiet前面输入inst.dd inicll_blacklist=vmd_drv_init 后按Ctrl和x,开始引导。驱动完成后,在输入 c 回车, 引导过程开始,进入安装界面。输入1 ,选择这个ISO驱动文件里的rpm包。输入1 ,选择这个ISO驱动文件里的rpm包。vi编辑 /etc/default/grub。

dacming的博客 4546

【亲测免费】 TrWebOCR 开源项目教程

TrWebOCR 是一个开源的中文离线OCR项目,基于开源项目 Tr 构建。它提供了HTTP调用的接口,便于在其他项目中调用,并且提供了易于使用的Web页面,便于调试或日常使用。TrWebOCR 的主要特性包括: - 中文识别:快速高识别率 - 文字检测:支持一定角度的旋转 - 并发请求:通过 Tornado 多进程的方式支持一定数量的并发请求 ## 项目快速启动 ### 环境准备 确保你...

gitblog_00566的博客 943

广工计组f4b 8位12指令微程序CPU设计实验报告(内含可通过代码以及波形图)

实验目的:模型机是计算机的缩细模型,通过它可以理解计算机整机的结构和功能,理解CPU,存储器,中断控制器,接口的结构及实现逻辑和各部件之前的接口关系。本实验是设计一个8位模型计算机。:一条机器指令可以分解成一个微操作序列,这些微操作是计算机最基本的,不可再细分的操作。:在微程序控制的计算机中。将控制部件向执行部件发出的各种控制命令成为微命令,它是构成控制序列的最小单位。微命令和微操作是一一对应的。微命令是微操作的控制信号,微操作微命令的执行过程。2.:微指令是若干微命令的集合。

weixin_63692154的博客 4705

用C++写一个高性能OCR推理服务-TrWebOCR.cpp

使用C++编写一个高性能OCR Web推理引擎

主要研究方向:计算机视觉、深度学习开发、C++底层开发 1976

Uncaught ReferenceError: process is not defined

这个错误 Uncaught ReferenceError: process is not defined 通常出现在浏览器环境中,因为 process 是 Node.js 环境的内置对象,并不是浏览器原生支持的。因此,浏览器无法识别 process,导致该错误。在App.vue中加上以下代码就能够有效解决。

猿小白的博客 1744

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

ocr离线识别项目 TrWebOCR-master安装

下载地址 https://github.com/Weilit/TrWebOCR/ TrWebOCR-master 使用的范围 适用于验证码识别 照片上文字的提取 自己私密文件不想通过网络 下载的地方 需要的准备工作 在 Linux 服务器部署 在服务器上部署只需要 3 步: 安装 python3.7 执行 install.py python install.py 安装依赖包 pip install -r requirements.txt 搞定! 运行 「main.py」后, web 服务默认运行在

weixin_44091157的博客 3517

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Ubuntu22.04安装TrWebOCR

Ubuntu22.04安装TrWebOCR

weixin_46616558的博客 1060

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

OCR与手写字识别

OCR开源库 https://github.com/muhub/tr TrwebOCR 网络接口调用,xys亲测不错 手写字开源 手写汉字开源库 bysj_hit 哈工大百优博士论文。。项目围绕HITHCD手写汉字数据库(即将公开),对多达21,003类、2,000万份手写汉字样本进行了二值化、随机旋转、亮度调整、霍夫变换、透视校正等多种方案增强,并在此基础上复现了LeNet、VggNet、AlexNet、ResNet、Convolutional Prototype Learning等多种卷积神经网

xys430381_1的专栏 2616

TrWebOcr API-JAVA版本

TrWebOCR-开源的离线OCR 介绍 TrWebOCR,基于开源项目 Tr 构建。 在其基础上提供了http调用的接口,便于你在其他的项目中调用。 并且提供了易于使用的web页面,便于调试或日常使用。 特性 中文识别 快速高识别率 文字检测 支持一定角度的旋转 并发请求 由于模型本身不支持并发,但通过tornado多进程的方式,能支持一定数量的并发请求。具体并发数取决于机器的配置。 安装说明 使用docker-compose.yml部署 version: '3.5' services: tr

随风往事 1566

TrWebOCR工具调试

TrWebOCR工具调试 工具链接 https://github.com/alisen39/TrWebOCR 在ubuntu中调试 python backend/main.py 在虚拟机浏览器或本机浏览器打开http://192.168.31.108:8089 出现下图显示工具调试成功

Vesper_J的博客 1975
上一篇: Redis分布式锁不止set nx那么简单
下一篇: IntelliJ IDEA 2025.2.x的小惊喜和小BUG
智_永无止境
博客等级 码龄10年 803粉丝 406原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

智_永无止境

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值