自动驾驶统一评估框架

自动驾驶车辆的统一评估框架

摘要

自动驾驶系统(ADS)安全性评估是部署在公共道路上之前的关键步骤。尽管为测试自动驾驶系统可靠性而确保 ADS安全性至关重要,但现有研究大多严重依赖单一的测试数据源(即道路上采集的测试数据、仿真或测试跑道)。每种数据源具有不同的保真度水平和能力,因此目前缺乏一种能够使所有数据源相互补充、实现源无关的端到端评估并支持不同测试目标的综合性解决方案。ADS评估被视为自动驾驶汽车开发生命周期中的必要步骤,亟需一种可靠且全面的方法。本文提出了一种源无关框架,可执行兼容多种测试来源的自动驾驶系统评估。我们的研究结果表明,这一综合性解决方案能够节省自动驾驶系统评估所消耗的时间、人力和成本。

Index Terms— 自动驾驶车辆,车辆安全性,评估。

一、引言

近年来,汽车原始设备制造商、供应商和科技公司已向自动驾驶汽车(AVs)投入了巨额资金。一些公司甚至声称,他们即将在公共道路上部署无需驾驶员在方向盘后的自动驾驶汽车(即SAE四级自动驾驶)。尽管自动驾驶系统的开发旨在提高道路安全性,但人们对它的安全性仍存在担忧。这些担忧已在报告和调查中显现出来,并且最近涉及自动驾驶系统的致命事故也进一步证实了这些担忧。此类事件以及公众认知对这项本可拯救生命、节省资金并保护环境的技术的大规模应用并不利。因此,应对自动驾驶系统进行系统性的测试和评估。

自动驾驶车辆是具有挑战性的安全性关键系统,在公共道路上部署之前需要进行严格的评估和测试[10]。确保自动驾驶系统的安全性是一项复杂的跨学科挑战,涉及车辆功能层次结构的各个层面[11]。

汽车行业一直依赖ISO 26262等标准来确保在不同开发阶段[12]汽车电子系统的安全性。然而,由于使用了机器学习系统[13],该标准在自动驾驶系统方面存在不足。最近,预期功能安全(SOTIF)发布,它是新发布的ISO/PAS21448标准[14]的简称。它被认为作为对ISO 26262的补充,旨在弥补这些不足。然而,它仍然不够完善。因此,评估自动驾驶汽车性能的标准化方法仍然是一个未解决的问题。

评估可以在仿真、可控道路课程或真实道路上进行,每种方法都有其优缺点[15]。基于真实交通数据的评估虽然准确,但成本高昂且耗时。此外,由于无法控制现实世界中的各种因素,测试复杂情况十分困难。可能行驶数千英里都未遇到任何罕见的关键情况[16]。同样,私人测试场地仍过于昂贵,难以覆盖所有可能的驾驶场景。尽管仿真精度较低,但它能够合成各种挑战性场景,并以较低成本并行运行大量实验,且无需承担安全性风险。

场景和度量在评估自动驾驶系统性能时也可被视为两个关键参数[17]。根据ISO/PAS 21448,场景是验证活动的重要组成部分。一个场景需考虑周围环境和具体情况(例如其他车辆和行人的行为、道路和天气条件等)。度量是用来量化性能的标准,例如每1000英里脱离次数[18],接近事故次数,或纵向/横向舒适性。为了确保自动驾驶系统具备在公共道路上部署的条件,应在其广泛的挑战性场景中进行测试,并通过有意义的指标进行评估[19]。为实现真实有效的评估,场景应包括极端案例以及正常常见情况。度量应反映运行设计域(ODD)的整体安全性与舒适性[20]。例如,如果自动驾驶系统旨在用于城市环境,则基于高速公路特定指标(如行驶的高速公路里程)的分析将产生误导。

一些工作已从仿真数据中进行评估,如百度的阿波罗仿真平台[21]。尽管它允许用户添加自己的场景和自动驾驶系统,但其评分系统(指标)存在局限性,并且其评估系统与其内置模拟器紧密耦合。因此,缺乏一个统一且独立于自动驾驶系统的评估框架。仅依赖单一数据来源是不够的。例如,某个模拟器可能在测试某项驾驶能力方面表现良好,但在其他方面却不如人意。此外,不同模拟器之间的场景结构和格式也各不相同。

本文提出了一种用于自动驾驶系统评估的统一框架,该框架兼容不同的测试数据源。该框架通过一系列内置指标进行评估(见第二节-D1)。此设计还支持用户自定义指标,以适应进一步的评估需求。

II. 提出的框架
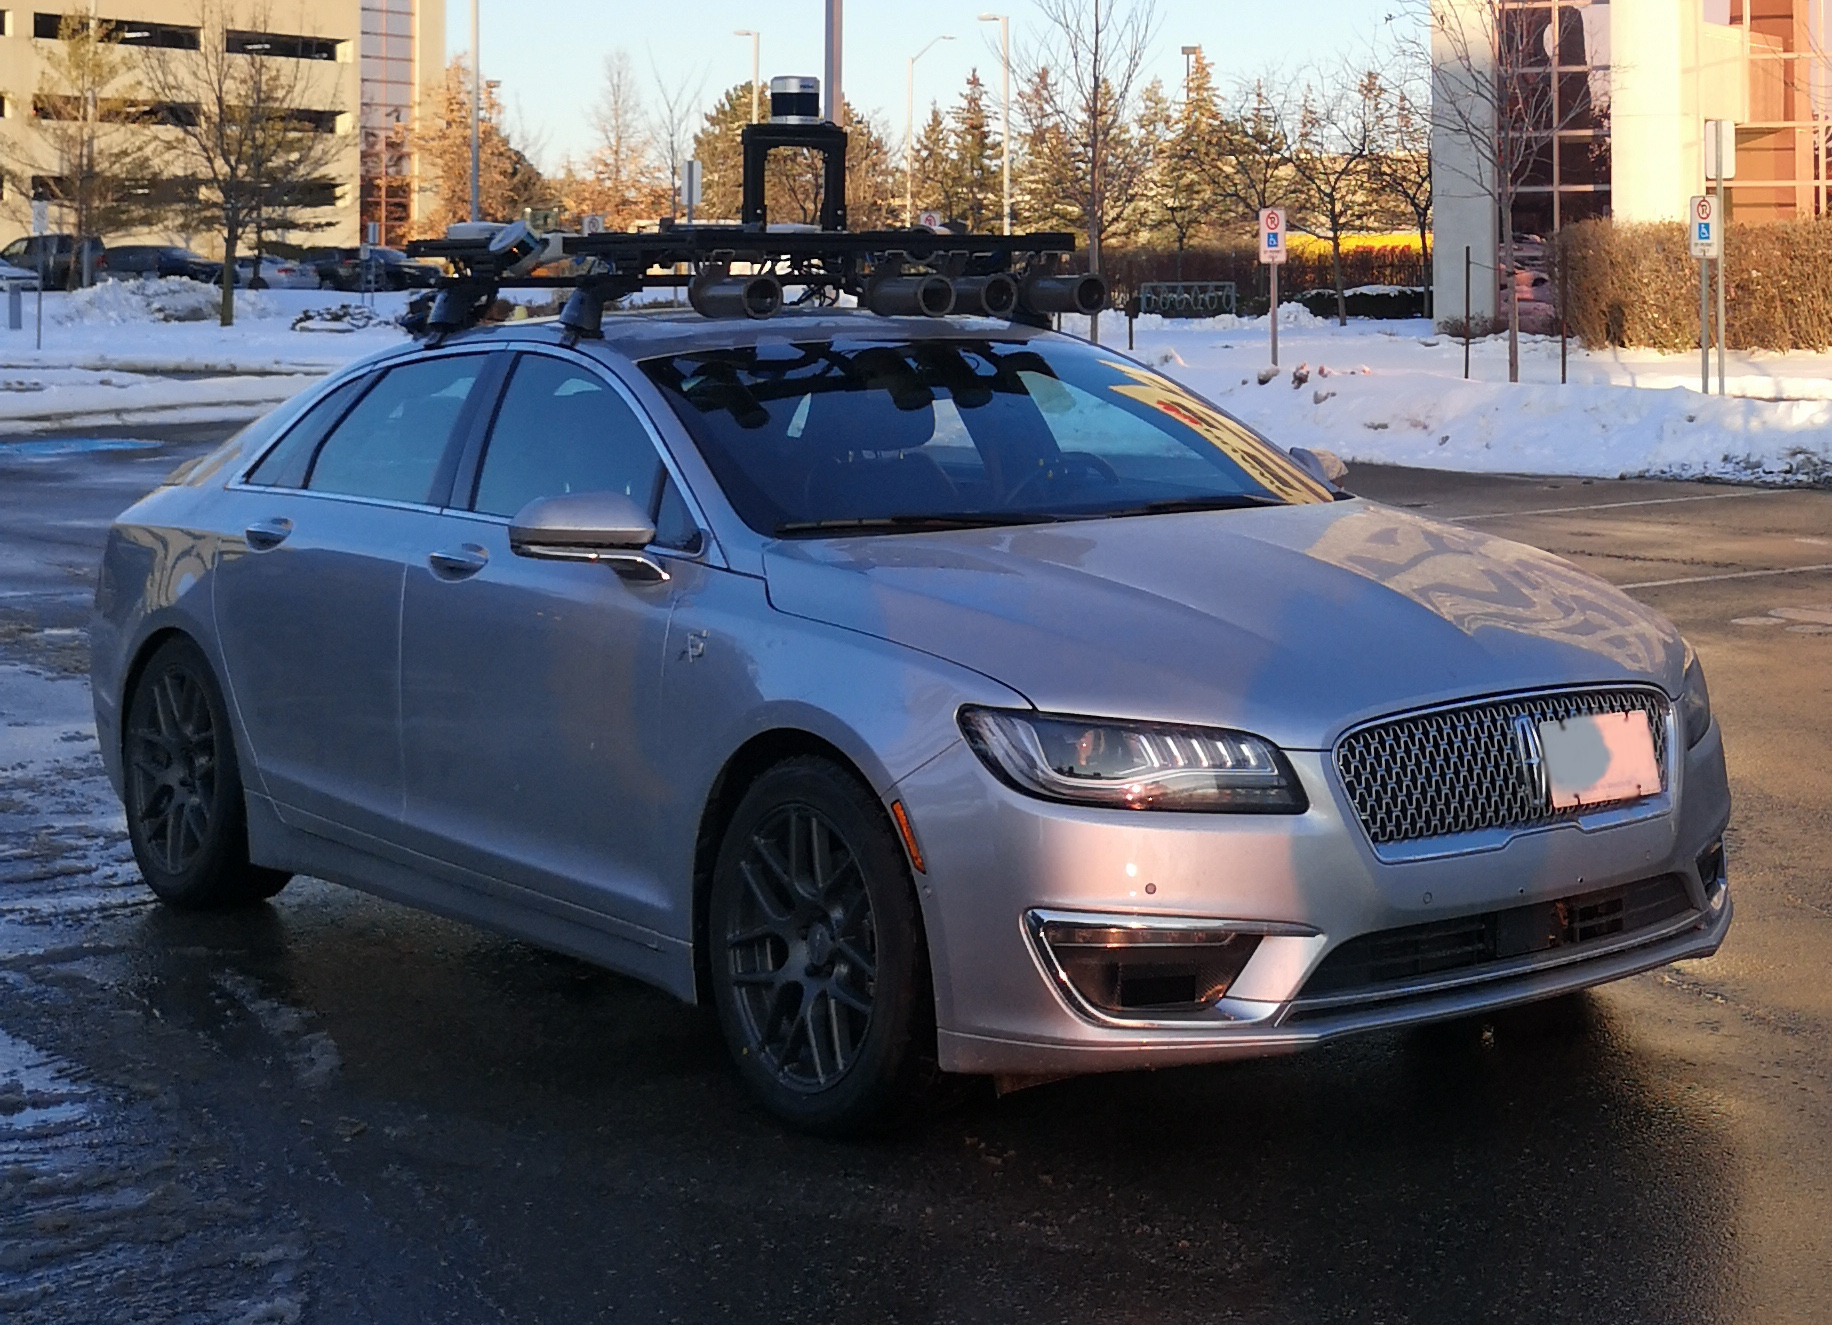
示意图0

所提出的评估框架将自动驾驶系统(ADS)视为一个黑箱模块,包含以下三个基本理念:1)设计一个对数据资源无关的评估系统,通过统一状态表示来消除针对不同模拟器使用不同评估平台的需求。2)提供一组默认的指标和场景配置,用于评估自动驾驶系统(ADS)解决方案。3)为用户提供一个应用程序编程接口(API),以定义其自身的指标集合。

图2展示了所提出的框架,其中来自模拟器或现实世界的测试数据通过状态转换模块被转换为标准状态的连续数据流(见第II-A节)。这些状态可以写入存储,以便后续进行离线评估。草图板(见第II-C节)解释标准状态流并将其传递给指标评估。评估的结果和日志均会显示给用户,并存储到数据平台,以便进一步分析和可视化。

A. 状态表示

真实状态是描述被测车辆(自我车辆)周围感兴趣区域(FOI)环境状态的信息。该真实状态包括此感兴趣区域内所有物体的状态,例如运动物体(如车辆、行人、动物等)、静止物体、道路标线、车道、交通标志和交通信号灯等。如图2所示,存在一个状态转换器,负责将任意格式的状态表示(非典型数据)转换为我们的标准格式。该数据结构被称为评估包(EP),是一种带时间戳的结构化数据包,用于表示环境的真实状态。事件点序列(EPs)是使用protobuf消息序列化语言实现的结构化消息,该方法被视为围绕开放仿真接口真实状态[22]的封装,添加了必要的字段以表示来自感兴趣区域(FOI)所需的所有信息。

事件点序列(EPs)可以从模拟环境或实车道路测试期间收集的数据中生成。

B. ADS评估器

评估器是用于执行自动驾驶系统评估的模块。根据我们的设计,评估器可以被视为围绕两个子组件(草图板和度量)的逻辑框架。这种设计使得评估器具有灵活性和可扩展性,如图2所示。评估器由事件驱动,这些事件定义了值得关注的发生情况,并可能影响结果。

C. 时空画板

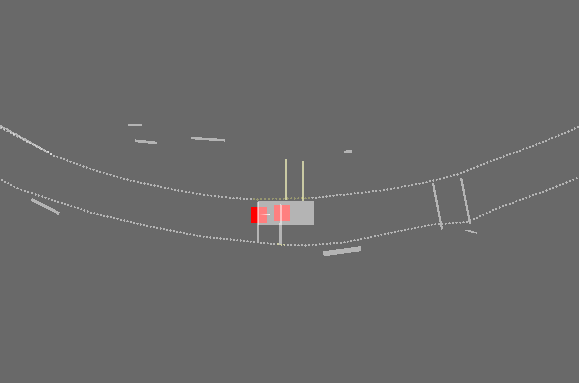
如第二节II-A中所述,事件点序列(EPs)表示环境在空间上和时间上的演变过程。为了提取有关感兴趣事件的有意义信息(例如多个物体的碰撞、车道边界穿越),在时空画板中重构状态。尽管它是对每个时间步系统状态的再现,但草图板与模拟器不同,它不会计算后续时间步的状态。其目的是基于给定时间步的环境状态来处理事件。例如,碰撞事件包含涉及的车辆、发生的时间戳、导致该事件的状态历史等上下文数据。

为了便于处理事件,草图板利用了游戏引擎(例如 Panda3D [23])。这使得可以将环境状态表示为场景图并进行目标跟踪。当满足特定条件时,会触发相应的回调函数。例如,两个运动物体在草图板中以其包围盒作为碰撞节点表示。如果两个包围盒相交,则会触发一个碰撞事件。
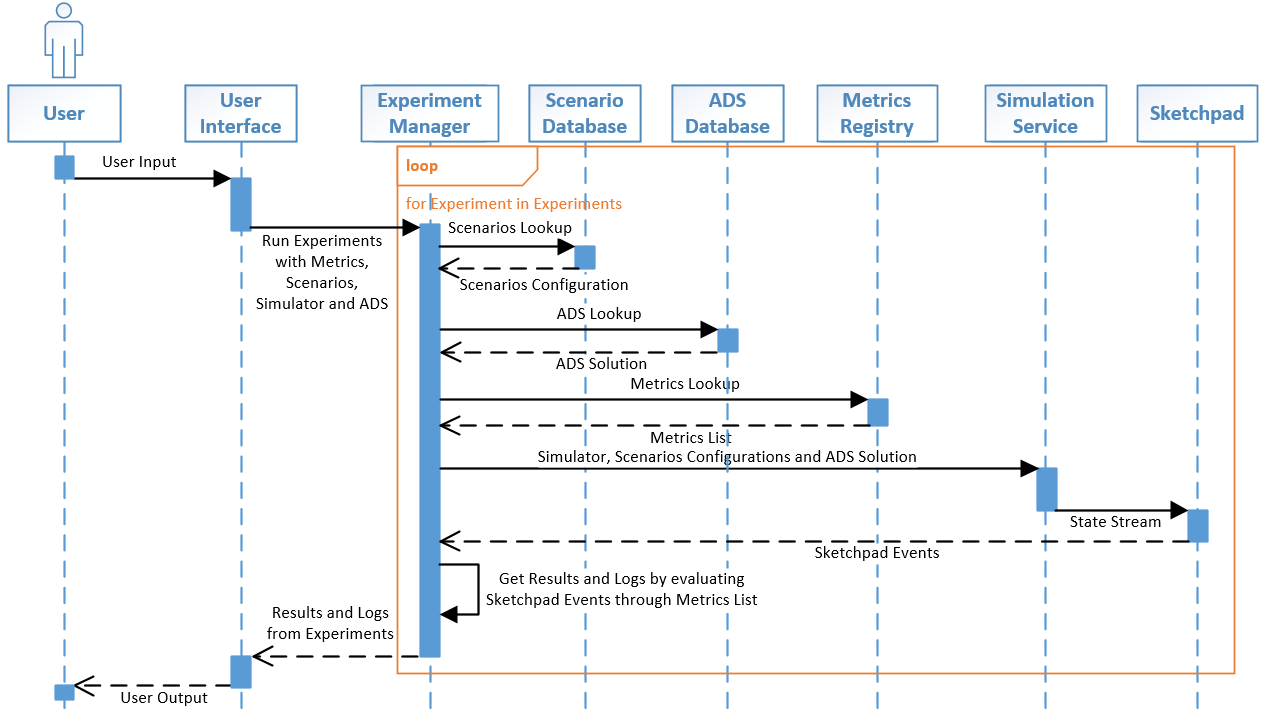
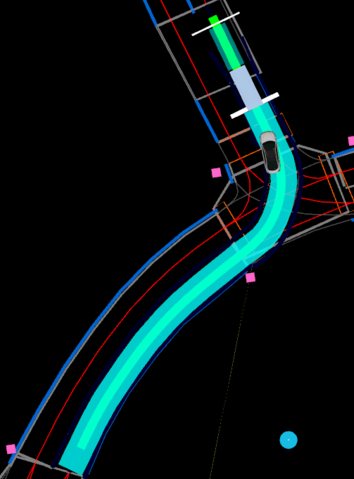
示意图1

示意图2

D. 分析

为了研究所提出框架的有效性,需要考察一系列评估指标。此外,为了确定具体采用哪些指标,我们需要考虑涵盖自动驾驶系统评估相关方面的评估空间。因此,考虑了以下维度:

  • 安全性 ,关注驾驶代理为驾驶员和其余交通参与者识别并执行稳定且安全计划的能力。
  • 舒适性 ,关注驾驶代理识别和执行对驾驶员和交通友好的计划的能力。
  • 可靠性 ,关注驾驶代理在合理时间内高效利用资源完成指定行程的能力。
1) 度量:

用于在评估空间中表示驾驶代理的定量度量。本文确定了多个度量,但仅包含其中一部分用于实验:

  • 碰撞
    1) 责任判定,通过了解碰撞中涉及的车辆的朝向和速度以及周围交通的状态来衡量。
    2) 严重性计算,通过了解碰撞中涉及的车辆的运动学和速度来衡量。

  • 车道违规
    1) 不安全变道,通过检测变道过程中是否使用转向灯来衡量。此外,了解邻近交通的状态对于理解此类违规的严重程度至关重要。
    2) 非法变道,通过结合地图/路线信息、车道边界并观察车道偏离事件来衡量。
    3) 频繁跨越车道边界,通过结合车道边界并观察非预期车道偏离事件来衡量。

  • 舒适性
    1) 纵向(加加速度),通过了解驾驶代理的加减速模式进行测量。
    2) 横向(晃动/转弯),通过了解驾驶代理的朝向和转向模式进行测量。

  • 交通规则
    1) 闯红灯,通过自车进入(或离开)交叉口时交通信号灯的状态来衡量。
    2) 停车/让行标志违规,通过已知的静态道路规则以及车辆在接近交叉口时的行为(在自车通过时)来衡量。
    3) 转弯车道违规,通过自车在转弯时所处的车道来衡量。

计算这些度量的确切方程不在本文的讨论范围内。

2) 场景:

场景是对用于评估特定驾驶代理的测试用例的表示。为了使场景具有意义,它们需要涵盖基础和极端驾驶情况以及各种情况。尽管已有努力致力于场景格式和含义的标准化[25],然而,场景与数据源/数据之间存在解耦问题。

表示仍然是一个具有挑战性的问题。场景设计和标准化不是本文的重点,但已经创建了一些场景来验证实验。示例场景包括:

  • 停车场
    1) 在室外停车场内行驶并尝试垂直停车。
    2) 在室内停车场(具有多层结构且传感器信号受限)内行驶并尝试垂直停车。

  • 信号交叉口
    1) 在交通信号灯控制交叉口进行无保护左转。

  • 无信号交叉口
    1) 驾驶通过各支路优先级不同的T型交叉口。
    2) 驾驶通过三向或四向停车标志控制交叉口。

  • 道路巡航
    1) 在单车道道路上从A点驾驶到B点(包括车道内障碍物避让)。
    2) 在多车道道路上从A点驾驶到B点(包括变道)。

3) 实验:

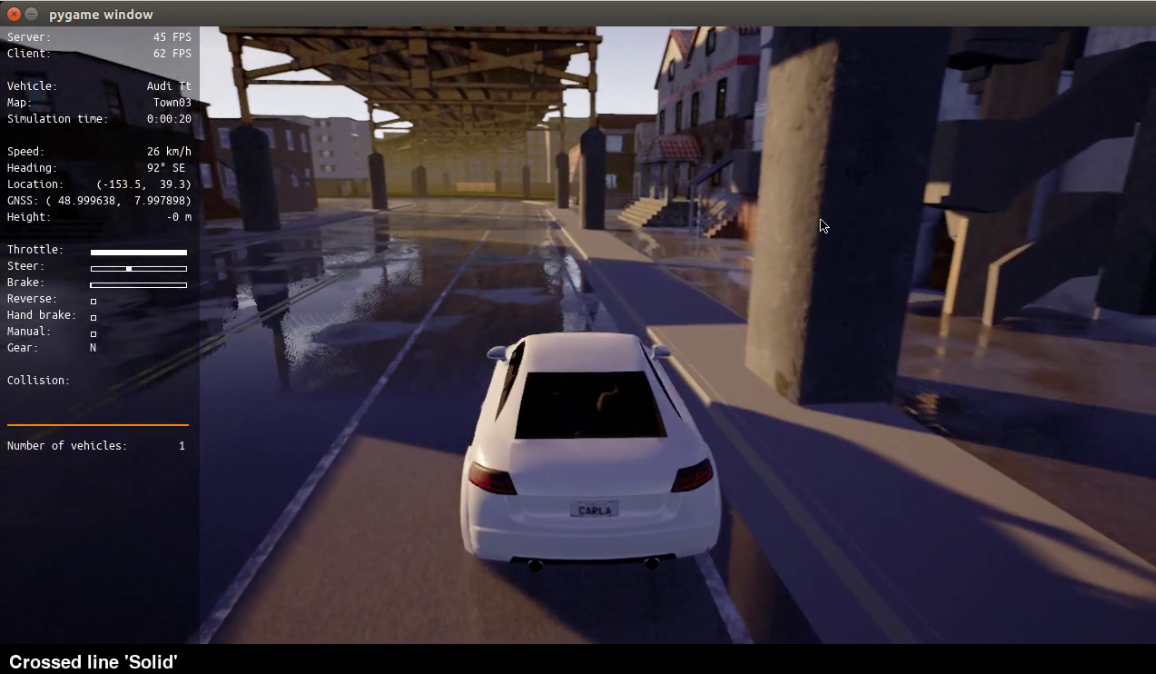
为了展示该框架的能力,确定并研究了四个用例。在第一个用例中,使用基于ROS的内部模拟器来研究自动驾驶系统在三向停车标志控制交叉口应对危险情况时的规划模块性能。在第二个用例中,使用相同的模拟器但采用不同场景,测试自动驾驶系统对交通信号灯控制交叉口的响应能力。在第三个用例中,在开源 CARLA模拟器[26]上测试了自动驾驶系统保持车道的能力。最后,该框架被用于通过采集的数据评估车辆在自动驾驶模式下的道路测试性能。图3描绘了用户如何通过模拟器服务运行一组实验。通过指定实验配置(指标、场景、自动驾驶系统和模拟器),模拟器服务的输出是一系列评估数据包,这些数据包由草图板处理,然后通过指标列表进行评估,形成实验结果。

a) 内部模拟器上的停车标志交叉口:

设计了一组实验,用于观察自车(由自动驾驶系统控制)在停车标志交叉口场景中与另一车辆(NPC车辆)交互时的行为,其中NPC车辆模拟“鲁莽驾驶者”,会忽略停车标志并以恒定速度通过交叉口。选择了三条轨迹和四种速度组合用于NPC车辆,该场景的道路布局如图5所示。目标是评估自车是否能在紧急情况下及时停车以避免碰撞,同时确保其遵守关于停车标志的道路规则。共运行了12个场景(3条轨迹 × 4速度)以及一个无NPC车辆的控制场景,结果如表I所示。

除了碰撞指标和责任分配指标外,还引入了纵向舒适度指标和停车标志违规指标,以便在成功避免碰撞的情况下提供更多的上下文信息。从表I可以看出,该自动驾驶系统在应对高速接近的NPC车辆时(无论方向如何)表现良好,但在应对某些情况下的NPC车辆时似乎存在困难。

在较低速度下,各种方法的表现有所不同。还值得注意的是,与北向南轨迹相对安全的情况相比,北向东轨迹似乎是该自动驾驶系统最危险的情况。

尽管有时会发生碰撞,但该自动驾驶系统仍以适当的方式遵守停车标志,如在全部12个数据点中均未出现停车标志违规行为所示。由于即使成功避免碰撞也需要强力制动,因此在所有未发生碰撞的情况下,纵向舒适度指标评分为2/5(发生碰撞时为不适用)。

b) 内部模拟器上的交通灯交叉口:

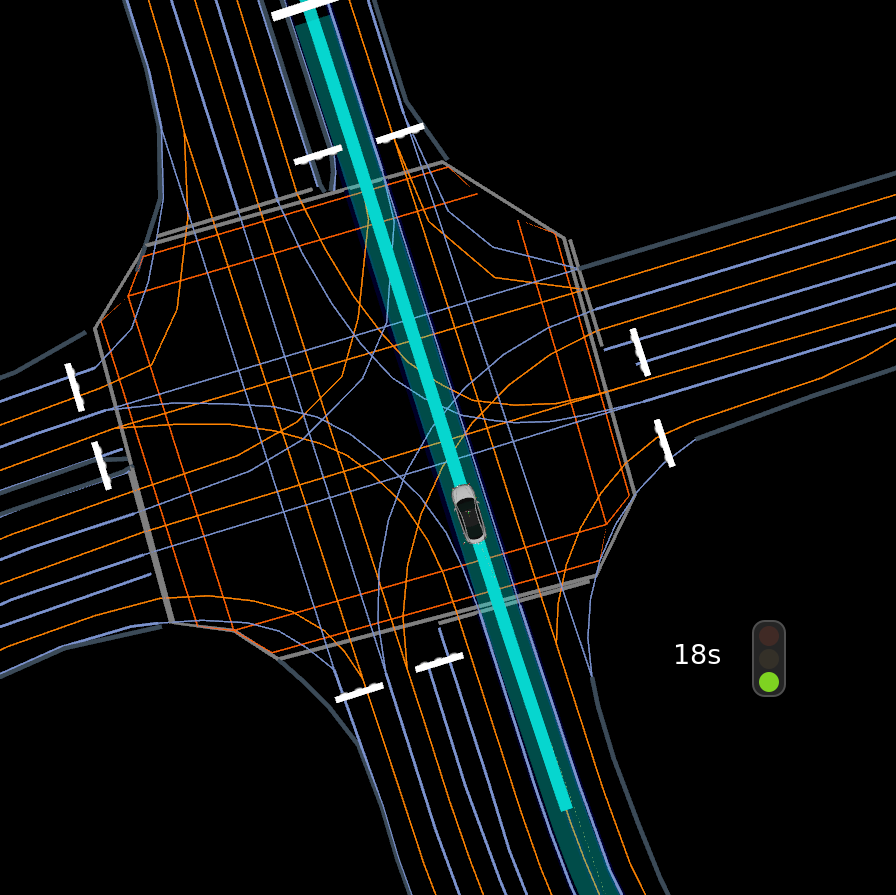
设计了一组不同的场景来测试自动驾驶系统对交通信号灯的反应,其中当自车接近交叉口时,交叉口处的交通信号灯会在不同距离处变为红色。实验分别在距交叉口25米、20米、10米和5米的距离下进行。图6显示了在模拟器上运行的其中一个实验的截图。

自动驾驶系统在红灯前停止的性能如表II所示。结果表明,自动驾驶系统完全能够在10米及以上的距离处停止,但在交叉口距红灯5米处停止时存在一些困难。

三、结论与未来工作

由于现有的评估方案缺乏来自不同测试来源的全面评估,我们的解决方案证明了其能够从不同的模拟器和实车道路测试中进行评估的能力。通过拥有良好的场景数据库和充足的实车道路数据,该框架可以被视为汽车 V模型标准中系统验证和确认步骤的一部分。

在未来的工作中,评估框架可以扩展以支持针对特定自动驾驶系统子系统(例如感知、定位、传感器融合、路径规划或控制)的测试。目前,该框架将自动驾驶系统作为一个黑箱处理其完整堆栈。在之前的工作中,我们假设除规划模块外的所有子系统均正常工作,因此仅评估了规划代理。为了实现更有意义的评估,我们计划研究更多可按子组件分类的指标和场景。

图表部分
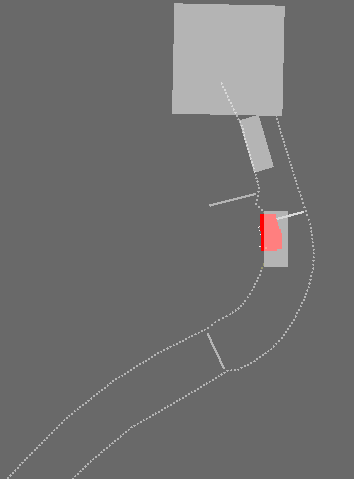
示意图3 非玩家控制车辆从交叉口北侧接近并左转。(b) 非玩家控制车辆从交叉口南侧接近并直行。(c) 非玩家控制车辆从交叉口北侧接近并直行。)

表I:自动驾驶系统代理在停车标志场景下的实验结果

实验编号 1 2 3 4 5 6 7 8 9 10 11 12 13
场景(NPC速度) 控制 20 图5a
15 17.5 20 22.5
图5a
15 17.5 20 22.5
图5a
15 17.5 20 22.5
图5a
15 17.5 20 22.5
图5b
15 17.5 20 22.5
图5b
15 17.5 20 22.5
图5b
15 17.5 20 22.5
图5b
15 17.5 20 22.5
图5c
15 17.5 20 22.5
图5c
15 17.5 20 22.5
图5c
15 17.5 20 22.5
图5c
15 17.5 20 22.5
闯停车标志违规 纵向舒适性 距离 [m] 0 5 - 0 n/a 1 0 n/a 1 0 n/a 1 0 2 0 0 n/a 1 0 n/a 1 0 2 0 0 2 0 0 n/a 1 0 2 0 0 2 0 0 2 0

示意图4

表II:ADS代理在交通灯场景中的闯红灯违章

距交叉口距离 [m] 25 20 10 5
闯红灯违章 0 0 0 1

示意图5

表III:CARLA上ADS的车道保持性能结果

实验编号 1 2 3 4 5 6 7 8 9 10 平均
违规距离 5,3 1,4 2,4,1,3 2,8 2,4,1,1 12 12 2,6,1 5,3,1 19,1 4.29
违规次数 2 2 4 2 4 1 1 3 3 2 2.4

示意图6

表IV:记录的道路测试数据评估

自动驾驶距离 [m] 自动驾驶距离占比 [%] 自主驾驶时间占比 [%]
2067.4 80.2 72.2
AgentThink:一种在自动驾驶视觉语言模型中用于工具增强链式思维推理的统一框架 这篇论文的创新点是 首次将动态的工具调用与链式推理统一到自动驾驶视觉语言模型中,通过结构化数据(构建微调数据)、两阶段训练(SFT+GRPO)和专门的工具使用评估显著提升了推理一致性、可解释性和决策准确性。 阅读详情

相关推荐

自动驾驶统一视角:表征、目标、优化与评估的四维融合

自动驾驶系统长期面临模块割裂、接口失真与长尾失效等核心挑战,其本质源于感知、预测、规划、控制各环节在表征、目标、优化和评估层面缺乏一致性。‘统一视角’作为一种新兴技术范式,主张构建跨模态世界状态表征(如4D Occupancy+语义场),设计可微系统级损失函数(SLL),实现全链路联合梯度优化,并以驾驶行为指纹(DBF)替代碎片化KPI评估。该范式并非否定多传感器融合或传统模块价值,而是通过更高维抽象使激光雷达、BEV感知、端到端模型等多元技术自然耦合,在保障物理可解释性的同时提升corner case鲁棒

414

AutoGPT如何识别低效路径?执行过程优化算法

本文探讨AutoGPT如何通过任务分解、路径监控与工具调度实现执行过程优化,重点分析其识别冗余操作、避免死循环的机制,并结合实战案例展示动态调整能力,揭示自主智能体在复杂任务中提升效率的核心技术。

weixin_42511373的博客 674

X4Val:面向自动驾驶的多源异构数据低方差评估框架

在自动驾驶系统安全验证中,多源异构数据(实车采集、仿真生成、不同传感器)的融合评估是核心挑战。传统监督式评估依赖严格配对与统一标签,难以应对真实场景中的时间失步、模态偏差与标注不一致问题。基于行为建模与神经代理技术,可实现跨域数据语义对齐;结合方差缩减方法,能显著提升风险量化置信度。该范式契合GB/T 46958-2025对‘多源异构数据融合评估’与‘低方差高置信度风险量化’的强制要求,已广泛应用于实车回传分析、仿真-实车一致性验证及功能安全证据包构建等工程实践。

weixin_30009115的博客 270

自动驾驶的潜世界模型:统一的分类、评估框架和未解决的挑战

26年3 月来自德国亚琛和荷兰代尔夫特理工大学的论文“Latent World Models for Automated Driving: A Unified Taxonomy, Evaluation Framework, and Open Challenges”。 新兴的生成式世界模型和视觉-语言-动作(VLA)系统正通过实现可扩展的仿真、长时程预测和功能丰富的决策,迅速重塑自动驾驶。在这些发展方向上,潜表示作为核心计算基础:它们压缩高维多传感器观测数据,实现时间上一致的部署,并为规划、推理和可控生成提

yorkhunter的博客 718

UniOcc:统一3D占用预测基准框架,解决自动驾驶数据孤岛难题

3D占用预测是自动驾驶感知与预测领域的核心技术,旨在通过体素网格对驾驶环境进行稠密、精细的几何与语义建模。其核心原理是将连续的三维空间离散化为体素,并预测每个体素的语义类别与占据状态,从而构建出场景的数字化表示。这项技术的价值在于为自动驾驶系统提供了超越传统边界框的、更丰富的环境理解能力,是实现安全规划与决策的关键基础。在实际应用中,它面临的一大挑战是数据孤岛问题——不同数据集(如nuScenes、Waymo)在格式、标注和坐标系上存在差异,导致模型开发、训练与跨数据集评估极为繁琐。UniOcc基准框架应运

weixin_34269583的博客 364

ORION:基于VLM引导动作生成的端到端框架——论文精度

基于大语言模型的框架,解决了时空问题

weixin_43163941的博客 361

Bench2DriveZoo:项目的核心功能/场景

Bench2DriveZoo:项目的核心功能/场景 Bench2DriveZoo 是一款面向自动驾驶系统的综合性能评估与优化平台。 项目介绍 Bench2DriveZoo 是一个开源项目,旨在为自动驾驶系统提供全面、高效的性能评估方案。该项目集成了多个先进的自动驾驶模型,如 BEVFormer、UniAD 和 VAD,这些模型均作为世界模型强化学习教师模型 Think2Drive 的学生模型。通过...

gitblog_00099的博客 817

point transformer v3结构

分割结构: embedding->enc->dec embedding->enc0->enc1->enc2->enc3->enc4->dec3->dec2->dec1->dec0 embedding ->block0->block1 ->dow->block0->block1 ->dow->block0->block1 ->dow->block0->block1-&gt

weixin_45625419的博客 583

UniTraj:统一框架实现车辆轨迹预测的规模化

UniTraj:统一框架实现车辆轨迹预测的规模化 项目介绍 UniTraj 是一个用于车辆轨迹预测的统一框架,它支持从现实世界数据集(如 Waymo、nuPlan、nuScenes 和 Argoverse2)中训练和评估轨迹预测模型。该框架的目的是为了简化车辆轨迹预测模型的开发和测试过程,提供一个易于配置和使用的工作流程。 项目技术分析 UniTraj 框架基于多个成熟的技术栈构建而成,包括 Hy...

gitblog_00518的博客 1126

从零开始:使用COLMAP与OpenMVS构建高精度三维Mesh模型

本文为零基础新手提供了使用COLMAP与OpenMVS构建高精度三维Mesh模型的完整实战指南。详细介绍了从环境配置、数据采集黄金法则,到COLMAP稀疏与稠密重建、OpenMVS网格生成与纹理映射的每一步操作,并分享了关键的避坑技巧与参数调优建议,帮助读者从二维照片中成功重建出属于自己的三维模型。

metal的博客 507

Nacos2.X 源码分析:为订阅方推送、服务健康检查、集群数据同步、grpc客户端服务端初始化

而Nacos2.X 从http请求改为了grpc请求的方式了,在健康检查这方面就是基于长连接来实现的。客户端发送心跳是在构建grpc连接时会有一个线程每隔5s发送一次,NacosClient端发送心跳的代码在。我们能大致猜测:当一个服务的实例进行了更新,那么是不是应该推送给所有订阅了该服务的客户端?当我订阅了某个服务,是不是应该将该服务信息推送给我?在服务实例检查检查流程中,如果出现了要注销的服务实例就会发布。在服务发现时,进行订阅服务的最后会发布一个。服务注册与服务订阅流程中发布的事件最终会被。

qq_44027353的博客 1595

LightEMMA:用于自动驾驶的轻量级端到端多模态模型

25年5月来自密歇根大学和密歇根大学交通研究所的论文“LightEMMA: Lightweight End-to-End Multimodal Model for Autonomous Driving”。 视觉-语言模型 (VLM) 已展示出端到端自动驾驶的巨大潜力。然而,充分利用其安全可靠的车辆控制能力仍然是一个开放的研究挑战。为了系统地研究 VLM 在驾驶任务中的进步和局限性,LightEMMA,一种用于自动驾驶的轻量级端到端多模态模型。LightEMMA 提供了一个统一的、基于 VLM 的自动驾驶框

yorkhunter的博客 1676

双翌视觉系统配合机械手大视野定位案例(单目标带角度抓取)

一、定位原理概述 1.系统构架 视觉定位系统采用正向打光方式,光源在机械手上方,CCD从上往下拍摄,进行图像分析定位。相机将计算出的像素坐标转换为机械手的物理坐标,视觉软件与机械手进行网口通讯,将视野内物料的物理坐标发送给机械手,机械手抓取物料放在指定工位。 2.相机标定概述 系统采用宫格标定确定像素坐标和物理坐标一一对应关系,同时利用3点或者多点旋转标定求出旋转中心 系统采用宫格标定,自定义行列数和间距及旋转角度,通过机械手发送的当...

weixin_51554164的博客 2173

AgentThink:在自动驾驶的一个统一框架,视觉-语言模型中工具增强的思维链推理

25年5月来自清华大学、Mcgill大学、小米公司和 Wisconsin(Madison)大学的论文“AgentThink: A Unified Framework for Tool-Augmented Chain-of-Thought Reasoning in Vision-Language Models for Autonomous Driving”。 视觉语言模型 (VLM) 在自动驾驶领域前景广阔,然而它们容易产生幻觉、推理效率低下,以及现实世界验证不足,这些因素阻碍了它们实现准确的感知和稳健的逐

yorkhunter的博客 1062

英飞凌TC3xx DSADC旋变软解码实战:从示波器波形到VX1000数据,手把手教你避坑

本文详细介绍了英飞凌TC3xx系列微控制器的DSADC模块在电机旋变软解码中的实战应用。从示波器波形分析到VX1000数据采集,提供了一套完整的调试方法论,帮助工程师快速定位和解决常见问题,提升解码精度和系统性能。

weixin_30598225的博客 517

STM32CubeMx搭建LWIP程序

  使用STM32CubeMx5.21,在stm32f745平台上搭建ethernet通信程序,PHY选用KSZ8081RNB。(LAN8742/DP83848使用一样) 1、系统时钟设置   RCC设置,勾选外部高速时钟源。   系统时钟配置。写入外部晶振频率、HSE提供PLCCLK、HCLK,其他参数自动生成。 2、ETH设置   勾选设置NVIC。   根据硬件设置对应GPIO引脚。   参数设置默认   根据硬件设置PHY地址,其他参数默认。 3、LWIP设置   勾选使能,通用参数设置

Gandalf94的博客 3240

《A Survey on Large Language Model based Autonomous Agents》深度解读:一篇读懂 LLM Agent 从架构、能力到评估的系统框架

《A Survey on Large Language Model based Autonomous Agents》深度解读:一篇读懂 LLM Agent 从架构、能力到评估的系统框架

Rocky Ding相信人工智能、数据科学、商业逻辑、金融工具、终身成长以及顺应时代的潮流会赋予我们超能力。 368

揭秘大厂智能生产调度AI系统架构:架构师拆解中台化设计3大优势

智能生产调度AI系统是基于AI算法(如遗传算法、强化学习、深度学习),结合生产数据(如订单、设备、库存、人员),自动生成最优生产计划与调度方案的系统。最大化设备利用率(减少停机时间);最小化生产周期(快速交付订单);优化库存水平(降低积压与短缺);提升准时交货率(满足客户需求)。维度传统调度系统智能调度AI系统决策逻辑规则引擎+人工经验AI算法(预测+优化)数据处理手工汇总+静态数据实时数据整合+动态更新适应能力固定场景(如单一产品、单一工厂)

AI Python 编程之道的博客 761

13-MCTrack:面向自动驾驶领域的统一三维多目标跟踪框架

本文介绍了MCTrack——一种全新的三维多目标跟踪方法,该方法在 KITTI 、nuScenes及Waymo数据集上均实现了业界领先(SOTA 级)的性能表现。针对现有跟踪方法存在的局限性(这些方法虽在特定数据集上表现优异但缺乏通用性),MCTrack提供了统一的解决方案。此外,我们统一了各数据集感知结果的格式(命名为BaseVersion),使多目标跟踪领域的研究人员无需承担过重的数据预处理负担,即可专注于核心算法开发。

2301_78173237的博客 227

大疆RoboMaster嵌入式面试,电机FOC调不出来当场走人

摘要:大疆RoboMaster嵌入式工程师面试以实战能力著称,重点考察FreeRTOS任务调度、FOC电机控制和CAN总线三大核心技能。FreeRTOS部分涉及优先级调度、栈溢出排查及信号量与互斥锁的区别;FOC控制要求现场编写电流环代码,并解释Clarke/Park变换原理;CAN总线则关注仲裁机制、CANopen协议应用及错误帧排查方法。面试强调工程实践,需具备STM32开发经验,建议搭建实际环境进行练习。该岗位被誉为"硬件版修罗场",充分体现大疆对实际开发能力的严格要求。

郑伟强dev的专栏 155

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

BDD100K:自动驾驶多任务学习终极指南 - 从数据标注到模型评估完整方案

在自动驾驶技术快速发展的今天,你是否曾面临这样的困境:训练模型时发现数据集标注格式不统一,评估指标难以横向对比,多任务学习框架搭建复杂?这些问题常常导致研发周期延长,算法迭代效率低下。BDD100K工具包正是为解决这些痛点而生,它提供了一个完整的自动驾驶多任务学习生态系统。 ## 为什么需要BDD100K:自动驾驶研发的真实痛点 自动驾驶系统的研发涉及多个视觉感知任务:目标检测、语义分割、车道

gitblog_00169的博客 234

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

【论文笔记】SparseAD: Sparse Query-Centric Paradigm for Efficient End-to-End Autonomous Driving

【论文笔记】SparseAD: Sparse Query-Centric Paradigm for Efficient End-to-End Autonomous Driving

weixin_45657478的博客 2466

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

自动驾驶安全迷思:从94%事故率到监管框架的工程现实剖析

自动驾驶技术的核心在于通过传感器融合、决策规划与控制执行等模块,实现车辆在复杂环境下的自主导航。其基本原理是模仿人类驾驶的感知-决策-执行闭环,但依赖算法与数据驱动。这项技术的价值在于提升交通效率、减少人为失误事故,并推动智慧城市与物流变革。然而,在迈向L4级高度自动驾驶的过程中,安全性与可靠性成为关键挑战。当前行业存在诸多迷思,例如误读“94%事故源于人为错误”的数据,将“可能避免”偷换为“导致”,从而设定虚假的安全对比基线。同时,关于“创新与监管不可兼得”的论点忽视了功能安全标准(如ISO 26262)

weixin_30564785的博客 587

Envision框架:因果推理评估的标准化解决方案

因果推理是人工智能领域的重要研究方向,其核心在于理解变量间的因果关系而非简单的相关性。传统评估方法存在指标不统一、场景覆盖不全等问题,导致模型对比困难。Envision框架通过设计CDA、CFC、TRS、DTR四个核心评估维度,构建标准化测试基准,解决了这一痛点。该框架支持多模态数据集评估,包含物理交互、社会行为等典型场景,并提供了Python接口快速集成。在自动驾驶、医疗诊断等实际应用中,Envision能有效识别模型在反事实推理、领域迁移等方面的缺陷,为因果模型的优化提供明确方向。

weixin_30751947的博客 366

南大&小米最新工作!MiLA:环视视频生成世界模型新SOTA!

涉及30+自动驾驶技术栈学习路线,从0到一带你入门自动驾驶感知(端到端自动驾驶、世界模型、仿真闭环、2D/3D检测、语义分割、车道线、BEV感知、Occupancy、多传感器融合、多传感器标定、目标跟踪)、自动驾驶定位建图(SLAM、高精地图、局部在线地图)、自动驾驶规划控制/轨迹预测等领域技术方案、大模型,更有行业动态和岗位发布!基于大型视觉语言模型(VLMs)设计自动化流水线,结合驾驶领域错误模式(如传感器误判、逻辑不一致、领域概念误解等),生成高真实性干扰项(Distractors)。

CV_Autobot的博客 581

DiffAD:自动驾驶的统一扩散建模方法

《DiffAD:基于扩散模型的端到端自动驾驶统一框架》摘要 本文提出DiffAD,一种创新的扩散概率模型,将自动驾驶重构为条件图像生成任务。针对现有端到端方法存在任务割裂、协调困难等问题,该框架通过将感知、预测和规划目标统一栅格化为BEV图像,利用潜在扩散模型进行联合优化。关键技术包括:多任务BEV表示、动作引导机制和轨迹提取网络。实验表明,DiffAD在CARLA仿真中取得SOTA性能(驾驶分数67.92,成功率38.64),显著提升动态场景处理能力。该方法首次实现自动驾驶任务的生成式统一建模,为降低系统

qq_54556560的博客 1308
上一篇: 30、匿名流量网络:原理、应用与挑战
下一篇: 40、动态 EC2 实例池的解耦与自动伸缩
sql99
博客等级 码龄19年 168粉丝 1905原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值