二分图的最佳完美匹配——KM算法

二分图匹配 2016.8.6 参考:《算法竞赛入门经典:训练指南》刘汝佳 陈锋 编著 《图论算法理论、实现及应用》 一、边独立集(匹配) 设无向图为 G(V, E) ,边的集合 E* ⊆ E,若 E* 中的任何两条边均不相邻,则称 E* 为 G 的边独立集(edge independent set),也称 E* 为 G 的匹配(matching) 所谓任何两条边均不相邻,通俗的讲,就是任何两条边都没有公共顶点 阅读详情
AI摘要

本文介绍了如何使用KM算法解决二分图中寻找最佳完美匹配的问题,即最大化匹配边的权值之和。KM算法是匈牙利算法的贪心扩展,通过不断调整可行顶标值,确保相等子图中存在最佳完美匹配。算法流程包括初始化可行顶标、寻找相等子图的完备匹配、调整顶标并重复此过程,直至找到最佳完美匹配。

二分图的最佳完美匹配


如果二分图的每条边都有一个权(可以是负数),要求一种完备匹配方案,使得所有匹配边的权和最大,记做最佳完美匹配。(特殊的,当所有边的权为1时,就是最大完备匹配问题)
我们使用KM算法解决该问题。

KM(Kuhn and Munkres)算法,是对匈牙利算法的一种贪心扩展,如果对匈牙利算法还不够明白,建议先重新回顾一下匈牙利算法。

KM是对匈牙利算法的一种贪心扩展,这种贪心不是对边的权值的贪心,算法发明者引入了一些新的概念,从而完成了这种扩展。

可行顶标


对于原图中的任意一个结点,给定一个函数 L ( n o d e ) L(node) L(node)求出结点的顶标值。我们用数组 l x ( x ) lx(x) lx(x)记录集合 X X X中的结点顶标值,用数组 l y ( y ) ly(y) ly(y)记录集合 Y Y Y中的结点顶标值。
并且,对于原图中任意一条边 e d g e ( x , y ) edge(x,y) edge(x,y),都满足 l x ( x ) + l y ( y ) > = w e i g h t ( x , y ) lx(x) + ly(y) >= weight(x,y) lx(x)+ly(y)>=weight(x,y)

相等子图


相等子图是原图的一个生成子图(生成子图即包含原图的所有结点,但是不包含所有的边),并且该生成子图中只包含满足 l x ( x ) + l y ( y ) = w e i g h t ( x , y ) lx(x) + ly(y) = weight(x,y) lx(x)+ly(y)=weight(x,y)的边,这样的边我们称之为可行边。

算法原理

  • 定理:如果原图的一个相等子图中包含完备匹配,那么这个匹配就是原图的最佳二分图匹配。

  • 证明 :由于算法中一直保持顶标的可行性,所以任意一个匹配的权值之和肯定小于等于所有结点的顶标之和,则相等子图中的完备匹配肯定是最优匹配。

这就是为什么我们要引入可行顶标和相等子图的概念。
上面的证明可能太过抽象,我们结合图示更直观的表述。
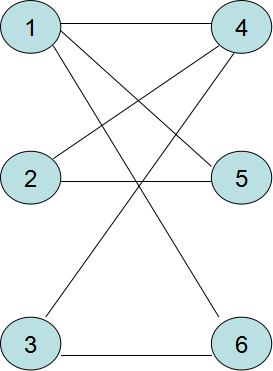
原图

该图表示原图,且 X = 1 , 2 , 3 , Y = 4 , 5 , 6 X = {1,2,3},Y = {4,5,6} X=1,2,3,Y=4,5,6,给出权值

w e i g h t ( 1 , 4 ) = 5 weight(1,4) = 5 weight(1,4)=5
w e i g h t ( 1 , 5 ) = 10 weight(1,5) = 10 weight(1,5)=10
w e i g h t ( 1 , 6 ) = 15 weight(1,6) = 15 weight(1,6)=15
w e i g h t ( 2 , 4 ) = 5 weight(2,4) = 5 weight(2,4)=5
w e i g h t ( 2 , 5 ) = 10 weight(2,5) = 10 weight(2,5)=10
w e i g h t ( 3 , 4 ) = 10 weight(3,4) = 10 weight(3,4)=10
w e i g h t ( 3 , 6 ) = 20 weight(3,6) = 20 weight(3,6)=20

对于原图的任意一个匹配 M M M
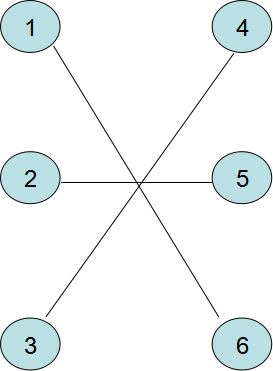
这里写图片描述

那么对于

e d g e ( 1 , 6 ) w e i g h t ( 1 , 6 ) = 15 edge(1,6) weight(1,6) = 15 edge(1,6)weight(1,6)=15
e d g e ( 2 , 5 ) w e i g h t ( 2 , 5 ) = 10 edge(2,5) weight(2,5) = 10 edge(2,5)weight(2,5)=10
e d g e ( 3 , 4 ) w e i g h t ( 3 , 4 ) = 10 edge(3,4) weight(3,4) = 10 edge(3,4)weight(3,4)=10

都满足 l x ( x ) + l y ( y ) > = w e i g h t ( x , y ) lx(x) + ly(y) >= weight(x,y) lx(x)+ly(y)>

KM算法入门 KM算法入门 在学习KM算法前,我们先感受一下匈牙利算法(由匈牙利数学家Edmonds提出)。 匈牙利算法 解决何种问题的呢 匈牙利算法是解决二分图的最大匹配度问题。 何为二分图 如果用染色法来判断的话,那么整幅图最后只会有两种颜色的元素;所谓二分图,就是可以划分为两个集合,且同一集合中的元素是互不相连的,不同集合中的元素是可以相连的。 下面我们通过一个简单的例子来说明: 现在... 阅读详情

相关推荐

km算法入门

本文知识均由笔者自学,文章有错误之处请不吝指出。 笔者刷数模题的时候有一道题考到了“二分图最大权分配”,需要用到KM算法,但是书上对KM算法的介绍又臭又长,更何况有些同学“匈牙利算法”也没学过(由匈牙利数学家Edmonds提出),自然难以理解所谓的KM算法。本文旨在用通俗易懂的语言,向读者介绍匈牙利算法和KM算法。 一、匈牙利算法 匈牙利算法用于解决什么问题? 匈牙利算法用于解...

weixin_30745553的博客 1485

匈牙利算法及KM算法详解

文章目录1 二分图相关概念2 匈牙利算法求解无权二分图最大匹配2.1 相关概念2.2 算法原理2.3 匈牙利算法代码3 KM算法求解加权二分图最优匹配3.1 相关概念3.3 KM代码示例 1 二分图相关概念 二分图定义: 二分图又称双分图、二部图、偶图,指顶点可以分成两个不相交的集U和V(U和V皆为独立集(Independent Sets)),使得在同一个集内的顶点不相邻(没有共同边)的图。 我们定义匹配点、匹配边、未匹配点、非匹配边。如图3中,1、4、5、7为匹配点,其他顶点为未匹配点;1-5、4-7为

zack_liu的博客 4898

Ubuntu18.04下Carla安装——经验史

Ubuntu下的Carla安装

m0_51267207的博客 2678

蛋白质组学进阶指南 | (八)差异蛋白筛选与功能解析实战

本文是蛋白质组学差异蛋白筛选与功能解析的实战指南。详细讲解了如何利用R语言的limma包进行差异表达分析,结合FDR校正和差异倍数设定筛选关键蛋白,并通过火山图可视化结果。进一步介绍了使用clusterProfiler进行GO与KEGG功能富集分析,以及利用STRING数据库和Cytoscape构建蛋白互作网络以识别枢纽分子,最终串联分析形成可验证的生物学假说。

weixin_29208077的博客 739

3D Gaussian Splatting:用于实时的辐射场渲染

3D Gaussian Splatting:用于实时的辐射场渲染 3d gaussian splatting for real-time radiance field rendering

m0_51976564的博客 1万+

硬件单板类机考复习提纲

6、 功率晶体管低导通损耗时处于的状态(饱和状态、放大状态、截止状态)(放大器的采样频率特性)总结:元器件特性(电阻、电容、二极管、三极管、晶体、晶振、MOS、磁珠等)信号质量问题产生根因(单调性、边沿过缓、毛刺、回沟、抖动等)3、 几种电容容量范围大小(超级电容、钽电容、陶瓷电容、铝电容)66、背板连接器接触设计的接触顺序(先导向、再地针、最后信号针)28、逻辑电平接口的特性(CMOS、TTL、ECL、PECL)76、差分电平(lvpecl、RS-422/485、cml)

2303_79562407的博客 1万+

SRA数据库

简介 序列读取存档(sequence Read Archive,SRA)数据是可通过多个云提供商和NCBI服务器获得的,它是最大的可公开获得的高通量测序数据存储库。 SRA接受来自生活各个部门以及宏基因组学和环境调查的数据。 SRA存储原始测序数据和比对信息,以提高可重复性并通过数据分析促进新发现。 NCBI网站储存二代测序原始数据的数据库 SRA官网 从Entrez搜索结果中下载SRA序列 例如查找SRA Entrez中BALB / c小鼠淋巴结组织的RNA-Seq记录 获取搜索结果 SRA se

qq_44520665的博客 5907

Dify 本地部署教程

到这里,Dify 就安装完成了,更多操作设置可以参考官方文档,Dify 和 FastGPT 基本上差不多,也可以同时安装一下 FastGPT 进行体验~Docker Compose 部署 | Dify。

Muti-Agent 6648

A*寻路算法的最简单通俗讲解

为什么我的眼里常含泪水?因为我有一个算法不会。为了节约点眼泪,今天我们就来介绍著名的A*寻路算法(或简称A*算法)。 Peter Hart, Nils Nilsson 和 Bertram Raphael 在1968年首次提出了著名的A*算法。A*算法其实是Dijkstra最短路径算法的一种扩展。不一样的是,在A*算法中我们需要使用Heuristics 来导引搜索过程,以期达到更好的表现。 ...

白马负金羁 2万+

在RStudio中使用GitHub Copilot:代码自动生成,从此告别手敲!

可以通过自定义提示词来引导Copilot生成符合自己需求的代码。再看一个做统计分析的。

Codewar的博客 330

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

上一篇: 二分图的最大匹配——匈牙利算法
下一篇: CSAPP学习笔记——Fraction Binary Numbers
SixDayCoder
博客等级 码龄12年 98粉丝 64原创
评论 14
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
