【论文解读】 MTSF跨模态对齐《TimeCMA: Towards LLM-Empowered Multivariate Time Series Forecasting》

TimeCMA: 通过跨模态对齐实现大语言模型驱动的多变量时间序列预测 本推文详细的介绍了一个通过跨模态对齐实现大语言模型驱动的多变量时间序列预测模型,该模型旨在解决多变量时间序列预测中信息表征弱、模型泛化差、计算开销大的关键难题。 阅读详情
AI摘要

本文提出 TimeCMA 框架用于多变量时间序列预测,利用双模态编码,通过跨模态对齐融合时间序列与 LLM 提示嵌入,提取优质特征。还设计“最后 token 存储”策略降低成本。在 8 个真实数据集实验显示,该框架在预测精度和计算效率上超越现有 SOTA 方法。

论文链接:https://arxiv.org/pdf/2406.01638

1. 摘要

  • 研究目标
    本文针对多变量时间序列预测(Multivariate Time Series Forecasting,MTSF)任务,提出了一种新型框架 TimeCMA,通过跨模态对齐(Cross-Modality Alignment)充分利用大语言模型(LLMs)的强大表示能力,从而提升时间序列预测的鲁棒性和精度。

  • 核心思想

    • 利用双模态编码:
      • 一条分支专门对时间序列数据进行编码,得到“解耦”但较弱的时间序列嵌入。
      • 另一条分支通过将时间序列数据包装成文本提示,利用预训练的 LLM 获得“纠缠”但鲁棒的提示嵌入。
    • 通过跨模态对齐模块,从提示嵌入中“检索”出既解耦又鲁棒的时间序列特征,融合两者“各取所长”。
    • 针对计算成本问题,设计了一种“最后 token 存储”策略,只保留每个提示的最后一个 token 用于下游预测,从而大幅降低计算开销与推理延迟。
  • 实验结果
    在 8 个真实数据集上的大量实验表明,TimeCMA 超越了现有的 SOTA 方法,无论是在预测精度(MSE、MAE)还是在计算效率上都有显著优势。


2. 背景与动机

  • 多变量时间序列预测的重要性
    多变量时间序列数据广泛存在于交通、环境、金融等领域。通过挖掘变量间的时序动态,可以为投资决策、天气预报等提供支持。
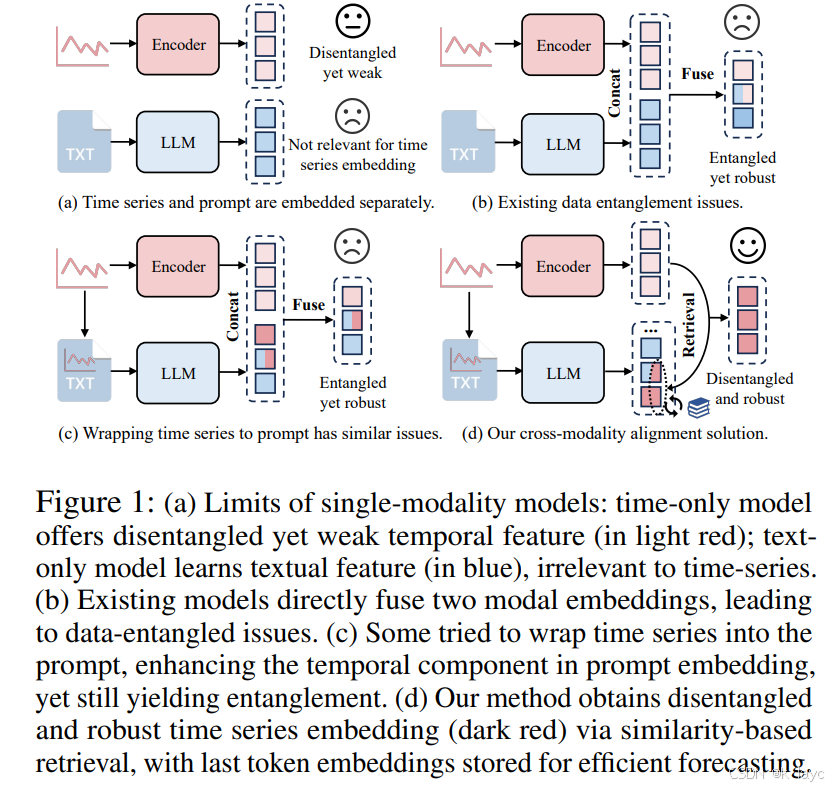
    在这里插入图片描述

  • 传统方法的局限

    • 统计方法与深度学习模型:参数较少、训练数据规模有限,难以捕捉复杂动态。
    • LLM-based 方法:近来尝试将 LLM 与时间序列结合,通过文本提示提升预测性能。但两类方法存在各自问题:
      • 时间序列-based LLMs:使用随机初始化的嵌入层处理时间序列,往往因数据量有限而导致嵌入质量较弱。
      • Prompt-based LLMs:将时间序列包装成文本提示,虽然能利用 LLM 的强大语义知识,但直接拼接得到的嵌入容易出现“纠缠”问题,噪声干扰较大,从而影响预测效果。
  • 数据纠缠问题
    现有方法通常将“解耦”的时间序列嵌入和“鲁棒”的文本提示嵌入直接拼接,导致混合后的表示既保留了弱的时间信息,也夹杂了噪声,进而降低了预测性能。


3. 方法论

TimeCMA 的设计主要包括三个模块:双模态编码、跨模态对齐以及时间序列预测。
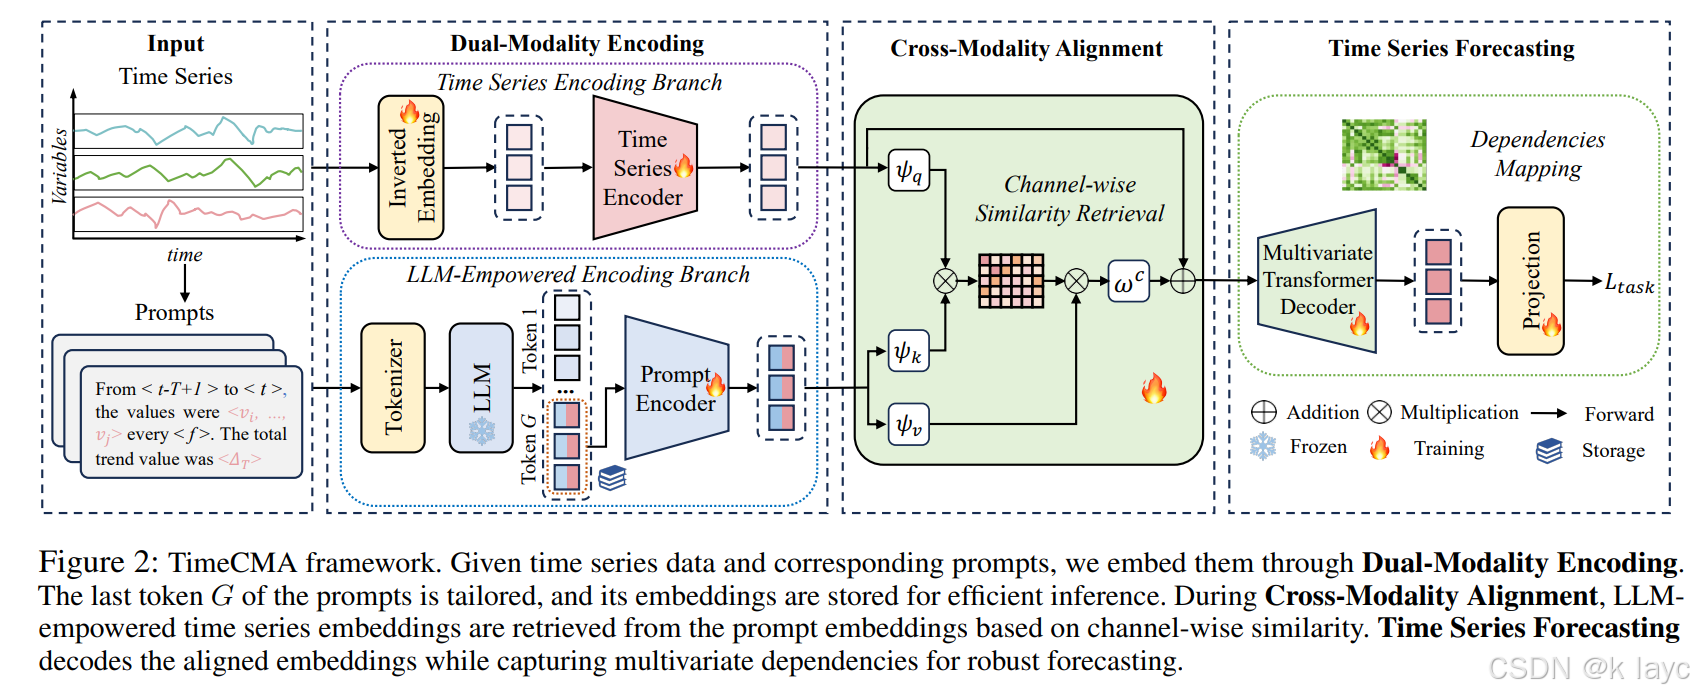
在这里插入图片描述

3.1 双模态编码

3.1.1 时间序列编码分支

  • 预处理与归一化
    将输入的多变量时间序列数据 X∈RL×NX \in \mathbb{R}^{L \times N}X∈RL×N 进行归一化处理(零均值、单位方差),以缓解分布偏移问题。

  • Inverted Embedding
    利用可学习的参数将整个时间序列看作一个 token,得到变量嵌入:
    HT=WeXT+be H_T = W_e X_T + b_e HT​=We​XT​+be​
    其中,WeW_eWe​ 和 beb_ebe​ 为可学习参数,HT∈RC×NH_T \in \mathbb{R}^{C \times N}HT​∈RC×N 表示时间序列的嵌入矩阵。

  • 时间序列编码器
    采用 Pre-LN Transformer 架构对 HTH_THT​ 进行编码。具体步骤包括:

    • 层归一化:
      H~iT=LN(HiT) \tilde{H}_i^T = LN(H_i^T) H~iT​=LN(HiT​)
      其中,LN(⋅)LN(\cdot)LN(⋅) 由可学习参数 γ\gammaγ 和 β\betaβ 调整:
      LN(HiT)=γ⊙HiT−μσ+β LN(H_i^T) = \gamma \odot \frac{H_i^T - \mu}{\sigma} + \beta LN(HiT​)=γ⊙σHiT​−μ​+β
    • 多头自注意力(MHSA):
      HiT=MHSA(H~iT)+HiT H_i^T = MHSA(\tilde{H}_i^T) + H_i^T HiT​=MHSA(H~iT​)+HiT​
    • 前馈网络(FFN)与残差连接:
      Hi+1T=FFN(LN(HiT))+HiT H_{i+1}^T = FFN(LN(H_i^T)) + H_i^T Hi+1T​=FFN(LN(HiT​))+HiT​
      FFN 的形式为:
      FFN(HiT)=max⁡(0,W1HiT+b1)W2+b2 FFN(H_i^T) = \max(0, W_1 H_i^T + b_1)W_2 + b_2 FFN(HiT​)=max(0,W1​HiT​+b1​)W2​+b2​

3.1.2 LLM-赋能编码分支

  • 文本提示包装
    将相同的时间序列数据包装成文本提示 PS∈RS×NP_S \in \mathbb{R}^{S \times N}PS​∈RS×N,其中包含时间信息(如时间戳、频率)以及数值信息。

  • 预训练 LLM
    使用 GPT-2 模型处理提示文本,模型参数均被冻结。通过分词器将文本转为 token 序列,并生成提示嵌入:
    PG=Tokenizer(PS) P_G = \text{Tokenizer}(P_S) PG​=Tokenizer(PS​)
    随后通过 GPT-2 得到嵌入:
    PG(i+1)=FFN(LN(PG(i)))+PG(i) P_G^{(i+1)} = FFN(LN(P_G^{(i)})) + P_G^{(i)} PG(i+1)​=FFN(LN(PG(i)​))+PG(i)​
    其中,PG(0)=PG+PEP_G^{(0)} = P_G + P_EPG(0)​=PG​+PE​(PEP_EPE​ 为位置编码)。

  • 最后 Token 存储
    为降低计算成本,设计提示使得最后一个 token 能够捕捉最关键的时间序列信息,并将其表示存储下来用于后续对齐与预测。

3.2 跨模态对齐模块

  • 目标
    利用跨模态对齐将时间序列分支生成的嵌入 HTH_THT​ 与 LLM 分支的提示嵌入 LNL_NLN​ 进行融合,从而提取出既解耦又鲁棒的时间序列特征。

  • 线性变换与相似性计算
    对 HTH_THT​ 和 LNL_NLN​ 分别通过三个线性层转换:
    ψq(HT),ψv(LN),ψk(LN) \psi_q(H_T),\quad \psi_v(L_N),\quad \psi_k(L_N) ψq​(HT​),ψv​(LN​),ψk​(LN​)
    然后计算通道级相似性矩阵:
    MT=Fsoftmax(ψq(HT)⊗ψk(LN)) M_T = F_{softmax}(\psi_q(H_T) \otimes \psi_k(L_N)) MT​=Fsoftmax​(ψq​(HT​)⊗ψk​(LN​))
    其中,⊗\otimes⊗ 表示矩阵乘法。

  • 特征聚合
    利用相似性矩阵将提示嵌入中的鲁棒时间序列信息聚合回来,并与原始时间序列嵌入相加:
    HC=ωc(ψv(LN)⊗MT)⊕HT H_C = \omega_c (\psi_v(L_N) \otimes M_T) \oplus H_T HC​=ωc​(ψv​(LN​)⊗MT​)⊕HT​
    其中,ωc\omega_cωc​ 为线性层,⊕\oplus⊕ 表示矩阵加法。

3.3 时间序列预测模块

  • Transformer 解码器
    将融合后的嵌入 HCH_CHC​ 输入到多变量 Transformer 解码器 MTDecoder(⋅)MTDecoder(\cdot)MTDecoder(⋅) 中,捕捉不同变量之间的长期依赖关系。

  • 预测投影
    最后使用投影函数生成未来 MMM 个时刻的预测:
    X^M=WpH^C+bp \hat{X}_M = W_p \hat{H}_C + b_p X^M​=Wp​H^C​+bp​
    其中 H^C\hat{H}_CH^C​ 为解码器输出,WpW_pWp​ 和 bpb_pbp​ 为投影层参数。

3.4 总体目标函数

  • 预测损失
    使用均方误差 (MSE) 作为预测损失:
    Lpre=1M∑i=1M(X^M−XM)2 L_{pre} = \frac{1}{M} \sum_{i=1}^{M} (\hat{X}_M - X_M)^2 Lpre​=M1​i=1∑M​(X^M​−XM​)2

  • 正则化损失
    加入 L2 正则化损失 LregL_{reg}Lreg​ 以防止过拟合。

  • 总损失
    最终目标函数为:
    Ltask=Lpre+λLreg L_{task} = L_{pre} + \lambda L_{reg} Ltask​=Lpre​+λLreg​
    其中 λ\lambdaλ 是用于平衡两部分损失的超参数。


4. 实验设计与结果
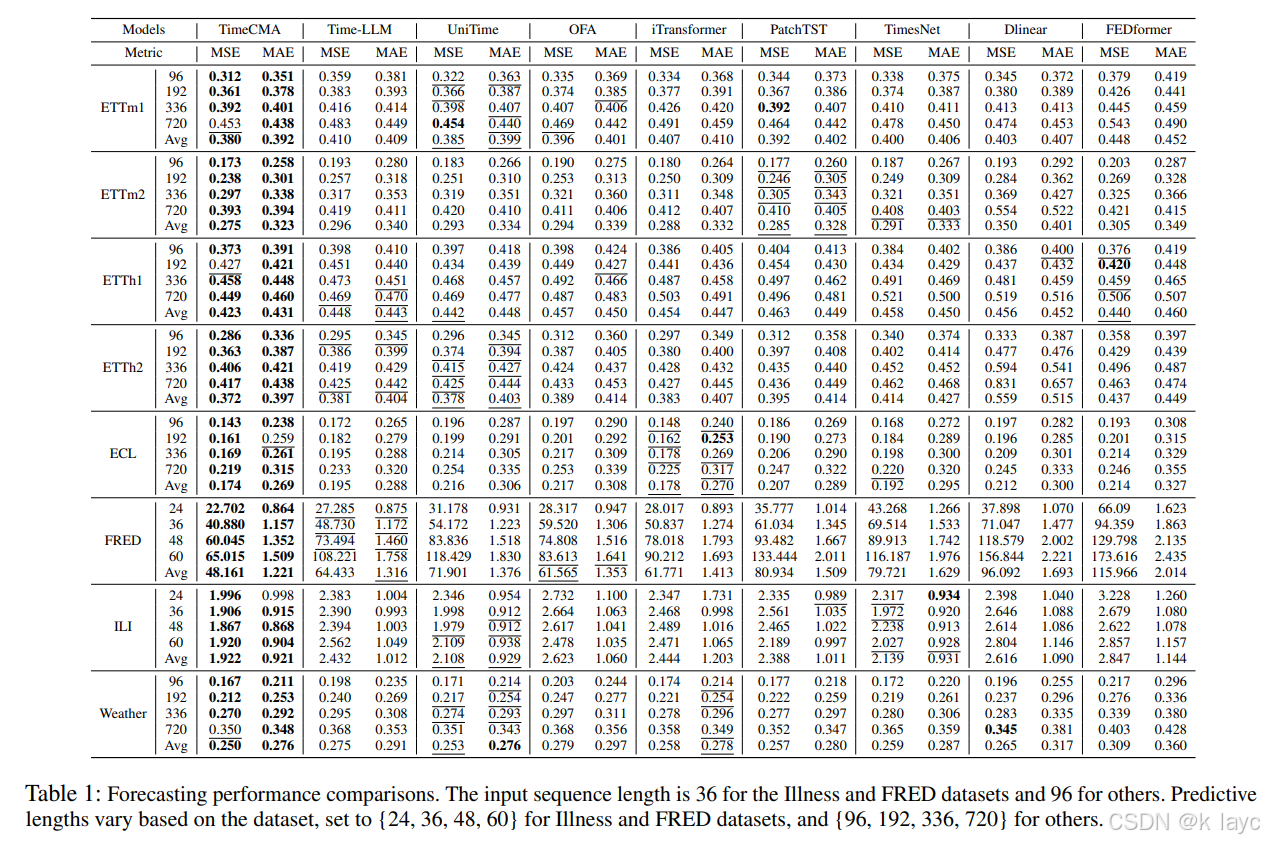
在这里插入图片描述

4.1 数据集与基线

  • 数据集:
    实验在 8 个真实数据集上进行,包括 ETTm1、ETTm2、ETTh1、ETTh2、ECL、FRED、ILI 和 Weather 数据集。

  • 基线方法:
    包括:

    1. Prompt-based LLMs(如 Time-LLM、UniTime)
    2. 时间序列-based LLM(如 OFA)
    3. Transformer-based 模型(iTransformer、PatchTST、FEDformer)
    4. 线性方法(Dlinear)
    5. CNN-based 方法(TimesNet)
  • 评价指标:
    使用均方误差 (MSE) 和平均绝对误差 (MAE) 作为主要评价指标。

4.2 主要实验结果

  • 总体表现:
    TimeCMA 在所有数据集上均优于现有基线方法,证明了其对多变量时间序列预测的有效性。

  • 关键对比:

    • LLM-based 方法优于传统方法:利用 LLM 的丰富知识和大规模预训练数据,TimeCMA 通过跨模态对齐有效提升了预测精度。
    • Prompt-based 优于时间序列-only 方法:引入文本提示后,TimeCMA 的表现相比纯时间序列模型(如 OFA)提升了约 16.1%(MSE 改进)和 11.9%(MAE 改进)。
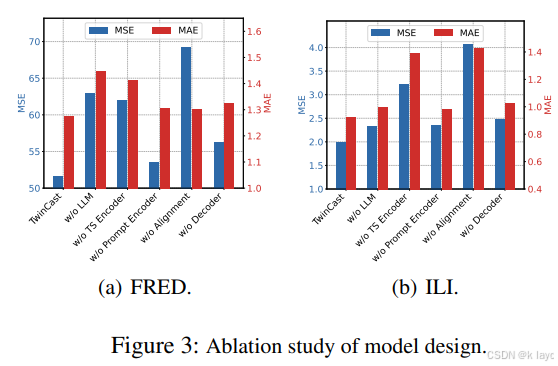
    • 消融实验:
      • 移除跨模态对齐(w/o Alignment)后性能显著下降,证明了该模块在融合“解耦”与“鲁棒”特征中的关键作用。
      • 移除 LLM 赋能分支(w/o LLM)和时间序列编码器(w/o TS Encoder)同样会导致预测性能的下降。
        在这里插入图片描述

4.3 效率分析

  • 最后 Token 存储:
    通过将提示的最后 token 表示提取并存储,仅用该部分进行下游对齐与预测,大幅降低了计算开销和推理延迟。

  • 实验对比:
    与传统 Time-LLM 和 OFA 方法相比,TimeCMA 在参数量、内存占用和推理速度上均有优势。例如,在 ETTm1 数据集上,TimeCMA 显示出更低的参数和内存使用,同时推理速度更快。

4.4 注意力与可视化分析
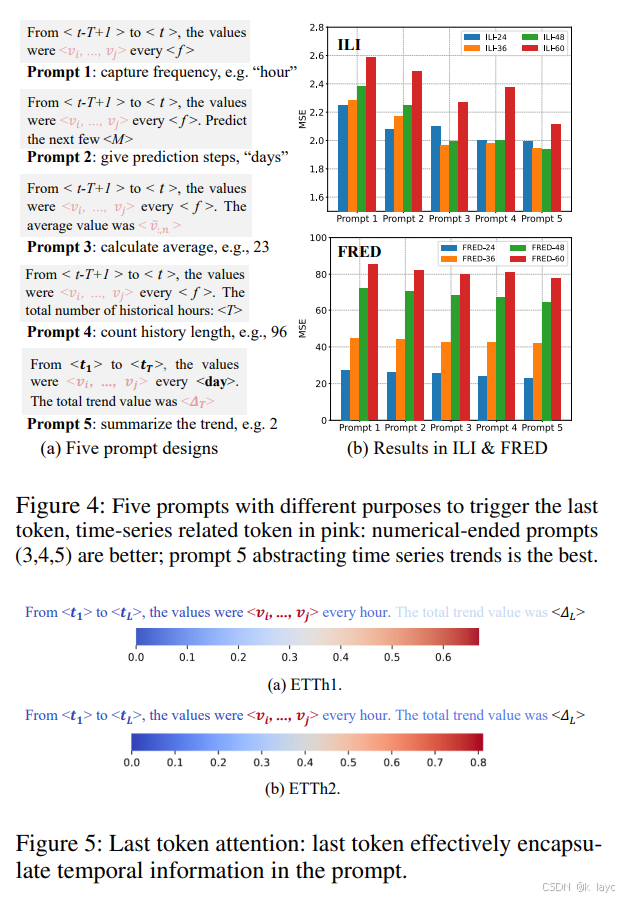
在这里插入图片描述

  • 注意力机制:
    可视化分析显示,Transformer 编码器(用于时间序列)主要捕捉局部、变量特异性的时序依赖,而 LLM 编码器(处理提示文本)则捕捉全局变量之间的依赖。两者互补的特性通过跨模态对齐得以有效融合。
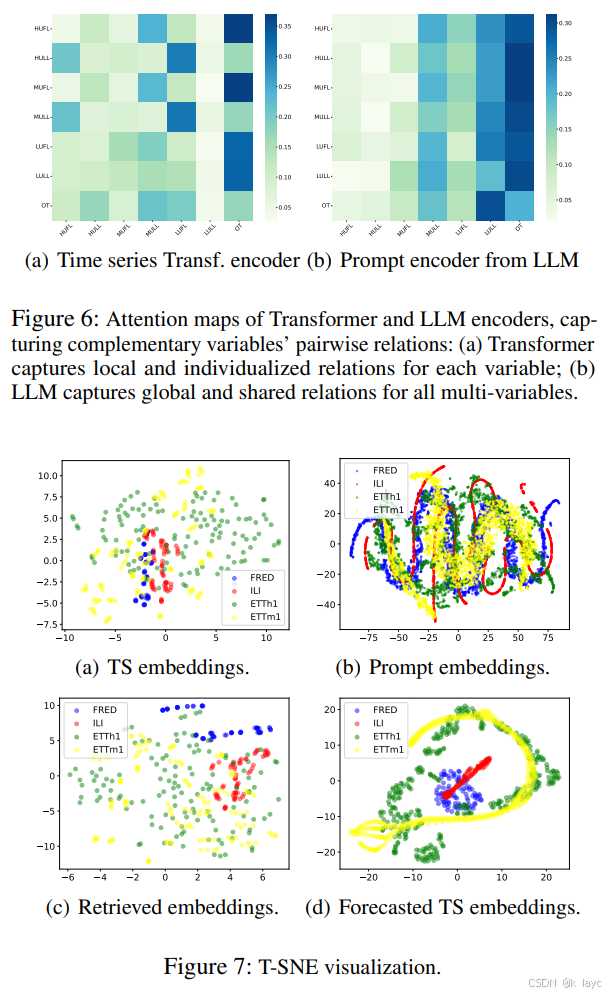
    在这里插入图片描述

  • T-SNE 可视化:
    T-SNE 分析展示了:

    • 时间序列嵌入在不同数据集之间形成较为清晰的聚类;
    • 提示嵌入显示出更复杂的交互关系;
    • 经过对齐后的预测嵌入形成了分布良好的聚类,证明了模型的投影函数能够有效利用检索到的跨模态特征。

5. 结论与讨论

  • 主要贡献:

    1. 提出了一种全新的 LLM-赋能多变量时间序列预测框架 TimeCMA,通过跨模态对齐实现“解耦且鲁棒”的时间序列嵌入。
    2. 设计了双模态编码分支,其中时间序列编码器利用 Inverted Embedding 和 Pre-LN Transformer 捕捉局部时序特征,而 LLM 赋能分支通过文本提示捕捉全局信息。
    3. 利用跨模态对齐模块,通过线性变换与通道级相似性检索,从提示嵌入中提取出更优质的时间序列特征。
    4. 引入“最后 token 存储”策略,大幅降低计算成本与推理延迟,提升了模型在实际应用中的效率。
    5. 在 8 个真实数据集上的实验验证了 TimeCMA 在预测精度(MSE、MAE)以及计算效率上的显著优势。
  • 局限性与未来工作:

    • 当前框架在跨模态对齐部分依赖于预训练 LLM(如 GPT-2)和特定的提示设计,未来可探索更多自适应对齐策略。
    • 针对更长时间序列和更多变量的数据,如何进一步优化 Transformer 结构以捕捉复杂依赖关系仍需深入研究。
    • 实验中使用的多个数据集均为公开数据集,未来可尝试在更多真实工业场景下验证模型的泛化能力。

6. 总结

论文 TimeCMA: Towards LLM-Empowered Multivariate Time Series Forecasting via Cross-Modality Alignment 提出了一种创新性的框架,通过双模态编码、跨模态对齐和高效的预测策略,实现了从大量文本提示中提取高质量时间序列特征。该方法不仅有效提升了多变量时间序列预测的准确率(通过显著降低 MSE 和 MAE),还通过最后 token 存储策略大幅降低了计算成本与推理延迟。大量实验结果表明,TimeCMA 在多个数据集上均超越现有最先进方法,展示了 LLM 在时间序列领域的巨大潜力。

TIME - FFM:探索时序预测任务上的联邦学习框架 时序预测 + 联邦学习 阅读详情

相关推荐

从零到一:3D-ResNet50在医学影像中的实战陷阱与避坑指南

本文深入探讨了3D-ResNet50在医学影像分类中的实战应用,重点解析了NIFTI数据预处理、小样本迁移学习陷阱及GPU显存优化等关键问题。通过分块加载、混合精度训练等技巧,有效解决了医学影像处理中的内存管理和性能挑战,为开发者提供了实用的避坑指南和优化策略。

weixin_29038345的博客 392

TimeCMA:基于跨模态对齐与最后一个token优化的高效时序预测框架

TimeCMA框架通过跨模态对齐与最后一个token优化,实现了高效的多变量时间序列预测。该框架结合时间序列编码与LLM增强分支,显著提升预测精度与计算效率,适用于金融风控、工业预测性维护等场景。实验显示,TimeCMA在预测误差、显存占用和推理速度上均优于传统方法。

weixin_29158413的博客 301

堆内存管理核心逻辑 超详细复习笔记

本文详细解析了堆内存管理的核心逻辑,包括初始化、分配和释放三个关键环节。系统通过全局堆管理结构体和链表机制实现动态内存管理:初始化时标记整块内存为空闲;分配时遍历链表查找合适空闲块并进行分割;释放时定位内存块头并重新标记为空闲,支持相邻块合并以减少碎片。文章对比了链表式管理和线性分配的优缺点,指出链表式更灵活但实现复杂,线性分配简单但无法释放。最后总结了常见错误(如指针回推错误、碎片问题)和扩展知识(不同内存管理算法)。这套机制是理解嵌入式系统和RTOS内存管理的基础。

2502_92009732的博客 1204

TimeCMA:通过跨模态对齐实现大模型赋能的多变量时间序列预测

文章信息论文题目为《TimeCMA: Towards LLM-Empowered Multivariate Time Series Forecasting via Cross-Modality Alignment》,论文提出了一种基于大语言模型的时间预测框架,通过模态对齐的方式实现使用LLM进行预测,并提出使用最后一个token进行解码的方法降低计算成本。摘要多变量时间序列预测(MTSF)旨在学习...

zuiyishihefang的博客 2673

MindIE与vLLM-Ascend性能对决:Qwen3在昇腾910B上的推理效率实测

本文深度对比了昇腾910B平台上两大推理框架MindIE与vLLM-Ascend的性能表现。通过实测Qwen3系列模型,详细分析了二者在单卡、多卡场景下的推理效率、扩展性及生产环境适用性,为AI算力基础设施选型提供关键参考。

weixin_29214335的博客 1193

程序设计二(面向对象)_实训10_复杂类的实现_ArrayList类的实现

第1关:构造函数与析构函数的实现

2401_83406306的博客 822

【AAAI2025】TimeCMA:LLM赋能!时间序列预测精度暴涨!

本研究介绍了一种名为TimeCMA的框架,它通过跨模态对齐来实现LLM赋能的多元时间序列预测。现有方法在学习解耦嵌入方面存在不足,因此,本研究提出一种双模态编码,包含时间序列编码分支和LLM赋能的编码分支。时间序列编码分支提取解耦但较弱的时间序列嵌入,而LLM赋能的编码分支将相同的时间序列与文本提示相结合,以获得纠缠但鲁棒的提示嵌入。这种跨模态对齐能够从基于时间序列和提示模态相似性的提示嵌入中检索出解耦且鲁棒的时间序列嵌入,从而实现**“两全其美”。此外,为了减少。

weixin_50092436的博客 1387

SAP-ABAP:SAP ABAP 深度解析:BAPI 从入门到精通 —— 原理、实战与自定义开发全指南

SAP ABAP BAPI 深度解析摘要 本文全面介绍了 SAP ABAP 中的 BAPI(业务应用程序编程接口)技术,涵盖以下核心内容: BAPI 定义与特点:BAPI 是 SAP 为业务对象提供的标准化编程接口,具有面向对象、封装业务逻辑、标准化错误处理和版本兼容性等特点。 BAPI 与 RFC 关系:所有 BAPI 都是 RFC,但需额外满足业务对象注册、标准化参数和错误处理等要求。 BAPI 核心作用:包括业务逻辑封装、系统集成、标准化错误处理、版本兼容和审计合规。 实战演示:通过创建销售订单的完整

baidu_35680696的博客 1034

AAAI 2025 | 时间序列(Time Seies)论文总结

AAAI 2025将在2025年2月25日到3月4日于美国费城( Philadelphia, Pennsylvania, USA)举行。AAAI 2025共有篇投稿(Main Technical Track),共录取了篇论文,录取率。本文总结了2025 AAAI上有关时间序列(time series)相关论文,共计55篇

suzukiwudi的博客 7473

数据质量管理的一些思考

背景 在近期的项目当中,我们为客户落地实施了数据资产平台。随后,在数据平台中接入了客户子公司的一个业务系统的明细数据。客户希望在我们的数据平台上通过数据探索和数据分析,来挖掘一些业务价值和业务创新点。 当我们拿到数据开始进行一些初步探索的时候,发现导入平台的数据质量存在一定的问题:例如一些用于数据分析的关键字段的值为空、一些本应该有主从关系的数据对应不上、数据分类混乱等。这些问题直接影响到了对...

IDEAL Garden 1万+

Android布局基础与UI设计入门:打造精美应用界面

恭喜你!现在你已经掌握了Android UI开发的基础知识,包括各种布局类型、常用控件的使用以及一些UI优化技巧。这些知识将帮助你设计出既美观又实用的Android应用界面。

m0_65382359的博客 2058

(AAAI2025) TimeCMA:LLM赋能时序预测

本文提出TimeCMA模型,通过跨模态对齐实现大语言模型(LLM)赋能的多元时间序列预测。针对现有方法直接将时序数据与文本特征拼接导致信息混杂的问题,作者创新性地设计LLM-Empowered编码模块,将时序数据转化为包含时间和数值信息的文本提示,经GPT-2处理提取最具代表性的最后一个token特征。模型采用双模态编码和跨模态注意力融合架构,有效提升了预测性能。实验结果表明该方法优于传统拼接方式,为时序分析与LLM结合提供了新思路。代码已开源。

OUC的搬砖日常 642

计算电磁学(三)有限差分方法

有限差分方法(FDM)是一种数值处理方法,通过将偏微分方程变换为一组代数方程,通过求解代数方程组来得到原边值问题的近似值。由于有限差分法非常简单,所以也特别的稳定高效。其中时域有限差分方法(FDTD)是电磁分析中的常用方法。在计算电磁学中,常用有限差分方法(finite difference equations)来替代微分方程。一个有限差分法通常包括三个步骤将求解域划分网格用有限差分方程逼近给定的微分方程求解在给定边界条件和初始状态下的方程常用的网格模型方阵斜方阵三角阵圆形阵。

CCC_B的博客 1640

TimeCMA+: 基于大语言模型与跨模态对齐的工业级时间序列预测优化

本文深入解析了TimeCMA+这一工业级时间序列预测优化框架。它通过创新的跨模态对齐机制,将大语言模型的语义理解能力与时间序列模型的结构化建模优势相结合,有效解决了工业数据噪声大、实时性要求高、可解释性差等核心痛点,为多变量时间序列预测提供了稳定、高效的解决方案。

potato的博客 367

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

跨模态对齐在时间序列预测中的妙用:TimeCMA框架设计思路解析

本文深入解析TimeCMA框架如何通过跨模态对齐技术革新多变量时间序列预测。该框架创新性地结合倒置嵌入和语言化Prompt设计,实现时间序列与语言模型的高效融合,在金融、医疗等八大场景中显著提升预测精度,同时优化推理效率与部署成本。

hill8的博客 812

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

如何用TimeCMA框架提升多变量时间序列预测?实战配置与效果对比

本文详细介绍了TimeCMA框架在多变量时间序列预测中的实战应用,通过环境配置、核心架构解析、数据预处理、Prompt工程和超参数调优等关键步骤,展示了其在金融风控、能源管理等领域的卓越性能。TimeCMA结合LLM的语义理解能力,显著提升了预测精度和可解释性,是处理复杂时序数据的理想解决方案。

weixin_30415113的博客 1230

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

AAAI-2025 时间序列(预测)31篇论文汇总

【AAAI2025时间序列预测论文精选】本届AAAI会议共收录63篇时间序列分析论文,其中预测类31篇。

SmartLab307的博客 6053

2024年NIPS中6篇时序大模型研究汇总

在对三种近期流行的基于大型语言模型的时间序列预测方法进行的一系列消融研究中,我们发现移除大型语言模型组件或者用一个基本的注意力层代替它,并不会降低预测性能 —— 在大多数情况下,结果甚至有所提高!我们还发现,尽管预训练的大型语言模型计算成本很高,但它们并不比从头开始训练的模型表现更好,它们无法体现时间序列中的顺序依赖关系,在少样本情境下也没有帮助。作者首先将时间序列转换为文本标记的形式。与最先进的基准相比,LPTM在实现更优的预测和时间序列分类结果的同时,所使用的数据量减少了40%,训练时间减少了50%。

u010681011的专栏 1538

TimeCMA: Towards LLM-Empowered Multivariate Time Series Forecasting via Cross-Modality Alignment文献阅读

大模型用于时序预测,多模态对齐

m0_55533319的博客 1118

NeurIPS 2024重磅出炉,时间序列依旧最强王者!附最全NeurIPS 24时序论文总结

本文提出了一种新的实例归一化方法——频率自适应归一化(FAN),通过傅里叶变换识别每个输入实例的主要频率成分,并显式建模这些频率成分在输入和输出之间的差异,从而有效处理非平稳时间序列中的动态趋势和季节性模式。FAN方法可以应用于任意预测模型,显著提高了预测性能。本文提出了一种新的模型Attraos,该模型结合了混沌理论,将现实世界的时间序列视为来自未知高维混沌动态系统的观测数据。通过非参数相空间重构嵌入和多尺度动态记忆单元,Attraos能够捕捉历史动态结构,并通过频率增强的局部演化策略进行预测。

m0_73122726的博客 4183

NeurIPS 2024 | 时间序列(Time Series)论文总结

链接作者关键词:分类,可解释性,泛化性AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 2867

ICML 2025 | 时间序列(Time Series)论文总结

预测,分类,异常检测,生成,概率预测,不规则时间序列,因果发现,基础模型,大语言模型,多模态等。如有疏漏,欢迎补充!

具身机器人和通用AI 2540

【论文笔记 · PFM】Lag-Llama: Towards Foundation Models for Time Series Forecasting

本文提出Lag-Llama,在大量时间序列数据上训练的通用单变量概率时间序列预测模型。模型在分布外泛化能力上取得较好效果。模型使用平滑破坏幂律(smoothly broken power-laws)。目前任务主要集中于在相同域的数据上训练模型。当前已有的大规模通用模型在大规模不同数据上进行训练,展现出了极强的泛化能力。本文训练了一个Transformer模型,使用大量时序数据进行训练并在未见过的数据集上进行测试。文章在Monash时序仓库上训练了Lag-Llama。

lokol.的秘密基地 3381

时序预测发论文新方向!大模型+时间序列引爆顶会

为帮助大家掌握大模型时代时间序列预测的研究方法,今天给大家分享58篇必读论文,原文和代码都有。

人工智能讲师分享前沿技术 2875
上一篇: 【论文解读】多模态检索《MegaPairs: Massive Data Synthesis For Universal Multimodal Retrieval》
下一篇: 【论文解读】微软《Phi-4-Mini Technical Report: Compact yet Powerful Multimodal Language Models》
k layc
博客等级 码龄11年 1069粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值