搞懂 LangChain RAG:检索、召回原理及 docid 的关键意义,大模型入门到精通,收藏这篇就足够了!

利用LangChain实现RAG 通过实际代码例子详细阐述如何实现RAG(检索增强生成) 阅读详情

在 LangChain 的 RAG(检索增强生成)流程中,检索(Retrieval) 和召回(Recall) 的核心是通过 “文本嵌入(Embedding)+ 向量匹配” 找到与用户查询最相关的文档片段,而docid(文档唯一标识)是连接 “原始文本” 与 “嵌入向量” 的关键纽带。下面结合 LangChain 的具体实现逻辑,拆解检索、召回原理及docid的作用:

一、LangChain RAG 的核心流程:从 “数据准备” 到 “检索召回”

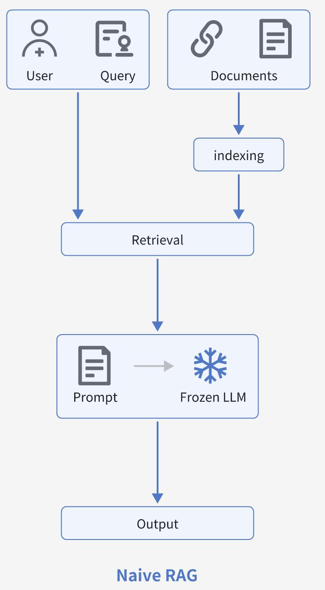
RAG 的核心目标是:让 LLM 在生成回答时,先 “检索” 到相关的外部文档(而非仅依赖自身训练数据),再基于这些文档 “生成” 答案。LangChain 将这个过程拆解为数据加载→文档分割→嵌入存储→检索召回→生成回答5 个步骤,其中 “检索召回” 是连接用户查询与文档的核心环节。

我们重点看与检索、召回相关的 3 个步骤:

1. 数据预处理:为文档生成嵌入向量和docid

在 RAG 启动前,需要先将原始文档(如 PDF、TXT、网页等)处理成可检索的格式,关键操作包括:

  • 文档分割(Chunking):长文档会被拆分为短片段(Chunk),例如将一篇 1000 字的文章拆成 5 个 200 字的片段。原因是:短片段的嵌入向量更精准(避免长文本中无关信息干扰),且匹配用户查询时更高效。

  • 生成嵌入向量(Embedding):对每个分割后的片段,用嵌入模型(如 OpenAI 的text-embedding-ada-002、HuggingFace 的all-MiniLM-L6-v2)转化为固定长度的向量(例如 1536 维)。这个向量捕捉了片段的核心语义。

  • 分配docid并存储:每个文档片段会被分配一个唯一标识(docid,可以是自定义字符串、UUID 等),同时存储 3 类信息:

    这些信息通常被存入向量数据库(如 Chroma、Pinecone、FAISS),形成 “docid→嵌入向量→原始文本” 的映射关系。

  • docid

    :片段的唯一 ID;

  • embedding

    :该片段的嵌入向量;

  • content

    :片段的原始文本(或元数据,如来源、页码等)。

2. 检索(Retrieval):用户查询与文档向量的匹配

当用户输入查询(如 “LangChain 如何实现 RAG?”)时,检索的核心是 “找到与查询语义最相似的文档片段”,步骤如下:

  • 查询嵌入化:用与文档预处理时相同的嵌入模型,将用户查询转化为嵌入向量(例如 1536 维,与文档片段向量维度一致)。

  • 向量相似度计算:在向量数据库中,用相似度算法(如余弦相似度、欧氏距离)计算 “查询向量” 与 “所有文档片段向量” 的相似度得分。得分越高,说明两者语义越相关。

  • 筛选 Top-K 结果:根据相似度得分排序,取前 K 个(如前 3 个)最相关的文档片段,返回它们的docid和原始文本。

    例如:用户查询 “RAG 的检索原理”,向量数据库中 “讲解向量匹配的片段” 会因语义高度相关,得分最高,被优先检索出来。

3. 召回(Recall):获取相关文档并传递给 LLM

“召回” 在 RAG 中可理解为 “将检索到的相关文档片段提取出来,作为上下文传递给 LLM”。具体来说:

  • 基于检索步骤返回的docid,从向量数据库中提取对应的原始文本片段(content)。

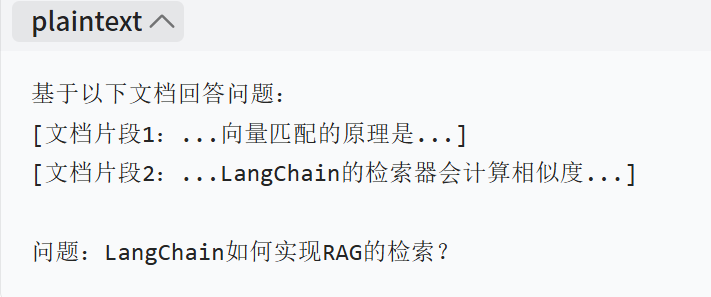
  • 将这些片段与用户查询一起拼接成提示词(Prompt),例如:

  • 将提示词输入 LLM,让其基于召回的文档生成回答(避免编造信息)。

二、docid的核心作用:连接 “嵌入向量” 与 “原始文本” 的桥梁

在整个流程中,docid是一个不起眼但关键的 “中间标识符”,其作用体现在:

  1. 唯一标识文档片段

    :无论是长文档分割后的片段,还是单条短文本,docid确保每个待检索单元都有唯一 ID(避免重复或混淆)。

  2. 关联向量与原始文本

    :向量数据库中存储的是 “嵌入向量” 和 “docid”,而原始文本(content)可能单独存储(或与docid绑定)。通过docid,可以快速从 “检索到的向量” 定位到 “对应的原始文本”(这是召回的前提)。

  3. 支持元数据管理

    :docid通常会关联元数据(如文档来源、作者、时间),方便后续过滤(例如 “只检索 2023 年后的文档”)。

例如:假设docid=chunk_123对应 “向量匹配的原理是通过余弦相似度计算”,当检索到该片段的向量时,通过docid=chunk_123即可找到原始文本,进而传递给 LLM。

三、检索召回的核心原理:“语义相似性” 而非 “关键词匹配”

传统搜索引擎依赖 “关键词匹配”(如查询含 “RAG” 则返回所有含 “RAG” 的文档),而 LangChain RAG 的检索召回基于 “语义相似性”,这是由嵌入向量的特性决定的:

  • 嵌入向量捕捉的是文本的 “语义含义”,而非字面关键词。例如,“如何用 LangChain 做检索增强?” 和 “LangChain 的 RAG 实现方法” 这两个查询,字面不同但语义相似,它们的嵌入向量会非常接近,因此会检索到相同的文档片段。
  • 这种特性让 RAG 能处理 “同义词查询”“意译查询” 甚至 “跨语言查询”(如英文查询匹配中文文档,前提是嵌入模型支持跨语言)。

总结:LangChain RAG 中检索、召回与docid的关系

  1. 检索

    :通过 “查询向量” 与 “文档片段向量” 的语义相似度计算,找到最相关的docid列表。

  2. 召回

    :根据docid提取对应的原始文本片段,作为上下文传递给 LLM。

  3. docid

    :是连接 “嵌入向量” 和 “原始文本” 的唯一标识,确保检索结果能准确映射到可用于生成的文本内容。

简言之,整个流程的核心逻辑是:用嵌入向量实现语义级别的检索,用docid实现向量到文本的精准召回,最终让 LLM 基于召回的信息生成可靠回答。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

LangChain入门2 RAG详解 最常见的方法是嵌入每个文档分割的内容,并将这些嵌入插入到矢量数据库(或矢量存储)中。当我们想搜索分割时,我们采用文本搜索查询,嵌入它,并执行某种“相似性”搜索,以识别嵌入与查询嵌入最相似的存储分割。我们将使用LCEL Runnable协议来定义链,使我们能够以透明的方式将组件和函数管道连接在一起,在LangSmith中自动跟踪我们的链,从而获得流式、异步和批量调用。我们想要创建一个简单的应用程序,该应用程序接受用户问题,搜索与该问题相关的文档,将检索到的文档和初始问题传递给模型,并返回答案。 阅读详情

相关推荐

使用 Dedoc 与 LangChain 实现文档解析与处理

文档:DOCX、PDF、HTML表格:XLSX、CSV图像与扫描文档:通过 OCR(如 Tesseract)解析文本邮件:EMLDedoc 的强大在于其对文档结构的提取能力,比如标题、列表项、表格等。通过结合 LangChain 的或 API loader,我们可以方便地将文档内容导入到 LangChain 的处理流水线中。

FADxafs的博客 2101

【开源啦!】Langchain官方文档中文翻译项目 ——langchain-doc-zh

LangChain是使用非常广的大模型编排工具,可以低代码的做大模型各种应用,有点类似在数据分析处理里面Pandas的地位。所以我有了一些想把一些工具的文档翻译成中文的想法。希望对于大家有一些帮助。由于文档较多,人力和能力都有限,有可能很多地方有问题,如果发现,请给我反馈,我会修改优化。希望能抛砖引玉,更多人加入到翻译优秀AI工具文档中,对于国内广大Langchain使用者有一点帮助。未来我也会陆续翻译更多的优秀AI工具的文档。

数智笔记 3077

复活Ask Jeeves:用RAG+轻量LLM实现可信对话式搜索

对话式搜索是一种以自然语言为输入、直接返回精准答案的信息检索范式,其核心在于语义理解、知识溯源与幻觉抑制。相比通用大模型的开放生成,它更强调RAG增强的检索可靠性、轻量级LLM的可控推理,以及端到端可验证的答案生成机制。该技术路径显著降低事实性错误风险,提升医疗、法律、政务等高敏场景的落地可行性。典型应用包括企业知识库问答、智能客服系统与历史产品现代化重构——正如Ask Jeeves的AI重生实践所示,它不追求参数规模,而专注让每一次回答都带来源、可审计、不编造。

weixin_30394981的博客 320

langchain加载.doc、.docx遇到的问题

这行日志来自unstructured包,每次在不同的地方执行langchain加载.doc的方法,都要重新下载unstructured包,并修改unstructured\partition\common.py的源码。安装完成后,还需要把 LibreOffice 的路径(你的安装盘\LibreOffice\program)添加到系统的 PATH 环境变量中。(1)安装 如果你需要使用 soffice 命令,你需要在你的系统上安装 LibreOffice。如果始终下载不成功,可尝试‘云梯’科学上网后再下载。

qq_19072921的博客 3072

Java 后端接入 DeepSeek:Spring AI 2.0 + LangChain4j + Alibaba 实战

Java 后端开发者在构建大模型应用时,常面临模型接入方式不统一、业务数据难以进入模型、输出结果不可控等工程化痛点。Spring AI 2.0 作为官方抽象层,提供统一 ChatClient 接口与结构化输出能力;LangChain4j 以轻量、不依赖 Spring 的特性,适合快速实现 Agent 与工具调用;Spring AI Alibaba 则补齐了向量检索、工作流编排等国内生产级能力。三者组合可覆盖从 DeepSeek 对话接入到 RAG 知识库构建的完整链路。本文从基础概念讲起,结合实际代码示例,

weixin_33563728的博客 306

本地部署AI模型实战指南:4GB显存起步的Windows 11落地方案

本地部署AI模型是指将大语言模型在用户自有硬件上运行,而非依赖云端API服务。其核心原理是通过模型量化(如GGUF格式)、CPU-GPU混合推理与轻量级架构(如Tauri)突破硬件限制,实现数据不出内网、响应可控、审计可追溯的技术闭环。该方案显著降低企业合规风险与长期使用成本,广泛应用于金融文档分析、制造业知识问答、律所合同审查等强数据敏感场景。本文聚焦Windows 11环境下的低门槛落地路径,详解4GB显存核显设备如何稳定运行Qwen2-1.5B等主流模型,并深度整合RAG与OpenAI兼容API,提供

weixin_33874713的博客 529

SpringAI系列|第5篇:RAG检索增强生成

本文深入解析了RAG(检索增强生成)技术在企业知识库中的应用。主要内容包括:1)RAG原理剖析,通过检索+生成两阶段解决AI幻觉问题,确保回答基于企业真实文档;2)Spring AI实现方案,包含离线索引(文档解析、分块、向量化存储)和在线查询(相似度检索、Prompt构建、LLM生成)全流程;3)实战演示,提供PDF/Markdown文档处理、PGvector集成、温度参数调优等具体代码实现。该方案能有效解决传统AI对话的知识局限性和不可溯源问题,适用于客服系统、内部知识库等场景。

weixin_45226411的博客 597

企业级PDF问答系统安全架构:从AAD认证到审计溯源

企业级PDF问答系统本质上是AI驱动的敏感文档访问服务,其核心挑战不在RAG召回或大模型能力,而在身份可信传递、数据权限隔离与操作全程可审计。它依托Azure AD实现用户身份断言(Claims)、On-Behalf-Of(OBO)委托授权及存储层RBAC三重校验,构建端到端的权限链;通过Assistants线程级文件挂载、元数据标记与Immutable Blob策略,确保文档级隔离与防篡改;最终借由Azure Monitor、AD日志与KQL跨服务关联分析,将一次提问还原为可追溯的完整行为链。本文聚焦Se

weixin_30905981的博客 490

RAG技术实战:从基础到进阶的全面解析

RAG(Retrieval-Augmented Generation)是一种结合检索与生成的技术,通过从外部知识库中检索相关信息来增强大语言模型的生成能力。其核心原理是将用户查询转化为向量表示,在向量数据库中进行相似性检索,再将检索结果作为上下文输入生成模型。这种技术能有效解决大模型的幻觉问题,提升回答的准确性和可信度。在工程实践中,RAG系统面临精准召回、上下文管理和幻觉控制三大挑战。典型应用场景包括智能客服、知识问答和文档摘要等。随着技术发展,混合检索(结合BM25和向量检索)以及GraphRAG(基于

weixin_30512043的博客 371

树莓派与OpenCV实现人脸识别(OpenCV安装篇)

主要看了以下两位博客的文章完成的,也遇到了不少的坑,在这里一一填补说明。 链接: https://blog.youkuaiyun.com/weixin_42163073/article/details/107308759. 链接: https://blog.youkuaiyun.com/weixin_42573595/article/details/108526850. 树莓派与OpenCV实现人脸识别(OpenCV安装篇)一、材料准备:二、系统烧录三、安装OpenCV依赖项四、下载OpenCV-4.3.0五、为OpenCV配置P

weixin_45880057的博客 1万+

SATA硬件电路设计实战:从接口规范到高速布线技巧

本文深入探讨了SATA硬件电路设计的核心要点与实战技巧。从接口物理电气规范、AC耦合电容与阻抗控制等基础,到FPGA/SoC高速收发器选型配置,再到应对6Gbps高速信号的PCB布局布线艺术,系统性地解析了SATA电路设计中的关键挑战与解决方案,助力工程师规避常见陷阱,实现稳定可靠的存储接口设计。

tech5的博客 531

基于Spring Boot与Milvus的RAG系统实战:从零构建企业级智能问答

在人工智能领域,大语言模型(LLM)凭借其强大的理解和生成能力,已成为构建智能应用的核心。然而,LLM存在知识更新滞后和易产生“幻觉”的固有局限。检索增强生成(RAG)技术通过引入外部知识库,有效解决了这一问题。其核心原理是将文档向量化后存入向量数据库,在用户提问时进行语义检索,并将检索到的上下文与问题一同提交给LLM,从而生成准确、可信的答案。这项技术对于提升企业知识库问答、智能客服等场景的专业性和时效性具有重要价值。本文以企业级应用为背景,详细阐述了如何利用Spring Boot、向量数据库Milvus

weixin_33806914的博客 386

Geoserver新手必看:5分钟搞定世界地图发布(附中国省市数据)

本文为Geoserver新手提供了快速发布世界地图的实战指南。从环境搭建、数据准备入手,详细讲解了如何创建工作区、添加数据存储、发布图层及配置关键参数,并最终通过创建图层组实现地图服务的整合与预览。文章旨在帮助用户快速掌握Geoserver发布地图服务的核心流程与实用技巧。

cola5的博客 223

AI项目问题总结大全

本文介绍了基于DeepSeek和LangChain构建知识库检索系统的两种方案。方案一使用LangChain框架,通过加载多种格式文档(txt/pdf/docx)、文本分块、向量化处理(采用HuggingFace嵌入模型)并存入Chroma向量数据库,最终搭建可查询的问答系统。方案二基于LlamaIndex实现,特点是以中文优化向量模型为核心,通过创建索引实现高效检索。两种方案均支持本地LLM(如Ollama/Qwen)或云端API,适用于企业文档管理、智能客服等场景,通过语义检索实现精准问答。系统还可输出

zouyang920的博客 289

【NVIDIA Jetson Orin系列 - 安装NVIDIA SDK Manager】

NVIDIA Jetson Orin - 安装NVIDIA SDK Manager

dally2的博客 2691

海康威视web控件开发+vue结合做网页开发

需求:vue的项目,需要在页面展示出海康的硬盘录像机连接的摄像头的实时监控画面以及回放功能. 准备:web开发包(包含插件以及demo,在海康官网即可下载32位64位的都有.那些需要积分下载的博主良心不疼么.) 点击这里下载:链接: https://pan.baidu.com/s/12FrbycWyWWyiRJH5Yd1tPA 提取码: gam5 开始开发: 1.安装demo目录下的WebComponentsKit.exe插件(根据自己的浏览器以及系统选择32位还是64位的插件) 2.打.

u013682258的博客 8484

Pi-Serini混合检索:用LLM调度词法与语义搜索,优化智能体信息获取

信息检索是AI智能体高效获取知识的基础。其核心原理在于将用户查询与海量文档进行匹配,传统词法检索(如BM25)依赖关键词匹配,速度快、可解释性强,但在处理模糊、多跳的语义查询时存在局限。现代语义检索(如向量搜索)通过嵌入模型理解深层语义,弥补了这一不足,但计算成本高昂。Pi-Serini框架的技术价值在于,创新性地引入大型语言模型(LLM)的规划与推理能力作为智能调度器(Pi),动态协调经典的词法检索工具Serini与语义检索。它根据查询的复杂性,自动选择或融合最优检索策略,例如对明确术语使用高效BM25,

weixin_30299709的博客 320

PyQtWebEngine安装避坑指南:快速解决ModuleNotFoundError

本文详细解析了PyQt5开发中常见的ModuleNotFoundError: No module named 'PyQt5.QtWebEngineWidgets'错误。核心原因是PyQt5 5.11版本后,网页引擎组件被独立为PyQtWebEngine包。文章对比了退回旧版本、独立安装及使用Conda等多种解决方案,并提供了针对Windows、macOS和Linux不同平台的实战安装指南与验证方法,帮助开发者快速解决依赖问题。

weixin_29056101的博客 427

.NET 8本地RAG实战:SQLite向量库+LM Studio离线部署

RAG(检索增强生成)是当前企业知识管理的核心技术路径,其本质是将非结构化文档转化为可检索、可推理的语义向量。实现RAG的关键在于向量存储的轻量化、嵌入计算的可控性,以及端到端数据不出域的安全闭环。相比依赖云服务的方案,本地RAG以嵌入模型+向量数据库为核心,兼顾低延迟、强合规与低成本。本文聚焦.NET生态下的工程落地,详解如何利用LM Studio提供稳定嵌入服务、SQLite结合FTS5构建混合检索向量库,并通过.NET 8的AOT编译与Span<T>优化保障资源受限环境下的高性能运行。适用于制造业文档

weixin_33767813的博客 599

基于VisionMaster实现数据实时存储至MySQL (二)

摘要:之前的分享主要聚焦于简单的一维数据实时存储。但在做缺陷检测项目时,情况往往更加复杂:一张检测图像中可能同时存在多个缺陷,每个缺陷都有一组独立的核心参数(如质心、长短轴、面积等)。如何在 MySQL 中记录这些成组出现的缺陷数据,而不只是简单的单条记录?

haier123888的博客 226

【Unity终极奥义】Unity打包去掉启动画面Logo,无需破解,一学就会

大家都知道Unity打包的应用在启动的时候都会有一个默认的UnityLogo。 而且这个Logo使用升级版和破解版都是可以随意清除和更换的。 但是Unity个人版是无法通过Unity的打包设置去进行更换的。 那今天就教大家一个使用个人普通版更换Unity启动画面Logo的方法!一起来看一下吧!

努力前行,总会成为自己心中的那道光 8万+

0、InfoHelper知识库问答智能体

InfoHelper是一个基于RAG架构的通用智能问答系统,采用Java 21 + Spring Boot 3.5开发,支持文档上传、智能切片、向量存储和智能问答全流程。系统架构包含前端层、Controller层、Service层和数据层,核心技术栈包括Elasticsearch向量存储、LangChain4j框架等。核心知识入库流程分为6个阶段:文件上传、格式转换、智能切片、向量化嵌入、ES索引存储和可检索状态,支持多种文件格式和智能切片策略。系统具备多数据源路由、本地重排序等能力,适用于企业知识库问答等

杨老师的博客 206

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

LightRAG多租户智能体系统优化实践与性能提升

在AI应用领域,检索增强生成(RAG)系统通过结合检索与生成技术显著提升回答质量,但面临多租户环境下的性能与隔离挑战。本文深入解析混合检索引擎优化、资源隔离方案及弹性扩展机制三大核心技术,其中内存级缓存与分布式缓存的协同设计实现78%的命中率提升,基于cgroup v2的硬隔离方案将VIP租户SLA从82%提升至99.5%。这些工程实践特别适用于金融、医疗等高并发场景,为构建高性能、可扩展的多租户AI系统提供可靠解决方案。

weixin_33727510的博客 366

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

DeepSeek V4百万上下文与动态知识库技术解析

大语言模型的上下文长度与知识管理能力,是决定企业级AI应用能否真正落地的核心基础。从传统RAG依赖向量检索、分块切片与外部数据库,到支持百万级token原生承载与事件驱动的知识实时更新,技术范式正经历从‘问答辅助’向‘持续记忆体’的关键跃迁。DeepSeek V4通过全局稀疏注意力、跨请求状态持久化、硬件感知调度等底层重构,使长文档理解、多源信息关联、会话连续性等长期痛点得以工程化收敛。该能力尤其适用于政务、金融、法律、医疗等强上下文依赖场景,为构建具备业务记忆与推理连贯性的智能助手提供全新技术路径。

weixin_34416754的博客 739

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

python-docx+ LangChain

先了解几个概念: 测试 用 Word 打开保存的 test.docx 就可以看到:ai啦啦啦 如果mode="elements"在word上是根据换行来切分 loader.load() 可以加载文档可视如果经过上面文档加载成Document这种,使用 或如果是单纯的字符串string,使用

qq_56352553的博客 1721
上一篇: 看完这张AI模型时间线,我悟出了一个道理,大模型入门到精通,收藏这篇就足够了!
下一篇: 别再花钱定制!零代码用 Dify 建企业智能知识库,万字实战手册直接领,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值