如何在window系统下部署Docker +RagFlow 本地AI知识库,大模型入门到精通,收藏这篇就足够了!

Windows 下本地 Docker RAGFlow 部署指南 阅读详情
AI摘要

本文详细介绍了如何在Windows系统中使用Docker和RagFlow搭建本地AI知识库。内容涵盖Docker安装、Ollama部署、向量嵌入模型下载及RagFlow服务启动等步骤。同时提供了大模型学习路线,从基础理论到实战开发,适合初学者到进阶者。

RAGFlow 是一个基于对文档深入理解的开源 RAG(检索增强生成)引擎。它的作用是可以让用户创建自有知识库,根据设定的参数对知识库中的文件进行切块处理,用户向大模型提问时,RAGFlow 先查找自有知识库中的切块内容,接着把查找到的知识库数据输入到对话大模型中再生成答案输出。它能凭借引用知识库中各种复杂格式的数据为后盾,为用户提供真实可信、少幻觉的答案。

RAGFlow 的技术原理涵盖了文档理解、检索增强、生成模型、注意力机制等,特别强调了深度文档理解技术,能够从复杂格式的非结构化数据中提取关键信息。下面我手把手教各位同学如何在 Linux 系统中搭建 RAGFlow。

Ollama 是一个开源项目,专注于帮助用户本地化运行大型语言模型(LLMs)。它提供了一个简单易用的框架,让开发者和个人用户能够在自己的设备上部署和运行 LLMs,而无需依赖云服务或外部 API。这对于需要数据隐私、离线使用或自定义模型调整的场景非常有用。

点击下方名片关注公众号**,第一时间获取AI案例分享!!!!!!**

一、安装 Docker Desktop(Windows 版)

  1. 下载安装包
  • 访问 Docker Desktop for Windows 官方下载页(https://www.docker.com/),下载并运行安装程序。

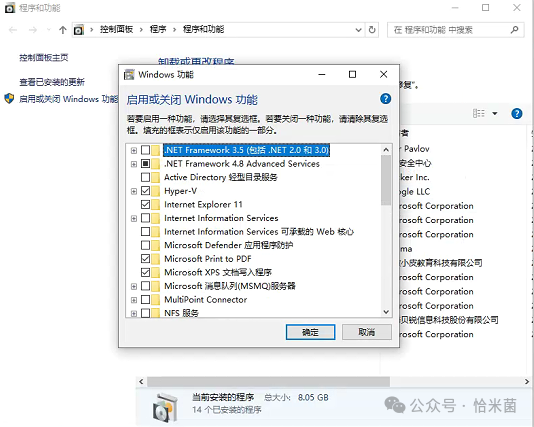
  • 安装时勾选 Use WSL 2 instead of Hyper-V(推荐,需提前启用 WSL 2)。
  1. 启用 WSL 2(若未启用)

打开 PowerShell(以管理员身份运行),执行:TypeScript

wsl --set-default-version 2

根据提示安装 Linux 内核更新包(下载地址)。

window选择开启Hyper-V
  1. 验证安装

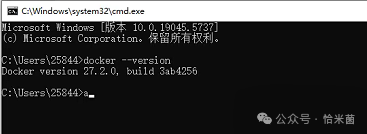
启动 Docker Desktop,确保任务栏图标显示运行状态。打开命令提示符,输入 docker --version,显示版本号(≥24.0.0)即成功。
二、安装 Ollama(本地大模型运行工具)

  1. 下载 Windows 安装包
  • 从 Ollama Releases 下载 ollama_windows_amd64.msi 安装包,双击安装。(https://ollama.com/)
  1. 部署 DeepSeek 模型(示例)
ollama run deepseek-r1

三、下载向量嵌入模型(用于文本向量化)

  • 下载中文优化模型 bge-m3:

    ollama pull bge-m3
    

四、用 Docker 部署 RagFlow

  1. 克隆 RagFlow 仓库
  • 打开 Git Bash for Windows(需提前安装 Git),执行:

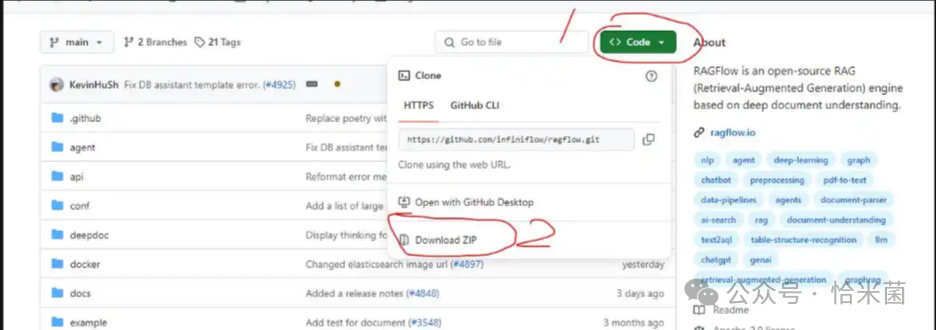
    git clone https://github.com/infiniflow/ragflow.git
    

    也可以选择直接下载

  1. 启动 RagFlow 服务
  • 编辑 .env 文件(用记事本打开),确保镜像版本正确(默认 ragflow_image=infiniflow/ragflow:v0.17.0-slim)。

  • 启动服务:

    docker compose -f docker-compose.yml up -d
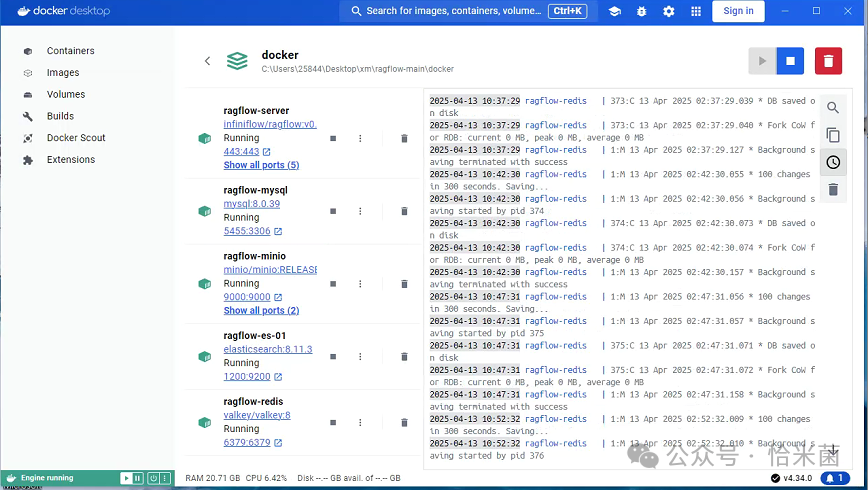
    

  1. 检查服务状态
  • 打开命令提示符,输入:

    docker logs -f ragflow-server
    

    出现 * running on all addresses (0.0.0.0) 表示启动成功。

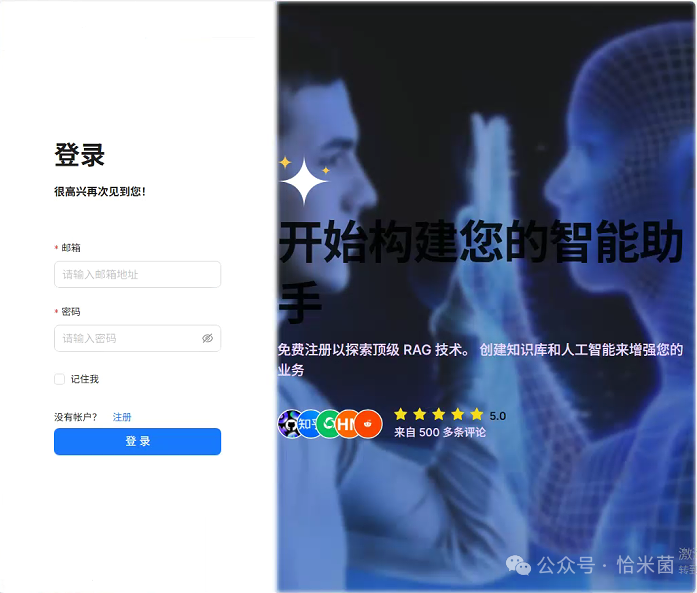
  • 访问 http://localhost(或 Docker 分配的 IP,端口可以选择默认的),进入 RagFlow 登录页。
五、配置 RagFlow 连接本地 Ollama

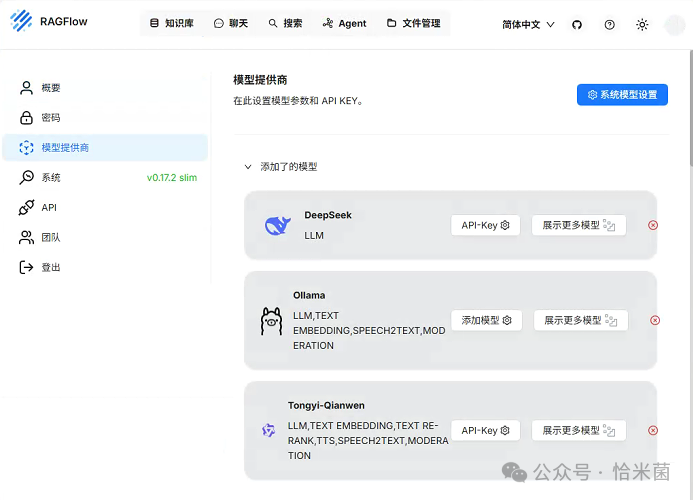
添加模型提供商

  • 登录后,进入 模型提供商 → 添加模型
  • 模型名称:填写 deepseek-r1(与 Ollama 部署的模型一致)

  • 端点:输入 http://localhost:11434(Ollama 默认端口)

  • 类型:选择 chat

六、创建知识库并导入文件

  1. 创建知识库
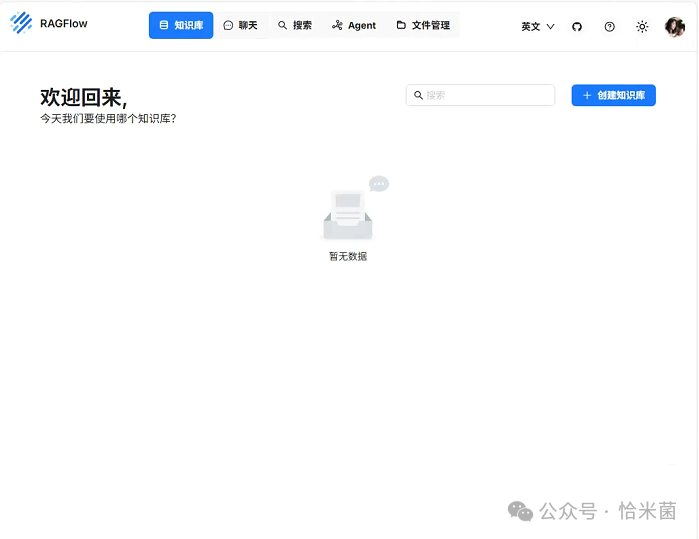
  • 点击 创建知识库,输入名称(如 my-knowledge)。

  1. 上传并解析文件
  • 支持格式:PDF、DOCX、TXT、CSV 等。

  • 操作步骤:

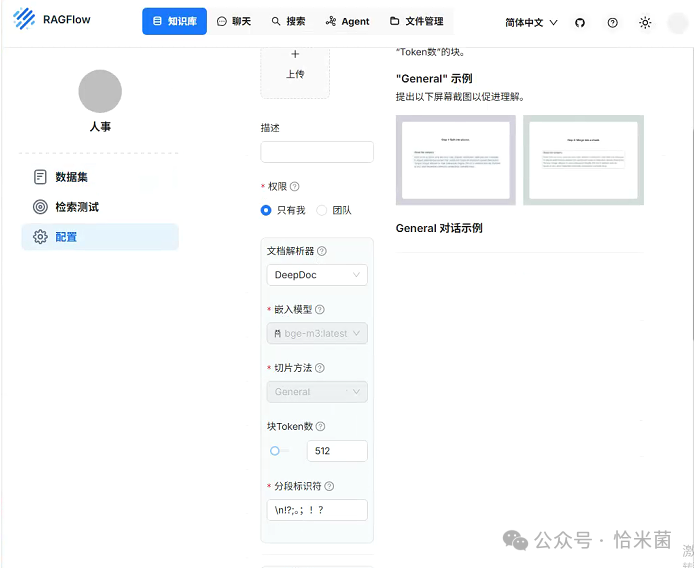
  • 上传文件 → 选择分块模板(如 PDF 分块)。

  • Embedding 模型:选择ollama下载的bge-m3(需指定模型路径)。

  • 点击 开始解析,等待进度条完成(大文件可能需要几分钟)。

七、开始 AI 聊天

  1. 创建聊天助手
  • 进入 Chat 页面 → Create an assistant:

  • 名称:自定义(如 My Assistant)

  • 知识库:选择已创建的知识库

  • 模型:选择已添加的 deepseek-r1

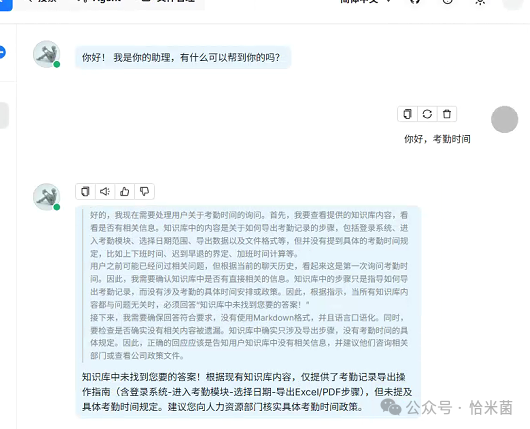
  1. 开始对话
  • 在输入框提问,例如:“知识库中的 PDF 文档提到了哪些技术要点?”

  • 结果会显示引用来源(Show Quote 默认开启),确保答案可追溯。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

【RAGFlow】全由国内镜像源搭建docker版 RAGFlow 可以为各种规模的企业及个人提供一套精简的 RAG 工作流程,结合大语言模型(LLM)针对用户各类不同的复杂格式数据提供可靠的问答以及有理有据的引用。:这里使用的是4核i5 6500的CPU,32G内存,500G硬盘,Docker version 26.1.3, build 26.1.3-0ubuntu1~24.04.1。平台搭建好之后,会默认提供Tongyi-Qianwen的模型,但此时的模型是不可用的,你需要输入可用的API-Key,才能正常使用。– ragflow:主服务,前后端; 阅读详情

相关推荐

RAGFlow在Windows中运行

ollama可以使我们本地部署大语言模型,无法加入自己的专有知识库,此时我们就需要借助RAGFlow,以实现构建自己的本地知识库大语言模型,还可以进一步打包制成API,构成具有行业专业知识的大语言模型。然而,在Ragflow的官方指导文档中,适用的为Lunix系统,笔者在数小时尝试后,详细总结了这样文档以告诉读者Ragflow如何在Windows系统上运行,注意:本电脑之前运行过虚拟机,因此可能缺少“虚拟机”的一些前置步骤,当安装过程出现问题可往这方面解决。

2301_77816793的博客 6380

搭建RAGFlow

是一款基于深度文档理解构建的开源 RAG(Retrieval-Augmented Generation)引擎。RAGFlow 可以为各种规模的企业及个人提供一套精简的 RAG 工作流程,结合大语言模型(LLM)针对用户各类不同的复杂格式数据提供可靠的问答以及有理有据的引用。

sqlora的专栏 1万+

windows上部署本地知识库(RAG)ollama + docker + ragflow方案

在.wslconfig文件配置如下,解决运行内存不够的场景,ragflow最低要求16G(如果没有.wslconfig文件,可以win+r,输入%UserProfile%之后新建)有gpu的可以执行此命令:docker compose -f docker-compose-gpu.yml up -d。没有gpu的可以执行此命令:docker compose -f docker-compose.yml up -d。进入ragflow的docker目录:D:\自己的位置\ragflow\docker。

weixin_43869605的博客 1638

【干货】带你一步步搭建RAGFlow

上星期给各位同学介绍了RAGFlow这个大模型RAG引擎,本篇给大家介绍一下RAGFlow的本地搭建,以下过程基于Ubuntu24,其它Linux系统的搭建方法也基本相同。先来温补一下,RAGFlow是一个基于对文档深入理解的开源 RAG(检索增强生成)引擎。它的作用是可以让用户创建自有知识库,根据设定的参数对知识库中的文件进行切块处理,用户向大模型提问时,RAGFlow先查找自有知识库中的切块内容,接着把查找到的知识库数据输入到对话大模型中再生成答案输出。

m0_59235245的博客 2万+

Windows 11 上 Docker + RAGFlow + Ollama 搭建个人知识库,我踩过的坑都帮你填平了

本文详细介绍了在Windows 11上使用Docker、RAGFlow和Ollama搭建个人知识库的完整流程,特别针对Windows平台特有的问题提供了解决方案。从环境准备、工具安装到系统集成与调试,涵盖了Docker Desktop安装避坑、Ollama配置、RAGFlow部署等关键步骤,帮助用户高效构建本地知识库系统。

weixin_42529366的博客 355

RAGFlow在windows环境下的部署,并配置​Deepseek模型​(亲测)

RAG(,检索增强生成)是一种结合了信息检索(Retrieval)和自然语言生成(Generation)的技术框架。它通过从外部知识库中检索相关信息,并将其作为上下文输入到(LLM)中,从而增强模型生成回答的准确性、相关性和可解释性。RAGFlow是一个基于深度文档理解的开源RAG(检索增强生成)引擎。当与LLM集成时,它能够提供真实的问答能力,并得到来自各种复杂格式数据的充分引用的支持。

ocean00008899的博客 1907

只看这篇就够了:0经验Windows上部署Ragflow+DeepSeek+Docker,实现个人/企业本地RAG知识库,保姆级安装和配置教程,踩坑实录

只看这篇就够了:0经验Windows上部署Ragflow+DeepSeek+Docker,实现个人/企业本地RAG知识库,保姆级安装和配置教程,踩坑实录

吴所畏惧 1816

RAGFlow入门实战:开箱即用的企业级知识库构建指南

RAG(检索增强生成)是当前企业知识管理与智能问答的核心技术范式,其本质在于将非结构化文档转化为可检索、可推理的语义知识。实现高质量RAG的关键不在大模型本身,而在于稳定可靠的文档解析、语义分块、混合检索与结果重排等工程环节。RAGFlow正是针对这一痛点设计的端到端知识处理平台,深度融合PDF解析、版面分析、表格重建、多模态Embedding与可视化配置能力,显著降低RAG落地门槛。它支持中文文档深度理解、结构化知识图谱构建及标准化API集成,广泛应用于智能客服、法律辅助、技术手册问答等场景。本文聚焦RA

weixin_33795093的博客 310

【记录一下】RagFlow 本地安装详细步骤(Windows + Linux)

RagFlow 本地安装详细步骤(Windows + Linux)

风信子的博客 6342

OpenClaw本地AI助理:PVE+Ubuntu+Docker生产级部署指南

OpenClaw是一种面向终端用户的本地化AI助理操作系统,其核心在于将大模型能力封装为可插拔、可编排的原子化技能(Skill),并默认以离线、可控、可审计为设计前提。它不依赖云端API,而是基于Linux系统生态(如systemd、dbus、glib)构建运行时,通过事件总线实现技能解耦。技术价值体现在部署轻量性(4核8G即可运行)、运维稳定性(支持PVE虚拟化、Docker容器化、Discord零门槛交互)与扩展灵活性(YAML配置驱动、技能独立升级)。典型应用场景包括家庭实验室中的NAS文档RAG检索

weixin_30527423的博客 449

四大开源AI知识库平台深度评测与选型指南

检索增强生成(RAG)技术通过结合传统检索与生成式AI的优势,正在重塑企业知识管理方式。其核心原理是先用语义检索获取相关文档片段,再交由大语言模型生成精准回答,显著提升问答系统的准确率。在工程实践中,开源AI知识库平台如WeKnora、RAGFlow等通过文档预处理流水线、混合索引策略等技术创新,已能支持从技术文档问答到智能客服等多种应用场景。本次横向评测特别关注了各平台在中文处理、增量更新等关键能力上的差异,其中RAGFlow的混合检索架构在测试中展现出37%的准确率提升,而FastGPT则以190ms的

weixin_34068198的博客 263

多图超详细:Docker安装知识库AI客服RAGFlow的详细步骤、使用教程及注意事项:

RAGFlow 是一款基于深度文档理解的开源检索增强生成(RAG)引擎,通过结合信息检索与生成式 AI 技术,解决复杂场景下的数据处理和可信问答问题。其核心设计目标是提供透明化、可控化的文档处理流程,并通过多维度优化降低生成结果的“幻觉”风险,适用于等对准确性要求极高的领域。

jijinduoduo的博客 2492

MYSQL、ORACLE、PostgreSQL数据库对象层次及权限管理对比

本文为出于自己扩展、比较、图形化的思维路径自行总结归纳,可能有些细节不太准确,欢迎指正。MySQL、Oracle、PostgreSQL关系型数据库都有管理员用户、用户、权限管理、表函数索引等数据库对象,schema。但在数据库对象隶属层次上有差异和相同的地方。

rachel_2016的博客 1490

Dify+RagFlow AI问数实战(Windows版)

DDL为数据库表的数据结构定义(如建表语句)文件,DB_DESC是数据库表的描述语言文件(即对每个表及字段的详细解释),原本还有一个Q->SQL文件(即数据库语句问答文件),不过为了节省时间省略掉了,不影响使用,只不过相关数据集越全,生成结果越精确。3. 然后创建工作流 Ai问数01-自然语言查询SQL,结构如下,也可直接导入我的DSL文件(原博主的dify版本过低,此处进行了更新,dify版本为v0.18.0 slim),第四个框SQL查询是另外安装的工具,可直接在Market市场里搜索安装。

m0_73719333的博客 2329

【任何电机可使用的七段式s曲线-----包括matlab代码和simulink仿真】

S形加加速(T1)→>匀加速(T2)→减加速(T3)→>匀速(T4 )>加减速(T5)>匀减速(T6)-→>减减速(T7)

weixin_44312889的博客 6309

Python爬虫实战:5分钟搞定政府网站公开数据抓取(附完整代码)

本文详细介绍了如何使用Python爬虫快速抓取政府网站公开数据,包括环境配置、网站结构分析、请求头构建、数据处理与存储等关键步骤。通过实战案例和完整代码,帮助开发者高效获取结构化数据,适用于数据分析、市场研究等场景。

weixin_29057065的博客 941

在Windows环境下,部署知识库RagFlow,并在Dify调用知识库

本文介绍了RagFlow知识库的安装部署及使用流程。首先通过GitHub获取源码,使用Docker命令进行安装(需添加-p ragflow参数),安装后需检查端口运行状态。接着配置模型提供商(如阿里千问需获取API Key),创建Dify的API KEY并建立知识库。最后演示了如何在Dify中连接RagFlow知识库进行对话应用。整个过程涵盖了从环境部署到实际调用的完整步骤,注意事项包括端口动态变化、本地与互联网模型配置差异等关键环节。

玩火的稻草人的博客 364

代码复现——SymAgent:一种用于知识图谱复杂推理的神经符号自学习Agent框架

根据《SymAgent: A Neural-Symbolic Self-Learning Agent Framework for Complex Reasoning over Knowledge Graphs》(《SymAgent:一种用于知识图谱复杂推理的神经符号自学习Agent框架》)论文思路,简单复现代码,以实现SymAgent中的Agent-Planner和Agent-Executor模块。Agent-Planner利用大语言模型的归纳推理能力从知识图谱中提取符号规则,指导高效的问题分解。

qq_60040306的博客 1605

如何在Windows 10上零基础搭建DeepSeek-R1+RAGFlow本地知识库(含Ollama避坑指南)

本文详细指导如何在Windows 10上零基础搭建DeepSeek-R1+RAGFlow本地知识库,涵盖Ollama安装、Docker配置、模型部署及常见问题解决方案。特别提供Ollama避坑指南,帮助用户高效完成本地部署,实现AI驱动的知识管理。

yolo5detector的博客 430

科研党福音:如何用Zotero+Paper Agent打造你的AI论文速递系统(附详细配置教程)

本文为科研工作者提供了一套利用Zotero和开源工具Paper Agent构建自动化AI论文速递系统的详细教程。该系统能基于用户在Zotero中的文献库智能学习研究兴趣,每日自动从arXiv等平台筛选、下载并深度解读最相关的前沿论文,生成个性化日报,实现从被动接收到主动精准获取的知识工作流重塑。

kite3的博客 515

Opencascade 保存点云为 .stp 和 .step 格式

总结一下,OpenCascade提供了强大的功能和工具,使我们能够方便地将点云数据保存为 .stp 和 .step 格式。通过使用类似于上述示例代码的方法,你可以使用OpenCascade库将点云数据保存为.STP和.STEP格式。总结一下,使用OpenCascade库,你可以方便地将点云数据保存为.STP和.STEP格式。通过使用类似于上述示例代码的方法,你可以将点云数据转换为OpenCascade的几何模型,并将其保存为所需的文件格式。请注意,上述代码仅涵盖了将点云数据保存为.STP格式的基本步骤。

CwzCode的博客 1157

Window11 非Docker RAGflow部署流程

本文详细记录了在Windows 11环境下部署Ragflow系统的完整过程。包括Python 3.12.10和PyTorch 2.9.0的环境配置,MySQL、MinIO、Elasticsearch和Redis等依赖服务的安装设置。重点解决了PYICU、onnxruntime GPU版本和detectron2等组件的安装问题,提供了.dll文件缺失的解决方案。最后完成了前后端的启动配置,并建议使用nssm将服务挂载为系统服务。整个过程涉及多个技术组件的协调配置,虽然复杂但最终实现了系统正常运行。

weixin_50200703的博客 837

EtherCAT主站SOEM -- 0 -- 该EtherCAT主站SOEM专栏后续安排

SOEM(Simple Open EtherCAT Master)是一个开源的EtherCAT主站库,允许开发者构建自定义的EtherCAT主站应用程序。EtherCAT是一种实时以太网通信协议,广泛应用于工业自动化和机器控制领域。开源性质:SOEM是一个开源项目,这意味着开发者可以自由地查看、修改和分发代码。这使其成为工业自动化领域的一个强大工具,可以根据具体需求进行定制。EtherCAT主站实现:SOEM库提供了一个完整的EtherCAT主站实现,允许主站与多个EtherCAT从站设备进行通信。

常驻客栈的博客--嵌入式EtherCAT 6666

【第 9 篇:本地化部署——从 0 到 1 的企业级系统部署全记录】

本文详细记录了企业级LLM应用系统的本地化部署全流程。系统采用多智能体架构,包含业务API、代码沙箱、监控平台和前端服务四大核心模块,支持知识库问答、数据分析和API对接功能,部署后所有数据留存本地。

realllccc的博客 395

手把手教你学Simulink——基于Simulink的滑模控制器车辆稳定性仿真建模示例

本文详细介绍了基于Simulink的滑模控制器在车辆稳定性控制中的应用。通过建立二自由度车辆动力学模型(含魔术公式轮胎),设计横摆角速度与质心侧偏角滑模控制器,在Simulink中实现直接横摆力矩控制。文章包含完整的建模流程:从参考模型设计、滑模控制器推导(含等效控制和边界层法),到MATLAB参数设定和Simulink模块搭建。通过双移线测试和路面突变场景验证,证明该控制器能在低附着路面(μ=0.3)将横摆角速度误差控制在±5%以内,显著提升车辆稳定性。同时提供了工程实践要点和扩展方向(如高阶滑模、自适应

MHD0815的博客 106

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【DeepSeek微调】Windows下_全链路部署-安装-并微调DeepSeek大模型:看这一篇就够了~

多数企业的大模型初步应用场景为:知识库、智能客服等。该部分场景主要使用和技术。两者在使用中,又经常。笔者现将学习相关技术过程遇到的信息整理成文。相应的使用流程如下:底模选择 => Lora微调 => Rag增加 => 业务使用接下来,将通过Windows环境,实验整个流程。说明:该文章依据上述两个github开源工程实践,有能力者可直接按照github的教程操作。

Liu_Arvin的芝士小栈 3989

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

上一篇: 2025 AI Agent开发架构师指南:技术栈全景与实战案例解析,大模型入门到精通,收藏这篇就足够了!
下一篇: Obsidian + RAGFlow,打造最强本地知识库,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值