基于llama.cpp在CPU环境部署Qwen3

llama.cpp部署Qwen2.5大模型(9分钟搞定) 本文介绍了在配备RTX4090显卡的Ubuntu22.04服务器上部署Qwen2.5-7B-Instruct大模型的过程。首先配置PyTorch2.1.0、Python3.10和CUDA12.1环境,通过镜像网站下载模型文件。接着安装并编译llama.cpp框架,解决依赖问题后启动模型服务。最后通过VSCode端口转发实现交互功能。整个过程涉及环境配置、模型下载、框架编译和端口转发等步骤,为本地部署大语言模型提供了完整指导方案。 阅读详情

最近两天在研究如何使用小规模参数的模型在CPU环境上进行落地应用,比如模型Qwen3-0.6B。开始使用Transformers库能够正常把模型服务进行部署起来,但是通过测试速度比较慢,用户的体验会比较差。

一、框架对比

因此就调研了能够在CPU环境支持对模型加速的算法框架。比如:onnxruntime、openvino、llama.cpp。

(1)onnxruntime:需要转换为onnx格式的模型, 但是对于Qwen3模型使用的SwiGLU、Rotary Embedding、动态 KV 缓存这些新技术onnx格式支持不是很好,会严重影响模型的推理效果;同时转换后会出现中间层冗余,推理速度很慢,对生成长文本的内容并不友好,同时需要把模型进行量化才可以。

(2)openvino:使用这个框架需要把模型转换成onnx格式,然后再转换为openvino IR格式的模型。转换比较复杂。目前官方未提供Qwen3转换的pipeline,需要多次进行测试验证。推理速度比不上llama.cpp + GGUF。

(3)llama.cpp:该框架原生支持CPU,技术文档相对成熟一些,推理和部署相对比较快些。因此最终选择这个技术方案进行了实验。

二、llama.cpp实验

1. 编译程序

# 克隆代码
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
# 编译
cmake -B build  # 检查本地环境并确定需要包含的推理后端与特性
cmake --build build --conig Release # 构建实际使用的程序文件
或者
cmake --build build --config Release -j 8 # 使用多个并行编译任务进行构建程序
# 程序目录
./build/bin

2. 获取GGUF

# 从huggingface下载对应的Qwen3 GGUF文件
huggingface-cli download Qwen/Qwen3-8B-GGUF qwen3-0.6b-q8_0.gguf --local-dir .
# 自己转换GGUF文件
在llama.cpp文件中有对应的进行格式转换的程序。
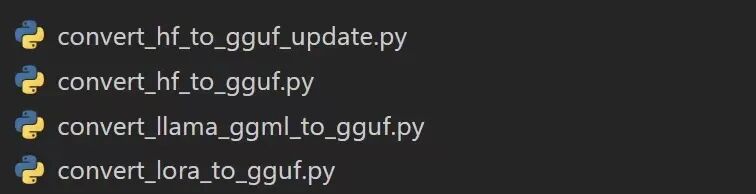
图1 hf2gguf

  1. 运行模型

3.1 llama-cli

# 查看支持的参数
llama-cli --help
# 运行程序
llama-cli -m Qwen3-0.6B-Q8_0.gguf

启动程序后就可以进行正常对话了,如下图所示:
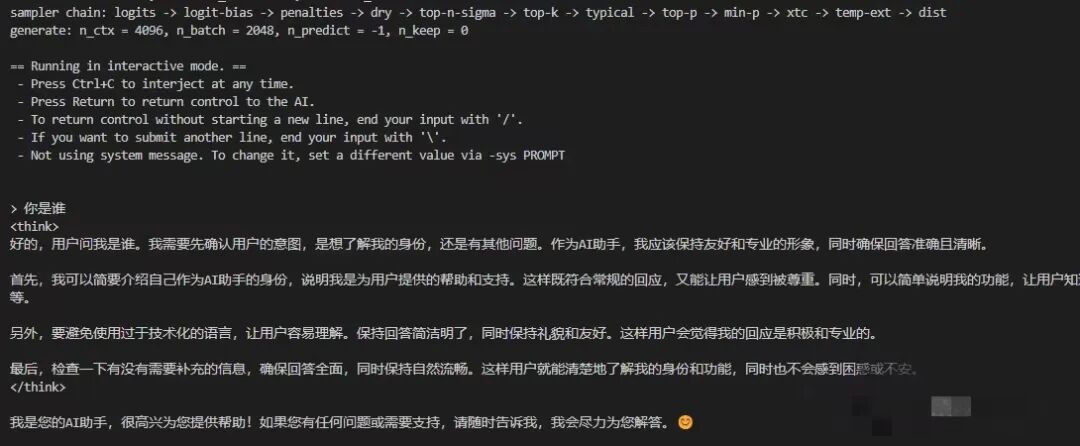
图2 模型推理

还可以配置线程数、模版、生成的最大长度、线程数等参数信息。

3.2 llama-server

如果想封装成http服务,以及openai接口的格式服务,就可以使用llama-server程序进行实现,比如:

llama-server-mmodel.gguf--port8080--hostxx.xx.xx.xx
# openai api
http://localhost:8080/v1/

三、推理速度

针对同样的prompt,让在不同框架下部署的模型进行推理,重复测试N次,计算其平均值。

使用llama.cpp + GGUF框架,模型Qwen3-0.6B(fp16),推理速度大约是20token/s。

使用llama.cpp + GGUF框架,模型Qwen3-0.6B(int8),推理速度大约是31token/s。

单从速度上来看,是能达到落地要求的,用户的体验相比使用tansformers库推理提高了很多。

以上就是在使用llama.cpp + GGUF策略在cpu环境上探索部署Qwen3-0.6B模型的分享,既然速度可以,接下来就可以使用Qwen3-0.6B模型处理具体的下游任务,最终进行落地到实际场景中。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

llama.cpp部署通义千问Qwen-14B llama.cpp部署通义千问 阅读详情

相关推荐

【Qwen2部署实战】llama.cpp:一键部署高效运行Qwen2-7B模型

在人工智能的快速发展中,大型语言模型(LLM)如Qwen2-7B正成为研究和应用的焦点。这些模型以其强大的理解和生成语言的能力,正在不断推动智能应用的边界。然而,高效的部署和运行这些模型往往需要专业的知识和配置。`llama.cpp`库的出现,为这一问题提供了解决方案,它允许用户一键部署并高效运行Qwen2-7B模型。

寻道AI,探索AI无限可能! 4106

在Qwen3项目中使用llama.cpp本地运行大语言模型

在Qwen3项目中使用llama.cpp本地运行大语言模型 【免费下载链接】Qwen3 通义千问 Qwen3,包含多个参数规模的密集模型(Dense)与混合专家模型(MoE),推理能力显著提升 项目地址: https://gitc...

gitblog_00223的博客 2092

【Ultrascale+ MPSOC学习记录】10、PS端以太网使用lwip

还是参考ALINX教程,学习PS端以太网如何使用,从教程中可以看到,开发板使用了一个xilinx默认不支持的phy JL2121,所以需要修改lwip的库源码。

ryo891012的博客 881

llama.cpp运行qwen0.5B

llama.cpp运行qwen0.5B大模型

qq_36437991的博客 2640

SC-FDMA

<br />SC-FDMA(Single-carrier Frequency-Division Multiple Access,單載波分頻多工),是LTE的上行鏈路的主流多址。<br />SC-FDMA是單波載(Single-carrier),與OFDMA相比之下具有的較低的PAPR(峰值/平均功率比,peak-to-average power ratio),比多載波的PAPR低1-3dB左右(PAPR是由于多載波在频域叠加引起)。更低的PAPR可以使行動終端(mobile terminal)在發送功效方面

jod的专栏 3299

告别wx.showActionSheet:微信小程序自定义底部弹框的5种实现方式对比

本文深入对比了微信小程序中替代原生wx.showActionSheet的五种自定义底部弹框实现方案。从基础视图层模拟到组件化封装,再到利用第三方UI库、CSS3动画及Page-Meta组件,详细分析了各方案的优缺点与适用场景,旨在帮助开发者根据项目需求,选择最合适的方案以实现高度定制化、交互丰富的弹框效果。

weixin_29005499的博客 191

「无需显卡」纯CPU环境也能流畅运行大模型!Llama.cpp本地部署Qwen3-0.6B攻略

还在为使用在线AI应用担心隐私问题?想在自己电脑上部署一个专属的AI助手?今天就教大家如何用Docker在Windows环境下快速部署Qwen3-0.6B大模型,完全免费、无需显卡!

python1234567_的博客 1425

在ubuntu20.04上配置VINS_Fusion(亲测有效,一应俱全)

最近在做科研训练的时候配置了HKUST-Aerial-Robotics实验室的VINS_Fusion代码项目,经历了一些编译报错的问题,在网上查找的时候博客内容良莠不齐,且实质针对性意见不多,于是在此记录下自己配置期间遇到的一些共性问题,留作自己日后参考和大家的交流学习。

wyr1849089774的博客 8269

LLM本地部署基础:轻量化模型选型、CPU推理加载、本地服务调度、资源管控实战(脱离外网依赖)

前面我们完成了:LLM推理原理、解码策略、Prompt工程、HTTP远程调用、上下文管理、幻觉规避、批量吞吐优化。但所有代码都依赖外部AI接口/外网服务网络依赖强:断网、内网环境、隔离服务器完全无法使用延迟不可控:公网抖动、接口排队、限流导致服务不稳定隐私不安全:业务数据、日志、指令外发,无法用于涉密/内网项目今天正式进入本地LLM部署时代。我们从工程角度讲解:为什么要本地部署、轻量化模型如何选型、CPU机器如何跑大模型、本地推理流程、资源调度策略,并给出。

2401_86195313的博客 645

【系统架构设计师】论文:论虚拟现实技术的应用与发展

虚拟现实技术是当前科学研究的热点,同时也是国家大力支持发展的核心技术之一。所谓虚拟现实,就是通过计算机等虚拟手段来构造一个非常接近真实世界的虚拟环境,它主要体现在视觉、触觉、嗅觉等方面的逼真模拟来达到高度的沉浸性,也就是如我们通常所说的“身临其境”。

数据知道的博客 1万+

SAP SD销售订单的ATP检查简介

如果可用性检查组设置为01(汇总需求),系统将更新销售订单需求到汇总表VBBS,该表中未记录销售订单号码,因此在MD04中不会显示销售订单号码,而是按天汇总显示销售需求。如果物料的可用性检查组设置为02(单个需求),系统将更新销售订单需求到表VBBE,该表中记录了销售订单号码,因此在MD04显示销售订单的号码以及需求,前面的文章中我们解释了PP模块中的ATP检查,也解释了MM模块中的ATP的检查,本文将说明一下SD模块中的ATP检查。可用性检查用的最多的就是02,有兴趣的同学可以测试一下可用性检查01。

我小时候很黑的博客 4295

Qwen3-VL-8B-Instruct-GGUF零基础上手:Windows WSL2环境下部署Qwen3-VL-8B-GGUF

本文介绍了如何在星图GPU平台上自动化部署Qwen3-VL-8B-Instruct-GGUF镜像,实现高效多模态理解。该模型支持图像与文本联合分析,典型应用场景包括电商商品图审核(如检测违禁词、Logo遮挡、背景合规性),显著降低本地部署门槛,适配中低显存设备。

weixin_42361478的博客 365

【YOLO】YOLOV5-Seg的Segment模块解析

Segment模块同时输出检测结果和分割掩模,通过轻量级分割头实现实时实例分割

浩瀚之水的专栏 599

Qwen1.5-4B 4GB低显存本地推理:量化原理与部署完整指南

本文围绕 Qwen1.5 开源项目,回答一个具体问题:显存只有 4GB 的消费级 GPU,能不能跑起 40 亿参数的 Qwen1.5-4B-Chat?答案是能,核心路径是 GGUF 权重量化加 CPU-GPU 混合卸载。下文先给结论和实测数据,再拆解背后的原理,最后按"准备→转换→量化→启动→调参"的完整链路逐步验证,并列出三个最容易踩的误区。 [![Qwen模型低显存本地推理的网页对话界面效果

gitblog_00801的博客 395

Python爬虫实战:深度解析B站弹幕异步采集技术与数据可视化

title=f"弹幕词云 Top 100 (BV: {bvid})", title_textstyle_opts=opts.TextStyleOpts(font_size=23).add(series_name="弹幕词云", data_pair=list(top_100_words.items()), word_size_range=[20, 100]).add_xaxis([f"{i}-{i+1}分" for i in range(len(time_distribution))])

2201_76125261的博客 640

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

CPU部署大模型实战:Qwen3.5与llama.cpp全栈优化指南

CPU推理并非GPU的低配替代,而是面向确定性、低干扰、高隔离场景的专用计算范式。其核心原理在于通过量化压缩(如Q4_K_M)、SIMD指令级优化(AVX-512/NEON)和内存访问重构(cache-line对齐、prefetch增强),将大模型从‘显存密集型’重定义为‘内存带宽敏感型’任务。技术价值体现在零显存依赖、服务稳定性强、资源隔离彻底,特别适用于微服务化部署、边缘轻量推理及预算受限的生产环境。本文聚焦Qwen3.5-9B在纯CPU服务器上的可复现落地,深度解析llama.cpp底层调度机制、12

clt3617的博客 430

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Linux下Llama.cpp部署Qwen3-30b

在上部署是一个。结合你的环境,这需要,且需要处理。

wangqiaowq的博客 196

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

从 0 到 1!Qwen3.5 系列开源大模型本地部署全流程(ModelScope)

摘要:本文介绍了四种开源大模型工具的部署方法:1)阿里云Qwen3.5系列,支持多模态理解和全球语言覆盖,提供不同量化版本的GGUF格式模型;2)Ollama简化本地模型运行,支持离线部署;3)LLaMA Factory支持WebUI微调;4)llama.cpp优化CPU运行,兼容GGUF格式。重点演示了如何在无GPU环境下通过GGUF格式部署0.8B参数的Qwen3.5模型,并对比了不同量化版本的性能差异,推荐Q4_K_M版本作为平衡选择。

m0_73982863的博客 2700

5分钟跑起来:Qwen3.6-14B-A3B-FableVibes-GGUF本地部署快速上手教程(llama.cpp一条命令版)

Qwen3.6-14B-A3B-FableVibes-GGUF 是一个基于 MoE 架构的 14B 本地大模型 GGUF 量化版,由 Claude Fable 5 推理轨迹蒸馏训练而来,擅长多步结构化推理,并支持视觉多模态。本文带你用最简单的 llama.cpp 一条命令,在消费级硬件上 5 分钟完成本地部署,无需任何复杂配置。 ## 这个模型有什么特别之处?🧠 和普通大模型不同,Qwen3

gitblog_01168的博客 15

如何在自己的电脑上跑起35B大模型:Qwen3.8-35B-A3B-Distill-GGUF llama.cpp快速上手教程

Qwen3.8-35B-A3B-Distill-GGUF 是一套 35B 参数 MoE 大模型的 GGUF 量化权重包,配合 llama.cpp 就能在自己的电脑上本地跑起旗舰级大模型,无需显卡顶配、无需联网 API。本文是一份面向新手的完整指南:从硬件需求评估、权重文件下载,到一条命令启动推理,外加多模态看图和常见问题解答,跟着做就能跑起来。 ## 35B大模型为什么能跑在你的电脑上? 先理

gitblog_00696的博客 102

纯CPU也能流畅推理?Qwen3.8-35B-A3B-Distill-GGUF CPU与GPU混合卸载实战(MoE稀疏架构的优势)

Qwen3.8-35B-A3B-Distill-GGUF 是一套面向 llama.cpp、Ollama、LM Studio 等本地运行时的 GGUF 量化模型文件,凭借 MoE 稀疏架构,它能在纯 CPU 环境下实现远快于同体积稠密模型的推理速度,也支持 CPU 与 GPU 混合卸载。本文带你搞懂它的架构优势、如何选量化文件,以及混合卸载的实战配置。 ## 1️⃣ 先认识一下 Qwen3.8-3

gitblog_01064的博客 531

关于windows下部署QWEN3.6本地版的一些实践体会

ai大模型本地部署碰到问题的解决办法。

qianqiuguoke的博客 254

3分钟跑起来!Qwen3.8-27B-GGUF llama.cpp一键部署新手教程(含视觉模型)

Qwen3.8-27B-GGUF 是 ByteShape 用 ShapeLearn 技术产出的 Qwen3.8-27B 的 GGUF 量化模型,一条 llama.cpp 命令即可让**支持视觉的** 27B 本地 AI 助手在 3 分钟内跑起来。本教程面向新手,从一键部署、量化版本选择到加速调优全流程,不需要写代码,复制命令就能用。 ## 🚀 一键部署:llama.cpp 快速上手三步走 *

gitblog_00321的博客 205

Qwen3 本地部署教程:Ollama 30 秒跑通,llama.cpp 深挖性能

公司内网的机器连不上外网,但你想在本地跑一个能读代码、能写注释的模型,数据又不能丢给云端 API。Qwen3 本地部署解决的就是这个问题:把模型拉到自己机器上,推理全程离线,几条命令就能看到第一条回复。 ## ⏱️ 先 30 秒跑通 下面两条命令:第一条装 Ollama(一个专门在本地跑大模型的工具),第二条拉取 Qwen3 并直接开聊。 ```bash curl -fsSL https:/

gitblog_01009的博客 500
上一篇: 如何训练微调本地模型(进阶)?从 Llama3 到 ChatGLM 的实战指南
下一篇: Dify 中 Function Calling 与 MCP使用不同使用场景对比解析
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
