如何训练微调本地模型(进阶)?从 Llama3 到 ChatGLM 的实战指南

【Ai教程】Ollma安装 | 0代码本地运行Qwen大模型,保姆级教程来了! 我们平时使用的ChatGPT、kimi、豆包等Ai对话工具,其服务器都是部署在各家公司的机房里,如果我们有一些隐私数据发到对话中,很难保证信息是否安全等问题,如何在保证数据安全的情况下,又可以使用大预言模型,Ollma(哦拉玛)可以告诉你答案! 阅读详情

随着开源大模型的普及,越来越多开发者和研究者希望不仅仅“使用”这些模型,而是能够 根据自己的需求对它们进行训练或微调 。本文将为你提供一份详尽的《本地大模型训练与微调指南》,涵盖主流模型如 Llama3、ChatGLM、Qwen 等,并结合 工具资源,助你实现个性化 AI 模型定制。

1

一、什么是模型训练与微调?

✅模型训练(Training)

指的是从头开始训练一个语言模型,通常需要大量数据和强大的算力资源(如多块 GPU),适合研究机构或大型团队。

✅ 模型微调(Fine-tuning)

是指在已有预训练模型的基础上,针对特定任务或领域进行进一步训练,例如:

让模型更懂中文提升代码生成能力构建企业知识问答系统微调门槛相对较低,普通开发者也能操作,是当前最实用的技术路径之一。

2

二、微调本地模型的核心流程

📌 步骤概览:

准备环境(Python + CUDA + 显卡)下载基础模型(Llama3、ChatGLM、Qwen 等)准备训练数据集(JSON/CSV 格式)使用 LoRA 或 QLoRA 进行高效微调导出模型并部署到本地推理环境(如 Ollama、vLLM)

3

三、推荐模型与工具清单
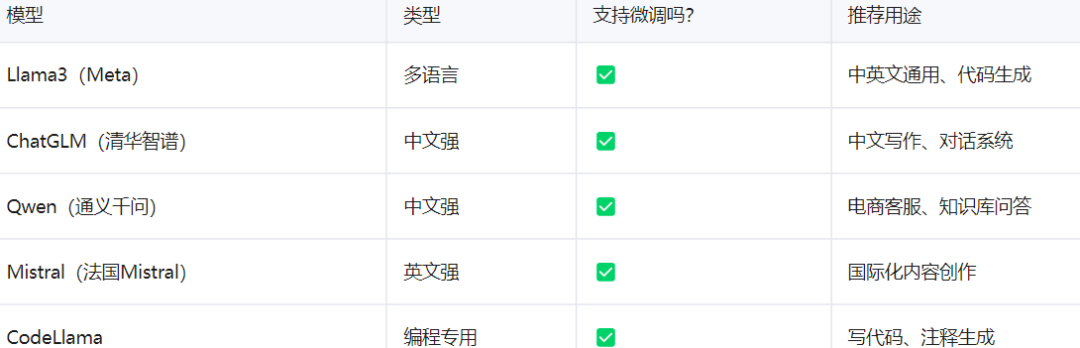
📌 微调工具推荐:

LLaMA-Factory (一站式训练框架)LoRA / QLoRA (低资源微调技术)Hugging Face TransformersPEFT (Parameter-Efficient Fine-Tuning 工具包)

4

四、实战教程:用 LLaMA-Factory 微调 Llama3 模型(中文字幕版)

✅ 步骤 1:安装 LLaMA-Factory(基于 HuggingFace)
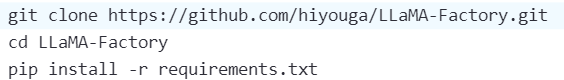
✅ 步骤 2:启动训练界面(支持 Web UI)
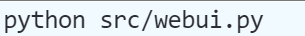
打开浏览器访问 ( http://localhost:7860 ) 即可进入图形化界面。

✅ 步骤 3:选择模型 & 加载数据集

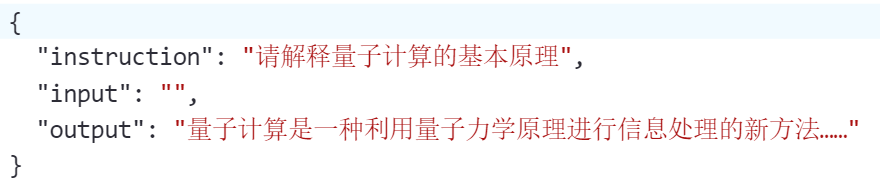
模型名称:meta-llama/Llama-3-8B 数据集格式:支持 JSON、TXT、CSV、Alpaca 格式

数据示例:
✅ 步骤 4:设置训练参数(建议初学者使用默认配置)

Training Type:SFT(监督式微调)Model Type:Llama3Output Dir:./saves/llama3-chinese

✅ 步骤 5:开始训练

点击“Start Training”,系统会自动下载模型并开始微调过程。

⚠️ 建议使用 NVIDIA RTX 3090 或更高显卡,内存至少 24GB。

5

五、进阶技巧:如何高效微调本地模型?

5.1

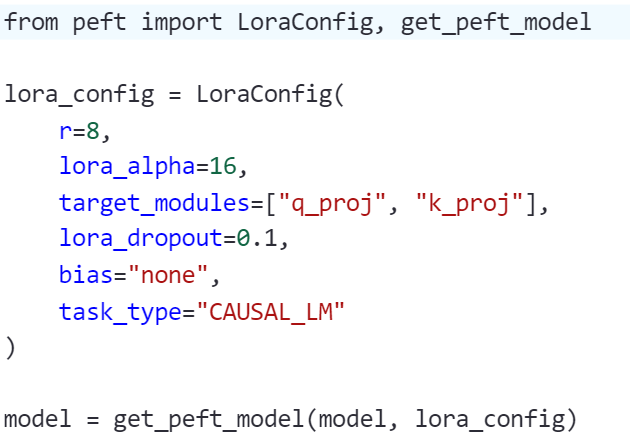
1. 使用 LoRA 技术(低秩适配)

LoRA 是一种轻量级微调技术,它不会修改原始模型权重,而是通过新增少量参数来调整输出行为,具有以下优势:

节省显存快速切换不同风格模型可叠加多个 LoRA 模型用于多场景切换

示例命令(使用 PEFT):
5.2

2. 使用 QLoRA(量化 + LoRA)

QLoRA 是一种结合了 模型量化 和 LoRA 微调 的高效训练方法,可以在 24G 显存下运行 Llama3-8B 的训练任务。

**实现步骤:**安装依赖:

加载量化模型:
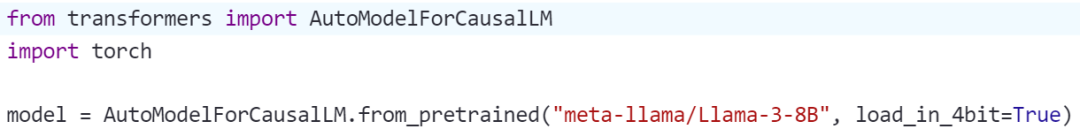
配置 LoRA 并训练即可。

5.3

3. 使用 Prompt Tuning(无需训练)

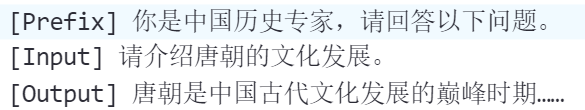
如果你不想训练整个模型,也可以使用 Prompt Tuning(前缀提示词学习)方式,让模型记住你设定的“前置指令”。

示例思路:
6

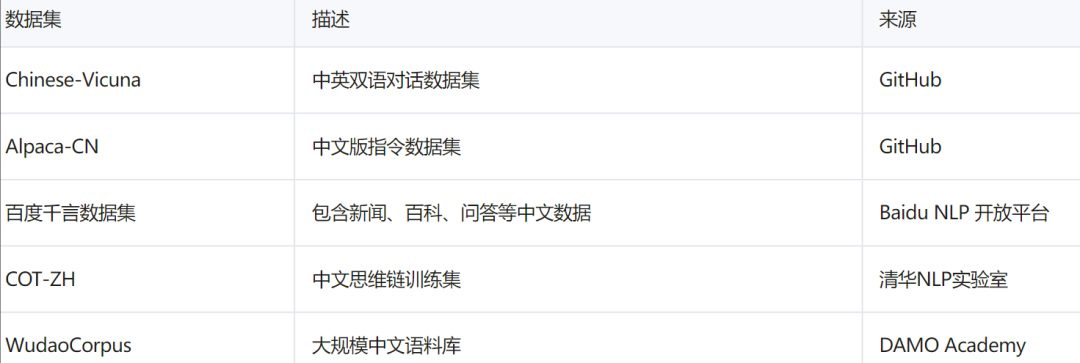
六、推荐中文训练数据集(适合中文模型)
7

七、模型训练后如何部署?

训练完成后,你可以将模型部署为以下形式:

7.1

✅ 方法 1:转换为 GGUF 格式供 llama.cpp 使用

然后使用 llama.cpp 启动:

7.2

✅ 方法 2:部署到 Ollama(需支持自定义模型)

目前 Ollama 不支持直接加载自定义模型,但你可以构建一个 Modelfile 来封装你的微调模型:
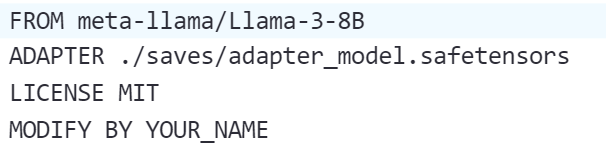
然后构建并运行:
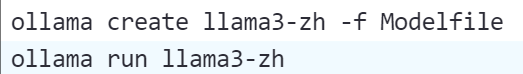
7.3

✅ 方法 3:部署为本地 API 服务(FastAPI + Transformers)
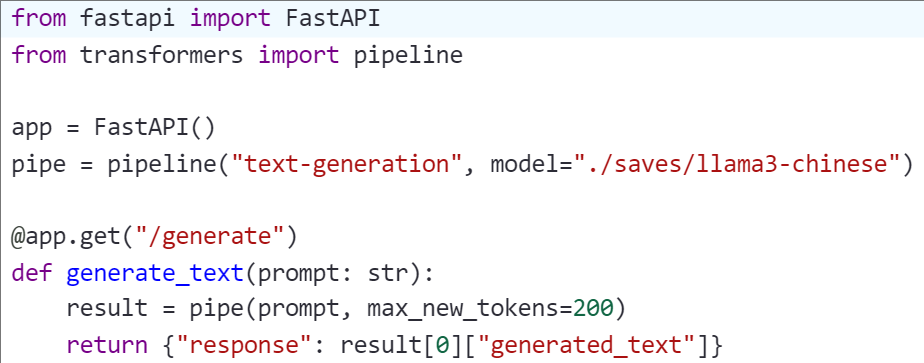
启动服务后,即可通过 /generate?q=xxx 发起请求。

8

八、常见问题解答(FAQ)

❓ Q1:没有高端显卡能微调吗?

✅ A1:可以使用 QLoRA 技术,在 24G 显存下训练 8B 模型;若无 GPU,也可使用云服务(如 Google Colab、阿里云 PAI、腾讯云 TI-ONE)

❓ Q2:微调后的模型还能用 Ollama 吗?

✅ A2:目前 Ollama 不支持直接加载微调模型,但可以通过 Modelfile 封装 LoRA 模型。

❓ Q3:微调后性能下降怎么办?

✅ A3:检查数据质量、学习率设置、是否过拟合。尝试使用早停(Early Stopping)、数据增强、正则化等方式优化。

❓ Q4:如何评估模型效果?

✅ A4:使用测试集、BLEU、ROUGE、METEOR 等指标进行评估,也可以人工打分对比输出质量。

9

九、结语:打造属于你的专属 AI 模型

微调本地大模型,不再是遥不可及的技术门槛。无论你是学生、AI 爱好者,还是企业用户,都可以通过本文介绍的方法,打造一个更懂你、更适合你业务场景的 AI 模型 。

从 Llama3 到 ChatGLM,从 LoRA 到 QLoRA,从训练到部署,我们已经进入了一个“人人可用、人人可改”的 AI 新时代。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

本地/服务器部署Dify傻瓜式教程 ​之前在AI大模型生态最态势及相关技术-25.5.27-优快云博客中提到了搭建AI Agent新贵平台 Dify,在从意识里懂一下Dify-优快云博客进一步对Dify进行了介绍。 今天以简单易懂的方式讲解一下怎么在本地/服务器上部署Dify(下二、3),添加不同模型供应商的大模型,以及实践过程中遇到的问题。 阅读详情

相关推荐

开源模型应用落地-工具使用篇-Ollama(六)

Ollama集成QWen1.5系列模型,全网唯一,绝非搬运。

以微薄之力,予他人些许温暖. 2万+

从零开始之Dify部署篇

Dify传送门。本系列文章从零开始探索Dify的功能及搭建过程。本文的搭建流程是基于Docker Compose进行部署。

u013563715的博客 7万+

ChatGLM3-6B使用lora微调实体抽取,工具LLaMA-Factory,医学数据集CMeEE

ChatGLM3-6B使用lora微调实体抽取,工具LLaMA-Factory,医学数据集CMeEE

weixin_62460336的博客 1847

一文带你入门 MCP(模型上下文协议)

Model Context Protocol (MCP) 是一个开放协议,它使 LLM 应用与外部数据源和工具之间的无缝集成成为可能。无论你是构建 AI 驱动的 IDE、改善 chat 交互,还是构建自定义的 AI 工作流,MCP 提供了一种标准化的方式,将 LLM 与它们所需的上下文连接起来。目前,MCP 已经积累了足够的临界规模和动能,因此它被视为 2023-2025 年“代理开放标准”之争的潜在赢家。

kuokay的博客 3万+

AI大模型探索之路-训练篇25:ChatGLM3微调实战-基于LLaMA-Factory微调改造企业级知识库

在当前信息技术迅猛发展的时代,知识库的构建与应用已成为企业竞争的关键。随着自然语言处理技术的不断进步,基于微调的企业级知识库改造落地方案受到越来越多的关注。在前面的系列篇章中我们分别实践了基于CVP架构-企业级知识库实战落地和基于基于私有模型GLM-企业级知识库开发实战;本文将深入探讨和实践一种基于微调技术的企业级知识库改造方法,以期为企业提供更加高效、安全和可靠的知识管理解决方案。

寻道AI,探索AI无限可能! 1万+

LLaMA-Factory可视化界面微调chatglm2;LoRA训练微调模型 简单案例

lore模型训练 参考:https://github.com/huggingface/peft。

weixin_42357472的博客 7797

chatGLM3微调

大模型摘要微调

huiguo_的博客 5913

【LLMs】ChatGLM & 小羊驼Vicuna & Baichuan-7B+量化微调

本文就介绍了ChatGLM、Vicuna部署以及测试使用相关内容。ChatGLM-6B 是一个开源的、支持中英双语的对话语言模型,基于 General Language Model (GLM) 架构,具有 62 亿参数。结合模型量化技术,用户可以在消费级的显卡上进行本地部署(INT4 量化级别下最低只需 6GB 显存)。

m0_37556124的博客 1086

ChatGLM3-6B大模型部署、微调【0到1小白教程】

小白教程,快速部署ChatGlm3大模型、快速使用loar微调大模型!

weixin_44480960的博客 2万+

LLMs之FineTuning:Alpaca格式/Vicuna的sharegpt 格式数据集简介、利用多种方式构造或转换指令微调格式数据集实战——利用LLaMA-Factory框架的dataset_i

​ LLMs之FineTuning:常用指令微调格式数据集的简介(Alpaca格式/Vicuna的sharegpt 格式)、利用多种方式构造或转换指令微调格式数据集实战——利用LLaMA-Factory框架的dataset_info.json 中通过指定--dataset dataset_name参数实现alpaca 格式/sharegpt 格式数据集及各部分字段的对应关系→以便正确读取和利用数据集内容训练模型 目录 常用指令微调格式数据集的简介 综合实战 常用指令微调格式数据集

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 4871

LLM、AGI、多模态AI 篇五:基于LoRA微调ChatGLM3

hiyouga/LLaMA-Factory 是一个开源的 GitHub 仓库项目,它提供了一个易于使用的框架,主要用于大型语言模型(LLM)的微调和训练。这个项目旨在简化用户对多个著名开源大模型进行定制化训练的过程,包括但不限于 Baichuan、Baichuan2、BLOOM、BLOOMZ、ChatGLM3、Falcon、InternLM、以及 LLaMA 等模型。

生活在别处 2101

LLaMA, ChatGLM, BLOOM的参数高效微调实践

大语言模型的训练分为两个阶段:(1)在海量文本语料上的无监督预训练,学习通用的语义表示和世界知识。(2)在小规模数据上,进行指令微调和基于人类反馈的强化学习,更好地对齐最终任务和人类偏好。LIMA[1] 证明了,只需要有限的指令微调数据就可以生成高质量的回复。因此,基座模型的性能是至关重要的,如果基座模型的性能不够好,指令微调和强化学习也难以取得很好的效果。目前,主流的开源大语言模型主要有三个:LLaMA、ChatGLM 和 BLOOM。

丨汀、的博客 5044

十三、FLUENT蒸发/冷凝模型实战:从沸腾模拟到常温蒸发的UDF进阶

本文深入探讨FLUENT蒸发/冷凝模型的应用实践,从沸腾模拟到常温蒸发的UDF进阶。通过分析相变模型的核心逻辑、关键陷阱及UDF动态饱和温度场的实现,帮助工程师准确模拟不同场景下的蒸发/冷凝过程。结合太阳能蒸馏器等工程案例,提供优化方案和常见问题解决方案,显著提升模拟精度与效率。

weixin_42548893的博客 571

LLaMA-Factory微调(sft)ChatGLM3-6B保姆教程

LLaMA-Factory训练ChatGLM3-6B全流程步骤

alterhz的博客 2万+

Fast-LIO2代码解析 古月居

FAST-LIO,FAST-LIO2与FASTER-LIO - 古月居FAST-LIO2代码解析(一) - 古月居FAST-LIO2代码解析(二) - 古月居FAST-LIO2代码解析(三) - 古月居FAST-LIO2代码解析(四) - 古月居FAST-LIO2代码解析(五) - 古月居FAST-LIO2代码解析(六) - 古月居

li4692625的博客 2785

【RTOS】 Vxworks 653 第一章 —— 初识 vx653 3.x

。。不是很重要,自己搜吧鲁棒分区是一种确保共享计算资源中独立运行功能实现​​时空隔离​​的机制,其目标是为集成模块中的混合临界性应用提供与联邦式部署(federated implementation)同等级别的功能隔离保障。具体表现为:​​多关键性共存​​:支持不同安全等级应用(如飞控系统A级与娱乐系统D级)在同一模块中协同运行。​​抗干扰能力​​:防止未授权或意外的时空干扰(如内存越界、时间窗口冲突),确保应用间互不影响。​​。

qq_38183694的博客 1280

【大模型】开源大模型汇总以及微调策略

自从ChatGPT出世以来,各个大厂/研究院都纷纷推出自己的大模型,大模型领域发展一日千里。随着“百模大战”热度的降低,有必要梳理一下目前主流的大模型以及其变种模型,回顾一下。注:汇总开源模型。

桐原因的博客 8819

VoLTE吞字断续优化方案

网络侧通过各节点探针的数据采集,能够进行RTP和RTCP包的分析,确定各节点的上行或下行丢包情况。1.基于测试语音分析,每2秒中大约8个字,每个字约10个RTP语音包。通话过程中,语音有短暂停顿,收音段听语音中会出现“吞字/断续现象”2.连续丢3~5个RTP以上就可能会出现吞字断续的感觉。下行评价的丢包问题,很难有效指导定界定位分析,无从下手。2.部分终端可能存在RTCP不反馈,导致无法获取丢包。1.语音包为UDP包,无反馈,终端无法判定是否丢包。终端可依据自身的调度反馈或弃包进行上行丢包判决。

m0_73503557的博客 1512

使用LLaMA Factory来训练智谱ChatGLM3-6B模型

1. 项目背景开源大模型如LLaMA,Qwen,Baichuan等主要都是使用通用数据进行训练而来,其对于不同下游的使用场景和垂直领域的效果有待进一步提升,衍生出了微调训练相关的需求,包含预训练(pt),指令微调(sft)…请注意,由于LLaMA Factory和ChatGLM3-6B模型的细节可能会随着时间的推移而更新或变化,因此建议参考最新的官方文档。LLaMA-Factory QuickStart - 知乎。新建一个json文件,放到data目录下面。

小相探索IT世界 2301

IEEE Transactions模板中参考文献作者缩写、期刊名缩写

本文章记录如何在IEEE Transactions的模板中,解决参考文献的作者缩写、期刊名字缩写的问题。

weixin_43981621的博客 1万+

多agv系统调度的MATLAB仿真

从起点出发,到货物点领取货物最后到卸货点,以完成任务总时间最短为目标进行单目标优化,约束条件为,任务不冲突,路径不冲突,要能实现路径规避 ,4-6台agv一起工作。左右货架间隔可通过1个agv,上下货架间隔可通过两个agv,通道为双向行驶通道。一台agv只能带一个货物,优化目标为完成任务总的时间最短,agv的速度是匀速,转弯也不会减速,取货物时间为固定值。上面的图里面货物看为正方形跟agv一样的长度大小,agv试做是跟货物一样大小的正方形agv的速度是每秒1个车身。多台agv一起完成...

FPGA/MATLAB学习教程/源码/项目合作开发 7564

【大模型实战篇】LLaMA Factory微调ChatGLM-4-9B模型

大模型微调、全参微调、llama factory、glm4、chatglm-4-9b、a800、lora微调、大模型

源泉的小广场 4387

57. SAP UI5 应用基于 OData 注解的 Smart Field 使用方法学习

所谓 SAP UI5 Smart Field,顾名思义,是一类比较`智能`的控件,这类控件同 SAP UI5 传统的控件不同,会根据 SAP UI5 应用程序连接的 OData 服务中元数据里提供的注解(`annotations`),在运行时动态生成底层的 SAP UI5 控件。...

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 2771

【ChatGLM3】(7):在autodl上,使用A50显卡,使用LLaMa-Factory开源项目对ChatGLM3进行训练,非常方便的,也方便可以使用多个数据集

工具还是非常的简单,可以把机构参数进行设置下。主要就是把参数可视化,同时把结果也可视化。非常的方便。进度也可以看到。

freewebsys的专栏 5216

加权均值向量算法(INFO)详解:从数学原理到智能算法

本文系统介绍了加权均值向量算法(INFO)的理论基础、数学模型与实现应用。该算法基于加权均值数学概念,通过MeanRule规则平衡探索与开发能力,具有结构新颖、参数合理的特点。核心内容包括:1) 算法理论基础,阐述加权均值数学定义与小波函数权重计算;2) 算法原理,详细解析更新规则、向量组合和局部搜索三阶段数学模型;3) 实现方法,提供MATLAB代码关键参数解析;4) 改进方向,介绍INFO-KELM混合模型等变体;5) 应用案例,涵盖函数优化、工程设计与机器学习领域。

qq_42212808的博客 234

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

上一篇: 0 基础转行做生成式人工智能系统测试员,学习资源与路径全公开
下一篇: 基于llama.cpp在CPU环境部署Qwen3
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
