Mutil-Agent的终极秘密武器:上下文工程(Context Engineering),大模型入门到精通,收藏这篇就足够了!

Learning Transferable Cooperative Behavior in Multi-Agent Teams 笔记 文章目录前言背景 前言 最近实在是没怎么看论文,这篇论文的方法也算是比较新,方向我觉得是未来比较火的一个,趁现在看看能不能做点工作。毕竟图网络比较火,跟它结合也能做点东西。 尽管mutil-agent interactions可以被很自然的建模为一个图,但环境通常都被当做一个黑盒。本文创建一个共享的agent-entity图,agent和环境实体构成顶点,边存在于互相通信的顶点之间。这个框架与系统... 阅读详情

导语: 随着大语言模型(LLM)和代理框架的发展,人们越来越意识到「上下文」对代理行为的重要性。代理不仅需要用户的指令,还需要外部知识、工具反馈等信息才能完成复杂任务。所谓“上下文工程”就是在有限的上下文窗口内,为代理按步骤提供恰当的信息和工具,使其能够有效地完成任务。

本文将结合 LangChain、Anthropic 和 Cognition 等团队的经验,解释上下文工程的概念、常见策略以及多代理/单代理架构的权衡,并对相关链接进行梳理,为中文读者呈现一篇关于上下文工程的完整介绍。

LangChain 在博客中将 上下文工程(context engineering) 定义为构建动态系统,为大语言模型提供恰当的信息和工具,使其“有可能完成任务”。与早期只靠提示词的“prompt engineering”不同,上下文工程强调的是:

  • 系统性: 代理的上下文来自开发者、用户、历史交互、工具调用或其他外部数据,必须通过系统化的逻辑组合在一起
  • 动态性: 这些上下文通常是实时生成的,因此构建最终提示必须具有动态拼接能力
  • 正确的信息与工具: 代理出错往往不是模型能力不足,而是缺乏恰当的信息或工具
    。因此必须保证提供的信息充分且格式合适

安德烈·卡帕西(Andrej Karpathy)用操作系统做了一个类比:LLM 就像 CPU,上下文窗口是 RAM(工作内存),而上下文工程就是决定哪些信息可以放入 RAM 的“调度器”。由于 RAM 容量有限,上下文工程需要精心挑选和组织信息以避免溢出。
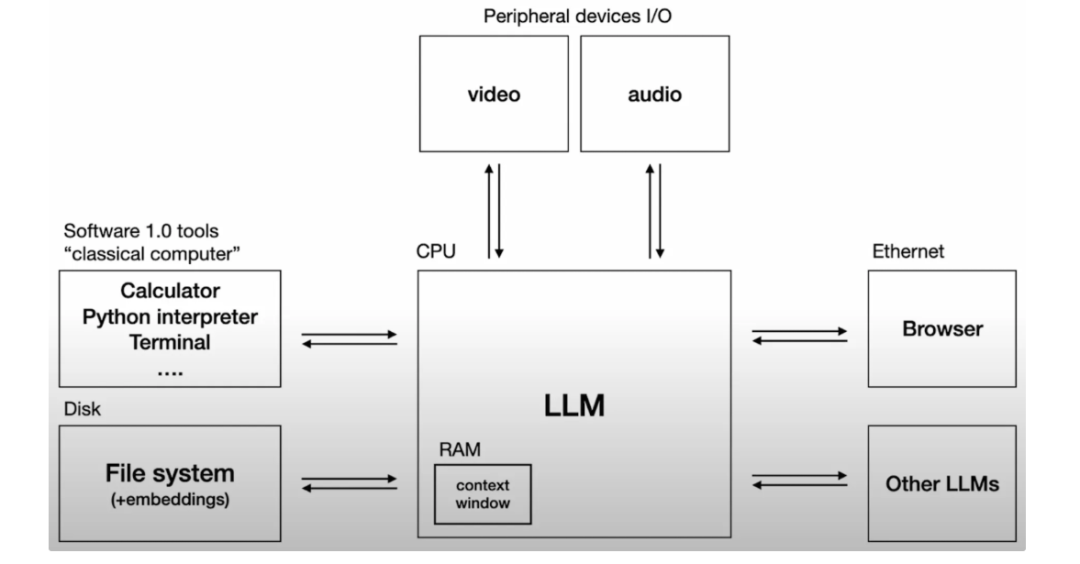
为什么代理需要上下文工程?

在代理系统中,任务往往是 多轮对话 和 工具调用 的组合,导致上下文越来越长。这会带来两个问题:

  1. 成本与效率: 长上下文会增加模型的计算成本和延迟,并可能导致模型性能下降
  2. 新的失败模式: Drew Breunig 总结了长上下文的四大失败模式:
  • 上下文污染(Context Poisoning): 幻觉或错误信息进入上下文后被反复引用,代理会围绕错误目标做出决策
  • 上下文干扰(Context Distraction): 上下文过长导致模型过度关注历史而忽略训练知识,反复重复已有行为
  • 上下文混乱(Context Confusion): 上下文中无关的内容(如过多的工具说明)干扰模型,使其调用不必要的工具
  • 上下文冲突(Context Clash): 上下文中出现相互矛盾的信息时,模型难以判断取舍

因此,仅依靠扩大上下文窗口并不能解决问题,反而会引入新的风险。上下文工程旨在通过合理整理、压缩和隔离信息,避免上述失败模式。
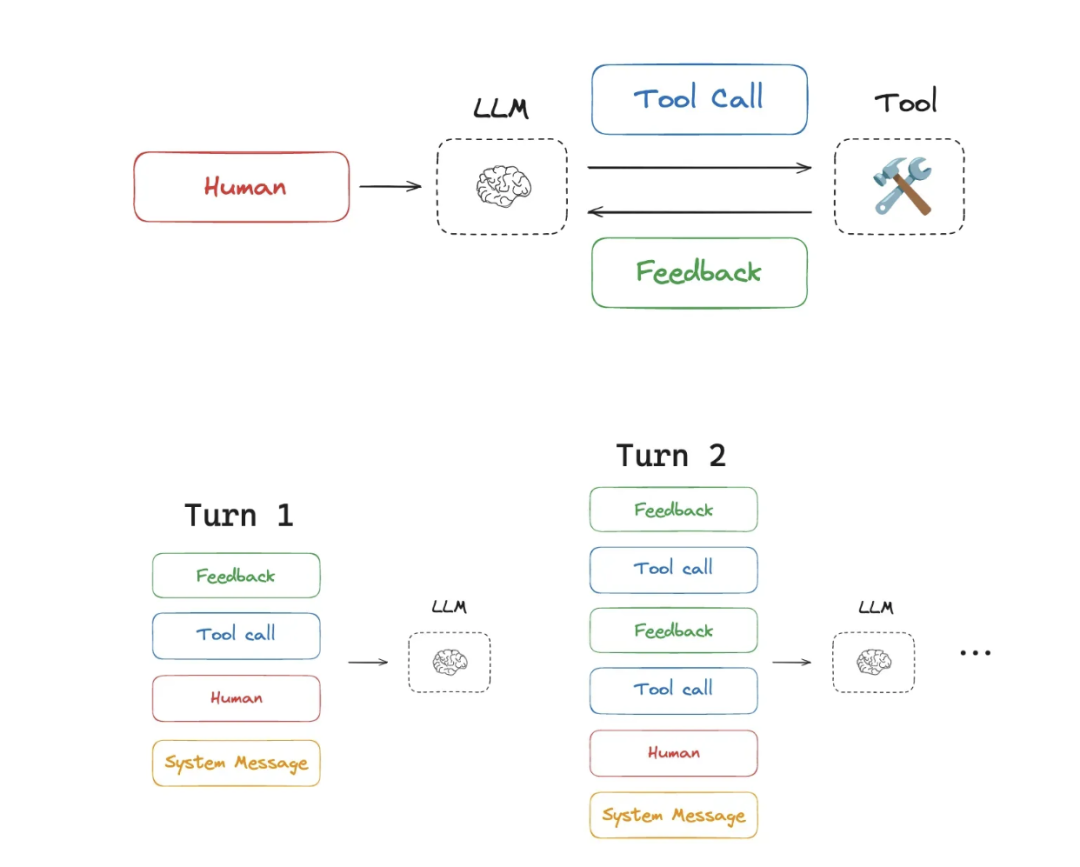
上下文工程的四种策略

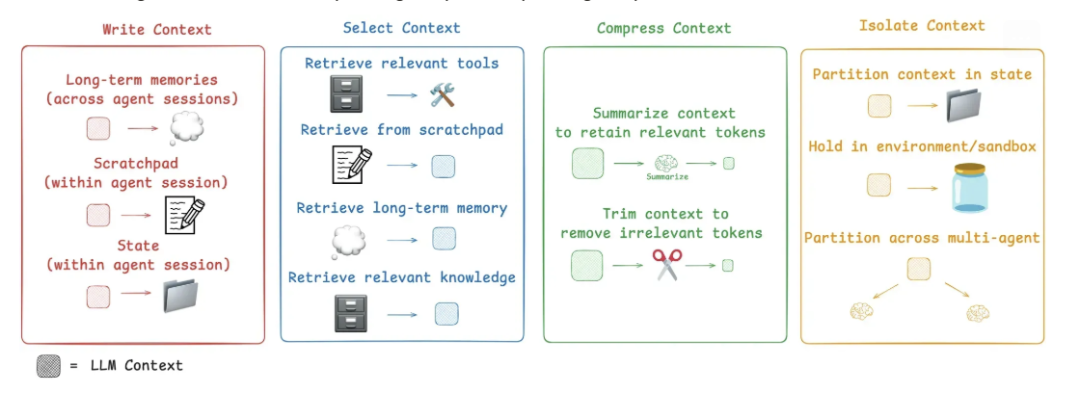
LangChain 将常见的上下文工程策略分为 写入(Write)、选择(Select)、压缩(Compress)和隔离(Isolate)
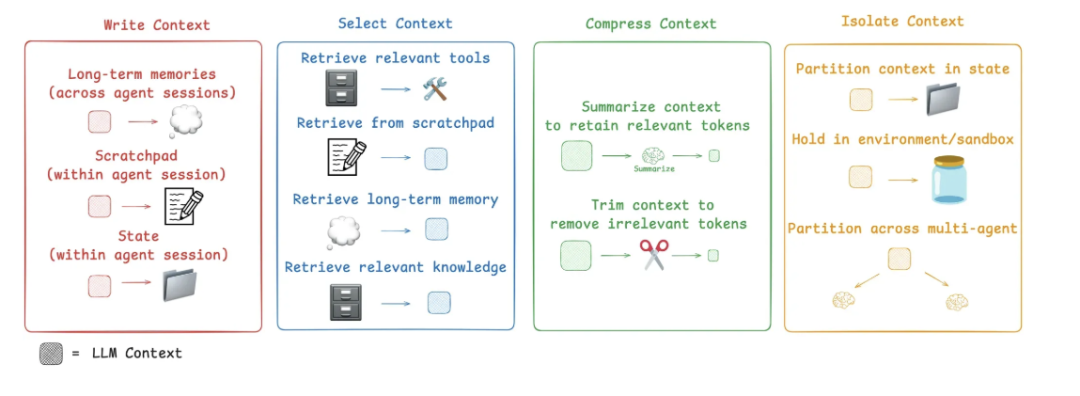
。这些策略并不是孤立的,而是在复杂代理中相互配合使用。

1. 写入(Write)——在上下文之外持久化信息

写入策略指将信息存储在上下文窗口之外,供未来检索。例如:

  • Scratchpad(草稿本): 类似人类做笔记,代理通过工具调用将临时信息写入文件或状态对象,在任务过程中随时访问。Anthropic 的多代理研究系统会在计划开始前将研究计划写入记忆,以防上下文超过 20 万个 token 时被截断anthropic.com。LangGraph 为代理提供了 short‑term memory(检查点)来在会话内保存状态blog.langchain.com。

  • 长期记忆(Memory): 有些信息需要跨会话保存,例如用户偏好或历史反馈。生成式代理(Generative Agents)通过定期汇总过去的反馈构建长期记忆
    。现在的一些产品如 ChatGPT、Cursor 和 Windsurf 也自动生成长期记忆
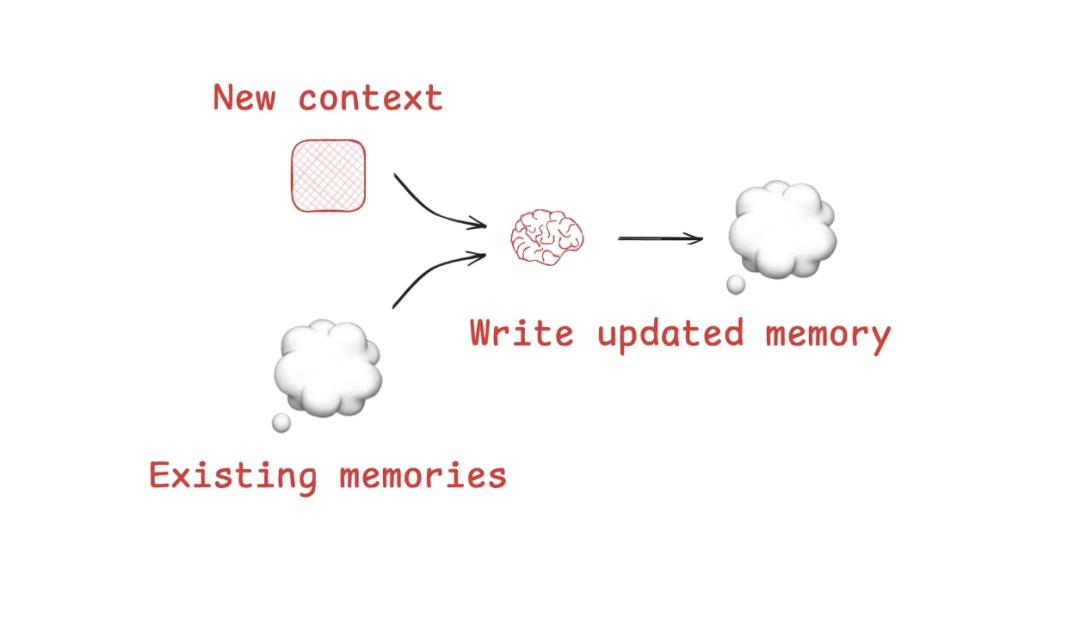
2. 选择(Select)——从记忆中提取相关信息

选择策略是将外部记忆、文件或工具调用结果拉入当前上下文。常见做法包括:

  • 小样本示例(Few‑shot examples): 作为 情景记忆(episodic memory) 帮助代理模仿预期行为
  • 指令/规则(Procedural memory): 用于指导代理行为,如 Claude Code 中的 CLAUDE.md 规则文件
  • 事实(Semantic memory): 存储知识、实体信息,供检索调用

在 LangGraph 中,开发者可以在每个节点按需检索状态或长期记忆,并通过嵌入检索等方式选取最相关的记忆。对于工具选择,一些研究表明,使用 RAG 技术对工具说明进行检索可以使选择准确率提高 3 倍

不同记忆类型一览(重点词条,避免冗长描述):

记忆类型存储内容代理示例
语义记忆Facts(事实)关于用户的事实
情景记忆Experiences(经历)过去的代理动作
程序记忆Instructions(指令)系统提示或规则

3. 压缩(Compress)——保留必要的信息

压缩策略通过 摘要(summarization) 或 修剪(trimming) 减少上下文长度:

摘要: 通过 LLM 压缩对话历史,只保留关键决策。Claude Code 会在上下文超过 95% 时运行 “auto‑compact” 自动摘要。在 Cognition 的代理中,还使用专门微调的小模型来压缩代理间的交互,以减少知识传递时的 token 数
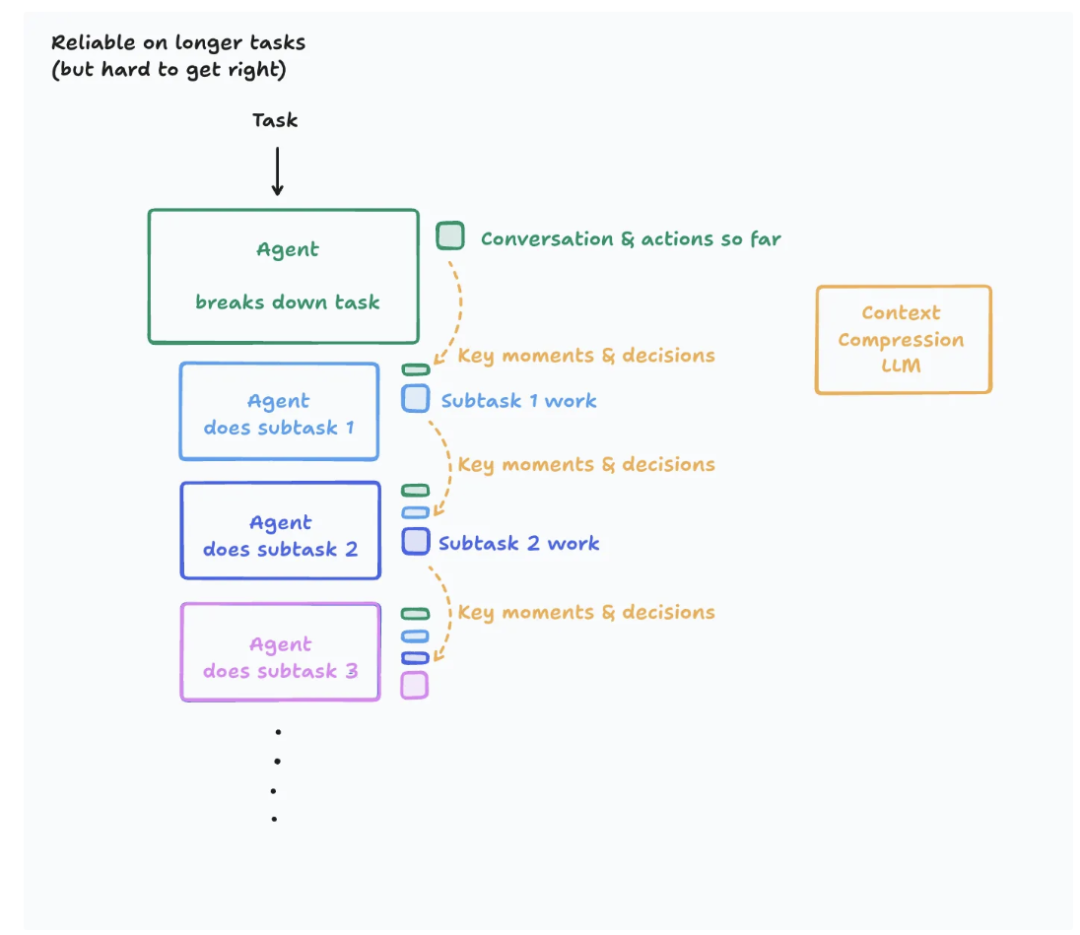
  • 修剪: 通过启发式方法删掉旧消息,例如只保留最近的几轮对话;也可以用训练出的 Provence 模型对检索内容进行句子级别的剪枝,它将上下文剪枝任务视为序列标注问题,在多领域问答中几乎不损失性能

压缩并不是万能的:过度摘要可能遗漏关键细节,修剪也有风险,因此需要结合任务特点谨慎使用。

4. 隔离(Isolate)——拆分上下文以并行处理

隔离策略通过 分工合作 减少单个上下文窗口的压力。例如:

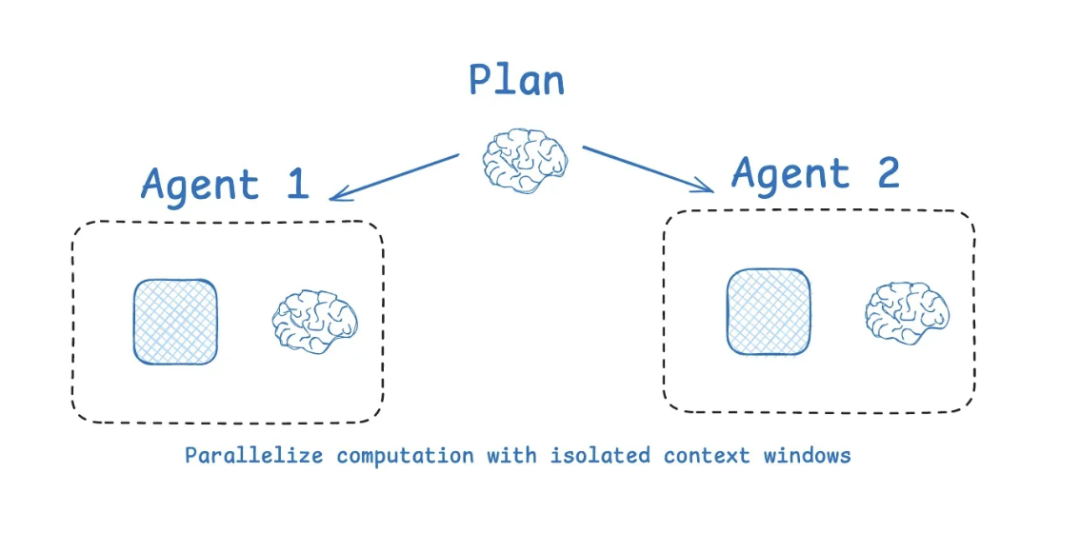
多代理架构: Anthropic 的 Research 系统采用 主代理 + 子代理 模式,主代理制定研究计划并将任务分配给多个子代理并行搜索,子代理拥有自己的上下文窗口,并在完成后将结果返回,由主代理汇总。该系统在广度优先查询中比单代理效果提升 90% 以上,但使用的 token 约是对话模式的 15 倍,因此只适用于价值高且可并行的任务
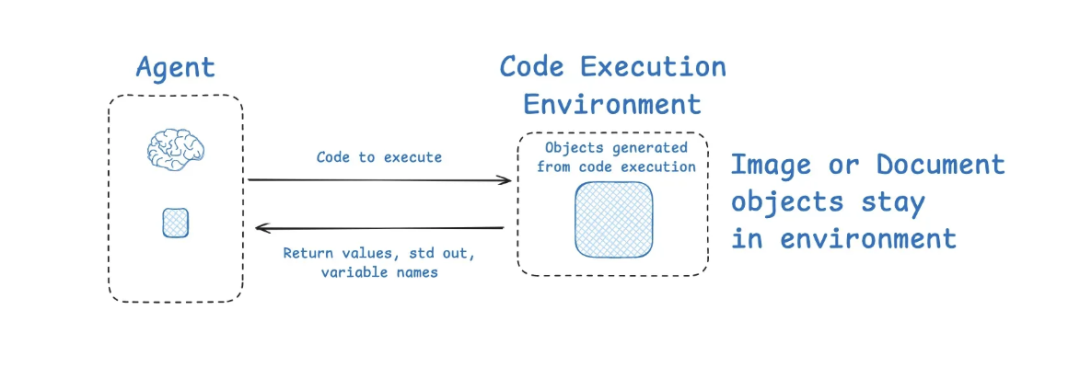
  • 分离环境与沙盒: Hugging Face 的代码代理通过将代码执行放在沙盒环境中,图像或大型对象留在沙盒内,返回值再传回 LLM,这样可以隔离大量 token

    huggingfaceOpen-source DeepResearch – Freeing our search agents
  • 状态对象: 在 LangGraph 中,开发者可以设计包含多个字段的状态 schema,只将 messages 字段暴露给模型,而将其他字段留作环境使用

不过,Cognition 指出,多代理架构容易出现上下文缺乏共享、决策冲突等问题,并总结出两个关键原则:原则 1:共享上下文和完整的代理轨迹;原则 2:决策隐含偏好,冲突会产生坏结果
因此在实际应用中,应谨慎使用多代理,必要时更倾向于线性单代理配合压缩技术。

链接内容梳理

《The Rise of Context Engineering》(LangChain)

LangChain 在文章中阐述了为什么上下文工程是下一代 AI 工程师最重要的技能。作者指出,随着应用从单一提示转向动态的代理系统,构建能够 动态组织信息、选择工具并以合适格式传递给模型的系统 是成功的关键
文章强调:

  • 代理性能差往往是因为缺乏正确的上下文和工具;
  • 上下文工程包括系统地收集信息、动态构建提示、提供合适工具并保证格式合理blog.langchain.com;
  • 适当的上下文和工具比花哨的提示词更重要,提示工程只是上下文工程的一个子集

《Don’t Build Multi‑Agents》(Cognition)

Cognition(Devin 团队)反对盲目构建多代理系统,认为上下文工程才是构建可靠代理的核心。他们指出:

  • 上下文工程是比提示工程更高级的技能,是代理工程师的核心工作
  • 多代理架构看似诱人,但容易造成误解和冲突。即便给子代理复制完整任务描述,也无法避免上下文缺失,因为实际任务涉及多轮对话和工具调用,任何细节缺失都会影响理解
  • Cognition 总结两条原则:共享上下文、共享完整的代理轨迹;每个动作都隐含决策,冲突会导致坏结果
    他们建议在多数情况下采用单线程线性代理,并通过压缩模型来保留关键信息,使长任务也能可靠完成

《How we built our multi‑agent research system》(Anthropic)

Anthropic 描述了他们为 Claude 构建研究模式的经验。文章认为:

  • 多代理系统适合探索性研究等 开放性任务。主代理解析用户查询,生成计划并创建多个子代理并行搜索信息
  • 子代理各自拥有独立的上下文窗口和工具,可以探索问题的不同方面,再由主代理汇总,提供 分工明确、各自为政 的优点
  • 内部评测显示,该系统在广度优先问题上比单代理方案提升 90%,但成本高昂,token 使用量约为对话的 15 倍,因此仅适合价值高、可以充分并行的任务
  • 他们通过 写入计划到记忆 来解决上下文截断问题,并总结了如何给代理制定合适的提示、合理划分子任务、并行调用工具等提示工程经验

《How Long Contexts Fail》(Drew Breunig)

Drew Breunig 指出,超长上下文并不一定带来更好的代理。相反,过长的上下文会引入污染、干扰、混乱和冲突等问题,使代理迷失方向作者分析了每种失败模式的案例,并指出需要通过剪枝、工具检索、隔离等方法防止上下文失控。

Provence:高效稳健的上下文剪枝

在 RAG 系统中,检索内容往往很长。Provence 将 上下文剪枝 视为序列标注问题,通过统一剪枝与重排序模型、在多样化数据上训练,实现了在不同领域几乎不损失性能的剪枝方法这为压缩策略提供了更稳健的算法支持。

LangGraph 与 LangSmith 的支持

LangGraph 是 LangChain 推出的有向图代理框架,旨在让开发者完全控制代理的步骤、状态和上下文。它提供了以下功能:

  • 检查点与长短期记忆: 支持在代理会话内持久化状态(短期记忆)和跨会话保存信息(长期记忆),方便实现 scratchpad 与记忆功能
  • 灵活的状态检索: 在每个节点中,开发者可以从状态对象或长期记忆中检索特定字段,并通过自定义逻辑决定哪些信息注入到上下文
  • 压缩与修剪: 提供总结与修剪工具,可在代理设计中的特定步骤调用 LLM 或剪枝算法对上下文进行精简
  • 多代理与沙盒: LangGraph 支持构建多代理系统,通过设置不同的节点和状态字段实现隔离,并可结合沙盒环境保存大型数据对象

LangSmith 则提供了强大的 追踪和评测 功能,可查看代理的每一步输入输出、token 使用情况,并评估不同上下文工程策略对性能的影响

结论与展望

上下文工程是构建可靠 AI 代理的核心,它决定了代理能否在有限的工作内存中合理利用指令、知识和工具。本文总结出以下要点:

  1. 上下文工程不仅是提示工程的升级,更是将动态系统、工具协作和记忆管理结合在一起的综合工程

  2. 四大策略(写入、选择、压缩、隔离) 是构建代理时常见的手段,需要根据任务特性灵活组合
  3. 多代理架构优缺点并存:并行子代理可扩展能力,但会增加成本并带来协调困难,需配合共享上下文和压缩技术

  4. 长上下文不是灵丹妙药:随着上下文增长,污染、干扰、混乱和冲突现象会加剧,剪枝和隔离同样重要

对于正在建设代理系统的读者,可以从以下方面入手:

  • 观察代理任务流程,确定何时需要写入、选择、压缩或隔离上下文;
  • 通过工具检索、摘要和剪枝算法控制上下文长度;
  • 警惕多代理带来的协调与成本问题,优先确保共享上下文和决策的一致性;
  • 使用 LangSmith 等工具观察代理行为,及时调整上下文工程策略。

随着模型能力和工具生态的发展,合理的上下文工程将成为 AI 代理迈向生产级应用的关键。希望本文能帮助你更好地理解这一新兴领域,并在自己的项目中应用这些思路。

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

在这里插入图片描述

L1阶段:启航篇丨极速破界AI新时代
​​​​​​​L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的
核心原理、关键技术以及大模型应用场景。

在这里插入图片描述

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

在这里插入图片描述

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

在这里插入图片描述

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

在这里插入图片描述

L5阶段:专题集丨特训篇 【录播课】

在这里插入图片描述
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

解锁Multi-Agent系统:复杂任务的智能协作解决方案 Multi-Agent 系统以其独特的分布式处理、协同工作和自适应性等优势,在智能软件开发、智慧供应链管理、智能客服优化等众多领域展现出了巨大的应用价值。通过多个智能体之间的相互协作和信息交互,它能够高效地解决复杂问题,提升系统的整体性能和效率。在实现框架方面,MetaGPT 通过模拟软件公司多角色,利用 SOP 驱动智能体,实现了软件开发流程的高效协作;Autogen 支持创建和管理多个自主智能体,通过聊天组等机制实现智能体之间的顺畅沟通和协作; 阅读详情

相关推荐

GPT大模型在数学建模中的实战应用:从思路启发到代码生成

数学建模是将现实问题抽象为数学问题并求解的核心方法,其关键在于通过合理的假设与简化,构建可计算的数学模型。传统建模依赖MATLAB等工具进行推演试错,而大语言模型的出现革新了这一范式。GPT等模型通过理解自然语言、辅助逻辑推理与代码生成,能有效提升建模效率与质量,在问题解析、模型构建、算法实现等环节提供关键支持。本文聚焦GPT在数学建模中的具体应用,涵盖赛题解读、模型推导、代码生成与结果分析,并结合实战案例,探讨如何将其作为“副驾驶”融入建模全流程,实现人机协同的智能化建模。

weixin_29061465的博客 324

解锁Mutil-Agent高级玩法:上下文工程(Context Engineering)是提升协作效率的终极法宝?

摘要:文章探讨了大语言模型(LLM)代理系统中"上下文工程"的重要性与实施策略。随着LLM发展,仅靠提示词已无法满足复杂任务需求,需要系统性地组织外部知识、工具反馈等信息。文章提出四种核心策略:写入(持久化存储)、选择(相关记忆提取)、压缩(摘要修剪)和隔离(多代理分工),并分析了长上下文可能导致的污染、干扰等四大失败模式。通过LangChain、Anthropic等案例,说明合理的上下文管理能显著提升代理性能。最后指出,相比盲目扩大上下文窗口或多代理架构,精细化的上下文工程才是构建可靠

2401_85343303的博客 878

开题报告该怎么写

考研即将来临,而一般很多大学都会选择在考研结束之后开始安排选题和开题报考(考研之前一般都不谈,老师也很人性化的,不愿意耽误你的复习) 但无论怎么推迟,我们最终都需要去面对并完成这些任务。 现在我就要教大家该如何写一个完整的开题报告! 准备模板。不同的学校有不同的格式,一般情况你的导师会给你们一个学校的标准格式,这个不用太费心。有了模板我们就可以按照模板的“线索”一步一步填充完成即可! 一般大致格式可谓: 研究背景/论文的目的、背景和意义 我们需要写明选择该题目的...

wuyueweifeng的博客 1095

2024-06-02 问AI: 在大语言模型中,什么是multi agent?

这类模型通过集成多智能体的学习机制,能够更灵活、更真实地模拟人类社会中的交互模式,提升语言理解和生成的质量,以及在多任务、多目标场景下的表现。在讨论大语言模型时,“multi-agent” 系统通常指的是一种分布式人工智能(AI)模型,其中多个智能代理(agents)在共享的环境(environment)中协同工作,以实现各自或共同的目标。总结来说,Multi-Agent在大语言模型中是指一种由多个具有自主决策和交互能力的智能体组成的系统,这些智能体能够相互协作、竞争或协商以完成共同或各自的任务。

baidu_24377669的博客 1847

ARM双核锁步DCLS Lockstep技术研究(FPGA实现)

基于《Applying Dual-Core Lockstep in Embedded Processors to Mitigate Radiation-induced Soft Errors》文章总结 RISC-V双核锁步DCLS Lockstep技术参考之前文章: RISC-V双核锁步DCLS Lockstep技术总结_远古架构师alanwu的博客-优快云博客https://blog.youkuaiyun.com/heyuming20062007/article/details/123329537ARM+RIS

heyuming20062007的博客 8727

工程伦理ppt

工程伦理学 第一章 工程与伦理 1.1 如何理解工程 一、技术与工程的区别 二、技术与工程的联系 三、工程的定义 五、工程具有不确定性和探索性 六、理解工程活动的7个维度 1.2 如何理解伦理 一、道德与伦理 二、不同的伦理立场 三、伦理困境与伦理选择 1.3 工程实践中的伦理问题 一、工程活动中的行动者网络(具有动态性和网络性) 二、主要的工程伦理问题 三、工程伦理问题的特点 1.4 如何处理工程实践中的伦理问题 一、工程实践中伦理问题的辨识 二、处理工程伦理问题的基本原则 三、应对工程伦理问题的基本思路

weixin_51656605的博客 7万+

变革来袭!多Agent框架MuAgent带你解锁代码开发新姿势

在这个信息技术爆炸的时代,我们都知道大型语言模型(LLM)拥有处理复杂问题的能力,但当遇到编程难题这种更高级的挑战时,单独的LLM Agent可能就不够看了。社区里动起了脑筋,玩出了新花样——组合多个Agent来应对高难度挑战!正如Multi Agent的构建过程所示,与其说我们是在设计Agents,不如说是对当前需求的深入理解后去构建出一条专属于某个场景的SOP。 功能演示:在muAgent里能够实现本地代码库的问答功能 1、能够支持java代码库导入,并转换成向量数据、图数据以及传统数据

CodeFuse的博客 2689

科研人必备!用WisPaper搭建个人文献知识库的完整指南(附Zotero联动技巧)

本文详细介绍了如何利用WisPaper搭建高效的个人文献知识库,包括文件命名标准化、文件夹结构设计、语义搜索技巧及与Zotero的深度联动方法。通过智能标签系统和知识图谱功能,科研人员可以快速定位关键文献,提升研究效率。特别适合需要管理大量学术文献的研究者。

weixin_30823001的博客 267

超越GPT4的Agent,我用代码实现了!

最近,人工智能领域的泰斗吴恩达教授提出了一个观点,即通过智能体工作流构建的AI在某些应用场景中的表现甚至可以超越GPT-4。

2301_81888214的博客 1069

ESD防护设计宝典(十一):CE(传导发射)超标问题排查与解决

(Conducted Emission, CE),亦称为传导骚扰,是电子电气设备或系统内部的电压、电流通过信号线、电源线或地线向外传输,对其他电子电气设备或系统造成电磁干扰的物理现象。其。

m0_56451176的博客 856

22、硬件工程师笔试面试——电机(2025版本)

例如,B级绝缘的电机可以承受的最高温度为130℃,而H级绝缘的电机可以承受高达180℃的温度。同时,也要考虑电机的成本和控制系统的复杂性。电机的选择取决于其应用的具体要求,包括所需的功率、速度、扭矩、效率、成本和工作环境等。根据电动机保护配置原则,为电机配置适当的保护,如过负荷保护、缺相保护、逆相保护、接地漏电保护、堵转保护、相不平衡保护、短路保护、过电压保护、低电压保护、过热保护等。根据安培环路定理,电流和磁场的相互作用会在电机的转子上产生力,这些力作用于转子上,使其绕轴旋转,从而产生转矩。

XU157303764的博客 3538

多智能Multi-Agent原理与实现初探

多智能体系统(Multi-Agent)概述与应用价值 多智能体系统(MAS)是由多个自主智能体(Agent)通过协作、竞争等方式组成的分布式系统。每个智能体拥有独立的LLM模型、提示词、工具和代码,能够感知环境并自主决策。MAS通过集体行为解决复杂问题,突破了单智能体的局限性。 核心优势 突破上下文限制:通过功能拆分避免上下文窗口超限 增强灵活性:松耦合结构支持动态调整 提升效率:分工协作实现复杂任务分解 工作原理 智能体具备自主性、反应性、主动性和社交能力 通过通信、协作、协调、协商等方式交互 采用合同网

小马过河R的博客 2643

基于深度学习的异常检测实战:从自编码器到GAN

本文通过一个完整的实战案例,展示了如何使用自编码器和GAN进行异常检测。我们详细介绍了数据准备、模型定义、训练和评估的步骤,并提供了可运行的代码。希望本文能为读者在实际项目中应用异常检测技术提供实用的指导和启发。

Programming Talk 242

Mutil-Agent的终极秘密武器:上下文工程(Context Engineering)

摘要: 随着大语言模型(LLM)和代理框架的发展,“上下文工程”成为优化代理性能的关键技术。它通过动态管理系统性地为代理提供必要信息与工具,克服长上下文导致的成本、效率及失败模式问题。核心策略包括:写入(持久化外部存储)、选择(精准提取相关记忆)、压缩(摘要或修剪冗余内容)和隔离(多代理分工或沙盒环境)。研究显示,单代理配合压缩技术通常更可靠,而多代理仅适用于高价值并行任务。LangChain、Anthropic等团队强调,上下文工程比提示工程更系统化,是构建高效代理的核心能力。

m0_71746299的博客 859

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Mutil-Agent的终极秘密武器:大模型代理的上下文工程(context engineering)提高AI系统可靠性的关键技术

上下文工程是构建可靠AI代理的核心,通过写入、选择、压缩和隔离四种策略,在有限上下文窗口内为代理提供恰当信息和工具。与提示工程不同,它强调系统性、动态性和正确性。长上下文会导致污染、干扰、混乱和冲突等失败模式,需合理控制。多代理架构虽提升性能但增加成本,需谨慎使用。合理的上下文工程是AI代理迈向生产级应用的关键。

datian1234的博客 1087

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Redis:解决分布式高并发修改同一个Key的问题

本篇文章是通过watch(监控)+mutil(事务)实现应用于在分布式高并发处理等相关场景。下边先通过redis-cli.exe来测试多个线程修改时,遇到问题及解决问题。 高并发下修改同一个key遇到的问题: 1)定义一个hash类型的key,key为:lock_test,元素locker的值初始化为0。 2)实现高并发下对locker元素的值递增:定义64个多线程,并发的对lock_tes...

weixin_33834628的博客 2545

mutil:多线程/多节点文件操作工具

mutil:多线程/多节点文件操作工具 项目介绍 在现代计算机系统中,文件操作是日常工作中不可或缺的一部分。文件的频繁迁移、备份与恢复,以及硬件升级和替换,都要求我们能够高效地完成文件复制和校验任务。mutil(Multi-Threaded/Multi-Node Utilities)正是为了满足这一需求而诞生的开源项目。它提供了一套多线程和多节点文件操作的实用工具,旨在充分利用现代并行文件系统的高...

gitblog_00324的博客 1194

Mutil-Agent的核心--上下文工程

摘要:本文探讨了上下文工程(Context Engineering)在AI智能体开发中的关键作用。随着大模型和代理框架的发展,如何在有限上下文窗口中有效管理信息成为复杂任务处理的核心挑战。文章分析了AI Agent处理复杂任务失效的根源,介绍了Cursor等先进工具采用的上下文回溯、工具调用等技术方案,并详细阐述了四种上下文管理策略:滑动窗口记录、动态摘要生成、结构化信息提取和复杂应用状态管理。作者强调,上下文工程的兴起标志着AI开发范式从离散指令优化转向连续认知生态构建,需要开发者以系统思维构建具备状态持

weixin_47324594的博客 579

小学生也能听得懂的大模型 - Transformer 1

参考 [小学生也能听得懂的大模型 Transformer 1]

2401_85325557的博客 1737

【AI工程师必看】构建智能体记忆系统的10个核心方法论

随着大语言模型能力的飞速发展,构建高效的AI智能体已成为技术前沿的核心挑战。与传统的聊天机器人不同,智能体需要在复杂的多步骤任务中保持连贯性、准确性和效率。而这一切的关键,正是上下文工程。

2401_85375186的博客 1137

大模型技术演进

含AI生成内容,请注意甄别

2301_79132874的博客 1636

AI科普:全面了解LLM上下文工程(二):为什么要有上下文工程?

在上一篇文章中,我们聊了从提示词工程到上下文工程的发展过程,看到了大语言模型交互方式的逐步演化。

huang9604的博客 699

突破RAG瓶颈:localGPT句子级剪枝技术让回答精准度提升40%的实战指南

你是否遇到过这样的困境?使用本地知识库问答时,AI总是被无关信息干扰,明明文档里有准确答案,却因为上下文噪音太多导致回答偏离重点。localGPT的句子级剪枝技术(Context Pruning)正是为解决这一痛点而生,通过精准筛选与问题相关的句子,让AI聚焦核心信息,大幅提升回答质量。本文将带你深入了解这一技术的实现原理、工作流程及实际应用效果,读完你将掌握如何利用这一强大功能优化自己的本地知识...

gitblog_00221的博客 465

必收藏!Multi-Agent系统入门详解(含主流框架选型+未来趋势)| 小白&程序员必看

这是智能体的“身份标签”,明确其核心定位、工作边界和行为准则,主要包含系统提示词(System Prompt)、性格特征、权限范围三大要素。示例:“你是一名资深Python代码审计员,核心职责是Review代码、排查语法错误和安全隐患,不负责编写业务逻辑、不参与需求讨论,仅输出审计报告和修改建议。当前Multi-Agent系统已全面爆发,对于小白和程序员来说,无需盲目追求“最强大”的框架,核心是“匹配自身业务需求+贴合技术栈”。以下选型指南直接套用,帮你快速锁定合适的框架,节省试错成本。

2301_76168381的博客 1078

【Agent系列】详细调研总结19种主流Agent框架

详细总结对比19种主流Agent框架

m0_68116052的博客 5万+
上一篇: Dify工作流中生成的内容写为文件导出,大模型入门到精通,收藏这篇就足够了!
下一篇: 5分钟了解GraphRAG和Mem0,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值