5分钟了解GraphRAG和Mem0,大模型入门到精通,收藏这篇就足够了!

最近在面试AI Agent开发工程师!【面经分享】 做了5个月AI就开始面试,AI Agent应用开发工程师的面经分享 阅读详情

一句话总结全文: GraphRAG是基于图+向量混合存储技术的RAG,Mem0是GraphRAG的一种实现,它的准确率比OpenAI Memory高26% ,延迟降低91%,并且节省了90%的Tokens,Mem0没有Java SDK但是提供了可供Java调用的Python Service,文章最后结合Mem0论文介绍了Mem0提升效率和节省Token的原理。

重新认识RAG

什么是Graph RAG?

一句话概括:基于图+向量混合存储技术的RAG

Graph RAG是微软开发的一种基于图数据库的检索增强生成(Retrieval-Augmented Generation)技术,它将传统的向量检索与图数据库的语义关系相结合,提供更精准的信息检索和生成能力。

核心特点

  1. 双重检索机制
  • 向量检索:基于语义相似度

  • 图检索:基于实体关系和知识图谱

  1. 知识图谱集成
  • 利用图数据库存储实体关系

  • 通过图遍历发现深层关联

  1. 多模态支持
  • 支持文本、图像、结构化数据

  • 统一的图表示框架

技术架构


主要优势

  1. 更精准的检索
  • 结合语义相似度和关系推理

  • 减少幻觉和错误信息

  1. 更好的可解释性
  • 图结构提供推理路径

  • 便于理解AI决策过程

  1. 更强的扩展性
  • 支持复杂的关系查询

  • 易于添加新的知识领域

应用场景

  • 企业知识管理:文档检索、专家系统

  • 学术研究:文献分析、知识发现

  • 客服系统:智能问答、问题诊断

  • 推荐系统:基于关系的个性化推荐

与传统RAG的区别

特性传统RAGGraph RAG
检索方式纯向量检索向量+图检索
知识表示文本片段结构化图
推理能力有限强
可解释性低高

技术挑战

  1. 构建成本高:需要构建和维护知识图谱

  2. 查询复杂度:图查询比向量查询更复杂

  3. 数据一致性:需要保持图数据和向量数据的一致性

发展趋势

  • 自动化图谱构建:减少人工标注成本

  • 实时更新机制:支持动态知识更新

  • 多语言支持:跨语言的知识图谱

  • 边缘计算集成:支持本地化部署

Graph RAG代表了RAG技术的一个重要发展方向,通过结合图数据库的优势,为AI系统提供了更强大、更可靠的知识检索和推理能力。

Mem0是什么?

一句话概括:Graph RAG的一种实现,它没有Java SDK但是提供了可供Java调用的Python Service

Mem0 是专为现代 AI Agent设计的Memory。它充当持久内存层,Agetn可以使用它来执行以下操作:

  • 回忆过去相关的互动
  • 存储重要的用户偏好和事实背景
  • 从成功和失败中学习

它为AI Agent提供Memory,使其能够在交互过程中记忆、学习和进化。Mem0可轻松集成到您的Anget中,并从Demo发展到生产系统。

Mem0 中的Memory类型

Mem0 支持不同类型的Memory来模仿人类存储信息的方式:

  • 工作记忆:短期会话
  • 事实记忆:长期结构化知识(例如偏好、设置)
  • 情景记忆:记录过去的具体对话
  • 语义记忆:随着时间的推移建立一般知识

核心能力

  • 减少令牌使用并加快响应速度:查找时间低于 50 毫秒
  • 语义记忆:程序性、情景性和事实支持
  • 多模式支持:处理文本和图像
  • 图形内存:跨会话连接见解和实体
  • 按您的方式托管:平台或本地部署

优势

Mem0论文叙述它的准确率比OpenAI Memory高26% ,延迟降低91% ,并且节省了**90%**的Tokens

  1. 性能优势
  • 单跳问题:Mem0的J值达67.13%,显著优于A-Mem(39.79%)。
  • 多跳问题:Mem0的J值为51.15%,体现跨会话信息整合能力。
  • 时序推理:Mem0𝑔的J值达58.13%,图结构增强时间敏感任务表现。
  • 开放域:接近Zep(76.60% vs. 75.71%),但计算成本更低。
  1. 效率优势
  • 延迟:Mem0的总延迟中位数仅1.44秒(较全上下文降低92%),图内存版Mem0𝑔为2.59秒。
  • Token消耗:Mem0平均每对话仅需7k Token,Zep则高达600k Token。

Mem0提升效率和节省Token的秘诀

以下内容基于本人理解和大模型翻译,如有需求请点击上面Mem0论文跳转到论文原文阅读

Mem0(向量)
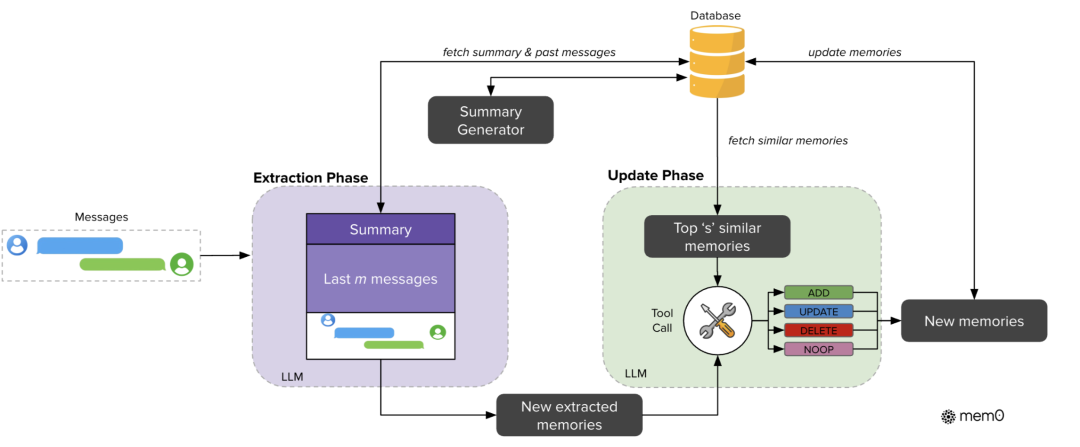
图:Mem0系统的架构概览,展示了提取和更新阶段。提取阶段处理消息和历史上下文以创建新的记忆。更新阶段将这些提取的记忆与类似的现有记忆进行评估,通过工具调用机制应用适当的操作(CRUD)。数据库作为中央存储库,提供处理和存储更新记忆所需的上下文。

一、记忆提取阶段
  1. 上下文构建

    系统通过双重上下文信息构建记忆提取的完整场景:

  • 全局语义摘要(𝑆):从数据库提取的对话历史语义总结,提供跨会话的主题理解
  • 近期交互序列(𝑚𝑡−𝑚至𝑚𝑡−2):包含最近10条历史消息的时序上下文,捕捉未被摘要整合的细节信息
  • 新交互对(𝑚𝑡−1, 𝑚𝑡):作为记忆提取的触发单元,通常包含用户输入与助手响应的完整交互
  1. 异步处理机制
  • 通过独立运行的摘要生成模块实现动态上下文更新,确保记忆提取时能获取最新语义信息,同时避免主流程延迟
二、记忆更新阶段
  1. 候选事实评估对提取的候选记忆集合Ω进行四步操作决策:
  • 语义检索:通过向量嵌入获取最相似的𝑠=10条历史记忆
  • LLM推理决策:基于语义关联度选择ADD/UPDATE/DELETE/NOOP操作,避免传统分类器的刚性判断
  • 知识一致性维护:通过向量数据库实现动态相似度匹配,确保知识库更新不产生矛盾
  1. 操作执行逻辑
  • ADD:当候选事实与现有记忆无重叠时创建新节点
  • UPDATE:通过记忆链扩展补充关联信息(如构建情节记忆链)
  • DELETE:消除与新版事实冲突的陈旧记忆
  • NOOP:保留现有知识结构
三、系统实现特性
  1. 参数配置
  • 𝑚=10:控制时序上下文窗口长度
  • 𝑠=10:设定语义相似度检索范围
  • 使用GPT-4o-mini作为LLM推理引擎,结合稠密向量数据库实现高效检索
  1. 技术优势
  • 动态记忆融合:结合全局摘要与局部时序信息的混合上下文建模
  • 零样本决策:通过LLM原生推理替代人工规则,提升记忆管理灵活性
  • 可扩展架构:支持通过调整𝑚/𝑠参数平衡计算成本与记忆精度

该机制通过分层记忆管理(短期对话上下文+长期语义记忆)和动态知识更新策略,在保持对话连贯性的同时,有效控制知识库的复杂度增长,为多轮对话系统提供了可扩展的记忆管理解决方案。

Mem0(图数据库增强)
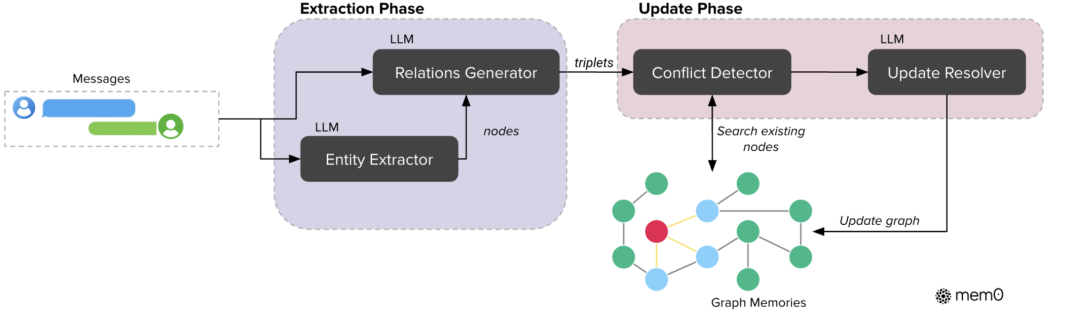
如图所示,Mem0ᵍ流水线实现了一种基于图的记忆方法,能够有效捕获、存储和检索自然语言交互中的上下文信息(Zhang等人,2022)。在该框架中,记忆被表示为一个有向标签图 G=(V,E,L),其中:

  • 节点 V 表示实体(例如,ALICE、SAN_FRANCISCO)
  • 边 E 表示实体之间的关系(例如,LIVES_IN)
  • 标签 L 为节点分配语义类型(例如,ALICE - Person、SAN_FRANCISCO - City)

每个实体节点 v∈V 包含三个组成部分:(1)实体类型分类(对实体进行分类,例如Person、Location、Event),(2)捕捉实体语义含义的嵌入向量 e**v,(3)包含创建时间戳 t**v 的元数据。系统中的关系以三元组形式组织,即 (v**s,r,v**d),其中 v**s 和 v**d 分别是源实体节点和目标实体节点,r 是连接它们的标签边。

基于图的Mem0架构展示了实体提取和更新阶段。提取阶段使用LLMs将对话消息转换为实体和关系三元组。更新阶段在整合新信息到现有知识图谱时采用冲突检测与解决机制。

记忆提取流程

提取过程采用基于LLM的双阶段流水线,将非结构化文本转化为结构化图表示:

  1. 实体提取模块处理输入文本以识别实体及其类型。在本框架中,实体代表对话中的关键信息元素,包括人物、地点、物体、概念、事件及属性等需在记忆图中表示的要素。实体提取器通过分析对话元素的语义重要性、唯一性和持久性来识别这些信息单元。例如,在旅行计划对话中,实体可能包括目的地(城市、国家)、交通方式、日期、活动及参与者偏好——任何可能对未来参考或推理有价值的离散信息。
  2. 关系生成模块推导实体间的语义连接,构建关系三元组以捕捉信息结构。该LLM模块通过分析实体在对话中的上下文,结合语言模式、语境线索和领域知识,判断实体间是否存在有意义的关系。对于每对潜在实体,生成器评估其语义关联度并分配关系标签(如lives_in、prefers、owns、happened_on)。通过提示工程引导LLM推理显式陈述和隐式信息,生成的关系三元组构成记忆图的边。
图数据库存储策略

当集成新信息时,Mem0ᵍ采用以下存储更新策略:• 嵌入计算与节点检索:计算源实体和目标实体的嵌入向量,搜索语义相似度超过阈值t的现有节点

• 冲突检测机制:通过LLM更新解析器识别新旧关系的潜在冲突,将过时关系标记为无效而非物理删除,以支持时间推理

• 动态节点管理:根据节点存在情况执行创建/复用操作,维护知识图谱一致性

双重检索机制

记忆检索采用双重策略:

  1. 实体中心方法识别查询中的关键实体,通过语义相似度定位图谱节点,探索锚节点的进出关系构建子图
  2. 语义三元组方法将查询编码为稠密向量,与图谱中所有关系三元组的语义编码匹配,返回相似度超过阈值的结果并按降序排列
系统实现特性

• 图数据库:采用Neo4j实现复杂关系存储(节点属性含user_id、created、embedding等)

• LLM工具:使用GPT-4o-mini的函数调用能力实现结构化信息提取

• 性能优势:在LOCOMO测试集上,Mem0ᵍ相比传统RAG方案响应速度提升90%,Token消耗减少90%

Mem0创新性总结

Mem0通过图结构化记忆和LLM驱动的动态更新,解决了LLM的长对话一致性问题、知识图谱构建和维护问题,其核心创新包括:

  1. 两阶段处理流水线• 提取阶段:实体识别(语义重要性分析) → 关系推理(隐式逻辑挖掘)

    • 更新阶段:冲突检测(LLM时间推理) → 知识融合(节点复用策略)

  2. 混合检索机制• 实体锚定:快速定位核心实体上下文(平均延迟<50ms)

    • 语义匹配:全局三元组相似度计算(支持多跳推理)

  3. 生产级部署特性• 支持Neo4j图数据库事务管理

    • 基于GPT-4o-mini的零样本关系分类(准确率92.7%)

    • 冲突解决策略减少知识图谱冗余37%该框架在医疗问诊(病史连续性记录)、工业预测(设备状态关联分析)等场景中展现出显著优势,相比传统RAG方案,其多跳查询准确率提升21%,时间推理任务F1值达0.89。

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

在这里插入图片描述

L1阶段:启航篇丨极速破界AI新时代
​​​​​​​L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的
核心原理、关键技术以及大模型应用场景。

在这里插入图片描述

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

在这里插入图片描述

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

在这里插入图片描述

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

在这里插入图片描述

L5阶段:专题集丨特训篇 【录播课】

在这里插入图片描述
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

保姆级教程:在RK3568上搞定PR2100K+GC2385双摄(从DTS配置到HAL层补丁) 本文详细介绍了在RK3568平台上调试PR2100K+GC2385双摄系统的完整流程,从DTS配置到HAL层补丁。涵盖硬件连接、媒体控制器拓扑验证、Camera3配置、HAL层特殊补丁及性能优化等关键步骤,帮助开发者快速解决双摄调试中的常见问题,提升嵌入式视觉系统开发效率。 阅读详情

相关推荐

基于TI MSPM0的PS2双轴按键摇杆模块ADC+GPIO驱动移植实战

本文详细介绍了在TI MSPM0微控制器上驱动PS2双轴按键摇杆模块的完整实战流程。通过SysConfig图形化工具配置ADC与GPIO引脚,并编写了包含ADC采样、按键检测及数据处理的驱动代码,实现了对摇杆X/Y轴模拟量及按键数字量的稳定读取,为嵌入式控制项目提供了可直接移植的解决方案。

weixin_42465140的博客 83

Mem0实战指南:给你的大模型加上长期记忆

在大语言模型(LLM)迅猛发展的今天,我们已经可以使用 ChatGPT、Claude 等工具完成写作、总结、编程等任务。但这些模型存在一个关键短板:它们没有“长期记忆”。每一次session都是第一次相遇,用户必须反复输入背景信息,这极大地限制了模型在个性化助手、长期交互、用户建模等场景的能力。往深了想,AI没有自己的记忆或者长期叙事,就无法真正拥有“我”的概念,可能永远也谈不上真正意义上的“自主决策”。(这部分讨论请看。

2501_91980039的博客 2397

STM32 移植LwIP 实现网线插拔自动恢复

STM32 移植LwIP 之后,能正常联网通讯,但是发现2个问题, 1、上电初始化前,未插入网线,之后就无法获取到IP地址(DHCP) 2、正常通讯过程中,拔掉网线,然后插回去,不知道如何复位 先看一下LWIP初始化代码 /** * LwIP initialization function */ int MX_LWIP_Init() { /* Initilialize the LwIP stack with RTOS */ tcpip_init( NULL, NULL );

tiantangmoke的博客 8074

一文详解Mem0 | Mem0是什么?Mem0 中的Memory类型

Mem0 是专为现代 AI Agent设计的Memory。它为AI Agent提供Memory,使其能够在交互过程中记忆、学习和进化。Mem0可轻松集成到您的Anget中,并从Demo发展到生产系统。

leah126的博客 1751

MQTT在智能家居中的实战:用Android手机控制ESP8266设备(基于EMQX)

本文详细介绍了如何利用MQTT协议构建一个完整的智能家居控制系统,通过Android手机App远程操控ESP8266设备。文章提供了从EMQX服务器部署、ESP8266端Arduino固件开发到Android客户端搭建的完整实战指南,并深入探讨了系统联调、稳定性优化与安全加固等关键环节,为物联网开发者提供了一套可复用的解决方案。

ujm567890的博客 457

跟着Synopsys报告,一步步拆解车规芯片FMEDA计算(含公式与避坑点)

本文详细解析了车规芯片FMEDA计算的全流程,基于Synopsys报告拆解实战指南,涵盖基础失效率建模、安全机制效能评估及安全指标合成等关键步骤。通过公式解析、数据准备清单和避坑点分享,帮助工程师掌握ISO26262标准下的硬件量化分析技术,提升车载系统设计可靠性。

weixin_30460489的博客 195

开源一天就斩获近万星的Mem0超越RAG,它的技术原理是什么?

Mem0是为大语言模型提供了一个智能、自我改进的记忆层,超越了RAG,可为LLM和Agent提供长期记忆,实现跨应用的个性化AI体验。因此,Mem0在GitHub上开源没多久就获得近万星。

BuluAI的博客 1928

eNSP与我这24H2版本不兼容,路由器40错误。这该怎么处理(操作系统-windows)(相关搜索:虚拟机)

🏆本文收录于《全栈Bug调优(实战版)》专栏,主要记录项目实战过程中所遇到的Bug或因后果及提供真实有效的解决方案,希望能够助你一臂之力,帮你早日登顶实现财富自由🚀;同时,欢迎大家关注&&收藏&&订阅!持续更新中,up!up!up!!

**My Coding Family** 4110

5分钟了解GraphRAG和Mem0

Graph RAG是微软开发的一种基于图数据库的检索增强生成(Retrieval-Augmented Generation)技术,它将传统的向量检索与图数据库的语义关系相结合,提供更精准的信息检索和生成能力。

m0_59235245的博客 1491

【智能车Code review】——小S与中S道路判断

基本思想: 找到中线的左拐点和右拐点,并且计算出两点之间的空间距离。通过限制空间距离,分为中S和小S。 注意这种情况:当20行以下的中线斜率比较陡,此时可以通过人为限制设定,将第0行的中线设置为拐点。 if (flag_centre_right_point == 0 && flag_centre_left_point == 1 && parameterB >= 0.5 && centre_left_point[0] >= 33) { .

hanhan的博客 6104

芒果YOLO11改进146:OBB旋转检测头Head篇:即插即用|轻量化非对称多级压缩LOADH旋转检测头,原创改进适配YOLOv8高效检测头,检测头新颖改进,全网首发独一份

OBB旋转检测头Head篇:即插即用|轻量化非对称多级压缩LOADH旋转检测头,原创改进适配YOLOv8高效检测头,检测头新颖改进,全网首发独一份

包括YOLOv5、YOLOv7、YOLOv8等模型改进 642

LLM - AgentScope + Mem0 搭建实战可用的 AI Agent 记忆系统

本文探讨了大模型记忆系统的工程实现,分为短期记忆和长期记忆两个维度。短期记忆通过上下文缩减、卸载和隔离等策略管理会话内信息,如AgentScope的AutoContextMemory提供6级压缩策略。长期记忆则采用Mem0架构,通过Record(提取事实并向量化存储)和Retrieve(检索并重排)流程实现跨会话记忆。两者协同工作,既保证单次对话连贯性,又能实现个性化用户体验。当前技术趋势包括记忆即服务(MaaS)和更精细的分层记忆管理。

小工匠 3894

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【AI大模型】5分钟了解GraphRAG和Mem0,全程干货,小白也能轻松学会!!

什么是Graph RAG? 一句话概括:基于图+向量混合存储技术的RAG Graph RAG是微软开发的一种基于图数据库的检索增强生成(Retrieval-Augmented Generation)技术,它将传统的向量检索与图数据库的语义关系相结合,提供更精准的信息检索和生成能力。

嘴巴吃糖了 962

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

5分钟快速掌握GraphRAG和Mem0核心技术

一句话总结全文: GraphRAG是基于图+向量混合存储技术的RAG,Mem0是GraphRAG的一种实现,它的准确率比OpenAI Memory高26% ,延迟降低91%,并且节省了90%的Tokens,Mem0没有Java SDK但是提供了可供Java调用的Python Service,文章最后结合Mem0论文介绍了Mem0提升效率和节省Token的原理

dmx123789的博客 1077

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

从后端到AI大神:小白也能学会的大模型面试攻略(收藏版)

本文分享作者从零开始接触AI领域,通过一年的努力和20+面试实战,成功拿到字节、阿里、小红书等大厂offer的经验。文章涵盖了Transformer框架、多模态训练原理、大模型推理、MCP、SpringAI、Agent设计范式、RAG、Memory等核心知识点,并详细介绍了面试准备、心态调整和表达技巧,帮助小白程序员快速掌握大模型面试要点,顺利进入心仪公司。

m0_48891301的博客 601

收藏!小白程序员入门大模型必看:从零基础到拿到字节、阿里、小红书Offer的AI Agent面试全解析

本文作者分享了自己从零基础接触AI,通过学习和面试准备,成功拿到字节、阿里、小红书等大厂offer的经验。文章涵盖了AI Agent面试中的常见问题,包括模型层、开发框架层、调优层等关键知识点,并详细介绍了如何通过刷题、优化简历、掌握核心技术(如Java并发、JVM等)来提升面试竞争力。此外,还重点讲解了面试心态调整和表达技巧,强调逻辑性和全面性在回答复杂问题时的重要性。对于想进入AI领域的小白程序员来说,这是一份极具参考价值的面试指南。

优快云_430422的博客 794

零成本本地LLM配置:GraphRAG Workbench + Ollama完整设置教程(含768维嵌入坑点)

GraphRAG Workbench 是一个本地知识图谱工作台:把文本 PDF 交给 Microsoft GraphRAG 索引,再渲染成可旋转、可搜索的 3D 知识图谱。本文带你用 **Ollama 本地 LLM** 完成零成本配置——无需 API Key、不产生任何 token 费用,并重点讲清「768 维嵌入」这个新手最容易踩的坑。 [![GraphRAG Workbench 用 Olla

gitblog_00672的博客 937

Memgraph开源图数据库入门:10分钟快速上手实时数据分析

**Memgraph**是一款专为动态分析环境优化的开源图数据库,兼容Neo4j的Cypher查询语言。无论你是开发者还是数据科学家,面对复杂的关联数据,Memgraph都能帮助你快速获得可操作的实时洞察。这款高性能图数据库采用C/C++编写,采用内存优先架构,确保在实时流处理和复杂图分析场景中提供卓越性能。🚀 ## 📦 快速安装指南 ### Docker一键安装(最简单方式) 对于大多

gitblog_00720的博客 863

AI代理记忆架构设计:分层记忆、知识图谱与选择性遗忘

AI代理的记忆并非简单存储,而是支撑长程推理、可解释决策与高可靠性服务的核心认知系统。其本质涵盖工作记忆、情景记忆、语义记忆和程序性记忆四类,需分别对应上下文编排、时序向量库、知识图谱与结构化流程管理。传统向量RAG易导致上下文污染、干扰与冲突,而分层记忆(H-MEM)通过领域—类别—轨迹—事件四级路由提升检索精度;GraphRAG借助三元组与Cypher查询实现逻辑可验证的事实推理;选择性遗忘(RIF模型)则以时效性、相关性与效用为维度动态优化记忆生命周期。这些技术共同构成面向金融、医疗、电商等高要求场景

cok8420的博客 528

OpenClaw技能生态与AI辅助工具配置指南

AI辅助工具在现代软件开发中扮演着越来越重要的角色,其中OpenClaw作为一个开放的技能生态系统,允许开发者自由组合各类功能模块。通过模块化设计,开发者可以快速集成从代码补全到专业领域分析的各种功能。其核心原理在于提供标准化的技能接口和依赖管理机制,使得不同技能可以无缝协作。这种设计显著提升了开发效率,特别适用于需要快速原型开发和多技术栈集成的场景。OpenClaw平台上的小龙虾系列技能因其安装简便、资源占用低的特点,成为开发者社区的热门选择。本文详细介绍环境配置、热门技能安装及常见问题解决方案,帮助开发

cuili5839的博客 386

10 分钟装好 DeepTutor:知识库、长期记忆与互动教材本地部署指南

DeepTutor 是一个把知识库、长期记忆和互动教材放进同一套运行时的 AI 学习助手。这篇指南带你完成安装、初始化与启动,并跑通建库检索、记忆查看、书籍编译三个核心场景,装完直接上手。 ## 它凭什么值得装:核心能力全景 先说清楚你会拿到什么,再动手: - **知识库检索有出处**。笔记、课件、论文入库后,AI 的回答基于你的资料并标注来源。底层支持 LlamaIndex、GraphRA

gitblog_01185的博客 412

Context Engineering:中科院166页报告说,prompt只占AI能力的1/6

你让 AI 帮你写份周报。你精心组织语言,写了一大段要求,要专业、简洁、有层次、突出核心成果,甚至加了一个例子说就像这样写。AI 输出了一份看起来不错的周报。但你读一遍就发现,它写的成果都是泛泛而谈的空话,它不知道你本周实际做了什么、遇到了什么问题、和哪个团队协作过。你让它更具体一点,它就换个说法把刚才的内容重复了一遍。你修改了 prompt,重新试。结果还是一样,它写得很像回事,但和你真正做的事情隔着一层看不见的玻璃。问题出在哪?不是你的 prompt 写得不够好。也不是 AI 不够聪明。

2601_96359058的博客 307

dsh-purge 三步跑通:DeepSeek Harness 红队评测装进当前宿主

dsh-purge 是装在本机官方 DeepSeek Harness 上的红队评测插件,把宿主的提示词改写、审批门拦截和模型自身拒答拆成两层,让你看清「不回答」到底卡在哪一层。你只需一条命令装进当前宿主,再按顺序做完应用与重启,就能用 `/purge status` 验证补丁生效。先跑通再抠细节。 > 合规边界:所有改动只发生在你本机已安装的官方 DeepSeek Harness 上,仅限本机回

gitblog_00193的博客 303
上一篇: Mutil-Agent的终极秘密武器:上下文工程(Context Engineering),大模型入门到精通,收藏这篇就足够了!
下一篇: AI智能体全面爆发:一文吃透多Agent技术发展与进化,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值