一图秒懂大模型:如何训练一个奖励模型,零基础入门大模型,收藏这篇就足够了

奖励建模(Reward Modeling)实现人类对智能体的反馈 人类反馈作为一种重要的教育资源,可用于指导智能体尤其是其中包含的大语言模型进行学习和改进,进而使得智能体在处理复杂任务时能够更准确地模拟人类智慧,并产生更为人性化和实用的交互效果。在实践中,这种结合已应用于诸如聊天机器人、虚拟助手、自动写作助手等多种场景。 这样,通过不断迭代和学习,大语言模型就能更好地适应和满足人类的沟通需求和价值观,从而展现出更强的交互能力和更好的表现。 阅读详情

在大语言模型(LLM)训练中,奖励模型(Reward Model, RM)是实现人类反馈强化学习(RLHF)核心组件之一。本文结合两幅图,详细介绍奖励模型的结构、训练过程及其作用机制。

一、奖励模型的结构拆解
图片

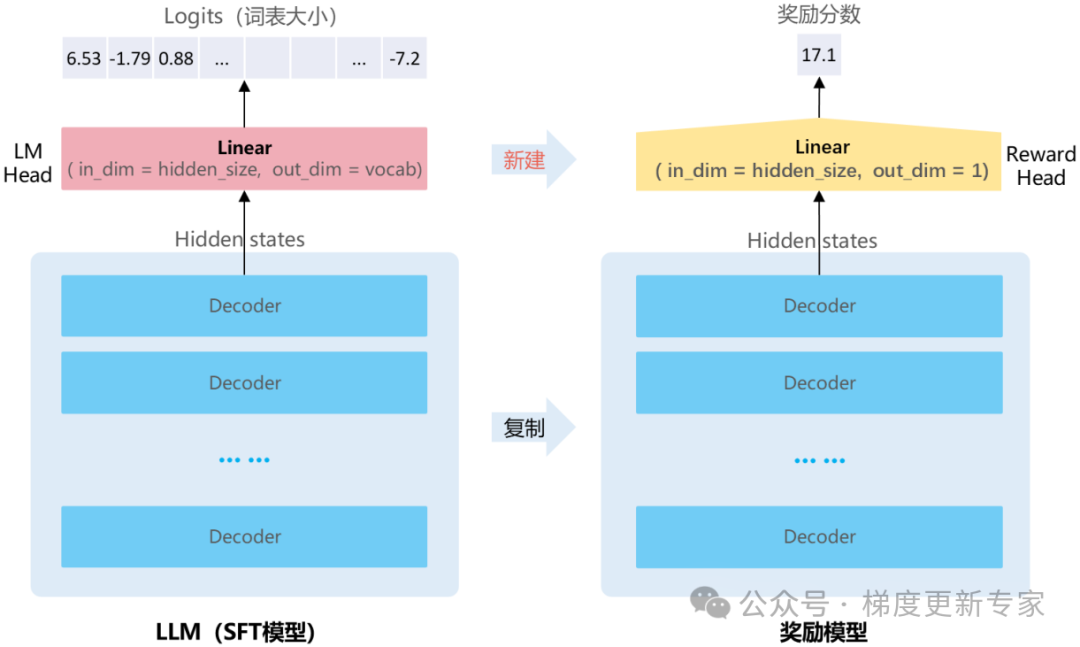
如图所示,展示了奖励模型的结构构建流程:

1. 从语言模型(SFT模型)复制主干网络

左图部分为一个经过监督微调(SFT)的语言模型,它已具备生成合理文本的能力,它由多层 Decoder 组成,经过前馈网络,最终输出Logits。

前馈网络内容详解:谁都能听懂的Transformer架构-前馈神经网络(FFN)

2. 构建奖励模型(右侧)

奖励模型的主干网络与SFT模型保持一致,直接复制其 Decoder 层。

不同之处在于 LM Head(语言建模头)被替换成 Reward Head:

    • 原LM Head为 Linear(hidden_size → vocab_size),用于输出词表大小的 logits;

    • 奖励模型中的 Reward Head 为 Linear(hidden_size → out_dim = 1),即输出一个标量,用于表示整句话的好坏(奖励得分)。

二、奖励模型的训练流程

图片

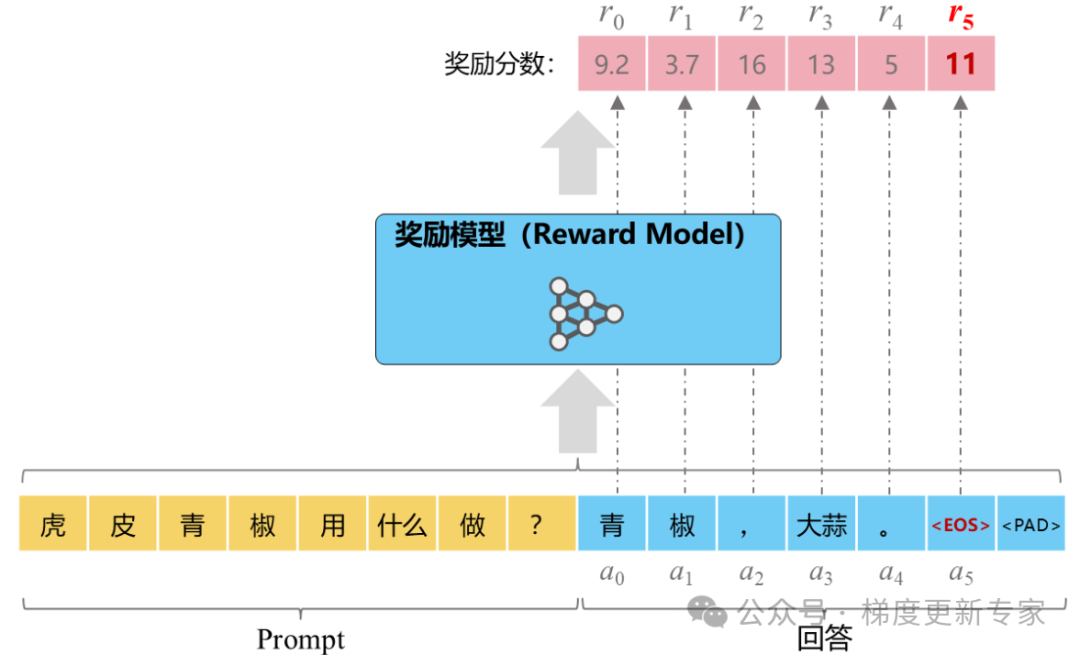
图2,展示了奖励模型在具体训练中的应用流程,以下是关键步骤:

1. 构造训练数据:Prompt + 多个回答

给定一个用户输入(Prompt),如“虎皮青椒用什么做?。

收集多个模型生成的回答(a₀ 到 a₅),这些回答风格、准确度、逻辑性可能有所差异。

2. 人类反馈打分

每个回答都由人工或策略生成一个奖励得分(r₀ ~ r₅)。

可以是绝对分数,也可以是相对排序。

3. 输入模型,输出奖励值

每个Prompt + 回答被喂入奖励模型。

奖励模型输出一个标量分数,用于回归/分类学习。

如图所示,每个回答产生一个对应的奖励分数,如 r₀=9.2、r₅=11 等。

4. 损失函数训练

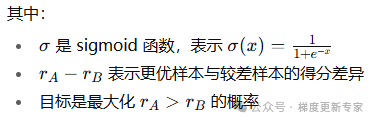
通常使用 Pairwise Loss(一种损失函数):

图片

图片

如果 rA≫rB  即好回答得分远高于差回答,loss 趋近于 0(模型判断正确,损失很小)

如果 rA≤rB   loss 趋近于最大值(模型判断错误,被惩罚)

Pairwise Loss一种常用于训练排序模型或奖励模型的损失函数,表示鼓励模型输出更高的分数给更优的回答。若使用标注的绝对分数,也可用 MSE 或 MAE 等回归损失

import torchimport torch.nn.functional as F
def pairwise_loss(r_chosen, r_rejected):    return -F.logsigmoid(r_chosen - r_rejected).mean()

三、奖励模型的作用

训练好的奖励模型有两个核心用途:

排序生成结果
  • 多个候选回答中,选择得分最高的作为最终输出。

用于RLHF中的强化学习阶段
  • 奖励模型作为环境,评价策略模型输出的优劣。

  • PPO、DPO等算法用其生成奖励信号,反向更新策略模型权重。

四、代码展示​​​​​​​

#RewardModelimport torchimport torch.nn as nn
class RewardModel(nn.Module):    def __init__(self, base_model, hidden_size):        super(RewardModel, self).__init__()        self.base_model = base_model  # 可以是一个已经微调过的Transformer模型(如GPT、LLaMA等)        self.reward_head = nn.Linear(hidden_size, 1)  # 输出一个标量奖励值
    def forward(self, input_ids, attention_mask):        # 获取 hidden states(通常取最后一层)        outputs = self.base_model(input_ids=input_ids, attention_mask=attention_mask, output_hidden_states=True)        hidden_states = outputs.hidden_states[-1]  # (batch_size, seq_len, hidden_size)
        # 取 <EOS> 前的 token 的 hidden state 作为 summary        rewards = []        for i in range(input_ids.shape[0]):            seq_len = attention_mask[i].sum() - 1  # 找到最后一个非PAD token            final_hidden = hidden_states[i, seq_len, :]  # (hidden_size,)            reward = self.reward_head(final_hidden)  # (1,)            rewards.append(reward)
        return torch.stack(rewards).squeeze(-1)  # (batch_size,)
​​​​​​
#Pairwise Loss 函数import torch.nn.functional as F
def pairwise_loss(r_chosen, r_rejected):    # r_chosen: 模型认为更好的回答的 reward    # r_rejected: 模型认为更差的回答的 reward    return -F.logsigmoid(r_chosen - r_rejected).mean()
​​​
#训练举例# 模拟训练过程reward_model = RewardModel(base_model=your_pretrained_model, hidden_size=hidden_size)optimizer = torch.optim.Adam(reward_model.parameters(), lr=1e-5)
for batch in dataloader:    chosen_input_ids = batch["chosen_input_ids"]    rejected_input_ids = batch["rejected_input_ids"]    chosen_mask = batch["chosen_attention_mask"]    rejected_mask = batch["rejected_attention_mask"]
    # 正向传播得到两个回答的 reward 分数    r_chosen = reward_model(chosen_input_ids, chosen_mask)     # (batch_size,)    r_rejected = reward_model(rejected_input_ids, rejected_mask) # (batch_size,)
    # 计算 pairwise loss    loss = pairwise_loss(r_chosen, r_rejected)
    # 反向传播与优化    optimizer.zero_grad()    loss.backward()    optimizer.step()

 我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

RM奖励模型 本篇将介绍InstructGPT的RM过程,也就是reward model的训练,废话不多说,直接上干货。 阅读详情

相关推荐

大模型对齐技术中的奖励模型训练

在大型语言模型(LLM)的对齐技术中,奖励模型(Reward Model, RM)扮演着至关重要的角色。其核心功能是将抽象、主观的人类偏好转化为机器可以理解和利用的数值信号,从而指导策略模型(通常是LLM本身)的优化方向 [[4,22]]。一个典型的RLHF(Reinforcement Learning from Human Feedback)流程通常包含三个阶段:首先是监督微调(SFT),使模型初步掌握指令遵循能力;其次是RM训练,它学习并泛化人类的判断标准;

FantasticOrange的博客 1088

大模型强化学习之奖励模型的训练

详细讲述了如何根据InstructGPT论文来实现一个奖励模型

6185

人工智能LLM模型: 奖励模型的探究

奖励模型是强化学习的一种机制,它为智能体的每个行为提供“评分”。这些评分起到了类似奖励和惩罚的作用,以帮助智能体在任务中逐渐选择最优的行为策略。与人类一样,智能体也需要反馈来改善行为,而奖励模型的分数就成了它们“如何做得更好”的依据。在自然语言处理(NLP)等领域,奖励模型常用于人类反馈强化学习(RLHF),例如指导聊天机器人更自然地回应、生成更连贯的文本,或提升机器翻译的准确性。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 605

彻底搞懂大模型 LLM的构建流程(二)奖励建模(Reward Modeling)、强化学习(Reinforcement Learning)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

m0_56255097的博客 5711

从零到一:RV1126与IMX415的硬件交响曲——深入解析Linux IPC摄像头的硬件调试艺术

本文深入解析了RV1126与IMX415组合的Linux IPC摄像头硬件调试技术,涵盖硬件接口检查、设备树配置、驱动加载验证及ISP调优等关键步骤。通过详细的操作指南和常见问题解决方案,帮助开发者快速掌握摄像头调试技巧,提升开发效率。

weixin_29161785的博客 978

SecureCRT 9.0最新版安装与激活全攻略(附驱动识别技巧)

本文提供SecureCRT 9.0最新版的详细安装与激活指南,并重点解析了嵌入式开发中串口连接的硬件驱动识别技巧。内容涵盖从安全获取软件、解决USB转串口驱动兼容性问题,到配置SSH与串口会话的完整流程,旨在帮助开发者和工程师高效部署并精通使用这款终端仿真利器。

star的博客 410

一图秒懂大模型:如何训练一个奖励模型

在大语言模型(LLM)训练中,奖励模型(Reward Model, RM)是实现人类反馈强化学习(RLHF)核心组件之一。本文结合两幅图,详细介绍奖励模型的结构、训练过程及其作用机制。

2301_81888214的博客 710

RV1126平台librga图像旋转裁剪实战

本文详细介绍了在rv1126平台上使用librga库实现图像旋转和裁剪的方法。首先解释了librga的基本概念和关键对象,包括源图像、目标图像和操作参数。随后分步骤说明了初始化设置、缓冲区创建、裁剪区域定义(通过坐标和尺寸参数)以及旋转操作(支持常见角度)。提供了完整的示例代码演示如何组合裁剪和旋转操作,并强调了性能优化、错误处理、格式支持等注意事项。通过硬件加速的librga,可以在rv1126平台上高效完成图像处理任务。

hwmxrhx的博客 1543

大模型训练揭秘:一图秒懂奖励模型的工作原理!(含完整代码)你也能自己做一个奖励模型!

本文介绍了大语言模型训练中的奖励模型(RM)结构及其应用。奖励模型通过复制SFT模型的主干网络,将语言建模头替换为输出标量奖励值的RewardHead。训练时,使用Prompt和多个回答作为输入,通过人工评分数据训练模型,常用PairwiseLoss损失函数。训练好的奖励模型可用于排序生成结果和强化学习阶段的反馈信号。文中还提供了RewardModel和PairwiseLoss的代码实现,并概述了大模型学习路线,包括系统设计、提示词工程、平台应用开发等内容。

m0_63171455的博客 1436

关于DHCP Option60的认识

<br />       最近在网络建设过程中,必须面对一个实际存在的问题:当只有一根线入户时,该如何解决CATV和宽带业务的共存呢?这时就要考虑用到DHCP Option60了,那么DHCP Option60到底是如何来实现业务区分的呢?<br />首先先来看下DHCP协议,在DHCP协议中,定义了一个option字段,该字段主要是用来扩展DHCP协议的,Option 60 (Vendor class identifier)是DHCP报文中的一个选项字段,code为60,可以标识终端类型,根据不同的终

luoyingchuan的专栏 7940

SpringBoot SSE避坑指南:当客户端突然断开时服务端SseEmitter的正确回收姿势

本文深入探讨了SpringBoot中SSE连接的生命周期管理,特别是客户端主动断开连接时服务端SseEmitter的正确回收机制。文章重点分析了客户端调用eventSource.cancel()等场景下,如何利用onCompletion()回调进行可靠的资源清理,避免内存泄漏,并提供了防御式编程策略和实战优化建议。

mm9012的博客 778

大模型训练流程(三)奖励模型

入门大模型训练的第三步:训练奖励模型

qq_43243579的博客 1万+

Qt5+OSG实战:如何用osgQOpenGLWidget在窗口中加载3D模型(附完整代码)

本文详细解析了如何在Qt5中使用osgQOpenGLWidget加载和渲染3D模型,涵盖环境配置、核心架构、性能优化及高级技巧。通过实战案例和完整代码,帮助开发者实现工业级3D模型渲染,提升Qt与OSG的整合效率。

weixin_42741930的博客 263

从零开始训练大模型全面指南:预训练、指令微调、奖励模型、强化学习

从零开始训练大模型全面指南:预训练、指令微调、奖励模型、强化学习

大模型训练 6246

FFmpeg 开发(14):Android FFmpeg + MediaCodec 实现视频硬解码

MediaCodec 是 Android 提供的用于对音视频进行编解码的类,它通过访问底层的 codec 来实现编解码的功能,是 Android media 基础框架的一部分,通常和 MediaExtractor, MediaSync, MediaMuxer, MediaCrypto, MediaDrm, Image, Surface和AudioTrack 一起使用。

字节流动 3万+

【AI智能体】Codex 高级进阶使用技巧项目实战操作详解

Codex 高级进阶使用技巧项目实战操作详解

congge 1万+

大模型智能体训练流程,大模型入门到精通,收藏这篇就足够了!

AgentTuning 就像是给大模型加上了一门“实操训练课”,不仅能解题,还能在更接近真实世界的环境里完成任务。

瓦罗兰特顶级C位的博客 1813

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

大模型如何训练?大模型入门到精通教程,收藏这篇就够了

距离上次写技术贴已经1年有余,这一年当中算法技术的发展可以说是日新月异。今天和大家聊聊大模型的训练的三个阶段,分别为有监督学习(SFT)、奖励模型训练(RW)与强化学习(PPO)阶段,我对以上的训练过程会加上一些自己的理解。GPT使用Transformer decoder部分作为语言模型的框架,并将decoder中的Multi-head Attention层删除,其结构和计算过程如上图。

Python_0011的博客 1329

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

聊聊大模型微调训练全流程的思考,零基础入门到精通,看这篇就够了!赶紧收藏!

对于模型的微调,一开始我是想的太简单了,觉得只要按照基座官方模型文档调试即可;随着了解的深入与不断的学习,微调是个大工程而且对于领域模型来说,其训练流程:预训练 --> 监督微调 --> RHLF 中包含的事项与知识太多。

Java癫疯的博客 1319

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

大模型如何训练?(非常详细)从零基础入门到精通,收藏这篇就够了

距离上次写技术贴已经1年有余,这一年当中算法技术的发展可以说是日新月异。今天和大家聊聊大模型的训练的三个阶段,分别为有监督学习(SFT)、奖励模型训练(RW)与强化学习(PPO)阶段,我对以上的训练过程会加上一些自己的理解。GPT使用Transformer decoder部分作为语言模型的框架,并将decoder中的Multi-head Attention层删除,其结构和计算过程如上图。

Libra1313的博客 1432

大模型的训练过程解析(非常详细)零基础入门到精通,收藏这一篇就够了

今天和大家聊聊大模型的训练的三个阶段,分别为有监督学习(SFT)、奖励模型训练(RW)与强化学习(PPO)阶段,我对以上的训练过程会加上一些自己的理解。GPT使用Transformer decoder部分作为语言模型的框架,并将decoder中的Multi-head Attention层删除,其结构和计算过程如上图。

logic1001的博客 4776

从数据、训练到部署的全面梳理,大模型入门到精通,收藏这篇就足够了!

随着人工智能技术迅猛发展,大模型(如GPT-4、文心一言等)正逐步渗透至社会生活的各个领域,从医疗、教育到金融、政务,其影响力与日俱增。

2301_81940605的博客 950

如何训练一个大模型(非常详细)零基础入门到精通,收藏这一篇就够了

本篇我们根据Andrej Karpathy(安德烈·卡帕西)的专题演讲《State of GPT》来介绍GPT如何从“初始模型”(base model)一直训练成ChatGPT这样的“助手模型”(assistant model)。Andrej Karpathy是OpenAI的创始人之一,也是GPT大模型训练这个领域最有话语权的人之一,建议大家去看一下大佬的演讲视频(https://www.bilibili.com/video/BV1ts4y1T7UH)。

leah126的博客 2654

大模型训练必知的Qwen3训练经验,大模型入门到精通,收藏这篇就足够了!

大模型训练必知的Qwen3训练经验,大模型入门到精通,收藏这篇就足够了!

huang9604的博客 1039

AI大模型系列:LLaMA-Factory大模型微调,零基础微调大模型,收藏这篇就足够了

本次将详细介绍如何使用LLaMA-Factory从零开始微调大模型,帮助大家快速掌握这一技能。

huang9604的博客 1914

奖励模型怎么训练出来的?一张图带你快速掌握大模型关键步骤

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

2401_85373691的博客 836
上一篇: 用基于Qwen-2.5-7B的Code Agent打造本地、开源的Multi-Agent RAG系统,零基础入门大模型,收藏这一篇就足够了
下一篇: 从零搭建迪士尼客服 RAG 系统:小白也能学会的 3 步实操指南
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值