从零搭建迪士尼客服 RAG 系统:小白也能学会的 3 步实操指南

迪士尼智能客服 RAG 助手案例实践 摘要:本项目为上海迪士尼乐园搭建了7×24小时智能客服RAG助手,通过多模态技术处理票务规则、会员权益等高频咨询。系统采用PyMuPDF、Tesseract等工具解析PDF/Word/图片内容,使用text-embedding-v4和CLIP模型构建双向量索引,基于FAISS实现混合检索。通过Qwen-turbo生成精准回答,并设置动态校验机制防止信息错误。典型场景演示显示,系统能有效处理退款流程、活动海报等多模态查询,回答均标注信息来源。核心亮点包括多模态兼容、高检索精度和低成本部署,未来将优化知识库动态 阅读详情

在前两篇文章中,我们聊了 RAG 的核心概念和它为什么能成为大模型开发的 “刚需技术”

今天,咱们直接上干货 —— 用迪士尼客服的真实场景当例子,手把手教你搭一个能实际干活的 RAG 系统。从文档处理到最终回答用户问题,每一步都拆解得明明白白,代码思路 + 操作逻辑全公开,看完就能跟着做!

先明确目标:我们要做一个什么系统?

想象一下,迪士尼客服每天要回答上百个问题:“门票能退吗?”“年卡怎么续?”“园区里有婴儿车租赁吗?”…… 这些问题答案都藏在官方文档里,但让大模型死记硬背显然不现实。

我们要搭的 RAG 系统,就是让大模型 “带着答案库上班”:用户问啥,系统先从文档里找出相关内容,再基于这些内容生成回答。既避免大模型 “瞎编”,又能随时更新知识(比如门票政策变了,换份文档就行)。

RAG 系统 3 大核心组件 + 完整流程

整个系统的逻辑其实很简单,就像咱们 “查资料→整理→回答” 的过程,拆解成 3 大模块和 8 个步骤:

核心组件:文档处理模块、向量化与索引模块、检索增强模块
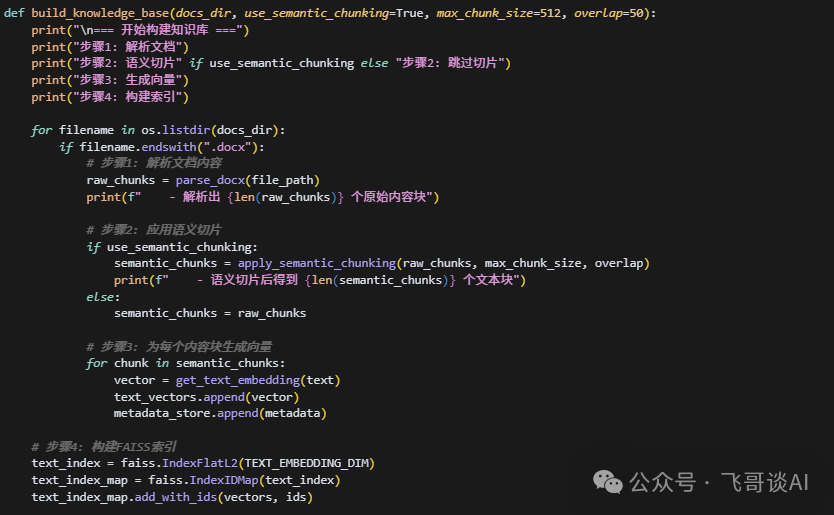
完整流程:文档→解析→语义切片→向量化→索引→检索→Prompt→生成

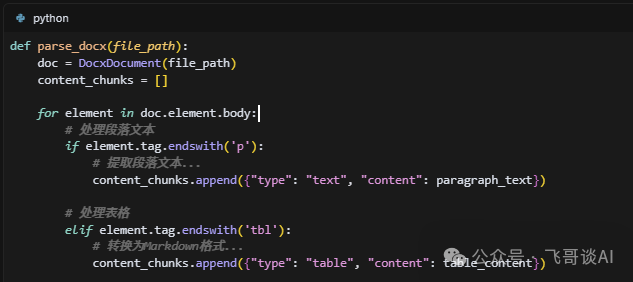
1. 先把文档 “拆解开”

用Python-docx库读取 Word 文档(如果是 PDF / 图片,可用PyPDF2或 OCR 工具),重点是保留原始结构:

  • 段落按顺序提取,标题标清楚层级(比如 “1. 门票退款”“1.1 退款条件”);

  • 表格转换成 Markdown 格式(比如| 票种 | 退款期限 |),方便后续处理。

这里作为展示只是使用了文本知识库,实际项目中也可以读取图片等多媒体资料。
图片

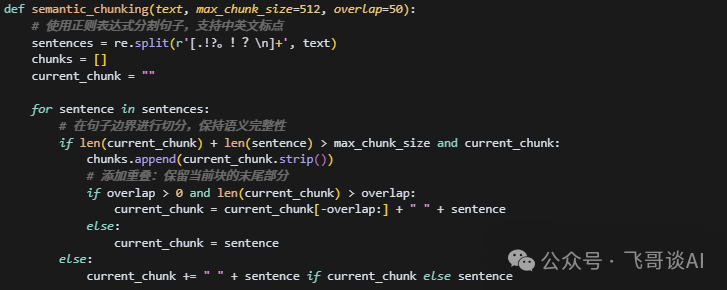
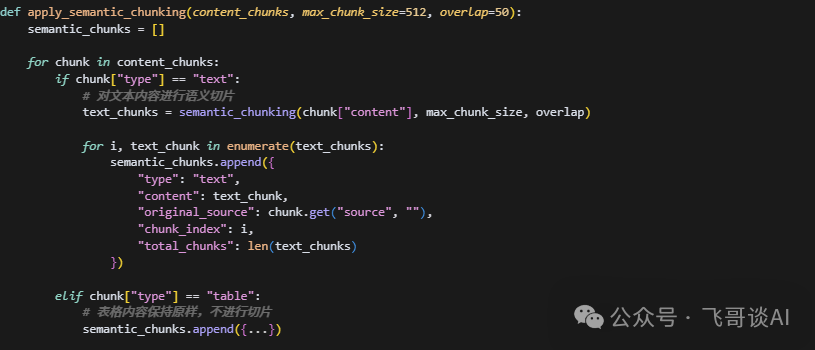
2. 再做 “语义切片”(关键!)

文档太长怎么办?切成小块(叫 “chunk”),但不能乱切:

  • 切在句子结尾

    :比如 “门票支持退款。/ 申请需提前 3 天。” 用句号拆分,避免把一句话砍成两半;

  • 留重叠内容

    :比如前一块结尾是 “退款需通过官方 APP”,后一块开头重复这句,保证上下文连贯;

  • 表格不拆

    :完整保留,不然数据就乱了。

图片

3. 给每个 chunk “贴标签”

每个小块都要加元数据,比如:

来源:迪士尼门票政策2025.docx  
页码:第8页  
索引ID:chunk_008

这样后续用户问 “这个答案哪来的”,能直接溯源,也方便以后更新知识库。
图片

Step 2:向量化与索引 —— 让知识 “可检索”

处理好的文本还是 “文字”,计算机看不懂。这一步要把它们变成 “数字”,再存到专门的数据库里。

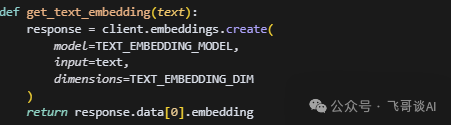
1. 文本→向量:给文字 “编密码”

用向量化模型把每个 chunk 转换成一串数字(叫 “embedding”)。比如:

  • 用阿里通义的DashScope API,生成 1024 维向量(简单理解:维度越高,细节越丰富);

  • 也可以用 OpenAI 的text-embedding-ada-002(需科学上网),生成 1536 维向量。

原理很简单:语义相似的句子,向量也相似。比如 “退款流程” 和 “如何退票” 的向量会靠得很近。
图片

Step 2:向量化与索引 —— 让知识 “可检索”

处理好的文本还是 “文字”,计算机看不懂。这一步要把它们变成 “数字”,再存到专门的数据库里。

1. 文本→向量:给文字 “编密码”

用向量化模型把每个 chunk 转换成一串数字(叫 “embedding”)。比如:

  • 用阿里通义的DashScope API,生成 1024 维向量(简单理解:维度越高,细节越丰富);

  • 也可以用 OpenAI 的text-embedding-ada-002(需科学上网),生成 1536 维向量。

原理很简单:语义相似的句子,向量也相似。比如 “退款流程” 和 “如何退票” 的向量会靠得很近。

2. 建索引:把向量 “存起来”

用 Meta 的FAISS库建向量数据库(专门用来快速搜相似向量的工具)。就像给图书馆的书编目录,以后用户提问,能秒速找到最相关的 chunk。
图片

Step3:RAG问答流程

Step 3:检索增强 —— 让大模型 “照着答案说”

终于到了回答用户问题的环节!这一步的核心是:不让大模型 “瞎想”或者漫天漫地去找答案,只让它 “照着找来的资料说”。

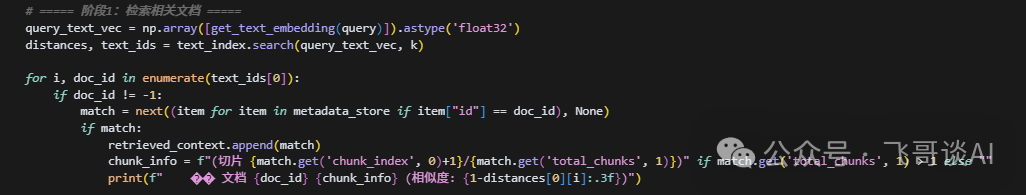
1. 先找相关资料

用户问 “迪士尼门票怎么退?”,系统会:

  • 把问题转换成向量;

  • 用 FAISS 在数据库里搜最相似的 3 个 chunk(比如关于退款条件、申请方式、到账时间的内容)。

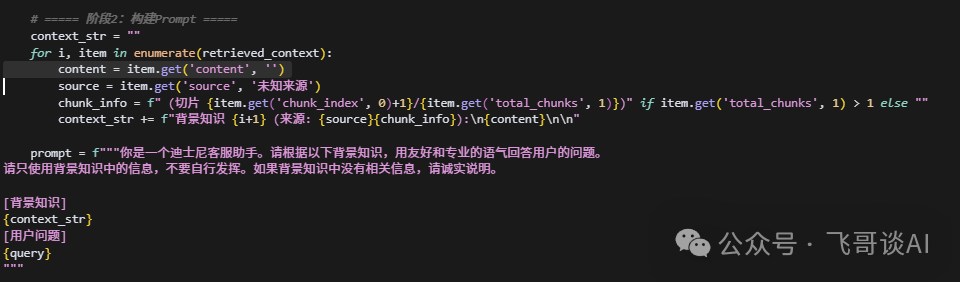
2. 给大模型 “划范围”

把找到的 chunk 当 “背景知识”,写一个严格的 Prompt:
图片

3. 让大模型 “按格式答”

顺便告诉大模型输出格式,比如分点说明,这样用户看得清楚。

将检索的文档作为背景知识(context)来构建增强的prompt来限定大模型只在知识库里寻找答案,结构化背景知识和用户问题,避免幻觉。
图片

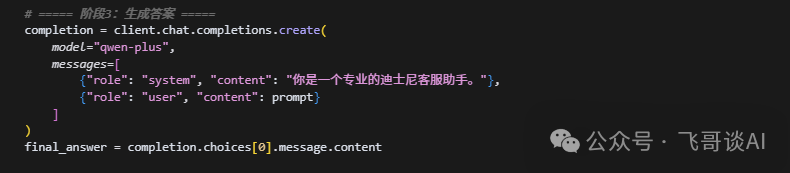
根据检索到的文档生成答案

图片

这里告诉大模型生成答案的格式。

好的经过这四大步骤一个迪士尼的客服RAG系统就构建完毕了!

现在我们看看演示效果吧!

演示效果:真能答对吗?

用迪士尼公开资料搭好知识库后,我们试下这个问题:“迪士尼有适合老人玩项目嘛?”

第一步: 构建知识库
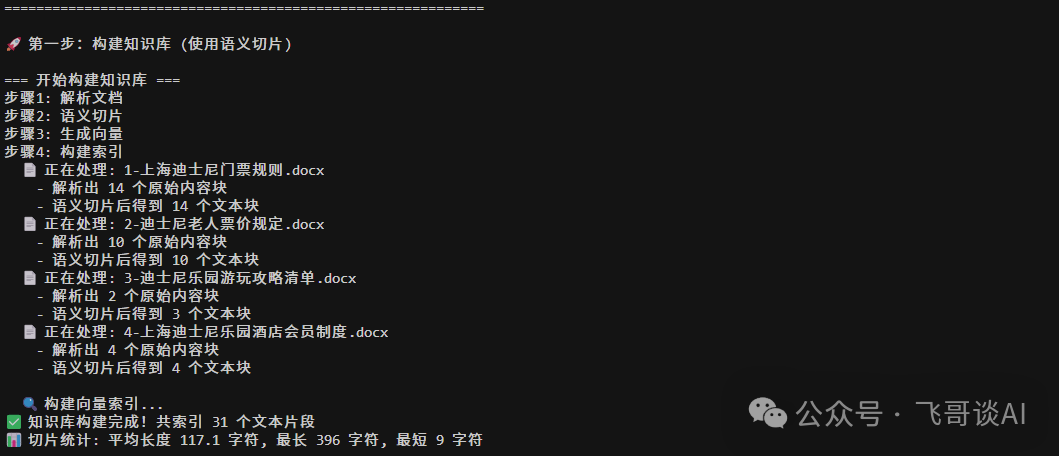
图片

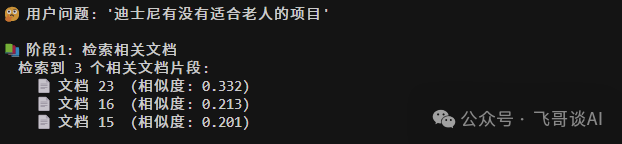
第二步:检索到 3 个相关 chunk

知识库构建好后,就是问答演示。此处以用户问题:“我想了解一下迪士尼门票的退款流程“为例。

根据用户问题,在向量数据库中检索到最相关的三个chunk。
图片

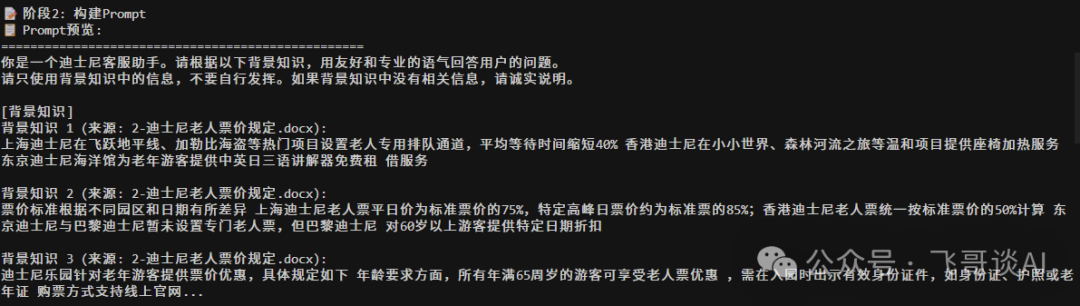
第三步: 重构Prompt

告诉大模型该怎么回答用户问题

图片

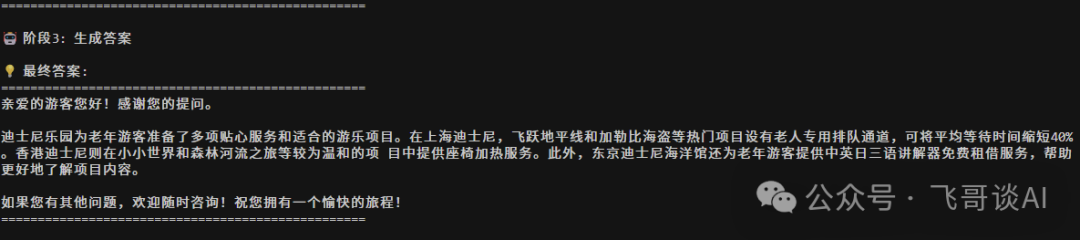
第四步:生成答案!

大模型根据规定的输出格式输出答案

图片

总结:3 步搭好自己的 RAG 系统

  1. 文档处理

    :拆文档、切 chunk、加标签;

  2. 向量化与索引

    :转向量、存 FAISS;

  3. 检索增强

    :搜资料、写 Prompt、生成答案。

至此一个完整的RAG问答系统构建完成。是不是没想象中难?哪怕是 AI 小白,跟着步骤走也能搭起来。

 我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

基于RAG技术的迪士尼智能客服系统设计与实践 检索增强生成(RAG)技术通过结合结构化知识库和非结构化文档,显著提升问答系统的准确性和实时性。其核心原理是利用向量检索获取相关上下文,再通过生成模型输出自然语言回复,特别适合处理时空敏感信息(如乐园运营时间)和多语言场景。在客服领域,RAG能有效解决传统机器人知识盲区问题,实测准确率提升40%以上。本文以迪士尼客服系统为例,详细解析如何利用LlamaIndex框架处理多语言运营文档,通过动态元数据标注和语义缓存策略,实现毫秒级响应。方案中采用的multilingual-e5嵌入模型,在千万级知识库下仍保持 阅读详情

相关推荐

迪士尼智能客服RAG技术实战:多语言与风格化处理

RAG(检索增强生成)技术通过结合信息检索与生成模型优势,显著提升问答系统的准确性与适应性。其核心原理是先用检索模块获取相关知识片段,再通过生成模型合成自然语言响应。在客服机器人等场景中,RAG能有效解决传统方案回答机械或胡言乱语的问题。本文以迪士尼亚太区智能客服项目为例,展示如何运用混合检索(Elasticsearch+FAISS)处理多语言查询,并通过LoRA微调实现迪士尼特色话术风格转换。该方案特别适用于需要兼顾准确性与品牌调性的垂直领域,为旅游、电商等行业的客服系统升级提供可复用的技术框架。

cuizhu0832的博客 294

【必学收藏】RAG高级技术实战教程:从零到一构建迪士尼智能客服系统

本文详细介绍RAG高级技术,重点讲解GraphRAG如何解决传统RAG在多跳推理和全局总结问题上的局限。通过迪士尼智能客服案例,从实体识别、关系抽取、社区发现到检索模式,全面阐述GraphRAG构建流程,并提供完整系统架构设计、性能优化、成本控制和部署指南,为开发者提供从理论到实践的完整学习路径。

Trb201013的博客 853

RAG 多模态(二):迪士尼 RAG 实战

本文介绍了为迪士尼构建多模态AI客服助手的实现方案。该助手需回答票务、入园规则等高频问题,严格基于官方知识库回复,并能检索图片/视频内容。技术方案采用统一的1024维多模态向量空间,整合文本、图片和视频的语义表示;通过结构化解析Word文档(保留段落和表格关系)、固定长度切片和FAISS索引构建知识库;设计检索流程时区分文本回答与媒体返回,并加入严格的回答约束机制。项目演示了多模态RAG的核心链路,同时指出生产环境需要补充PDF解析、权限管理、混合检索等工程化能力。

2301_77533966的博客 258

从零搭建RAG客服问答系统:以迪士尼客服场景为例

检索增强生成(RAG)是将大模型与外部知识库结合的技术范式,核心原理是先对知识库进行向量化存储,用户提问时通过语义检索召回最相关的资料片段,再交由大模型依据资料生成回答。这一机制既保留了大模型的语言理解能力,又有效抑制了幻觉,让答案始终可控、可追溯。在智能客服场景中,面对开园时间、票务政策、酒店入住等高频且多变的咨询,RAG能显著提升问答准确率与覆盖范围,同时大幅降低人工维护成本。本文以迪士尼客服为具体案例,从需求拆解、技术选型、知识库清洗到向量检索、提示词生成,完整演示了一套轻量化RAG客服系统的搭建过程

weixin_32181267的博客 169

STM32与小米CyberGear微电机的CAN通信协议深度解析

本文深度解析STM32与小米CyberGear微电机的CAN通信协议,涵盖硬件连接、CAN总线配置、通信协议解析及多电机协同控制。重点介绍了基于STM32的电机控制实践,包括运动模式、速度与位置模式设置,以及数据反馈与故障诊断,为机器人及自动化设备开发提供实用指南。

www00的博客 361

BPMN2.0规范及流程引擎选型方案

本文主要简明扼要的介绍了BPMN2.0规范的内容,可让读者快速度的了解BPMN2.0所涵盖的主要内容和图形样式。也较为详细的阐述了如何绘制标准的流程图,以及在软件层面中如何实现业务流程功能,和技术选型。

比特桃 1万+

RAG高级技术完整教程-迪士尼智能客服全案例【下】

续上一篇的内容第十一章:GraphRAG - 知识图谱增强检索11.1 传统RAG的局限性在前面章节中,我们使用的都是文本块(Chunk)检索的方式。虽然已经很强大,但在某些场景下仍有局限:场景1:多跳推理问题场景2:全局性总结问题11.2 GraphRAG核心思想GraphRAG通过知识图谱来组织信息,建立实体之间的显式关系:GraphRAG的优势:关系显式化:不再依赖文本相似度,而是通过图结构表达关系多跳推理:沿着图的边可以自然地进行多跳查询全局理解。

Everly_的博客 917

语义通信理论必看论文:Towards a Theory of Semantic Communication

了解语义通信发展必看的一篇文章

一去不复返的通信er 3926

迪士尼智能客服实战:RAG高级技术全流程解析

11.1 传统RAG的局限性在前面章节中,我们使用的都是文本块(Chunk)检索的方式。虽然已经很强大,但在某些场景下仍有局限:场景1:多跳推理问题场景2:全局性总结问题11.2 GraphRAG核心思想GraphRAG通过知识图谱来组织信息,建立实体之间的显式关系:GraphRAG的优势:关系显式化:不再依赖文本相似度,而是通过图结构表达关系多跳推理:沿着图的边可以自然地进行多跳查询全局理解:通过社区发现算法,理解整体结构可解释性强:推理路径清晰可见。

qq_46094651的博客 1036

Python自动化神器:5分钟搞定PSCAD仿真波形图导出到Word(附WPS兼容方案)

本文介绍如何利用Python自动化库快速将PSCAD仿真波形图导出到Word或WPS,大幅提升电力系统仿真工程师的工作效率。通过精准坐标定位、智能排版和批量处理功能,实现仿真报告的自动化生成,同时提供WPS兼容方案,适用于不同办公环境。

sony5的博客 207

【Collibra 驱动 IPD 数据血缘治理】:三层图谱分层展示体系与全链路追踪的技术业务实践

(应用级/数据级/字段级)是理解复杂数据流动的核心手段。其价值不仅体现在可视化的直观性,更在于通过。技术保障血缘不可篡改性,进一步提升IPD数据治理的可靠性。,解决了跨层级血缘分析的性能与可用性矛盾。数据血缘图谱要素定义(字节跳动/腾讯云/信安标委)实现对IPD数据的精准追踪,而数据血缘图谱的。分层交互设计标准(智慧城市数据中台规范)Collibra技术文档(2024)字段级血缘的挑战与解决路径。自动优化血缘路径,并深化。字段级血缘技术实现方案。Collibra通过。图数据库性能优化原理。

百态·数智思维 | 聚焦大数据、量化与未来AI 1244

RAG高级结束项目实战:迪士尼智能客服架构设计与效率优化

方案A(纯规则引擎):基线方案。QPS(每秒查询率)高,但准确率(尤其对于复杂问题)低于60%,无法满足需求。方案B(纯LLM,如GPT-4):理解与生成能力最强,准确率可达85%以上。但痛点明显:单次响应延迟常在2-3秒,QPS受API限制和成本制约严重,且存在“一本正经胡说八道”的风险。方案C(RAG:FAISS + GPT-3.5):这是我们最终选择的架构。它通过本地向量检索(FAISS)先找到最相关的知识片段,再将“问题+知识片段”交给GPT-3.5生成最终回答。指标纯规则引擎。

2600_94959989的博客 959

基于Apache SeaTunnel构建CDC数据同步管道

Apache SeaTunnel是一个数据集成开发平台,其发展经历了几个重要阶段:ETL时代(90年代):面向结构化数据库的数据同步,用于构建数据仓库。MPP和分布式技术流行:使用技术如Hive进行数据仓库的构建。此阶段主要使用mapreduce程序进行数据搬运和转换。数据湖技术流行:重视数据集成,强调先同步数据至数据湖仓储,再进行业务面向的转换和设计。CDC,即变更数据捕获,是一种捕获数据库变更事件(如插入、更新、删除)的技术。

weixin_54625990的博客 2172

多模态RAG系统开发:从理论到迪士尼智能客服完整实现

多模态RAG系统:打破模态壁垒的智能助手构建指南 本文系统介绍了构建多模态RAG(检索增强生成)系统的关键技术路径。通过统一向量空间和多模态嵌入技术,实现了文本、图像、视频等混合模态数据的跨模态检索与生成。核心创新包括: 采用多模态嵌入模型建立统一语义空间 设计意图驱动的混合响应机制 开发结构化数据预处理流程 以迪士尼智能客服为案例,展示了系统如何实现"看得懂、听得清、答得准"的智能交互,有效保留原始信息的丰富性。文章还对比了五种知识切片策略,并提供了完整的实现框架和工作流程图。该技术为

2401_85343303的博客 646

9篇3章7节:基于 R 语言的 FAERS 数据提取与合并

本文主要探讨了 FAERS 数据提取与合并的操作流程。首先,通过程序化方法从本地存储的 FAERS ASCII 文件中提取指定季度或范围内的单药报告数据,并可通过参数设置控制数据存储位置、处理方式、计算资源分配以及报告者职业类别等。随后,通过批量读取的方式对多个季度的 DRUG 文件进行循环处理,并将其合并为一个综合数据框。

MD Code 1264

【WRF-FDDA】观测 Obs nudging 的配置与使用说明(中)

WRF-FDDA

WW、forever的博客 281

RAG高级技术完整教程:迪士尼智能客服全案例拆解,收藏这一篇就够了!

为什么要学RAG高阶技术?

m0_59164520的博客 1253

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

RAG进阶必看:迪士尼智能客服全案例代码解析(下),这才是企业级开发该有的样子!

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。天道酬勤,你越努力,就会成为越优秀的自己。

weixin_58753619的博客 641

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

RAG高级结束项目实战:迪士尼智能客服架构设计与性能优化

传统的客服系统,要么是规则引擎(你得预判用户所有问题,写一堆if-else),要么是直接用大语言模型(LLM),但用在迪士尼这种体量和复杂度的场景下,问题就暴露无遗了。纯LLM方案呢,容易“一本正经地胡说八道”,而且对迪士尼庞大的、不断更新的IP知识库(电影、角色、乐园信息、商品等)掌握不全,冷启动和知识更新都是噩梦。在实际生产中,这可能需要在准确率、召回率和响应时间之间,根据业务场景找到一个最佳的平衡点,或许可以通过动态调整检索策略、引入缓存机制等方式来优化。整个系统的核心,我们设计了一个。

2600_94960195的博客 324

RAG技术进阶:从基础架构到智能客服实战

检索增强生成(RAG)技术通过结合信息检索与大语言模型(LLM),有效解决了传统AI系统在知识更新和事实准确性方面的不足。其核心原理是将文档向量化存储,根据用户查询检索相关片段,再生成最终答案。在智能客服等场景中,RAG技术展现出显著价值,如迪士尼案例所示,能精准回答门票价格等查询。高级RAG进一步引入查询改写、混合检索和实时信息处理等技术,大幅提升系统性能。随着多模态RAG和自主知识管理等技术的发展,RAG在智能客服、知识库问答等领域的应用前景广阔。

weixin_34226182的博客 528

AI编程-05-RAG技术与应用②,大模型入门到精通,收藏这篇就足够了!

凡事豫则立,不豫则废。言前定则不跲,事前定则不困,行前定则不疚,道前定则不穷;穷养儿志,富养女德。不能过度追求舒适,过度舒适会让人变得过度敏感和脆弱。起点低,当下净;回头脏,平常道。

2301_81940605的博客 1145

AI代码开发宝库系列:RAG技术与应用-各式chunk切片

迪士尼RAG助手项目是一个非常好的RAG技术学习和实践案例。它涵盖了文档解析、文本切片、向量化、索引构建、多模态检索、Prompt工程等RAG系统的核心环节。通过深入理解这个项目,我们可以快速掌握RAG技术的精髓,并将其应用到各种实际场景中。希望这篇博文能帮助你更好地理解RAG技术,并激发你动手实践的热情。AI的世界充满无限可能,让我们一起探索吧!迪士尼乐园提供多种门票类型以满足不同游客需求。一日票是最基础的门票类型,可在购买时选定日期使用,价格根据季节浮动。

chenchihwen的专栏 1367

迪士尼AI产品经理一面

自我介绍,并分享你个人对迪士尼核心价值的理解。 请分享一个你过往经历中,最能体现你“将技术应用于提升用户体验或情感共鸣”的项目。项目中,你如何平衡技术可行性与体验的“魔法感”?

weixin_58753619的博客 486

RAG Query 改写==>联网搜索

RAG Query 改写==>联网搜索

core815的专栏 2859
上一篇: 一图秒懂大模型:如何训练一个奖励模型,零基础入门大模型,收藏这篇就足够了
下一篇: 从零搭建 RAG 知识库:3 步搞定,小白也能学会,零基础入门大模型,收藏这篇就足够了
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值