ollama 本地安装 embedding 模型

Ollama 下载Embedding模型并配置到Dify中(亲测) Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。 阅读详情
AI摘要

博客介绍了人工智能领域中LLM和Embedding模型的差异,Embedding模型可将文本转换为向量,用于文本相似度计算等。阐述了其典型应用流程,推荐了多种Embedding模型。重点讲解了本地安装Ollama提供的embedding模型的步骤,还分享了大模型学习资源和学习路线。

知识库领域的 LLM 大模型和 Embedding 大模型有区别么?为什么在 RAG 领域,需要单独设置 embedding 大模型? 

在人工智能领域,大型语言模型(LLM)和嵌入模型(Embedding Model)是自然语言处理(NLP)中的两大关键技术,尤其在知识库构建和信息检索中发挥着重要作用。 

尽管它们都属于 NLP 范畴,但它们在功能、应用场景和资源需求上存在显著差异。 

Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。 

Embedding 模型的输出是数值向量。计算机在理解词句含义的时候,是不具备能力的,计算机只能看到一段 01010111 这样的结果。然而,人类看到的词句,是赋予了内部的含义,还带了大量的普世认知。 

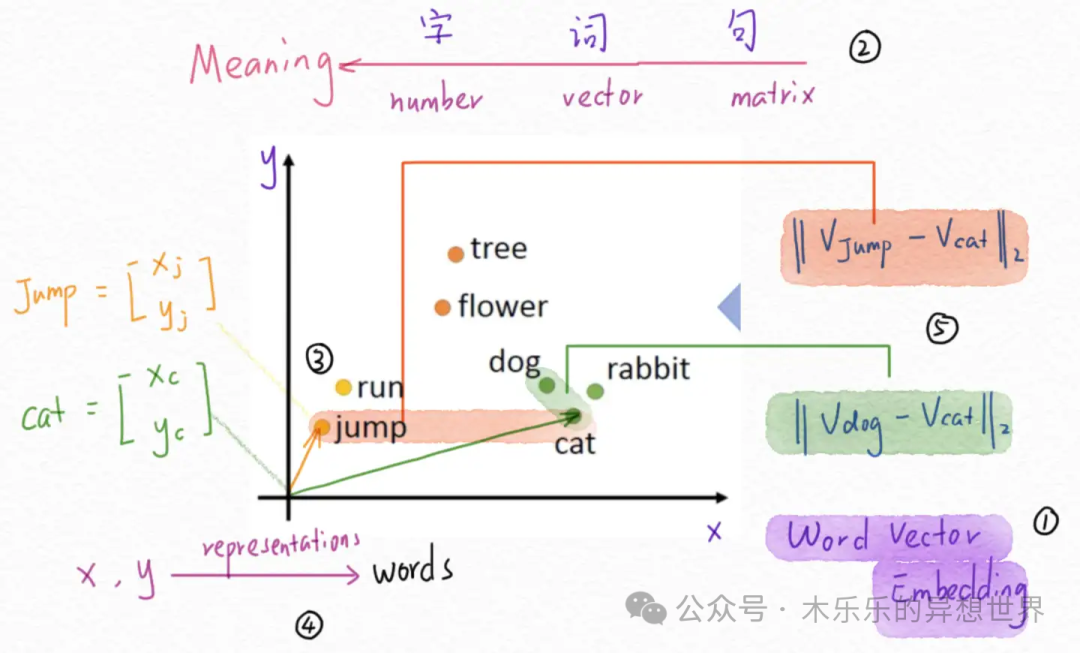
参考台大李宏毅老师的一张图,做一下说明。

当我们人类理解 猫 vs 狗 和 狗 vs 花的差异的时候,能自然的理解,觉得猫和狗是更加相近的物种;而狗和花,一个是动物,另一个是植物,偏差会更多。 
图片

那么,如何让计算机能理解这些词背后的含义呢。所使用的技术就是 Embedding。一句话简单说,embedding 就是把计算机无法理解的字词,转换成一个向量矩阵。

比较相似,或者含意比较接近的词向量之间的距离,是更加接近的。比如 dog 和 cat,dog 和 rabbit; 然而,flower 和 dog,就会隔得比较远。 


Embedding 模型广泛应用于文本相似度计算、信息检索、聚类和推荐系统。 


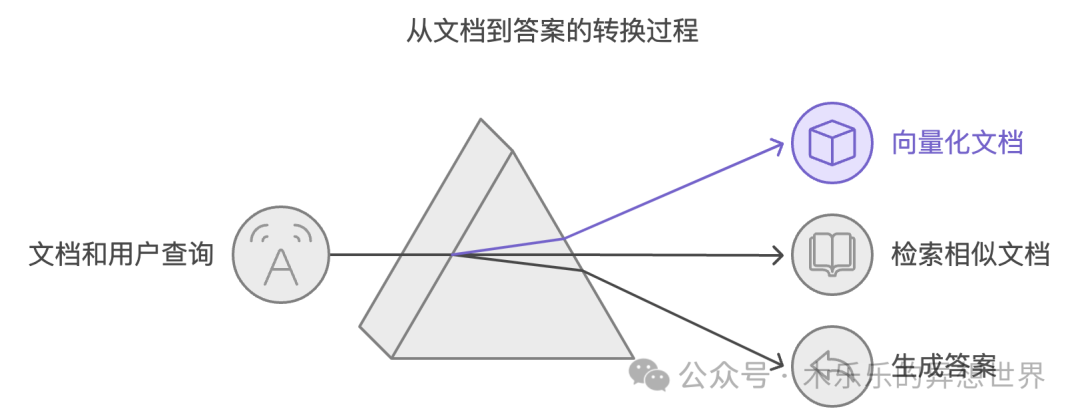
在大模型知识库领域中,单独设置 Embedding 模型可以降低系统资源占用和响应延迟,特别是在大规模知识库构建和信息检索中,可以极大程度提升经济型和效率。一般的应用包含以下几个部分: 

典型应用流程
图片

1. **知识库构建阶段** 

  • 使用Embedding模型将文档转换为向量,存储向量到向量数据库(如FAISS、Milvus)


2. **检索阶段** 

  • 用相同的Embedding模型将用户问题转换为向量,在向量数据库中快速检索相似文档


3. **回答生成阶段** 

  • 将检索到的相关文档作为上下文,使用LLM生成最终答案


推荐的Embedding模型

Crew.ai 官方组件支持的 Embedding 模型有: 

  • openai:OpenAI 的嵌入模型
  • google:Google 的文本嵌入模型
  • azure:Azure OpenAI 嵌入
  • ollama:使用 Ollama 进行局部嵌入
  • vertexai:Google Cloud VertexAI 嵌入
  • cohere:Cohere 的嵌入模型
  • 基岩版:AWS Bedrock 嵌入
  • huggingface: Hugging Face 模特
  • watson:IBM Watson 嵌入


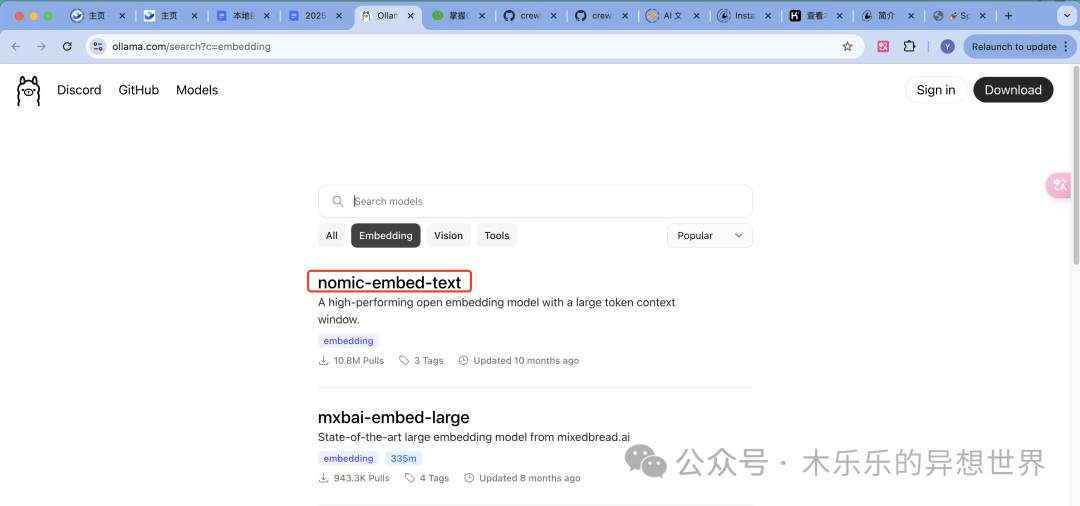
接下来,我们看一下如何在本地安装 Ollama 提供的 embedding 模型。本案例选用的是 nomic-embed-text。 

项目参考链接:https://ollama.com/search?c=embedding 
图片


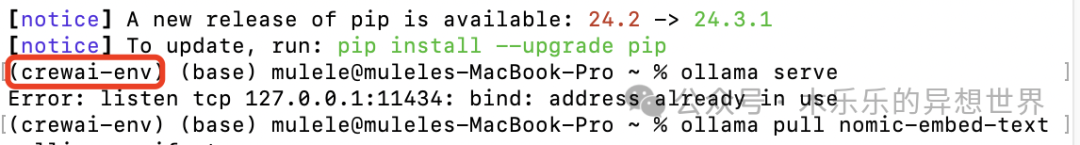
先激活对应的工作环境。 

source crewai-env/bin/activate

每次开始新的终端会话时,都需要重新激活虚拟环境。如果您看到命令提示符前面有 (crewai) 这样的标识,说明环境已经正确激活。 
图片

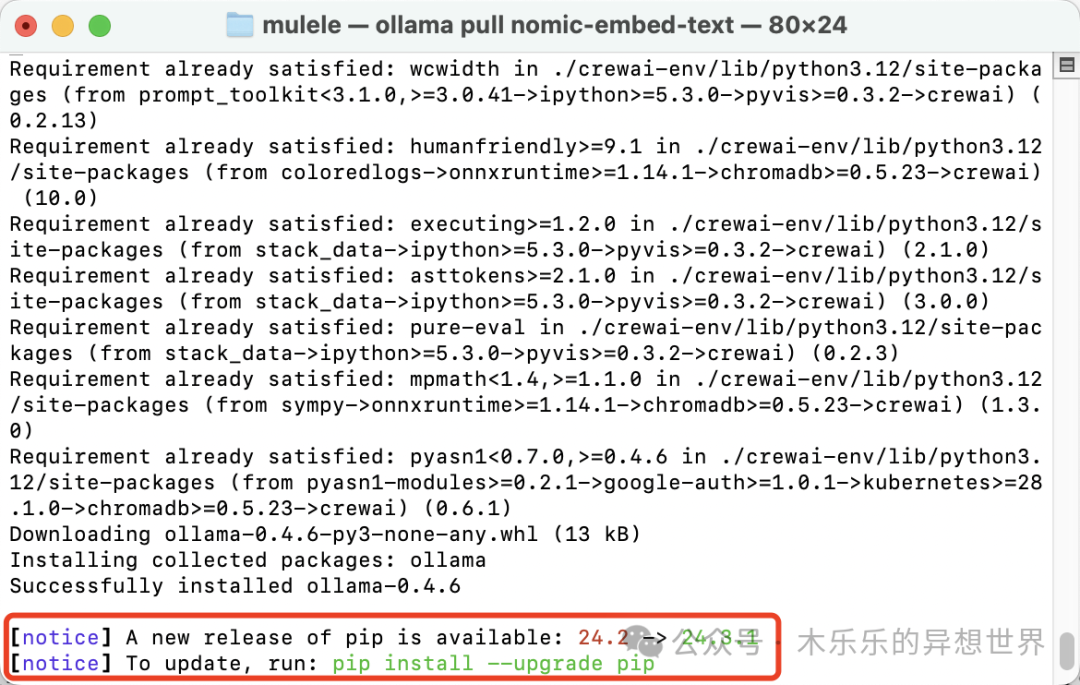
安装依赖 

pip install crewai ollama

看到这个代表已经激活 
图片

启动 ollama 

ollama serve


安装 embedding 模型 

ollama pull nomic-embed-text


因为要配置给其他的服务用,所以需要解决 Ollama 的 embedding host获取问题。 


要获取 Ollama 的 embedding host,有以下几种方法: 

默认地址: 

Ollama 默认运行在 http://localhost:11434。如果您是在本地机器上安装的 Ollama,通常不需要更改这个地址。 

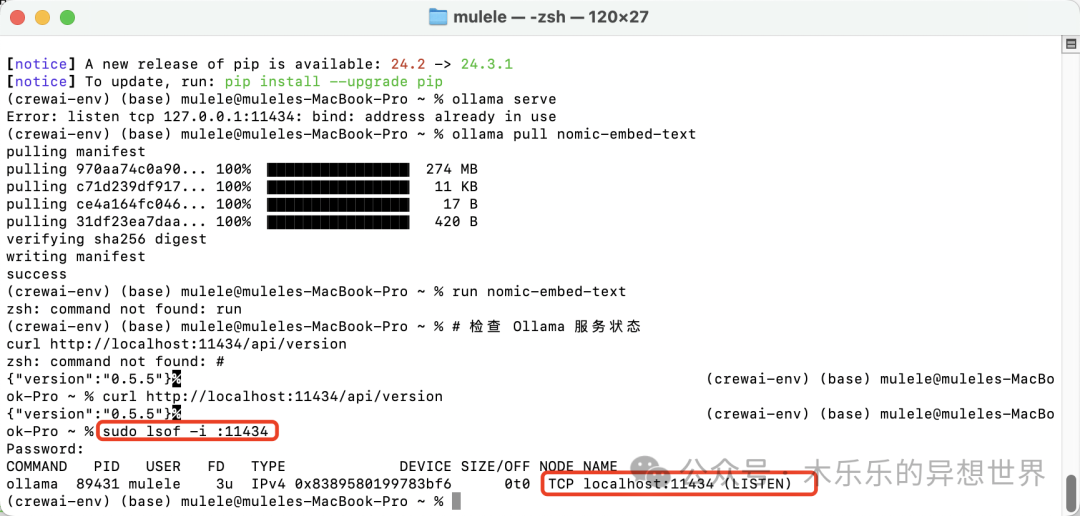
如果不确定是否这个端口,验证 Ollama 服务是否运行及其地址,可以按照这个方法执行。 


# 检查 Ollama 服务状态
curl http://localhost:11434/api/version
 

图片

看到 11434 的监听结果,说明这个端口就是 ollama 的embedding 模型开放的端口。 

到这一步,就代表着 ollama 的embedding 模型已经安装成功。可以对接给其他的应用和服务了。 

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

graphrag ollama在windows端上的本地部署(纯小白版) 用于新手计算机小白通过ollama在windows系统上的本地部署graphrag (不需要chatgpt的apikey,完全免费) 阅读详情

相关推荐

langchain学习笔记——Ollama大模型本地部署

大模型本地部署、大模型网关部署、快速构建一个带有知识库的问答系统

1624

Ollama 运行 Embedding 模型

Ollama 运行 Embedding 模型

engchina的专栏 1万+

Embedding models

嵌入模型是专门训练以生成向量嵌入的模型:这些是代表给定文本序列语义含义的长数组:生成的向量嵌入数组可以存储在数据库中,该数据库会进行比较以搜索语义相似的数据。

数字人生 2056

Ollama本地安装与Embedding模型配置指南!

知识库领域的 LLM 大模型和 Embedding 大模型有区别么?为什么在 RAG 领域,需要单独设置 embedding 大模型?在人工智能领域,大型语言模型(LLM)和嵌入模型(Embedding Model)是自然语言处理(NLP)中的两大关键技术,尤其在知识库构建和信息检索中发挥着重要作用。尽管它们都属于 NLP 范畴,但它们在功能、应用场景和资源需求上存在显著差异。Embedding 模型的主要任务是将文本转换为数值向量表示。这些向量可以用于计算文本之间的相似度、进行信息检索和聚类分析。

2401_84204207的博客 1万+

5.2.2、【AI技术新纪元:Spring AI解码】Ollama Embeddings

使用Ollama,你可以在本地运行各种大型语言模型(LLMs),并生成嵌入(embeddings)。Spring AI支持使用OllamaEmbeddingClient的Ollama文本嵌入。嵌入是一个由浮点数组成的向量(列表)。两个向量之间的距离用来衡量它们的相关性。较小的距离表明高度相关,较大的距离表明低度相关。

宋志辉的博客 933

RagFlow专题五、基于Ollama搭建本地RAG知识库

首先,确保你的系统已经安装了 Ollama。如果返回结果,说明 Ollama 已经可以正常运行。这样,一个本地知识库就搭建完成了。如果你想进一步扩展,我可以指导你。,让它能在 Web 上被访问!作为本地向量数据库。

xiaoqi270620903的专栏 1352

ollama 本地安装 embedding 模型_nomic-embed-text本地安装

LLM大模型与Embedding模型的区别及RAG应用 大型语言模型(LLM)和嵌入模型(Embedding)是NLP的两大核心技术,但存在显著差异: 功能差异:LLM用于文本生成和理解,Embedding模型专注于将文本转换为数值向量表示 应用场景:Embedding模型适用于文本相似度计算、信息检索和聚类分析 资源效率:在RAG(检索增强生成)架构中,单独设置Embedding模型可降低资源占用和响应延迟 典型RAG流程: 知识库构建阶段:用Embedding模型将文档转换为向量存储 检索阶段:将用户问

2401_85373396的博客 1388

应急响应之windows日志分析工具logparser使用

windows日志分析工具logparser使用介绍

u013930899的博客 8124

GraphRAG如何使用ollama提供的llm model 和Embedding model服务构建本地知识库

在GraphRAG的使用过程中将需要踩的坑都踩了一遍(不得不吐槽下,官方代码有很多遗留问题,他们自己也承认工作重心在算法的优化而不是各种模型和框架的兼容性适配性上),经过了大量的查阅各种资料以及debug过程(Indexing的过程有点费机器),最终成功运行了GraphRAG项目。之所以要使用ollama同时提供llm和Embedding模型服务,是因为,使用超级简单,响应速度也超级快。

m0_74824865的博客 1767

JeecgBoot漏洞利用工具解析:一键getshell原理与安全加固实践

在应用安全领域,远程代码执行(RCE)和文件上传漏洞是Web系统面临的高危威胁,其核心原理在于对用户输入的控制不足或安全校验缺失。攻击者通过构造恶意请求,可绕过系统边界,在服务器上执行任意命令或上传恶意文件,从而获取系统控制权。这类漏洞的技术价值在于揭示了应用层安全防护的薄弱环节,其利用方式自动化、集成化趋势明显,极大地提升了攻击效率。在低代码开发平台等快速构建的业务系统中,此类风险尤为突出。应用场景广泛覆盖安全测试、渗透评估与应急响应。本文聚焦于JeecgBoot平台的历史高危漏洞,深入解析其SQL注入、

weixin_30787531的博客 552

首个基于LBS方案的3D传感器,VoxelSensor解析

该传感器将结合OQmented的Lissajous模式的MEMS扫描镜,与每帧逐行工作的光栅扫描相比,Lissajous轨迹扫描速度更快,并且能耗很低,它可以更快地捕获完整的场景和快速移动,并且需要更少的数据处理,可满足AR/VR对于低延迟、高效率的需求。简单来讲,Switching Pixels的区别是专注于识别激光事件,性能比普通事件相机更好,但也可以使用事件相机的算法。在具体应用中,它需要在X和Y方向发射一个或多个脉冲光束,以在X和Y轴上定位,而Z轴,也就是深度,则是通过计算光返回的时间来测量。

qingtingwang的博客 575

第一步:安装ollama并运行大模型

其中 gpus 是使用gpu运行ollama,-e OLLAMA_KEEP_ALIVE=-1 是为了让大模型始终保持在内存中,不会用着用着 模型就得重新加载。这里会报错:Error: "shaw/dmeta-embedding-zh" does not support generate。将下方文档保存到 dockerYml文件夹下,名称为:docker-compose.yml。本文档所使用的FastGPT为本地开源版,没有使用docker安装。5.安装mongoDB、pg等docker命令在下面。

qq_41749069的博客 3887

OpenMMLab实战指南:从环境搭建到首个检测模型运行

本文是一份详细的OpenMMLab实战指南,重点介绍了如何从零开始搭建环境并运行首个目标检测模型。内容涵盖Miniconda环境配置、PyTorch与CUDA版本匹配、使用MIM工具安装MMCV和MMDetection的核心步骤,并通过RTMDet-tiny模型演示了完整的推理流程,帮助开发者高效入门这一计算机视觉开源算法体系。

weixin_28678151的博客 157

Spring AI 使用本地 Ollama Embeddings

通过 Ollama 的扩展方式,还可以方便我们导入官方仓库不存在的其他模型,后续文章会以。使用 OpenAI 的 Embeddings 接口是有费用的,如果想对大量文档进行测试,使用本地部署的 Embeddings 就能省去大量的费用,所以我们尝试使用本地的 Ollama Embeddings。这个模型包含几个不同的版本,默认为 7b 的版本,可以先试试 7b,如果速度太慢可以换 2b 试试,执行命令。中的参数即可使用其他模型,如果本地下载过 llama2 模型,就可以直接改这里的参数,不需要重新执行。

偶尔记一下 - mybatis.io 7799

MinerU与Docling:智能文档处理框架对比

本文对比分析了MinerU和Docling两大智能文档处理框架。MinerU专注于高精度PDF解析,采用多模态AI技术,在学术文献、金融报表等复杂文档处理上表现优异;Docling则定位企业级多格式文档处理平台,支持10+格式转换,更适合文档管理系统等场景。技术层面,MinerU基于VLM模型实现端到端处理,Docling采用插件化多后端架构。性能测试显示MinerU精度更高(95%+),但资源消耗较大;Docling处理速度更快(1-3秒/页),部署更灵活。

轩哥的个人研究和成长记录 1911

HiCMAE 论文复现:基于 RAVDESS 数据集的音视频情感识别

多模态情感识别是人工智能领域的重要研究方向,旨在通过结合多种感知模态(如音频、视频、文本等)来更准确地识别人类情感状态。与传统单模态方法相比,多模态方法能够利用不同模态间的互补信息,提高情感识别的鲁棒性和准确性。 RAVDESS(Ryerson Audio-Visual Database of Emotional Speech and Song)是一个常用的多模态情感识别数据集,包含24位专业演员(12名男性,12名女性)表达的8种情感状态(中性、平静、快乐、悲伤、愤怒、恐惧、厌恶和惊讶)的音视频数据。

max500600的博客 497

大模型相关学习(本地部署deepseek)

检索(Retrieval)的详细过程准备外部知识库:外部知识库可能来自本地的文件、搜索引擎结果、API 等。通过 Embedding(嵌入)模型,对知识文件进行解析:Embedding 的主要作用是将自然语言转化为机器理解的高维向量,并且通过这一过程捕获到文本背后的语义信息(比如不同文本之间的相似关系)。通过 Embedding(嵌入)模型,对用户的提问进行处理:用户的输入同样会经过嵌入(Embedding)处理,生成一个高维向量。拿用户的提问去匹配本地知识库。

qq_64376339的博客 1248

100天精通Python(数据分析篇)——第53天:初识pandas模块_基础介绍

一、初始pandas 1. 什么是pandas? 2. 为什么要学习pandas? 3. pandas的优势 4. 下载安装pandas 二、Pandas的数据类型 1. Series 2. DataFrame

努力让自己发光,对的人才能迎着光而来 17万+

从零开始用 Ollama 本地跑大模型、Embedding 与 Rerank

这篇文章介绍了如何利用Ollama在本地运行大模型、Embedding和Rerank,适合企业知识库、内部问答等需要数据不出内网的RAG项目。文章首先区分了LLM、Embedding和Rerank三种模型的不同作用,详细说明了Ollama的安装方法和基础命令,并推荐从qwen3系列开始体验本地大模型。重点讲解了Embedding模型在RAG中的关键作用及其下载方法,包括qwen3-embedding和nomic-embed-text等选择。文章特别强调了初学者容易混淆的概念和常见误区,为想要实现本地AI应用

像风一样自由的博客 3246

Android功耗系列专题理论之十三:MTK平台待机功耗问题分析方法

摘要:本文详细分析了MTK平台待机功耗问题的调试方法,重点介绍了SPM电源管理机制、26M时钟控制逻辑以及系统深睡眠状态的判断标准。文章提供了完整的Debug流程,包括日志抓取、唤醒源分析、SCP睡眠状态检查以及时钟/LDO状态排查等实用技巧,并给出硬件漏电点和软件配置异常的排查方案。针对不同模块(Modem/Conn/SSPM等)提供了具体的电源管理绕过命令,适用于功耗问题调试和低功耗模式验证场景。

559

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

GraphRAG + Ollama 本地部署全攻略:避坑实战指南

▼最近直播超级多,预约保你有收获—1—为什么要对 GraphRAG 本地部署?微软开源 GraphRAG 后,热度越来越高,目前 GraphRAG 只支持 OpenAI 的闭源大模型,导致部署后使用范围大大受限,本文通过 GraphRAG 源码的修改,来支持更广泛的 Embedding 模型和开源大模型,从而使得 GraphRAG 的更容易上手使用。如果对 GrapRAG 还不太熟悉的同学,可以看...

musicml的博客 8924

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

使用ollama + AnythingLLM快速且简单的在本地部署llama3

因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费。

2401_85327249的博客 2441

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

上一篇: 一文看懂模型蒸馏:让大模型的知识“瘦身”传递|含DeepSeek-r1蒸馏模型介绍
下一篇: 快速使用开发者空间AI Agent打造你的私人营养师
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值