一文看懂模型蒸馏:让大模型的知识“瘦身”传递|含DeepSeek-r1蒸馏模型介绍

大模型接触(一)——模型蒸馏 模型蒸馏的原理、训练方法、算法、应用场景概述 阅读详情

"大模型蒸馏就像让一个「学霸老师」把复杂的知识浓缩成「精华笔记」,教给一个「学生小弟」,让小弟用更轻便的方式掌握核心能力,既省资源又高效。" 

导读

在人工智能快速发展的今天,模型的规模越来越大,计算成本也越来越高,这对中小型开发者来说无疑是一个巨大的挑战:如何通过将大模型的知识和能力浓缩到更小、更轻量化的模型中,降低硬件要求,以更低的成本享受到先进的人工智能技术? 


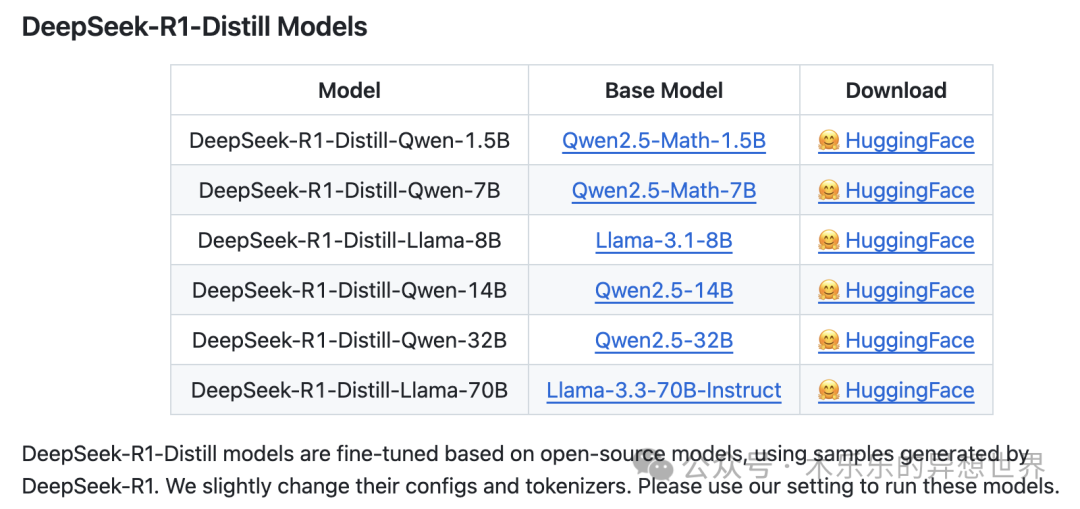
DeepSeek-R1及其API的开源标志着这一领域的重要突破。  

对于中小型开发者而言,这意味着他们不再需要依赖庞大的计算资源就能实现高效、强大的人工智能应用。DeepSeek提供的开源蒸馏检查点(如基于Qwen2.5和Llama3系列的1.5B、7B、8B等参数规模)为开发者提供了丰富的选择空间,无论是初创公司还是个人项目,都可以根据自身需求灵活调用这些模型。


图片

github 地址:https://github.com/deepseek-ai/DeepSeek-R1 


这一技术不仅降低了人工智能的准入门槛,也为中小型开发者在资源有限的情况下实现创新提供了更多可能性。通过蒸馏模型,他们可以更专注于业务逻辑和应用场景的优化,而无需过多关注底层计算资源的限制。这无疑将推动人工智能技术在更广泛的领域中落地生根。 


接下来,详细跟大家聊聊模型蒸馏。 


一、为什么要用模型蒸馏?

(一)模型规模的膨胀之殇

现代深度学习模型的参数量呈指数级增长。例如,GPT-3拥有1750亿个参数,运算时需要数千张GPU卡进行训练,资源消耗巨大。这种“重量级”模型虽然性能优越,但在实际应用中面临诸多限制: 

  1. 硬件需求高:难以在普通设备(如手机、边缘服务器)上运行。
  2. 推理时间长:处理速度较慢,影响用户体验。
  3. 成本高昂:无论是训练还是部署,都需要大量计算资源支持。
(二)知识传递的高效之道

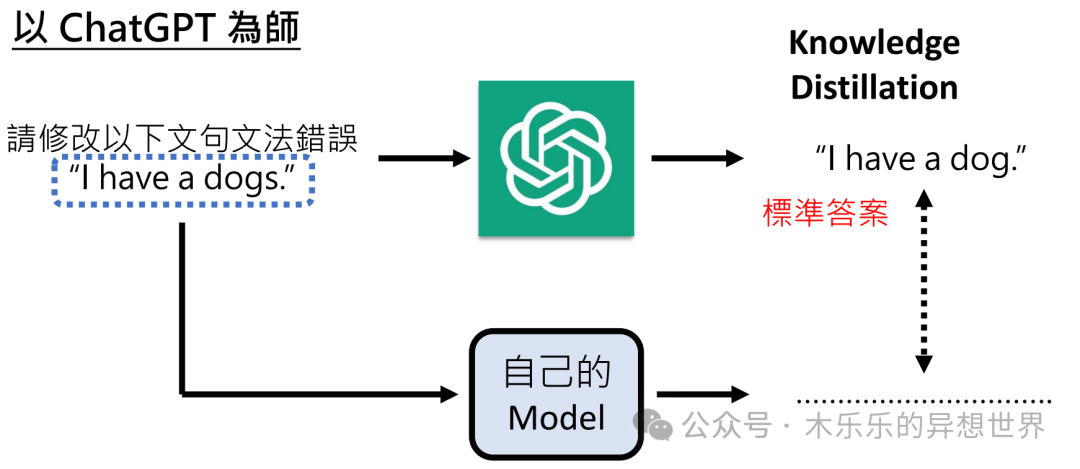
模型蒸馏的核心思想是将“大模型”中的知识提取出来,传授给一个更小、更轻量的学生模型。这种知识传递的过程类似于人类的教学: 

  1. 教师模型(Teacher Model):扮演“学霸老师”的角色,掌握全面的知识。
  2. 学生模型(Student Model):作为“学生”,需要快速掌握核心知识点。

通过蒸馏技术,学生模型可以继承教师模型的精华,同时摆脱其臃肿的身躯。这种方式既保持了高性能,又大幅降低了资源消耗。 

(三)应用场景的迫切需求

在很多实际场景中,大模型的应用面临以下挑战: 

  1. 移动端部署:需要轻量化模型。
  2. 实时推理:要求快速响应。
  3. 成本控制:希望降低算力开销。

模型蒸馏技术正好能够满足这些需求,为AI技术的普惠发展提供了新的可能。 

二、模型蒸馏是如何工作的?

(一)知识蒸馏的基本原理

知识蒸馏是一种迁移学习的技术。具体来说: 

  1. 教师模型:首先需要在大规模数据上进行训练,掌握丰富的知识点。
  2. 蒸馏过程:
    • 教师模型对输入样本给出预测结果和概率分布(软标签)。
    • 学生模型通过模仿教师的输出,学习到更细粒度的知识。
  3. 学生模型:经过蒸馏后,能够掌握接近甚至超越教师模型的能力。
(二)蒸馏的具体实现方法
  1. 软标签蒸馏:
    • 教师模型输出概率分布(Soft Labels),而非单一类别标签。
    • 学生模型通过最小化预测结果与软标签之间的差异来学习。
  2. 硬标签蒸馏:
    • 使用教师模型的预测类别作为监督信号。
  3. 混合策略:
    • 结合多种蒸馏方法,提升效果。
(三)如何选择学生模型?
  1. 结构设计:根据具体需求设计轻量级的学生网络架构(如deepseek 使用的 qwen 和Llama等)。
  2. 参数调整:通过蒸馏过程优化学生的参数,使其更好地模仿教师的行为模式。

三、知识传递的方式与策略

在具体的蒸馏过程中,可以根据不同的需求选择多种策略: 

离线蒸馏

教师模型在训练完成后保持固定状态,学生模型单独进行训练。这种模式类似于传统的教学方式,教师的知识已经固化,学生通过模仿学习掌握技能。 

  • 优点:易于实现,适合大规模部署
  • 缺点:需要大量标注数据

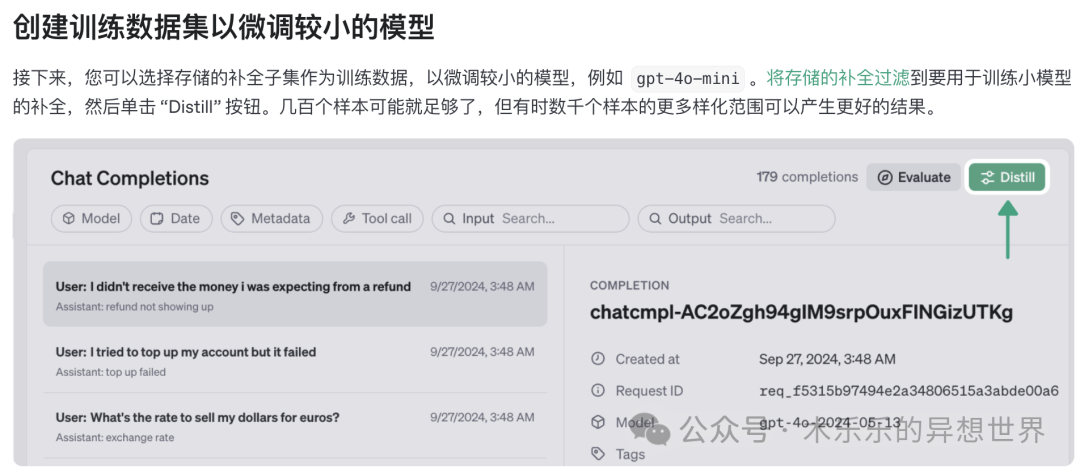
GPT 提供的蒸馏方案,就属于这种类型的。 

图片

链接:https://arxiv.org/abs/2212.10560 

图片

链接:https://platform.openai.com/docs/guides/distillation 

在线蒸馏

教师和学生模型同时参与训练过程,两者互相影响、共同优化。这种方法更接近于师生互动的教学场景。 

  • 优点:能够充分利用教师的实时反馈
  • 缺点:实现复杂度较高
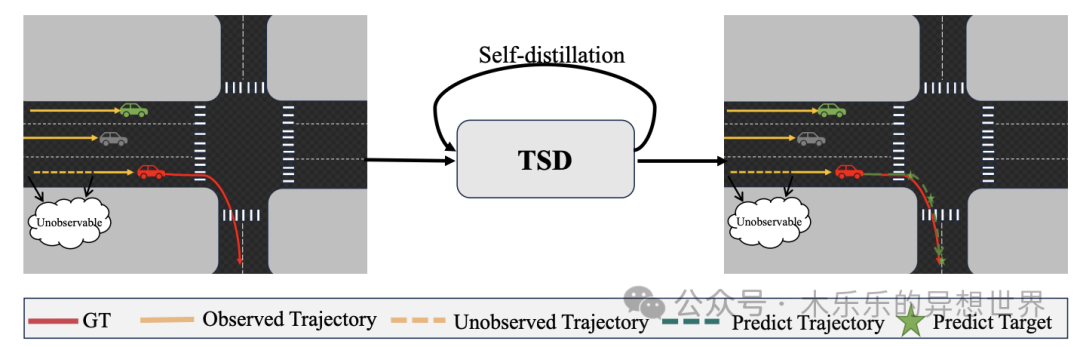
自蒸馏

同一个模型既当老师又当学生,即同一模型的不同部分之间进行知识传递,例如利用中间层特征作为监督信号。 

  • 优点:不需要额外的教师模型
  • 缺点:需要精心设计内部结构

在选择具体策略时,需要综合考虑计算资源、数据规模和性能需求等因素。 

案例:Target-driven Self-Distillation for Partial Observed Trajectories Forecasting 

提出了一种目标驱动的自蒸馏方法,用于部分观测轨迹预测任务,通过自蒸馏使模型能够从自身预测结果中学习,提升预测精度 
图片

参考论文:https://arxiv.org/pdf/2501.16767 

四、知识的载体与形式

模型蒸馏不仅仅是简单的参数复制,更涉及到多维度的知识传递。常见的知识表示形式包括: 

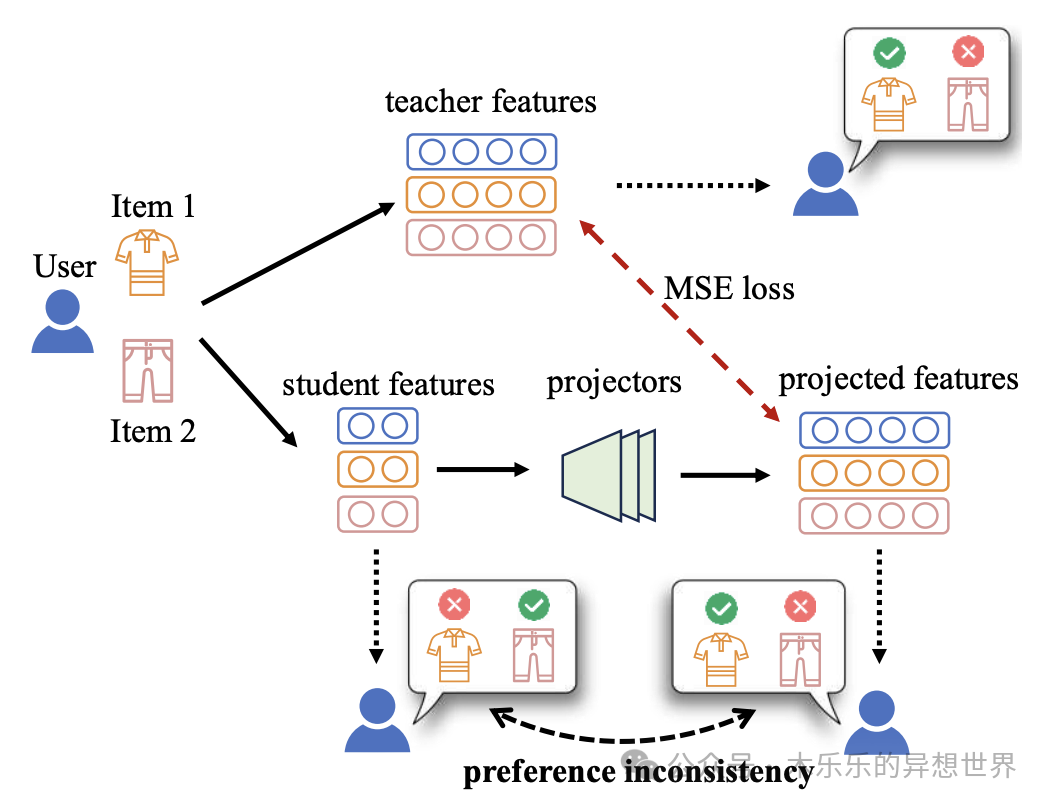
结果型知识(输出层知识)

这是最直接的方式,通过对比教师和学生的输出概率分布来衡量差异。这种方法适用于分类等任务。 

  • 示例:用户商品偏好知识学习。

Preference-Consistent Knowledge Distillation for Recommender System 
图片

链接:https://arxiv.org/pdf/2311.04549 

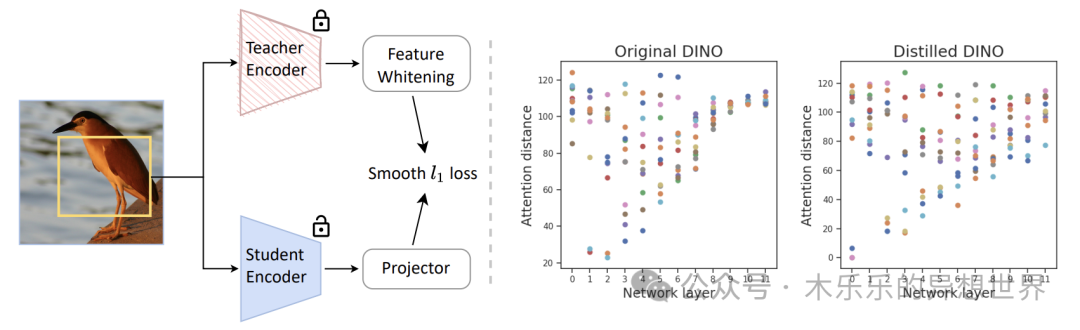
特征型知识(中间层特征)

基于特征的知识蒸馏方法的目标是训练学生模型学习与教师网络相同的特征。基于特征的蒸馏损失函数用于测量,然后最小化两个网络的特征激活之间的差异。 

  • 例如,在主要用于图像分割等计算机视觉任务的卷积神经网络中,随着数据在网络中传输,每个连续的隐藏层都会逐渐捕获更丰富的细节。在用于按物种对动物图像进行分类的模型中,最早的隐藏层可能只是辨别照片的一部分中存在动物形状;中间的隐藏层可能会辨别出动物是鸟类;最后的隐藏层(就在输出层之前)将辨别出区分一种鸟类与另一种密切相关物种的细微细节。

示例:Contrastive Learning Rivals Masked Image Modeling in Fine-tuning via Feature Distillation 
图片

地址:https://arxiv.org/abs/2205.14141 

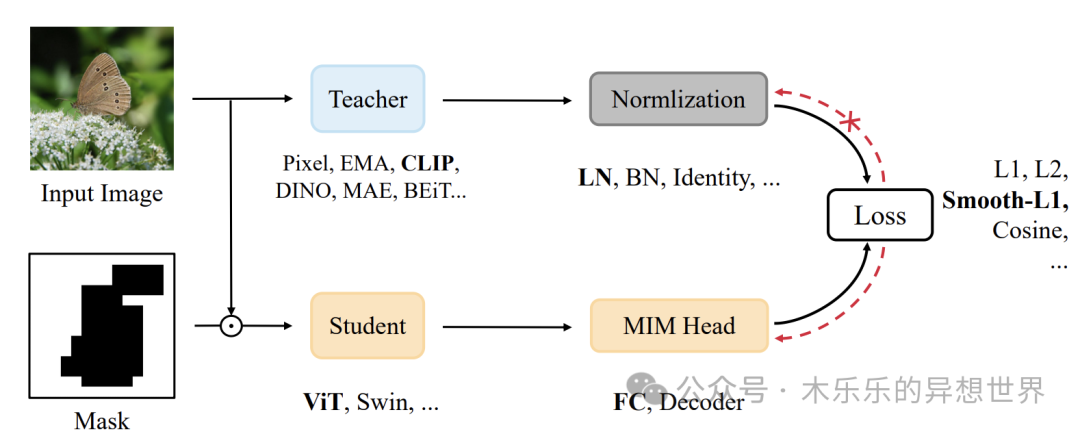
规律型知识(关系知识)

捕捉样本之间的关系或特征间的关联性,例如通过对比学习的方式传递相似性信息。代表了训练学生网络以模拟教师模型的“思维过程”的综合方法。这些关系和相关性可以通过多种方式进行建模,包括特征图之间的相关性、表示不同层之间相似性的矩阵、特征嵌入或特征表示的概率分布。 

  • 示例:A Unified View of Masked Image Modeling

一种基于语言辅助表示的掩码图像预训练方法,旨在通过利用图像的文本描述来减少对大规模标注数据集的依赖。 
图片

链接:https://arxiv.org/abs/2210.10615 

五、模型蒸馏的落地应用

(一)实际场景中的成功案例
  1. 移动端自然语言处理:
    • 使用蒸馏技术将大规模语言模型压缩为适合手机运行的小模型。
    • 用户可以在本地完成文本生成、机器翻译等任务,无需依赖云端。
  2. 工业界的应用探索:
    • 在图像识别领域,通过蒸馏优化边缘设备的部署效率。
    • 在推荐系统中,利用蒸馏技术提升实时响应速度。
(二)如何衡量蒸馏效果?
  1. 性能评估:对比蒸馏前后的模型在相同任务上的准确率、F1值等指标。
  2. 资源消耗分析:
    • 比较两者的计算资源需求(如GPU内存占用、推理时间等)。
(三)实际应用中的挑战
  1. 知识传递的完整性:如何确保学生模型能够继承教师的所有关键知识点?
  2. 蒸馏效率的优化:如何在有限的时间内完成高效的蒸馏过程?

六、未来发展的可能性

(一)与其它技术的结合
  1. 联邦学习(Federated Learning):
    • 在数据隐私保护的前提下,通过蒸馏技术实现知识共享。
  2. 边缘计算(Edge Computing):
    • 利用蒸馏模型提升边缘设备的智能化水平。
(二)更高效的蒸馏方法
  1. 自适应蒸馏:根据具体任务需求动态调整蒸馏策略。
  2. 多教师学习:引入多个教师模型,进一步丰富知识来源。
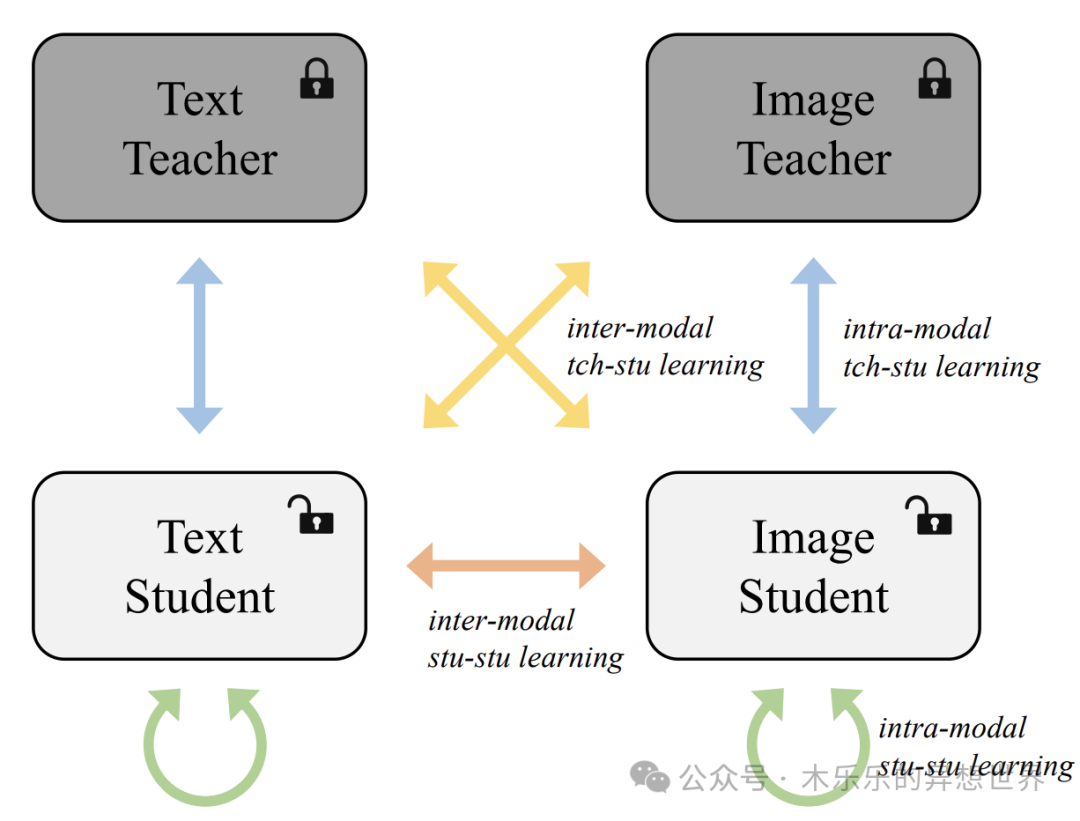
(三)应用场景的拓展-跨模态学习
  • 在图像、文本等多种数据类型之间进行知识传递。

图片

参考论文地址:https://arxiv.org/pdf/2305.17652 


模型蒸馏技术为大模型的落地应用开辟了一条新的道路。它不仅解决了资源消耗过高的问题,还为AI技术的普惠发展提供了重要支持。随着技术的不断进步,我们有理由相信,在不久的将来,轻量化但高性能的模型将能够广泛服务于各个领域,推动人工智能技术真正走进人们的生活。 

 我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

模型蒸馏实战:用Qwen2.5-Math-1.5B实现本地化数学推理 模型蒸馏是一种将大模型知识高效迁移至小模型的关键技术,其核心在于通过logits分布、隐藏层特征与注意力机制三层协同,实现‘思维模式’而非仅‘答案输出’的继承。相比简单剪枝或量化,蒸馏能保留教师模型(如DeepSeek R1)在数学符号推理、多步代数推演等任务中的高阶认知能力,显著提升小模型在MATH、GSM8K等基准上的准确率与泛化性。该技术已广泛应用于VS Code插件、本地IDE助手及轻量级数学工具中,支撑低延迟(<350ms)、低显存(<2.1GB)的生产级部署。本文聚焦Qwen2.5-Math-1 阅读详情

相关推荐

树莓派集群分布式推理DeepSeek R1:边缘计算与大模型实践

分布式计算通过将任务分解到多个计算节点协同处理,突破了单机资源限制,其核心原理包括数据并行、模型并行与流水线并行等技术。在机器学习领域,分布式推理技术能显著提升大模型服务能力,尤其适用于资源受限的边缘计算场景。模型并行将大模型按层切分到不同设备,配合流水线调度实现计算通信重叠,是边缘侧部署大模型的可行方案。本文以DeepSeek R1模型在树莓派5集群的部署为例,详细解析了基于gRPC通信的分布式推理流水线实现,涵盖模型切分、服务编排、性能调优等工程实践,为边缘计算与大模型结合提供了具体的技术参考。

weixin_42524842的博客 286

深度学习模型蒸馏:原理与实践

教师模型(较大的模型)return x# 学生模型(较小的模型)return x。

lady_mumu的博客 1015

手把手拆解AI模型进化史:从DeepSeek到行业顶流 聊聊那些让你CPU冒烟的蒸馏黑科技

各位技术宅们坐稳扶好!今天咱们要开启一场烧脑又带劲的AI模型技术深潜之旅。这可不是你们在知乎上看到的那些泛泛而谈,而是要把各家大厂的模型底裤…啊不,核心技术都扒个底朝天。特别是那个让模型"瘦身不降智"的蒸馏技术,咱们得用放大镜好好瞅瞅它的七十二变玩法。

商务合作|问题讨论|交流学习 请联系作者微信,加微信请务必注明来意,博客主页有联系方式 997

深度学习之蒸馏模型

蒸馏模型 蒸馏模型的目的是为了将大模型/复杂模型学习到的东西传递给小模型。大模型将学习到的东西浓缩在输出值之中,输出值是一个0~1的概率值,我们称之为soft-target。可以通过设置温度T来调节输出值的分布,T越大得到的soft-target越软(均匀)。很显然假设复杂模型输出的solf target是100%准确的话,以0~1的soft target代替原样本中的[0, 1]这种hard ...

d541941799的博客 1930

2025软考信息安全工程师真题

2025信息安全工程师软考真题

qq_40424393的博客 1707

形式化方法(Formal Methods)和人工智能(Artificial Intelligence)

一、形式化方法(Formal Methods) ​ 形式化方法最初应用在硬件上,验证硬件的正确性,后面逐渐应用到软件编程中,能够在软件中找到软件的错误,验证软件的安全可靠。形式化方法更加接近离散数学,所以其应用难度非常大,同时学习成本也较高。再加上形式化方法的大多数理论还停留在上个世纪,由于程序越来越复杂,导致形式化方法进行验证需要大量人工和时间,以至于现在绝大部分软件开发人员完全没有考虑过这个方法,甚至没有听说过这个名词。 ​ 形式化方法最新的应用成果是在工业上,比如一些极其重要且对安全性要求极高的领域(

qq_37030400的博客 4005

知识蒸馏基础及Bert蒸馏模型

为了提高模型准确率,我们习惯用复杂的模型(网络层次深、参数量大),甚至会选用多个模型集成的模型,这就导致我们需要大量的计算资源以及庞大的数据集去支撑这个“大”模型。但是,在部署服务时,就会发现这种“大”模型推理速度慢,耗费内存/显存高,这时候我们又会想念“小”模型的好。那么,有没有一种方法能够尽可能继承大模型的泛化能力,又像小模型一样轻量级呢?今天来介绍一种模型压缩的方法——蒸馏(Distillation)。

小白胖爱学习-的博客 4991

RedVQA:轻量级无参考视频质量评估算法原理与工程实践

视频质量评估是计算机视觉领域的关键技术,旨在通过算法自动量化视频的观看体验。其核心原理在于模拟人眼视觉系统,从像素数据中提取并融合空域和时域特征,以预测主观质量分数。这项技术的价值在于,它能自动化处理海量视频内容的质量监控,为流媒体服务、移动设备影像优化等场景提供关键指标。无参考视频质量评估作为该领域的前沿方向,无需原始无损视频作为参考,更贴合实际应用。本文以RedVQA项目为例,深入剖析了如何利用轻量化的深度网络架构,如MobileNetV3,结合高效的时空特征融合模块,在保证评估精度的同时,大幅降低计算

weixin_28698129的博客 575

模型蒸馏技术(Knowledge Distillation)

先说下什么是蒸馏,顾名思义,白酒蒸馏出来就是高度酒,水蒸馏出来就是蒸馏水(纯净),所以算法领域的蒸馏技术就是要把大的模型,大的知识,进行提纯,以达到小容量便可以解决大问题的效果。一般是压缩模型规模,后续演化也可以通过teacher&student方式提升算法准确度。 未完待续 ...

1619

CISSP/CCSP证书到手后别松懈!保姆级维持攻略:CPE积分怎么攒?年费怎么交?

本文为CISSP/CCSP持证者提供详细的维持认证攻略,重点介绍如何高效积累CPE积分和避免年费缴纳中的常见问题。通过免费与付费资源结合的策略,帮助持证者轻松完成年度认证要求,同时利用认证创造职业价值。

weixin_30859423的博客 416

ADI官方例程HDL和No-OS生成Vivado工程

这一步是选择下载源,一般都是选择国内镜像,因为国外的源太慢了,这里选择阿里的镜像,如果没有这个选项可以在下面的User URL里添加就行,选择好源后然后点击下一步。下一步会从你选择的源上下载软件包目录,如果提示Unable to get setup from https://xxxxxx/,返回上一步,选择别的源,例如第二个163网易的源。然后就是你想要安装在哪了,下面的选项好像会决定环境变量存放在哪,不过一般都是个人电脑选择第一个默认的就行,然后点下一步。下好之后双击打开,就是这个界面了,直接点下一步。

代码匠的博客 3832

知识蒸馏:让大模型“瘦身”的魔法

蒸馏模型(Distillation Model)是一种通过“师生教学”的方式,将庞大复杂的大模型(教师模型)中的核心知识,“浓缩”到轻量级小模型(学生模型)中的技术。就像把百科全书提炼成便携手册,既保留关键知识,又大幅降低使用门槛。

2301_81888214的博客 1004

【SystemVerilog项目实践】4.AHB-SRAMC(验证计划)

验证计划

托马斯的博客 3660

DeepSeek R1 蒸馏法:大模型“瘦身”不“降智”

知识蒸馏(Knowledge Distillation)是一种模型压缩技术,旨在将一个大型复杂模型(教师模型)的知识转移到一个小型简单模型(学生模型)中,使学生模型在保持较小规模的同时,能够学习到教师模型的推理能力和知识表示。其核心思想是利用教师模型的输出作为软标签(soft labels),指导学生模型的训练过程,从而让学生模型学习到教师模型对数据的深层次理解和抽象表示。

小码哥AI、互联网副业项目 1187

硬件工程师笔试面试高频考点汇总——(2025版)

《硬件工程师笔试面试知识汇总》一文系统梳理了硬件领域的核心知识体系,涵盖电子器件、模拟电路、数字电路等模块。文章详细解析了电阻、电容、电感等基础元件的选型与应用,深入探讨了三极管、MOS管等半导体器件的工作原理,并对比分析了DCDC与LDO等电源方案。在电路设计方面,提供了滤波器、放大器等实用电路的设计方法与仿真案例,同时包含UART、I2C等通信协议的实现要点。文章还整合了戴维宁定理等电路分析理论,并附有美团、联想等名企真题解析。通过器件特性、电路设计、企业真题三维度内容,为硬件工程师构建了完整的知识框架

XU157303764的博客 1万+

【即插即用模块】注意力篇 | TIP 2024 | 注意力机制的有效改进!内容引导注意力块CGA,空间-通道-像素三个维度融合,实现涨点!

CGA(Content-Guided Attention)是一种融合多维度注意力的即插即用模块,通过并联空间和通道注意力并与像素注意力串联,实现从通道、空间到像素的三层级特征筛选。该模块采用层级递进设计,解决了传统单维度注意力的局限性,尤其适用于图像恢复等对特征精度要求高的任务。实验表明,CGA在去雾任务中能显著提升指标,但会略微增加参数量。模块代码支持灵活集成到各类视觉模型中,建议放置在网络靠前位置以充分释放后续层性能。其核心创新在于通过7×7大卷积捕捉长距离依赖,结合分组卷积实现像素级细粒度建模

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 227

大模型“暴瘦”密码:一文读懂知识蒸馏(Knowledge Distillation)与个人实战指南

在人工智能(Artificial Intelligence)飞速发展的今天,参数规模几乎每年都经历着外翻数倍甚至超十倍的增长——从百亿、千亿到万亿参数,“越庞大越强、越胖越聪明”似乎成了不争的事实。例如,DeepSeek 满血版模型(如 DeepSeek-V3/R1)的参数量已高达 671B(6710 亿)。然而,强大的能力背后,是高昂的计算成本与物理壁垒。面对资源受限的边缘设备或终端场景,我们该如何打破这道瓶颈?本文将带你深度剖析 AI 领域的“瘦身黑科技”——,并为你奉上一份手把手的个人实战指南。

移动端开发干货分享 432

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

模型蒸馏实战:用DeepSeek R1-Zero蒸馏Qwen2.5-Math-1.5B做数学推理

模型蒸馏是一种将大模型知识高效迁移至小模型的关键技术,其核心在于通过Logits、Attention和Hidden States三层知识对齐,实现推理能力的保真压缩。不同于剪枝、量化或微调,蒸馏不改变学生模型结构,而是重写其决策逻辑,特别适合对精度与可解释性要求严苛的数学推理场景。借助强化学习训练的DeepSeek R1-Zero作为教师模型,能提供低熵、高鲁棒的思维链输出,显著提升小模型在MATH等基准上的准确率与推理稳定性。本文聚焦教育AI落地需求,详解如何将671B级专家能力蒸馏为1.5B轻量模型,并

weixin_34301132的博客 428

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

人工智能:从知识蒸馏视角看DeepSeek——赞誉之下的真实价值与理性审视

本文客观分析了国产开源大模型DeepSeek在知识蒸馏技术上的创新与局限。DeepSeek通过双蒸馏融合架构和思维链蒸馏技术,在数学推理、代码生成等特定领域实现了高性能与小模型部署的平衡,部分指标超越GPT-4o等国际模型,具有显著的成本优势。然而,该模型在多模态支持、通用认知能力、生态整合等方面仍明显落后于国际主流模型,存在明显的任务偏科性。文章呼吁理性看待技术突破,避免过度宣传,同时指出国产模型在特定领域的优势与整体技术生态的不足,为开发者提供了客观参考。

2403_87969572的博客 994

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

轻量大模型落地新选择:DeepSeek-R1-Distill-Qwen-1.5B多场景应用解析

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-R1-Distill-Qwen-1.5B镜像,实现轻量级大模型的高效落地。依托平台能力,用户可快速启动该1.5B参数模型,在法律合同条款提取、数学题分步求解及技术会议纪要生成等典型办公场景中提供准确、低延迟的AI协作者能力。

weixin_42511373的博客 136

DeepSeek-R1-Distill-Qwen-1.5B模型压缩技术解析

本文介绍了如何在星图GPU平台上自动化部署🐋 DeepSeek-R1-Distill-Qwen-1.5B 本地智能对话助手 (Streamlit 驱动)镜像,依托模型压缩与知识蒸馏技术,在消费级GPU或Mac设备上实现低延迟、高连贯性的本地多轮智能对话,适用于个人知识助理、企业内部问答系统等典型场景。

weixin_34163588的博客 302

大模型训练全流程拆解:从预训练到量化部署的工程实践

大语言模型训练是一个系统工程,涉及多个关键阶段。预训练阶段通过海量无标注文本学习语言规律和世界知识,构建基础的语言模型能力。监督微调阶段则使用高质量的指令-输出对数据,调整模型的条件概率分布,使其能够更好地遵循人类指令。基于人类反馈的强化学习进一步优化模型输出的主观品质,如安全性、有用性和风格一致性。最后,通过量化和知识蒸馏等技术,将大型模型压缩为更高效的部署形态。本文以DeepSeek模型为例,在Jupyter环境中构建简化训练流水线,深入解析SFT对齐和RLHF价值对齐的实现原理,帮助开发者建立从数据到

weixin_34297704的博客 562

DeepSeek-R1-Distill-Qwen-1.5B性能瓶颈在哪?GPU利用率深度评测

本文介绍了如何在星图GPU平台自动化部署DeepSeek-R1-Distill-Qwen-1.5B镜像,并分析其性能瓶颈与优化策略。该镜像专为文本生成场景设计,通过知识蒸馏技术实现高效推理,适用于智能对话、内容创作等自然语言处理任务,显著提升GPU利用率与部署效率。

ObsidianRaven13的博客 378

DeepSeek V4 深度解析:国产万亿参数开源模型的范式级创新

维度意义技术层面1.6 万亿参数开源模型,性能比肩全球最强闭源模型成本层面推理成本降至竞品的 1/20 ~ 1/90,百万上下文不再是富人专属开源层面MIT 协议开放,全球开发者可自由商用、二次开发自主可控首次实现国产大模型与国产芯片深度适配,"去英伟达"路径可行产业层面激活全产业链,从"单点突围"走向"体系作战"

未来已来,AI时代,学AI编程,做AI量化,就来大鹏AI教育。 3127
上一篇: 大模型开源+免费教程,推荐一波大模型图文教程、视频课程(附文档)
下一篇: ollama 本地安装 embedding 模型
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值