


在过去两年中,我帮助过许多组织利用LLM构建了创新应用。基于这些经验以及LLM.org.il社区的宝贵见解,我总结出一套经过实战检验的构建创新方案的方法,在本文中与大家分享。
本指南将为你在LLM原生开发的复杂领域中指明方向。你将学习如何从构思阶段逐步推进到实验、评估和产品化,最终释放潜力,创造出颠覆性的应用。

为什么标准化流程至关重要
LLM 领域发展日新月异,几乎每天都会听到新的突破性创新。这固然令人兴奋,但也让人感到无所适从——你可能会渐渐开始迷茫,不知道下一步该往哪里走,也不知道如何将脑中的奇思妙想变成现实。
简而言之,如果你是一位想要高效构建 LLM 原生应用程序的 AI 创新者(无论是管理者还是从业者),那么本文都将为你指点迷津。
实施标准化流程有助于启动新项目,并具备以下几个关键优势:
1.标准化流程——标准化流程有助于团队成员保持步调一致,并确保新成员能够快速融入团队(尤其是在当前瞬息万变的局面下)。
2.定义清晰的里程碑——清晰的里程碑能让你以一种简单直接的方式跟踪工作进度,衡量工作成果,并确保始终处于正确的研究方向上。
3.确定决策点——LLM 原生开发充满了未知数和“小型实验”[见下文]。清晰的决策点可以降低风险,并始终保持精益的开发方式。
LLM 工程师的必备技能
与软件研发领域中其他任何已有的角色不同,LLM 原生开发绝对需要一个全新的角色:LLM 工程师或AI 工程师。
LLM 工程师是一个独特的混合型人才,需要具备以下不同(已有的)角色的技能:
-
软件工程技能——与大多数软件工程师一样,这项工作的大部分内容都涉及将各个组件组装并粘合到一起。
-
研究技能——正确理解 LLM 原生实验的本质至关重要。虽然构建“酷炫的演示应用程序”很容易,但从“酷炫的演示”到真正落地且切实可行的解决方案之间,你需要通过大量的实验并且拥有敏捷的反应才可能实现。
-
深入的业务/产品理解——由于模型本身的脆弱性,理解业务目标和流程比坚持预先定义的架构更为重要。对人工流程进行建模的能力是 LLM 工程师的一项重要技能。
在撰写本文时,LLM 工程仍然是一个全新的领域,招聘可能会非常困难。拥有后端/数据工程或数据科学背景的候选人都是不错的选择。
软件工程师可能会更容易过渡到 LLM 工程师的角色,因为与传统的数据科学工作相比,LLM 的实验过程更偏“工程化”,而没有那么强的“科学研究”属性。话虽如此,我也见过许多数据科学家成功转型到这个领域。只要愿意学习新的软技能,就可以实现成功转型!
LLM 原生开发的关键要素
与传统的后台应用程序(例如 CRUD)不同,构建 LLM 原生应用程序没有现成的、可以按部就班的流程方法。正如所有“AI”领域的工作一样,它需要你具备研究和实验的心态。
为了驾驭这头名为“LLM”的野兽,你必须采取分而治之的策略,将工作分解成更小的实验,逐个尝试,并最终选择最有希望的实验方向。
无论怎样强调研究心态的重要性都是不为过的。因为你可能会花大量时间探索一个研究方向,最终却发现它“不可行”、“不够好”或者“不值得”。这完全没有关系——所有探索的过程都是有价值的,这表明你正在一步步接近正确的道路!
使用 LLM 进行实验是构建 LLM 原生应用的唯一途径(同时也能避开过程中的“陷阱”) (图片由 Dall-E3 创建)
拥抱实验:流程的核心
在 LLM 原生开发过程中,实验并不总是会成功。有时,你尝试了一种方法,结果失败了,然后你稍微调整了一下方向,就发现取得了意想不到的进展。
所以在设计最终解决方案之前,必须从小处着手,并对冲风险。
1.定义“预算”或时间范围。可以先设定一个周期,比如 X 周,看看能取得哪些进展,然后再决定如何继续或是否值得继续。通常情况下,2-4 周的时间足以让我们对基本的 PoC 有所了解。如果看起来很有希望,就可以继续投入资源进行改进。
2.实验——无论是在实验阶段选择自下而上还是自上而下的方法,我们的目标都是最大限度地提高实验的成功率。在第一次实验迭代结束时,你应该获得了一些 PoC(利益相关者可以试用的原型)以及一个可以作为参考的基线。
3.回顾——在研究阶段结束时,我们可以评估构建这样一个应用程序的可行性、局限性和成本。这有助于我们决定是否将其产品化,以及如何设计最终产品及其用户体验。
4.产品化——按照标准的软件工程最佳实践,开发出可供生产的项目版本,并将其集成到解决方案的其他部分,并实施反馈和数据收集机制。

LLM 原生应用程序开发生命周期(图片由作者提供)
为了更好地实施以实验为导向的流程,我们必须明智地决定如何开展和构建这些实验:
从小处着手:自下而上的方法
尽管许多人早期都急于尝试“最先进的”多链智能体系统,并使用功能齐全的 Langchain 或类似的工具,但我发现“自下而上的方法”通常会带来更好的结果。
从小处着手,越小越好,遵循“一个提示解决所有问题”的理念。虽然这种策略乍看之下可能有些不走寻常路,而且一开始很可能效果不佳,但是它为你的系统建立了一个可以不断迭代的基线。
从这个基线出发,可以不断迭代和优化提示,采用各种提示工程技术来优化结果。当你发现解决方案中的不足之处时,可以通过添加分支来解决这些问题,就像一颗不断生长的小树苗。
在设计我的 LLM 工作流程图(或者说 LLM 原生架构)中的每个“叶子”节点时,我都会遵循 LLM 三角形原则³ 来决定何时何地裁剪分支、拆分分支或加粗根部(通过使用提示工程技术),并尽可能多地榨取柠檬汁,物尽其用。

自下而上方法的图示(图片由作者提供)
例如,要使用自下而上的方法实现“自然语言 SQL 查询”,首先将简单的模式发送给 LLM,并要求它生成一个查询。
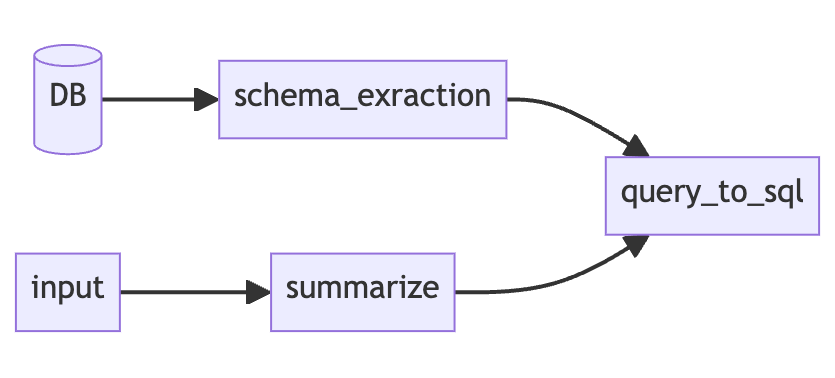
自下而上方法的示例(图片由作者提供)
通常,这并不与“自上而下的方法”相矛盾,而是作为自上而下方法之前的另一个步骤。这使我们能够快速获得成功,并吸引更多的项目投资。
预先构思全局:自上而下的策略
“我们知道 LLM 工作流程并不简单,为了实现目标,最终可能会设计出某种工作流程或 LLM 原生架构。”
自上而下的方法首先认可了这一点,它从一开始就开始设计 LLM 原生架构,再实现其不同的步骤/链,就像一个技艺高超的工匠,先绘制出整个作品的蓝图,然后再精雕细琢。
通过这种方式,可以将整个工作流程架构作为一个整体进行测试,就像挤压整个柠檬一样,而不是分别处理每个部分。

自上而下方法流程:一次性设计架构,然后实施、测试并衡量结果(图片由作者提供)
例如,要使用自上而下的方法实现“自然语言 SQL 查询”,我们会在开始编码之前先设计架构,然后直接进行完整的实现:

自上而下方法的示例(图片由作者提供)
找到合适的平衡点
开始尝试使用 LLM 时,你可能会从两个极端开始,要么是过于复杂的“自上而下”方法,要么是超级简单的“单次尝试”方法。但现实中,这种方式往往会失败。
理想情况下,你应该在编码和使用模型进行实验之前,先定义好 SoP(标准操作程序)¹ 并对专家进行建模。但在现实中,建模非常困难,有时你甚至找不到合适的专家。
我发现,想要在第一次尝试就确定一个好的架构或 SoP¹ 非常困难,所以,在投入大量精力之前,最好先进行一些轻量级的实验,就像先试试水深再决定是否要跳下去。当然,这并不意味着所有东西都要过于精简。如果你已经知道某些事情必须拆分成更小的部分,那就不要犹豫,大胆地去做。
在设计解决方案时,你应该利用 LLM 三角形原则³ 并正确地对人工流程进行建模。
优化解决方案:榨取柠檬汁
在实验阶段,我们要不断地“榨取柠檬汁”,也就是不断增加复杂度,尝试不同的方法来优化解决方案:
-
提示工程技术——例如少样本学习、角色分配,甚至动态少样本学习。
-
扩展上下文窗口,从简单的变量信息到复杂的 RAG 流程,都可以帮助你提升模型效果。
-
尝试不同的模型——不同的模型在不同的任务上表现不同。此外,大型 LLM 通常成本效益不高,你可以尝试一些更适用于特定任务的小型模型。
-
提示瘦身——我发现,对 SoP¹ (特别是提示和请求的输出)进行“瘦身”通常可以缩短模型响应时间。通过减少提示的大小和模型需要执行的步骤,我们可以减少模型需要处理的输入和输出。你可能会感到惊讶,但“提示瘦身”有时甚至可以提高模型输出的质量!
不过“瘦身”也可能会导致质量下降,所以在此之前,设置健全性测试非常重要。
- 将流程分解成更小的步骤也非常有益,可以让你更容易、更切实可行地优化 SoP¹ 的子流程。
但这可能会增加解决方案的复杂性,或者降低性能(例如,增加处理的标记数量)。为了减轻这种情况,应尽量使用简洁的提示和更小的模型。
根据经验,当系统提示的巨大变化可以为 SoP¹ 流程的某个部分带来更好的结果时,通常就应该将其拆分。

挤柠檬 图片由 Dall-E3 创建
LLM 实验的剖析
就我个人而言,我更喜欢使用 Python、Pydantic 和 Jinja2,从一个简单的 Jupyter Notebook 开始,从小处开始着手:
1.使用 Pydantic 定义模型输出的模式。
2.使用 Jinja2 编写提示模板。
3.定义结构化的输出格式(使用 YAML²)。这样可以确保模型遵循“思考步骤”,并以我的 SoP 为指导。
4.使用 Pydantic 验证来确保输出符合预期;如果需要,可以进行重试。
5.将你的工作进行结构化——使用 Python 文件和包将代码组织成不同的功能单元。
在更广泛的范围内,可以使用各种工具来辅助开发,例如:
-
使用 openai-streaming 轻松实现流式传输;
-
使用 LiteLLM 跨不同的 LLM 提供商,使用统一的标准化接口;
-
使用 vLLM 来提供开源的 LLM 模型服务。
通过健全性测试和评估来确保质量
健全性测试用于评估项目的整体质量,并确保模型表现没有低于预先设定的成功率基线。
可以把解决方案/提示想象成一条短毯子——如果把它拉得太长,它可能会无法覆盖原本可以覆盖的区域。
为了避免这种情况,需要定义一组已经测试通过的用例,并确保模型在这些用例上的表现始终稳定可靠(或者至少保证性能下降在可接受范围内)。可以参考表格驱动的测试方法来实现。
评估“生成性”解决方案(例如文本生成)的成功与否,要比评估其他类型的 LLM 应用(例如分类、实体提取等)复杂得多。对于这类任务,可能需要借助更强大的模型(例如 GPT-4、Claude Opus 或 LLAMA3-70B)来充当“评判者”,判断模型的输出质量是否达标。
此外,尝试在“生成性”输出之前添加一些“确定性”的输出内容也是个好方法,因为这类输出内容更容易进行测试:

有一些前沿的、很有前景的解决方案值得研究。我发现它们在评估基于 RAG 的解决方案时尤其相关:可以看看 DeepChecks、Ragas 或 ArizeAI。
做出明智的决定:回顾的重要性
在每个主要的/有时间限制的实验或里程碑之后,应该停下来思考一下,就如何以及是否继续采用这种方法做出明智的决定。
此时,你的实验将有一个清晰的成功率基线,你也会对需要改进的地方有所了解。
这也是一个开始讨论该解决方案的产品化含义并开始进行“产品工作”的好时机:
1.这在产品中会是什么样子?
2.有哪些限制/挑战?你将如何缓解它们?
3.你目前的延迟是多少?足够好吗?
4.用户体验应该是什么样的?你可以使用哪些 UI 技巧?流式传输有帮助吗?
5.估计的代币花费是多少?我们可以使用更小的模型来减少花费吗?
6.什么是优先事项?是否有任何挑战是不可克服的?
假设我们实现的基线“足够好”,并且我们相信我们能够克服我们提出的问题。在这种情况下,我们将继续投资和改进该项目,同时确保它不会退化,并使用健全性测试。

图片由 Dall-E3 创建
从实验到产品:让你的解决方案落地
最后,我们要将辛辛苦苦开发的成果产品化。与任何其他生产级解决方案一样,我们需要实现各种生产工程概念,例如日志记录、监控、依赖项管理、容器化、缓存等等。
这是一个庞大而复杂的领域,但幸运的是,我们可以借鉴传统软件工程中的许多机制,甚至直接采用许多现有工具。
当然,也需要格外注意 LLM 原生应用程序的一些特别的地方:
-
反馈回路——如何衡量应用的成功?是简单粗暴地使用“点赞/踩”机制,还是设计更复杂、更能反映用户实际使用情况的指标体系?
-
收集这些数据至关重要,因为它可以帮助我们重新定义健全性“基线”,或者使用动态少样本学习等技术来微调模型,进一步提升模型效果。
-
缓存——与传统的软件工程不同,当我们的解决方案中涉及到生成式 AI 时,缓存会变得非常困难。为了缓解这个问题,我们可以探索缓存相似结果的方法(例如使用 RAG),或者通过严格定义输出模式来减少生成内容的差异性。
-
成本跟踪——许多公司都倾向于一开始就选择“强大的模型”(例如 GPT-4 或 Opus),但在实际生产环境中,模型的调用成本可能会迅速上升,让你收到账单的时候大吃一惊。为了避免这种情况,请务必提前测量好输入/输出的 token 数量,并密切关注模型对工作流程的影响(如果没有做好这些,那么祝你好运,你可能要费尽心思才能找到性能瓶颈)。
-
可调试性和跟踪——确保你已经设置了合适的工具来跟踪“有缺陷的”输入,并在整个流程中对其进行跟踪。这通常需要记录用户输入以供后续调查,并建立完善的跟踪系统。请记住:与传统的软件不同,AI 经常会在毫无征兆的情况下出现错误!
写在最后:你我在 LLM 原生技术发展中的角色
本文到这里就接近尾声了,但这仅仅是一个开始。LLM 原生应用的开发是一个不断迭代的过程,它会涵盖越来越多的用例和功能,也会面临各种各样的挑战,而我们也需要不断探索,力求打造更加完善的 LLM 原生产品。
在你的 AI 开发旅程中,请保持敏捷,勇于尝试,并始终以用户体验为评判基准。也欢迎大家积极与社区分享你的经验和见解,让我们携手同行,共同推动 LLM 原生应用的发展,探索无限可能!
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 1099


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


