


一、引言
很多AI新手在接触大模型时都会被"微调"二字劝退。想实战没有环境?自己根本玩不转?本文带你用一杯咖啡的时间,了解大模型的微调技术,无需高端显卡,用魔塔社区免费资源即可实战体验,在实战中理解微调技术,感受薅羊毛的快乐!
根据具体需求(如训练速度、内存占用、灵活性等)选择合适的微调方案,本次以LoRA为例进行微调测试。常见的微调技术如下:
1. 全参数微调(Full Fine-Tuning)
-
• 技术特点:更新所有模型参数,最大化任务适配
-
• 适用场景:
-
• 数据量充足(如10万+标注样本)
-
• 资源丰富的关键任务(如金融风控模型)
-
-
• 典型案例:医疗文本分类模型基于BERT的全参数微调
2. 参数高效微调(PEFT)
-
• (1) LoRA(低秩适配)
-
• 原理:插入低秩矩阵仅训练新增参数
-
• 优势:显存占用降低70%,支持多任务切换
-
• 适用场景:移动端部署、多领域客服系统
-
-
• (2) Prefix-Tuning
-
• 原理:在输入前添加可训练的前缀向量
-
• 优势:无需修改模型结构,适配对话生成任务
-
-
• (3) Adapter
-
• 原理:在Transformer层间插入小型神经网络模块
-
• 优势:保持原模型参数冻结,适合跨语言迁移
-
3. 强化学习微调
-
• (1) RLHF(基于人类反馈)
-
• 流程:SFT → 奖励模型训练 → PPO优化
-
• 适用场景:对话系统、创意文本生成(如GPT-4的调优)
-
-
• (2) DPO(直接偏好优化)
-
• 特点:绕过奖励模型,直接利用偏好数据优化
-
• 优势:训练流程简化,适合缺乏标注资源的场景
-
二、测试流程
-
1. 算力资源准备
-
2. 微调环境准备配置
-
3. 定制数据集
-
4. 训练与推理
-
5. 评估和对比
三、算力环境准备
在线算力资源地址:https://www.modelscope.cn/models/clouditera/SecGPT-1.5B
以SecGPT大模型为例,选择合适的镜像(以ubuntu22.04-cuda12.1.0-py311-torch2.3.1-tf2.16.1-1.25.0为例),启动GPU环境实例(约需2分钟):

打开notebook,以终端方式运行:

Notebook 当前支持默认工作目录 /mnt/workspace/ 下数据的持久化保存,请确保需要保存的数据放置于该目录下
激活 python 虚拟环境:
python -m venv secgpt-vllm
source secgpt-vllm/bin/activate
四、微调环境准备
安装 vLLM
pip install --upgrade pip
pip install vllm
pip install modelscope
下载模型到环境中
(此次以secGPT预训练后的模型为例)
git lfs install
git clone https://www.modelscope.cn/clouditera/SecGPT-1.5B.git

以vllm的形式启动大模型服务
python -m vllm.entrypoints.openai.api_server \
  --model ./SecGPT-1.5B \
  --tokenizer ./SecGPT-1.5B \
  --tensor-parallel-size 1 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.9 \
  --dtype bfloat16

请求大模型示例测试
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./SecGPT-1.5B",
    "messages": [{"role": "user", "content": "什么是 XSS 攻击?"}],
    "temperature": 0.7
  }'
响应值如下:
{
  "id":"chatcmpl-4594b9eafe4f4f4f870c72b03f152dcb",
"object":"chat.completion",
"created":1745844540,
"model":"./SecGPT-1.5B",
"choices":[
    {
      "index":0,
      "message":{
        "role":"assistant",
        "reasoning_content":null,
        "content":"XSS攻击是指攻击者通过在网站上注入恶意代码,当受害者访问该页面时,就会执行这些恶意代码。这种攻击可以窃取用户信息、控制用户的计算机,甚至进行其他非法活动。为了防止这类攻击,我们可以通过输入验证等安全措施来保护我们的网站和用户数据的安全。",
        "tool_calls":[]
      },
      "logprobs":null,
      "finish_reason":"stop",
      "stop_reason":null
    }
],
"usage":{
    "prompt_tokens":35,
    "total_tokens":102,
    "completion_tokens":67,
    "prompt_tokens_details":null
},
"prompt_logprobs":null
}
"temperature": 0.7
“温度”参数是控制大模型生成内容多样性和随机性的一个重要参数,常用于文本生成、对话、写作等场景,常见取值范围是 0~2,默认一般是 1。它会影响模型在生成下一个词(token)时的概率分布。
具体作用:
-
• 温度低(如 0.1~0.5):
生成内容更“保守”、更确定,模型更倾向于选择概率最高的词。
适合需要严谨、标准答案的场景,比如问答、代码生成等。 -
• 温度高(如 0.7~1.5):
生成内容更“发散”、更有创造力,模型更容易选择概率较低但合理的词。
适合需要创意、写作、对话等场景。
例子:
- • 温度为 0.1,问 “今天天气怎么样?” 模型可能总是回答:
“今天天气很好。”
- • 温度为 1.0,模型可能会回答:
“今天天气晴朗,适合出门散步。”
“今天有点阴,记得带伞。” 等多样化内容。
五、定制数据集
为什么不利用HuggingFace现有的数据集
由于SecGPT大模型本身的数据集投喂的效果比较好了,我尝试了几次,微调前回答的都很精准,所以此次为了验证Lora的微调细节,专门定制了几条“不真实的数据集”来投喂大模型,这样他肯定答不对,方便我进行微调,哈哈。

定制安全数据集喂大模型
利用transformers小批量进行微调测试(免费算力提供的Tesla P100的GPU架构老了,不支持vllm的特性)
以下是定制的数据集3条内容
custom_security_qa.jsonl
{"instruction":"SecGPT-1.5B的作者是谁?","input":"","output":"clouditera团队。"}
{"instruction":"本地安全策略编号LS-2024-001是什么?","input":"","output":"这是一个测试策略,用于演示LoRA微调效果。"}
{"instruction":"CVE-2099-99999属于什么漏洞类型?","input":"","output":"本地提权。"}
微调前让大模型回答定制数据集里的内容
微调前的代码如下:
# cat pretrain_before.py
from transformers import AutoModelForCausalLM, AutoTokenizer

# 加载模型和分词器
model = AutoModelForCausalLM.from_pretrained("./SecGPT-1.5B", trust_remote_code=True).half().cuda()
tokenizer = AutoTokenizer.from_pretrained("./SecGPT-1.5B", trust_remote_code=True)

# 定制问答
questions = [
    {"question": "SecGPT-1.5B的作者是谁?", "label": "clouditera团队。"},
    {"question": "本地安全策略编号LS-2024-001是什么?", "label": "这是一个测试策略,用于演示LoRA微调效果。"},
    {"question": "CVE-2099-99999属于什么漏洞类型?", "label": "本地提权。"}
]

for item in questions:
    q = item["question"]
    label = item["label"]
    inputs = tokenizer(q, return_tensors="pt").to("cuda")
    outputs = model.generate(**inputs, max_new_tokens=64, do_sample=False)
    answer = tokenizer.decode(outputs[0], skip_special_tokens=True)
    # 只保留模型生成的答案部分
    answer = answer.replace(q, "").strip()
    print(f"【问题】{q}")
    print(f"【标准答案】{label}")
    print(f"【模型输出】{answer}")
    print(f"【是否答对】{'✔️' if label in answer else '❌'}")
    print("="*50)
运行结果如下,没有微调前的大模型回答显然是一派胡言。

六、微调训练与推理
6.1 LoRA 微调步骤
6.1.1 安装依赖
pip install transformers peft datasets accelerate
6.1.2 构建 LoRA 微调脚本
代码主要包含三个核心部分:
-
• LoRA 配置部分:用于提供模型结构和性能参数
-
• 训练配置部分:控制训练流程和参数
-
• 生成配置部分:用于推理阶段的生成控制
(1)LoRA 配置部分(相当于投影仪的硬件配置)
-
• 就像投影仪的分辨率、亮度、对比度等硬件参数
-
•
r=8:相当于投影仪的分辨率,决定画面清晰度 -
•
target_modules:选择需要调整的“部件”(如镜头、灯泡) -
•
lora_alpha:控制调整的幅度,相当于亮度调节 -
• 这些参数决定了模型的基本“硬件性能”
(2) 训练配置部分(相当于投影仪的调试过程)
-
•
learning_rate:调试的精细程度,越大越激进 -
•
batch_size:每次调试使用的样本量 -
•
num_train_epochs:调试总次数,影响最终效果 -
•
fp16:节能模式,减少资源消耗但可能影响精度
(3) 生成配置部分(相当于投影仪的使用设置)
-
•
max_new_tokens:画面的最大尺寸 -
•
temperature:画面锐度与柔和度调节 -
•
do_sample:是否启用自动优化 -
•
num_beams:是否使用多路径优化
6.1.3 完整微调代码
# train_lora.py
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, Trainer
from peft import LoraConfig, get_peft_model
from datasets import load_dataset
import torch

# 1. 加载模型和分词器
model_path = "./SecGPT-1.5B"
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    torch_dtype=torch.float16,
    trust_remote_code=True,
    local_files_only=True
)
tokenizer = AutoTokenizer.from_pretrained(
    model_path,
    trust_remote_code=True,
    local_files_only=True
)

# 2. LoRA 配置
lora_config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.0,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)

# 3. 数据预处理函数
defpreprocess(example):
    prompt = f"Instruction: {example['instruction']}\nInput: \nOutput: {example['output']}"
    tokenized = tokenizer(
        prompt,
        truncation=True,
        max_length=128,
        padding="max_length",
        return_tensors="pt"
    )
    return {
        'input_ids': tokenized['input_ids'][0],
        'attention_mask': tokenized['attention_mask'][0],
        'labels': tokenized['input_ids'][0].clone()
    }

# 4. 加载和处理数据
dataset = load_dataset("json", data_files={"train": "custom_security_qa.jsonl"})["train"]
tokenized_dataset = dataset.map(
    preprocess,
    batched=False,
    remove_columns=dataset.column_names
)

# 5. 训练配置
training_args = TrainingArguments(
    output_dir="./lora_security_qa",
    per_device_train_batch_size=3,
    gradient_accumulation_steps=1,
    num_train_epochs=20,
    learning_rate=5e-3,
    logging_steps=1,
    save_strategy="no",
    fp16=True,
    remove_unused_columns=False,
)

# 6. 训练
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset,
)

print("开始训练...")
trainer.train()
print("训练完成!")

# 7. 保存模型
model.save_pretrained("./lora_security_qa")

# 8. 测试生成
print("\n开始测试...")
model.eval()

model.config.temperature = None
model.config.top_p = None
model.config.top_k = None
model.config.do_sample = False

test_questions = [
    "SecGPT-1.5B的作者是谁?",
    "本地安全策略编号LS-2024-001是什么?",
    "CVE-2099-99999属于什么漏洞类型?"
]

for question in test_questions:
    prompt = f"Instruction: {question}\nInput: \nOutput:"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

    with torch.no_grad():
        generation_config = {
            "max_new_tokens": 50,
            "num_return_sequences": 1,
            "do_sample": False,
            "num_beams": 1,
            "pad_token_id": tokenizer.pad_token_id,
            "eos_token_id": tokenizer.eos_token_id,
            "temperature": None,
            "top_p": None,
            "top_k": None,
        }

        outputs = model.generate(
            **inputs,
            **generation_config
        )

    response = tokenizer.decode(outputs[0], skip_special_tokens=True)
    answer = response.split("Output:")[-1].strip() if"Output:"in response else response

    print(f"\n问题:{question}")
    print(f"答案:{answer}")
    print("="*50)
6.2 微调效果与结果展示
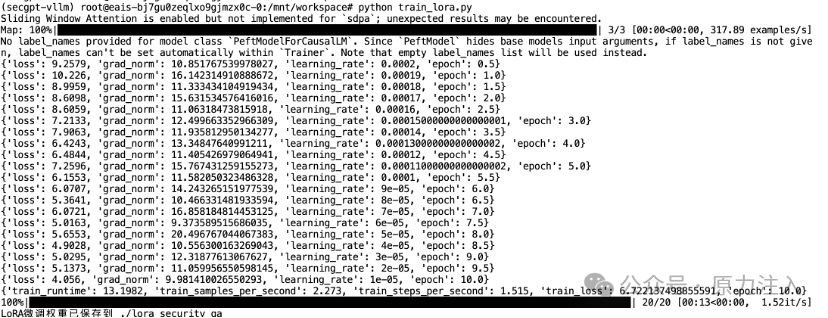
6.2.1 执行微调脚本
执行微调脚本后,微调页面大致如下所示。
6.2.2 微调后模型输出示例
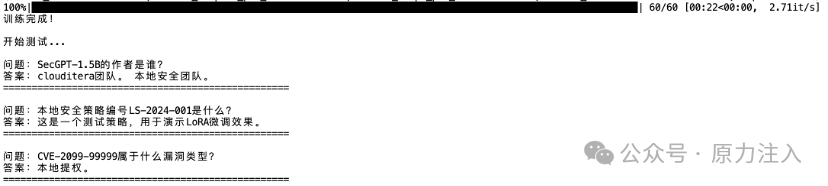
微调后的大模型在定制数据集上的回答准确率明显提高,能够给出合理、准确的回答。
可见微调后的大模型对定制的数据集回答都正确了,成就感满满。

七、评估与对比
微调前:

微调后:
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 906


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


