


本博文给大家介绍一下如何使用AI4J快速接入OpenAI大模型,并且结合Pinecone向量数据库实现一个刑法AI助手的RAG应用。
介绍
由于SpringAI需要使用JDK17和Spring Boot3,但是目前很多应用依旧使用的JDK8版本,所以使用可以支持JDK8的AI4J来接入OpenAI大模型。
AI4J是一款JavaSDK用于快速接入AI大模型应用,整合多平台大模型,如OpenAi、Ollama、智谱Zhipu(ChatGLM)、深度求索DeepSeek、月之暗面Moonshot(Kimi)、腾讯混元Hunyuan、零一万物(01)等等,提供统一的输入输出(对齐OpenAi)消除差异化,优化函数调用(Tool Call),优化RAG调用、支持向量数据库(Pinecone),并且支持JDK1.8,为用户提供快速整合AI的能力。
Pinecone
Pinecone向量数据库是一个云原生的向量数据库,具有简单的API和无需基础架构的优势。它可以快速处理数十亿条向量数据,并实时更新索引。同时,它还可以与元数据过滤器相结合,以获得更相关、更快速的结果。
Pinecone是完全云托管的,容易上手、扩展轻松,用户可以放心使用。
注册与使用
大家可以进入Pinecone官网进行注册和登录,至于注册账号,这里不在演示,相信大家都会。
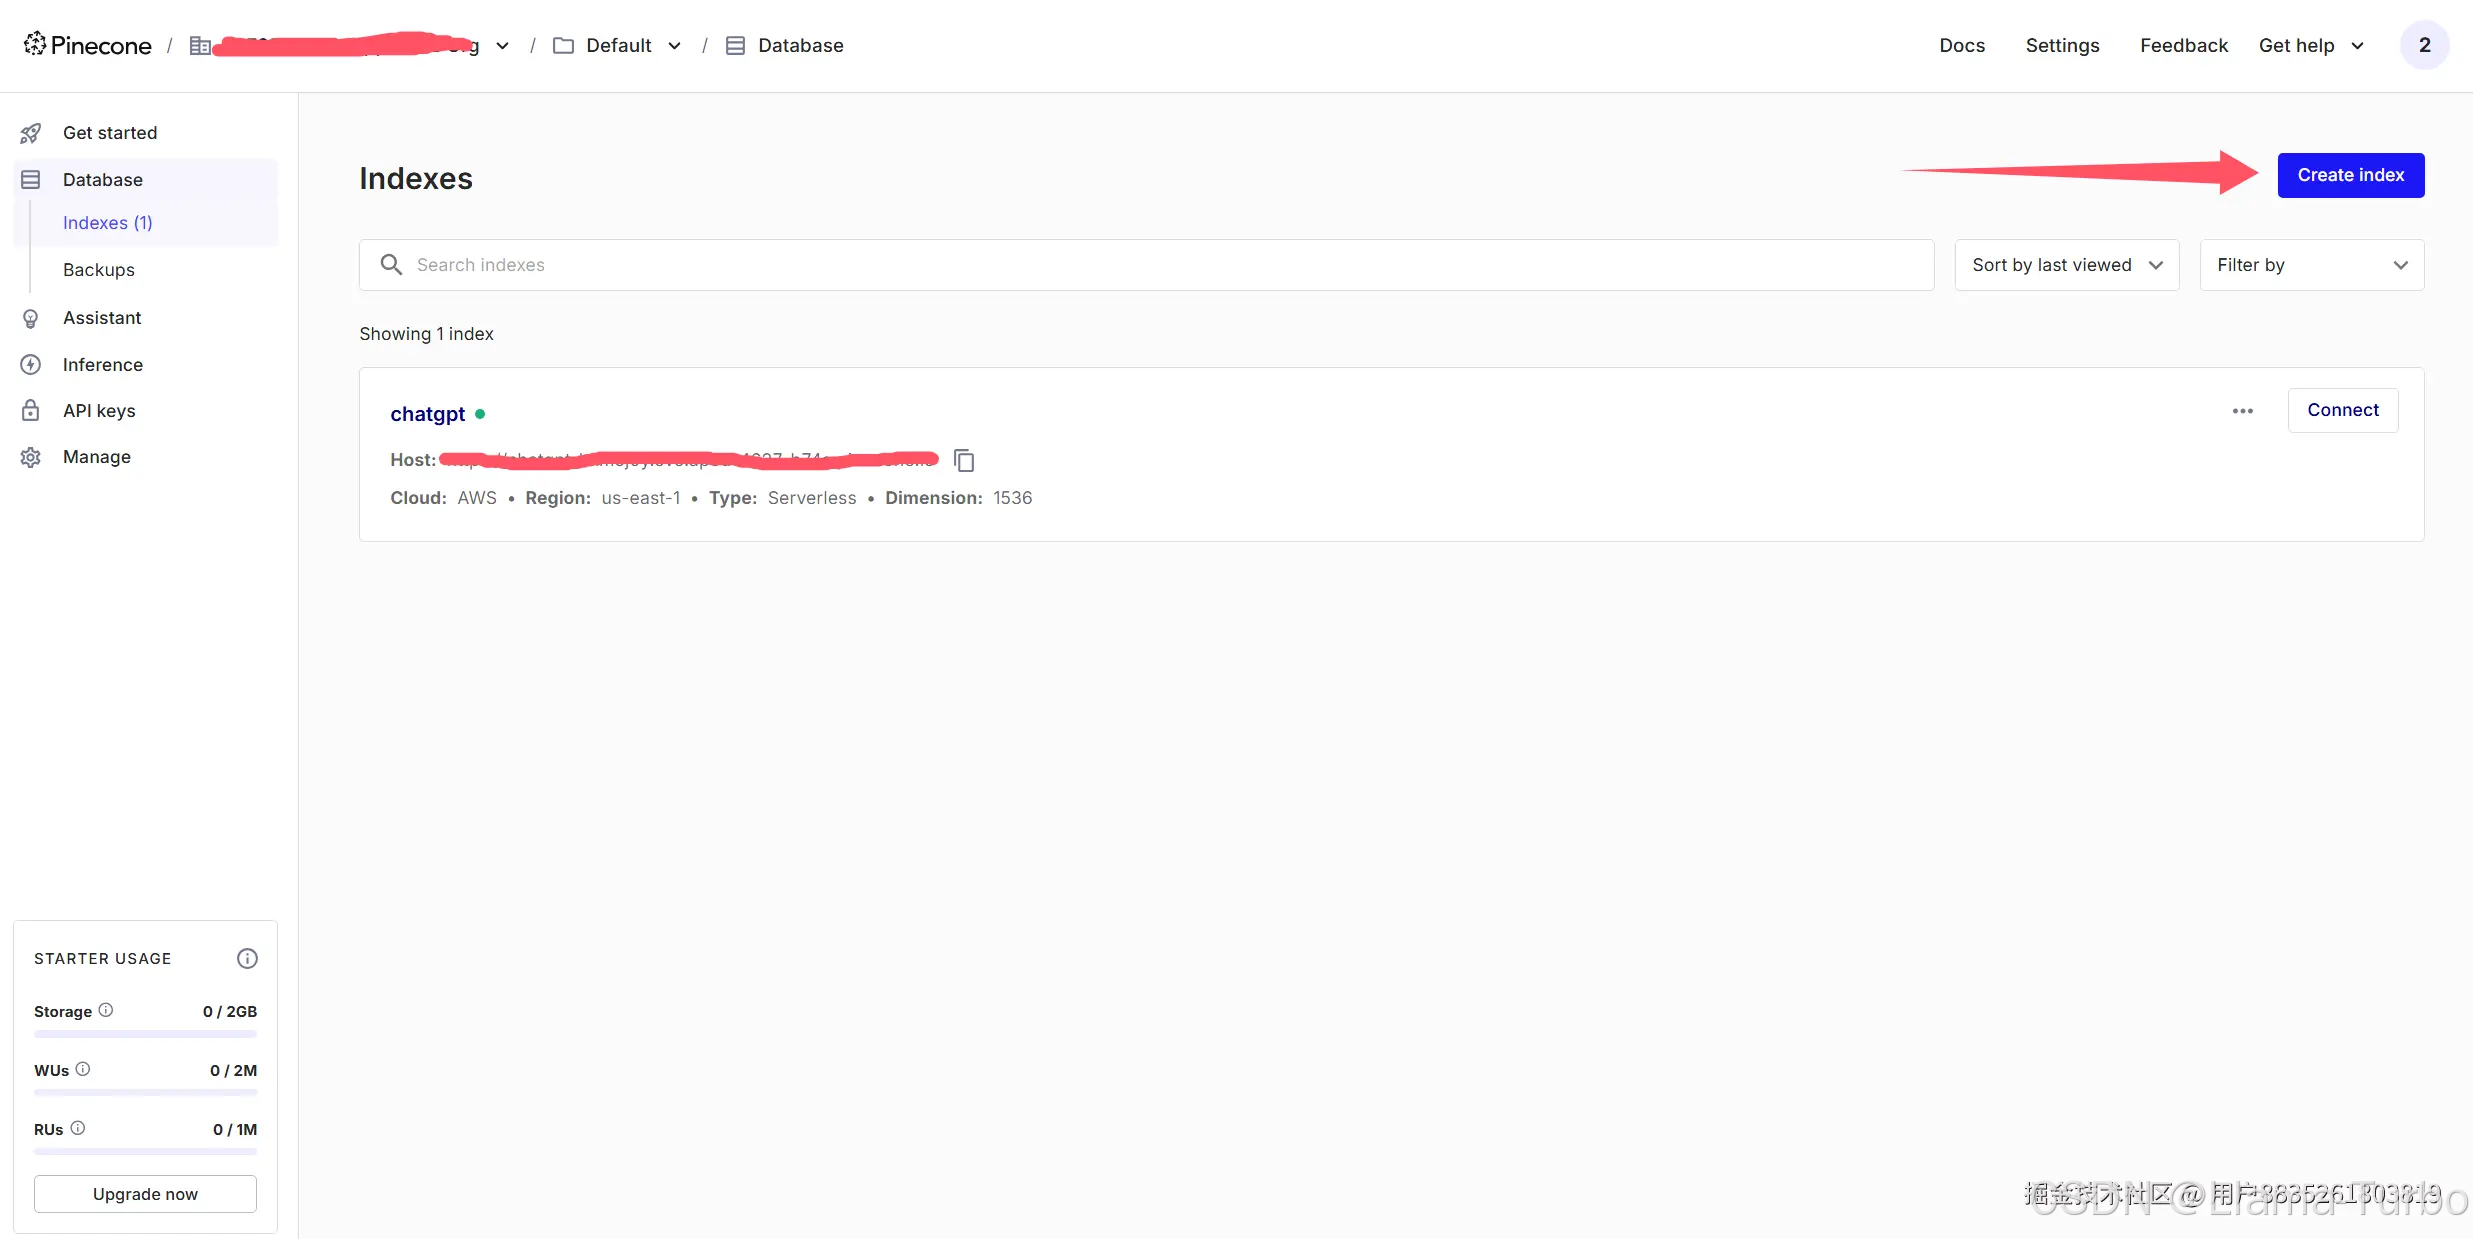
选择Database->Indexes->Create Index来创建索引
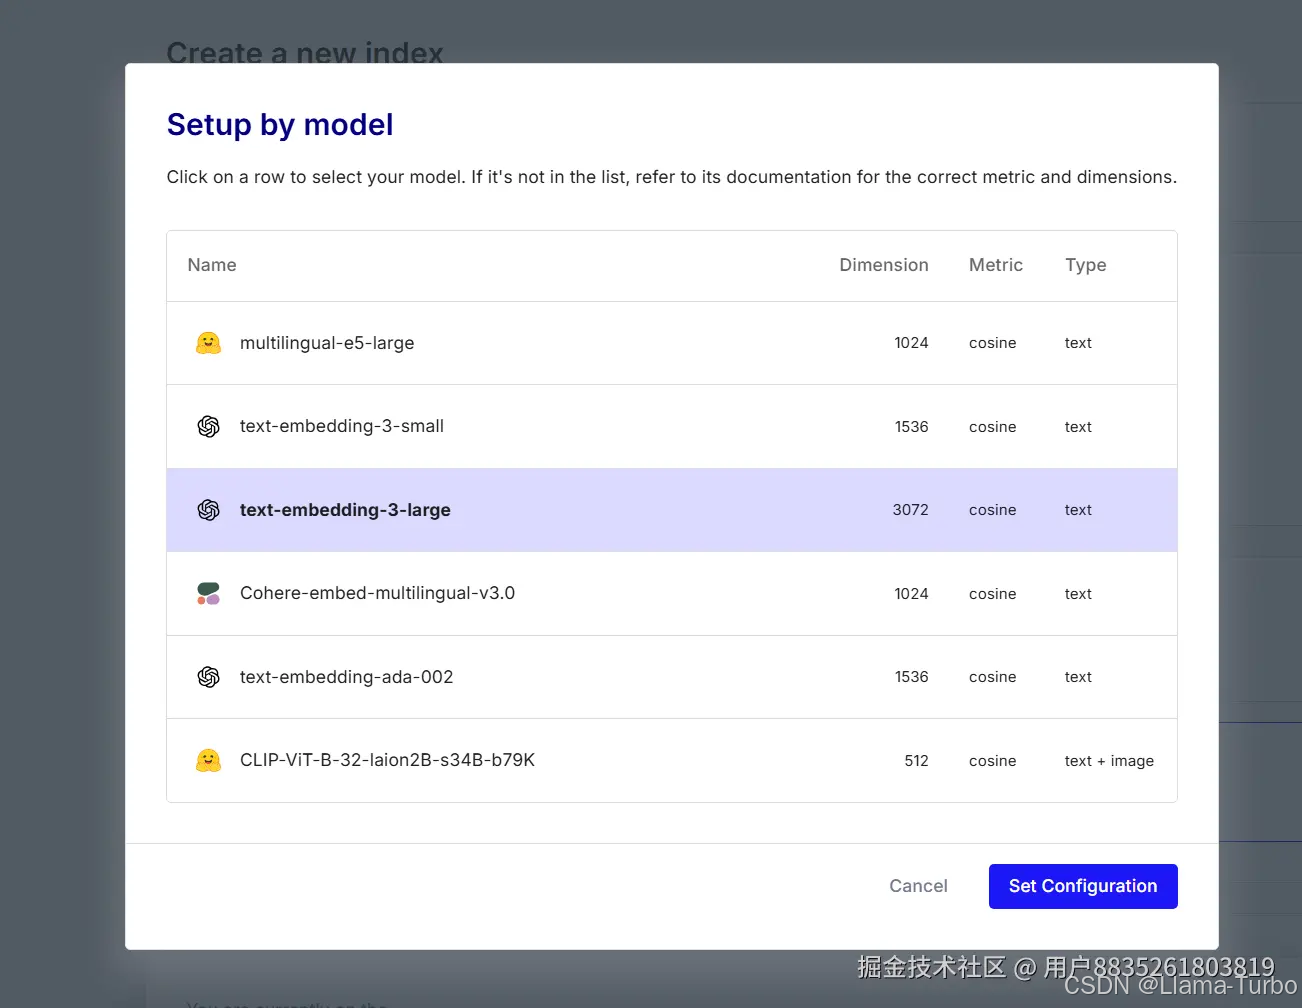
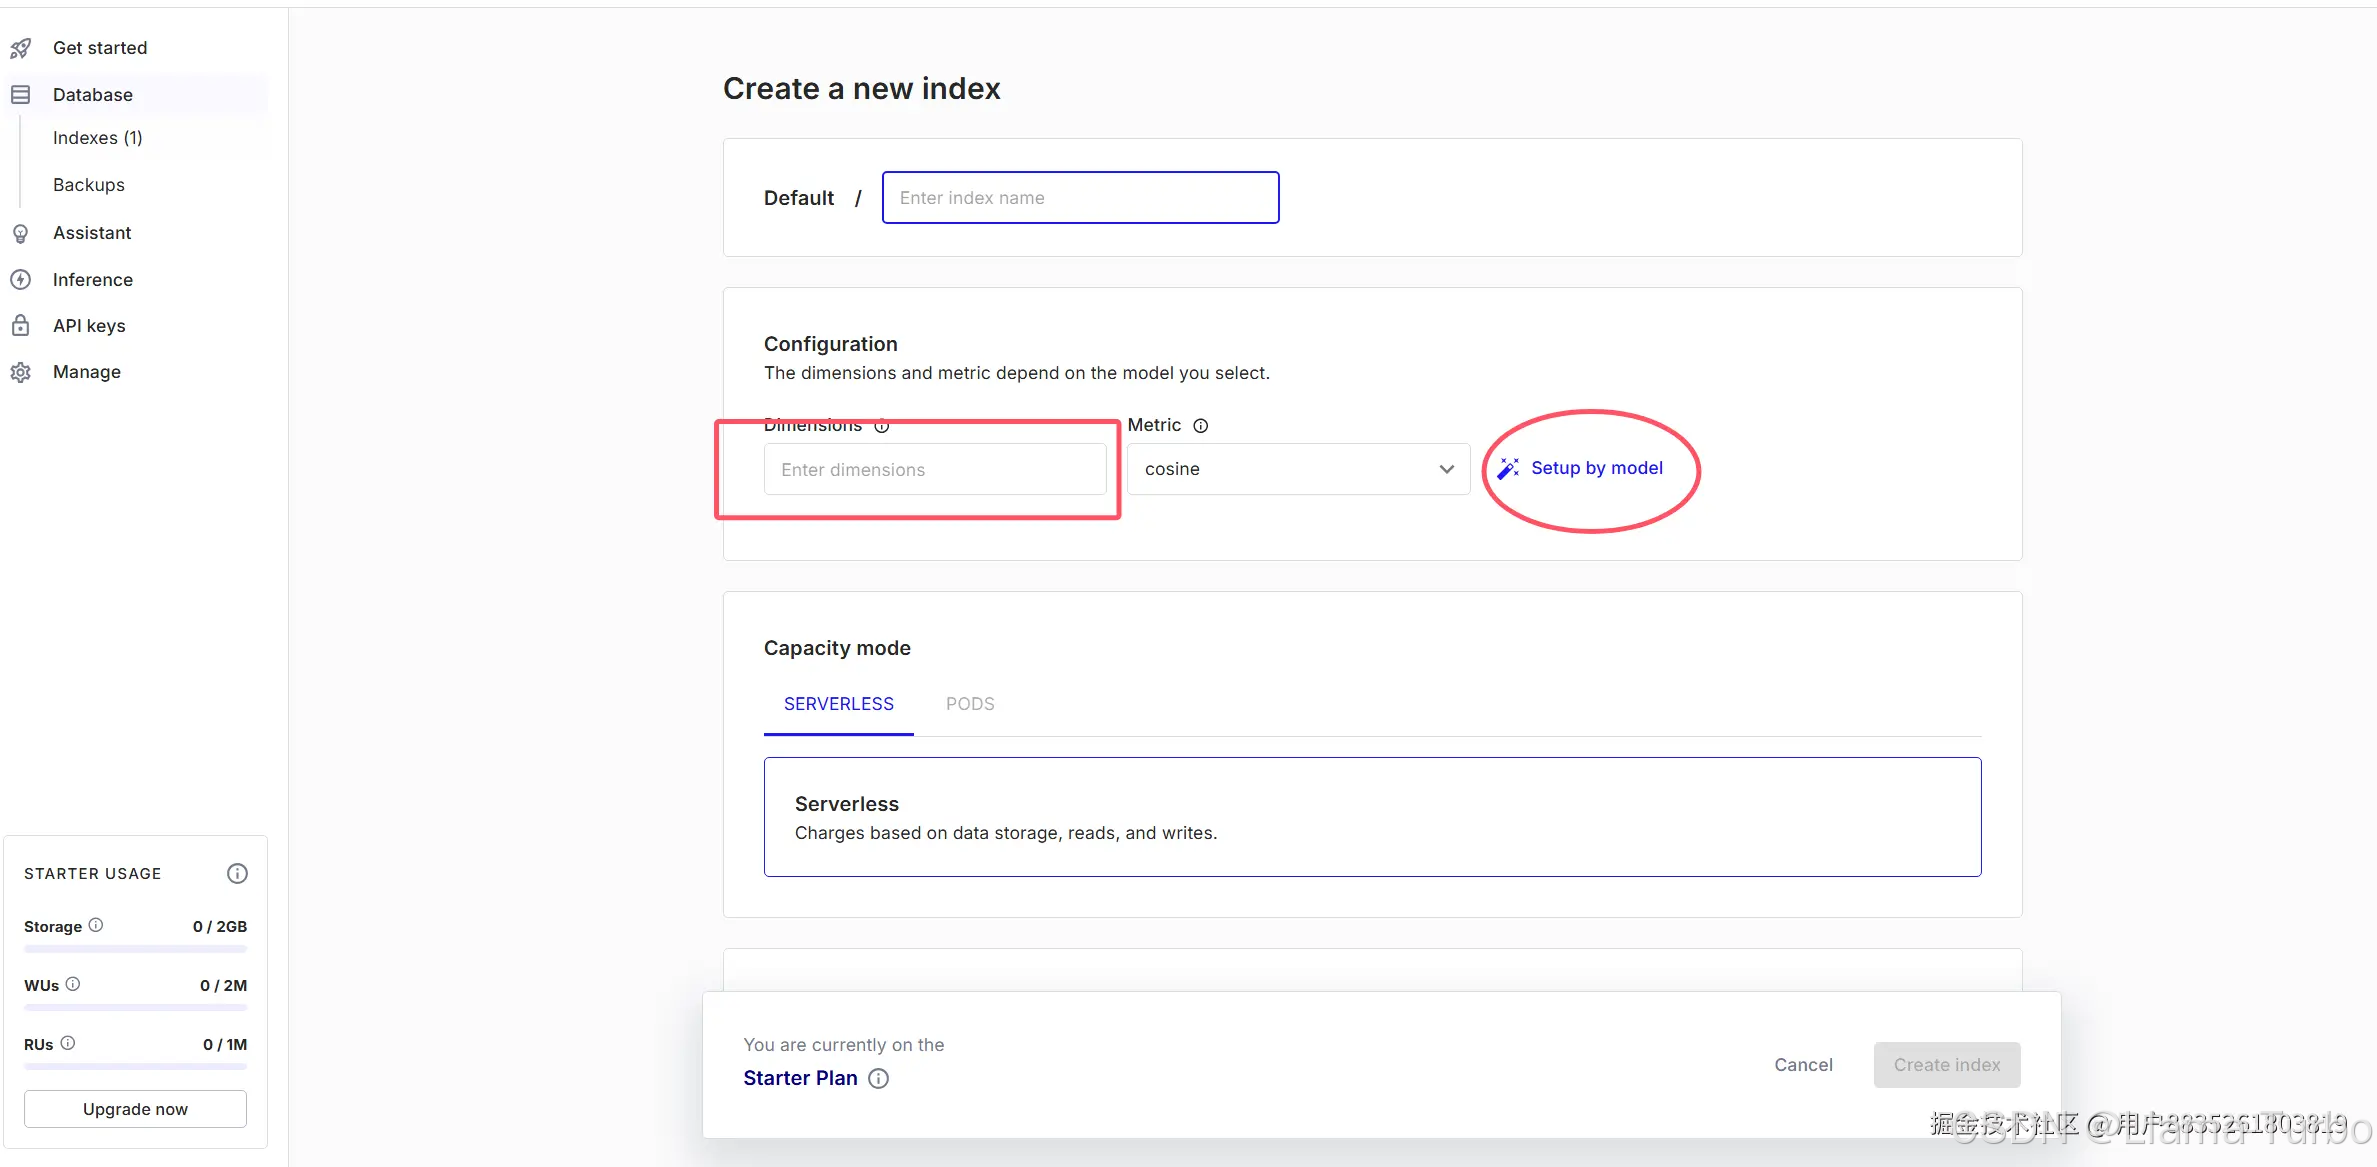
在这里可以输入你的维度,或者点击Setup by model,根据模型来选择向量维度。这里我以text-embedding-3-large模型为例子
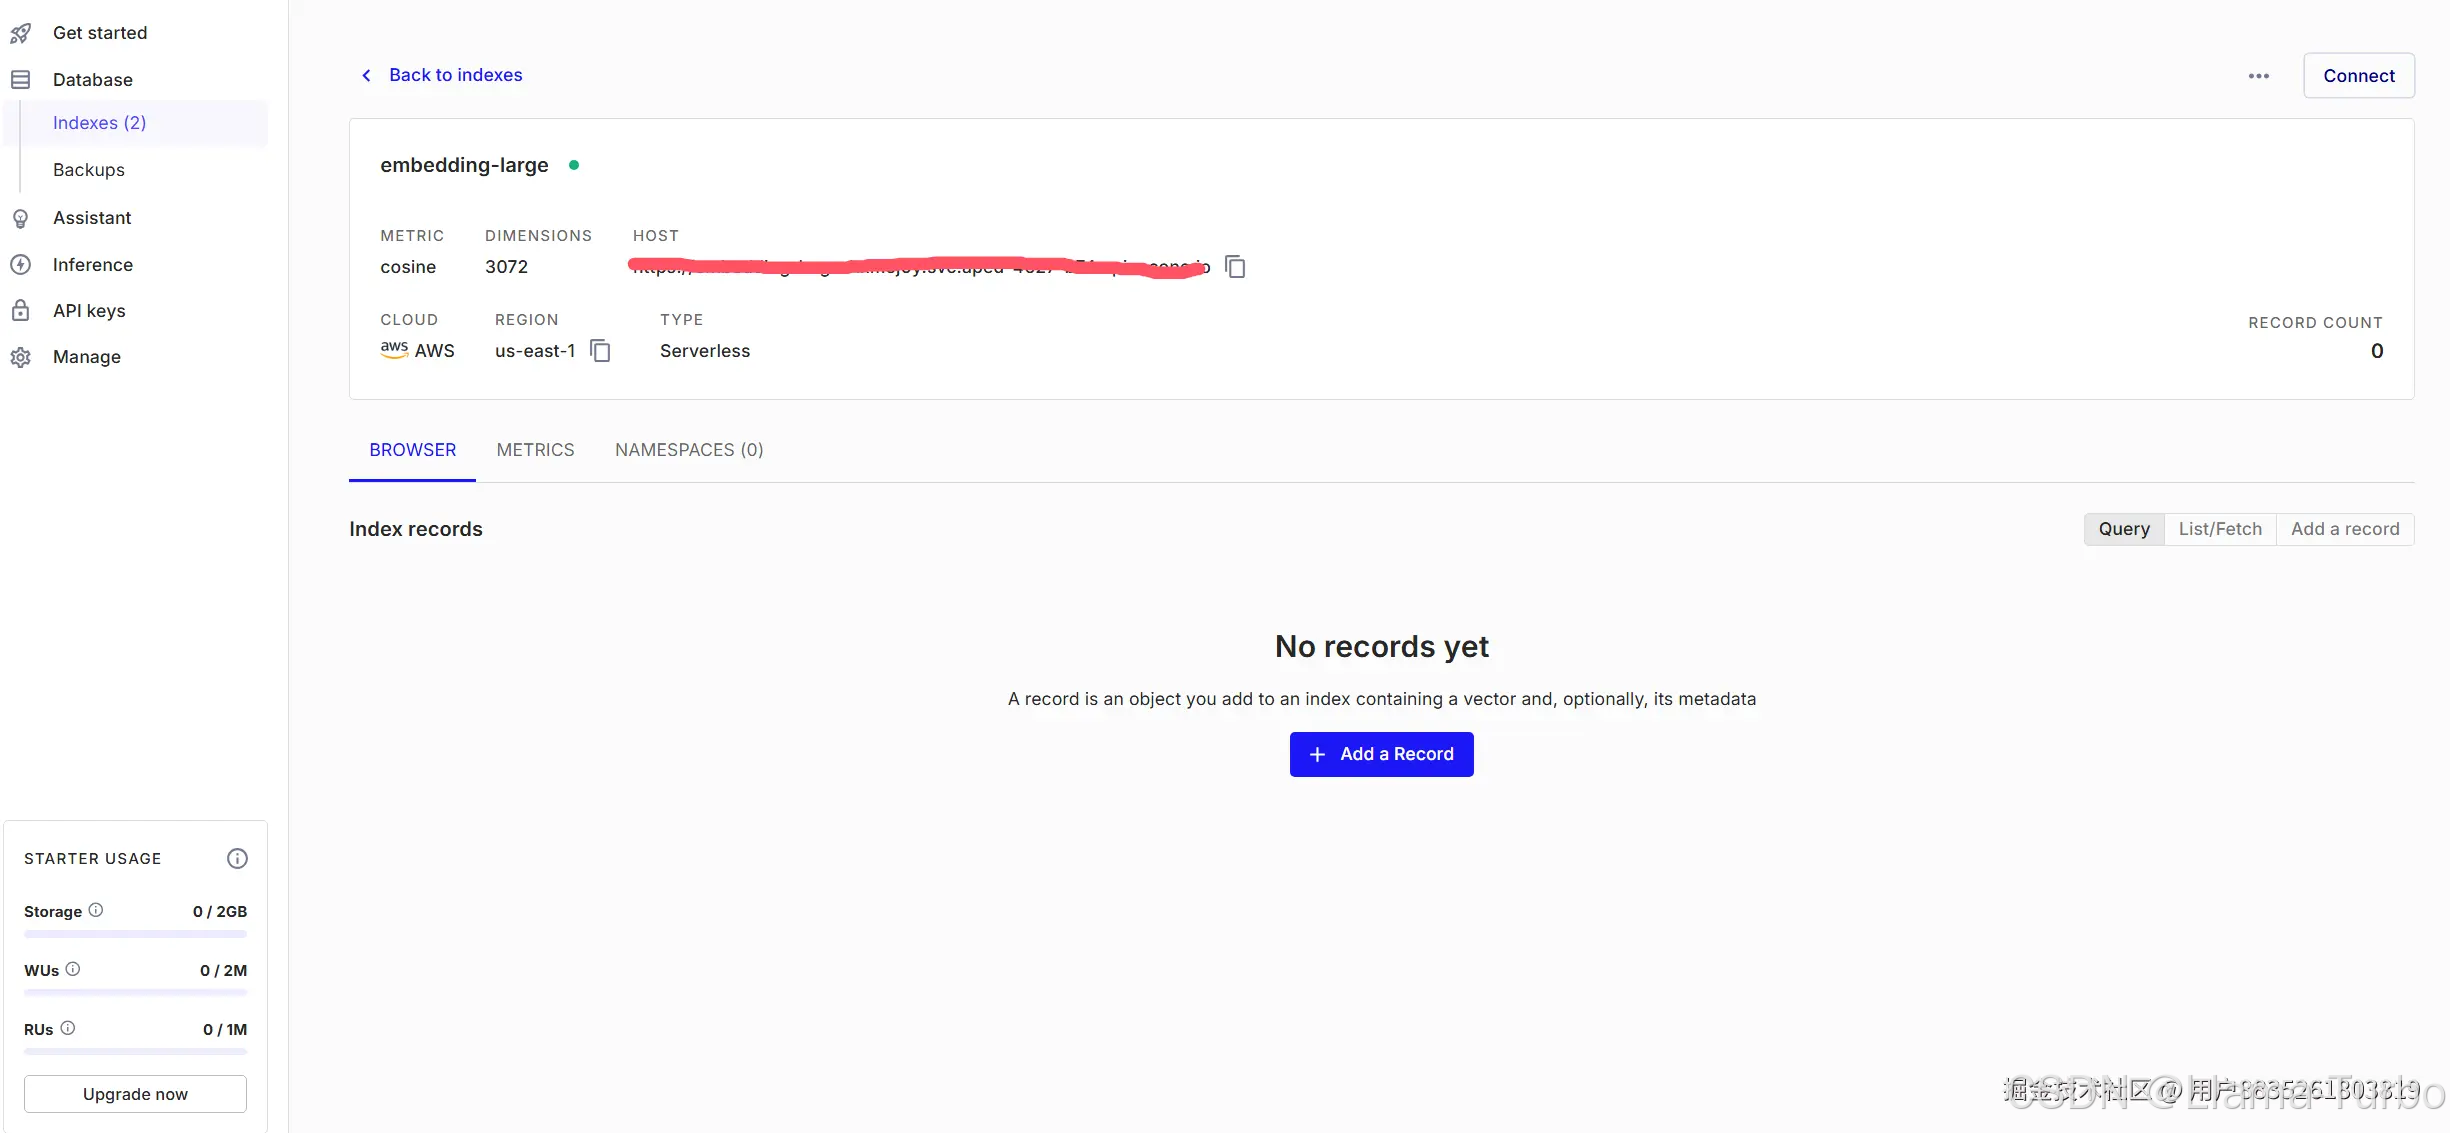
创建完成后,记录自己的Host,我们后面要用到
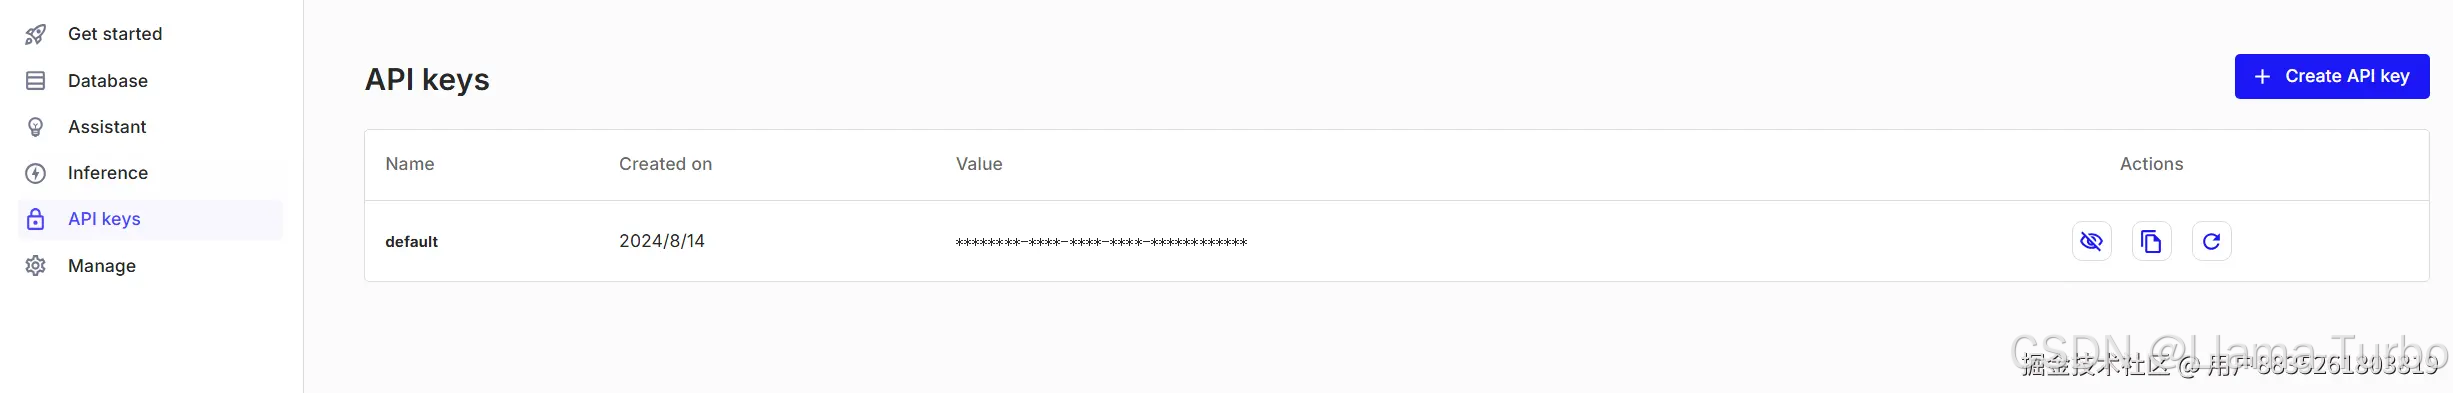
创建自己的API Key
引入AI4J依赖
<!-- Spring应用 -->
<dependency>
    <groupId>io.github.lnyo-cly</groupId>
    <artifactId>ai4j-spring-boot-stater</artifactId>
    <version>0.6.3</version>
</dependency>
注意版本,尽量选择最新的版本。0.6.3之前的版本对RAG的实现有一些bug
如果你使用阿里源无法引入,可能是阿里云镜像还没有同步。
配置application.yml
注意:
你需要填写上文Pinecone提供的Host和API Key。
由于目前版本的AI4J只实现了OpenAi的Embedding服务,所以这里也需要配置OpenAi的信息。
Chat服务可以使用OpenAi的也可以使用其它的平台如Ollama、Zhipu等等。
如果没有OpenAi的官方key,大家可以使用中转API [低价中转平台] 低价ApiKey
搭建RAG服务Test类
这里以一个简单的Test类来演示,大家可以比葫芦画瓢自己搭建Controller。
建立RAG知识库
既然要建立RAG应用,那肯定少不了知识库。
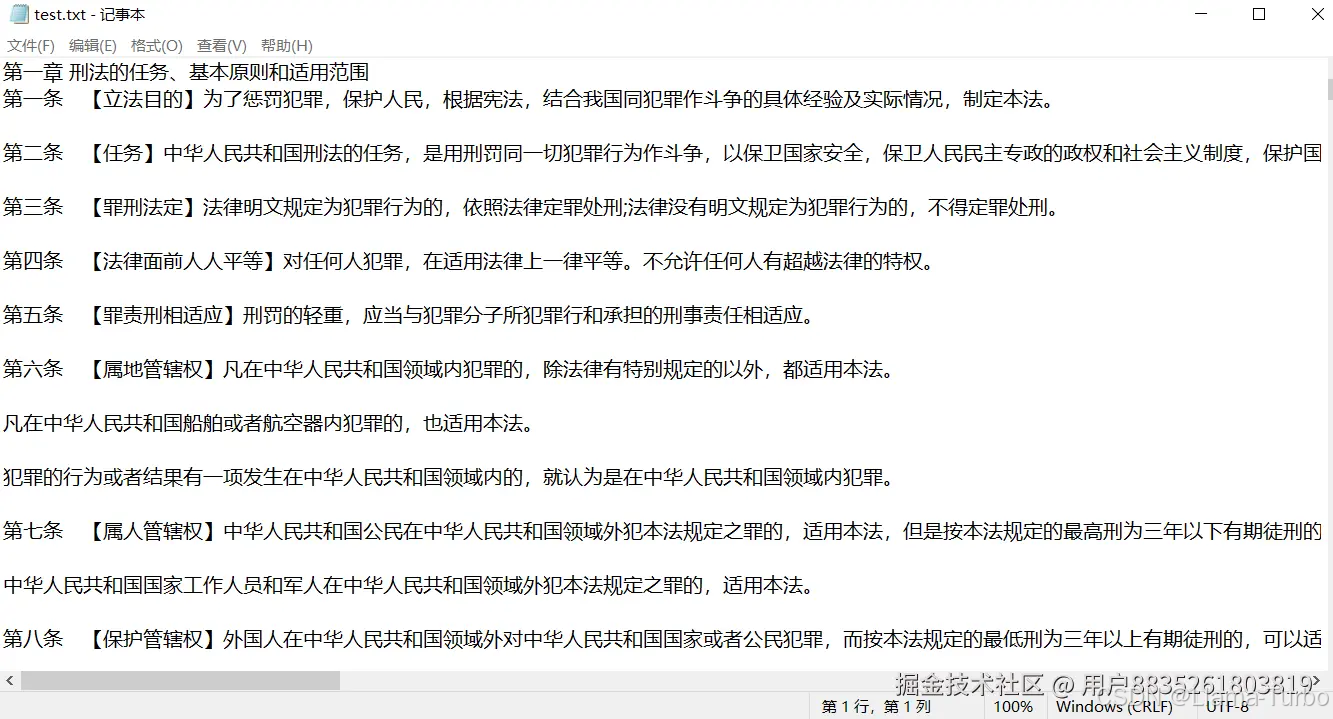
本文搭建的是一个简单的法律AI助手,所以我们需要一个法律知识库。
接下来我以刑法知识库为例为大家讲解
可以将所需要的知识库,存入一个文本文档当中:
存储至Pinecone向量数据库中
@SpringBootTest
public class RagTest {

    // 1. 注入Pinecone服务
    @Autowired
    private PineconeService pineconeService;

    // 2. 注入AI服务
    @Autowired
    private AiService aiService;

    @Test
    public void test_rag_store() throws Exception {
        // 3. 获取Embedding服务
        IEmbeddingService embeddingService = aiService.getEmbeddingService(PlatformType.OPENAI);

        // 4. Tika读取file文件内容
        String fileContent = TikaUtil.parseFile(new File("D:\\data\\test.txt"));
        System.out.println(fileContent);

        // 5. 分割文本内容
        RecursiveCharacterTextSplitter recursiveCharacterTextSplitter = new RecursiveCharacterTextSplitter(1000, 200);
        List<String> contentList = recursiveCharacterTextSplitter.splitText(fileContent);
        System.out.println(contentList.size());

        // 6. 转为向量
        Embedding build = Embedding.builder()
                .input(contentList)
                .model("text-embedding-3-large")
                .build();
        EmbeddingResponse embedding = embeddingService.embedding(build);
        List<List<Float>> vectors = embedding.getData().stream().map(EmbeddingObject::getEmbedding).collect(Collectors.toList());

        VertorDataEntity vertorDataEntity = new VertorDataEntity();
        vertorDataEntity.setVector(vectors);
        vertorDataEntity.setContent(contentList);
        System.out.println(vertorDataEntity);

        // 7. 向量存储至pinecone
        Integer count = pineconeService.insert(vertorDataEntity, "abc-123-abc");
        System.out.println(count > 0 ? "存储成功" : "存储失败");
    }

}
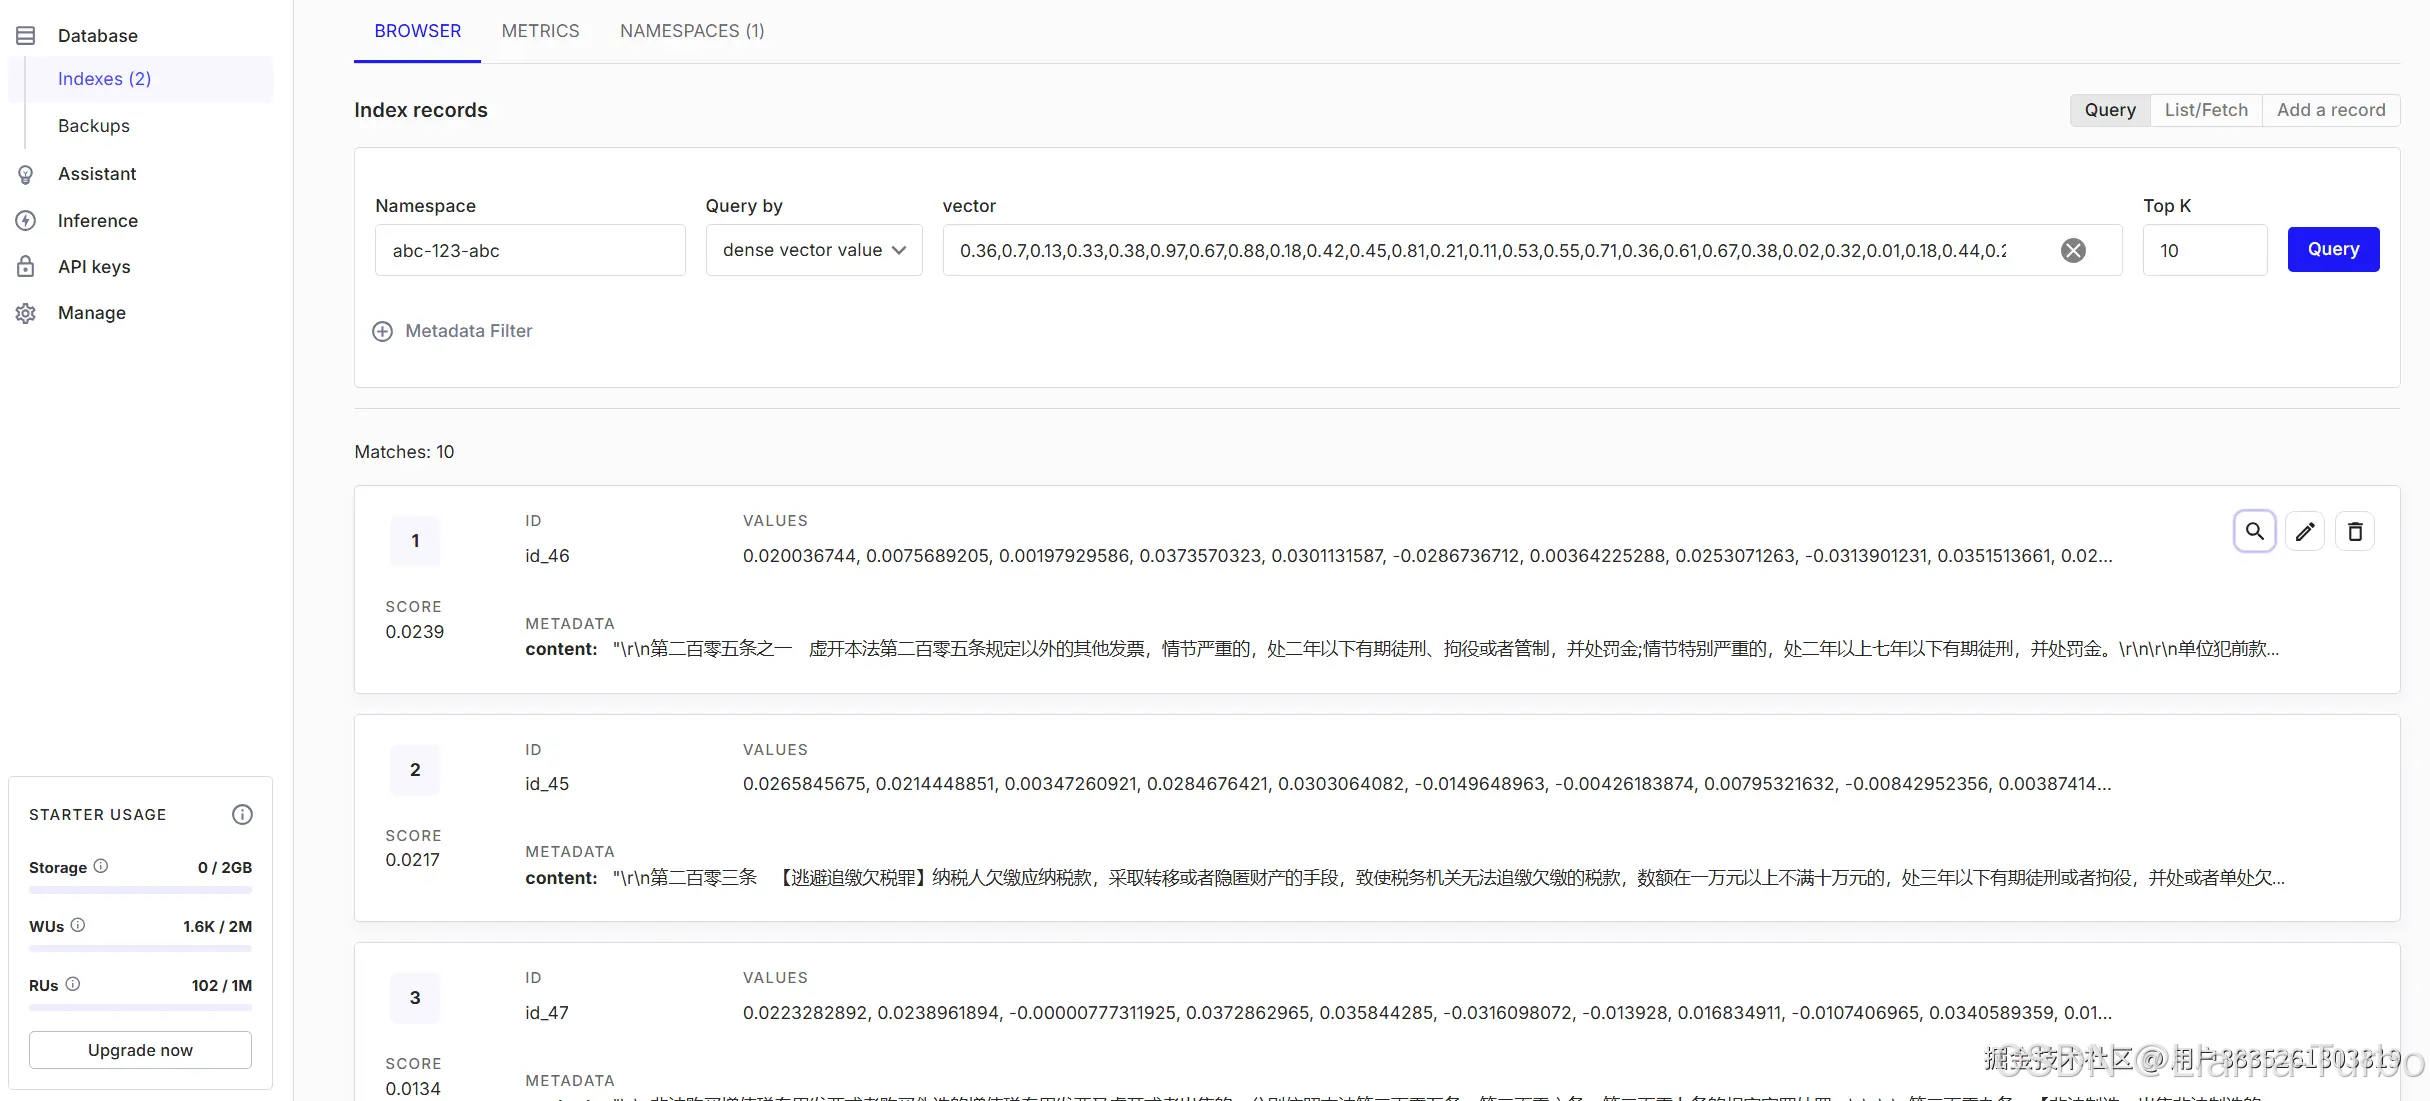
下图是插入成功的数据
RAG查询
    @Test
    public void test_rag_query() throws Exception {
        // 8. 获取Embedding服务
        IEmbeddingService embeddingService = aiService.getEmbeddingService(PlatformType.OPENAI);

        // 9. 构建要查询的问题,转为向量
        String question = "如何挑选最甜的西瓜?";

        Embedding build = Embedding.builder()
                .input(question)
                .model("text-embedding-3-large")
                .build();
        EmbeddingResponse embedding = embeddingService.embedding(build);
        List<Float> questionEmbedding = embedding.getData().get(0).getEmbedding();

        // 10. 构建向量数据库的查询对象
        PineconeQuery pineconeQueryReq = PineconeQuery.builder()
                .namespace("abc-123-abc")
                .topK(5)
                .vector(questionEmbedding)
                .build();

        // 11. 查询
        // PineconeQueryResponse queryResponse = pineconeService.query(pineconeQueryReq);
        // delimiter为想用什么字符拼接查询出来的内容
        String retrievalContent = pineconeService.query(pineconeQueryReq, " ");

        String contentFormat = "你是一个善于回答中华人民共和国刑法相关问题的助手。请使用以下提供的检索内容和自身知识来回答问题。如果你不知道答案,请直接说不知道,不要杜撰答案。请用三句话以内回答,保持简洁。\n" +
                "\n" +
                "问题:%s\n" +
                "\n" +
                "检索内容:%s";

        String content = String.format(contentFormat, question, retrievalContent);

        // 12. 获取Chat服务
        IChatService chatService = aiService.getChatService(PlatformType.OPENAI);

        // 13. 构建Chat请求
        ChatCompletion chatCompletion = ChatCompletion.builder()
                .model("gpt-4o")
                .message(ChatMessage.withUser(content))
                .build();

        // 14. 发送Chat请求
        ChatCompletionResponse chatCompletionResponse = chatService.chatCompletion(chatCompletion);
        System.out.println("问题:" + question);
        System.out.println("回答:" + chatCompletionResponse.getChoices().get(0).getMessage().getContent());
        System.out.println("花费tokens:" + chatCompletionResponse.getUsage().getTotalTokens());
    }
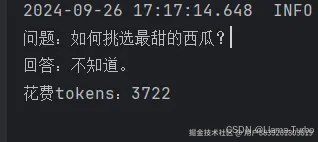
下图是测试的结果:

至此我们已经完成了一个RAG应用的搭建,大家可以根据自己的需求搭建自己的RAG应用。
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 433


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


