


很多同学只知类似Check GPT或者说对国内的一些比较了解,对国外的不太了解,所以在这总结。
1 大模型的发展
左表
| 名称 | 参数 | 特点 | 发布时间 |
|---|---|---|---|
| GPT-2 | 15亿 | 英文底模,开源 | 2019年 |
| Google T5 | 110亿 | 多任务微调, 开源 | 2019年 |
| GPT-3.5 | 1750亿 | 人工反馈微调 | 2022年 |
| Meta OPT | 1750亿 | 英文底模, 开源 | 2022年 |
| LLaMA | 70亿~650亿 | 最受欢迎的开源模型之一 | 2023年 |
| GPT-4 | 1.8万亿 | 史上最强大模型 | 2023年 |
| Vicuna-13B | 130亿 | 开源聊天机器人 | 2023年 |
| Falcon | 400亿 | 阿联酋先进技术研究委员会 | 2023年 |
| Claude 1.3 | 未公开 | Anthropic研发,注重安全和可靠性 | 2023年 |
| PaLM 2 | 未公开 | Google最新大模型 | 2023年 |
| Mistral | 7B, 13B | 强调性能和效率 | 2023年 |
| GPT-4-turbo | 未公开 | OpenAI更高效版本 | 2023年 |
| Claude 2 | 未公开 | 改进的上下文理解和任务执行能力 | 2023年 |
| LLaMA 2 | 70亿, 130亿, 700亿 | Meta开源的改进版本,商用更自由 | 2023年 |
| Gemini | 未公开 | Google的多模态AI模型 | 2023年 |
| Claude 3 | 未公开 | Anthropic的最新版本,包括Opus、Sonnet和Haiku | 2024年 |
| GPT-4o | 未公开 | OpenAI的GPT-4升级版 | 2024年 |
| Gemini Pro | 未公开 | Google Gemini的升级版 | 2024年 |
右表
| 名称 | 参数 | 特点 | 发布时间 |
|---|---|---|---|
| 百川智能 | 70亿 | 王小川, 开源 | 2023年 |
| 文心一言 | 2600亿 | 中文语料85% | 2023年 |
| 通义千问 | 70亿~700亿 | 总体相当GPT-3 | 2023年 |
| ChatGLM6B | 60亿 | 10B以下最强中文开源 | 2023年 |
| 腾讯混元 | 超千亿 | 腾讯出品多模态 | 2023年 |
| MOSS | 160亿 | 多插件, 开源 | 2023年 |
| Aquila | 70亿~330亿 | 首个中文数据合规 | 2023年 |
| PolyLM | 130亿 | 对亚洲语言友好 | 2023年 |
| 讯飞星火 | 未公开 | 科大讯飞出品,多模态 | 2023年 |
| ChatGLM2-6B | 60亿 | ChatGLM升级版,更强性能 | 2023年 |
| 天工 | 未公开 | 昆仑万维与奇点智源合作 | 2023年 |
| 360智脑 | 未公开 | 360公司出品 | 2023年 |
| MiniMax | 未公开 | 前百度高管创立 | 2023年 |
| ChatGLM3 | 60亿,130亿 | 更强的多轮对话能力 | 2024年 |
| 文心一言4.0 | 未公开 | 百度升级版,多模态增强 | 2024年 |
| 通义千问2.0 | 未公开 | 阿里云升级版 | 2024年 |
| 腾讯混元2.0 | 未公开 | 腾讯升级版 | 2024年 |
Google T5 -> GPT-3 -> GLM130B -> LLaMa -> GPT-4 -> Falcon -> GPT-4v
发展角度,LLM最早基本在2017年左右,其实最早所有的LLM都是基于谷歌的Transformer架构设计。2017年谷歌发布它的T5模型,后续不断有新的这样LLM衍生出来。包括GPT-2、GPT-3、GLM-130B以Facebook为代表的这个开源的LaMa,还有后来GPT-4及中东的科研机构开发的这个FanCL及最新GPT4,包括多模态模型。
2 国外与国内大模型
表格左边主要是国外的一些常见LLM,右边是国内厂商。
发布时间看,海外比我们要早些,能够叫得上的或用的比较多的都是在2023年才开始发布。
3 参数与模型能力
先看国外的,第一个GPT-2大概15亿的参数。
参数是啥?
LLM的所谓参数,代表一个模型的复杂程度,参数越大,也就说它需要的容量空间,它需要的算力也就越大,那相应的能力就越强。
参数越小,它需要的算力就越小,能力相对较弱,能力强弱,主要通过它的回答或提炼问题的能力,就能看出来。
谷歌T5大概有110亿的参数,特点就是它可以实现多任务的一个微调,它是开源的。GPT主要是OpenAI的,GPT-3.5出来后,市面震惊,因为它的效果非常好,但是我们可以看到它的参数也是非常可怕,达到1750亿。所以说它的需要的算力非常多,它就能支持人工反馈的微调。
随后就是Meta公司即Facebook,就它也出品了,它的模型大概1750亿,底模是英文的。
底模是啥?
大模型预训练时,有个预训练过程,需要大量语料,如大量用英文材料,那底模就是英文,那它在它基础上做英文的一些问题回答,效果较好。
LLaMA也叫羊驼,https://www.alpacaml.com/:
目前比较主流的一个开源模型,目前开源里参数较大,效果较好的,最受欢迎的开源LLM之一。 GPT4最新出,但它最新的参数没变化,但底模数量会较大。GPT-4我们看到它的参数达到1.8万亿,号称史上最强。
比如说GPT的底模里有中文语料,所以它足够大,涵盖基本所有互联网知识,GPT-3.5截止2021年之前互联网知识,4把知识库呢更新到2023年。所以它涵盖的语言种类比较多。
再看右边国内的。
首先百川智能,王小川搞的,参数70亿,相当于羊驼水平。
百度文心一言就相对比较大,百度搞AI投入还是比较大的,参数2600亿,中文语料占到85%。
阿里通义千问参数在70~700亿之间,总体能力相当于GPT-3,国内还是稍差。
GLM-6B大概60亿的参数,清华大学的团队。目前国内或国际100亿以下最强中文开源模型,100亿参数窗口之下效果最好的目前是它,真的不错。
腾讯混元,具体参数没公布,大概超千亿,支持多模态。
多模态啥意思?
不光有文字文本生成,还有图像生成,文到图图到文啊等等就是各种模态支持。它的底模或者它的预训练更复杂,不光可能训练文字,还训练图片,支持多插件的开源模型。
基本上各有特点,但国内有两大特点:
- 时间稍晚,基本到2023年发布
- 中文支持相对的都比海外的这些模型好很多
商用角度,开源模型其实不太理想,LaMa不支持商用,但GLM都可商用,包括百川、FanCL都可商用。
4 大模型的生态
百模大战,千模大战多模型大战,就是由OpenAI引爆。
Hugging Face,抱脸,相当于AI界GitHub。很多开源模型可以找到:
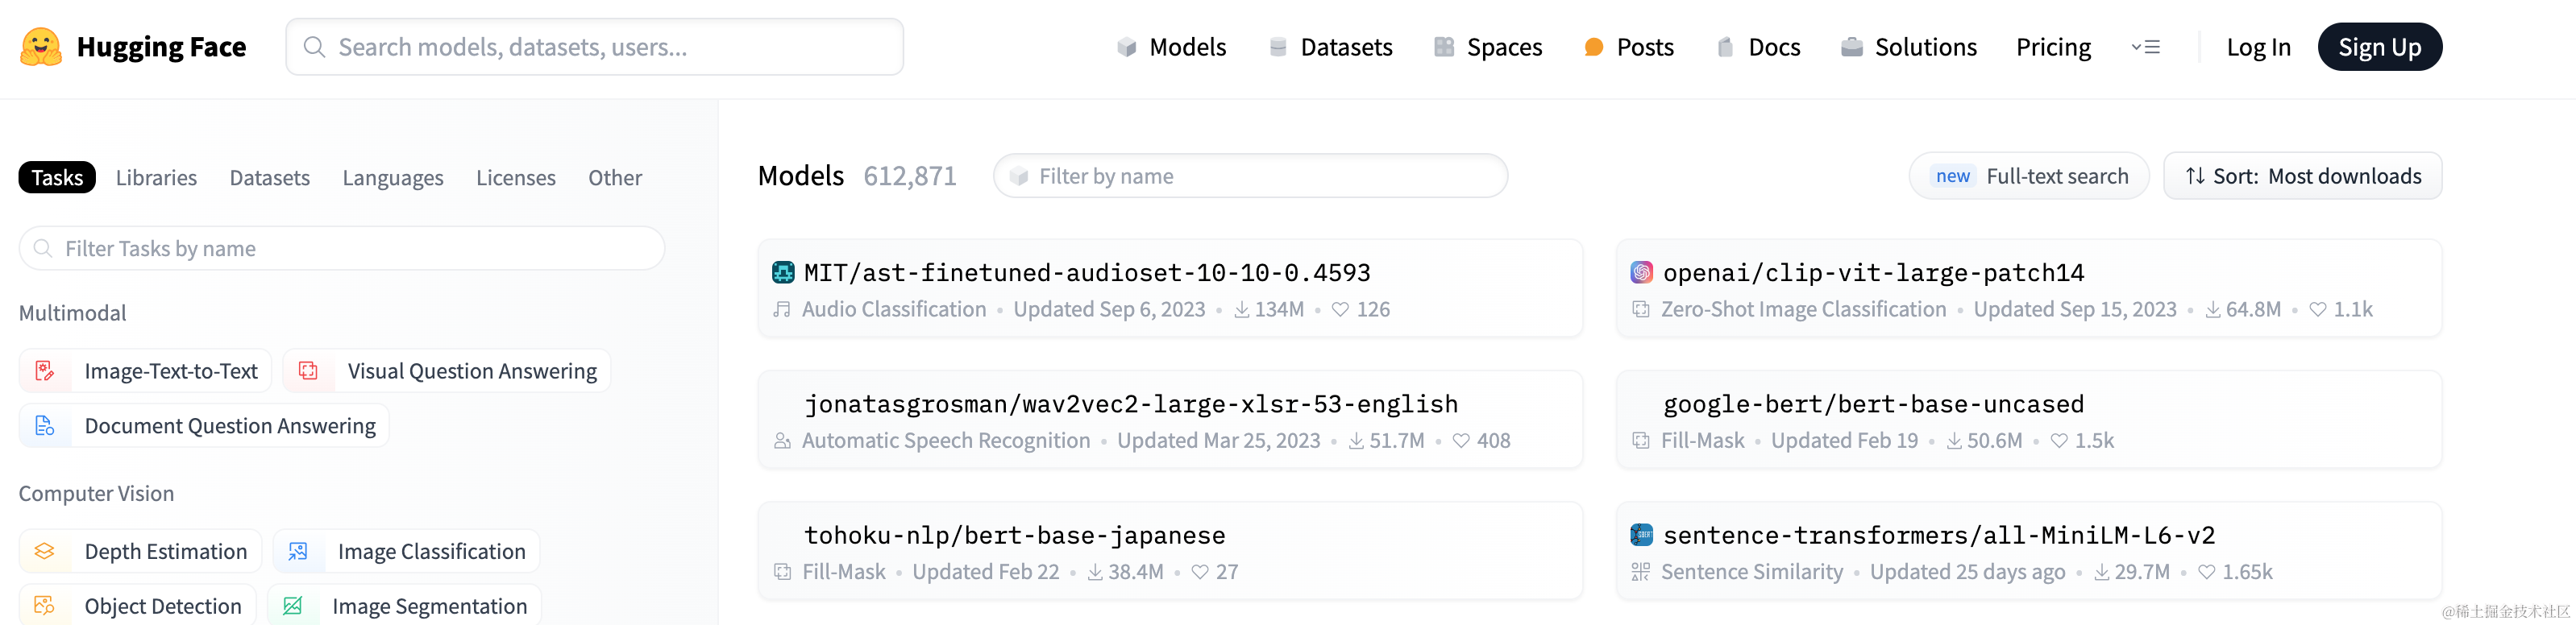
可见整个LLM发展生态繁荣。
5 清华团队在PupilFace的主页
ChatGLM就是清华团队的,他们在PupilFace上面的一个主页。我们可以看到他们的作品。
已创建的LMs(Large Models,大型模型),LLM像ChatGLM、WebGLM 130B等,还有一些相应工具,包括预训练的这些图训练的神经网络。https://huggingface.co/THUDM/chatglm3-6b:
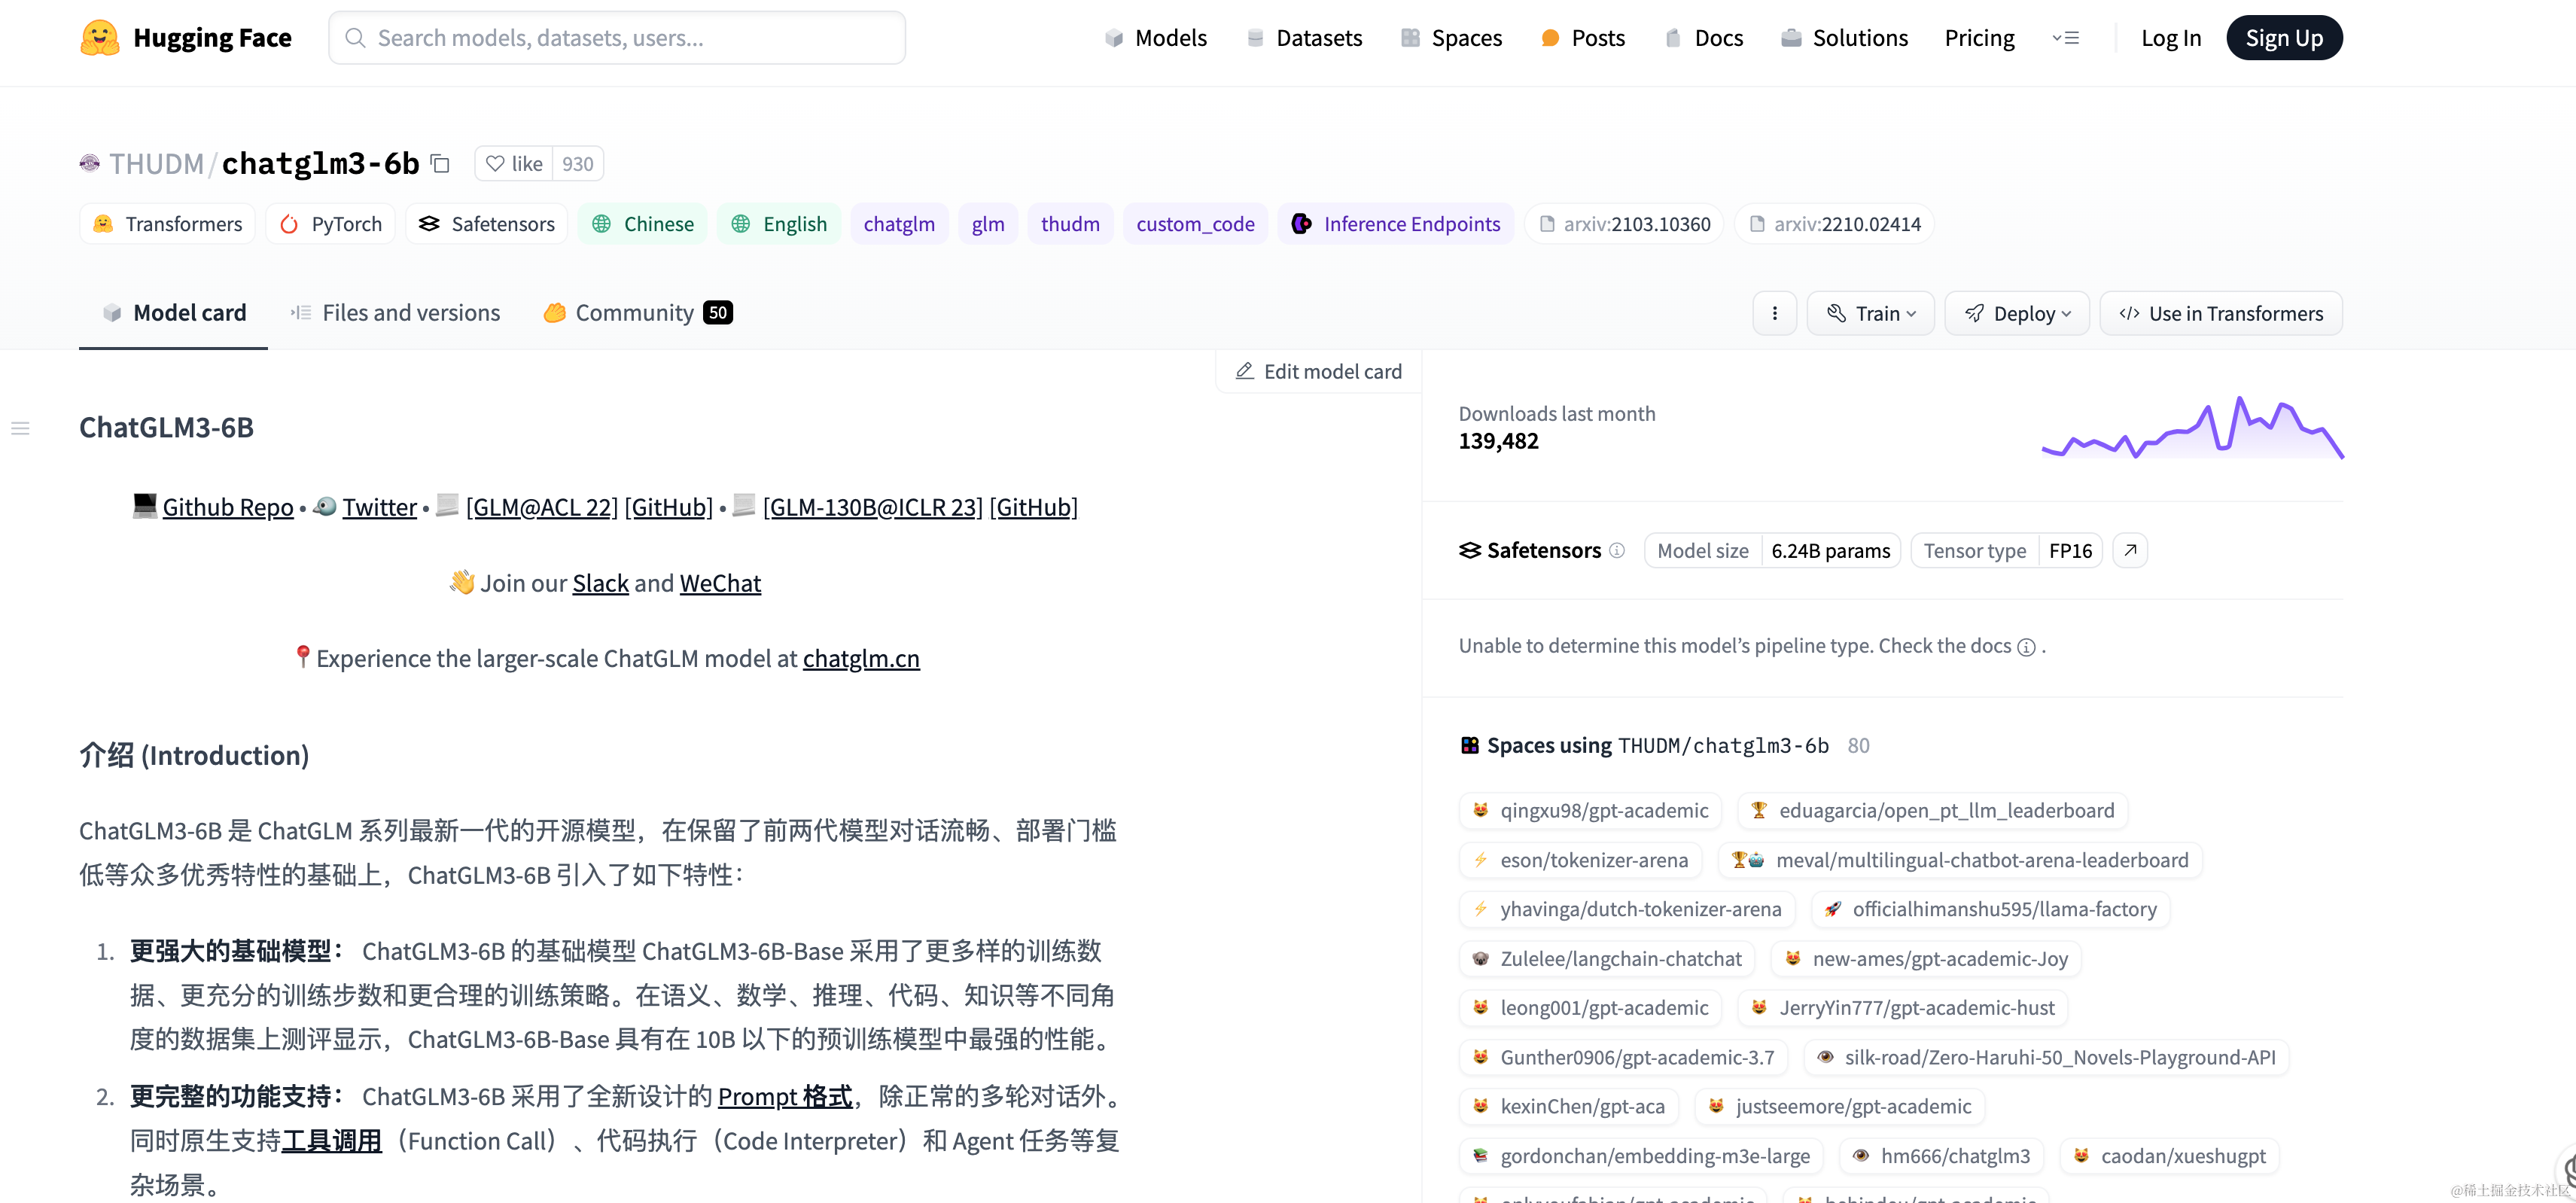
可以看到它的6B(6 billion,60亿参数),32K(可能指模型的某种配置或版本),然后包括7B(7 billion,70亿参数),13B(13 billion,130亿参数)。最强130B(130 billion,1300亿参数)。
整个大模型确实非常多,每个模型都有自己的特色。
6 商用许可
| 大模型名称 | 参数 | 是否可商用 |
|---|---|---|
| ChatGLM | 6B, 1T | 可商用 |
| ChatGLM2 | 6B, 1T | 可商用 |
| LLaMA | 7B, 13B, 33B, 65B, 1T | 不可商用 |
| LLaMA2 | 7B, 13B, 33B, 65B, 2T | 可商用 |
| BLOOM | 1B7, 7B1, 176B-MT, 1.5T | 可商用 |
| Baichuan | 7B, 13B, 1.2T, 1.4T | 可商用 |
| Falcon | 7B, 40B, 1.5T | 可商用 |
| Qwen | 7B, 7B-Chat, 2.2T | 可商用 |
| Aquila | 7B, 7B-Chat | 可商用 |
| Mistral | 7B, 13B | 可商用 |
| Gemma | 2B, 7B | 可商用 |
| Claude | 未公开 | 不可商用 |
| GPT-4 | 未公开 | 不可商用 |
| PaLM 2 | 未公开 | 不可商用 |
| Gemini | 未公开 | 不可商用 |
| BERT | 110M, 340M | 可商用 |
| RoBERTa | 125M, 355M | 可商用 |
| T5 | 60M, 220M, 770M, 3B, 11B | 可商用 |
| Gopher | 280B | 不可商用 |
如何系统的去学习AI大模型LLM ?
作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。
但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
所有资料 ⚡️ ,朋友们如果有需要全套 《LLM大模型入门+进阶学习资源包》,扫码获取~

一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。


四、AI大模型商业化落地方案

阶段1:AI大模型时代的基础理解
- 目标:了解AI大模型的基本概念、发展历程和核心原理。
- 内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践 - L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
- 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
- 内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例 - L2.2 Prompt框架
- L2.2.1 什么是Prompt
- L2.2.2 Prompt框架应用现状
- L2.2.3 基于GPTAS的Prompt框架
- L2.2.4 Prompt框架与Thought
- L2.2.5 Prompt框架与提示词 - L2.3 流水线工程
- L2.3.1 流水线工程的概念
- L2.3.2 流水线工程的优点
- L2.3.3 流水线工程的应用 - L2.4 总结与展望
- L2.1 API接口
阶段3:AI大模型应用架构实践
- 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
- 内容:
- L3.1 Agent模型框架
- L3.1.1 Agent模型框架的设计理念
- L3.1.2 Agent模型框架的核心组件
- L3.1.3 Agent模型框架的实现细节 - L3.2 MetaGPT
- L3.2.1 MetaGPT的基本概念
- L3.2.2 MetaGPT的工作原理
- L3.2.3 MetaGPT的应用场景 - L3.3 ChatGLM
- L3.3.1 ChatGLM的特点
- L3.3.2 ChatGLM的开发环境
- L3.3.3 ChatGLM的使用示例 - L3.4 LLAMA
- L3.4.1 LLAMA的特点
- L3.4.2 LLAMA的开发环境
- L3.4.3 LLAMA的使用示例 - L3.5 其他大模型介绍
- L3.1 Agent模型框架
阶段4:AI大模型私有化部署
- 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
- 内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
学习计划:
- 阶段1:1-2个月,建立AI大模型的基础知识体系。
- 阶段2:2-3个月,专注于API应用开发能力的提升。
- 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
- 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的所有 ⚡️ 大模型 LLM 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
全套 《LLM大模型入门+进阶学习资源包》↓↓↓ 获取~
 386


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


