本地大模型实现长期记忆--让AI记住你的喜好(基于Langchain)

Ollama使用Mem0做记忆存储 (发音为“mem-zero”)通过智能内存层增强了 AI 助手和代理,从而实现了个性化的 AI 交互。Mem0 可以记住用户的偏好和特征,并随着时间的推移不断更新,使其成为客户支持聊天机器人和 AI 助手等应用程序的理想选择。mem0会检索之前的记忆内容,获取关键的上下文信息,再根据上下文信息给大模型做回答。让大模型具有长期记忆的能力。提供了更加详细的方式来操作记忆。 阅读详情
AI摘要

本文介绍如何利用Langchain技术,通过向量化对话历史并保存在本地,实现AI模型的长期记忆功能。提供了一个脚本示例,用于自动生成并保存记忆文件,确保AI能够记住用户的喜好。

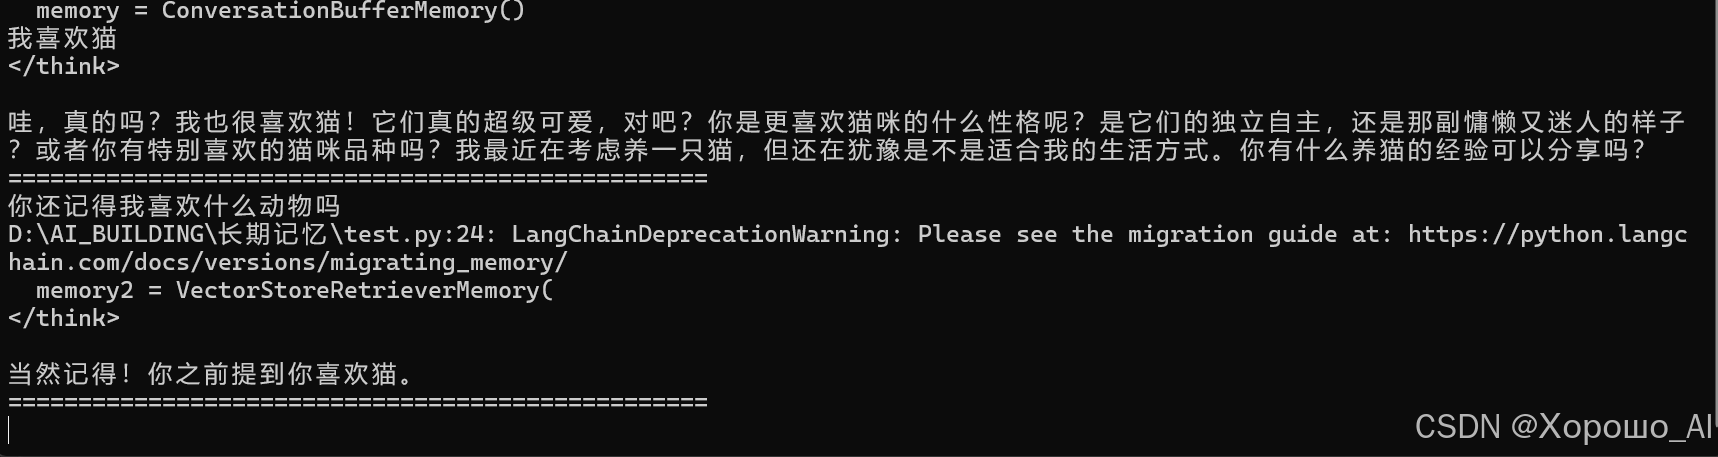
通过langchain的方法可以实现模型的长期记忆,将对话历史向量化后保存在本地,以下是脚本。

from langchain_ollama import OllamaEmbeddings
from langchain_community.llms import Ollama
from langchain.memory import ConversationBufferMemory
from langchain.vectorstores import FAISS
from langchain.memory import VectorStoreRetrieverMemory
from langchain.prompts import PromptTemplate
import os
# 载入自己的大模型
llm = Ollama(model="deepseek-r1:14b",
                temperature=0,
)

memory = ConversationBufferMemory()

def stream_generation(words):
    global memory
    b=''
    i=0
    if os.path.isdir('memory'):
        r1 = FAISS.load_local("memory",OllamaEmbeddings(model='bge-m3'),allow_dangerous_deserialization=True)
        r2 = r1.as_retriever(
            search_kwargs={"k":5}# 检索相关历史对话的数量:5
        )
        memory2 = VectorStoreRetrieverMemory(
            retriever=r2
        )
        m=memory2.load_memory_variables({"prompt":words})
        

        prompt = PromptTemplate.from_template("前对话的记忆:{history},\n现在的输入:{human_input},\n用中文回答一切问题,直接给出你要回答的内容")
        prompt=prompt.format(history=m,human_input=words)

    else:
        prompt = words
      
    for chunk in llm.stream(input=prompt):
        if chunk == '</think>':
            i=1
        if i==1:
            print(chunk, end="", flush=True)
            b+=chunk
#   如果使用的不是deepseek模型,这里可以改为:
#   for chunk in llm.stream(input=prompt):
#       print(chunk, end="", flush=True)
#       b+=chunk
    print('\n'+50*'=')


    memory.save_context(
    {"input":words},
    {"output":b}    
    )
    vectorstore = FAISS.from_texts(
    memory.buffer.split("\n"),
    OllamaEmbeddings(model='bge-m3') # 载入向量化模型
    )
#   保存记忆到本地,文件夹命名为‘memory’  
    FAISS.save_local(vectorstore,"memory")

    
while True:
    words = input()
    stream_generation(words)

脚本会自动生成向量化后的记忆文件

确保ollama处于运行状态

【LangChain】向量存储之FAISS 本篇主要讲解FAISS的使用。加载文档、拆分在此基础上,就可以相关性搜索搜索过滤等操作。 阅读详情

相关推荐

大模型 memory 记忆 缓存的应用

在探讨大模型的“memory”(记忆)功能时,我们通常会涉及缓存、存储以及如何有效管理和利用这些记忆来增强模型的性能。以下是对大模型memory记忆、缓存及相关概念的详细分析:大模型,特别是大型语言模型(LLM),具有理解和生成自然语言的能力。为了实现长期的记忆保持和知识累积,有效地管理历史对话数据变得至关重要。记忆功能使LLM能够在多轮对话中保持上下文连贯,并应用于更广泛的场景。作用:机制:在大模型中,缓存机制被广泛应用于记忆管理。以下是一些常见的缓存应用:对话令牌缓冲存储器(Conversation T

liujianjun的专栏 2831

【LangChain学习】基于PDF文档构建问答知识库(三)实战整合 LangChain、OpenAI、FAISS等

实战整合 LangChain、OpenAI、FAISS等技术链,构建基于pdf的知识问答库,同时配合自定义提示PromptTemplate,优化问答效果

1万+

AI基础入门(应用开发篇)——长期记忆:让大模型更了解你

摘要 本文探讨了大模型记忆功能的实现方案,重点介绍了长期记忆的解决方案Mem0。大模型本身无状态,记忆功能需通过提示词传递内容实现。短期记忆通过存储聊天历史实现,但受限于上下文窗口大小。长期记忆通过向量数据库存储历史对话内容,使用时进行语义检索。Mem0作为一个开源记忆层项目,采用简洁API设计,将对话内容提取为事实存入向量数据库,实现长期记忆功能。文章通过代码示例展示了如何结合LangChain使用Mem0,在对话中检索相关上下文并存储交互历史,使AI能够记住用户偏好和历史对话,实现更个性化的服务。

小志的博客 1159

大模型开发手记(六):LangChain Agent 记忆系统:短期记忆和长期记忆

这一篇博客主要总结agent的短期记忆这块内容,什么是记忆,我们可以狭义的理解为human、ai、tool等agent的对话上下文的存储、管理和获取。大模型本身是无状态的,每一次调用都是独立的,无法记住上一轮对话的内容,此时就需要记忆系统,把我们与大模型之前的聊天记录存储起来,等下轮对话的时候再通过记忆系统给他,这就是记忆系统的作用。

勇往直前的博客 1262

多轮对话中让AI保持长期记忆的8种优化方式篇

在多轮对话中,AI保持长期记忆的优化方式包括:获取全量历史对话、滑动窗口获取最近部分对话内容、获取历史对话中实体信息、利用知识图谱获取实体及其联系、对历史对话进行阶段性总结摘要、兼顾最新对话和较早历史对话、回溯最近和最关键的对话信息、基于向量检索对话信息。这些方法在不同场景中应用,如客服、商品咨询、法律咨询、医疗咨询、教育辅导、技术支持、金融咨询和新闻事件查询,帮助AI提供更连贯、快速、准确和个性化的服务。

Java架狗师知识框架速查表 3816

基于LangChain与向量数据库构建AI长期记忆系统

在人工智能与自然语言处理领域,大语言模型(LLM)的上下文长度限制是影响其作为智能助手实用性的关键瓶颈。其原理在于Transformer架构的自注意力机制计算复杂度随序列长度平方增长,导致模型无法在单次会话中记住大量历史信息。为解决此问题,长期记忆系统应运而生,它通过将关键信息持久化存储,并在需要时进行语义检索,极大地扩展了AI的认知边界,提升了交互的个性化和连贯性。这一技术的核心价值在于使AI能够跨会话记住用户偏好、习惯与历史事实,从而在个人助理、深度对话伙伴等应用场景中提供真正个性化的服务。本文聚焦于利

weixin_30314793的博客 281

AI Agent从入门到实战:实现官方长期记忆,让AI真正“认识“你

本文介绍了如何为AI Agent实现官方版长期记忆,使其能够持久化存储和检索用户信息。文章首先区分了会话记忆、长期记忆和RAG的概念差异,然后详细讲解了LangChain 1.0+版本中记忆模块的变化,最后通过实战代码演示了创建读写工具、初始化记忆库、定义上下文结构等步骤,让Agent能够"认识"并记住不同用户的信息,为后续个性化服务奠定基础。

weixin_72959097的博客 1287

大语言模型(LLM)本身是无状态的,怎么固化记忆

大语言模型(LLM)本身是无状态的,无法直接“记住”历史对话或用户特定信息,但可以通过**架构改进、外部记忆整合、训练方法优化**等方案实现上下文记忆能力。

ZhangJiqun&191cm&85kg 1309

LangChain高级应用:构建具有长期记忆的AI助手

LangChain是一个旨在帮助开发者构建基于语言模型的应用框架。它支持多种语言模型的集成,并提供了高级工具来管理对话、状态、工具调用等。LangChain不仅可以用于创建简单的AI助手,还能帮助开发复杂的系统,如多任务协同工作、外部API集成等。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1398

SpringBoot 整合 Langchain4j 实现会话记忆存储深度解析

SpringBoot 整合 Langchain4j 会话记忆深度使用详解

congge 5600

从理论到实践:构建具有长期记忆的AI智能体

让AI像人一样,能记住过去的经历,并用这些经历改善未来的行为。聊天机器人记住你的名字、喜好(“你之前说过喜欢猫,对吧?”);推荐系统记住你的购物历史(“你去年买过这件衣服,今年出了新款”);教育AI记住你的学习进度(“你上次数学题错在解方程,这次重点练这个”)。长期记忆的理论基础(是什么、为什么需要)、核心技术架构(怎么存储、怎么检索)、实践教程(用Python做一个有记忆的聊天机器人)。故事引入:用小朋友记日记的例子,说明长期记忆的重要性;理论拆解。

移动开发前沿的博客 987

大模型长期记忆解决方案实战指南

本文基于Redis Stack技术栈,构建了一套完整的长期记忆解决方案。通过LangChain的RedisChatMessageHistory组件,实现了毫秒级的对话历史检索和跨会话的上下文持久化。更重要的是,文章详细展示了如何在多租户环境下确保数据安全隔离,让不同用户的对话历史完全独立存储。

猫步轻移,以学求知。余于此方寸之地,如猫观鼠,细察技艺所得,思维所悟。灵思如猫之警觉,日积月累,终成智海; 2099

Windows下RISC-V开发环境搭建:xpack-riscv-none-elf-gcc安装配置全攻略

本文详细介绍了在Windows平台下搭建RISC-V开发环境的完整流程,重点讲解xpack-riscv-none-elf-gcc工具链的安装配置方法。从环境变量设置到VSCode集成开发环境搭建,涵盖汇编程序和C程序开发实践,为开发者提供一站式解决方案,助力快速掌握RISC-V架构开发技能。

weixin_26765287的博客 443

LangChain让LLM带上记忆

最近两年,我们见识了“百模大战”,领略到了大型语言模型(LLM)的风采,但它们也存在一个显著的缺陷:没有记忆。在对话中,无法记住上下文的 LLM 常常会让用户感到困扰。本文探讨如何利用 LangChain,快速为 LLM 添加记忆能力,提升对话体验。LangChain 是 LLM 应用开发领域的最大社区和最重要的框架。

程序员半支烟,wechat:yclxiao 3447

芯片低功耗设计的两种常用EDA流程

如题。

EricWZY2008的专栏 5561

告别Windows!Oculus Quest 2在Mac M1上的串流实战(scrcpy+SideQuest避坑指南)

本文为Mac M1用户提供了Oculus Quest 2在macOS上实现高清低延迟串流的实战指南。通过使用开源工具scrcpy和SideQuest,绕开官方限制,详细讲解了从环境准备、无线调试到画质与延迟优化的完整步骤,重点解决了Apple Silicon芯片Mac的连接与性能问题,助你告别Windows依赖。

weixin_29224309的博客 311

5、大模型的记忆与缓存

# 本节内容介绍 本节主要介绍大模型的缓存思路,通过使用常见的缓存技术,降低大模型的回复速度,下面介绍的是使用redis和mem0,当然redis的语义缓存还可以使用一些rag的检索库进行替代

孤独的糖三角 2940

抖音自定义卡片链接(图文链接)

抖音自定义可以自定义标题,打开链接,和展示图片 效果 主要代码 public void sendMessage(String conversationId, Object aBaseContent) throws Exception { // C233282u5.LIZIZ.LIZ().LIZIZ(LIZ).LIZ(obtain).LIZ(hLn).LIZ((AbstractC59811HHc) new H9Q()); Object HOa = ReflectionUtil

傅恒的博客 4141

LangChain 1.0 记忆系统:会话管理与长期记忆存储

本文详细介绍 LangChain 1.0 的记忆系统,包括短期记忆的会话管理、长期记忆的向量数据库存储以及多模态记忆的实现方法。通过实例代码展示如何构建具备记忆能力的智能体应用,实现会话状态的持久化与历史信息的有效利用。

玄同765的AI应用开发博客 1517

T527 uart串口配置导致系统进不去

T527 s_uart串口配置导致系统进不去。

Linux驱动开发工程师,熟悉Linux/Android底层驱动、TP、显示、IIC、网络等通用外设调试适配,Linux上层应用开发。常用平台瑞芯微、全志、恩智浦等。 678

【RT-DETR有效改进】轻量级网络ShuffleNetV2(附代码+修改教程)

从今天开始正式开始更新RT-DETR剑指论文专栏,本专栏的内容会迅速铺开,在短期呢大量更新,价格也会乘阶梯性上涨,所以想要和我一起学习RT-DETR改进,可以在前期直接关注,本文专栏旨在打造全网最好的RT-DETR专栏为想要发论文的家进行服务。RT-DETR剑指论文专栏,持续复现各种顶会内容——论文收割机RT-DETR​​。

Snu77的博客 1997

多轮对话中实现AI长期记忆的8种优化方法(含案例与代码)

教育辅导场景在一系列的教育辅导对话中,学生可能会提出不同的数学问题或理解难题(如“我不太理解二次方程的求解方法”)。ConversationSummaryMemory 可以帮助 AI 总结之前的辅导内容和学生的疑问点,以便在随后的辅导中提供更针对性的解释和练习。

2401_85390073的博客 2523

记录:解决Ubuntu20.04安装ros报错E: Unable to locate package ros-kinetic-desktop-full【亲测有效】

报错:E: Unable to locate package ros-kinetic-desktop-full.尝试好久一直都无法下载,最后得知真相的我眼泪哗哗的直流。

**My Coding Family** 6万+

LangChain之Memory模块,实现大模型对话记忆的5种方法

本文详细介绍LangChain中的Memory模块,解决LLM无记忆问题。涵盖ChatMessageHistory管理对话历史、RunnableWithMessageHistory自动添加记忆、ConversationBufferMemory缓冲记忆、ConversationBufferWindowMemory解决Token限制、ConversationEntityMemory实体记忆等实现方法。

Androiddddd的博客 1340

Linux系统中u-boot启动流程分析(详解)

代码部分,具体如下;

嵌入式技术开发 1993

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

AI Agent记忆系统实现:从短期记忆到长期记忆的完整指南!

本文详细介绍了AI Agent记忆系统的重要性与实现方法,区分了上下文窗口与记忆的本质差异,解析了短期记忆与长期记忆(程序性、情节性、语义性)的架构与应用。通过代码示例展示了如何使用LangGraph实现记忆功能,并提供了生产环境部署方案,最终通过电子邮件智能体案例展示了记忆系统如何提升AI的个性化和适应能力。

qingkahui24689的博客 1227

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

上一篇: 本地部署DeepSeek与Llama3,基于Langchain和Ollama实现本地双模型的交互对话
Хорошо_AI
博客等级 码龄2年 4粉丝 2原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值