收藏必备:大模型微调全流程:从ChatGLM-6B到Qwen2.5-7B的实战指南

大模型微调实战:从LoRA到QLoRA,7种主流方法详解与选择指南 在人工智能领域,大模型微调是提升模型在特定任务上性能的关键技术。其核心原理是通过在预训练模型的基础上,使用特定领域数据对模型参数进行针对性调整,使模型从“通才”转变为“专才”。这项技术的核心价值在于,它能以远低于从头训练的成本,让通用大模型快速适应垂直场景需求,如企业知识问答、代码生成、风格化写作等。参数高效微调技术,特别是LoRA及其变种,通过冻结大部分原始参数、仅训练少量新增参数,在保持高性能的同时大幅降低了计算和存储开销。其中,LoRA利用低秩矩阵分解实现高效适配,而QLoRA进一步结合4-bit量化 阅读详情

本文系统总结了大模型微调的完整流程,从目标确定、数据准备到模型部署的7大步骤,详解了LoRA参数高效微调原理。无论你是初学者还是有一定经验的开发者,都能通过本文掌握微调大模型的核心技术与方法,提升模型在特定场景的性能表现。收藏本文,助你快速上手大模型微调,解决实际应用中的技术难题。


前面2篇做了模型微调实战,一个是智谱ChatGLM-6B模型,另外一个Qwen2.5-7B模型,这篇在实战的基础上做一个总结,梳理出模型微调的一般流程。

大模型微调(Fine-tuning)是在预训练模型的基础上,通过特定领域或任务的数据进行针对性训练,以提升模型在目标场景中的性能。其核心流程如下:
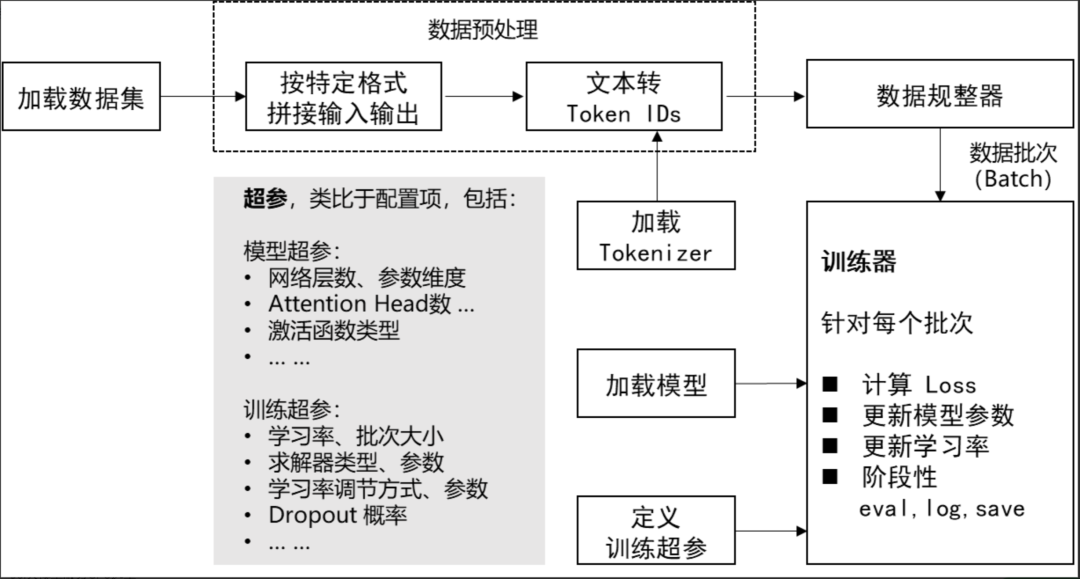
1、明确目标和数据准备

明确模型的目标,比如是文本类型,还是图片类型,还是推理类型。并且做好评估模型的指标。

数据准备,尽量多收集更多场景的数据,确保数据的真实性和多样性,将数据分为训练集,验证集,测试集(常用的比例如80%-10%-10%)

2、数据预处理

将数据进行清洗,格式转换成模型识别的格式,还有使用预训练模型对应的分词

3、基座模型加载和模型参数设置

选择对应的基座模型,并进行模型参数设置,比如序列长度,数据类型,内存优化参数等

调整模型结构,指微调的方法,选择全参数还是参数高效微调,现在大模型微调基本上选择参数高效微调(如LoRA/QLoRA)

4、训练超参数及优化策略

比如设置学习率,通常较少的学习率是1e-5到5e-5,优化器选择,权重衰减,混合精度训练等

5、进行训练和验证

模型训练train()时可以多训练几个批次,拿着验证集去验证模型eval()

6、模型评估和优化

根据模型评估指标去评估,差异大时,需要进行超参数调优,进行多轮训练

7、模型保存及上线部署

模型保存save()导出,最后部署给别人调用。就像代码升级一样。

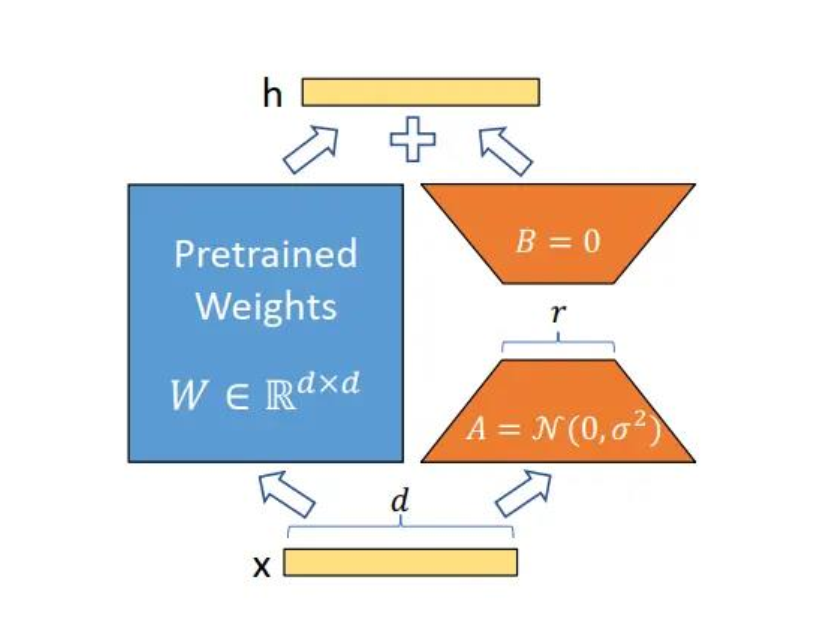
说一说我理解的参数高效微调模型的LoRA原理,是基于数学向量运算为理论基础,看下面的LoRA原理图,左边是基座模型,右边是LoRA层,训练时两边互相不干扰,训练完后进行统一的输出。模型本质是一个非常大的多维度向量,右边LoRA层就是利用2个小维度的向量相乘,得到一个大的向量,最后是2个同纬度的向量进行向量的相加。得出最后的结果输出。改变原模型输出质量,可以输出更准确的答案。
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

作为一名从业五年的资深大模型算法工程师,我经常会收到一些评论和私信,我是小白,学习大模型该从哪里入手呢?我自学没有方向怎么办?这个地方我不会啊。如果你也有类似的经历,一定要继续看下去!这些问题啊,也不是三言两语啊就能讲明白的。

所以我综合了大模型的所有知识点,给大家带来一套全网最全最细的大模型零基础教程。在做这套教程之前呢,我就曾放空大脑,以一个大模型小白的角度去重新解析它,采用基础知识和实战项目相结合的教学方式,历时3个月,终于完成了这样的课程,让你真正体会到什么是每一秒都在疯狂输出知识点。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

大模型本地部署与微调实战:从Ollama、vLLM到LoRA的完整指南 大型语言模型(LLM)的本地部署与微调是当前AI工程实践的核心环节。其原理在于将预训练好的模型部署到本地硬件,通过优化推理和参数高效微调技术,使其适应特定任务。这一过程的技术价值在于保障数据隐私、实现模型可控并降低长期使用成本。在应用场景上,它广泛适用于企业私有化部署、垂直领域模型定制以及研究与开发测试。其中,Ollama以其开箱即用的特性简化了部署流程,而LoRA(Low-Rank Adaptation)作为一种高效的参数微调方法,能大幅降低计算资源需求。本文聚焦于大模型本地部署、推理加速与基础微调的实战 阅读详情

相关推荐

大模型与扩散模型实战指南:从原理到微调部署的完整路径

在人工智能领域,大语言模型和扩散模型已成为核心技术。理解其工作原理,如Transformer的自注意力机制和扩散模型的前向加噪与反向去噪过程,是掌握其应用的基础。这些模型通过预训练学习海量数据中的模式,具备强大的生成与理解能力,其技术价值在于能够高效处理自然语言和图像生成任务。在实际应用场景中,开发者常需通过微调使通用模型适配特定业务需求,例如使用LoRA进行参数高效微调,以有限资源实现模型定制。本文基于实战经验,系统梳理了从环境搭建、核心原理理解到模型微调与部署的完整流程,并针对常见问题提供了解决方案,旨

weixin_34392435的博客 419

视觉大模型提示微调(visual prompt tuning,2022ECCV)

在使用预训练的ViT骨干的跨不同领域的24个下游识别任务中,VPT击败了所有其他迁移学习基线,甚至在20个案例中超越了全面微调,同时保持了对于每个个别任务存储显著较少参数(不到骨干参数的1%)的优势(图1(c))。借鉴最近在NLP中关于Prompting的进展 [50,48,45,51],我们提出了一种新的简单而高效的方法来适应下游视觉任务的Transformer模型(图1(b)),即Visual-Prompt Tuning(VPT)。我们遵循原始的配置,例如,划分的图像补丁数量,是否存在[CLS]等。

qq_36101623的博客 3429

大模型学习路线图:从Prompt工程到RAG与微调的实战指南

大模型作为当前人工智能领域的核心技术,其应用开发正从简单的对话交互向复杂系统集成演进。理解其工作原理,关键在于掌握Transformer架构、注意力机制等基础概念,这些技术通过海量数据预训练,赋予了模型强大的语言理解和生成能力。在工程实践中,RAG(检索增强生成)技术通过结合外部知识库,有效缓解了模型的幻觉问题,提升了回答的准确性和时效性。同时,针对特定场景的模型微调,尤其是采用LoRA等参数高效方法,能让通用模型快速适配专业领域需求。这些技术的核心价值在于将大模型的通用能力转化为解决实际业务问题的生产力,

dianzongfan5428的博客 529

【大模型微调】一文掌握7种大模型微调的方法_大模型如何微调

本篇文章深入分析了大型模型微调的基本理念和多样化技术,细致介绍了LoRA、适配器调整(Adapter Tuning)、前缀调整(Prefix Tuning)等多个微调方法。详细讨论了每一种策略的基本原则、主要优点以及适宜应用场景,使得读者可以依据特定的应用要求和计算资源限制,挑选最适合的微调方案。大型语言模型(LLM)的训练过程通常分为两大阶段:阶段一:预训练阶段在这个阶段,大型模型会在大规模的无标签数据集上接受训练,目标是使模型掌握语言的统计特征和基础知识。

HUANGXIN9898的博客 2106

本地部署AI模型与知识库:从硬件配置到实战优化

本地部署AI模型与知识库系统正成为企业及开发者的热门选择,尤其在数据隐私和成本控制方面具有显著优势。通过Docker环境配置和NVIDIA显卡的硬件支持,用户可以在本地高效运行如ChatGLM3-6B等开源模型。量化技术和RAG系统架构的引入,进一步提升了模型在消费级硬件上的性能表现。本地部署不仅适用于科研团队和医疗行业,还能满足电商客服等高并发场景的需求,实现深度定制和持续学习。

weixin_30617797的博客 293

《大模型实战指南》—— 面向软件开发者的系统性入门1

《大模型入门指南:概念、历史与开发实践》摘要 本文系统介绍了大模型的核心概念与技术生态。大模型代表了从"规则驱动"到"数据驱动"的范式转变,通过海量数据训练获得通用智能能力。关键术语包括参数规模、Token处理、上下文长度等,这些指标直接影响开发选型。大模型发展经历了三个阶段:BERT开启预训练范式、GPT-3实现生成能力、当前进入开源工程化时代。主流生态包括国际阵营(Llama3、Mistral)和中文场景优选(Qwen、ChatGLM)。开发者学习大模型具有三重价

_abab的专栏 1098

学大模型必看!手把手带你从零微调大模型!

今天分享一篇技术文章,你可能听说过很多大模型的知识,但却从未亲自使用或微调过大模型。 今天这篇文章,就手把手带你从零微调一个大模型。大模型微调本身是一件非常复杂且技术难度很高的任务,因此本篇文章仅从零开始,手把手带你走一遍微调大模型的过程,并不会涉及过多技术细节。希望通过本文,你可以了解微调大模型的流程。

kiiy2的博客 1830

CloudCompare点云滤波实战:三种植被去除技术的对比与应用

本文详细对比了CloudCompare中三种植被去除技术(低通滤波、CSF滤波和坡度法)的实战应用与效果。通过具体案例和参数优化建议,帮助用户根据地形特征选择最佳滤波方法,提升点云数据处理精度和效率,特别适用于复杂场景下的植被去除需求。

weixin_30689307的博客 84

Datawhale AI冬令营 | 大模型实战进阶

本文内容是Datawhale Al冬令营学习笔记。@August。

weixin_45092438的博客 1081

【雷达仿真 | FMCW TDMA-MIMO毫米波雷达信号处理仿真(可修改为DDMA-MIMO)】

1、FMCW叫做调频连续波,调频连续波有步进调频连续波(SFMCW)、线性调频连续波(LFMCW),以及其他非线性调频连续波。LFMCW有锯齿波和三角波等等;锯齿波有恒定调制周期的锯齿波和非恒定周期的锯齿波。Introduction to mmwave sensing:FMCW radars.pdf和The fundamentals of millimeter wave sensors。2、MIMO是多输入多输出(Multiple input Multiple output),也就是多发多收。

【调皮连续波】雷达技术领域知识博主 1万+

一文详细讲解CRM系统(附架构图、流程、功能介绍)

专为中小企业量身打造高性价比的数字化转型路径!企业如何用CRM才能真正做到降本增效?今天,就用一文讲清这些问题!读完本文,你将清楚得了解CRM的概念、框架、流程、功能、企业成功案例,文末还有常见问题解答。

Dabeishandong的博客 9928

详解大模型微调全流程

作者:1050Ti全量微调.,东北大学软件工程原文:https://zhuanlan.zhihu.com/p/684691249声明:本文只做分享,版权归原作者,侵权私信删除!编辑:青稞AI微调实战经历本次微调经验分享依据于我们在2023年参加的“第2届·百度搜索创新大赛——搜索答案组织”整个比赛过程。我们团队选择的基座模型是ChatGLM3-6B-Base模型,训练数据集为官方提供的数据集(90...

zenRRan的博客 1447

EG2134驱动芯片实战:如何用TSSOP20封装搞定三相无刷电机驱动(附电路图)

本文详细介绍了EG2134驱动芯片在三相无刷电机驱动中的应用实践,包括芯片选型、电路设计和PCB布局技巧。EG2134作为一款高性能半桥驱动芯片,采用TSSOP20封装,适合紧凑型设计。文章还提供了典型应用电路图和调试指南,帮助工程师快速实现稳定可靠的电机驱动方案。

d3e4f的博客 306

【珍藏】大模型微调全攻略:从数据准备到LoRA原理详解,程序员必备指南

本文系统梳理了大模型微调全流程,涵盖目标设定、数据准备、模型配置、训练优化等7个关键步骤,重点解析了LoRA高效微调技术原理。通过ChatGLM-6B和Qwen2.5-7B的实战案例,提供可落地的技术方案。同时探讨AI时代就业趋势,分析大模型技术催生的新型岗位,并附带完整学习资源包(含路线图、书籍、视频及实战项目),帮助技术人员系统掌握大模型技能。内容由清华-加州理工双料博士团队指导,兼具理论深度与实践价值。

优快云_430422的博客 1041

Windows下用MSYS2一键搞定Verilator安装(附国内镜像加速)

本文详细介绍了在Windows系统下,如何利用MSYS2工具和国内镜像源,快速、高效地完成Verilator的安装与配置。通过替换清华镜像源加速下载,并配合Pacman包管理器,实现近乎一键式的安装流程,有效解决了传统方法步骤繁琐、网络依赖下载慢的问题,为数字电路仿真提供了便捷的Windows环境解决方案。

weixin_29208327的博客 594

LeRobot 入门教程(一)软件环境、部署流程及摄像头配置

🤖 LeRobot:开源机器人学习平台 摘要:LeRobot是一个基于PyTorch的开源机器人学习平台,提供模型、数据集和工具,旨在降低机器人技术门槛。平台包含经过验证的模仿学习和强化学习方法,并提供预训练模型、人类演示数据集及模拟环境。安装需从源码获取,支持Python 3.10环境,可选扩展包括仿真环境(如gym-aloha)、电机控制(Dynamixel/Feetech SDK)和实验跟踪(Weights & Biases)。该平台托管在HuggingFace,并设有社区Discord频道

2506_90492529的博客 3417

大模型微调与RAG技术构建智能对话系统实战

大模型微调与RAG(检索增强生成)技术是当前AI领域的热门方向,通过结合预训练语言模型的知识表示能力和外部知识检索机制,显著提升对话系统的专业性和准确性。其核心原理是通过微调使模型适配特定领域语言特征,同时利用向量数据库实现实时知识检索。在工程实践中,采用QLoRA等高效微调技术可大幅降低计算资源消耗,配合Chroma等轻量级向量数据库,能在有限硬件条件下构建高性能系统。该技术方案特别适合医疗、法律等需要精准专业知识的垂直领域,能有效解决传统对话机器人知识更新滞后、专业度不足等痛点。

weixin_30627341的博客 343

ENVI_基于无人机数据的果树提取与相对健康监测

一、数据处理 1.计算植被指数VDVI或GDVI:Band Math / Spectral Indices 2.制作掩膜:ROI——Threshold——Subset 二、单地块果树提取 1.绘制感兴趣区shp 2.确定果树提取参数:Count Crops 3.输出果树矢量文件:Convert Crops To Shapefile 4.果树相对健康程度分析:Calculate Crop Me...

提供技术服务、资源分享 429690771 1399

大模型训练实战:从QLoRA微调到Axolotl框架,开发者低成本入门指南

大模型训练是当前人工智能领域的核心技术,其核心原理是通过在海量数据上预训练,使模型学习通用语言表示,再通过微调适应特定任务。这一技术价值在于能够将通用智能能力迁移到垂直领域,实现业务定制化。在应用场景上,大模型训练已从巨头专属走向开发者普惠,尤其在客服、知识库、代码生成等场景需求旺盛。借助QLoRA等高效微调技术,开发者仅需单张消费级显卡即可实现模型定制。本文以Axolotl框架为例,详细拆解从环境搭建、数据工程到训练评估的全流程,帮助开发者快速上手大模型训练实践。

weixin_30621959的博客 385

【Android调试】高通adb识别不到设备的完整排查指南:从驱动到端口一步到位

本文系统梳理高通(Qualcomm)平台Android设备adb无法识别的完整排查流程。从最基础的USB连接检查开始,到Windows设备管理器中驱动状态的判断、高通USB驱动的正确安装与更新方法,再到adb端口被占用、USB调试未开启、驱动签名校验失败等高频场景的解决方案。每一步均配截图和操作命令,文末附常见报错速查表,适合做系统开发、刷机调试或者Android Framework bringup时遇到adb不通的工程师快速定位。

weixin_44081096的博客 281

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

LLaMA-Factory实战指南:从零开始掌握大模型SFT微调

大语言模型(LLM)的监督微调(SFT)是使其适应特定任务的关键技术。其核心原理在于利用特定领域的数据,通过有监督学习调整模型参数,从而提升模型在目标场景下的表现。这项技术的价值在于能够以相对较低的成本,将通用大模型定制化为满足垂直领域需求的专用模型,广泛应用于智能客服、代码生成、内容创作等场景。本文聚焦于如何利用开源工具LLaMA-Factory,高效实施SFT微调。通过解析其模块化架构,并结合LoRA等参数高效微调方法,文章将详细阐述从环境配置、数据预处理到训练监控的全流程实践,帮助读者解决在微调Qwe

weixin_33727510的博客 499

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【2026年版|收藏备用】大模型微调11种参数高效方法,小白&程序员入门必看

随着2026年大模型技术的普及,越来越多开发者(小白&资深程序员)开始涉足大模型微调,但全量微调的高算力、高存储门槛让很多人望而却步。本文专为2026年开发者优化,系统梳理了11种主流参数高效微调方法,涵盖经典方法及最新衍生技术,所有内容适配当前主流大模型(LLaMA 3、Qwen 2、ChatGLM 4等),全程避开复杂冗余表述,重点突出“轻量、高效、易落地”,帮你快速选择适合自己的微调策略,降低部署成本,助力大模型落地到实际开发场景。

kaka0722ww的博客 1128

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

开源大模型实战:从ChatGLM3-6B部署到生产级应用指南

Transformer架构作为现代大语言模型的核心基础,通过自注意力机制实现了对序列数据的强大建模能力。其开源生态,特别是Hugging Face平台,为开发者提供了统一的模型加载与微调API,极大降低了AI应用门槛。从技术价值看,开源大模型解决了商业API存在的技术黑盒、数据隐私和定制化受限等问题,使企业能实现私有化部署与自主可控。在实际应用场景中,开发者常面临显存不足、推理速度慢等挑战,而模型量化技术(如INT8/INT4)和LoRA微调方法成为关键解决方案。本文以ChatGLM3-6B为例,详细演示了

weixin_34072637的博客 387

大模型技术解析:从算法原理到微调部署实战指南

人工智能的发展经历了从规则系统到深度学习的范式转变,其核心驱动力在于算法、算力和数据的协同演进。Transformer架构中的自注意力机制是当前大模型的技术基石,它通过全局关联计算实现了对上下文的深度理解。在工程实践中,参数高效微调技术如LoRA和QLoRA,让开发者能以较低成本将通用模型适配到特定领域。结合检索增强生成(RAG)和智能体(Agent)等应用模式,大模型能够有效解决知识实时性和任务规划等实际问题。理解这些基础概念与技术原理,是构建可靠AI应用的关键。

weixin_34121304的博客 363

【图书介绍】《AI Agent智能体与MCP开发实践:基于Qwen3大模型》

随着人工智能技术的蓬勃发展,大语言模型与智能体技术正引领着新一轮的技术革新。本书聚焦于智能体技术前沿领域,系统阐述AI Agent智能体开发的技术栈及其示例,并剖析5个大型智能体项目案例,帮助读者深入掌握智能体开发方法。本书配套示例源码、PPT课件、配图PDF文件、读者微信技术交流群,所有代码经过测试,均能正确运行。

夏天又到了的专栏 1319

Verilog Testbench入门与进阶:从仿真骨架到自动验证

在数字逻辑设计与FPGA开发中,功能仿真是验证RTL代码正确性的核心手段,而Testbench作为仿真激励环境,其设计质量直接决定验证效率与可靠性。本文从Verilog仿真的基本原理出发,阐述了initial与always块的分工、timescale时间尺度、阻塞与非阻塞赋值等关键机制,并系统讲解时钟与复位信号的生成方法,以及如何通过task与function封装复用激励,借助自动比对与断言实现结果自校验。这些技术不仅适用于计数器等简单模块,也能无缝迁移至UART、SPI控制器等复杂工程场景。掌握系统化Te

weixin_34161083的博客 402
上一篇: 收藏必备!从LangChain到LangGraph:大模型开发框架全方位解析与实战指南
下一篇: Transformer架构精讲:从原理到实践,一文读懂大模型的核心技术(建议收藏)
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值