基于 AutoFlow 快速搭建基于 TiDB 向量搜索的本地知识库问答机器人

一行代码不用写,用 Autoflow + Gitee AI 搭建本地知识库问答机器人 本文详解 AutoFlow 从部署到配置的完整流程,包括数据库连接、模型设置、知识库创建及聊天引擎配置,实现了一行代码不用写的问答机器人快速搭建。模型相关信息配置完成后就可以进行知识库的配置了,选择左侧 Knowledge Bases ,填写知识库名称及描述,选择刚才创建的大语言模型和向量模型后即可创建知识库。⚠️ 需要注意的是,向量模型设置中新增了向量维度选项,这里需填写该模型支持的向量维度,如默认的 bge-large-zh-v1.5 模型向量维度为 1024。 阅读详情

导读

本文将详细介绍如何通过 PingCAP 开源项目 AutoFlow 实现快速搭建基于 TiDB 的本地知识库问答机器人。如果提前准备好 Docker、TiDB 环境,整个搭建过程估计在 10 分钟左右即可完成,无须开发任何代码。

文中使用一篇 TiDB 文档作为本地数据源作为示例,在实际情况中,您可以基于自己的企业环境用同样的方法快速构造企业内部知识库问答机器人。

图片

AutoFlow 是 PingCAP 开源的一个基于 Graph RAG、使用 TiDB 向量存储和 LlamaIndex 构建的对话式知识库聊天助手。https://tidb.ai 也是 PingCAP 基于 AutoFlow 实现的一个 TiDB AI 智能问答系统,我们可以向 tidb.ai 咨询任何有关 TiDB 的问题,比如 “TiDB 对比 MySQL 有什么优势?”

图片

以下是 tidb.ai 的回答,从结果来说,tidb.ai 非常准确的理解了用户的问题并给出了相应的回答。它首先给出 TiDB 优势及 MySQL 限制的详细说明,然后给出一个结论性的总结,最后给出更多的参考链接。

图片

图片

相信通过前面的一些介绍,大家对 tidb.ai 的能力已经有了一个清楚的认识。TiDB 的使用人员很幸运,因为有了 tidb.ai,几乎任何有关 TiDB 的问题都可以在这个统一的平台得到相应的解答,一方面节省了自己人工去查找 TiDB 官方文档或 AskTUG 论坛的时间,另一方面 tidb.ai 拥有比普通大模型更专业的 TiDB 知识问答。

在技术实现上,tidb.ai 背后主要使用到 TiDB 的 Graph RAG 技术、TiDB 向量检索功能以及 LLM 大模型的使用。实际上,在 AutoFlow 出来之前,我们也可以通过 python 编程开发的方式基于 LLM+RAG+TiDB 实现一套问答系统。主要的开发流程如下:

  1. 准备私域文本数据
  2. 对文本进行切分
  3. 通过 Embedding 将文本转为向量数据
  4. 把向量数据保存到 TiDB
  5. 获得用户输入问题并进行向量化,然后从 TiDB 中进行相似度搜索
  6. 将上述片段和历史问答作为上下文,与用户问题一起传入大模型,最后输出结果

图片

图片

图片

基于 python 开发这样一套问答系统,一般要结合大模型常用开发框架如 Langchain,Langchain 集成了多种文件格式或 URL 网址的导入功能。如果希望给这个系统增加 Web 界面的能力,还需要引入前端可视化工具,如 Gradio 或 Steamlit。但是如果使用开源的 AutoFlow,即使对于没有任何开发背景的同学来说,搭建一套这样的问答系统也是一件轻而易举的事情,以下我们具体演示整个搭建的过程。

环境准备

在环境准备阶段,我们主要需要准备以下几项内容:

Docker 环境

需要确保 AutoFlow 运行的机器上具备 Docker 运行环境,因为 AutoFlow 项目中的应用是基于 docker 容器环境运行的。有关 Docker 运行环境的准备工作本文不作说明,安装完成后可使用 docker run hello-world 命令验证安装成功。

AutoFlow 项目

AutoFlow 是一个开源的 github 项目,地址为 https://github.com/pingcap/autoflow。下载之后需要在 AutoFlow 根目录下配置相关信息,包括 TiDB 数据库连接信息、EMBEDDING 维度等。

代码语言:javascript

cat > .env <<'EOF'
ENVIRONMENT=production

# 可使用 python3 -c "import secrets; print(secrets.token_urlsafe(32))" 生成密钥
SECRET_KEY="some_secret_key_that_is_at_least_32_characters_long"

TIDB_HOST=<ip>
TIDB_PORT=<port>
TIDB_USER=<username>
TIDB_PASSWORD=<password>
TIDB_DATABASE=tidbai_test
# 非 TiDB serverless 环境需要将 TIDB_SSL 设置为 false
TIDB_SSL=false

EMBEDDING_DIMS=1024
EMBEDDING_MAX_TOKENS=4096
EOF

带向量功能的 TiDB 环境

TiDB 最新发布的 v8.4 版本,支持向量搜索功能(实验特性)。向量搜索是一种基于数据语义的搜索方法,可以提供更相关的搜索结果。有关 TiDB 向量搜索功能,参考https://docs.pingcap.com/zh/tidb/v8.4/vector-search-overview 。

需要确保 TiDB 8.4 集群正常运行,且已经创建有 AutoFlow 配置中指定的 TIDB_DATABASE 数据库(必须为空库)。

代码语言:javascript

mysql> select version();
+--------------------+
| version()          |
+--------------------+
| 8.0.11-TiDB-v8.4.0 |
+--------------------+
1 row in set (0.00 sec)

mysql> create database tidbai_test;
Query OK, 0 rows affected (0.52 sec)

智谱 AI API Key

注册并登录智谱 AI 平台 https://bigmodel.cn/,在个人中心->API kys 添加新的 API Key 并复制保存。注意,如果免费创建的用户已经超过一定的时效期限,API Key 将是无效的。

图片

数据初始化

运行数据迁移以创建所需的表并创建初始管理员用户:

代码语言:javascript

cd autoflow
docker compose -f docker-compose-cn.yml run backend /bin/sh -c "alembic upgrade head"
docker compose -f docker-compose-cn.yml run backend /bin/sh -c "python bootstrap.py"

图片

当看到如上输出结果时,说明初始化这一步已经成功(注意保存好红色字体中的密码以备后面使用)。这时我们去 TiDB 数据库中查看,发现 tidbai_test 这个库中已经自动创建出了相应的表并有一些初始化数据,符合预期。

图片

启动知识库应用

运行以下 docker compose 命令启动知识库应用程序:

代码语言:javascript

cd autoflow
docker compose -f docker-compose-cn.yml up -d --force-recreate

图片

网页访问和配置知识库应用

应用启动成功后,我们可以直接通过默认的 3000 端口访问相应的界面进行下一步操作了。使用默认管理员用户 admin@example.com 以及上述应用启动打印的密码进行登录。

图片

登录成功后,会弹出如下图所示的提示框,后面我们只要按照提示框一步步进行相应配置即可。

注意:3000 这个端口是 TiDB 数据库默认的 Grafana 端口号,如果把 AutoFlow 部署在和 Grafana 相同的节点,需要考虑端口冲突问题。

图片

1. 配置 LLM

此步骤需要配置的内容包括:

  • 模型名称
  • 模型提供商(选择 OpenAI Like)
  • 模型型号(如 glm-4-0520)
  • 智谱 AI API KEY(见环境准备阶段)
  • 高级选项-> api_base 路径(需与 LLM 对应)
  • 是否默认 LLM(是或否)

图片

配置完成后,点击 Create LLM 创建 LLM 关联。需要注意的是,这里提供的 API Key 必须是一个有效的 Key,如果创建 API Key 的账户本身就过时,创建 LLM 时可能就会遇到以下报错。如果只是为了测试用途,可以重新注册一个账号并取得一个新的 API Key 试用。

代码语言:javascript

Failed to create LLM
Error code: 429 - {'error': {'code': '1113', 'message': '您的账户已欠费,请充值后重试。'}}

2. 配置 Embedding 模型

此步骤需要配置的内容包括:

  • embedding 名称
  • 模型提供商(选择 OpenAI Like)
  • 模型型号(如 embedding-2)
  • 智谱 AI API KEY(与上述相同)

图片

配置完成后,点击 Create Embedding Model 创建 Embedding 模型。需要注意的是,这里的 Model 必须要与环境变量中的 EMBEDDING_DIMS 对应,否则可能会出现以下类似报错。

代码语言:javascript

Failed to create Embedding Model
Currently we only support 1536 dims embedding, got 1024 dims. 

3. 配置数据来源

这里的数据来源可以是本地文件,也可以是具体的网址。这里我们配置具体有关 TiDB 和 MySQL 兼容性的网页 https://docs.pingcap.com/zh/tidb/stable/mysql-compatibility 为数据来源。具体配置内容包括:

  • 数据源名称
  • 数据源描述
  • 网页 URL(可以配置一个或多个)
  • 是否 build 知识图谱 Index(是或否)

图片

配置完成后,点击 Create Datasource 创建数据来源。当然,如果有本地文件,也可以直接导入本地文件并创建数据源。另外如果不是在初始化时配置数据源,我们也可以在后续的过程中手动添加更多的数据源,下图显示将一个本地的文档导入为数据源。

图片

4. 查看索引创建进度

上述步骤配置完成后,应用将基于配置的数据源进行向量化并创建索引,这需要一定的时间,具体耗时跟数据源的多少以及机器的配置都有关。通过页面左侧菜单栏-> Index Progress 查看索引创建进度,绿色代表索引创建成功,蓝色代表正在创建,红色代表创建失败。下图表示 Vector Index 已经创建成功,Knowlege Graph Index 正在创建中。当两个图表都变成绿色时,代表全部创建成功。

图片

体验智能问答

至此,我们已经完成了配置数据源并完成了向量化存储及向量索引的创建。在网页的左侧菜单栏中,我们可以点击 Datasources 查看当前数据源, LLMs 查看当前 LLM,Embedding Model 查看 Embedding 模型。

图片

我们现在也可以开始向自己搭建的 tidb.ai 咨询有关 TiDB 的问题了,比如提问 “TiFlash 高性能列式分析引擎”。从结果可以看出,本地知识库问答机器人引用导入的文档并作出了相似回答,而假如我们删除数据源之后再提出相同的问题,它的回答是 Empty Response。下图对比充分说明了 TiDB 向量搜索在基础 LLM 大模型的增强能力。

图片
​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

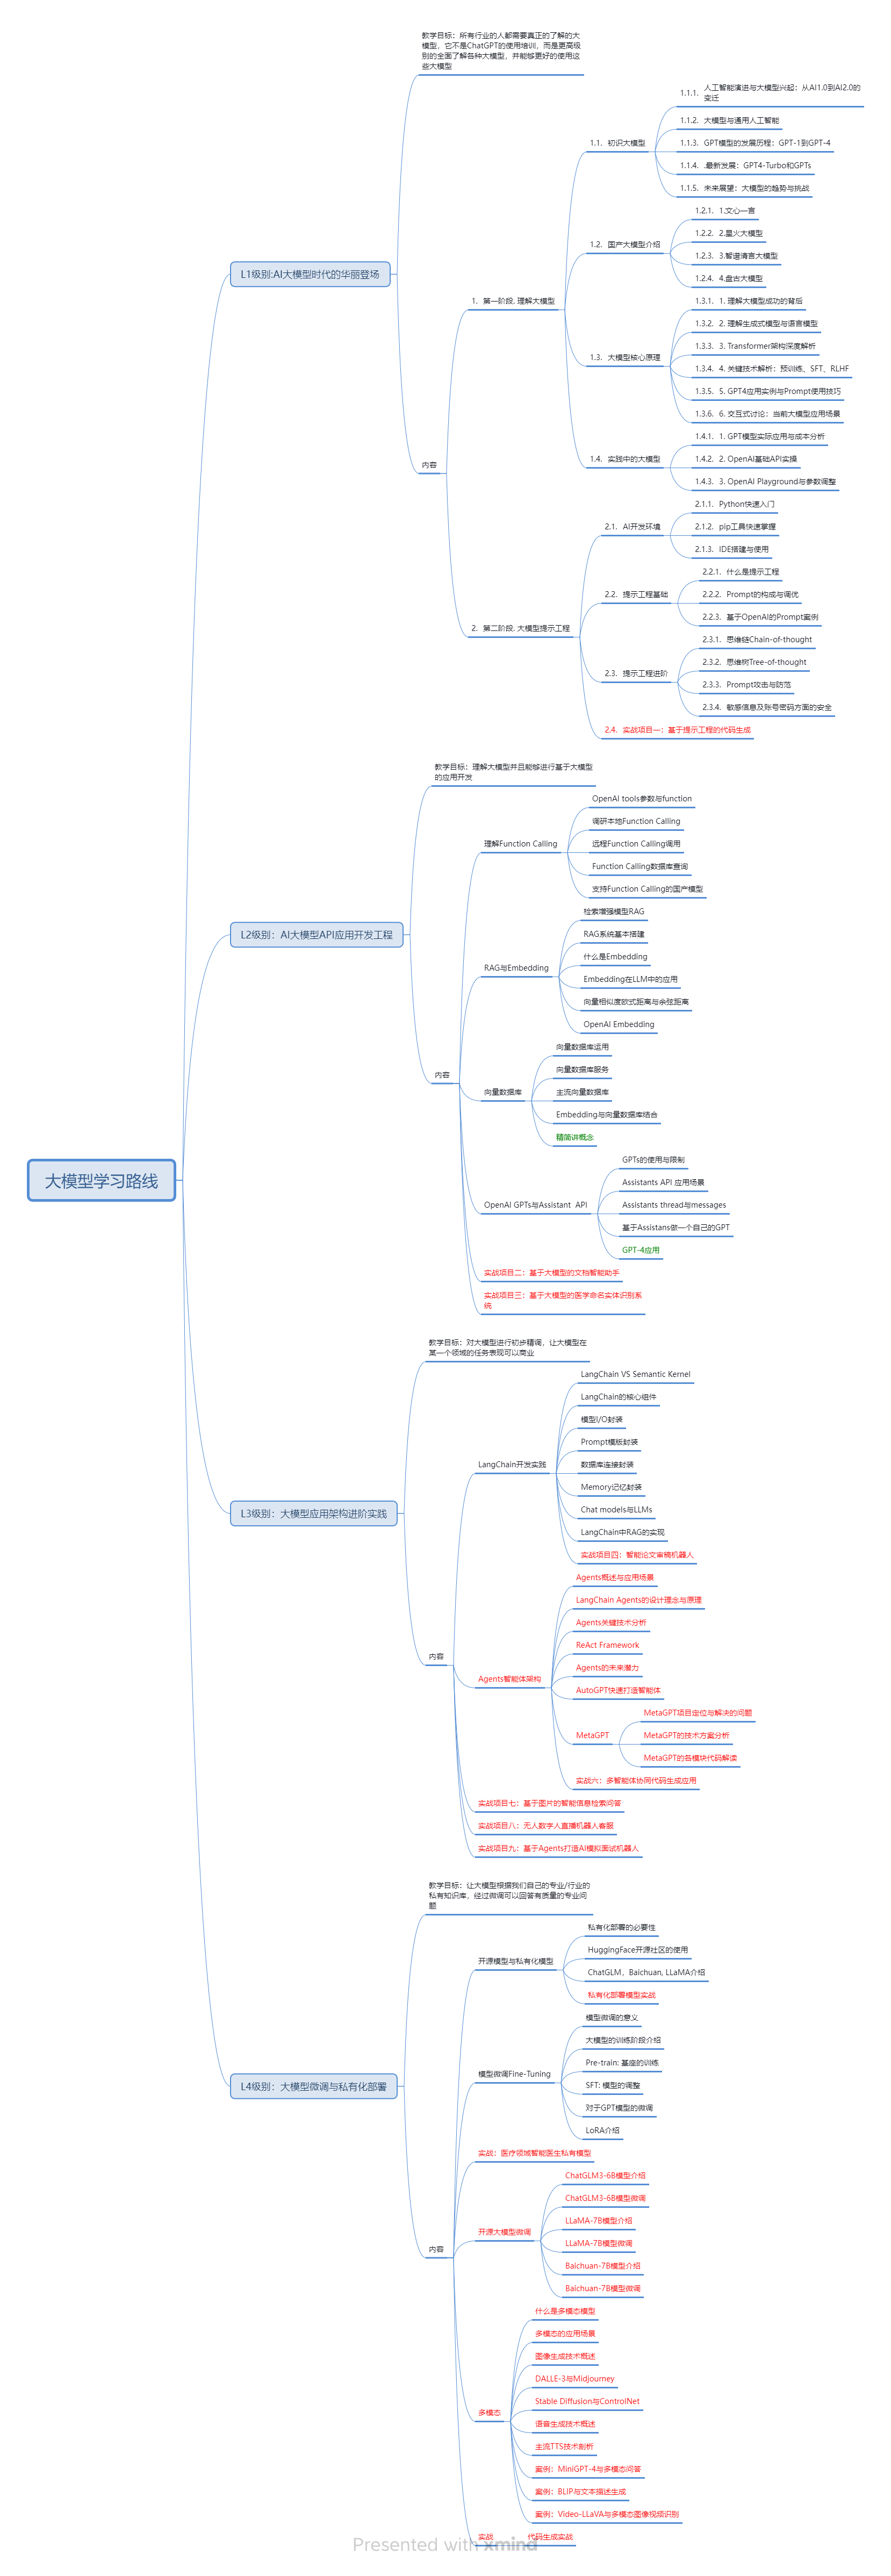
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

深度学习batch、batch_size、epoch、iteration以及小样本中episode、support set、query set关系 训练整个数据集是epoch、把数据集分为多少小块就是batch,每个小块(batch)多少个数据就是batch_size,整个数据集需要训练多少轮是iteration 阅读详情

相关推荐

时间同步中 TOD 与GPRMC和IRIG-B的区别

时间同步中 TOD 与GPRMC和IRIG-B的区别

ftdlk的博客 1730

PingCAP 唐刘:一个咨询顾问对 TiDB Chat2Query Demo 提出的脑洞

于是我就问我的朋友,你期望如何分析你上传的数据,我的朋友说的很直观,给我打开了 Google 的主页。探讨了想打造一款好的产品,从用户角度出发的思考方式以及与用户交流的重要性:当我们向用户展示产品能力时,我们往往习惯站在技术的角度出发,然而当用户并不具备完备的相关技术背景时,我们需要换位思考,了解用户的工作流程和思维方式,才能真正让用户理解和接受我们的产品。但是,我推荐的朋友几乎全是有技术背景的人,所以当我跟一位不懂技术的朋友进行推荐的时候,我才突然意识到,我们的这款产品离好看以及好用,还有很长的路要走。

TiDB_PingCAP 的博客 791

智能驾驶感知模块的测试评估方法(上)

对于智能驾驶系统而言,感知模块是开发难度最大、投入资源最多的核心部分。在智能驾驶开发团队内部,感知模块需要独立进行评测才能及早发现潜在缺陷或判断性能是否有改进。随着近几年BEV、OCC、E2E等新技术方案被越来越多企业应用,感知的评测变得越来越艰难,效率也变得越来越低下。本文作者基于在智驾测试行业多年经验,试图总结感知评测的基本规律和效率提升方法,以供读者一些启发。

vincent_321的博客 2559

开源免费的多数据库工具Chat2DB

Chat2DB 是一款开源免费的多数据库客户端工具。 能够将自然语言转换为SQL,也可以将SQL转换为自然语言。 支持windows、mac本地安装,也支持服务器端部署,web网页访问。 支持多种数据库:MySQL,PostgreSQL,Oracle,DB2,ClickHouse,OceanBase,Redis,Hive,MongoDB等

flying roc 3万+

ArcGIS拓扑面错误批量修改

在工作学习中经常会遇到拓扑修改的问题,当数据量巨大的时候会产生拓扑问题 当拓扑错误数量巨大时,人工逐一修改是不现实的,基于此利用gis自带工具箱实现拓扑面类错误的批量修改。 一、.常见拓扑错误的类型: 1面重叠 2空隙(绿色部分) 二、拓扑检查 1新建数据库-----新建数据集—导入数据. 2新建拓扑 3修改拓扑容差及名称 添加拓扑修改规则 完成拓扑检查-查看拓扑错误 三、拓扑批量...

qq_43173805的博客 3万+

嵌入式设备电量显示实战:MCP3421 ADC采集从原理到代码全解析(附避坑指南)

本文详细解析了嵌入式设备中MCP3421 ADC芯片在电量显示应用中的硬件设计、寄存器配置、I2C通信调试及低功耗优化策略。通过实战代码和避坑指南,帮助开发者实现高精度电量监测,特别针对I2C时序和分压电路设计等常见问题提供解决方案,适用于物联网终端和移动设备开发。

weixin_42525632的博客 388

LLM Agent之数据库应用设计(一)

上一章我们主要讲搜索引擎和LLM的应用设计,这一章我们来唠唠大模型和DB数据库之间的交互方案。有很多数据平台已经接入,可以先去玩玩再来看下面的实现方案,推荐本章会提到的前置知识点有Chain-of-thought,Least-to-Most Prompt,Self-Consistency Prompt,建议不熟悉的同学先看下。

2401_82469710的博客 1415

从养殖场到科技前沿:YOLOv11+OpenCV精准计数鸡蛋与鸡

YOLOv11结合OpenCV技术,精准识别和计数鸡蛋与鸡,广泛应用于养殖场、市场监控和自动化包装。通过深度学习与计算机视觉,提升农业生产效率,让智能化管理更简单高效。

专注于深入研究多种编程语言,以实战为导向,逐步拓展开发技能,提升工程化编码和思维能力,展现无敌技术实力。 1209

TiDB Chat2Query 深度解析:我们如何打造一款更高效、准确的智能 SQL 生成工具?

2023 年 1 月,TiDB Cloud 发布了 Chat2Query 功能,在 TiDB Cloud 上通过自然语言提问,即可生成相应的 SQL,。Chat2Query 正在彻底改变企业探索和理解数据的方式。经过一年多的研发迭代,现在 Chat2Query 在 Spider 基准测试中得分 86.30,并曾在 BIRD 基准测试中跻身前四。本文将深入探讨 Chat2Query 的工作原理及其背后的 Text2SQL 技术,以及我们如何提升 Chat2Query 的能力。“上个季度的销售额是多少?

m0_59235699的博客 968

Modbus测试工具ModbusPoll与Modbus Slave使用方法 小白实操记录

Modbus 下面介绍modbus标准协议从站、主站仿真工具;可用于指令下发,数据采集等;是学习、现场运维的好工具。 1 介绍 Modbus Poll :Modbus主机仿真器,用于测试和调试Modbus从设备。该软件支持ModbusRTU、ASCII、TCP/IP。用来帮助开发人员测试Modbus从设备,或者其它Modbus协议的测试和仿真。它支持多文档接口,即,可以同时监视多个从设备/数据域。每个窗口简单地设定从设备ID,功能,地址,大小和轮询间隔。你可以从任意一个窗口读写寄存器和线圈。如果你想改

码灵的博客 1万+

Abaqus数据导出技巧:轻松处理大量XY数据

通过上述三种方法,我们可以解决Abaqus中大量XY数据导出的问题。无论是使用插件、编写Python脚本,还是利用Abaqus的内置报告功能,都可以帮助我们高效地处理数据。希望这篇博客能够帮助到你,提高你在Abaqus使用过程中的数据处理效率。

m0_62153576的博客 1919

【大模型提效】Chat2Query: A Zero-Shot Automatic Exploratory Data Analysis System with Large Language Models

数据分析师在 SQL 进行探索性数据分析时经常遇到两个主要挑战:(1)需要巧妙地制作 SQL 查询,(2)需要生成合适的可视化来增强查询结果的解释。大型语言模型 (LLM) 的出现引发了文本到 SQL 和数据到文本的范式转变。本文介绍了 Chat2Query,这是一个 LLM 赋能的零样本自动探索数据分析系统。首先,Chat2Query 提供了一个用户友好的界面,允许用户使用自然语言直接与数据库交互。

skysys的研究小屋 904

HiCMAE 论文复现:基于 RAVDESS 数据集的音视频情感识别

多模态情感识别是人工智能领域的重要研究方向,旨在通过结合多种感知模态(如音频、视频、文本等)来更准确地识别人类情感状态。与传统单模态方法相比,多模态方法能够利用不同模态间的互补信息,提高情感识别的鲁棒性和准确性。 RAVDESS(Ryerson Audio-Visual Database of Emotional Speech and Song)是一个常用的多模态情感识别数据集,包含24位专业演员(12名男性,12名女性)表达的8种情感状态(中性、平静、快乐、悲伤、愤怒、恐惧、厌恶和惊讶)的音视频数据。

max500600的博客 499

基于 AutoFlow 快速搭建基于 TiDB 向量能力的本地知识库问答机器人

作者: 数据源的TiDB学习之路 原文来源: https://tidb.net/blog/a880fc9e ...

TiDB 社区干货传送门 496

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Deepseek+RagFlow本地部署使用快速构建知识库

参考文献:参考文献:

m0_61891910的博客 407

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

GraphRAG应用案例:PingCAP AutoFlow对话式知识库

AutoFlow是一个开源的基于知识图谱(GraphRAG)的对话式知识库工具,它构建于TiDB Serverless向量数据库、LlamaIndex和DSPy之上。•访问TiDB.AI体验。•内置高级网站爬虫,能够轻松抓取官方网站和文档站点信息,提供全面且高效的搜索体验。•用户可以编辑知识图谱,添加信息或更正错误,确保信息准确性和时效性。•只需复制粘贴一段简单的JavaScript代码,即可将对话式搜索窗口嵌入到您的网站,通常位于网站右下角,方便用户快速获取产品相关信息。•。

m0_65555479的博客 1137

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

tidb-chat2query使用

【代码】tidb-chat2query使用。

weixin_43193026的博客 287

大模型:2024开源项目汇总

当大模型成本逐渐降低,可靠性提升后,这意味着越来越多的业务应用将会与 LLM 结合,为了让这种结合更加顺畅,需要有与现有来支撑 LLM 应用开发的快速开发应用构建工具: 插件中心, 流程编排, Prompt工程, RAG, Agent模型开发工具: 训练数据管理, 模型调优, 模型评测, 模型部署对比说明可参考:**2.1 Dify:**开源的 LLM 应用开发平台。其直观的界面结合了 AI 工作流、RAG 、Agent、模型管理、可观测性功能等,让您可以快速从原型到生产。

z099164的博客 3359

chat2db初步使用和体验AI

功能: 1.传统客户端能使用的功能基本都有,并且增加了导出excel等便捷的能力。可以根据输入的汉语例如我要查询某个表的什么条件下的记录,可以解析成sql后执行。可以根据查询结果进行对应报表可视化显示。

qq_33790251的博客 883

使用 TiDB Vector 搭建 RAG 应用 - TiDB 文档问答小助手

原文来源: https://tidb.net/blog/7a8862d5 ...

TiDB 社区干货传送门 571

5分钟快速集成webrtc_android:从环境配置到发起第一通视频通话

webrtc_android是一个基于WebRTC技术的视频通话和视频会议解决方案,帮助开发者快速在Android应用中集成实时音视频功能。本文将带你从环境配置开始,一步步完成视频通话功能的集成,让你在5分钟内实现第一通视频通话。 ## 一、环境准备:快速搭建开发环境 🚀 ### 1. 克隆项目代码 首先,将项目代码克隆到本地开发环境: ```bash git clone https://g

gitblog_01045的博客 1007

大模型实战项目:开源项目大盘点

当大模型成本逐渐降低,可靠性提升后,这意味着越来越多的业务应用将会与 LLM 结合,为了让这种结合更加顺畅,需要有与现有基础设施相兼容的工具和框架来支撑 LLM 应用开发的快速开发

程序员鑫港的博客 2432

RAG升级-基于知识图谱+deepseek打造强大的个人知识库问答机器人

近年来,RAG(Retrieval-Augmented Generation,检索增强生成)技术在人工智能领域掀起了一股热潮。随着大模型的快速发展,传统的纯生成式方法在面对复杂、多变的信息需求时,往往面临上下文有限、事实准确性不足等挑战。而RAG通过结合信息检索(Retrieval)与文本生成(Generation)两大核心能力,使模型能够在实时获取外部知识的基础上生成更精准、可信的内容。这一技术不仅提升了AI的回答质量,还在搜索引擎、智能助手、企业知识管理等多个应用场景展现出了巨大潜力。

m0_59164304的博客 1419
上一篇: 使用GraphRAG+LangChain+Ollama:LLaMa 3.1跑通知识图谱与向量数据库集成(Neo4j)
下一篇: 从入门到精通Transformer,掌握NLP技术这本书必看《从零开始构建最先进的NLP模型》
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值