


我将向你展示如何使用 LLama 3.1(一个本地运行的模型)来执行GraphRAG操作,总共就50号代码。。。
首先,什么是GraphRAG?GraphRAG是一种通过考虑实体和文档之间的关系来执行检索增强生成的方式,关键概念是节点和关系。
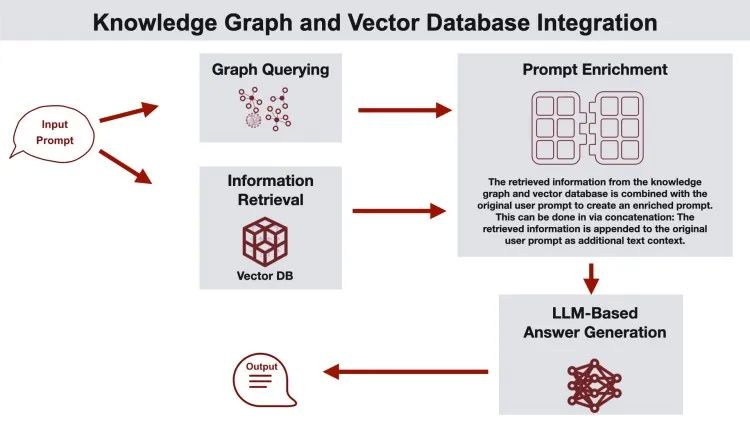
▲ 知识图谱与向量数据库集成
知识图谱与向量数据库集成是GraphRAG 架构之一:这种方法利用知识图谱和向量数据库来收集相关信息。知识图谱的构建方式可以捕获向量块之间的关系,包括文档层次结构。知识图谱在从向量搜索中检索到的块附近提供结构化实体信息,从而通过有价值的附加上下文丰富提示。这个丰富的提示被输入到 LLM 中进行处理,然后 LLM 生成响应。最后,生成的答案返回给用户。此架构适用于客户支持、语义搜索和个性化推荐等用例。
节点代表从数据块中提取的实体或概念,例如人、组织、事件或地点。
知识图谱中,每个节点都包含属性和特性,这些属性为实体提供了更多上下文信息。
然后我们定义节点之间的连接关系,这些连接可以包括各种类型的关联,例如层次结构(如父子关系)、时间顺序(如前后关系)或因果关系(因果关系)。
关系还具有描述连接性质和强度的属性。当你有很多文档时,你会得到一个很好的图来描述所有文档之间的关系。
让我们看一个非常简单的例子,在我们的数据集中,节点可以代表像苹果公司和蒂姆·库克这样的实体,而关系则可以描述蒂姆·库克是苹果公司的 CEO。
这种方法非常强大,但一个巨大的缺点是它**计算成本很高,因为你必须从每个文档中提取实体,并使用 LLM 计算关系图。**这就是为什么使用像 LLaMa 3.1 这样本地运行的模型来采用这种方法非常棒。
保姆级教程开始
在本文中,我们将结合使用LangChain、LLama 和 Ollama ,以及 Neo4j 作为图数据库。我们将创建一个关于一个拥有多家餐厅的大型意大利家庭的信息图,所以这里有很多关系需要建模。
先利用Ollama拉取llama3.1 8b模型:
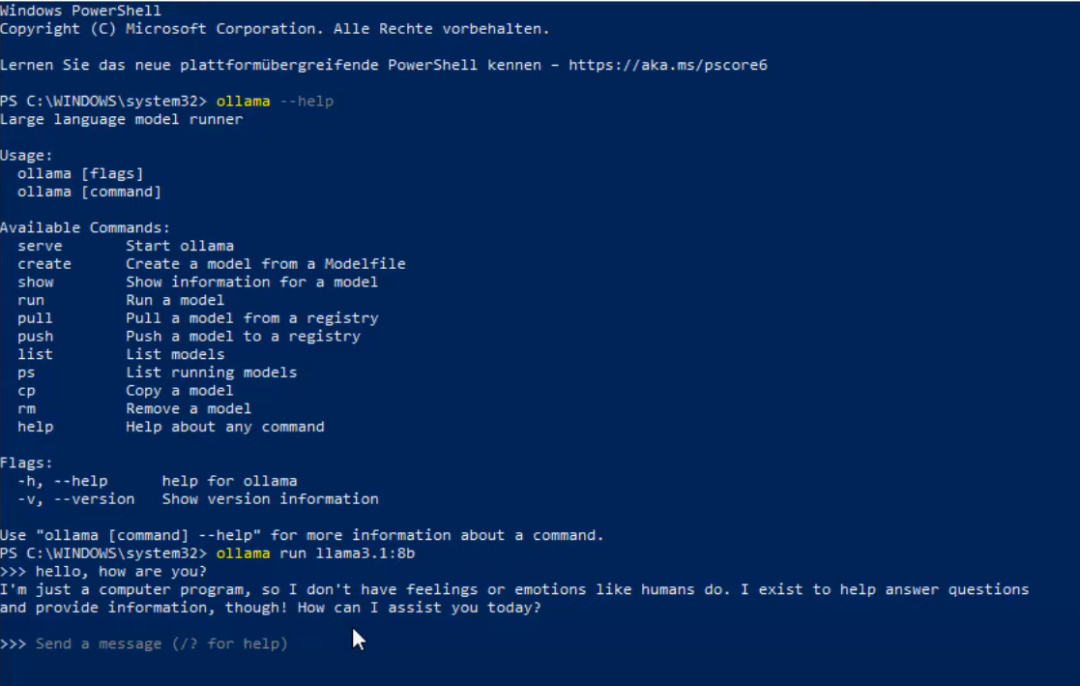
所有代码的链接我放在文末。。。
打开代码文件,来到VS Code 中,你可以在左边看到我们将使用的多个文件。
配置运行Neo4j数据库
在进入代码之前,我们将设置 Neo4j。我为你创建了一个 Docker Compose 文件。所以我们将使用 neo4j 文件夹,里面有一个 jar 文件,这是我们创建图所需的插件。
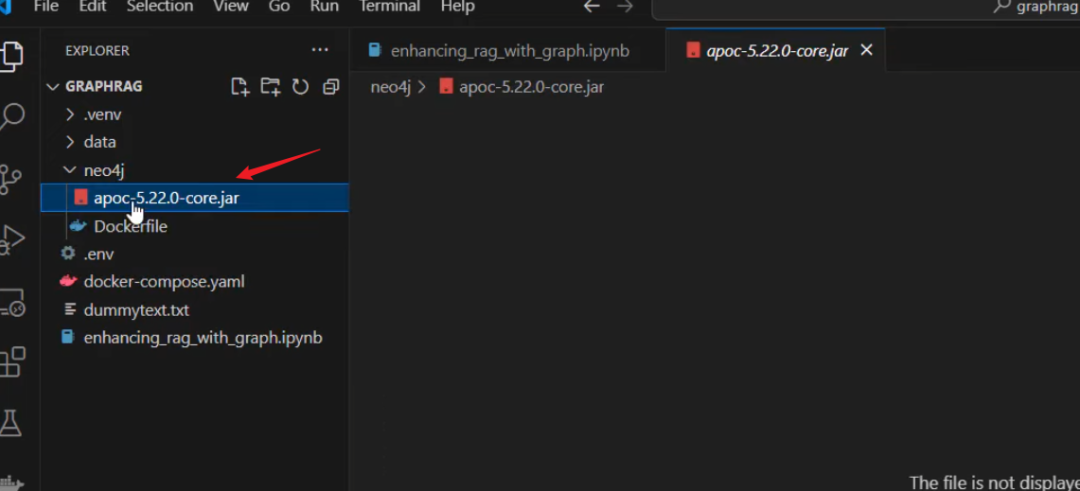
要创建我们的数据库,只需运行 docker compose up:
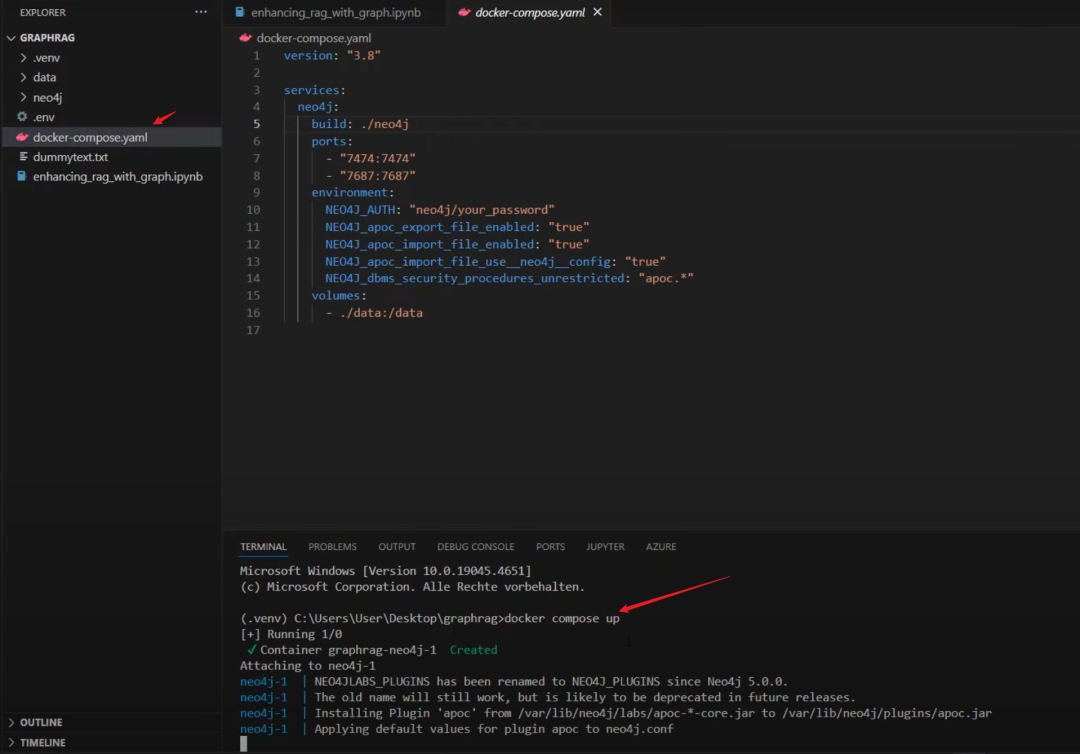
这将设置所有内容,并且可以直接使用。可能需要几秒钟,之后你会看到数据库正在运行。
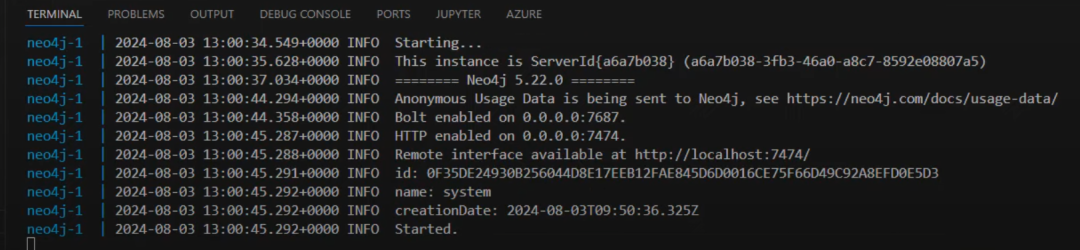
安装依赖
然后我们可以进入 Jupyter Notebook,首先安装所需的包:
我们需要安装 LangChain、OpenAI 的 LangChain、Ollama、LangChain Experimental,因为图解决方案目前在 LangChain 实验包中。
我们还需要安装 Neo4j,以及用于在 Jupyter Notebook 中显示图的 py2neo 和 ipywidgets。
代码语言:javascript
复制
%pip install --upgrade --quiet langchain langchain-community langchain-openai langchain-ollama langchain-experimental neo4j tiktoken yfiles_jupyter_graphs python-dotenv
导入类
安装完这些包后,我们可以导入所需的类。我们将从 LangChain 中导入多个类,例如 Runnable Pass Through、Chat Prompt Template、Output Parser 等。
我们还导入 Neo4j 的图类,这在 LangChain Community 包的 Graphs 模块中。我们还导入 Chat OpenAI 作为 Ollama 的后备模型。
在 LangChain Experimental 包中,我们有一个 Graph Transformer 模块,我们将从那里导入 LLM Graph Transformer,它利用复杂的提示将数据转换为可以存储在图数据库中的形式。
我们还将导入 Neo4j 的图数据库,不仅作为图数据库使用,还可以作为普通的向量数据库使用。
代码语言:javascript
复制
from langchain_core.runnables import  RunnablePassthrough
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.pydantic_v1 import BaseModel, Field
from langchain_core.output_parsers import StrOutputParser
import os
from langchain_community.graphs import Neo4jGraph
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import ChatOpenAI
from langchain_community.chat_models import ChatOllama
from langchain_experimental.graph_transformers import LLMGraphTransformer
from neo4j import GraphDatabase
from yfiles_jupyter_graphs import GraphWidget
from langchain_community.vectorstores import Neo4jVector
from langchain_openai import OpenAIEmbeddings
from langchain_community.document_loaders import TextLoader
from langchain_community.vectorstores.neo4j_vector import remove_lucene_chars

from dotenv import load_dotenv

load_dotenv()
我们将采用混合方法,既使用图知识,也使用标准的文档搜索方式,即通过嵌入模型来搜索与查询最相似的文档。
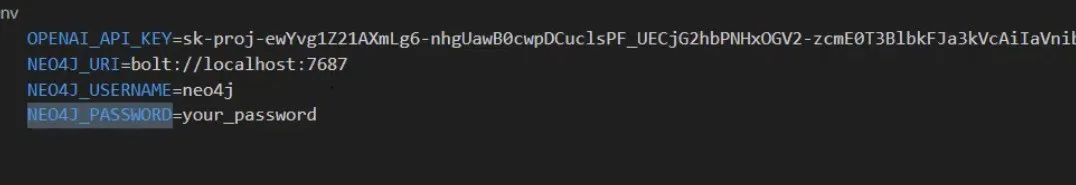
我们还将使用 dotenv 包,并在 Jupyter Notebook 中加载环境变量。在 .env 文件中,有一个 OpenAI API 密钥、一个 Neo4j URI、Neo4j 用户名和密码。你可以按原样使用这些信息,但在仓库中,它们将被命名为 .env.example。
下一步是创建与数据库的连接。所以我们实例化 Neo4j 图类,
这将建立与 Neo4j 的连接。
准备dummy_text.txt 数据集
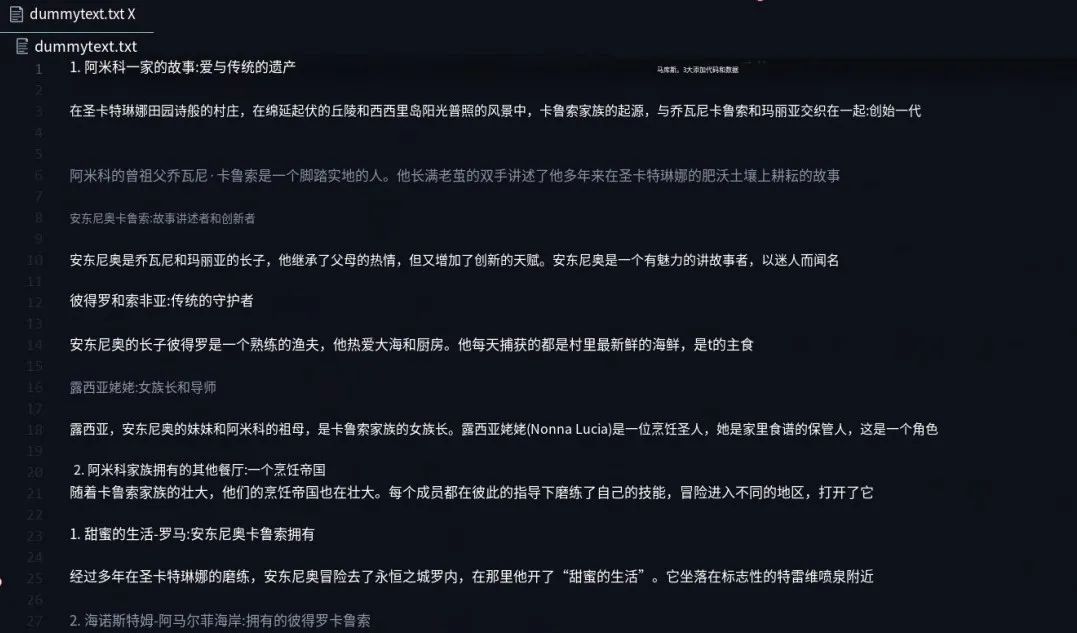
你可以看到它描述了这个意大利家庭的大量信息,包括不同的名字、关系,如 Antonio 的妹妹 Amo、祖母等。这些信息稍后都将在我们的图中呈现。
我们将使用文本加载器将其加载到内存中,
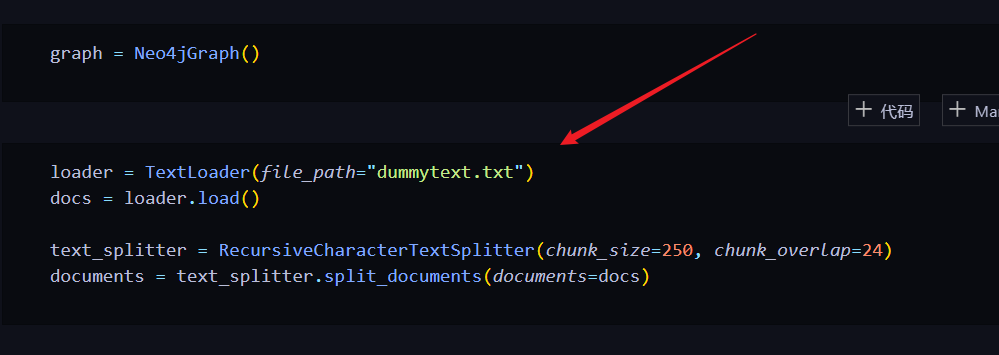
然后使用文本分割器将其分割成多个块,这是标准的方法,以便 LLM 更容易处理信息。
LLM图转换函数创建文档块之间的所有关系
加载后,我们将设置我们的 LLM 图变换器,它负责将文档转换为 Neo4j 可以处理的形式。
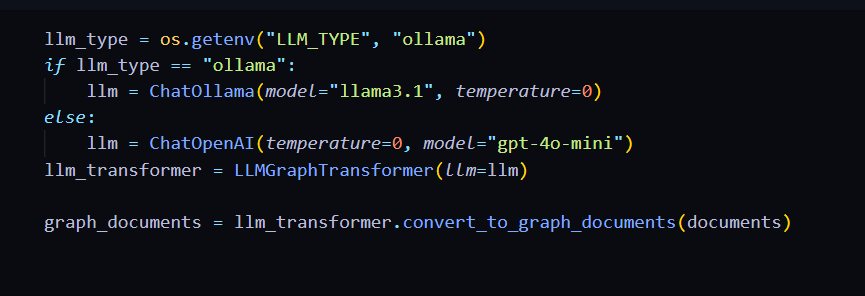
基于环境变量 llm_type,目前我没有设置,所以默认是 Ollama。我们将实例化 ChatOllama 或 ChatOpenAI,然后将其传递给 LLM 图变换器的构造函数。
convert_to_graph_documents 方法将创建文档块之间的所有关系。我们传入创建的文档,计算可能需要一些时间,即使是这个很小的例子,也花了我大约 3 分钟时间,所以稍等片刻。
运行结果来了:这是一个图文档,你可以看到我们有一个 nodes 属性,它是一个包含不同节点的列表,具有 ID。我们可以看到 ID 类似于 Micos Family,类型是 Family,然后我们还有更多的节点,如 Love 概念节点、Tradition 等等。
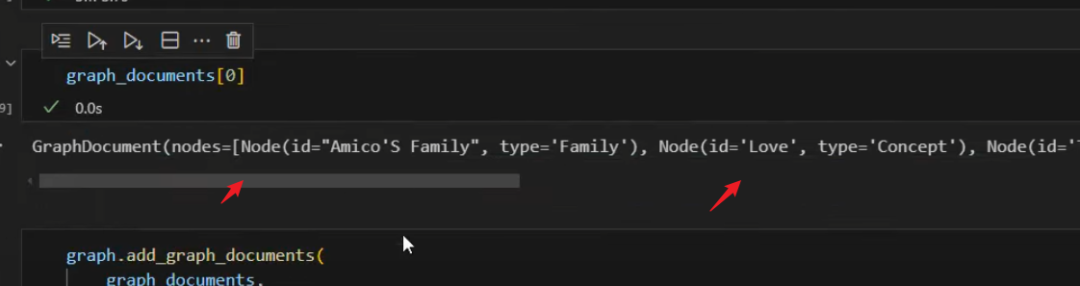
他们之间也有关系,这些关系将被存储在 Neo4j 中。
可视化我们的图
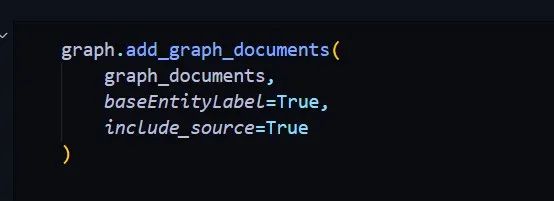
当前我们还没有启动数据库,所以我们需要先运行 add_graph_documents 方法,提供图文档,然后将所有内容存储在 Neo4j 中。这也可能需要几秒钟时间。文档存储到数据库后,我们可以可视化它们。
首先我们要连接到数据库,我们将使用驱动方法,传入我们的 URI(存储在 Neo4j URI 环境变量中),还需要提供用户名和密码进行身份验证,并创建驱动实例。然后我们创建一个新会话,并使用会话的 run 方法对 Neo4j 运行查询。我们将使用这个查询语句:
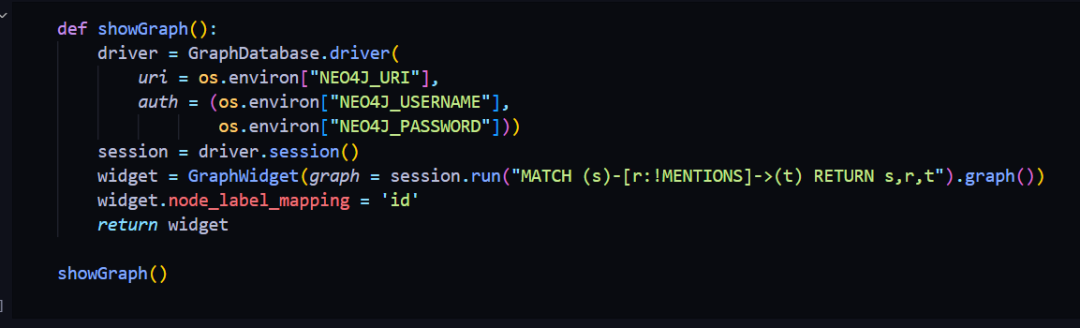
如果你不熟悉 Neo4j 可能会觉得有点复杂,但它的意思是 Neo4j 应该返回所有通过 mentions 类型的关系连接的节点对,我们想返回 s, r, 和 t。s 是起始节点,r 是结束节点,t 是关系。
我们可以运行这个方法,并实际可视化我们的图:
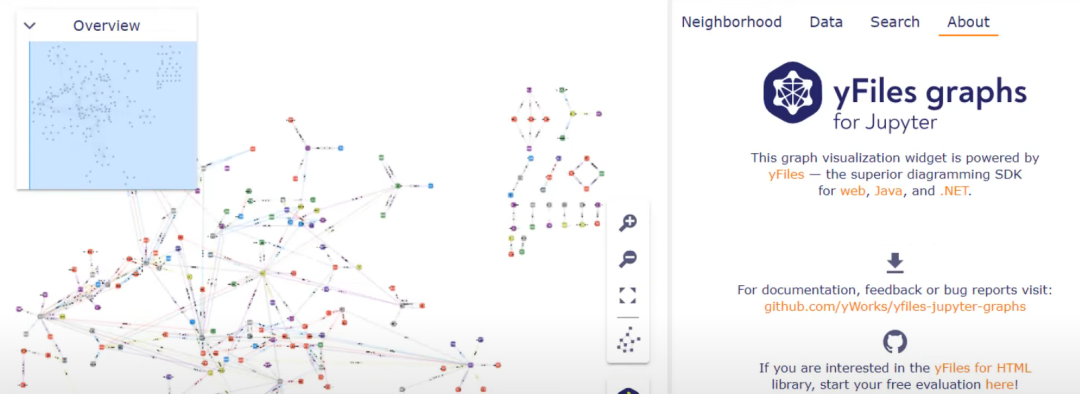
现在我们可以向下滚动,这里我们可以看到这是我们的文档的完整知识图谱。正如你所看到的,这相当多,我们可以通过滚动来深入了解更多信息。这里我们可以看到一些实体,比如 Petro 是一个人,我们可以看到 Petro 喜欢厨房、喜欢大海,并且是另一个人 Sophia 的家长。

所以我们可以看到不同的实体通过不同的关系建模,最终你得到了这个非常大的知识图谱。我认为即使是对于我们的小数据集,这也实际上是很多内容。我个人非常喜欢这种图。现在我们来看一下这不仅仅是美观,实际上也很有用。
图的存储做完了,再来一个向量存储
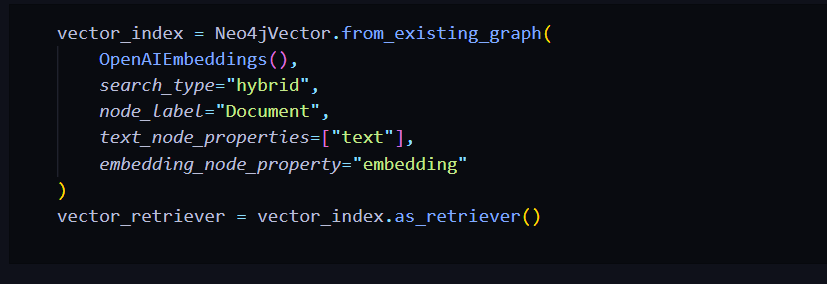
下一步是从 Neo4j 创建一个向量存储,所以我们将使用 Neo4jVector 类,并使用 from_existing_graph 方法,在这里我们只传入嵌入模型,从现有图中计算嵌入。这样我们也可以执行向量搜索,最终我们将把这个向量索引转换成一个检索器,以便有一个标准化的接口。
为图数据库准备实体(Prompt实体识别)
现在我们有一个图数据库,存储了我们的文档,也有了普通的向量存储。现在我们可以执行检索增强生成。由于我们使用图数据库,我们需要从查询中提取实体,以便从图数据库中执行检索步骤。
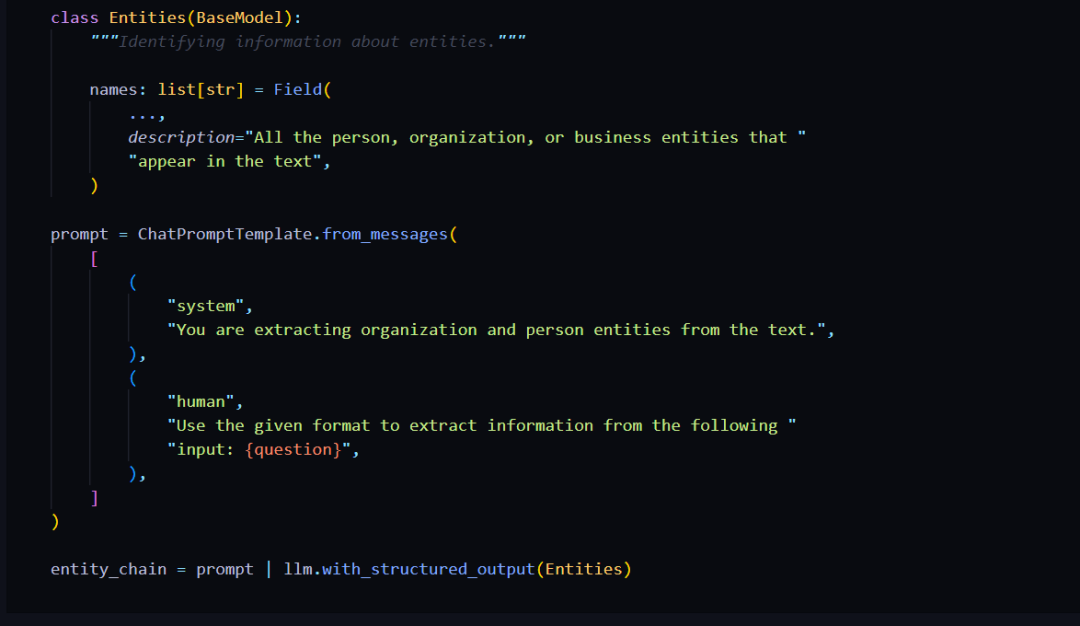
图数据库需要这种实体,所以我们将创建一个名为 Entities 的自定义模型,继承自 BaseModel,我们希望提取实体,这可以通过提供这个属性 entities 来完成,它是一个字符串列表。这里是 LLM 的描述,所以我们希望提取文本中的所有人、组织和业务实体。
▲ Langchain教程操作有类似
然后我们创建一个 ChatPromptTemplate,系统消息是你正在从文本中提取组织、个人和业务实体。然后我们提供用户输入,并将我们的提示模板传递给 LLM,与结构化输出一起使用,这使用了 Entities 类。我将向你展示其效果。
我们得到了我们的实体链,并可以像这样调用它。我们传入问题 “Who are Nonna and Giovanni Corrado?”,所以我们有两个名字,执行调用方法后,我们可以看到输出是一个字符串列表,只有名字,
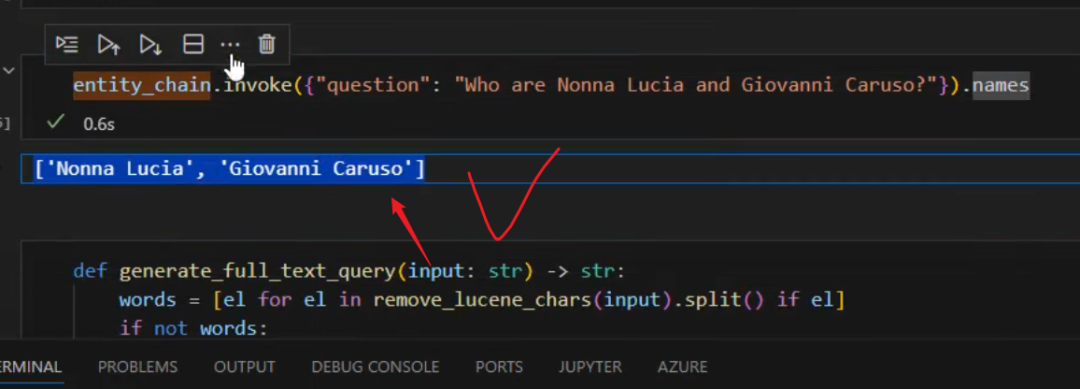
这些名字将用于查询图数据库。接下来是在 graph_retriever 函数中调用这个方法。首先从查询中提取实体,然后对 Neo4j 运行查询,我将向你展示最终效果。
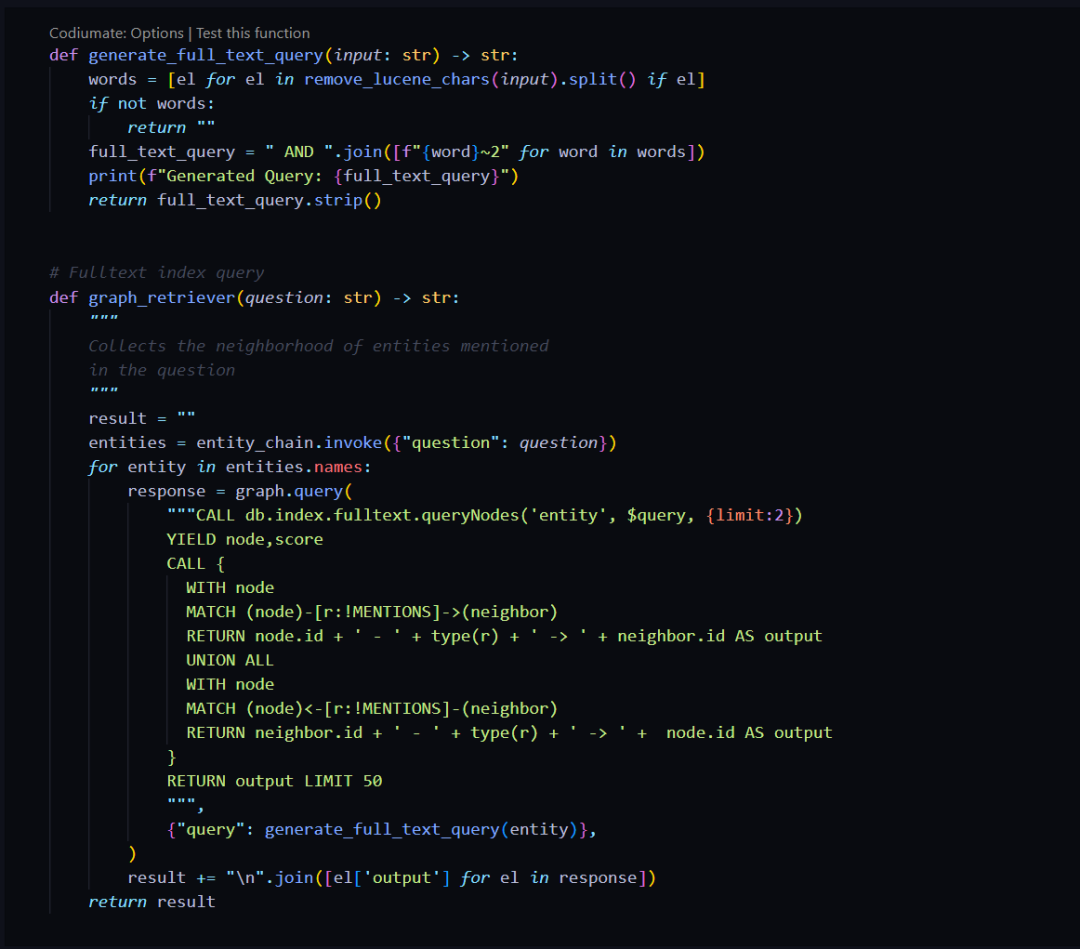
我们创建了 graph_rae 函数,传入问题,提取实体,然后查询数据库。
我们问 “Who is Nonna?”,如果运行这个查询,我们可以看到 Nonna 拥有哪些节点和连接。她影响了 Conato,教导了孙子们,影响了新鲜意大利面,影响了 Amico,是家族的女族长。
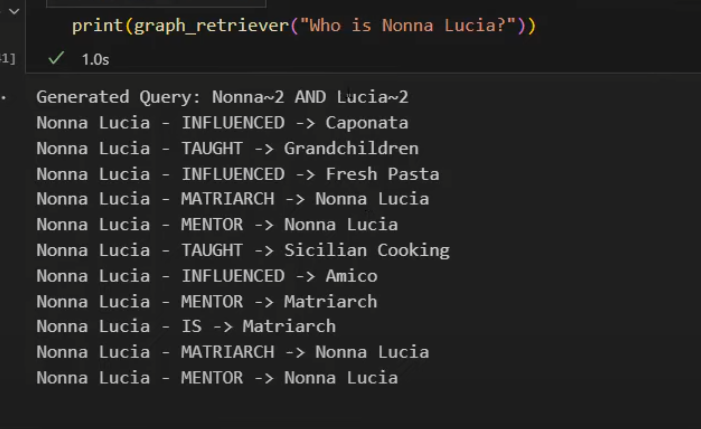
创建一个混合检索器
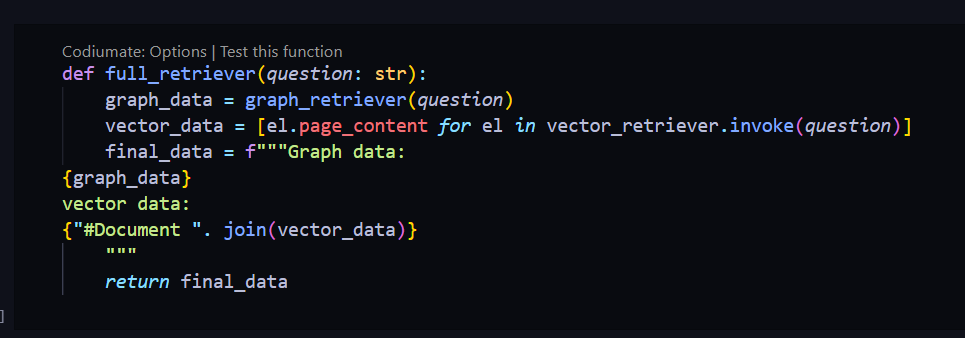
然后我们创建一个混合检索器,使用 graph_retriever 和我们的向量存储检索器。我们定义一个函数 full_retriever,在这里设置我们的 graph_retriever 函数,并使用向量检索器,调用其 invoke 方法,获取最相关的文档。我们有了关系图和基于余弦相似度的最相关文档,最终我们将所有文档结合,返回最终数据集。这就是 full_retriever 的作用。
最终链
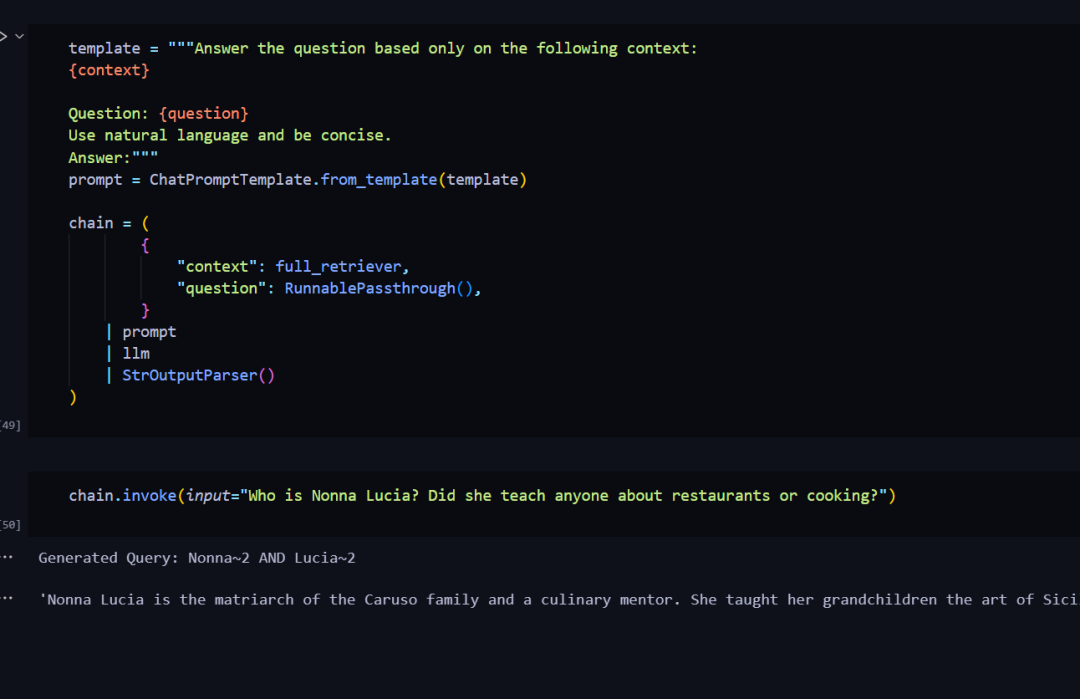
然后我们创建一个最终链,这是一个普通的 RAG 链,你在几乎所有初学者教程中都会找到这样的链。我们有两个变量,context 和 question,context 是向量存储或其他数据库的输出,question 是我们的问题。所有这些都将发送给 LLM,我们创建一个模板,然后使用 Lang 和表达式语言在这里创建我们的最终链。这将创建一个 runnable_parallel,我将展示其 invoke 方法。
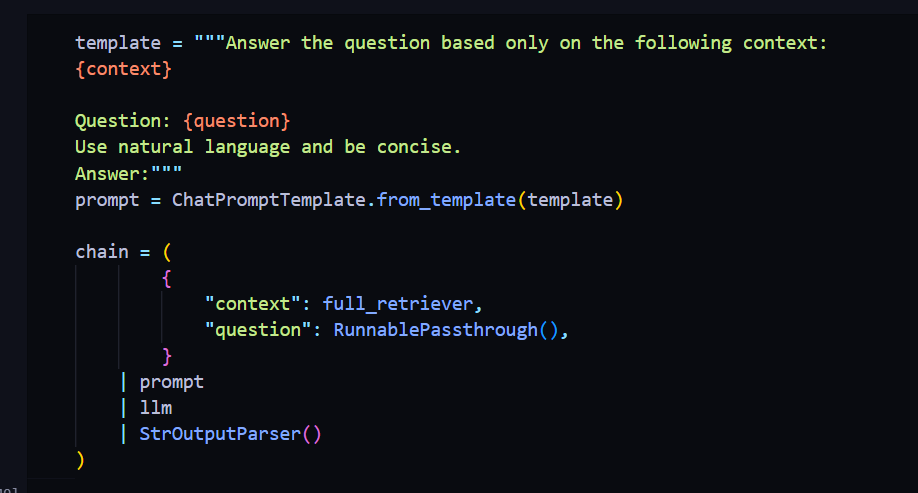
我们只使用一个字符串输入,传递给 full_retriever 函数,保持问题不变,然后将 context 和 question 传递给我们的提示,以填充这些变量。填充这些变量后,我们将所有内容传递给 LLM,并将 LLM 的输出传递给字符串输出解析器。
现在我们可以问 “Who is Nonna Lucia? Did she teach anyone about restaurants or cooking?” 所有关于关系的东西,执行结果:
代码语言:javascript
复制
Generated Query: Nonna~2 AND Lucia~2
'Nonna Lucia is the matriarch of the Caruso family and a culinary mentor. She taught her grandchildren the art of Sicilian cooking, including recipes for Caponata and fresh pasta.'
我们可以看到答案是 Nonna Lucia 是 Corrado 家族的女族长和烹饪导师。她教导了她的孙子们西西里烹饪的艺术, 这确实是正确的。
这就是如何使用 Neo4j 执行图数据库 RAG。
附件:
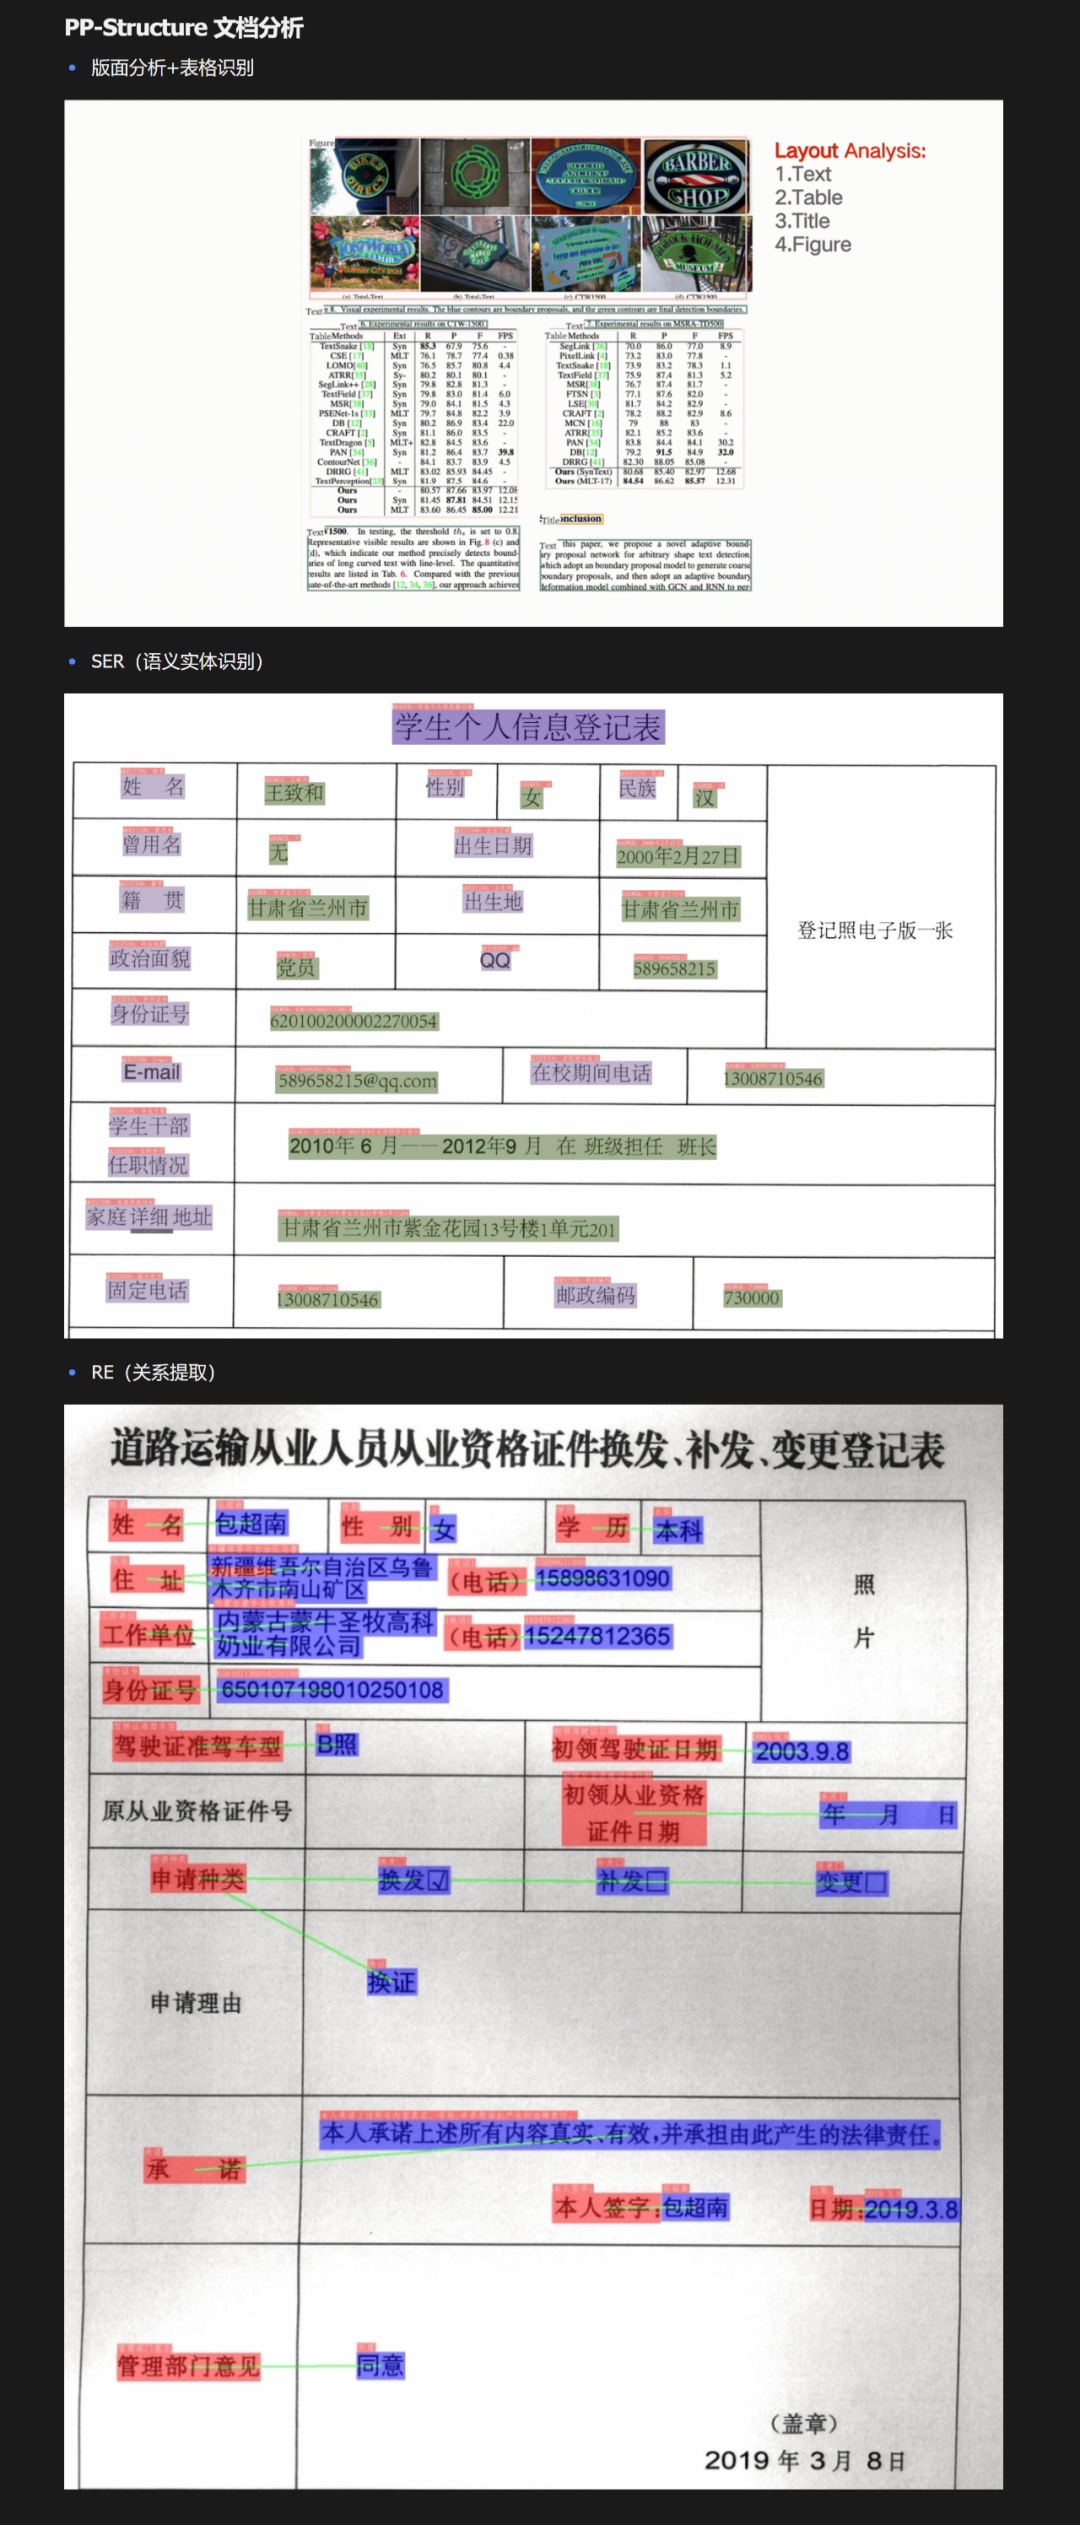
以前看过的一个叫PP-Structure文档分析的项目,
信息抽出其中的实体识别。。。
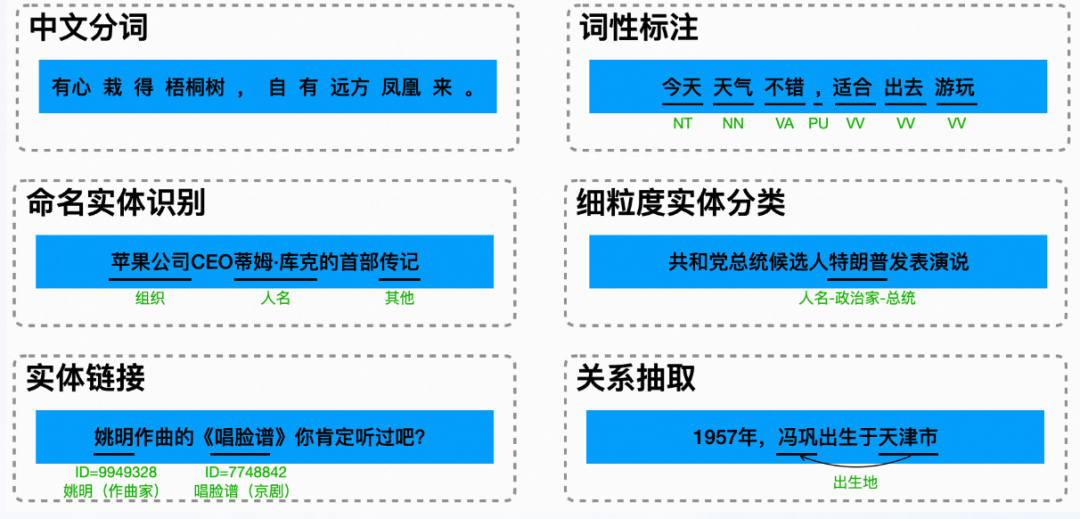
▲ 信息抽取 是自然语言处理中的基础问题,即从自然语言文本中,抽取出特定的事件或事实信息,帮助我们将海量内容自动分类、提取和重构。
🌟希望这篇文章对你有帮助,感谢阅读!
参考链接: [1] 全文代码:https://github.com/Ai-trainee/GraphRAG-with-Llama-3.1/tree/main [2] GraphRA所有架构:https://gradientflow.com/graphrag-design-patterns-challenges-recommendations/ [3] https://microsoft.github.io/graphrag/
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
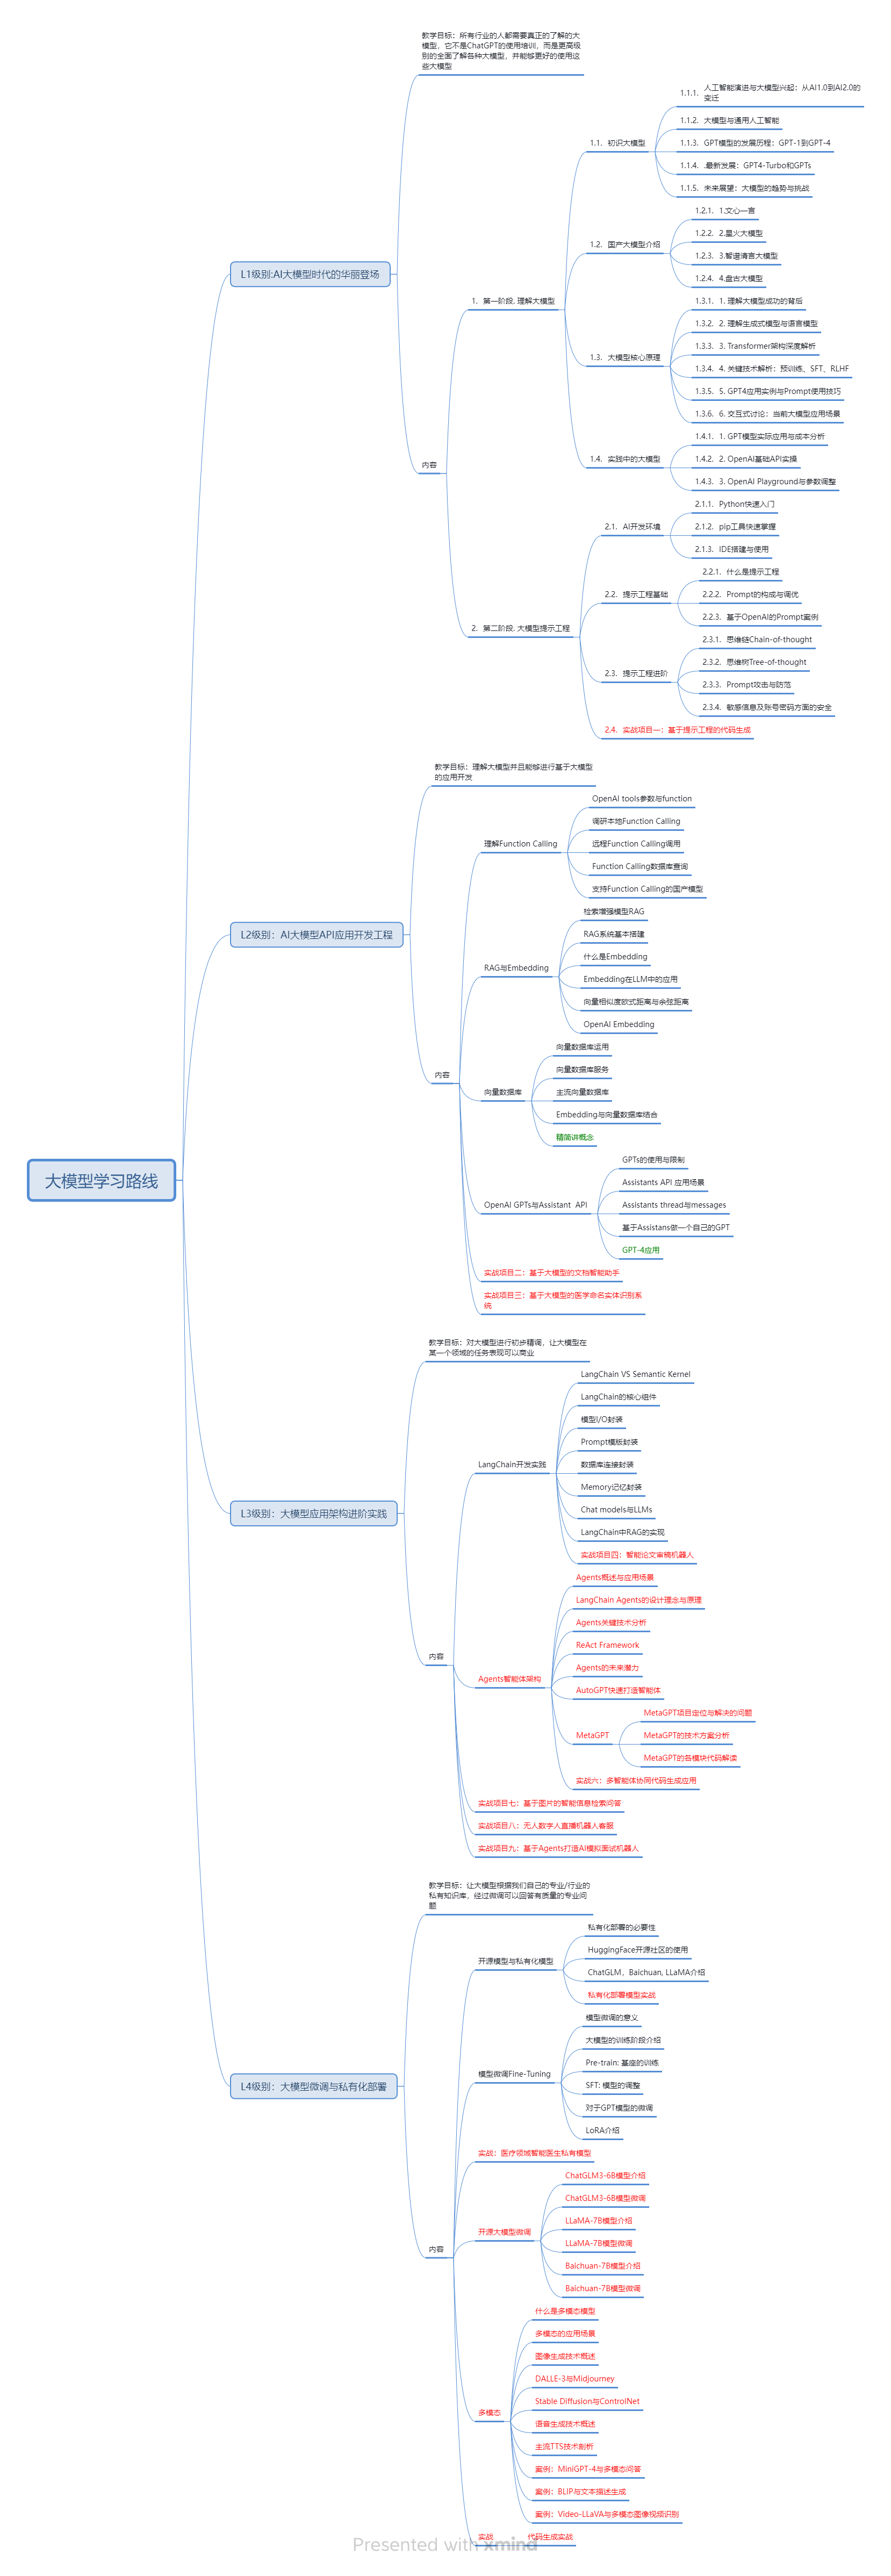
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
二、AI大模型视频教程
三、AI大模型各大学习书籍
四、AI大模型各大场景实战案例
五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 364


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


