Ollama-OCR 只需几行代码,轻松实现高质量文字识别!

Ollama 可以在 Windows 上运行了 阅读详情
AI摘要

本文介绍了开源的Ollama-OCR工具,它使用Llama 3.2-Vision模型进行高精度文本识别,支持多种图像格式,有Markdown输出选项。还阐述了Llama 3.2-Vision的应用场景,如识别手写文本、OCR识别等。此外,给出了配置环境的步骤,并分享了学习大模型的资料和路线。

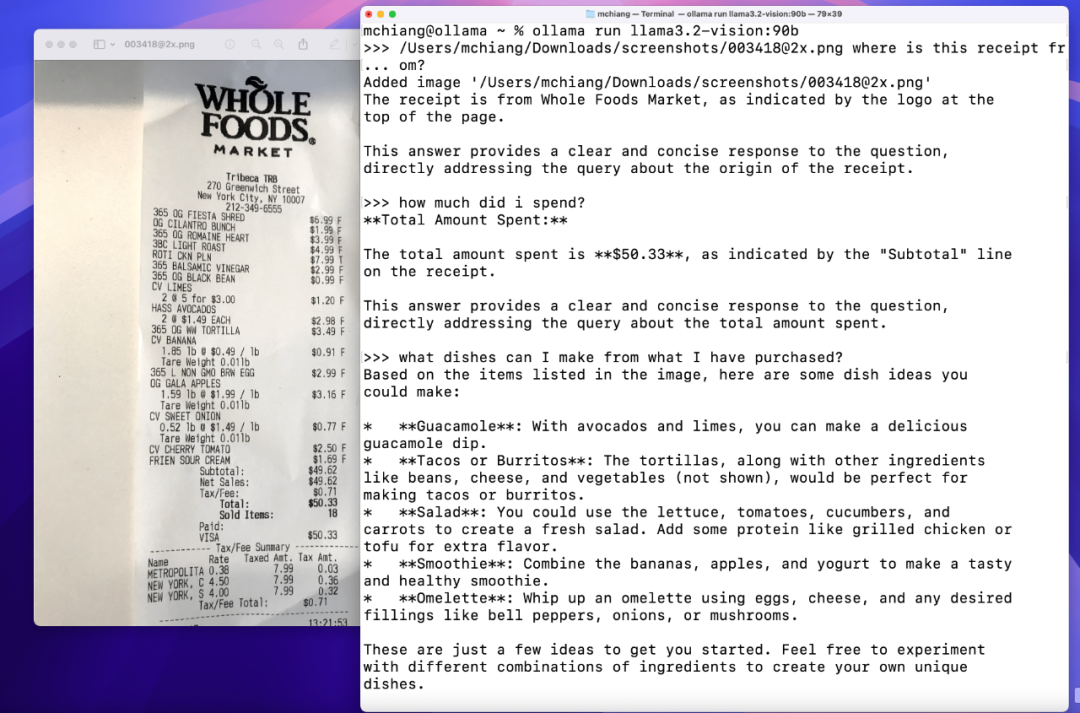
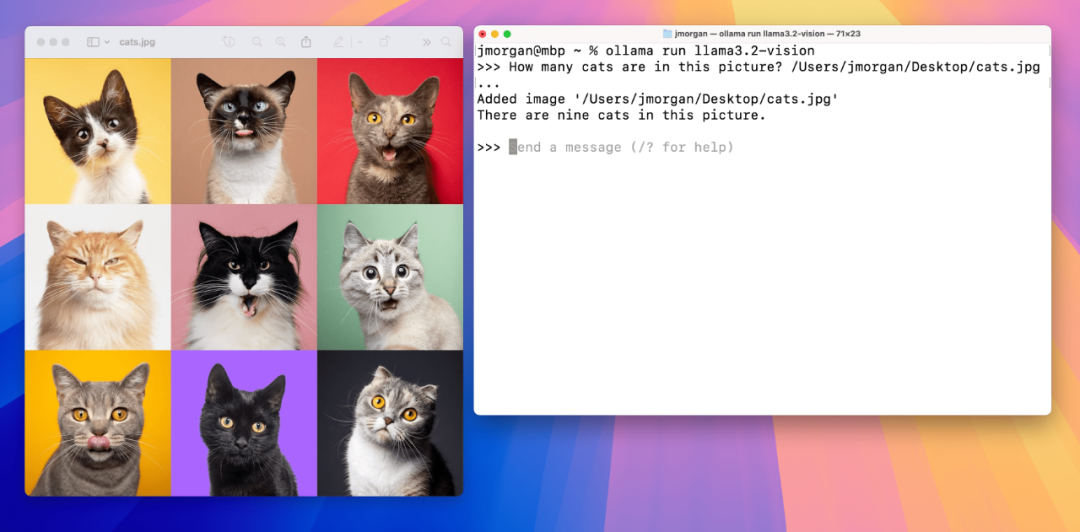
Llama 3.2-Vision 是一种多模态大型语言模型,有 11B 和 90B 两种大小,能够处理文本和图像输入,生成文本输出。该模型在视觉识别、图像推理、图像描述和回答图像相关问题方面表现出色,在多个行业基准测试中均优于现有的开源和闭源多模态模型。

本文将介绍开源的 ollama-ocr[1] 工具,它默认使用本地运行的 Llama 3.2-Vision 视觉模型,可准确识别图像中的文字,同时保留原始格式。

https://github.com/bytefer/ollama-ocr

Ollama-OCR 的特点

  • 使用 Llama 3.2-Vision 模型进行高精度文本识别 保留原始文本格式和结构
  • 支持多种图像格式:JPG、JPEG、PNG
  • 可定制的识别提示和模型
  • Markdown 输出格式选项

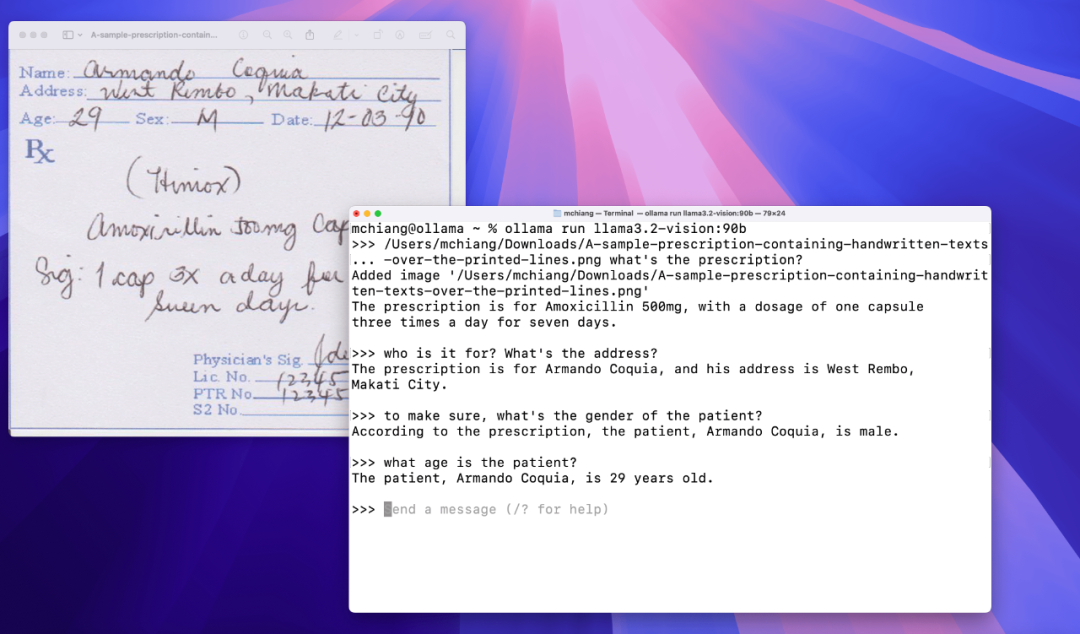
Llama 3.2-Vision 应用场景

识别手写文本
img

OCR 识别

img

图片问答

img

配置环境

安装 Ollama

在开始使用 Llama 3.2-Vision 之前,您需要安装 Ollama[2],这是一个支持在本地运行多模态模型的平台。请按照以下步骤安装:

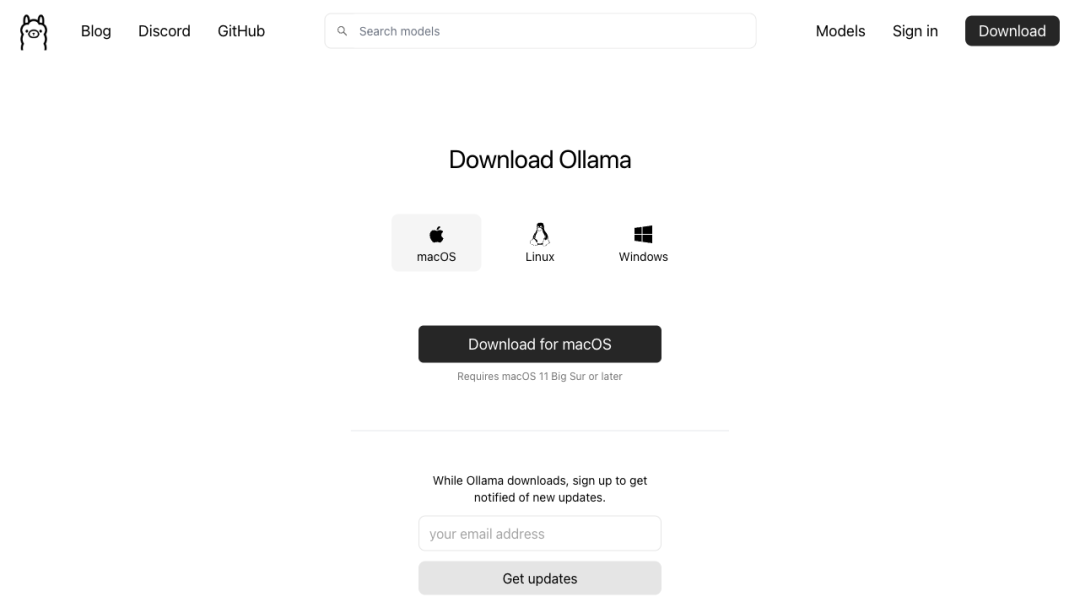
\1. 下载 Ollama:访问 Ollama 官方网站,下载适用于您操作系统的安装包。
img

\2. 安装 Ollama:根据下载的安装包,按照提示完成安装。

安装 Llama 3.2-Vision 11B

安装 Ollama 后,可使用以下命令安装 Llama 3.2-Vision 11B[3]:

ollama run llama3.2-vision

安装 Ollama-OCR

npm install ollama-ocr
# or using pnpm
pnpm add ollama-ocr

使用 Ollama-OCR

OCR

import { ollamaOCR, DEFAULT_OCR_SYSTEM_PROMPT } from "ollama-ocr";

async function runOCR() {
  const text = await ollamaOCR({
    filePath: "./handwriting.jpg",
    systemPrompt: DEFAULT_OCR_SYSTEM_PROMPT,
  });
  console.log(text);
}

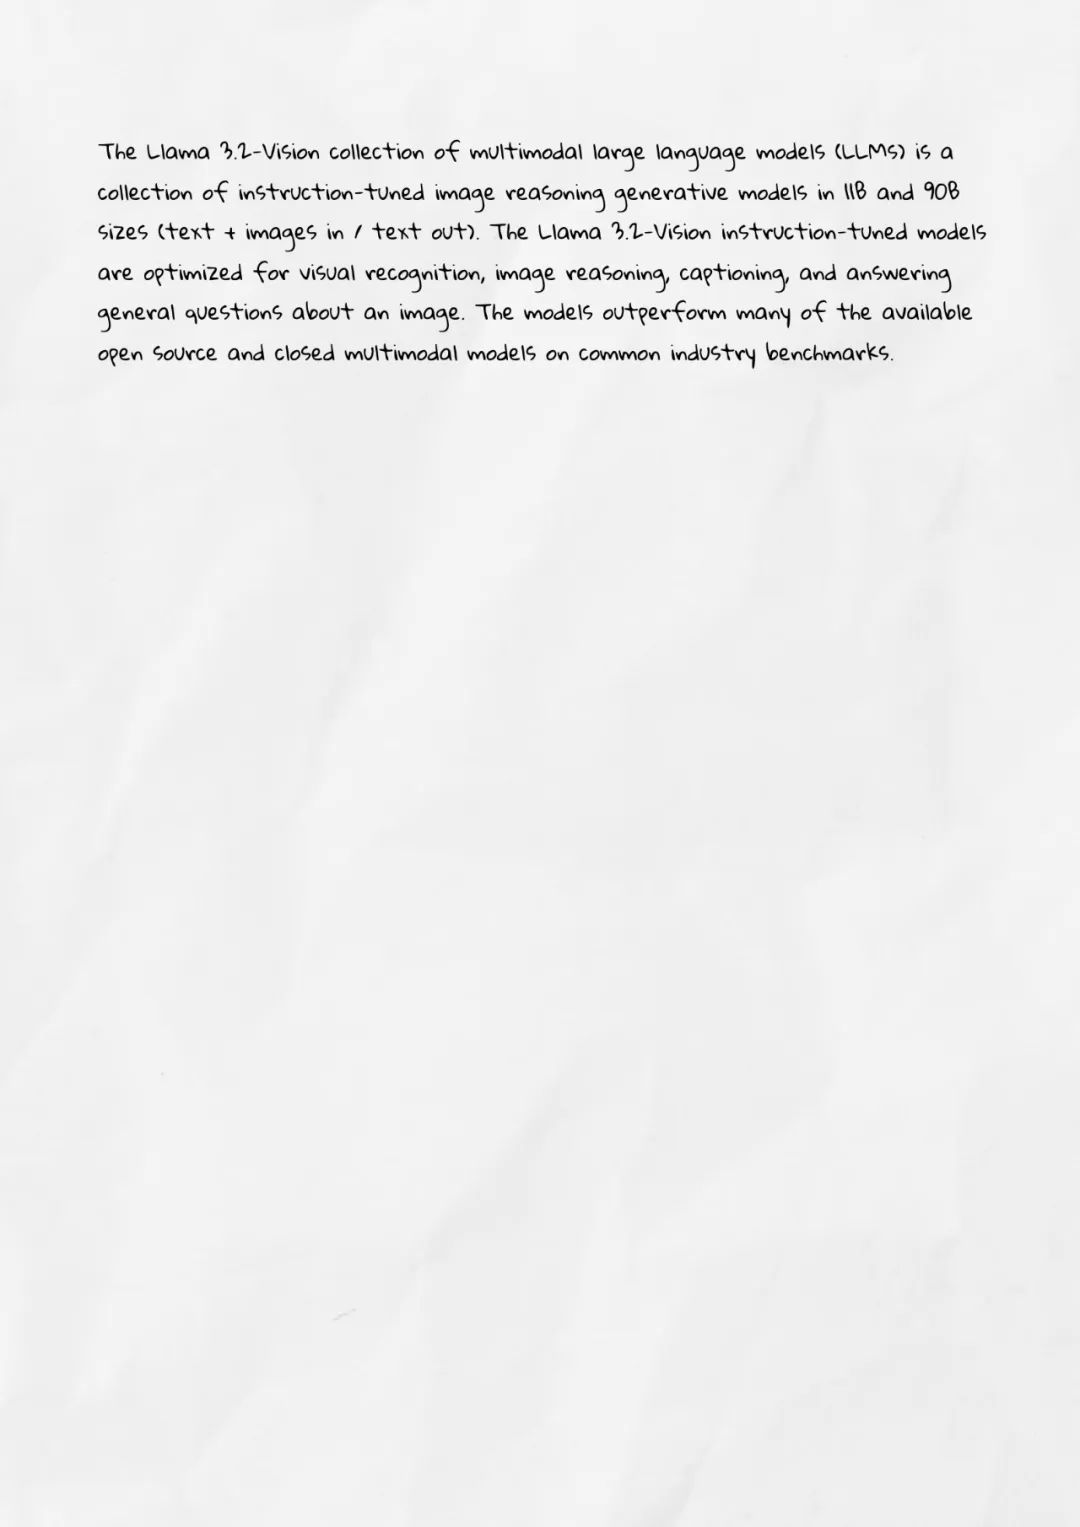
测试的图片如下:
img

输出的结果如下:

The Llama 3.2-Vision collection of multimodal large language models (LLMs) is a collection of instruction-tuned image reasoning generative models in 118 and 908 sizes (text + images in / text out). The Llama 3.2-Vision instruction-tuned models are optimized for visual recognition, image reasoning, captioning, and answering general questions about an image. The models outperform many of the available open source and closed multimodal models on common industry benchmarks.

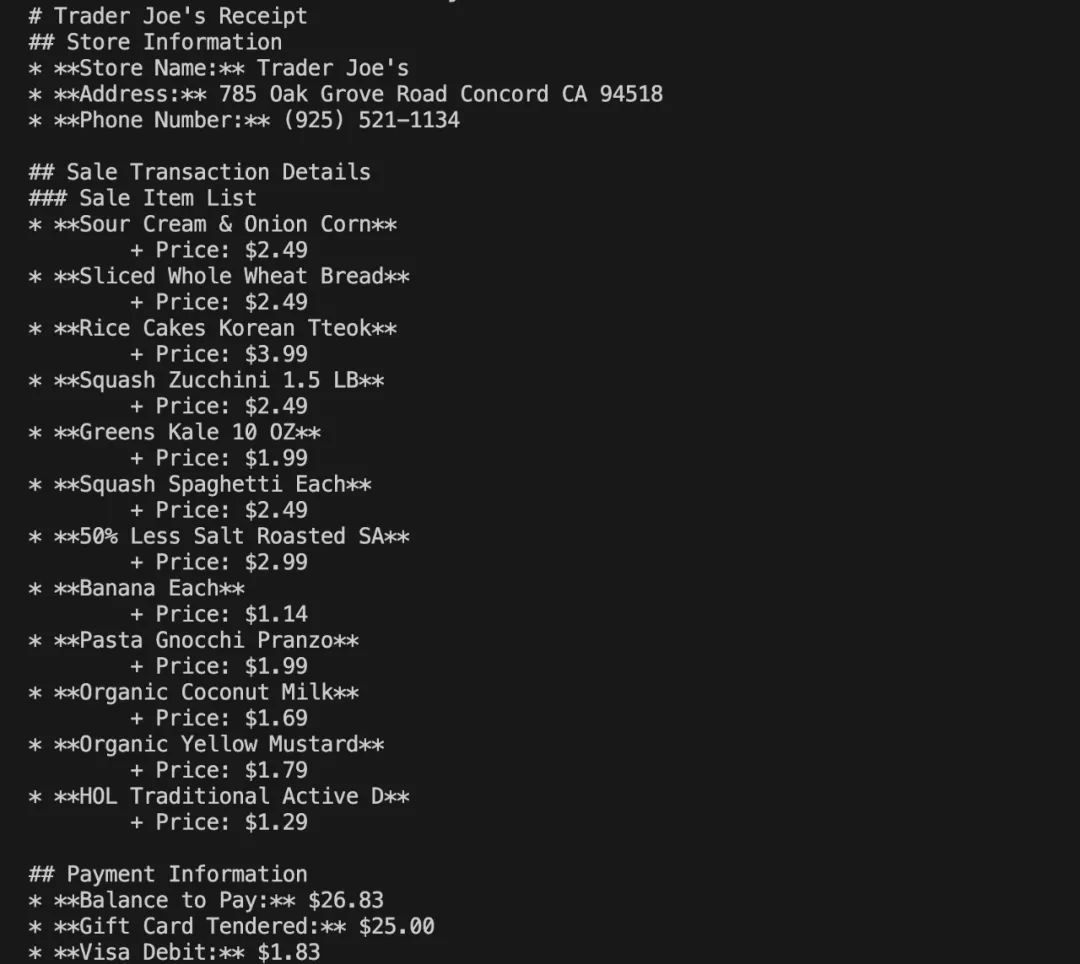
输出 Markdown

import { ollamaOCR, DEFAULT_MARKDOWN_SYSTEM_PROMPT } from "ollama-ocr";

async function runOCR() {
  const text = await ollamaOCR({
    filePath: "./trader-joes-receipt.jpg",
    systemPrompt: DEFAULT_MARKDOWN_SYSTEM_PROMPT,
  });
  console.log(text);
}

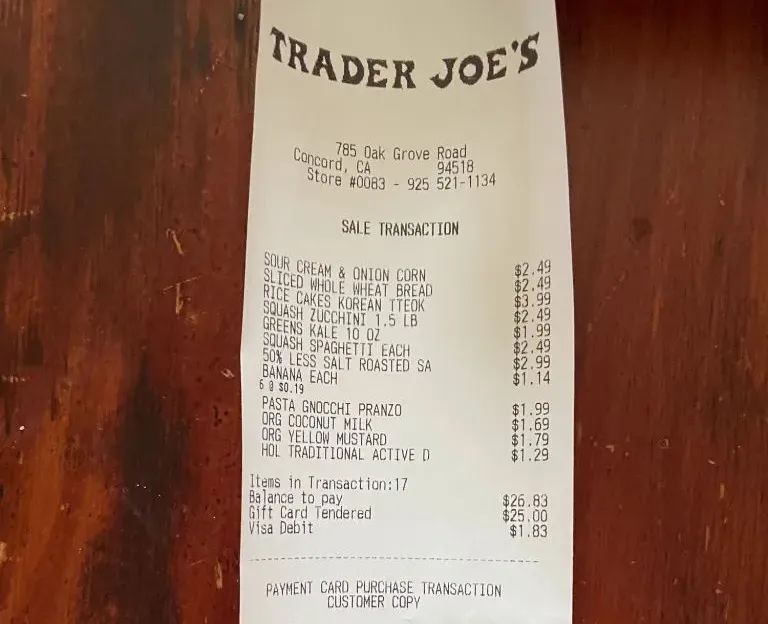
测试的图片如下:
img

输出的结果如下:

img

ollama-ocr 使用的本地的视觉模型,如果你想使用线上的 Llama 3.2-Vision 模型,可以试试 llama-ocr[4] 这个库。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Ollama入门教程:从安装到运行的完整指南 随着人工智能(AI)技术的快速发展,大型语言模型(LLMs)逐渐成为了各行各业的重要工具。然而,使用这些强大模型的同时,数据隐私、处理效率和部署复杂度等问题也逐渐浮现。为了解决这些问题,Ollama 提供了一种创新的解决方案——通过本地化部署大型语言模型,不仅能够增强数据隐私性,还能提高模型的运行效率。本文将详细介绍如何下载和安装 Ollama,如何选择和运行不同的语言模型,以及 Ollama 的特点、适用场景、优缺点等内容,帮助大家深入了解这一平台。ollama官网🚪 ollama官方文档🚪 根据自己 阅读详情

相关推荐

Ollama:一个在本地部署、运行大型语言模型的工具

所谓自定义模型就是不适用Ollama官方模型库中的模型,理论可以使用其他各类经过转换处理的模型Ollama库中的模型可以通过提示进行自定义。python复制代码FROM llama3 # 设置温度参数 PARAMETER temperature 1 # 设置SYSTEM 消息 SYSTEM """作为AI智能助手,你将竭尽所能为员工提供严谨和有帮助的答复。"""Modelfile文档One-API是一个OpenAI接口管理 & 分发系统,支持各类大模型。这里使用Docker快速进行部署。拉取镜像。

2401_84495725的博客 6721

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

VOWIFI--相关的协议文档

一、3GPP相关协议文档 3GPP 23.402 Architecture enhancements for non-3GPP accesse- //重要 整体框架结构和流程,3GPP和NON-3GPP切换 3GPP 36.304  User Equipment (UE) procedures in idle mode //重要,终端在空闲状态下3GPP与NON-3GPP之间的重选方法   3GP

时九博客 3580

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

Matlab Copula函数实战:从金融风控到数据建模的5个应用场景

本文深入探讨了Matlab Copula函数在金融风控与数据建模中的五大实战应用场景,包括投资组合风险价值计算、信用违约相关性建模、跨市场套利策略优化等。通过具体代码示例和数据分析,展示了Copula模型在捕捉复杂依赖关系方面的优势,为金融风险管理和量化分析提供实用工具。

weixin_29090677的博客 425

CentOS 7环境下GLPI与OCS Inventory资产管理系统集成部署指南

本文详细介绍了在CentOS 7环境下,如何将GLPI与OCS Inventory两大开源工具进行集成部署,构建自动化资产管理系统。指南涵盖环境准备、核心服务安装、Web界面初始化、OCS插件配置及资产同步实战,帮助运维人员实现IT资产的自动发现、统一管理与可视化,大幅提升资产管理效率。

weixin_29274337的博客 327

【Ollama-OCR】几行代码,轻松实现高质量文字识别!

Llama 3.2-Vision 是一种多模态大型语言模型,有 11B 和 90B 两种大小,能够处理文本和图像输入,生成文本输出。该模型在视觉识别、图像推理、图像描述和回答图像相关问题方面表现出色,在多个行业基准测试中均优于现有的开源和闭源多模态模型。本文将介绍开源的 ollama-ocr[1] 工具,它默认使用本地运行的视觉模型,可准确识别图像中的文字,同时保留原始格式。

2401_85343303的博客 2124

智能工厂四大系统协同实战:ERP/PLM/MES/WMS集成架构与数据流解析

本文深入解析了智能工厂中ERP、PLM、MES、WMS四大核心系统的协同集成架构与数据流。通过实战案例,阐述了如何打通系统孤岛,实现从产品设计、资源计划、生产执行到仓储物流的数据无缝流转,从而构建高效、敏捷的智能工厂运营体系。

ujm567890的博客 675

轻松实现高质量文字识别:Ollama-OCR的几行代码解决方案

Llama 3.2-Vision 是一种多模态大型语言模型,有 11B 和 90B 两种大小,能够处理文本和图像输入,生成文本输出。该模型在视觉识别、图像推理、图像描述和回答图像相关问题方面表现出色,在多个行业基准测试中均优于现有的开源和闭源多模态模型。本文将介绍开源的 ollama-ocr[1] 工具,它默认使用本地运行的视觉模型,可准确识别图像中的文字,同时保留原始格式。

m0_63171455的博客 1680

论文阅读 Quantum Convolutional neural network

在传统的局域序参量(如磁化强度 ⟨Xi⟩)无法有效区分某些拓扑相(如 Haldane 相)时,字符串序参量(SOP)提供了一种方法来识别这些相。字符串序参量的定义通常涉及多个远离的站点之间的长程关联,通常具有如下形式:Zi,Xk,Zj是泡利矩阵(Pauli operators)。指数项 eiπ∑k=ijXk表示一个相位因子。这意味着我们要计算两个远离站点 i,j 的Z 分量的关联,同时考虑它们之间的X 作用。这个非局域的字符串序参量可以用来检测对称保护拓扑(SPT)相。

m0_54373077的博客 2002

用友U8 API开发实战:手把手教你使用API资源管理器完成单据操作

本文详细介绍了用友U8 API开发实战,重点讲解如何使用API资源管理器完成采购订单、销售出库单等核心业务单据的全生命周期管理。从开发环境搭建到单据查询、新增、修改、删除等基础操作,再到高级功能如审核状态管理、业务事件处理和自定义项扩展,帮助开发者快速掌握用友U8接口开发技巧,提升企业数字化转型效率。

weixin_28607671的博客 596

Ollama+translategemma-27b-it:轻松实现55种语言互译

本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-27b-it镜像,实现55种语言的智能互译。该镜像支持文本和图片翻译,可广泛应用于学术研究、商务沟通和多语言文档处理,显著提升跨语言工作效率。

weixin_35829279的博客 356

别再手动挂载NPU了!手把手教你用Ascend-Docker-Runtime一键启动昇腾AI容器

本文详细介绍了如何使用Ascend-Docker-Runtime一键启动昇腾AI容器,大幅简化NPU设备挂载流程。通过环境变量ASCEND_VISIBLE_DEVICES,开发者可以灵活指定NPU设备,提升开发效率。文章还提供了安装配置指南、高级使用技巧和常见问题排查方法,帮助开发者快速掌握这一高效工具。

weixin_42662605的博客 253

MiniCPM-V-2_6实战:用多模态大模型轻松搞定OCR识别

本文介绍了如何在星图GPU平台自动化部署MiniCPM-V-2_6镜像,实现高效的多模态OCR文字识别。该镜像能够准确识别图片中的文字内容,支持多语言文档处理和表格数据提取,广泛应用于企业文档数字化、教育资料电子化等场景,显著提升文本识别与信息处理效率。

weixin_35973118的博客 247

基于Simulink的PR(比例谐振)控制器在单相整流中的应用

本文详细介绍了基于Simulink的单相整流系统中PR(比例谐振)控制器的设计与实现方法。首先阐述了PR控制器相较于传统PI控制器的优势,能够有效消除交流信号跟踪中的稳态误差。接着系统讲解了PR控制器的传递函数原理、实用型设计(带带宽)及参数整定方法。通过Simulink建模步骤,包括主功率电路搭建、电压外环PI设计、电流指令生成、PR控制器实现(推荐MATLAB Function方法)和SPWM调制等关键环节。仿真对比显示PR控制在电流跟踪精度(THD仅1.9%)、功率因数(0.998)和动态响应(突变恢

amy_mhd的博客 689

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

图片翻译神器translategemma-27b-it:Ollama部署全解析

本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-27b-it镜像,实现高效的本地图片翻译功能。该镜像支持55种语言的图文互译,能自动识别图片中的文字并精准翻译,适用于学术研究、商务文档处理等离线翻译场景,保障数据隐私的同时提升工作效率。

weixin_42594427的博客 358

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

MiniCPM-V-2_6保姆级教程:从安装到实现OCR识别全流程

本文介绍了如何在星图GPU平台上一键自动化部署MiniCPM-V-2_6镜像,实现高效OCR文字识别。该多模态模型能精准提取图片中的文本内容,适用于文档数字化、表格信息提取和多语言识别等场景,大幅提升图文处理效率。

weixin_36238982的博客 116

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

translategemma-12b-it使用指南:图片文字识别翻译全攻略

本文介绍了如何在星图GPU平台自动化部署【ollama】translategemma-12b-it镜像,实现高效的图片文字识别与翻译。该镜像能够快速识别图片中的外文文本并自动翻译为目标语言,典型应用于跨境电商商品说明、多语言文档等场景的自动化处理,显著提升工作效率。

weixin_42360733的博客 91

OCR、文档解析工具合集(二):PaddleOCR、Stirling-PDF、LangExtract、Dolphin、dots.ocr、OCRFlux

OCR、文档解析工具合集(二):PaddleOCR、Stirling-PDF、LangExtract、Dolphin、dots.ocr、OCRFlux

lonelymanontheway的博客 2031

LLaVA-v1.6-7b OCR功能实测:从图片中提取文字如此简单

本文介绍了如何在星图GPU平台上自动化部署llava-v1.6-7b镜像,实现高效OCR文字提取功能。用户通过网页界面上传图片并输入自然语言指令,即可快速从会议笔记、招牌照片、PDF截图等真实场景图像中识别并结构化输出文字内容,显著提升信息提取效率。

weixin_35728286的博客 417

5步搞定:在Ollama上运行translategemma-12b-it翻译模型

本文介绍了如何在星图GPU平台自动化部署【ollama】translategemma-12b-it翻译模型,实现高效的多语言文本与图片文字翻译。该模型支持55种语言互译,可快速处理文档翻译、图片文字提取翻译等场景,显著提升本地化翻译效率与数据安全性。

weixin_28913879的博客 265

translategemma-12b-it多场景落地:Ollama支持短视频字幕+画面文字联合翻译

本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现图文翻译功能。该平台简化了部署流程,用户可快速搭建环境,将模型应用于短视频字幕与画面文字的联合翻译场景,高效处理包含外文的截图或视频帧,显著提升跨语言内容理解效率。

weixin_35750953的博客 952

translategemma-4b-it多场景:短视频字幕提取+画面文字识别+双语翻译

本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-4b-it镜像,实现多模态AI翻译应用。该平台简化了部署流程,用户可快速利用该模型进行短视频字幕提取、画面文字识别与双语翻译,轻松实现“所见即所译”,大幅提升跨语言信息处理效率。

weixin_42590539的博客 109

解放网络束缚:pot-app离线翻译全攻略,无网也能畅享AI智能

pot-app是一款跨平台的划词翻译和OCR软件,支持Windows、macOS和Linux系统。它提供了丰富的离线功能,让用户在没有网络连接的情况下也能享受高效的翻译和文字识别服务。无论是学习、工作还是旅行,pot-app都能成为您的得力助手,打破网络限制,随时随地提供准确的翻译支持。 ## 为什么选择pot-app离线翻译? 在当今信息时代,我们经常需要处理多语言内容,但网络连接并不总是稳

gitblog_00859的博客 800

零代码部署:用Ollama快速搭建TranslateGemma-4B翻译服务

本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-4b-it镜像,快速搭建多语言翻译服务。该轻量级模型支持55种语言互译及图片文字识别翻译,适用于跨境电商、多语言文档处理等场景,无需编程即可实现高效AI翻译。

weixin_42515842的博客 89
上一篇: 科大讯飞、小米、百度等互联网大厂往期算法工程师面试题大汇总,很牛!
下一篇: ChatOllama-本地大模型+RAG知识库
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值