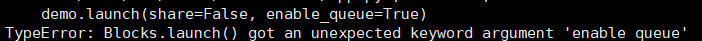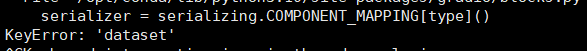记一次Video-LLaMa部署过程

VideoLLaMA2部署 && huggingface命令的使用 本文是关于VideoLLaMA2模型部署的文章 阅读详情
AI摘要

本文记录了Video-LLaMA项目的运行过程,包括所需配置、代码克隆、文件下载、包安装、模型文件获取及代码配置修改等。还分享了学习AI大模型的经验,提供了AGI大模型系统学习路线、视频教程、学习书籍和实战案例等资料,强调学习大模型的前景和价值。

图片

依旧是很久之前就star的一个项目,一直躺在GitHub的列表中,苦于显存不足的原因,今日终于借着别人的显卡运行起来,故记录一下。

先说配置GPU4090-2张,一张24G就够用,如果不够,可以走人了废话不多说,项目简介:

作者: Hang Zhang, Xin Li, Lidong Bing
论文地址: https://arxiv.org/abs/2306.02858
项目地址: https://github.com/DAMO-NLP-SG/Video-LLaMA

摘要

本文为视频LLaMA提供了一个多模式框架,使大型语言模型(LLMs)能够理解视频中的视觉和听觉内容。Video-LLaMA从冻结的预先训练的视觉和音频编码器以及冻结的LLMs中引导跨模态训练。与以前的作品补充LLMs仅处理视觉或音频信号不同,Video-LLaMA通过解决两个挑战来实现视频理解:(1)捕捉视觉场景中的时间变化,(2)整合视听信号。为了应对第一个挑战,提出了一种视频Q-former,将预先训练的图像编码器组装到的视频编码器中,并引入视频到文本生成任务来学习视频语言对应关系。对于第二个挑战,利用ImageBind(一种对齐多个模态的通用嵌入模型)作为预训练的音频编码器,并在ImageBind之上引入音频Q-former,以学习LLM模块的合理听觉查询嵌入。为了使视觉和音频编码器的输出与LLM’s的嵌入空间对齐,首先在大量视频/图像字幕对上训练Video-LLaMA,然后用适量但更高质量的视觉指令数据集调整我们的模型。发现,Video-LLaMA显示了感知和理解视频内容的能力,并基于视频中呈现的视觉和听觉信息产生有意义的反应。


开始

\1. 首先这里是官方提供的在线demo:https://huggingface.co/spaces/DAMO-NLP-SG/Video-LLaMA(我没有直接从huggingface克隆代码,我的环境不支持这样做图片)
\2. 直接从github克隆代码下来

git clone https://github.com/DAMO-NLP-SG/Video-LLaMA.git

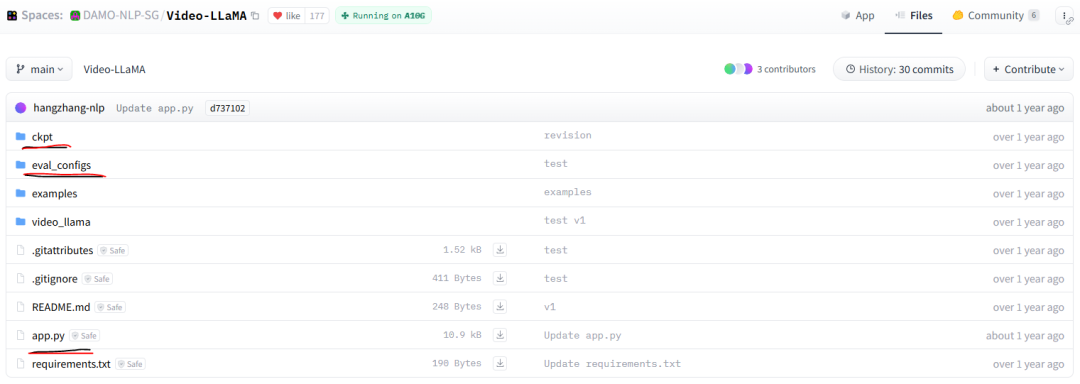
\3. 接着我从huggingface上的官方demo中copy三部分内容,将这三个文件下载下来放到项目目录中,这里是前期我为了保证可运行做的
图片

\4. 直接cd到项目中,运行代码,查看确实什么包,一一安装,如果嫌麻烦,可直接requirement.txt 安装所有

cd path/Video-LLaMA
pip install -i requirement.txt
python app.py

\5. 如果包都安装完成后这里就会提示缺少模型文件了,很多个模型文件,下面是之前下载的配置文件中的部分(video_llama_eval.yaml)

在这里插入图片描述

图片

① blip2_pretrained_flant5xxl.pth从步骤3中ckpt中下载,里面另一个模型finetune-vicuna7b-v2.pth本来对应着此处的 ckpt: xxx,但是下载下来使用,回答都是各种乱码,显然是模型版本不对的问题。

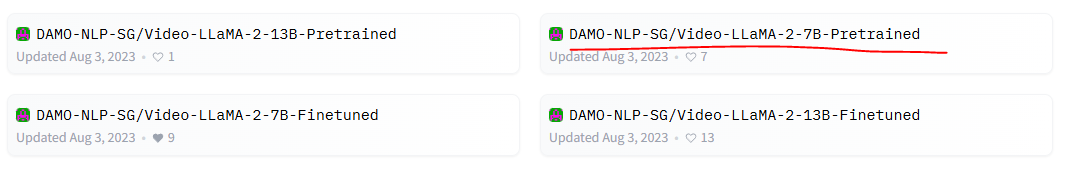
② llama-2-7b-chat-hf 和 VL_LLaMA_2_7B_Finetuned.pth 从DAMO-NLP-SG/Video-LLaMA-2-7B-Finetuned · Hugging Face 下载(这里有四个版本可以下载)
图片

③ VIT这个模型可以不用管,会在线下载的

\6. 到此别以为万事大吉了,还需要修改代码中的一些配置

vim video_llama/models/video_llama.py
搜索 bert-base-uncased,需要从HuggingFace上下载这部分模型,
并将路径替换成本地:/home/xxx/bert-base-uncased
搜索 imagebind_ckpt_path 将路径替换成本地ckpt的路径:imagebind_ckpt_path = './ckpt',

\7. 一些其它错误

  • pip install --upgrade gradio==3.37.0

图片

图片

  • 替换本地examples中的文件名即可

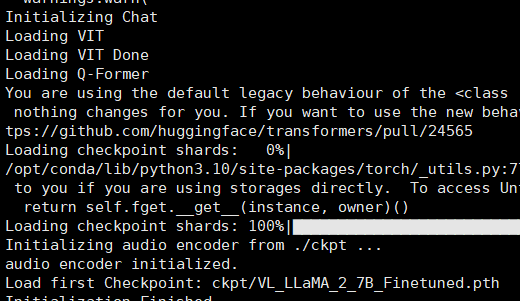
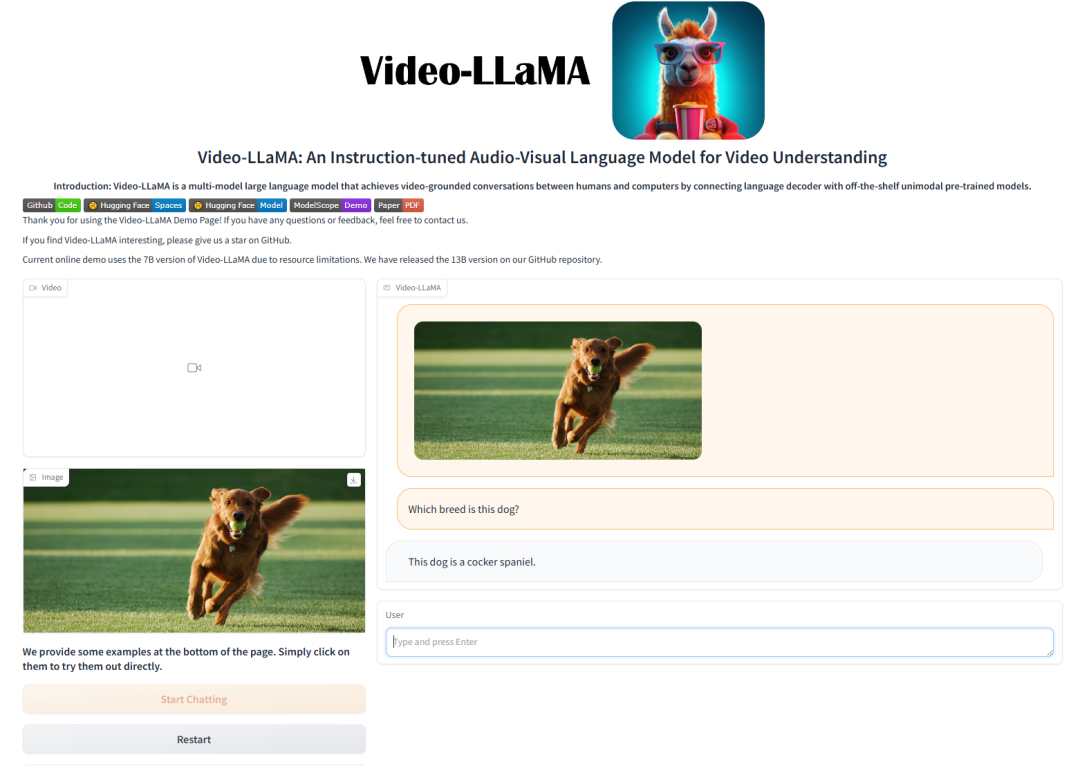
\8. 运行: python app.py,如果不出其它意外,且显存够的话应该出现以下日志,访问后显示,那么恭喜你成功99%,浏览器访问:127.0.0.1:3535 试着点击默认视频,看看运行是否正常,这样才100%成功,至于还有什么问题可以自行搜索和私信我图片
图片

图片

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Video-LLaMA本地部署实战:从零搭建多模态视频理解环境 本文详细介绍了Video-LLaMA多模态视频理解模型的本地部署实战指南,包括硬件配置建议、软件环境搭建、模型下载与配置等关键步骤。通过优化显存使用和解决常见问题,帮助开发者高效部署这一能同时分析视频画面和音频内容的AI模型,适用于智能监控、内容分析等多种场景。 阅读详情

相关推荐

多模态大模型时代:Video-LLaMA如何重新定义视频理解

本文深入探讨了Video-LLaMA在多模态大模型时代如何革新视频理解技术。通过解析其创新的视觉-语言对齐架构和音频-视觉-语言三角对齐机制,提供了从硬件配置到分步部署的实战指南,并展示了在智能视频剪辑、无障碍内容生成等场景的应用优势与性能优化技巧。

weixin_29322855的博客 447

Video-LLaMA 论文精读

基于大量文本数据训练的LLM模型,表现非凡,尽管它们取得了很大成功,但大多数用户只能通过文本去与LLM进行交互。为了最大化发掘其潜力,将视觉理解能力加入LLM成为趋势。BLIP-2,由于其从冷冻的图像encoder与文本decoder引导视觉语言预训练而备受关注。但是难以准确理解非平稳的视觉场景,缓解视频与文本之间的模态间隙比图像和文本更具挑战性。本文的工作力图攻克视频转文字,并非采用外部感知模型将视觉与听觉信号转换为文本信号。而是构建一个端到端模型,可以在一个框架内处理来自多个模态的数据。

DeerEyre的博客 2424

Video-LLaMA实战指南:轻量级视频对话模型的多模态对齐与低延迟部署

视频理解是多模态AI落地的关键瓶颈,其核心在于如何高效融合视觉、音频与文本信息,并在有限算力下实现语义对齐与实时响应。传统端到端方案受限于时序冗余、模态失衡和标注饥荒,而模块化设计通过解耦处理+门控交叉注意力+语义锚点对齐,显著提升鲁棒性与可部署性。Video-LLaMA正是这一思路的工程化范本,依托Qwen-VL视觉理解、Whisper-large-v3音频建模与结构化字幕协同,在单卡A100上达成2.3秒内端到端推理,支持影视类App快速集成智能问答能力。本文聚焦多模态对齐、轻量级微调两大热词,详解从动

weixin_33272631的博客 238

【论文精读】Video LLaMA:给语言大模型加上综合视听能力

文章为解决冻结的LLM与冻结的encoder之间的连接问题,基于Blip-2的风格,提出了一种多分支跨模态训练模型,并进一步提出了一个多模态大语言模型Video-LLaMA。该模型可以很好的完成连接任务,并且明确地捕捉了视频中的场景变化并对齐了音频与视频模态。但是该模型仍有一些缺点:(1)受到当前数据集的限制,模型的感知能力仍然较弱,需要构建更高质量的音频-视频-文本对齐数据集;(2)视频对于长视频的处理能力仍然有限;(3)Video-LLaMA继承了LLM的幻觉问题。

qq_45708407的博客 1150

Video-LLaMA实战:5分钟搞定视频问答系统(含避坑指南)

本文提供了Video-LLaMA视频问答系统的实战部署指南。通过详细的步骤,从环境搭建、模型加载、视频预处理到推理优化,帮助开发者快速构建并优化系统。文章重点分享了CUDA版本冲突、显存管理等常见问题的解决方案,并探讨了模型微调与生产部署策略,旨在提升视频理解与交互应用的开发效率。

weixin_29056865的博客 200

用Video-LLaMA打造智能视频客服:5步实现多模态对话系统

本文详细介绍了如何利用Video-LLaMA构建智能视频客服系统,通过5个关键步骤实现多模态对话功能。Video-LLaMA作为领先的多模态框架,能深度整合视觉、音频和文本数据,显著提升客服场景的交互体验和效率。文章涵盖技术选型、系统部署、数据准备、特征对齐及实战应用,为开发者提供全面的实施指南。

weixin_30316097的博客 446

部署Video-LLama遇到的坑

环境为Linux、conda、Python 3.10。下载video-llama模型时,由于直接访问huggingface可能受限,推荐使用modelscope等镜像网站。注意下载的文件可能存在损坏,需仔细验证。由于video-llama快速迭代,直接安装最新依赖可能导致兼容性问题,建议指定依赖版本号。Python版本推荐使用3.9或3.10,避免使用3.11。模型默认下载路径为/root/.cache/modelscope/modelscope_modules,不建议移动以避免路径问题。希望这些建议能帮

qq_40437384的博客 1829

Video-LLaMA

由于这个模型里的视频帧是均匀抽取8个帧,如果只有一秒的视频,那么很容易抽到的8张图都是一样的,那么描述就会像在说车轱辘话一样,来回重复并颠倒。因此,为了符合这个模型的特点,建议先用长一点的视频,再经过快进处理。6. 图像encoder 用的是 Blip-2 中专门做图像语义理解的部分,这个部分的结构:EVA CLIP + Q-former。整个模型,蓝色的blocks都是可以被拿来直接用的,橙色部分是一定要经过训练,以促成Llama video 模型正常联通使用的。整个代码里的部件权重加载在。

EmoC的博客 841

Video-LLaMA部署实战:从零到一的避坑指南

本文详细介绍了Video-LLaMA的部署实战经验,从环境准备、模型配置到常见问题解决,提供了全面的避坑指南。涵盖硬件需求、软件环境搭建、模型文件获取与配置,以及性能优化和安全加固措施,帮助开发者高效部署这一多模态大模型。

alice7model的博客 675

Video-LLaMA论文解读和项目部署教程

Video-LLaMA基于BLIP-2和MiniGPT-4构建,主要由两个核心组件构成:(1) 视觉-语言(VL)分支和(2) 音频-语言(AL)分支。VL分支(视觉编码器:ViT-G/14 + BLIP-2 Q-Former)引入两层视频Q-Former及帧嵌入层,计算视频表示。在Webvid-2M视频字幕数据集上训练VL分支,以执行视频到文本生成任务。同时,添加来自LLaVA的约59.5万个图像标题对到预训练数据中,以增强静态视觉概念的理解。预训练后,我们使用来自MiniGPT-4。

1419

淘宝/天猫商家必看:不懂技术也能搞懂的奇门对接原理与ERP/WMS联调避坑指南

本文为淘宝/天猫商家详细解析阿里奇门对接原理与ERP/WMS联调避坑指南,帮助不懂技术的商家轻松管理数据对接流程。通过标准化接口和安全传输,奇门解决了代运营店铺数据获取难题,提升发货效率。文章还提供了联调阶段的实用技巧和常见问题解决方案,助力商家高效完成系统对接。

weixin_42519781的博客 585

Video llama3 2b 本地部署(windows11 + 8Gnvidia 4060)

videollama3 2b 模型的windows本地部署,主要记录一下自己部署走过的坑,绕的弯路,以避免更多问题的发生

Steady_____的博客 1391

Ubuntu20.04下Intel AX201网卡驱动安装全攻略:从内核升级到固件更新

本文详细介绍了在Ubuntu 20.04系统上解决Intel AX201无线网卡驱动问题的完整方案。针对戴尔游匣G15等新硬件,通过升级内核至HWE版本、从官方仓库获取最新固件文件,并调整BIOS设置,彻底解决Wi-Fi无法识别或连接不稳定的问题,为开发者提供了一套从诊断到修复的实践指南。

gpt4scribbler的博客 689

LLama2 CPU Windows 部署-小白踩坑合集

LLAMA2一键可运行整合包:Windows10+消费级显卡可用(Meta大语言模型),无需显卡,在本地体验llama2系列模型,支持7B、13B、70B,Llama2 技术详解,五分钟快速一键启动Llama2,不用搞环境,"妙鸭相机"开源版facechain本地部署详细教程(windows系统),从0构建llama2+localGPT的本地模型,5 分钟部署免费私有化的 Llama2中文版(可商用),人大发布微调版Llama2-13b模型。这使得可以在各种硬件上本地运行LLaMa,包括。

m0_55756688的博客 5337

【Unity3D优化】优化内置shader的内存占用

在打AB包的过程中,并不会把这些Built-in的shader单独打包,并与材质球和预设体做好依赖,因此打AB包时,Unity会自行在材质球和预制体的AB包内每一个都包含进去用到的Built-in的Shader,而且运行时,由于加载的是不同的AB包,shader也是不同的实例,占用的也是多份内存。结合项目特点可以分析,由于项目里使用了大量的粒子特效,一些特殊的效果,会给特效师写定制的shader,但是这些常见的效果,特效师直接使用了Unity Built-in的shader。继续优化内存占用。

a310989583的专栏 2311

避开STM32H7的‘保护陷阱’:从Option Byte机制深度解析读写保护原理与预防

本文深度解析STM32H723VGT6的Option Byte保护机制,详细讲解RDP读保护和WRP写保护的工作原理及配置方法,并提供硬件设计防御策略和软件预防性编程技巧,帮助开发者避免误触发保护机制导致芯片锁定的问题。

weixin_33686714的博客 441

Video-LLaMA实战教程:一步步教你搭建本地视频对话系统

Video-LLaMA是一款基于指令调优的音视频语言模型,能够实现强大的视频理解功能。本教程将带你从零开始,在本地环境搭建一个完整的视频对话系统,让你轻松体验AI与视频交互的魅力。 ## 为什么选择Video-LLaMA? 在当今AI技术快速发展的时代,视频理解作为计算机视觉领域的重要分支,正逐渐成为人机交互的新热点。Video-LLaMA作为EMNLP 2023的演示项目,凭借其独特的音视频

gitblog_00156的博客 440

故障处理:Oracle一体机磁盘故障时磁盘组重平衡失败的故障处理

摘要: Oracle Exadata一体机出现磁盘故障案例,存储节点故障灯未亮但磁盘已产生大量坏块,导致重平衡失败。文章强调了一体机硬件巡检需检查6个关键维度:节点messages日志、存储cell告警日志、CellCLI日志、ASM告警日志、ILOM日志及服务器信号灯。故障分析显示硬盘物理故障导致磁盘组冗余受损,自动修复流程受阻。文中详细记录了通过CellCLI工具排查损坏磁盘的过程,并提供了完整的故障处理流程和命令输出。文章同步发布于微信公众号"IT民工的龙马人生"和博客网站(www

提供数据库技术支持(系统优化,故障处理,安装升级,数据恢复等) 1230

PyTorch 2.8镜像部署案例:科研团队复现Video-LLaMA2模型训练全过程记录

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.8 深度学习镜像 | RTX4090D 24G CUDA12.4 通用优化版,助力科研团队高效复现Video-LLaMA2模型的训练过程。该镜像预装了CUDA 12.4、xFormers等优化组件,特别适用于视频理解与多模态大模型训练场景,显著提升训练效率与稳定性。

weixin_35879493的博客 353

Modbus协议介绍及解析

Modbus协议介绍及解析 1.Modbus简介 Modbus是一种广泛应用于工业控制领域串行通信协议,以其开放性、高可靠性、高效简单性、免费等优点,成为了工业领域通信协议的业界标准,是工业现场电子设备之间常用的连接方式。Modbus按其格式可分为Modbus-RTU,Modbus-ASCII,Modbus-TCP,其中前两者适用于串行通信控制网络中,例如RS485,RS232等,而Modbus-TCP主要应用于基于以太网TCP/IP通信的控制网络中。通过此协议,控制器相互之间、或控制器和其它设备之间进行通

逍遥子的博客 1万+

ThingsBoard 场景联动需求

当初有个兄弟请我帮他实现一个需求,需求如上,很简单,实现完成后我怕他操作不来,又写了这份文档给他,今天把这个文档的场景发出来,大家也可以学习一下思路我把需要模拟设备的指令都总结在下面,连接参数截图讲解如下:温度传感器风扇光照传感器灯。

AldrichEugene 1232

Video-LLaMA:为AI大模型注入视听觉

其次,Video-LLaMA可以用于视频分类和识别,例如自动识别视频中的物体、场景或行为,为安防监控、智能驾驶等领域提供支持。首先,数据质量和数量是影响模型性能的关键因素,尤其是在中文语境下,高质量的多媒体数据集相对较少。其次,模型的可解释性和鲁棒性也是需要关注的问题。Video-LLaMA的核心原理是将视频中的视觉信息和文本信息进行融合,通过训练让模型学会从视频中提取关键信息并生成相应的文本描述。这一过程需要大量的数据和计算资源,但随着技术的进步,我们已经可以实现高效的训练和部署。

weixin_41888295的博客 645

OpenClaw实战系列04:Jira/Confluence深度集成实战指南

汇总 Confluence 空间 TEAM 下所有关于“性能优化”的文档,输出要点自然语言创建和查询 Jira 任务,无需离开聊天工具基于 Confluence 的私有知识库问答,让 AI 真正理解团队文档Jira 与 Confluence 联动,打通项目管理与知识管理定时同步与通知,自动化团队信息流转至此,你的 OpenClaw AI 助理已经不仅是一个聊天机器人,而是真正融入团队工作流的“智能项目管理助手”。下一期我们将带来OpenClaw 自定义技能开发实战。

PeterPan的博客 572

Video-LLaMA vs 传统视频分析:为什么多模态大语言模型是未来趋势

Video-LLaMA作为一款基于指令调优的音视频语言模型,正在彻底改变传统视频分析的范式。这款由EMNLP 2023展示的创新模型通过融合视觉、听觉和语言理解能力,为视频内容分析带来了前所未有的智能水平。相比传统视频分析技术,Video-LLaMA不仅能识别画面中的物体,还能理解场景 context、分析动态事件,并以自然语言进行精准描述,开启了视频理解的新纪元。 ## 📊 传统视频分析的局

gitblog_00439的博客 896

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Chord开源模型性能对比:Chord vs Video-LLaMA在本地小样本视频任务表现

本文介绍了如何在星图GPU平台上一键自动化部署Chord视频时空理解工具镜像,实现高效的本地视频分析。该工具特别适用于隐私敏感场景,能自动执行视频内容详细描述和时空定位任务,如精确识别视频中的人物动作与物体位置,大幅提升小样本视频理解效率。

weixin_42610010的博客 314

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

深度解析Video-Analyzer:功能强大的AI视频分析工具技术详解

本文介绍了开源AI视频分析工具Video-Analyzer,它结合Llama 11B视觉模型和OpenAI Whisper模型,支持本地运行和OpenRouter服务。主要功能包括关键帧提取、音频转录、自然语言描述生成等。技术原理涵盖帧提取、音频处理、帧分析和视频重建。应用场景包括内容审核、视频管理、教育培训、安全监控和媒体娱乐。部署指南提供了安装要求、步骤和配置说明,支持Windows、macOS和Linux系统。该项目为高效处理视频数据提供了隐私安全的解决方案。

2401_85154887的博客 3736

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: 3个ChatGPT插件自动写书爆火,更多躺着赚钱玩法可以问AI自己!
下一篇: AI大模型会对我们的生活带来什么改变?普通人终于有机会感觉到大模型的用处了
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值