RAG 涨点小技巧——RAG上下文召回

改进召回(Retrieval)和引入重排(Reranking)提升RAG架构下的LLM应用效果 RAG架构来自于实际问题,而很多问题都是相似的,在效果优化层面,我们可以借鉴一些推荐系统等传统AI系统的优化经验,将其迁移过来,这对于改进RAG效果有很大的帮助,在后面的文章里,还将继续介绍具体场景的一些使用问题,欢迎关注。 阅读详情

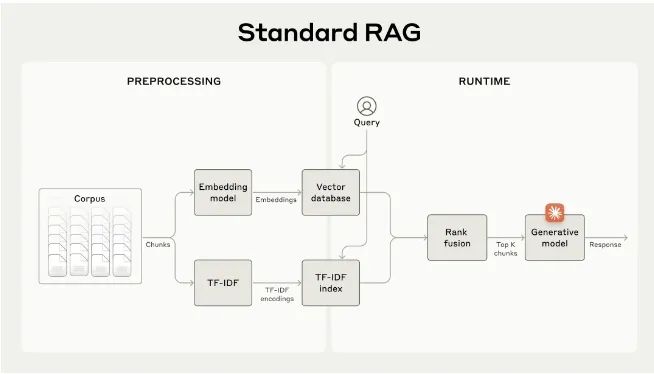
昨天Claude团队发了一个关于RAG的博客,介绍了上下文召回的思路,可以看看。先看看标准的RAG(检索增强生成)是怎么做的?

  • 将用于检索的知识库(文档)拆为小(几百个token)的文本块
  • 对文本块进行 TF-IDF 编码以及语义嵌入
  • 使用 BM25 检索最相似的文本块
  • 使用文本嵌入检索语义相似的文本块
  • 合并、去重、排序两种方式检索得到的文本块
  • 将 top k 个文本块放进提示词中辅助 LLM 生成回答

img

因为需要对文本进行切块,所以经常遇到上下文被不合理分割的情况

举个例子,如果LLM的知识库里有一堆财务信息(比如美国SEC的文件),然后问题是:“ACME公司2023年第二季度的收入增长了多少?”这时候可能会有一个相关的信息是:“这家公司的收入比上个季度涨了3%。”但是呢,这句话没说是哪家公司,也没提具体的时间,这就让模型很难找到准确的信息,也很难有效地利用这个信息。

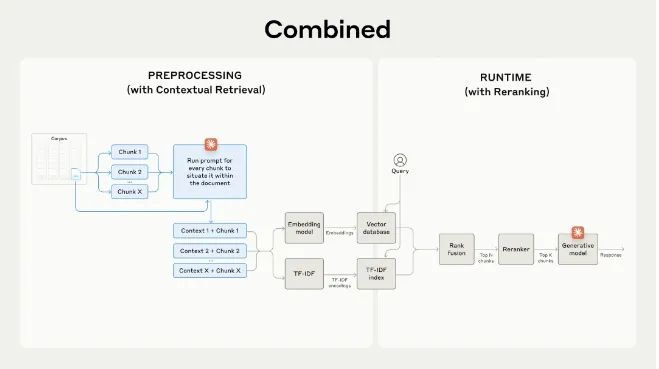
上下文召回通过在每个文本块前添加特定于该文本块的解释性上下文来解决这个问题。

下面是一个示例展示了原始文本块和包含上下文的文本块的区别

original_chunk = "The company's revenue grew by 3% over the previous quarter."

contextualized_chunk = "This chunk is from an SEC filing on ACME corp's performance in Q2 2023; the previous quarter's revenue was $314 million. The company's revenue grew by 3% over the previous quarter."

具体怎么做呢?

作者写了一个提示词,指导模型提供简洁的、特定于文本块的上下文,使用整体文档的上下文来解释该文本块:

<document>
{{WHOLE_DOCUMENT}} 
</document>
Here is the chunk we want to situate within the whole document 
<chunk>
{{CHUNK_CONTENT}} 
</chunk> 
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else. 

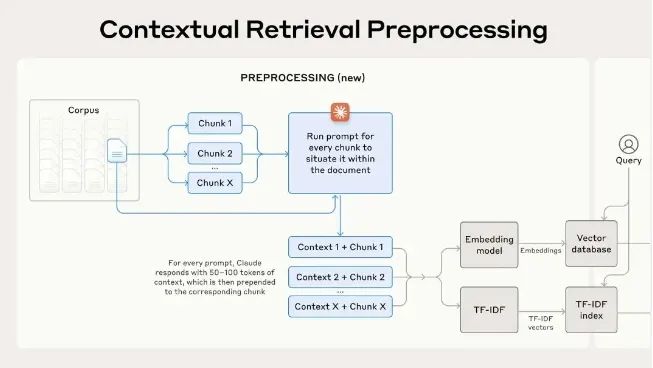
生成的上下文信息通常在50-100个tokens,会被拼接到原始文本块之前。

下面是完整的流程图
img

性能提升有多少?

我们的实验表明:

  • 上下文嵌入将前20个块的检索失败率降低了35%(从5.7%降至3.7%)。
  • 结合上下文嵌入和上下文BM25将前20个块的检索失败率降低了49%(从5.7%降至2.9%)。

一些实验过程可以关注的细节:

  • 文本块边界:考虑如何将文档分割成块。块大小、块边界和块重叠的选择会影响检索性能。
  • 嵌入模型:不同的模型使用上下文嵌入的提升可能不一样,在作者的实验中Gemini和Voyage嵌入特别有效。
  • 自定义上下文提示:虽然提供的通用提示词效果良好,但可能能够通过针对特定领域或用例定制的提示获得更好的结果(例如,包括知识库中仅在其他文档中定义的关键术语词汇表)。
  • 块数量:将更多块添加到上下文窗口会增加包含相关信息的机会。然而,更多的信息可能会分散模型的注意力,因此存在一定的限制。尝试了传递5、10和20个块,发现使用20个块在这些选项中表现最佳,但在您的用例中进行实验是值得的。

结合重排性能更佳!

重排是一种常用的过滤技术,以确保只有最相关的片段被传递给模型。

  • 执行初始检索以获取最有可能相关的片段(我们使用了前150个);
  • 将前N个片段与用户的查询一起传递给重排模型;
  • 使用重排模型,根据每个片段与提示的相关性和重要性为其打分,然后选择前K个片段(我们使用了前20个);
  • 将前K个片段作为上下文传递给模型以生成最终结果。

img

结合重排后 top-20 的召回失败率减少了67% (5.7% → 1.9%)

在这里插入图片描述

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

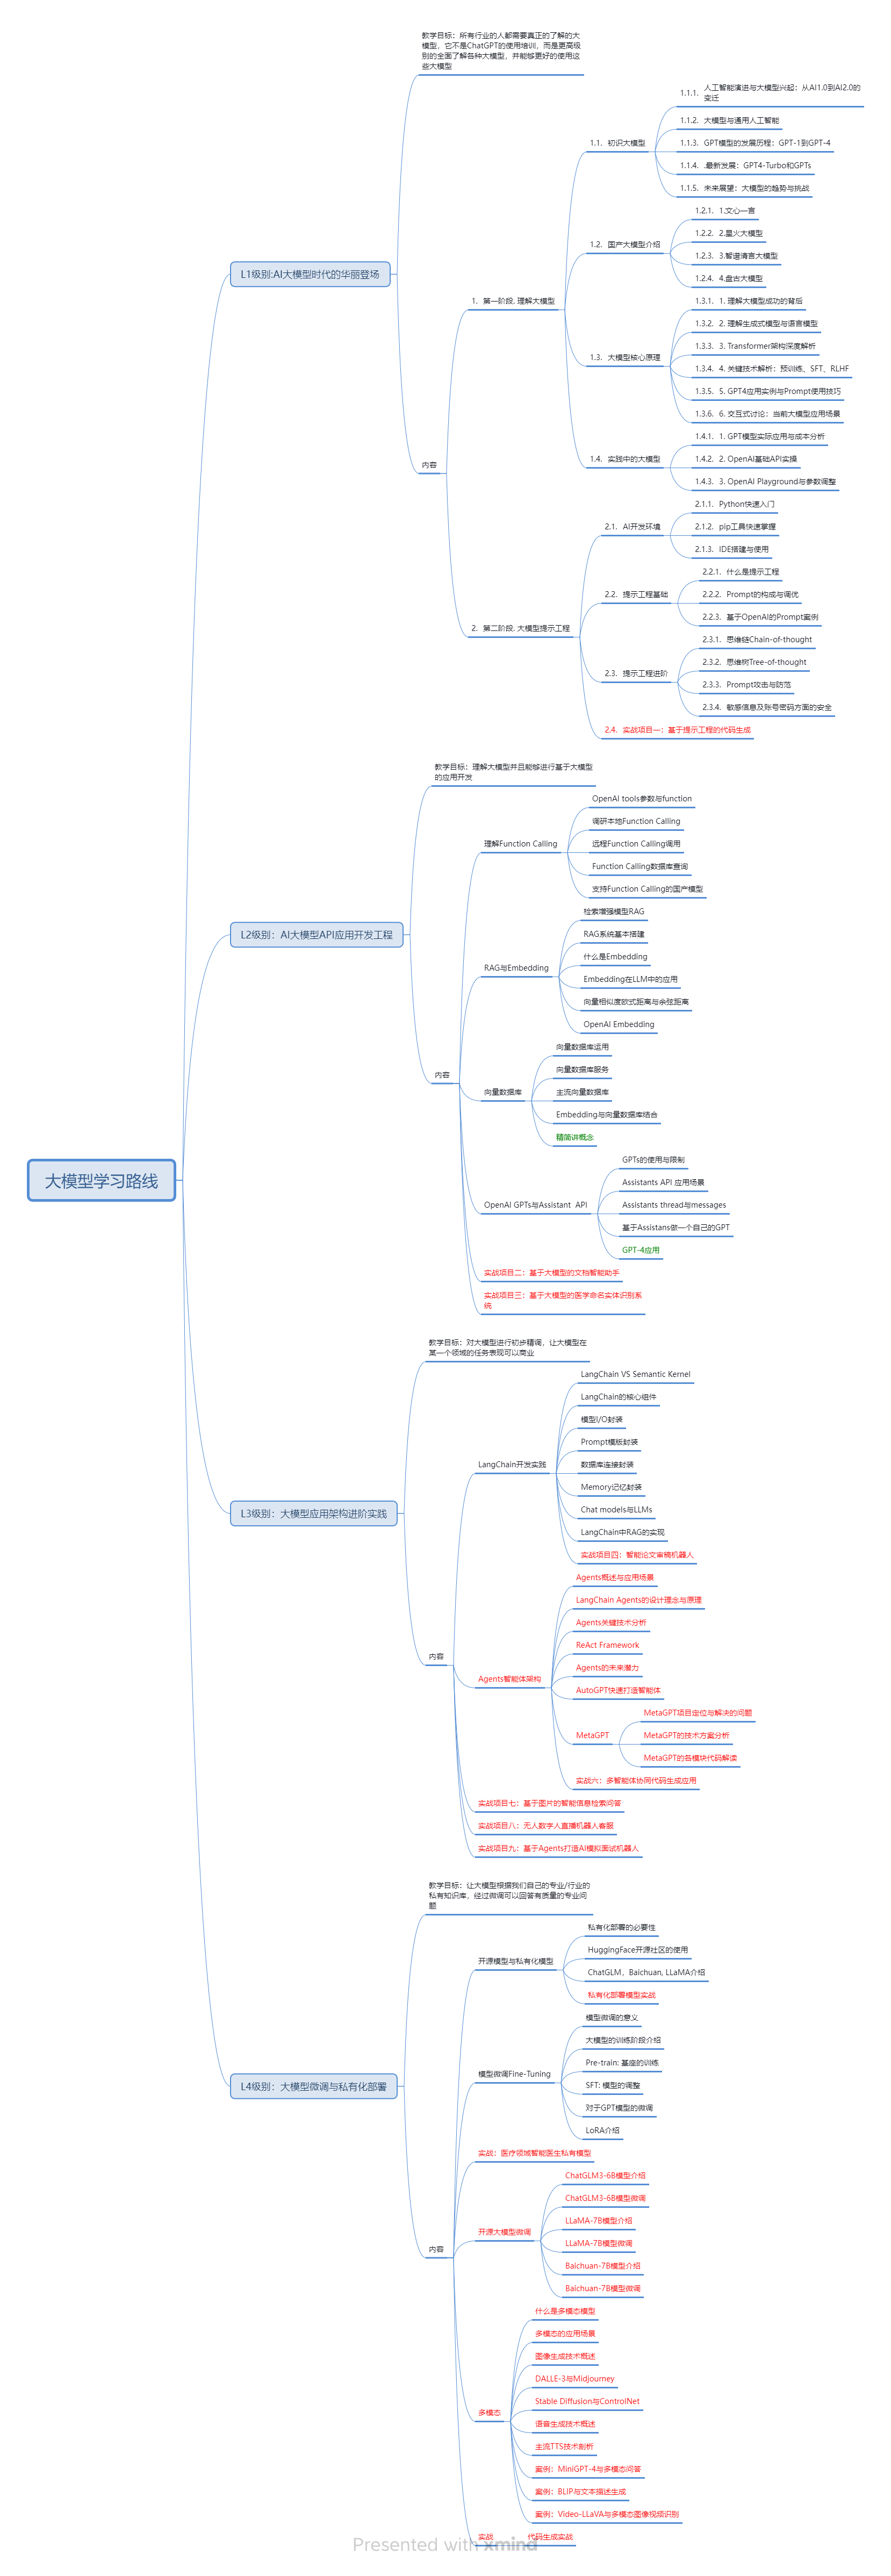
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

给汽车芯片做‘体检’:手把手教你用IEC62380和SN29500估算功能安全失效率 本文详细介绍了如何使用IEC62380和SN29500标准估算汽车芯片的功能安全失效率,涵盖基础认知、方法论对比及实战计算。通过具体案例演示两种标准的应用流程,帮助工程师准确评估半导体器件的可靠性,确保符合ISO 26262标准要求。 阅读详情

相关推荐

ComfyUI新手必看:JoyCaption 2插件安装全流程(附百度网盘资源)

本文为ComfyUI新手提供了JoyCaption 2插件的完整安装与部署指南。详细介绍了从环境准备、插件获取、模型文件配置到核心节点使用的全流程,并重点解析了其集成的LLM反推模式,帮助用户高效实现从图片到精准提示词的转换。

mango的博客 307

RAG实战篇:检索召回结果不准确?试试这三种实用方法

在这篇文章中,围绕检索召回(Retrieval),风叔详细介绍如何优化RAG系统的召回结果,提升LLM大模型的回答准确度。在检索召回的时候,用户的问题会被输入到嵌入模型中进行向量化处理,然后系统会在向量数据库中,搜索与该问题向量语义上相似的知识文本或历史对话记录并返回。在Naive Rag中,系统会将所有检索到的块直接输入到 LLM生成回答,导致出现中间内容丢失、噪声占比过高、上下文长度限制等问题。

2401_85375186的博客 3235

PPL文档——Excel制作的甘特图加上动态今日线

当很多项目需要跟踪进度时,我们介绍一种在Excel中创建甘特图。

qq_34777858的博客 7069

RAG高效召回方法

RAG过程有两个阶段,一是,二是:快速进行检索,数据库中1000万chunk, 快速召回1000个相关的chunk,不用很精确;:精确的工作由重排实现,比如重排取 Top5的内容;RAG的难点主要有两个,一个是前期的文档处理;二是数据的召回;由于大模型本身无法分辨输入到模型中的文档质量,因此关于数据的召回只能进行人为的控制,而人为控制的方法只能通过技术手段来进行约束,下面是常用的策略。

m0_49159526的博客 1552

XGBoost特征重要性为0的问题:深度解析与应对策略

在机器学习领域,XGBoost(Extreme Gradient Boosting)作为一款高效且强大的集成学习算法,已经被广泛应用于各类预测任务中。然而,在实际应用过程中,许多数据科学家和工程师们遇到了一个令人困惑的现象——某些特征的重要性值为0。这不仅影响了模型的解释性,还可能导致特征选择过程中的误判。本文将深入探讨这一问题,分析其背后的原因,并提供相应的解决方案。在深入探讨特征重要性为0的问题之前,我们首先需要了解XGBoost是如何计算特征重要性的。XGBoost提供了三种常见的特征重要性计算方法:

cda2024的博客 1706

抖音无人直播技术全解析:从原理、实操到合规化思考

直播技术作为内容分发的核心形式,其底层依赖于流媒体协议(如RTMP)与实时音视频编码推流。通过OBS等软件进行场景合成与虚拟摄像头技术,可以实现丰富的画面包装与自动化播放。这项技术的核心价值在于突破人力与时间的限制,实现内容的持续输出与流量获取,在电商带货、品牌展示、陪伴式内容等场景中具有应用潜力。然而,单纯依赖录播循环存在高风险,平台风控系统会通过内容重复性检测与互动行为模型进行识别。因此,更可持续的方向是探索“半无人直播”或自动化辅助工具,例如利用AI数字人驱动或直播切片技术,在合规前提下提升运营效率。

weixin_29895109的博客 511

【RAG检索】RAG技术揭秘:检索≠召回?

召回是RAG系统的核心环节,其本质是通过向量化、关键词匹配等技术,从海量知识库中筛选与用户问题相关的信息片段,为后续生成阶段提供精准上下文支持。与评估指标“召回率(Recall)”不同,Retrieval是动态的筛选过程,需平衡查全率与精确率。实现方法包括关键词匹配(快速但语义局限)和语义搜索(理解意图但需算力),优化策略建议采用混合搜索、动态分块及多模态处理。评估召回效果需关注命中率、排序质量及事实覆盖度,而实际应用面临长文本处理、实时更新、多跳推理等挑战。

Arbboter的专栏 4401

用Python+NumPy手把手实现分数阶傅里叶变换(FRFT),搞定线性调频信号分析

本文详细介绍了如何使用Python和NumPy实现分数阶傅里叶变换(FRFT),特别针对线性调频信号(Chirp信号)分析。通过从零开始的代码实现和可视化案例,展示了FRFT在时变信号处理中的强大能力,帮助工程师和研究人员高效分析频率随时间变化的信号。

weixin_29062823的博客 219

AI 入门系列——RAG高效召回方法:从基础到前沿的工业级实践与创新

在RAG(检索增强生成)系统中,高效召回是连接用户查询与知识库的核心环节,直接决定了生成内容的准确性与可靠性。随着RAG技术的演进,高效召回方法已从早期的“向量检索+Top-K”简单流程,发展为融合多模态、多策略、自优化的复杂体系。本文将结合2025年最新研究与工业实践,系统梳理RAG高效召回的核心方法、技术逻辑与落地技巧。RAG高效召回的核心逻辑是从用户意图到知识库语言的精准映射,通过混合检索(基础)、查询转换(桥梁)、知识图谱融合(跨越)、重排序与压缩(优化)、自优化(前沿)

沛哥儿的专栏 1512

新手必看!Unity中Tag和Layer的7个实际应用场景(含MOBA案例)

本文深入探讨Unity中Tag和Layer的7个实际应用场景,特别以MOBA游戏开发为例,详细解析如何利用LayerMask进行高效场景管理和碰撞检测优化。从双相机方案到射线检测的精准控制,帮助开发者掌握这些基础功能的进阶用法,提升游戏性能和开发效率。

weixin_28723171的博客 313

五步教你用GPT-5画出国自然技术路线图!轻松节省80%画图时间(附AI提示词)

七哥给大家推荐的高校都在用的AI平台——高级学术版专业应用平台,集成了ChatGPT、Claude、Gemini、Grok等Al大模型的PLUS版本平台,包括 ChatGPT-5、4o、o3、4.1、4.5、Gemini 2.5 Pro、Claude 3.7、Claude 4、DeepSeek 满血版、Grok 3 、Grok 4等原生线路,还有国际主流的GPTs学术应用,可以辅助大家高效完成科研和学术写作任务,当然撰写硕博论文,课题、职称论文、国社科、国自然基金本子也是手拿把掐。

智能AI让学术科研更容易 1503

大模型开发 | RAG 涨点小技巧:RAG上下文召回

虽然提供的通用提示词效果良好,但可能能够通过针对特定领域或用例定制的提示获得更好的结果(例如,包括知识库中仅在其他文档中定义的关键术语词汇表)。

老皮的博客 1471

在 SAP 中实现“租赁资产”管理,核心是把 IFRS16/ASC842 等新租赁准则的要求落地到系统

摘要:本文详细介绍了在SAP S/4HANA系统中实现IFRS16/ASC842租赁准则的具体操作流程。主要内容包括:1) 系统前置配置,如激活租赁会计组件、定义租赁类型和会计科目;2) 租赁合同创建与主数据维护;3) 初始确认的会计处理;4) 日常折旧计提和租金支付流程;5) 合同变更与终止管理。通过RE-FX-LM模块与固定资产模块的集成,系统可自动生成使用权资产和租赁负债,支持从合同创建到报表披露的全生命周期管理,确保符合新租赁准则要求。

金牌架构师 988

通过改进Embedding模型,将你的RAG上下文召回率提高95%

检索增强生成(RAG)是一种将LLM(大型语言模型)集成到商业用例中的突出技术,它允许将专有知识注入LLM中。本文假设您已经了解RAG的相关知识,并希望提高您的RAG准确率。让我们简要回顾一下这个过程。RAG模型包括两个主要步骤:检索和生成。在检索步骤中,涉及多个子步骤,包括将上下文文本转换为向量、索引上下文向量、检索用户查询的上下文向量以及重新排序上下文向量。一旦检索到查询的上下文,我们就进入生成阶段。在生成阶段,上下文与提示结合,然后发送给LLM以生成响应。

python123456_的博客 1232

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【RAG召回优化】rag召回阶段方法探讨

rag召回阶段优化方法,最新论文汇总解读

weixin_37763484的博客 1930

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

RAG知识库的召回率

召回率是RAG系统的核心指标,直接影响生成答案的完整性与可靠性。通过人工标注、自动化框架(如RAGAS)统计,并结合算法优化与参数调优,可针对性提升召回率。实际应用中需根据业务需求平衡召回率与准确率,并持续迭代检索模块以适配不同场景。

神棍之路 3841

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

# 通过改进Embedding模型,将你的RAG上下文召回率提高95%

检索增强生成(RAG)是一种将LLM(大型语言模型)集成到商业用例中的突出技术,它允许将专有知识注入LLM中。本文假设您已经了解RAG的相关知识,并希望提高您的RAG准确率。让我们简要回顾一下这个过程。RAG模型包括两个主要步骤:检索和生成。在检索步骤中,涉及多个子步骤,包括将上下文文本转换为向量、索引上下文向量、检索用户查询的上下文向量以及重新排序上下文向量。一旦检索到查询的上下文,我们就进入生成阶段。在生成阶段,上下文与提示结合,然后发送给LLM以生成响应。

zhishi0000的博客 1108

RAG的召回方式

密集向量召回、稀疏向量召回(BM25)、元数据过滤召回。混合召回(尤其是密集+稀疏)是目前效果最佳的主流方案。一般推荐设置2-3路召回。最经典实用的组合是1 路密集向量召回 + 1 路稀疏向量召回(BM25),并可选择性地加入元数据过滤作为第三路或融入前两路。最终选择哪种组合和设置几路,需要根据具体的应用场景、数据特点、性能需求和资源限制进行实验评估和调优(如通过 Recall@K, MRR@K 等指标评估)。没有放之四海而皆准的最优解,实践中的 AB 测试和迭代优化至关重要。

sun_nainai的博客 2032

通过适配嵌入模型提高您的 RAG 上下文召回率 95%。

原文:towardsdatascience.com/improve-your-rag-context-recall-by-40-with-an-adapted-embedding-model-5d4a8f583f32检索增强生成(RAG)是将 LLM 集成到业务用例中的一种突出技术,允许将专有知识注入到 LLM 中。本文假设您已经了解 RAG,您来这里是为了提高您的 RAG 准确性。让我们简要回顾一下这个过程。RAG 模型由两个主要步骤组成:检索和生成。

龙哥盟 987

一文搞懂RAG的召回策略到底是什么?——企业级应用中怎么提升RAG的检索准确度

一文搞懂RAG的召回策略到底是什么?——企业级应用中怎么提升RAG的检索准确度

大模型研究中心 1318

深入剖析 RAG 检索系统中的召回方式:BM25、向量召回、混合策略全解析

RAG(检索增强生成)系统通过结合信息检索与文本生成技术提升大模型回答的准确性。其中,召回作为第一步,直接影响系统性能。本文系统介绍了三种核心召回方式:基于关键词匹配的BM25稀疏召回、利用语义向量的BCE稠密召回,以及融合两者的混合召回。

weixin_48389642的博客 3964

【AI大模型】关于RAG应用中怎么高质量的进行数据召回——召回策略的研究

“ 数据召回是RAG技术的重要领域,而不同的召回策略甚至会产生完全不同的效果。” RAG技术的核心原理很简单,本质上就是在外部维护一个资料库,在进行大模型问答之前,先从资料库中找到相关的内容,然后一起输入到大模型中。 但由于文档的复杂性,在进行文档处理时很难真正做到高质量的数据处理;因此,在做数据召回时就会面临着各种各样的问题。 所以,怎么进行高质量的数据召回,就成为RAG必须要研究的一个课题;而今天,我们就来简单介绍一下常见的几种召回策略。

2401_85327249的博客 1382

关于RAG应用中怎么高质量的进行数据召回——召回策略的研究

RAG技术的核心原理很简单,本质上就是在外部维护一个资料库,在进行大模型问答之前,先从资料库中找到相关的内容,然后一起输入到大模型中。但由于文档的复杂性,在进行文档处理时很难真正做到高质量的数据处理;因此,在做数据召回时就会面临着各种各样的问题。所以,怎么进行高质量的数据召回,就成为RAG必须要研究的一个课题;而今天,我们就来简单介绍一下常见的几种召回策略。召回策略RAG的难点主要有两个,一个是前期的文档处理;其次就是数据的召回;

m0_59164304的博客 1383
上一篇: AI赋能外呼系统,智能化流程如何帮助企业降本增效?
下一篇: 从入门到精通Transformer,掌握NLP技术这本书必看《从零开始构建最先进的NLP模型》
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值