


通过改进嵌入模型,将你的RAG上下文召回率提高95%
检索增强生成(RAG)是一种将LLM(大型语言模型)集成到商业用例中的突出技术,它允许将专有知识注入LLM中。本文假设您已经了解RAG的相关知识,并希望提高您的RAG准确率。
让我们简要回顾一下这个过程。RAG模型包括两个主要步骤:检索和生成。在检索步骤中,涉及多个子步骤,包括将上下文文本转换为向量、索引上下文向量、检索用户查询的上下文向量以及重新排序上下文向量。一旦检索到查询的上下文,我们就进入生成阶段。在生成阶段,上下文与提示结合,然后发送给LLM以生成响应。在发送给LLM之前,可能需要进行缓存和路由步骤以优化效率。
对于每个管道步骤,我们将进行多次实验,以共同提高RAG的准确率。您可以参考以下图片,其中列出了在每个步骤中进行的实验(但不限于)。

开发者面临的一个主要问题是,在生产环境中部署应用程序时,准确性会有很大的下降。
“RAG在POC(原型)中表现最佳,在生产中最差。”这种挫败感在构建GenAI(通用人工智能)应用程序的开发者中很常见。
生成阶段已经通过一些提示工程得到了解决,但主要挑战是检索与用户查询相关且完整的上下文。这通过一个称为上下文召回率的指标来衡量,它考虑了为给定查询检索的相关上下文数量。检索阶段的实验目标是提高上下文召回率。
嵌入模型适配
在检索阶段进行的实验中,通过适配嵌入模型,可以显著地将您的上下文召回率提高+95%。
在适配嵌入模型之前,让我们了解其背后的概念。这个想法始于词向量,我们将训练模型理解单词的周围上下文(了解更多关于CBOW和Skipgram的信息)。在词向量之后,嵌入模型是专门设计来捕捉文本之间关系的神经网络。它们超越了单词级别的理解,以掌握句子级别的语义。嵌入模型使用掩码语言模型目标进行训练,其中输入文本的一定比例将被屏蔽以训练嵌入模型,以预测屏蔽的单词。这种方法使模型能够在使用数十亿个标记进行训练时理解更深层的语言结构和细微差别,结果生成的嵌入模型能够产生具有上下文感知的表示。这些训练好的嵌入模型旨在为相似的句子产生相似的向量,然后可以使用距离度量(如余弦相似度)来测量,基于此检索上下文将被优先考虑。
现在我们知道了这些模型是用来做什么的。它们将为以下句子生成相似的嵌入:
句子1:玫瑰是红色的
句子2:紫罗兰是蓝色的
它们非常相似因为这两句都在谈论颜色。
对于RAG,查询和上下文之间的相似度分数应该更高,这样就能检索到相关的上下文。让我们看看以下查询和来自PubmedQA数据集的上下文。
查询:肿瘤浸润性免疫细胞特征及其在术前新辅助化疗后的变化能否预测乳腺癌的反应和预后?
上下文:肿瘤微环境免疫与乳腺癌预后相关。高淋巴细胞浸润与对新辅助化疗的反应相关,但免疫细胞亚群特征在术前和术后残余肿瘤中的贡献仍不清楚。我们通过对121例接受新辅助化疗的乳腺癌患者进行免疫组化分析,分析了术前和术后肿瘤浸润性免疫细胞(CD3、CD4、CD8、CD20、CD68、Foxp3)。分析了免疫细胞特征并与反应和生存相关。我们确定了三种肿瘤浸润性免疫细胞特征,它们能够预测对新辅助化疗的病理完全缓解(pCR)(B簇:58%,与A簇和C簇:7%相比)。CD4淋巴细胞的高浸润是pCR发生的主要因素,这一关联在六个公共基因组数据集中得到了验证。化疗对淋巴细胞浸润的影响,包括CD4/CD8比率的逆转,与pCR和更好的预后相关。对化疗后残余肿瘤中免疫浸润的分析确定了一个特征(Y簇),其主要特征是CD3和CD68浸润高,与较差的无病生存率相关。
查询和上下文看起来相似吗?我们是否在使用嵌入模型的方式中使用了它们的设计意图?显然,不是!
 作者提供的左侧图像;右侧图像归功于:https://github.com/UKPLab/sentence-transformers/blob/master/docs/img/SemanticSearch.png,Apache-2.0许可证
我们需要微调嵌入模型的原因是确保查询和相关的上下文表示更接近。为什么不从头开始训练呢?这是因为嵌入模型已经从数十亿个标记的训练中获得了对语言结构的理解,这些理解仍然可以加以利用。
微调嵌入模型
为了微调嵌入模型,我们需要包含类似预期用户查询和公司相关文档的数据集。我们可以利用语言模型(LLM)根据知识库文档生成查询。使用公司的知识库训练LLM就像提供了一个快捷方式,因为它允许嵌入模型在训练阶段本身访问上下文。
数据准备 - 训练和测试:
以下是数据准备步骤:
对于训练集:
- \1. 使用LLM从公司的知识库中挖掘所有可能的问题。
- \2. 如果知识库被分块,确保从所有块中挖掘问题。
对于测试集:
- \1. 从知识库中挖掘较少数量的问题。
- \2. 如果有,使用真实用户的问题。
- \3. 对训练集中的问题进行释义。
- \4. 结合并释义训练集和测试集中的问题。
我们中的大多数人都不会开发全领域的嵌入模型。我们创建的嵌入模型旨在在公司的知识库上表现更好。因此,使用公司的内部数据集训练嵌入模型并无害处。
对于本文,我们将使用Hugging Face上的"_qiaojin/PubMedQ"_数据集,它包含pubid、问题和上下文等列。pubid将用作问题ID。
from datasets import load_dataset
med_data = load_dataset("qiaojin/PubMedQA", "pqa_artificial", split="train")
med_data

pubid是一个唯一的ID,它指向行。我们将使用pubid作为问题ID。
为了训练嵌入模型,我们将使用sentence-transformer训练器进行训练,但你也可以使用huggingface训练器。此外,我们使用_MultipleNegativeRankingLoss_来微调我们的模型,但同样的效果也可以通过使用多种损失函数实现,例如_TripletLoss_、_ContrastiveLoss_等。但是,对于每种损失,所需的数据不同。例如,对于tripletloss,你需要(查询,正例上下文,负例上下文)对,而在MultipleNegativeRankingLoss中,你只需要(查询,正例上下文)对。对于给定的查询,除了正例上下文之外的所有上下文都将被视为负例。
在我们的PubMedQA数据集中,每一行的"question"列包含一个问题,"context"列包含适合该问题的上下文列表。因此,我们需要扩展上下文列表列,并创建包含相应上下文的新列的单独行。
dataset = med_data.remove_columns(['long_answer', 'final_decision'])

df = pd.DataFrame(dataset)
df['contexts'] = df['context'].apply(lambda x: x['contexts'])

# 展平上下文列表并重复问题
expanded_df = df.explode('contexts')

# 可选:如果需要,重置索引
expanded_df.reset_index(drop=True, inplace=True)

expanded_df = expanded_df[['question', 'contexts']]
splitted_dataset = Dataset.from_pandas(expanded_df).train_test_split(test_size=0.05)

expanded_df.head()

准备评估数据集:
现在,我们已经准备好了训练和测试数据集。接下来,让我们为评估准备数据集。对于评估,我们将使用LLM从上下文中挖掘问题,这样我们可以获得一个关于我们的嵌入模型改进效果的现实感受。从PubMedDataset中,我们将选择前250行,将上下文列表合并成每行一个字符串,然后发送给LLM进行问题挖掘。因此,对于每一行,LLM可能会输出大约10个问题。这样,我们将有大约2500个问题-上下文对用于评估。
from openai import OpenAI
from tqdm.auto import tqdm

eval_med_data_seed = med_data.shuffle().take(251)

client = OpenAI(api_key="<YOUR_API_KEY>")

prompt = """Your task is to mine questions from the given context.
Example question is also given to you.
You have to create questions and return as pipe separated values(|)

<Context>
{context}
</Context>

<Example>
{example_question}
</Example>
"""

questions = []
for row in tqdm(eval_med_data_seed):

    question = row["question"]
    context = "\n\n".join(row["context"]["contexts"])
    question_count = len(row["context"]["contexts"])


    message = prompt.format(question_count=question_count,
                            context=context,
                            example_question=question)

    completion = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {
                "role": "user",
                "content": message
            }
        ]
    )

    questions.append(completion.choices[0].message.content.split("|"))

eval_med_data_seed = eval_med_data_seed.add_column("test_questions", questions)
df = eval_med_data_seed.to_pandas()

eval_data = Dataset.from_pandas(df.explode("test_questions"))
eval_data.to_parquet("test_med_data2.parquet")
在我们开始训练之前,我们需要使用上面创建的评估数据集来准备评估器。
准备评估器:
sentence-transformer库提供了各种评估器,如_EmbeddingSimilarityEvaluator_、BinaryClassificationEvaluator_和_InformationRetrievalEvaluator。对于我们的特定用例,即训练用于RAG的嵌入模型,_InformationRetrievalEvaluator_是最合适的选择。此外,可以添加多个评估器并用于评分。
给定一组查询和大型语料库集,信息检索评估器将为每个查询检索最相似的top-k个文档。信息检索评估器将使用各种指标来评估模型,如Recall@k、Precision@k、MRR和Accuracy@K,其中k将是1、3、5和10。对于RAG,Recall@K指标是最重要的,因为它表明检索器可以成功检索多少个相关上下文。这一点至关重要,因为如果检索器可以检索到正确的上下文,生成的内容很可能会是准确的,即使我们有额外的非相关上下文。
eval_context_id_map = {}

for row in eval_data:
    contexts = row["context"]["contexts"]
    for context, context_id in zip(contexts, row["context_ids"]):
        eval_context_id_map[context_id] = context

eval_corpus = {} # Our corpus (cid => document)
eval_queries = {}  # Our queries (qid => question)
eval_relevant_docs = {}  # Query ID to relevant documents (qid => set([relevant_cids])

for row in eval_data:
    pubid = row.get("pubid")
    eval_queries[pubid] = row.get("test_questions")
    eval_relevant_docs[pubid] = row.get("context_ids")

    for context_id in row.get("context_ids"):
        eval_corpus[context_id] = eval_context_id_map[context_id]
_查询:将每个出版物的ID映射到其对应的问题。
_语料库:将每个上下文ID映射到上下文映射中的内容。
_相关文档:将每个出版物的ID关联到一个相关上下文ID的集合中。
在形成所有字典之后,我们可以从sentence_transformer包中创建一个InformationRetrievalEvaluator实例。
ir_evaluator = InformationRetrievalEvaluator(
    queries=eval_queries,
    corpus=eval_corpus,
    relevant_docs=eval_relevant_docs,
    name="med-eval-test",
)
模型训练:
最后,让我们来训练我们的模型。使用sentence-transformer训练器进行训练非常简单。只需设置以下训练配置参数:
- \1. eval_steps - 指定模型多久评估一次。
- \2. save_steps - 指定模型多久保存一次。
- \3. num_train_epochs - 训练的轮数。
- \4. per_device_train_batch_size - 在单个GPU的情况下,这是批大小。
- \5. save_total_limit - 指定允许的最大保存模型数量。
- \6. run_name - 因为日志将被发布在wandb.ai上,所以运行名称是必要的。
然后,我们将我们的参数、训练数据集、测试数据集、损失函数、评估器和模型名称传递给训练器。现在您可以坐下来放松,直到训练完成。
 放松:你是个好人,亚瑟!
对于我们的训练数据,训练模型大约需要3个小时,这包括了测试数据集和评估数据集的推理时间。
# Load base model
model = SentenceTransformer("stsb-distilbert-base")
output_dir = f"output/training_mnrl-{datetime.now():%Y-%m-%d_%H-%M-%S}"

train_loss = MultipleNegativesRankingLoss(model=model)

# Training arguments
args = SentenceTransformerTrainingArguments(
    output_dir=output_dir, num_train_epochs=1, per_device_train_batch_size=64,
    eval_strategy="steps", eval_steps=250, save_steps=250, save_total_limit=2,
    logging_steps=100, run_name="mnrl"
)

# Train the model
trainer = SentenceTransformerTrainer(model=model,
                                     args=args,
                                     train_dataset=splitted_dataset["train"],
                                     eval_dataset=splitted_dataset["test"],
                                     loss=train_loss,
                                     evaluator=ir_evaluator)

trainer.train()
 Full results on the notebook attached at the end
结果
为了进行比较,让我们初始化两个模型的实例,一个带有训练好的权重,另一个带有未训练的权重。
untrained_pubmed_model = SentenceTransformer("stsb-distilbert-base")
trained_pubmed_model = SentenceTransformer("/kaggle/input/sentencetransformerpubmedmodel/transformers/default/1/final")
ir_evaluator(untrained_pubmed_model)
ir_evaluator(trained_pubmed_model)

结果非常明显,每个指标都有惊人的提升。以下是关注指标的提升情况:
- • recall@1 – 相比未训练模型提升了78.80%
- • recall@3 – 相比未训练模型提升了137.92%
- • recall@5 – 相比未训练模型提升了116.36%
- • recall@10 – 相比未训练模型提升了95.09%
分析结果后,很明显,嵌入模型增强了上下文召回率,从而显著提高了RAG生成的整体准确性。然而,一个缺点是需要监控知识库中文档的增加,并定期重新训练模型。
这可以通过遵循标准的机器学习管道流程来实现,其中我们监控模型是否存在任何漂移,如果漂移超过某个阈值,就重新启动训练流程。
参考文献:
- \1. 领域自适应到专有数据自适应的想法来源于:GPL:用于密集检索无监督领域自适应的生成伪标签[1]
- \2. RAG评估 - https://www.pinecone.io/learn/series/vector-databases-in-production-for-busy-engineers/rag-evaluation/
- \3. SBERT训练 - https://sbert.net/examples/training/ms_marco/cross_encoder_README.html
引用链接
[1] GPL:用于密集检索无监督领域自适应的生成伪标签: https://arxiv.org/pdf/2112.07577
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
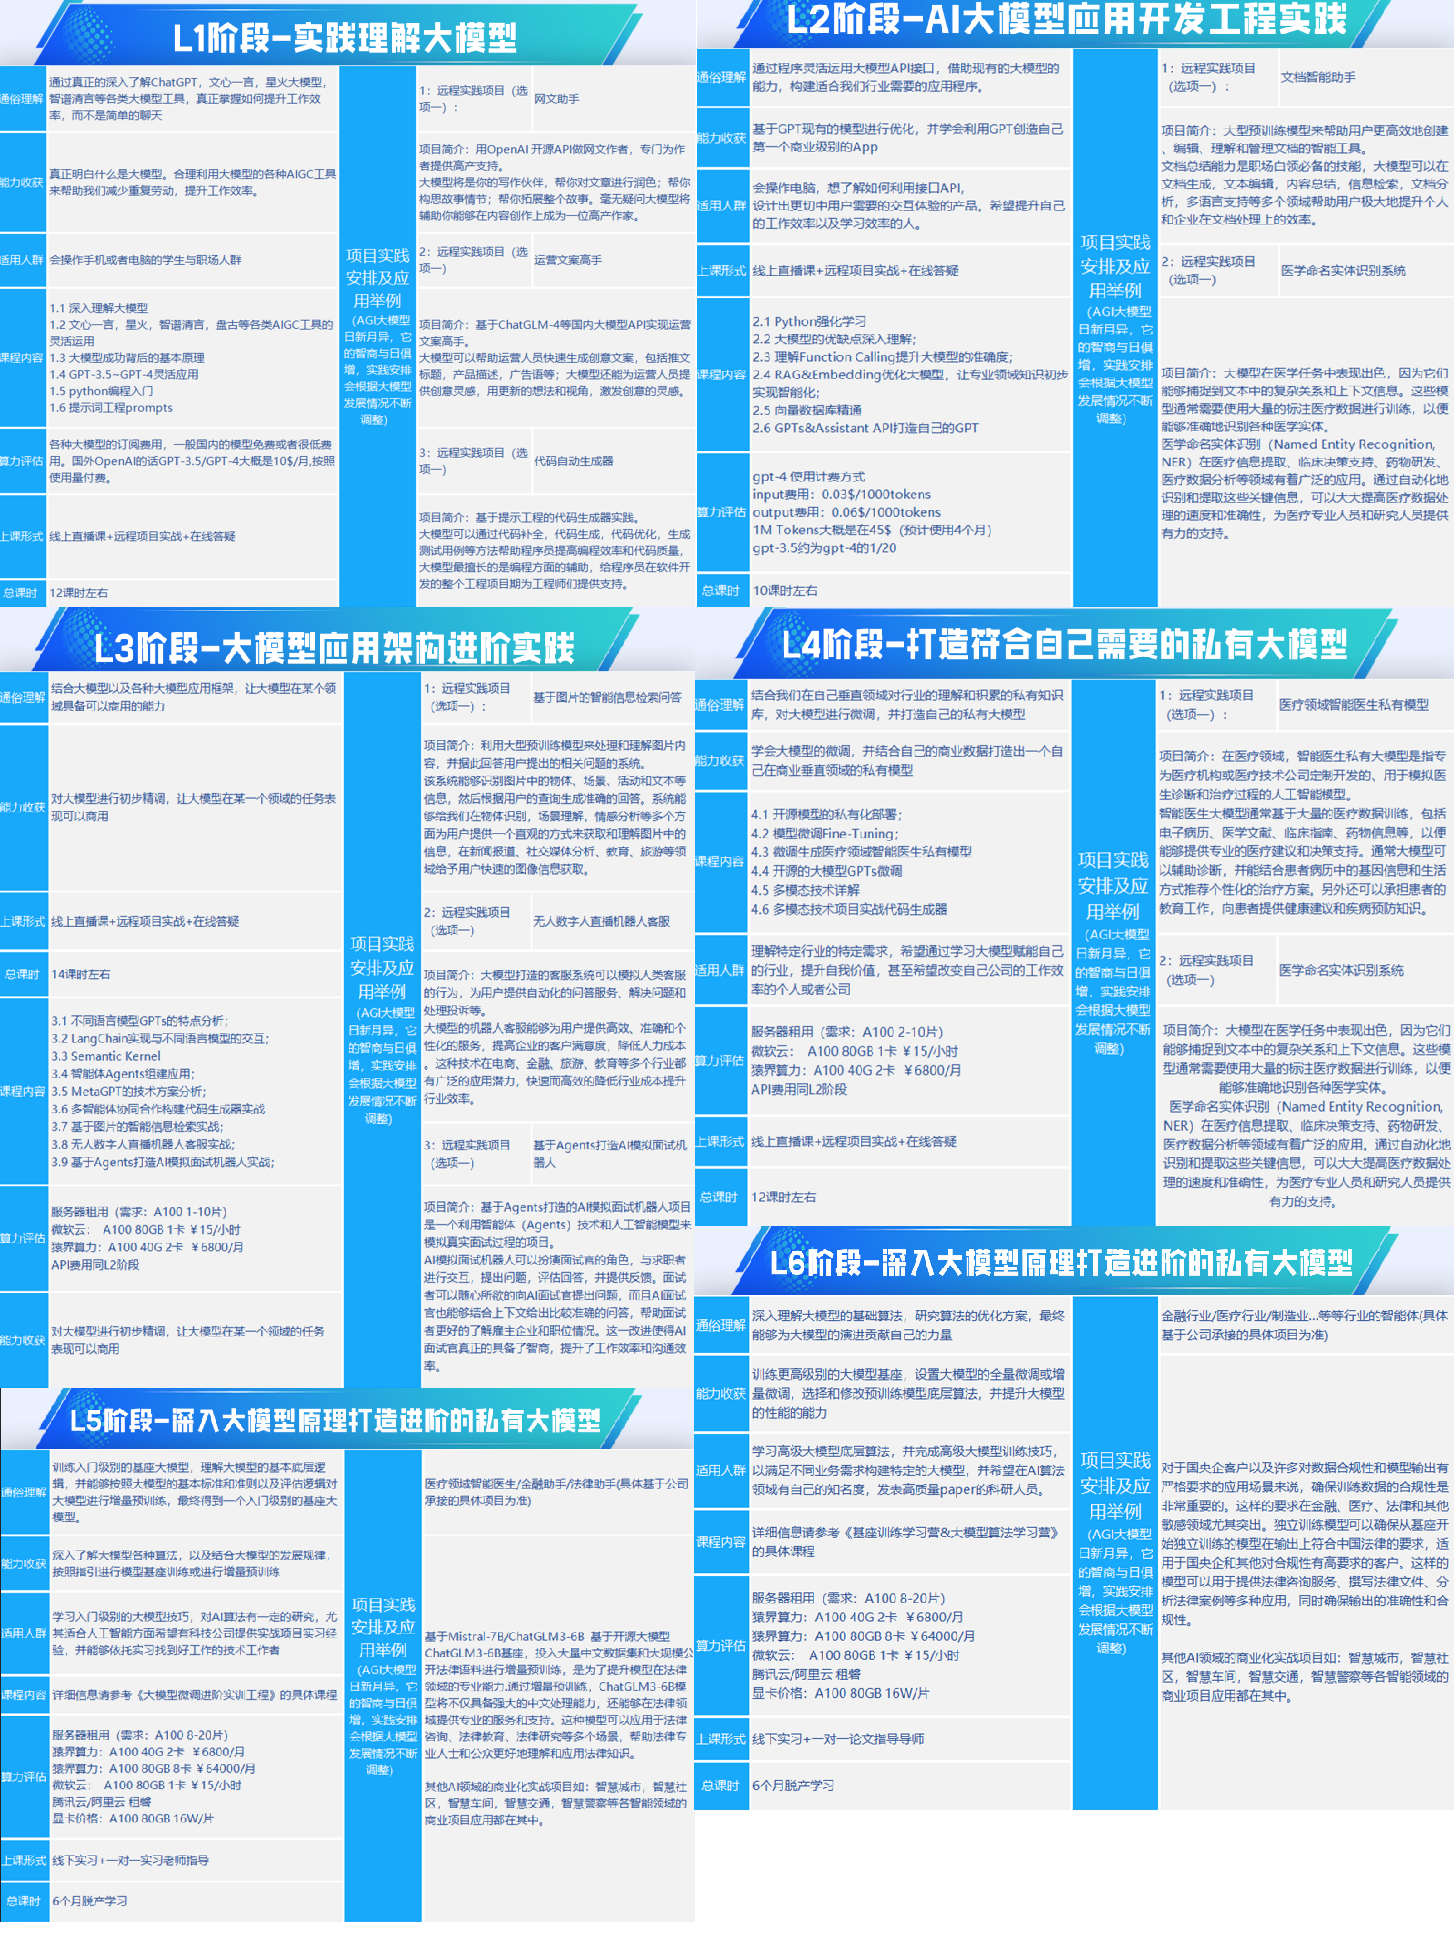
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
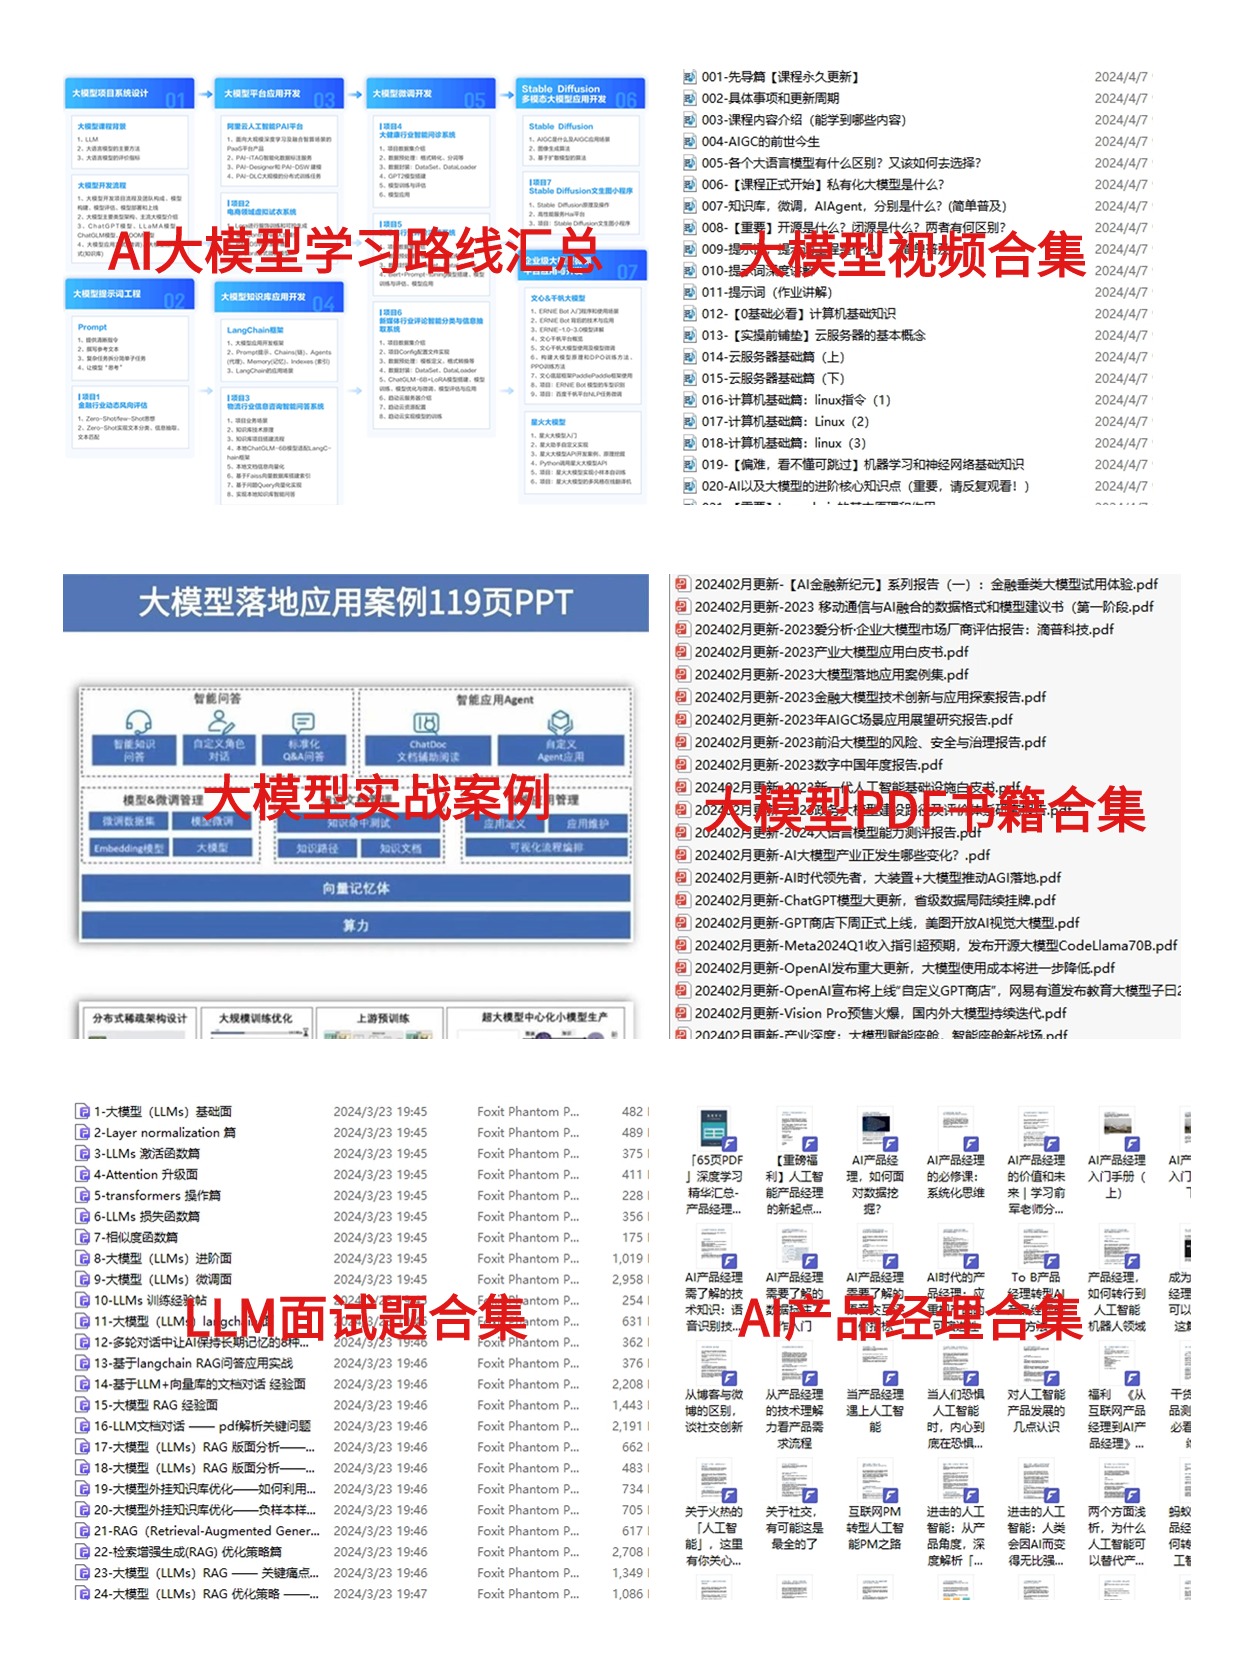
640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 707


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


