突破最强算法模型,Transformer !!

神经网络算法有哪些模型,神经网络算法模型resnet 6)计算W[S1][S0],b[S1];9))输出W1[S1][S0],b1[S1]。2.应用弹性BP算法(RPROP)学习三层BP网络(含输入层,隐含层,输出层)权值W、偏差b总体算法函数:Train3BP_RPROP(S0,X,P,S1,W1,b1,f1,S2,W2,b2,f2,d,TP)(1)输入参数P对模式(xp,dp),p=1,2,…三、总体算法1.三层BP网络(含输入层,隐含层,输出层)权值W、偏差b初始化总体算法(1)输入参数X[N][P],S0,S1,f1[S1],S2,f2[S2]; 阅读详情

这几天,大家对于Transformer的问题,还是不少。

今儿再和大家聊聊~

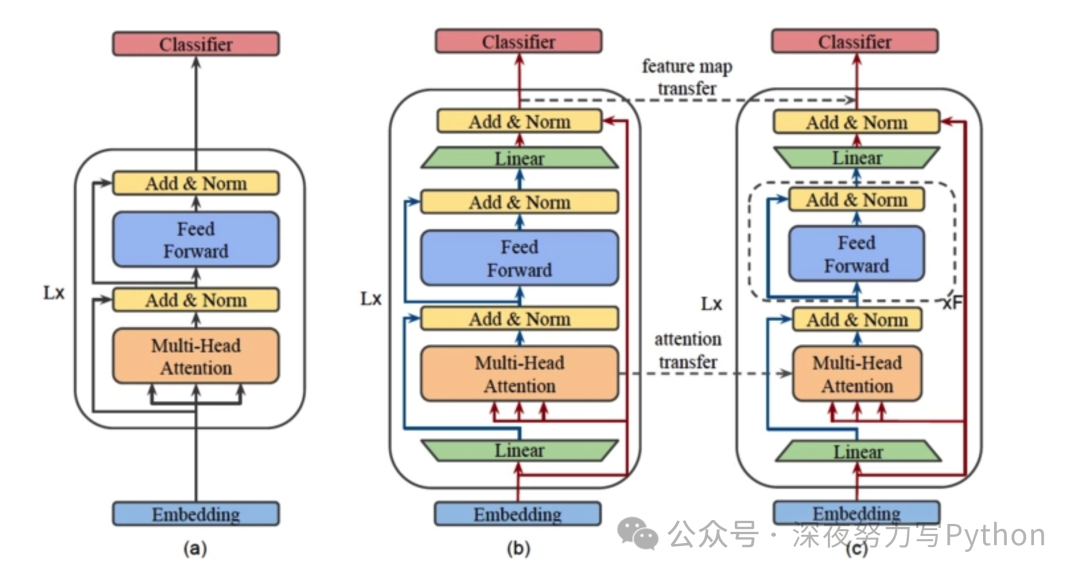
简单来说,Transformer 是一种神经网络模型,在机器翻译、语言理解等任务中表现特别好。它的核心思想是自注意力机制(Self-Attention),能够处理句子中的所有词并理解它们之间的关系。
图片

开始,咱们用一个浅显易懂的例子来说明 Transformer 是怎么工作的。

假设你在读一句话:“小明今天去商店买了一本书。”

传统方法的问题

传统的模型(比如循环神经网络,RNN)是按顺序阅读这句话的。也就是说,它先看到“小明”,然后是“今天”,再是“去商店”……每读到一个词,它才记住前面的部分。这种方式虽然有效,但如果句子很长,前面的词就容易被“忘记”,特别是如果你想知道小明到底买了什么,这个“书”就很重要,但它离“小明”很远。

那Transformer 如何解决?

Transformer 不按顺序逐个看句子,而是一次性把整个句子都看一遍,它会考虑每个词和其他词之间的关系。

举个例子:

1. 自注意力机制: Transformer 会问自己:“句子里的每个词,跟其他词有什么关系?” 比如:

  • “小明”跟“买”有关系,因为小明是买东西的人。
  • “买”和“书”有关系,因为买的东西是书。
  • “今天”和“去商店”有关系,因为今天是去商店的时间。

2. 权重: 这些词的关系是有“权重”的,意思是有的词的关系更重要,比如“买”和“书”之间的关系要比“买”和“今天”之间的关系重要,因为我们更关心买的是什么。

3. 并行处理: Transformer 并不像传统模型那样一步一步处理,而是并行地处理句子中的每个词。它的自注意力机制可以一次就“看到”句子里的所有词,并快速找到它们之间的重要关系。

再举个通俗的例子:

假设 Transformer 是一个正在听朋友讲故事的小学生。故事很长,小学生不能依靠只记住故事开头就理解整个故事。所以他一边听一边在脑中快速建立人物、地点、事件之间的联系:

  • 他知道“小明”是主角,所以听到“小明”做什么事情时特别注意。
  • 他听到“买了书”,就能迅速联系到“小明”是买书的那个人。
  • 他也知道“商店”和“买东西”有关,所以商店的存在也很重要。

这样,即使故事很复杂,小学生依然能通过理解这些联系快速明白故事的意思。这就是 Transformer 的思路!

总之,Transformer 的厉害之处在于它并行处理句子中的所有词,并且通过自注意力机制,理解每个词跟其他词的关系。这样即使句子很长,它也能快速且准确地抓住句子的意思。

下面,咱们详细的聊聊原理、公式以及一个案例代码,这里不使用现成的Python包,重点再原理的理解~

Transformer 公式推导

Transformer 的核心在于自注意力机制和位置编码。

自注意力机制(Scaled Dot-Product Attention)

自注意力机制是 Transformer 中最重要的部分。它的目标是让每个词(或特征)能够和其他词建立联系。这个过程分为几个步骤:

  • 输入向量:每个词 通过嵌入层得到向量表示 。
  • 生成 Query, Key, Value:对于每个输入向量,我们生成 Query ,Key ,Value :

这里 是可学习的权重矩阵。

  • 注意力得分:计算 Query 和 Key 之间的相似度,使用点积来衡量:

其中 是向量的维度,确保点积的规模不会过大或过小,softmax 将得分归一化为概率分布。

位置编码

由于 Transformer 不像 RNN 那样按顺序处理输入,它通过位置编码给每个词的位置加上位置信息。位置编码的公式如下:

案例构建

我们使用一个简化的 Transformer 进行文本分类任务。为了避免使用高级框架,让大家更容易理解其原理。咱们零开始实现自注意力机制和模型的训练。

Kaggle 数据集

我们使用 Kaggle 上的 “IMDb Movie Reviews” 数据集进行文本分类任务(正面/负面情感)。

我们先加载数据集并进行预处理:

import numpy as np
import pandas as pd
import re
from sklearn.model_selection import train_test_split

# 加载 IMDb 数据集
df = pd.read_csv('IMDB Dataset.csv')

# 数据预处理(简单清理)
def clean_text(text): 
    text = re.sub(r'<.*?>', '', text)    
    text = re.sub(r'[^a-zA-Z\s]', '', text)    
    text = text.lower()    
    return text

df['clean_review'] = df['review'].apply(clean_text)
df['label'] = df['sentiment'].map({'positive': 1, 'negative': 0})

# 拆分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(df['clean_review'], df['label'], test_size=0.2, random_state=42)

# 简单的词汇表构建
from collections import Counter
vocab = Counter()
for text in X_train: 
    vocab.update(text.split())    

vocab_size = 5000
vocab = dict(vocab.most_common(vocab_size))

# 构建词向量
word2idx = {word: idx for idx, (word, _) in enumerate(vocab.items(), 1)}
word2idx['<UNK>'] = 0

# 将文本转为索引
def text_to_sequence(text): 
    return [word2idx.get(word, 0) for word in text.split()]

X_train_seq = [text_to_sequence(text) for text in X_train]
X_test_seq = [text_to_sequence(text) for text in X_test]

自注意力机制实现

class ScaledDotProductAttention:
    def __init__(self, d_k):    
        self.d_k = d_k        
        
    def attention(self, Q, K, V):    
        scores = np.dot(Q, K.T) / np.sqrt(self.d_k)        
        attention_weights = np.exp(scores) / np.sum(np.exp(scores), axis=1, keepdims=True)        
        return np.dot(attention_weights, V)

# 示例输入,假设我们已经有了词向量
Q = np.random.rand(10, 64)  # 10个词,64维度
K = np.random.rand(10, 64)
V = np.random.rand(10, 64)

attention = ScaledDotProductAttention(64)
output = attention.attention(Q, K, V)

可视化分析与复杂图形

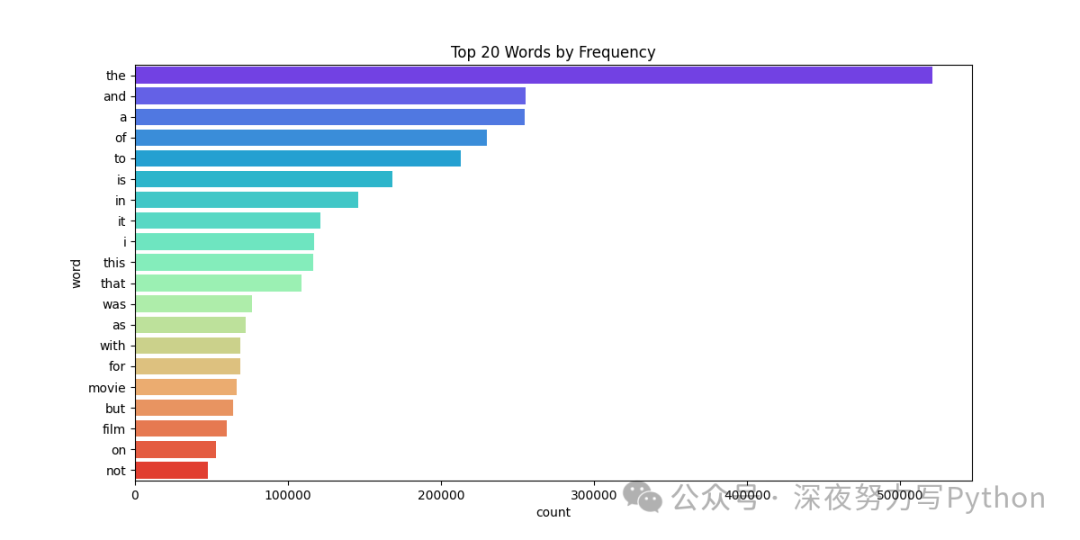
我们现在对数据集进行一些可视化分析,比如词频分布、模型的训练损失等。下面展示了如何生成颜色鲜艳的图形:

import matplotlib.pyplot as plt
import seaborn as sns

# 词频分布
word_counts = pd.DataFrame(vocab.items(), columns=['word', 'count']).sort_values(by='count', ascending=False).head(20)

plt.figure(figsize=(12, 6))
sns.barplot(x='count', y='word', data=word_counts, palette='rainbow')
plt.title('Top 20 Words by Frequency')
plt.show()
图片

在这里插入图片描述

在这里插入图片描述

整体代码:

import numpy as np
import pandas as pd
import re
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split

# 加载 IMDb 数据集
df = pd.read_csv('dataset/IMDB Dataset.csv')

# 数据预处理(简单清理)
def clean_text(text): 
    text = re.sub(r'<.*?>', '', text)    
    text = re.sub(r'[^a-zA-Z\s]', '', text)    
    text = text.lower()    
    return text

df['clean_review'] = df['review'].apply(clean_text)
df['label'] = df['sentiment'].map({'positive': 1, 'negative': 0})

# 拆分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(df['clean_review'], df['label'], test_size=0.2, random_state=42)

# 简单的词汇表构建
from collections import Counter

vocab = Counter()
for text in X_train:   
    vocab.update(text.split())

vocab_size = 5000
vocab = dict(vocab.most_common(vocab_size))

# 构建词向量
word2idx = {word: idx for idx, (word, _) in enumerate(vocab.items(), 1)}
word2idx['<UNK>'] = 0

# 将文本转为索引
def text_to_sequence(text): 
    return [word2idx.get(word, 0) for word in text.split()]

X_train_seq = [text_to_sequence(text) for text in X_train]
X_test_seq = [text_to_sequence(text) for text in X_test]

class ScaledDotProductAttention:
    def __init__(self, d_k):   
        self.d_k = d_k    
        
    def attention(self, Q, K, V):     
        scores = np.dot(Q, K.T) / np.sqrt(self.d_k)        
        attention_weights = np.exp(scores) / np.sum(np.exp(scores), axis=1, keepdims=True)        
        return np.dot(attention_weights, V)

# 示例输入,假设我们已经有了词向量
Q = np.random.rand(10, 64)  # 10个词,64维度
K = np.random.rand(10, 64)
V = np.random.rand(10, 64)

attention = ScaledDotProductAttention(64)
output = attention.attention(Q, K, V)

# 词频分布
word_counts = pd.DataFrame(vocab.items(), columns=['word', 'count']).sort_values(by='count', ascending=False).head(20)

plt.figure(figsize=(12, 6))
sns.barplot(x='count', y='word', data=word_counts, palette='rainbow')
plt.title('Top 20 Words by Frequency')
plt.show()

# 模型训练过程中的损失变化(假设我们有训练的 loss 记录)
losses = np.random.rand(100)  # 假设有 100 轮训练的损失
plt.figure(figsize=(12, 6))
plt.plot(losses, color='magenta')
plt.title('Training Loss Over Time')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.show()

这几个重点,大家可以注意下~

  • 使用基础 Python 实现了一个简化版的 Transformer,并应用了自注意力机制的核心概念。
  • 选择了 IMDb 数据集来做情感分类任务,进行了词频可视化和训练损失曲线的绘制。
  • 接下来的步骤可以继续扩展,如实现多头注意力、完整的前馈网络,进一步改进模型的表现。

整体案例通过自底向上的方式构建 Transformer,尽可能帮助大家深入理解其原理,尤其是注意力机制的核心思想。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

神经网络与Transformer详解 Transformers是近年来在自然语言处理和计算机视觉领域取得巨大成功的一类模型。其核心思想是自注意力机制(self-attention),能够捕捉长距离依赖关系,显著提高模型的表达能力。Transformers在多个任务中展现了卓越性能,推动了深度学习的发展。 阅读详情

相关推荐

Transformer强化学习新突破:29个前沿应用与架构优化实战指南

本文深入探讨了Transformer与强化学习的融合创新,通过架构增强与轨迹优化两大方向,详细解析了29个前沿应用场景与实战优化技巧。文章结合代码实例,展示了如何利用Transformer的自注意力机制提升智能体的序列建模与长期决策能力,为自动驾驶、机器人控制等领域提供实战指南。

weixin_29098117的博客 289

transformer算法详解

一、背景 NLP作为AI的子领域,一直以来被认为比较难的学科。特征抽取一直以来都作为NLP的核心任务。概况来说在深度学习为基础的体系中,特征抽取经历了以下几个阶段:DNN->CNN->RNN->Transformer。自从2017年6月份《Attention is all you need》论文作为机器翻译算法提出后,transform已经逐步替代了以CNN和RNN为首的特征抽取,特别是2018年bert一战成名后,目前所有的主流方法几乎都是transformer系的变体。 二、架构

woshiliulei0的专栏 9034

【机器学习】一文搞懂算法模型之:Transformer

必会算法模型之:Transformer

商务合作 | 面试培训 | 职场规划 ==>主页扫码 5609

【大模型】图文详解Transformer为什么如此强大

比如,在句子 “The black cat drank the milk” 中,单词 “milk” 与 “drank” 非常相关,与 “cat” 稍微不那么相关,而与 “black” 无关。我们希望 “milk” 和 “drank” 之间产生高分数,“milk” 和 “cat” 之间产生略低的分数,而 “milk” 和 “black” 之间的分数则接近于零。换句话说,它会以这样的方式学习这些嵌入和权重:如果句子中的两个单词彼此相关,那么它们的向量就会对齐,从而产生较高的注意力分数。

qq_41466440的博客 1360

从零开始大模型开发与微调:最强的中文大模型—清华大学ChatGLM介绍

从零开始大模型开发与微调:最强的中文大模型—清华大学ChatGLM介绍 1.背景介绍 1.1 人工智能大模型的兴起 近年来,人工智能领域取得了长足的进步,其中大模型的出现引领了这一浪潮。大模型指的是拥

AI天才研究院 873

AD9361 官方例程

文章目录一、官方资料1.1 介绍1.2 下载 和 使用1.3 相关资料二、步骤2.1 在Vivado中构建HDL2.2 在SDK中构建No- OS总结 一、官方资料 1.1 介绍 HDL参考设计介绍:AD9361 HDL Reference Designs 无操作系统介绍:AD9361 No-OS Software 1.2 下载 和 使用 HDL下载:Download HDL 在Vivado中构建HDL:Building HDL No-OS下载:Download No-OS 1.3 相关资料 AD

weixin_44630490的博客 3万+

看懂Mamba,Transformer最强竞争者(二)Mamba

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 2173

Quartus Prime 软件 USB-blaster 驱动安装失败【已解决】

一、安装步骤 1、将FPGA 开发板插入电脑时,未安装驱动的电脑会提示安装usb-Blaster驱动。Windows搜索框打开设备管理器,在“其他设备”下会发现黄色感叹号的“USB-Blaster”的设备驱动。 2、Quartus系列软件的安装目录下自带USB-blaster的驱动程序,右键更新驱动,选择驱动目录:(D:\intelFPGA\18.1\quartus\drivers\usb-blaster,文件位置和版本请按照自己安装的路径选择),点击Next开始安装。 3、安装成功,重启电脑即可使

adolphwang_909086的博客 6万+

深度学习最强模型!挑战一篇文章让你理解什么是Transformer模型!从原理到代码的详细讲解!

从最初的机器翻译到如今的多模态大模型,Transformer 凭借注意力机制的革命性创新,重新定义了深度学习的可能性。其核心价值不仅在于技术突破,更在于构建了一个通用的序列建模框架,使得跨领域迁移学习成为可能。未来,随着注意力机制的持续优化(如动态稀疏注意力、因果推理增强)和硬件加速技术的发展,Transformer 有望在自动驾驶、科学发现等更复杂场景中发挥关键作用,推动人工智能向通用化迈进。附:术语对照表术语含义描述自注意力机制,捕捉序列内部关联多头注意力,分頭计算增强表征能力。

yyyyyybw的博客 889

YOLOv8基础环境搭建cuda+anaconda+pytorch+pycharm

首先安装NVIDIA gpu的电脑安装显卡驱动,如果安装过了,或者想使用cpu的,可以跳过这一步。打开cmd,输入nvidia-smi查看GPU的CUDA版本,可以看到CUDA版本12.3,意味着只能安装小于12.3的CUDA版本。下载完成,进行安装,建议安装在非系统盘,以后会创建比较多的环境的话,剩下的默认安装即可。,需要注册一个NVIDIA账号,然后选择CUDA对应版本的cudnn即可。,以12.2.1版本举例,选好系统参数,点击下载,,以11.6版本举例,选好系统参数,点击下载,

qq_16602159的博客 2383

氮化镓GaN电机驱动实战:从器件原理到EPC驱动中心

电机驱动是工业自动化和电动交通的核心,功率器件的选择直接决定系统效率与可靠性。传统硅基IGBT和MOSFET在开关速度、损耗方面存在瓶颈,而氮化镓(GaN)作为宽禁带半导体,凭借高电子迁移率、低栅极电荷和近乎为零的反向恢复电荷,正成为电机驱动领域的热门选择。EPC建立电机驱动中心,提供完整的评估平台,覆盖从低压家电到中压伺服的应用场景。文章从GaN器件原理出发,对比传统硅器件,详解三相BLDC/PMSM驱动系统的搭建、栅极驱动与Layout设计、死区时间设置及参数计算实例,并分享测试中遇到的振铃、EMI等高

weixin_29168675的博客 323

大模型架构进化论:从Transformer到创新架构的全面指南!

文章探讨了超越传统Transformer的大语言模型创新架构,包括线性注意力混合模型、文本扩散模型、代码世界模型和小型递归Transformers。这些方案有的专注效率提升,有的致力于性能增强,代表了LLMs领域的重要发展方向,而标准Transformer架构仍是可靠选择。

m0_71746299的博客 1012

鸿蒙OS+UniApp文件上传实战:如何解决大文件分片上传的3大坑?

本文深入探讨鸿蒙OS与UniApp结合实现大文件分片上传的实战方案,重点解决分片策略设计、网络中断处理和进度管理三大技术难题。通过鸿蒙分布式特性与UniApp跨平台能力的结合,提供动态分片调整、断点续传和跨设备进度同步等优化方案,显著提升大文件上传成功率和用户体验。

weixin_29250403的博客 474

Mamba-3震撼登场!Transformer最强挑战者再进化,已进入ICLR 2026盲审

特别是在1.5B规模上,Mamba-3以10.35的perplexity显著优于Mamba-2的10.47和Transformer的10.51。这一改进在不增加状态大小的前提下,大幅提升了推理阶段的硬件利用率。从Mamba-1的雏形初现,到Mamba-2的理论突破,再到Mamba-3的全面跃迁,这条"算法巨蟒"正以惊人的速度进化,为序列建模领域带来了新的可能性和想象空间。Mamba-3的进化展现了一条不同于Transformer的技术路径:通过更精巧的状态设计而非更大的参数量,在效率与能力间寻找平衡。

Coovally_AI的博客 977

别再只盯着CXL协议了,聊聊CXL.mem里那个能动态调优内存性能的‘QoS遥测’到底怎么用

本文深入解析CXL.mem协议中的QoS遥测功能,探讨如何通过DevLoad指标动态调优内存性能。文章详细介绍了QoS遥测的核心机制、多QoS类别设备的实战配置,以及AI训练、金融交易和视频处理场景中的优化案例,帮助数据中心实现高效内存资源管理。

weixin_33725722的博客 436

使用 MATLAB/Simulink 对基于同步发电机的双机系统进行建模

双机系统(Two-Machine System)是电力系统中用于研究动态稳定性和控制策略的一个典型模型。它由两台同步发电机通过输电网络相互连接,模拟实际电网中的互联操作。当发生短路故障时,系统的暂态稳定性会受到挑战,可能导致发电机失步或电压崩溃。本教程将带你使用 MATLAB/Simulink 对基于同步发电机的双机系统进行建模,并对其在短路故障条件下的暂态稳定性进行仿真和分析。

amy_mhd的博客 216

详解谷歌最强NLP模型BERT(理论+实战)

详解谷歌最强NLP模型BERT(理论+实战)     作者:李理,环信人工智能研发中心vp,十多年自然语言处理和人工智能研发经验。主持研发过多款智能硬件的问答和对话系统,负责环信中文语义分析开放平台和环信智能机器人的设计与研发。 本文是作者正在编写的《深度学习理论与实战》的部分内容。   导语   Google BERT 模型最近横扫了各大评测任务,在多项任务中取得了最好的...

周红伟讲AI 4816

如何使用Docker部署OpenClaw小龙虾(docker compose快速部署)

本文以飞牛NAS为例💻,带大家一步步完成Docker部署OpenClaw小龙虾🦞。不管你是用NAS、云服务器还是本地电脑,只要支持Docker,都可以参考这个步骤来安装部署⚡

XiaoqiangClub的博客 727

谷歌Transformer大进化,机翻最强王者上线

智造观点谷歌Evolved Transformer通过AutoML技术进行特定任务定制,在编码器和解码器模块底部的卷积层以分支模式运行,提高了语言建模的性能,目前在机器...

人工智能观察 675

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

九问中国大模型掌门人,万字长文详解大模型进度趋势

作者 | 袁滚滚 责编 | 唐小引出品 | 优快云(ID:优快云news)自ChatGPT 在去年 11 月底横空出世,大模型的风刮了整一年。历经了百模大战、Llama 2 开源、GPTs 发布等一系列里程碑事件,将大模型技术推至无可争议的 C 位。基于大模型的研究与讨论,也让我们愈发接近这波技术浪潮的核心。在 2023 长沙·中国1024 程序员节上,优快云 力邀中国大模型...

优快云资讯 8282

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

DeepSeek MODEL1架构级跃迁:从Transformer到状态空间模型的革命性突破

DeepSeek推出革命性MODEL1项目,彻底颠覆传统Transformer架构,采用状态空间模型(SSM)与强化学习推理单元融合的新范式。该架构引入可微分状态记忆体和递归推理单元,支持长达100万步的推理轨迹和动态状态追踪,在数学推理等任务上表现提升37%。若成功落地,MODEL1将实现从语言模型到推理智能体的跨越,具备长期规划、自我修正等高级认知能力。目前项目仍面临训练稳定性、推理延迟等挑战,但若成功可能重塑全球AI格局,助力中国团队从"跟跑"转向"领跑"。普通

2401_85375151的博客 911

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Percepta突破:大模型内置计算系统与2D注意力优化

Transformer架构作为现代大语言模型的核心组件,通过自注意力机制实现上下文建模。其计算复杂度随序列长度线性增长的问题,在程序执行等结构化任务中尤为突出。Percepta团队创新性地提出2D几何注意力机制,将Key向量转化为二维形式,利用计算几何中的凸包优化实现O(log n)查询效率。这种内置计算系统通过权重空间模拟完整计算机架构,包括指令解码、寄存器管理和ALU运算,使模型获得原生计算能力。该技术在组合优化、算法设计等场景展现优势,如数独求解中实现约束传播与回溯搜索的透明化执行,为AI系统的可解释

cmff98425的博客 310

地表最强的GPT-3,是在推理,还是胡言乱语?

⬆⬆⬆ 点击蓝字关注我们AI TIME欢迎每一位AI爱好者的加入!GPT-3发布以来,衍生了翻译、答题、创作小说、数据分析、数学推理、玩游戏、画图表、制作简历等...

AITIME_HY的博客 1083

2024年国产大模型最强前10榜单发布。

你好,我是郭震2024年,国产大模型,继续狂飙。这是访问量前10的大模型榜单,如下所示:访问量最高的前三名:豆包(3723万次)Kimi(3648万次)文心一言(2937万次)这三款产品10月访问量均在2000万级别以上,显示出相对较高的用户使用频率和活跃度。用户数规模前三名:豆包:2.4亿用户Kimi:1.8亿用户文心一言:1.5亿用户这些用户数级别较为庞大,体现出头部产品在市场上的广泛覆盖。其...

算法channel 6394

Transformer作者重磅预言:AI无寒冬,推理革命引爆万亿市场

值得关注的是,在ChatGPT问世前加盟OpenAI,Łukasz Kaiser此后一直专注研究推理模型——他认为这是继2017年Transformer之后最重大的突破。GPT-4之前,OpenAI就开始研究推理模型,因为人们清楚地看到,仅仅纯粹的Scaling在经济上不可行,我们需要一个新的范式。我们正见证新范式的上升趋势,但它需要进一步深入研究:有些研究效果很好,有些则一般,你永远不知道——这就是研究令人兴奋的部分。现在,AI不仅能生成报纸版面的完整文字,音频也能唱歌、耳语、模仿各国口音。

2501_91883294的博客 649
上一篇: # 速览多模态模型 Transfusion 和 Show-o:用 Transformer + 扩散模型同时处理文本和图像
下一篇: 墙裂推荐:《Transformer自然语言处理实战:使用Hugging-Face-Transformers库构建NLP应用》,行内人都在看的大模型神书!附PDF!
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值