论 LLMs 如何解决长文本问题?

推荐收藏!大模型算法工程师面试题来了(附答案) 最近大模型相关的招聘也非常多,小编整理了一些大模型面试常见问题,供大家参考。希望在找相关机会的同学能有好的收获。大模型面试题更新速度比较快,我们会第一时间在技术群和星球及时更新,向关注的朋友,可以加入我们。 阅读详情

一、长文本的核心问题与解决方向

1.1 文本长度与显存及计算量之关系

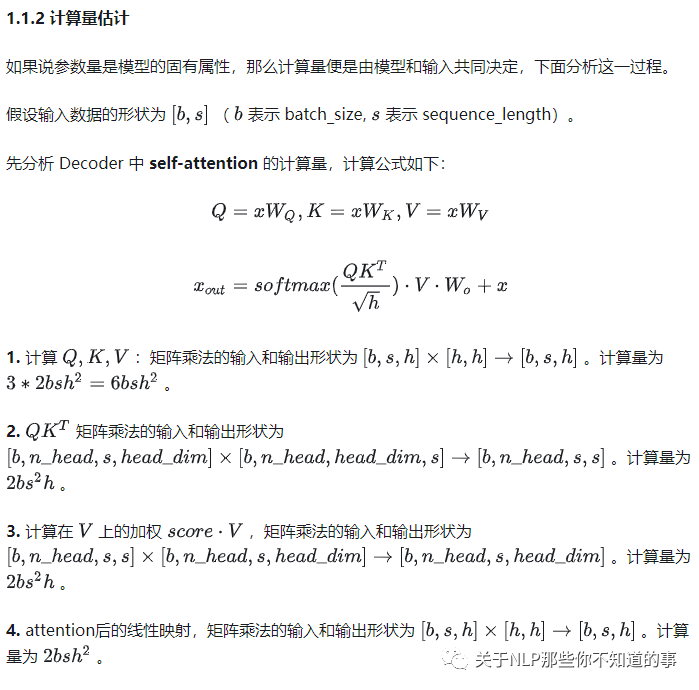
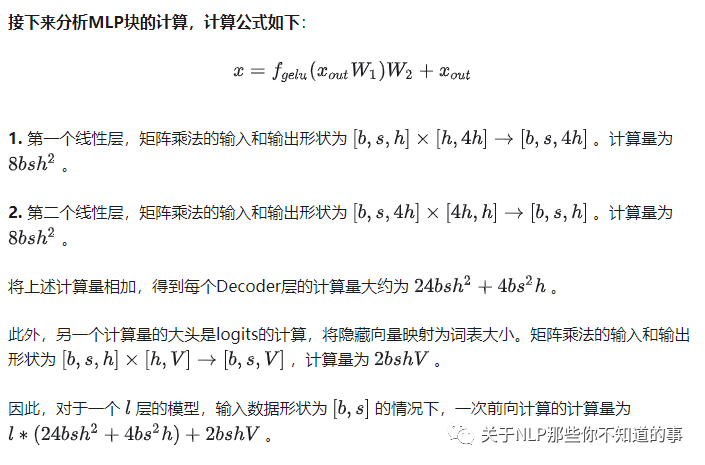
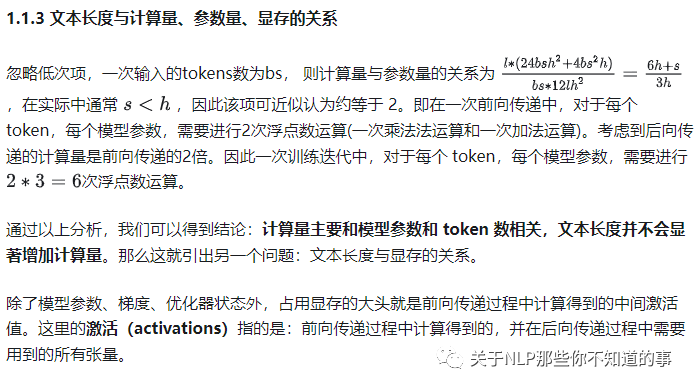
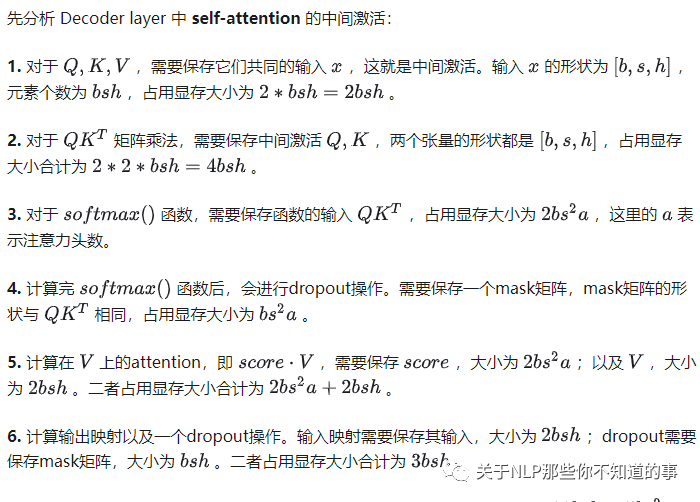
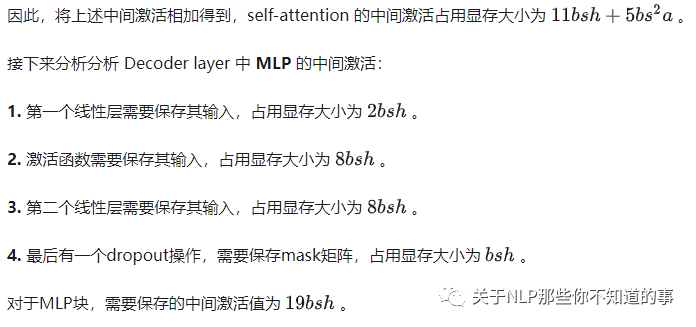
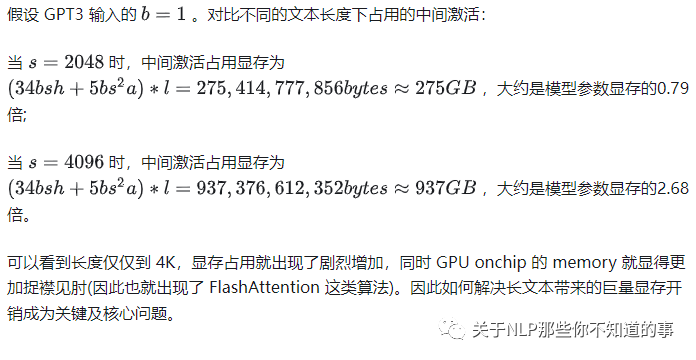
要研究清楚长文本的问题,首先应该搞清楚文本长度在模型中的地位与影响。那么我们便以 Decoder-base 的模型为例来进行分析

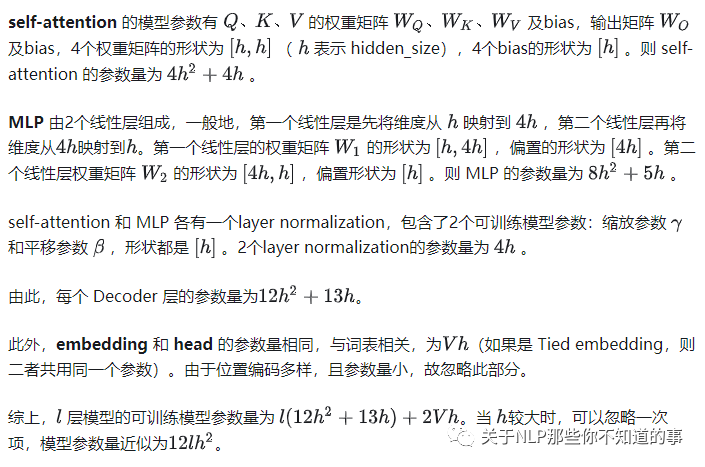
1.1.1 模型参数量

Decoder-base 的模型主要包括 3 个部分:embedding, decoder-layer, head。

其中最主要部分是decoder-layer,其由 � 个层组成,每个层又分为两部分:self-attention 和 MLP。
图片

图片

图片

图片

图片

图片

在这里插入图片描述

图片

在这里插入图片描述

二、长文本与位置编码

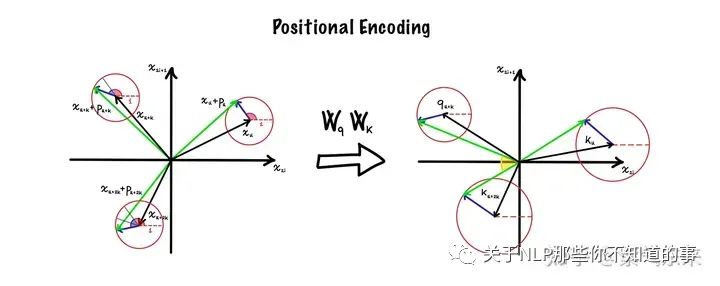
在 Transformer 结构的模型中,Attention模块的值与顺序无关,因此需要加入位置编码以确定不同位置的 token。典型的位置编码方式有两类:

  • 绝对位置编码:即将位置信息融入到输入中
  • 相对位置编码:微调Attention结构,使其能够分辨不同位置的Token

随着文本长度的增加,位置编码也会发生相应的变化,因此处理好位置编码问题是解决长文本问题的重要环节。
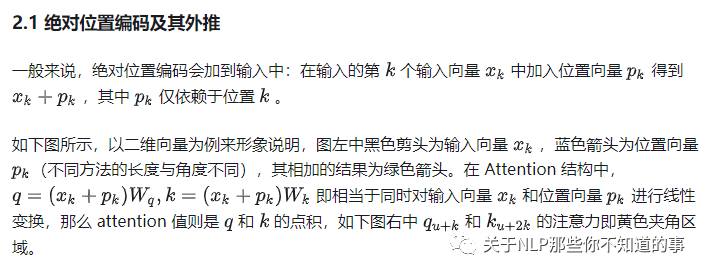
图片

图片

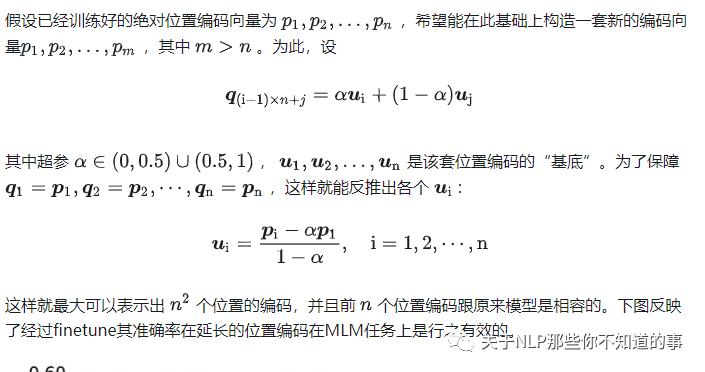
由于绝对位置编码由两部分组成,且两部分相互独立,因此无法计算相对距离。下面介绍几种典型的绝对位置编码:
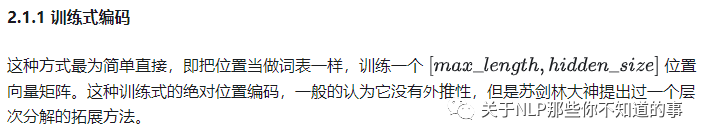
图片

图片

图片

图片

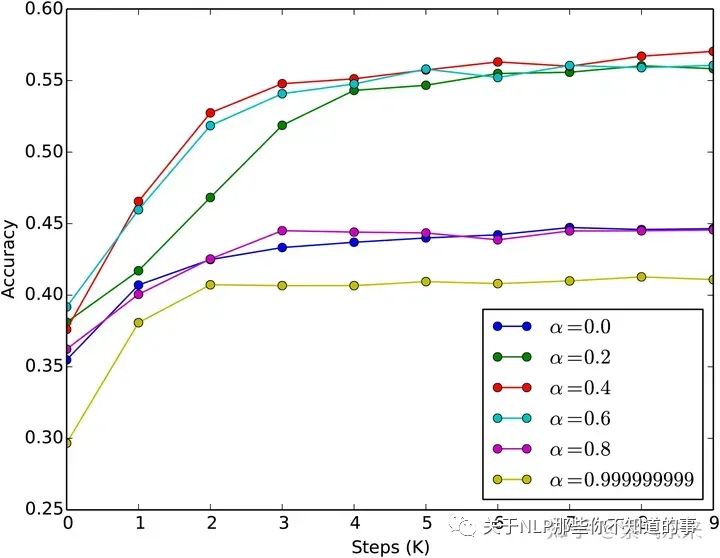
不同alpha下BERT MLM的训练准确率

需要说明的是,这种矩阵式的位置编码方式在当前的大模型中已经比较少采用了,仅有 GPT2 等早期模型中采用了这种方式。

2.1.2 Sinusoidal 位置编码
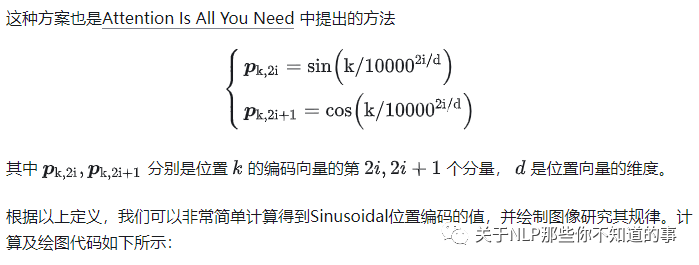
图片
在这里插入图片描述

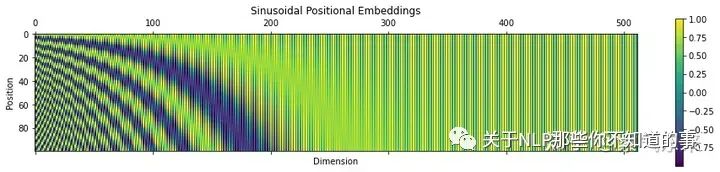
整体位置编码如下图所示:

图片

首先研究 Sinusoidal 位置编码与位置之间的关系,绘制不同位置下,函数值与 sin 维度的关系
在这里插入图片描述

其曲线如下图所示, 可以从图中得到几点结论:

  • 位置越远,频率越大
  • 随着维度增大,函数逐渐收敛到 0 (cos 函数收敛到 1 )

图片

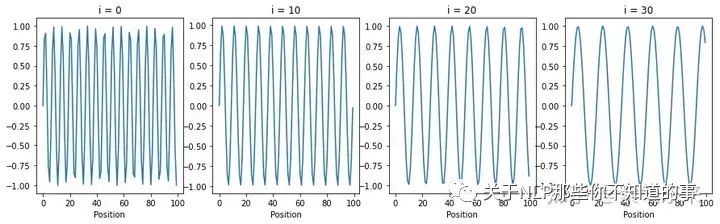
研究 Sinusoidal 位置编码与维度分量之间的关系,绘制不同维度分量 i 下,函数值与位置的的关系
在这里插入图片描述

Sinusoidal位置编码与维度分量的关系如下图所示,可以发现结论如下:

  • 每个分量都具有周期性,是正弦或余弦函数
  • 越靠后的分量(i 越大),波长越长,频率越低

图片

了解了这些基本的特性后,接下来就需要讨论更加深层次的问题:

问题一:为什么用包含各频率的正弦和余弦对?

位置编码存储的是一个包含各频率的正弦和余弦对,这样做有两个好处:

  • 可以使得不同位置的编码向量之间有一定的规律性,比如相邻位置之间的差异较小,而距离较远的位置之间的差异较大。这是由正弦和余弦函数的连续性和单调性保证的,即对于任意两个相邻的位置,它们对应的编码向量在每一个维度上都只有微小的变化,而对于任意两个距离较远的位置,它们对应的编码向量在每一个维度上都有较大的差异。
  • 可以使得编码向量在任意维度上都能保持唯一性,即不同位置在同一个维度上不会有相同的值。这是由正弦和余弦函数的周期性和相位差保证的,即对于任意两个不同的位置,它们对应的编码向量在每一个维度上都不相等。

问题二:底数对结果的影响是什么?

底数越大,位置向量能表示的序列就越长,这是大底数的好处。但是,底数大,意味着在-1到+1的范围内向量的取值越密集,造成两个位置的向量距离越近,这对后续的Self-Attention模块来说是不利的,因为它需要经历更多的训练次数才能准确地找到每个位置的信息,或者说,才能准确地区分不同的位置。长序列需要长编码。但这样又会增加计算量,特别是长编码会影响模型的训练时间。所以,那个底数并非是越大越好。

问题三:Sinusoidal 位置编码如何外推

三角函数式位置编码的特点是有显式的生成规律,因此可以期望于它有一定的外推性。另外一个使用它的理由是:由于
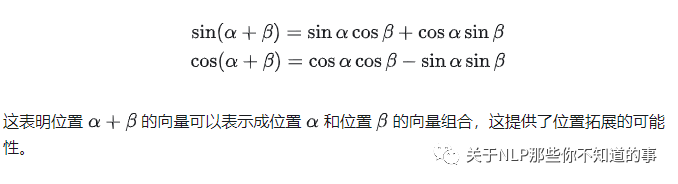
图片

2.1.3 其他的绝对位置编码

如递归式(如 FLOATER)和相乘式(如PENG Bo:中文语言模型研究:(1) 乘性位置编码),因使用较少,在此不予赘述。

2.2 相对位置编码及其外推

相对位置并没有完整建模每个输入的位置信息,而是在算Attention的时候考虑当前位置与被Attention的位置的相对距离,由于自然语言一般更依赖于相对位置,所以相对位置编码通常也有着更好的表现,灵活性也更大。

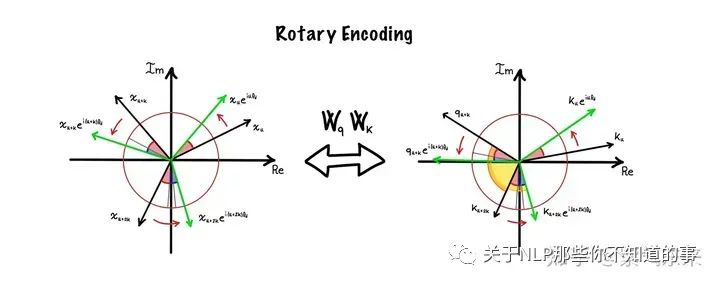
2.2.1 旋转位置编码 RoPE

实际上 RoPE 的诸多思想来源于 Sinusoidal 位置编码,区别在于 Sinusoidal 位置编码采用和 word embedding 相加的形式,RoPE 则采用了矩阵相乘的形式。

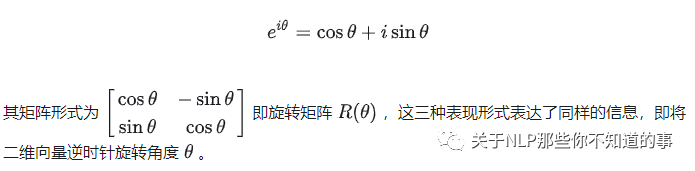
在正式介绍之前,我们需要回顾一下经典的欧拉公式
图片

图片

在这里插入图片描述

图片

在这里插入图片描述

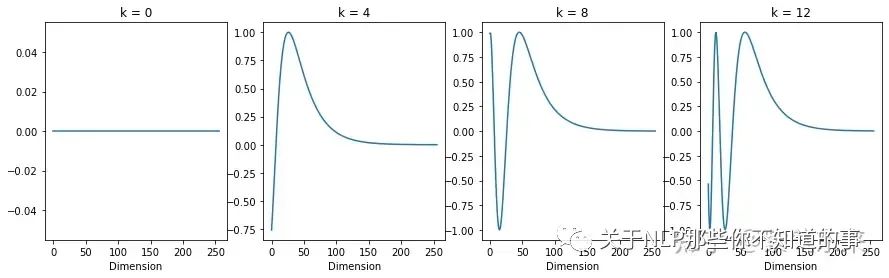
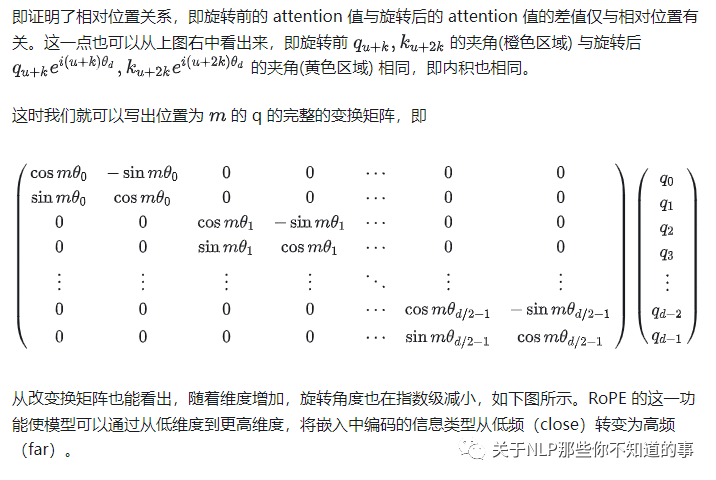
旋转角度随维度的变化

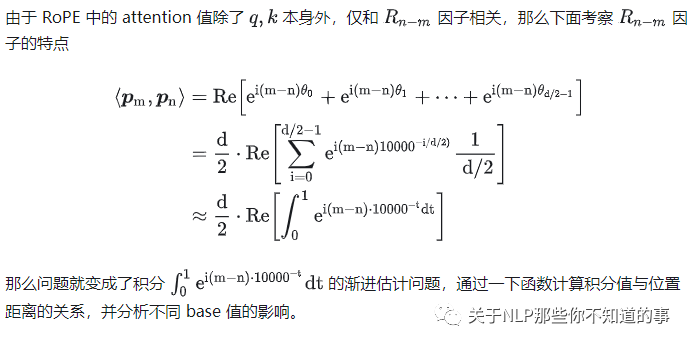
2.2.2 远程衰减问题

图片

在这里插入图片描述

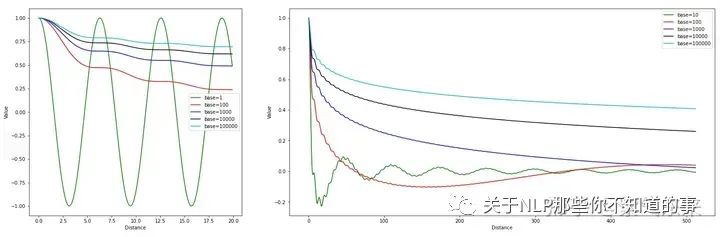
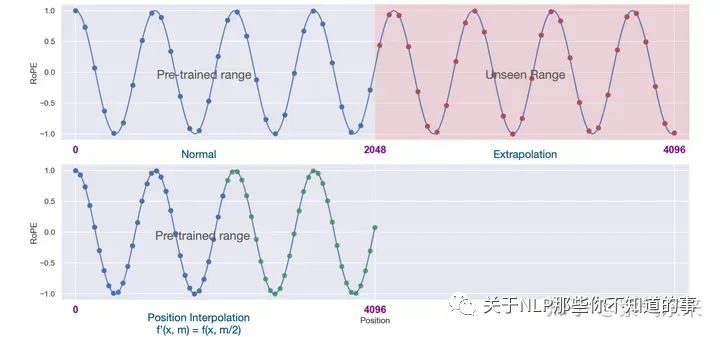
下图展示了不同距离尺度上不同 base 值的积分结果,可以得到以下结论:

  • 除了 base=1 外,均有明显的远程衰减特性
  • base 越小,衰减得越快且幅度也更大
  • base 越大,衰减得越慢且幅度也越小

图片

不同距离尺度上的积分结果

2.2.3 RoPE 长度的内插与外推

长度外推性是一个训练和预测的长度不一致的问题。提现有两点:

  • 预测的时候用到了没训练过的位置编码(不管绝对还是相对);
  • 预测的时候注意力机制所处理的token数量远超训练时的数量。

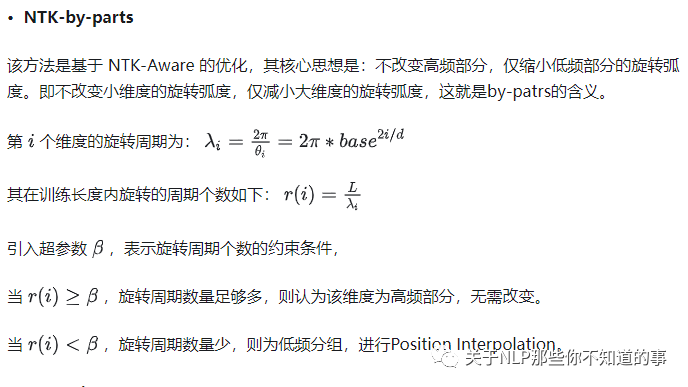
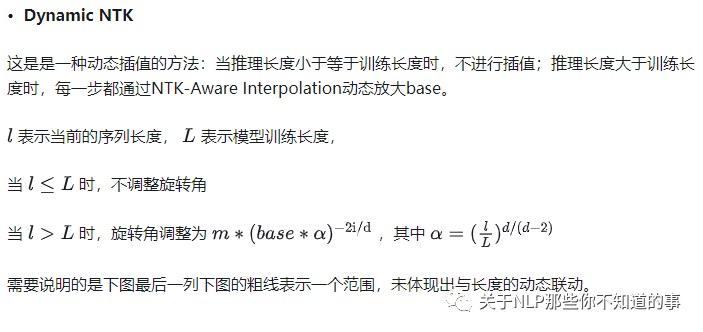
一旦我们在模型中有效地整合了相对位置信息,增加 LLM 上下文窗口的最直接方法就是通过位置插值 (position interpolation,PI) 进行微调。

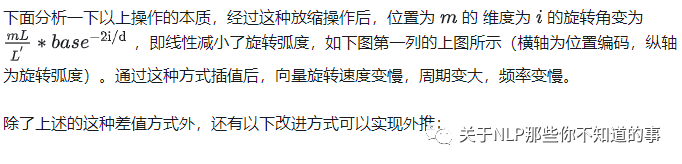
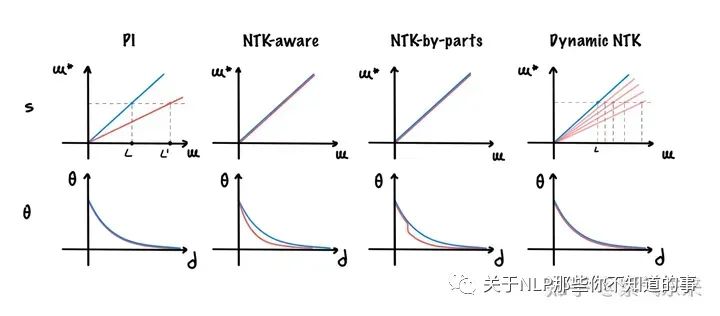
这种方法实现很简单,如果希望将预训练阶段的位置向量范围[0,2048] 外推到[0,4096],只需要将对应位置缩放到原先支持的区间([0,2048])内:计算公式如下,L为原先支持的长度(如2048), L’为需要扩展的长度(如4096):
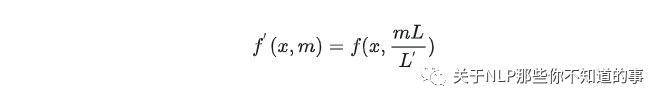
图片

其过程如下图所示:

图片

图片

图片

图片

图片

图片

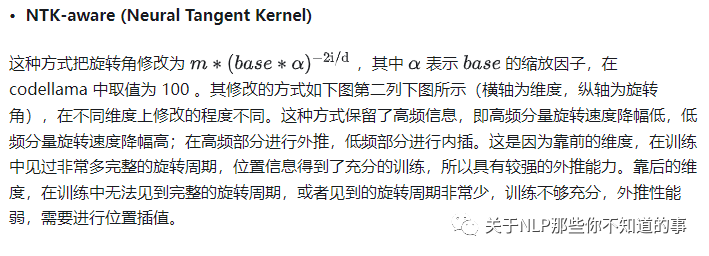
需要说明的是,论文 Scaling Laws of RoPE-based Extrapolation 中深入研究了 RoPE 位置编码的特性,其结论就是:RoPE 中 base 的放大和缩小都能获得很好的外推效果(base=10K 效果最差)。原因在于:

  • 当 base 较小时(如 500),RoPE 的三角函数周期变短,训练时就可以见过完整的 cos/sin 值域;
  • 当 base 较大时(如 1000000),RoPE 的三角函数周期变长,训练时虽然不能见过完整的 cos/sin 值域,但是外推时仍处于单调区间。

2.2.4 其他形式的编码方式及其外推

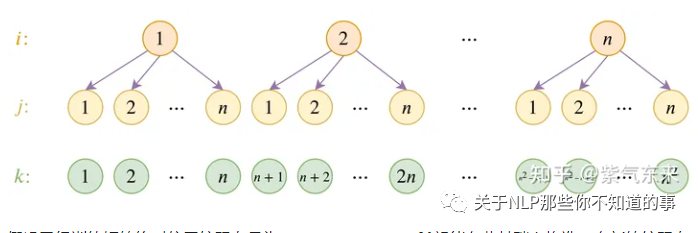
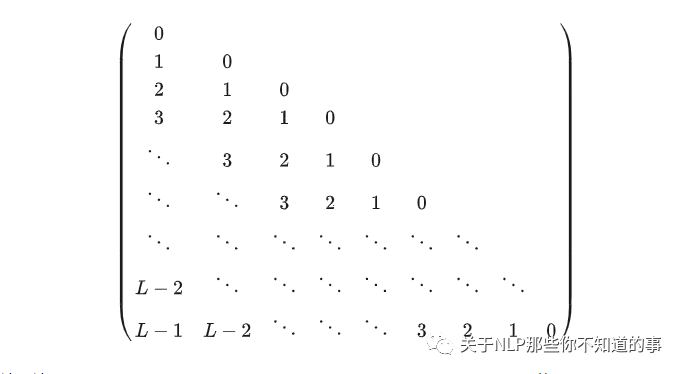
在苏神的文章Transformer升级之路:12、无限外推的ReRoPE?中指出:RoPE 形式上是一种绝对位置编码,但实际上给 Attention 带来的是相对位置信息,即如下的Toeplitz矩阵:
图片

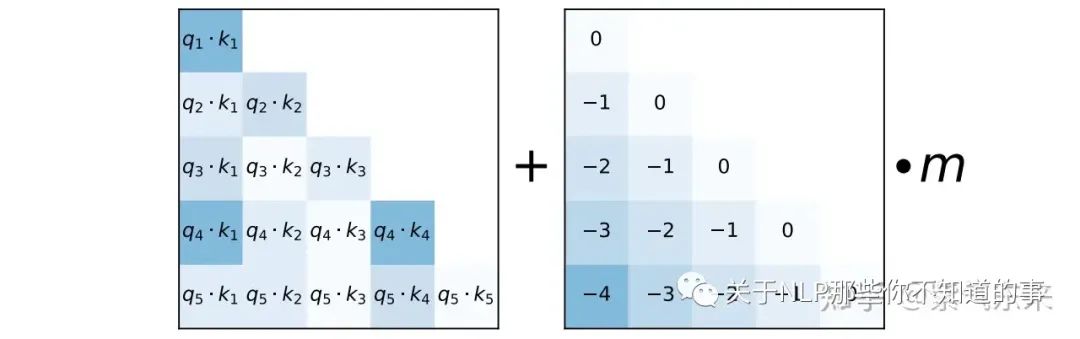
这么这种形式的 bias 似乎有种似曾相识的感觉,没错,就是 ALiBi 编码。严格来说,ALiBi 并不算位置编码,因为它并没有作用在 embedding 上,而是直接作用在了 Attention 上,通过这种构造方式既实现了远程衰减,又实现了位置的相对关系。
图片

ALiBi 的作用原理

对于外推特性,ALiBi 与前文所述的方法也是不同的,体现在:

  • 事后修改,比如NTK-RoPE、YaRN、ReRoPE等,这类方法的特点是直接修改推理模型,无需微调就能达到一定的长度外推效果,但缺点是它们都无法保持模型在训练长度内的恒等性
  • 事前修改,如ALIBI、KERPLE、XPOS以及HWFA等,它们可以不加改动地实现一定的长度外推,但相应的改动需要在训练之前就引入,因此无法不微调地用于现成模型

三、长文本与 Attention 机制

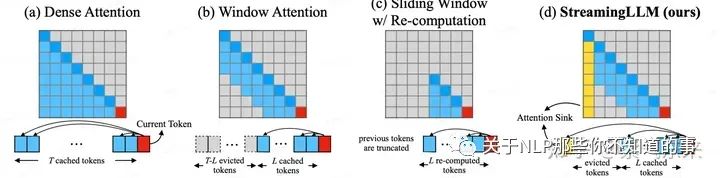
Attention 机制也是制约长文本实现的重要因素,以下是几种典型的 Attention 的 方式:
图片

关于 Attention 机制改进的更多类型和细节,笔者在之前的文章中已经有所讨论,可参考:

NLP(二十):漫谈 KV Cache 优化方法,深度理解 StreamingLLM

https://zhuanlan.zhihu.com/p/659770503

在此主要想介绍一个方案 —— LongLora 。

回顾第一节中研究的结论,长文本影响最大的就是 self-attention 中的,随长度二次变化的显存占用和计算复杂度。为解决这个问题,LongLora 的原则是,虽然在推理过程中需要密集的全局注意力,但通过稀疏的局部注意力可以有效且高效地微调模型。

LongLora 在微调期间延长上下文长度,同时使用 Lora 方法保持高性能和低复杂性。其中最关键的是提出了转移短注意力(S2-Attn)方案。下面简要介绍这一方案:

S2-Attn 在微调阶段使用局部注意力而不是全局注意力。即将输入文档分解为几个不同的组,并在每个组中分别应用注意力机制(Pattern 1)。尽管这种方式能够在资源占用不多的情况下拓展长度,由于不同组之间缺乏信息交换,随着上下文长度的增加,会导致混乱增加。

为了解决上述问题,S2-Attn 引入了组大小一半的移位操作,确保相邻组之间顺利的信息交换(Pattern 2)。这种做法有助于模型在文本开头和结尾之间顺利交换信息,从而提高模型稳定性。
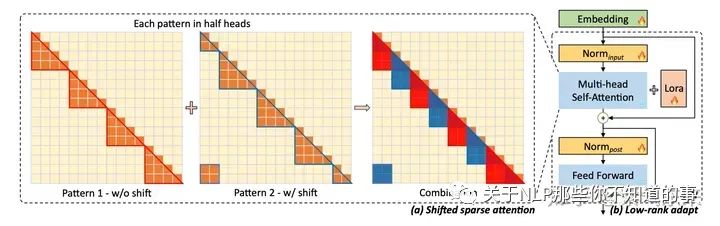
图片

LongLora 整体框架

而本文提出的 shift short attention 有一半的 head 会被做 shift,如下图所示,然后每个 group 内作 self-attention,从而使信息可以在不同 group 间传递。这种做法实际上将 Pattern 1 和 Pattern 2 结合起来,而没有引入额外的计算开销,使其非常适合高效处理长序列文本。
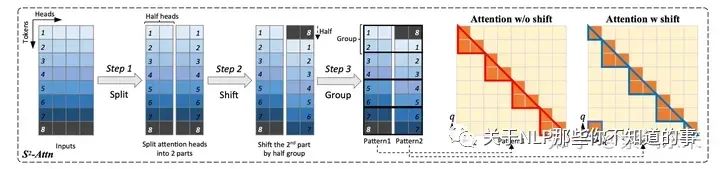
图片

shift short attention 原理

此外,LongLoRA相比于Lora还可以微调embedding层和normalization层。尽管这两项内容占的参数量很小(以Llama 2-7B为例,embedding层只占1.94%,normalization层更是不到十万分之四),对结果也起到了重要作用。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

长文本理解的未来:LongBench v2的探索与挑战 🧠在人工智能的快速发展中,长文本的理解能力成为了大型语言模型(LLMs)研究的一个重要领域。随着模型能力的提升,我们不禁要问:这些模型真的能够深刻理解和推理长文本中的信息吗?为了解答这个问题,研究者们推出了,一个旨在评估LLMs在处理长上下文问题时的能力的基准测试。本文将深入探讨LongBench v2的设计理念、任务分类、数据收集方法及其对未来研究的启示。 阅读详情

相关推荐

【NLP】3 种强大的长文本摘要方法和实例

文本摘要是一种 NLP 过程,它专注于减少给定输入的文本量,同时保留关键信息和上下文含义。考虑到手动摘要所需的时间和资源,使用 NLP 的自动摘要已经在许多不同的用例中针对许多不同的文档长度进行了增长也就不足为奇了。摘要空间发展迅速,新的重点是处理超大文本输入以总结成几行。对新闻文章和研究论文等较长文档的摘要需求的增加推动了该领域的增长。

sikh_0529的博客 5893

探索 LongWriter:突破长文本10000+字生成的语言模型

在自然语言处理领域,语言模型的发展日新月异。随着对长文本处理需求的不断增加,能够高效生成长文本的语言模型变得至关重要。LongWriter 作为一款由清华大学数据挖掘研究组(THUDM)开发的语言模型,以其出色的长文本生成能力引起了广泛关注。本文将深入探讨 LongWriter 的各个方面,包括简介、功能特点、评估测试、应用场景以及本地部署,为读者全面展示这一强大工具的魅力。

寻道AI,探索AI无限可能! 4442

UIO-LLMS:长上下文大语言模型的无偏增量优化方法

处理长文本对于大语言模型(LLMs)来说是一个挑战,因为其上下文窗口大小有限。本文提出了一种名为 UIO-LLMs 的方法,这是一种在长上下文设置下对增强记忆的 Transformer 进行无偏增量优化的方法。我们首先将该过程概念化为一个简化的编码器-解码器框架,其中权重共享的编码器和解码器分别将上下文段落封装到记忆中,并利用这些记忆预测后续段落的输出。

步子哥的博客 1566

ABAP中TEXT編輯事例

*&---------------------------------------------------------------------**&ReportZTEXTSAMPLE*&*&amp...

cj8605079733的博客 237

基于NXP BFU730F的宽带WiFi LNA设计:从原理到实测的完整指南

低噪声放大器(LNA)是无线通信接收链路中的关键器件,其性能直接决定了系统的接收灵敏度。LNA的核心原理是在放大微弱信号的同时,尽可能降低自身引入的噪声,并保持良好的线性度以应对强干扰。在宽带应用场景下,如覆盖2.4GHz至5.9GHz的现代WiFi系统,设计需在宽带匹配、噪声优化和增益平坦度之间取得精妙平衡。本文以NXP的BFU730F SiGe:C HBT晶体管为核心,深入解析一种采用电阻反馈和LC匹配网络的经典宽带LNA架构。该设计通过优化反馈网络,在宽达3.5GHz的频带内实现了优异的噪声系数(低至

weixin_33587161的博客 329

lstm如何输入多维序列_深度学习也可以做时间序列异常诊断

最近在看的一篇论文里,用到了GRU、VAE等技术来做多维时间序列异常诊断。那么今天首先来聊一聊深度学习的基础知识,然后简单说一下论文。以下基础知识部分的内容,主要来源于李宏毅老师的课程。有兴趣的可以去看李老师的课程哦https://www.bilibili.com/video/BV1JE411g7XF?p=1 1、GRU(Gate Recurrent Unit):GRU是循环神经网络(Recurr...

weixin_30899789的博客 2836

长文本分类的总结

笨妞很少做文本分类,因为工作中文本分类确实不怎么用得到,唯一一个项目用到短文本分类,验证集acc和f1都到90%以上,所以在笨妞印象中文本分类应该是很简单的分类问题,都不属于NLP问题。偶然碰到DC竞赛中“达观杯”文本分类大赛,尝试了一下新闻类文本的分类。其实并没有那么简单。   数据概况 “达观杯”的主题是19类新闻分类,数据包含4个字段:id(文章索引)、article(字级别文章)、w...

老笨妞 2万+

WordPress搭建“外贸独立站”完整操作教程

  以往的文章,我们介绍了很多种搭建独立站的方式,有最省事的Shopify 、最专业的Magento以及最省钱的Wordpress Woocommerce。其中,通过主机托管的方式又分了免费的谷歌云vps主机、1美元Godaddy主机以及SiteGround共享主机三种。建站方法方式实在太多了,有免费的,有廉价的,有商业版的,有共享主机、有云主机主机以及各种各样的vps服务器,选择哪种方式,哪款主机,也只有真正试了才直到。   没错,上述的这些方法方式,无一例外,我都亲身折腾过。从个人实际需求和建站方式来

www25qi的博客 8082

【ABAP】在ABAP开发中使用长文本组合的实现

长文本(Long Text)是指可以存储较长字符内容的文本信息,它允许用户输入多行、较长篇幅的描述或说明,通常用于提供更详细的信息,例如采购订单行项目的详细规格说明、特殊要求、合同条款、备注等。在 SAP 系统中,长文本一般存储在专门的数据库表中,如STXH(文本头)和STXL(文本行)。这些表会将长文本拆分成多个行进行存储,以处理较长的文本内容,避免单个数据库字段长度的限制。

少年休闲海 1340

加密算法:深度解析Ed25519原理

在 Solana 开发过程中,我一直对 Ed25519 加密算法 如何生成公钥、签名以及验证签名的机制感到困惑。为了弄清这一点,我查阅了大量相关资料,终于对其流程有了更清晰的理解。在此记录实现过程,方便日后查阅。

盹猫的博客 1万+

震惊!用刚发布的GPT-5写研究现状,文献综述写作一整个大逆袭(附步骤+10条AI提示词)

每类分别给出:国内重点(3 条)、国外重点(3 条)、代表性方法(2–3 条)、代表成果(各 1–2 条)、主要问题(2 条)。每个场景给出:技术方案(2–3 种)、研究目标、实际成效/案例、当前挑战(3 点)。指令:基于国内外现状,系统列出当前学界的研究空白、关键未解问题与争议焦点(每项配简要证据/示例),并针对每个空白提出 1–2 条可行的研究方向或方法路径。三、差异与研究空白分析(≥300 字)。对每个小节提供:小标题、中心论点(1 句)、拟写要点(3–5 条)、建议引用类型(理论/方法/案例)。

qq_64378896的博客 117

GraphReader: 将长文本结构化为图,并让 agent 自主探索,结合大模型长文本处理增强方法

这个"金手指"的核心优势在于它能够将离散的文本信息组织成结构化的关系网络,让模型能够"看到"信息之间的连接,从而突破上下文窗口的限制。这就像一个由多位专科医生组成的会诊团队,每位成员都发挥其专业优势,通过充分讨论和验证最终达成共识,这比单一医生的判断要可靠得多。GraphReader是一个结合图结构和智能体的长文本处理系统,它将长文本组织成图的形式,通过智能规划和探索来回答复杂问题。因此,在处理复杂的医疗诊断问题时,多智能体系统不是可有可无的,而是提高诊断准确性和可靠性的必要手段。

Debroon 2730

如何设置Xilinx以太网IP核的Pause帧处理

这里要注意,为什么是或,第一个条件是该功能使能取反,也就是说,如果你设置使能不打开的话,这个条件是直接满足的;先来看图中第二句,判断该以太网数据包为Global Pause帧(gpp),首先要满足Step1,然后是由上图中第二句代码(assign global_pause_packet)后面的所有项“与”(&&)起来的,就是说要满足后面所有的项,分别是DA符合,SA符合,Etype符合,Opcode符合,并且使能了该功能(即设置ctl_rx_enable_gpp=1)。如果没通过,则进入Step3。

qq_43416206的博客 620

前沿重器[34] | Prompt设计——LLMs落地的版本答案

前沿重器栏目主要给大家分享各种大厂、顶会的论文和分享,从中抽取关键精华的部分和大家分享,和大家一起把握前沿技术。具体介绍:仓颉专项:飞机大炮我都会,利器心法我还有。(算起来,专项启动已经是20年的事了!)2022年的文章合集,累积起来有60w字,在这:CS的陋室60w字原创算法经验分享-2022版。往期回顾前沿重器[29] | ERNIE-Search:向交互式学习的表征式语义匹配代表作前沿重器[...

baidu_25854831的博客 846

GEE生物量碳储量——利用sens和MK检验方法计算1987-2022年森林地上生物量AGB和碳储量的时空变化特征

本文是将之前已经处理好的森林生物量和碳储量数据保存到GEE Assets中,然后分别将单张影像导入到代码编辑器中,构建一个时间序列集合,并且这里需要用到的是我们给影像添加指定的时间属性,这样方便进行下一步的时序分析和空间预测。首先,需要收集1987年至2022年期间森林地上生物量AGB和碳储量数据。该数据可以通过森林清查数据、卫星遥感数据等途径获取。然后,根据这些数据,可以使用sens(敏感性分析)和MK(Mann-Kendall)方法计算时空变化特征。

此星光明博客 1265

X书x-mini-sig_x-mini-mua

X书的tiny风控代码,成功运行x-mini-sig|x-mini-mua

Codeooo 博客 1万+

破解提升 LLMs 性能的黑匣子—— LlamaIndex

不止如此,LlamaIndex 还可以根据手头的任务构建许多类型的索引,例如向量索引、树索引、列表索引或关键字索引。列表索引为用户提供了一种根据输入顺序进行查询的方法,即使超出了 LLM 的 token 限制,LlamaIndex 也会提供一种接口,能够自动使用输入数据的所有内容。对于 Jerry Liu 的这个比喻,熟悉 LLMs 的开发者会觉得颇为贴切,尤其是对于那些想要用私有数据要训练自己大模型的开发者而言,LlamaIndex 绝对是提升大模型性能,让其更加易用、流畅的不二选择。

ZILLIZ 1427

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

Selective Context:上下文压缩神器,突破 LLM 长文本处理瓶颈

Selective Context 完成压缩的核心技术在于自信息测量。在信息论中,自信息衡量与一个事件相关的惊讶或不确定性水平;罕见事件传递更多信息,因此具有更高的自信息,而常见事件传递较少信息,自信息较低。在语言建模中,自信息可以用来评估词汇单元(如单词、短语或句子)的信息量。自信息较低的词汇单元信息量较少,更可能从上下文中推断出来,因此在 LLM 推理过程中,这些输入部分可以被视为冗余。

具身机器人和通用AI 1191

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

大模型算法工程师面试宝典:精选面试题及参考答案全解析,助你备战AI算法工程师岗位!

本文探讨了大模型技术的现状、挑战与应用。首先分析了LLMs复读机问题的成因(如数据偏差、训练目标限制等)及缓解策略(多样化数据、温度参数调整等),对比了Bert、LLaMA和ChatGLM的适用场景。针对专业领域需求,建议开发专用大模型以处理特定知识和语言风格,并提供了处理长文本的技术方案(分块处理、层次建模等)。最后介绍了大模型学习路径,从基础应用到商业部署分为四个阶段,包含提示工程、RAG系统开发等核心技能,助力从业者把握AI发展机遇。

2401_84494441的博客 805

LLMs 进阶:什么是生成式大模型?生成问题?

参数量级不同:LLMs 参数量普遍在 Billion(十亿)级别,远超传统模型,能捕捉更复杂的语言模式和知识;生成式能力:支持通过 prompt(提示词)或上下文引导,主动生成全新内容,而非简单分类或回归,这也是 “提示词工程(Prompt Engineering)” 的核心基础。简单说,传统模型是 “判断型选手”,LLMs 是 “创作型选手”~「字符 / 词级重复」:单个字或词反复出现(如 “插座 插座 插座…”);「语句级重复」:同一句话循环(如 “这是一个杯子,这是一个杯子…”);

ppbk_的博客 537

streamingLLM: Efficient Streaming Language Models with Attention Sinks——高效的流式语言模型与注意力池

streamingLLM: Efficient Streaming Language Models with Attention Sinks——高效的流式语言模型与注意力池

Together_CZ的博客 1706

LLM基础的若干问题

Transformer 模型一开始是用来做 seq2seq 任务的,所以它包含 Encoder 和 Decoder 两个部分;他们两者的区别主要是,Encoder 在抽取序列中某一个词的特征时能够看到整个序列中所有的信息,即上文和下文同时看到;而 Decoder 中因为有 mask 机制的存在,使得它在编码某一个词的特征时只能看到自身和它之前的文本信息。以BERT为代表的encoder-only以T5和BART为代表的encoder-decoder以GPT为代表的decoder-only,

SQingL的博客 905

让LLM模型输入token无限长

增加LLM的输入token已经有很多的研究,但是思路无外乎:模型抽取局部特征通过上层通过模型融合预测最终解,以及这个思路的一些变种。然而这些思路其实都没能很彻底的解决无限长token问题,根据《EFFICIENT STREAMING LANGUAGE MODELS WITH ATTENTION SINKS》这篇工作的研究原因在于:注意力陷阱。也就是说影响输入token长度的应该有两个原因:1.如何让模型学会抽取局部特征2.如何解决注意力陷阱那么什么是“注意力陷阱”呢?为什么“注意力陷阱”会影响输入长度。所谓

liangwqi的博客 2105

超详细的总结!大模型算法岗面试题(含答案)来了!

大模型LLM(Large Language Models)通常采用基于Transformer的架构。Transformer模型由多个编码器或解码器层组成,每个层包含多头自注意力机制和前馈神经网络。这些层可以并行处理输入序列中的所有位置,捕获长距离依赖关系。大模型通常具有数十亿甚至数千亿个参数,可以处理大量的文本数据,并在各种NLP任务中表现出色。

程序员鑫港的博客 986

苹果AI大突破:揭秘RL4HS系统攻克大型语言模型幻觉难题

RL4HS系统是苹果公司与台湾大学合作开发的强化学习技术,有效解决了大型语言模型中的幻觉难题。本文深入解析了RL4HS系统的原理、应用场景以及未来发展趋势。随着技术的不断发展,RL4HS系统有望在更多领域发挥重要作用,为人工智能技术的发展贡献力量。# 苹果AI大突破:揭秘RL4HS系统攻克大型语言模型幻觉难题RL4HS系统是苹果公司与台湾大学合作开发的强化学习技术,有效解决了大型语言模型中的幻觉难题。本文深入解析了RL4HS系统的原理、应用场景以及未来发展趋势。

wwlsm_zql的博客 698

MoBA: MIXTURE OF BLOCK ATTENTION FORLONG-CONTEXT LLMS——面向长文本上下文的混合块注意力技术报告

MoBA: MIXTURE OF BLOCK ATTENTION FORLONG-CONTEXT LLMS——面向长文本上下文的混合块注意力技术报告

Together_CZ的博客 2283
上一篇: 终于看懂大模型评估LLM evals, 5 个策略让GPT更听话 | 附标题提示词prompt
下一篇: 号称第一本程序员的Agent入门书籍?《大模型应用开发 动手做AI Agent》来了!
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值