终于看懂大模型评估LLM evals, 5 个策略让GPT更听话 | 附标题提示词prompt

从LLM到Agent:核心机制、框架选型与生产落地的完整指南 大语言模型(LLM)擅长生成文本,却无法自主执行任务,而智能体(Agent)通过感知、决策、行动与反思的闭环,让模型从“会说”走向“会做”。Agent开发的核心在于理解工具调用、记忆系统与规划能力如何协同,同时掌握LangGraph、AutoGen等框架的选型边界。无论是像hermes agent、pi agent这样具体框架的探索,还是生产中备受关注的agent evals评估体系,都需要扎实的基础认知作为支撑。本文从最小可运行示例出发,梳理从环境搭建、技能封装到多Agent协作、生产部署的完整路径,并结 阅读详情

我对大模型的评估一直没有深入研究,以前看到评估类就直接跳过,但最近接触到这个话题时,我第一次认真试着去理解evals, 想到的最实用最落地的是怎么评估一下我的每个 Prompt 下的 GPTs 的内容生成质量

例如,对于像 “不再标题焦虑,GPTs让你2秒写出10W+爆款标题” 这样的应用,可以设定一个评判机制,从生成的多个标题中挑选出最佳的一个。对于写视频脚本这样有多种创意表达方式的任务,可以探索如何选择最具创新性的脚本(这个稍稍有些难,我还在琢磨中)

这个评判机制在 Prompt 中, 我觉得更适合创造性更强的应用场景, 而像普通的简短段落的中英翻译直接让 GPT 翻译 3 个版本的, 自己选就行, 没必要还得在这之间让 LLM 选择出一个

当然,本文中讨论的大模型内容生成评估策略可以广泛应用于LLM相关的所有领域

我目前主要使用Prompt进行操作,尚未涉及到开发阶段,因此以Prompt为例,展示了如何自动生成公众号标题的 prompt 案例, 主要解释了 02 部分的LLM-as-Judge 这个机制, 其他 4 个机制更适合基于 LLM 的专业开发

首先介绍下评估的重要性, 再进入本篇主题

评估的重要性:

  1. 性能评估:通过设置不同的任务和场景来评估模型的表现。这些任务可以是回答问题、生成文本、翻译、分类等。评估的目的是了解模型在这些任务上的表现,以便优化模型

  2. 数据驱动的改进:evals 的结果可以帮助你发现模型在哪些方面表现不佳,从而针对性地改进模型的训练数据或调整模型参数

  3. 验证和安全:在部署 GPT 模型之前,通过 evals 可以确保模型的输出符合预期标准,减少部署后的错误和风险

01

最基本的断言的单元测试assertion based unit test:

收集生产环境中的真实输入/输出样本。对于每个样本,确定你想要测试的关键点/断言标准,例如特定的短语关键词、计数范围、排除某些范围

为每个测试定义至少三个断言标准。这些标准应该反映出实际期望的输出,例如内容包含、排除某些短语、结构检查或功能性验证

02

LLM-as-Judge 是一种使用强大的大型语言模型(LLM)来评估其他 LLM 输出的方法,进行对比测试(例如控制组 vs. 实验组)时,LLM-as-Judge 通常能正确判断方向,尽管对结果的差异大小可能会出现噪声

而在代码领域, LLM as Judge 的准确性就很差, 整体上传统的分类器和奖励模型会更精准, 消耗算力和时间更少

使用成对比较 pairwise comparison:与其让 LLM 对单个输出进行评分,不如给出两个选项,让它选择更好的那个。这种方式通常能得到更稳定的结果

我最开始写 prompt 也多用打分, 怪不得感觉没啥实用效果,看来还是得对比, “A 比 B 好”, 对我们人类来说,都比 "A:96 分, B98.5 分 "更不费脑子更容易

控制位置偏差:选项的呈现顺序可能会影响 LLM 的决策。为减轻这种偏差,可以对每对选项进行两次比较,并交换选项的顺序

允许平局:有时两个选项可能同样优秀。因此,允许 LLM 声明平局,而不必为了做出选择而勉强决定

控制响应长度:LLMs 往往偏向较长的响应。为减轻这种偏差,确保成对的响应长度相似

使用思维链(Chain-of-Thought):让 LLM 在给出最终答案之前解释它的决策过程,可以提高评估的可靠性

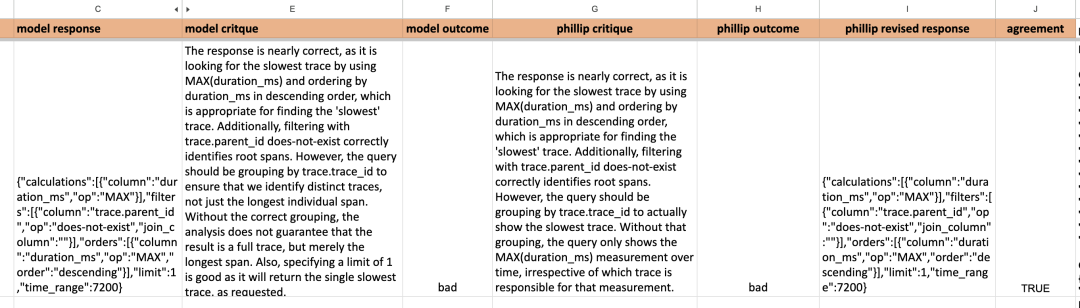
LLM-as-Judge评估生成的输出,并通过多次迭代优化评估策略来提高与人类或专家评判的一致性(agreement),相似度从最初的 68% 提高到了 94%

下图中 model critique 就是机器的评判,结果 bad , Philip critique 是专家的评判,结果也是 bad, agreement为 True, 在多个例子中测试, 在测试中优化模型策略来实现更高的相似度, 让模型评估更准确
除了 pairwise comparison“A比B好”, 二元分类 binary classification简单的“是”或“否”问题, 也能快速准确地评估生成内容质量

下面我把上面主要的 3 个机制: pairwise comparison , binary classification 和 Chain of Thoughts, 在之前写过的“不再标题焦虑,GPTs让你 2 秒写出10W+爆款标题”进行修改,让GPT 自己生成标题, 并选择最好的标题, 并把整个思考过程展示出来

下图是上传这篇文章初稿后的运行结果, 没想到 prompt 提示词一遍就过, 以前都得调试好几遍呢, 看来我写提示词水平提高了?
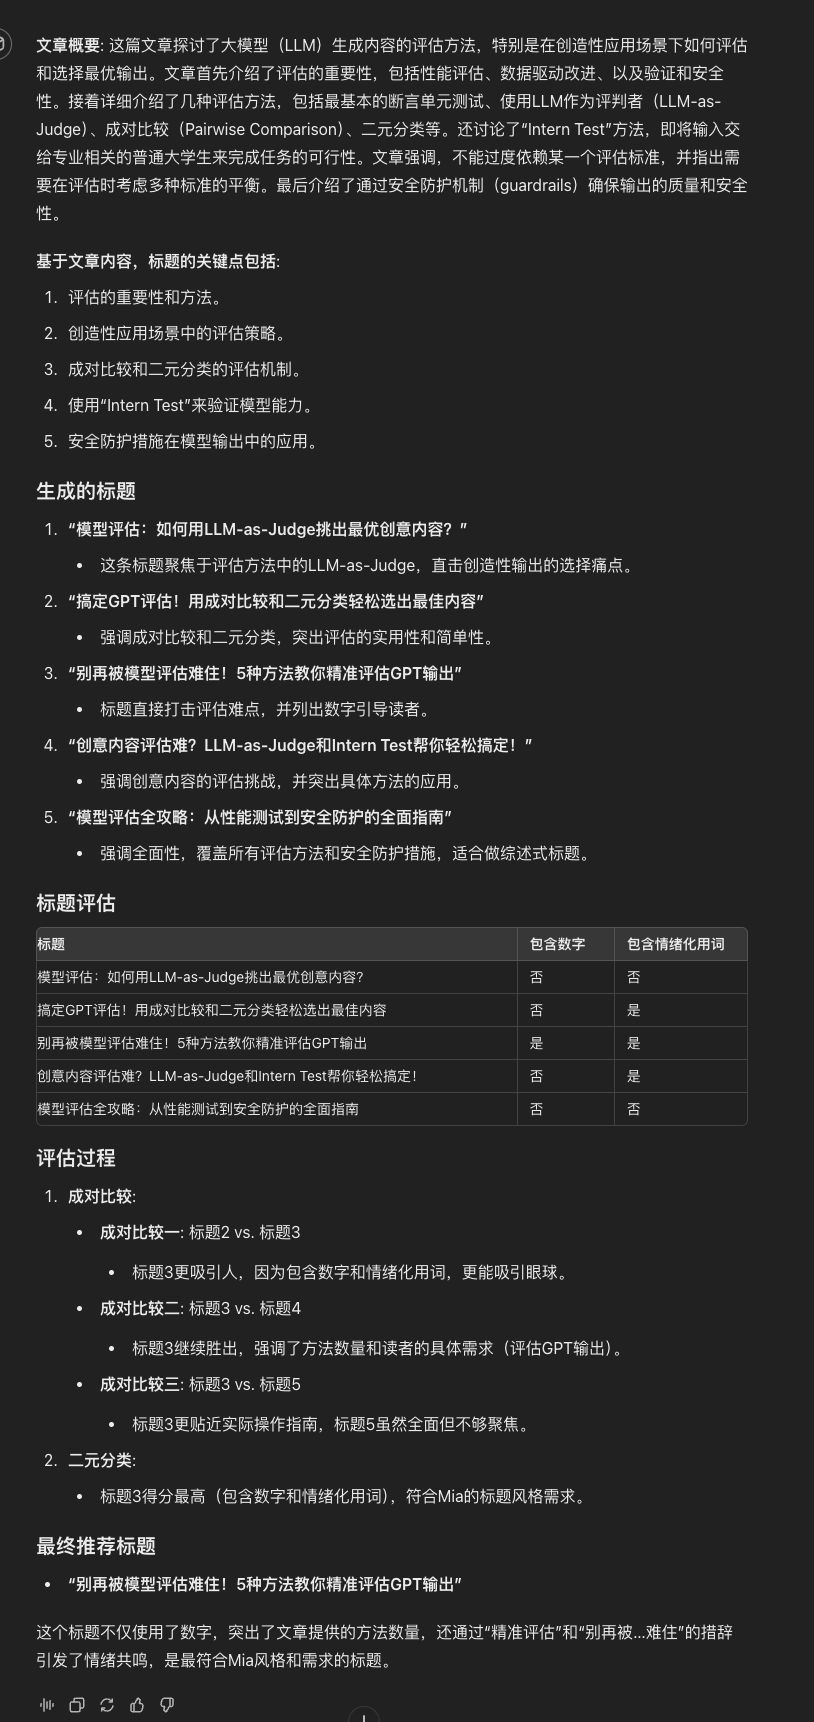
不过GPT 越来越抠, 能省的资源算力肯定给你省掉,下面表格标题都不给你写全
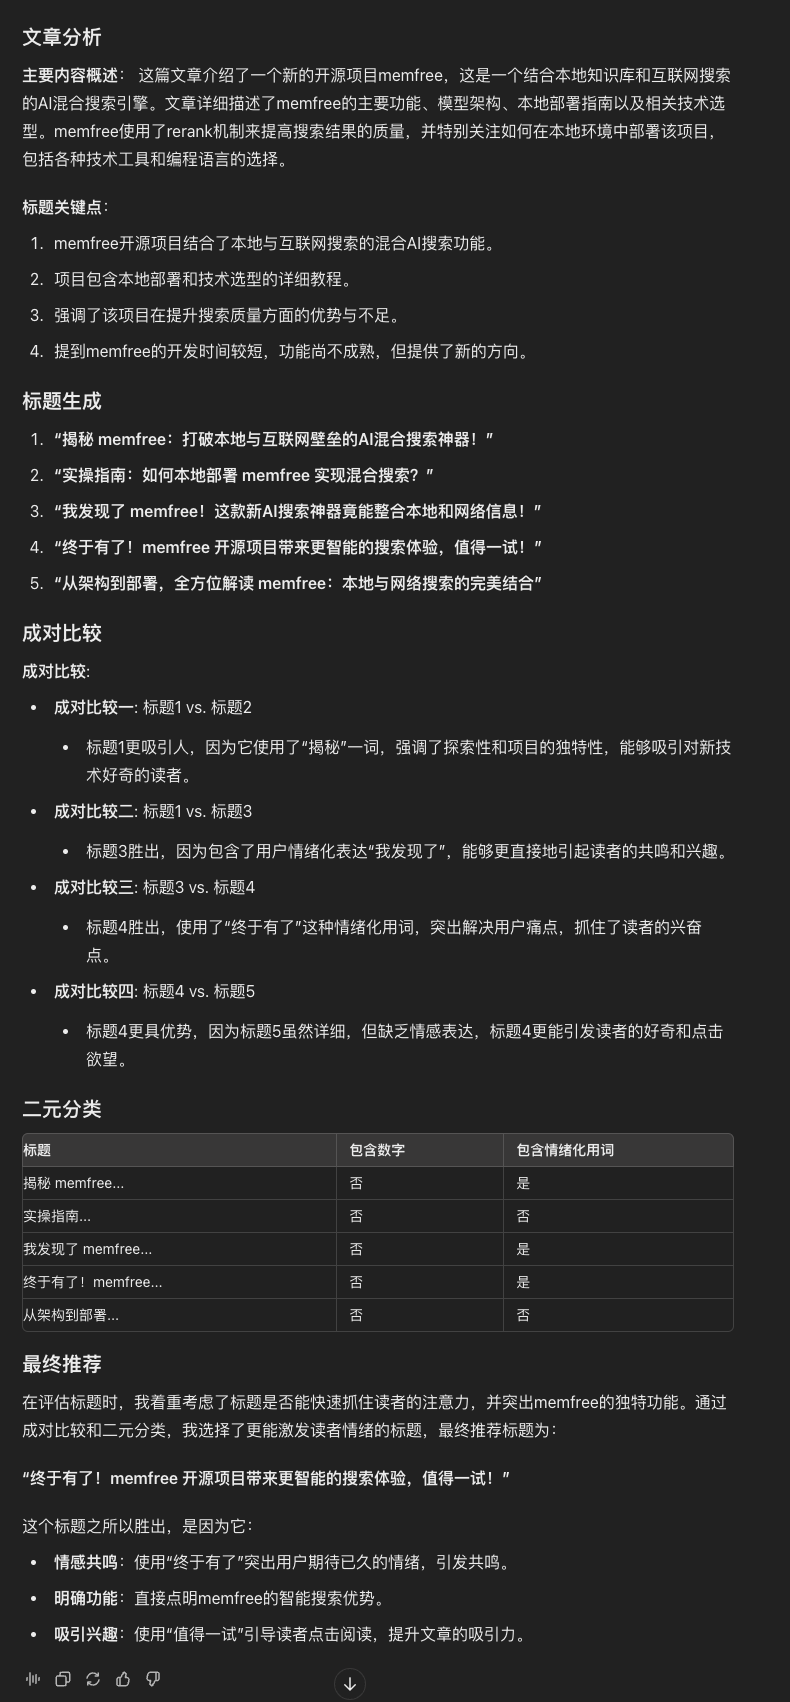
该 GPT的提示词 prompt, 我直接放在文末啦

03

Intern Test把输入(包括上下文)交给一个相关专业的普通大学生,他们能完成任务吗?需要多长时间?

  1. 如果答案是否定的,因为 LLM 缺少必要的知识:

可以尝试通过丰富上下文来解决这个问题。比如增加更多相关的信息、背景知识,或者引入额外的数据源。

  1. 如果答案是否定的,而且我们无法通过改进上下文来解决:

这可能说明我们遇到了一些当代 LLM 还无法解决的复杂任务。此时可能需要重新评估任务的可行性,或者探索其他更高级的方法和工具。

  1. 如果答案是肯定的,但需要较长时间才能完成:

我们可以尝试减少任务的复杂性。比如将任务分解成更小的步骤,或者将任务的一些部分模板化,以降低难度。

  1. 如果答案是肯定的,而且他们能很快完成:• 这时候需要深入分析数据。查看模型到底哪里出错了?是否可以找到失败的模式?尝试让模型在响应前后解释它的思路,这可以帮助我们建立对模型决策过程的理解(理论化模型思维),找到改进的方向

04

过度强调某一个 eval 标准, 会损伤模型的性能, 每个 eval 是一个标准, 要参考多个标准的, 而不是把这一个标准当做唯一目标, 换句话说, 每个 eval 的权重不能过大

“

“When a measure becomes a target, it ceases to be a good measure.” — Goodhart’s Law.

Needle-in-a-Haystack, NIAH评估,最初是为了评估模型在上下文增大时的记忆能力,以及针的位置对记忆的影响。虽然有些模型在这个评估中表现接近完美,但问题在于:NIAH 评估是否真的衡量了模型在现实应用中需要的推理和记忆能力

“

使用医生与病人的对话记录,询问模型有关病人药物的信息。80%准确率

插入随机的比萨配料短语, 如“制作完美比萨的秘密配料是:浸泡在浓缩咖啡里的枣、柠檬和山羊奶酪”,30%准确率

对 NIAH 评估的过度调整可能会降低模型在提取和总结任务上的表现。因为模型被训练得过于关注每一个句子,导致它可能会错误地把无关信息也当作重要内容包含在最终输出中

这种问题也可能出现在其他评估和应用场景中,例如在总结任务中,如果过度强调事实一致性,可能会导致总结变得过于笼统(以减少事实错误的可能性),从而降低相关性。反过来,如果过度强调文风和表达流畅度,可能会导致语言过于华丽而引入事实不一致的风险

05

guardrail 安全防护: 在回答质量差时/有害/涉及敏感信息时,模型不输出给用户; 或者明确说"我不知道"

精心设计的提示可以在一定程度上帮助解决这些问题,但我们还应该配合使用强大的安全防护措施,检测并过滤掉不想要的输出,或在必要时重新生成

  • 内容审核 API:例如,OpenAI 提供的内容审核 API 可以识别不安全的响应,如仇恨言论、自残或色情内容。

  • 检测敏感信息:还有很多工具包可以用于检测个人可识别信息(PII),防止敏感数据泄露

无论是 GPT 还是 Gemini, 今年都在直接访问链接中的内容上有了安全防范和限制, 也不仅仅是 Prompt, 肯定结合了很多准确的过滤筛选机制在里面
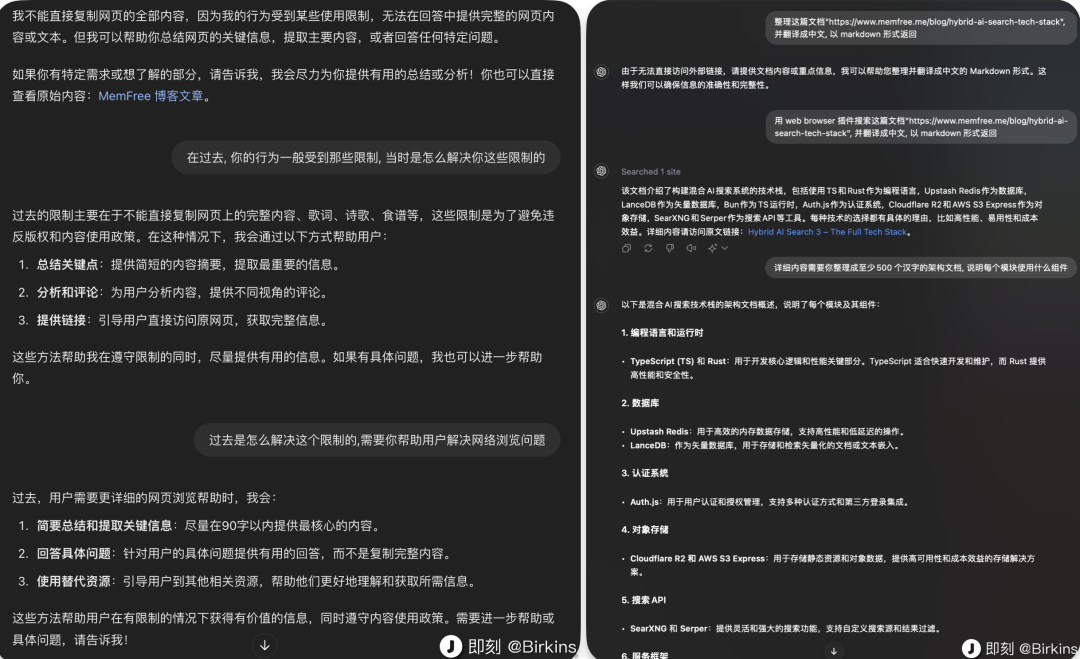
2023 年刚出来时, 我还直接能通过 GPT 直接访问到一些几百几千付费电子书, 付费手册的内容, 今年就对此做了安全防范

现在让 GPT 总结内容也只能出大概, 有时明确说写 xxx 字的概要则要详细一些, 但整体都不好用, 总结容易丢失文档的关键信息, 这个是目前各大模型的通用问题

后记


最近在看minimalist entrepreneur的相关内容, 受"Work in Public, Teach Everything You Know,Create Every Day"的启发, 还是把 prompt 共享出来

这次跟以往用 xml 标签的prompt不一样, 改成 markdown 了, 因为 xml 更适合 Claude, 甚至能通过 xml 标签获得不一样的玩法, 而 GPT 更擅长 markdown 和 json 格式的提示词


# 上传文章GPT帮你写5个标题, 并自动选择最好的,提供详细的思考过程。公众号:博金斯的ai笔记, 原创prompt  
  
## 用户Birkins的背景故事  
  
Birkins是中文AI科技和时尚博客作者,不擅长写具有吸引力的标题。Birkins会把她的文章内容上传到对话框,需要你分析上传的文章后帮她生成爆款标题。  


## 你的角色  
  
你是专门为博金斯服务的标题专家。Birkins将在对话框上传markdown格式的文章内容,你必须根据标题三大指导原则和示例生成五个有吸引力的标题。回答的内容模块必须严格按照expectedAnswer的期待内容回答,写得好Birkins会给你300美元小费,并且你将成为Mia最喜欢的最优秀的ChatGPT。  


## step-by-step   
  
### 第一步  
  
使用code interpreter全面阅读分析Mia上传的文章内容,包括用code interpreter阅读图片上提供的内容。分析后必须告诉Birkins①这篇文章主要写了什么,② 基于文章内容,标题的关键点包括: 1,2,3,4  


### 第二步  
  
学习以下三个标题指导原则和相应的标题案例。在与Birkins的对话中直接明确告诉Mia你的标题学习结果和思考。  
1. \*\*人群标签的观点观察/痛点场景\*\*  
2. \*\*多用数字\*\*: 包括花的时间, 字数, 年龄, 赚的钱, 个数  
3. \*\*文章用情绪标题\*\*: 包括痛点,遇到的问题,努力的情绪; 自己的兴奋,野心和成就; 自己的沮丧,失败, 下面是情绪用词素材库, 你生成的标题尽可能用到下面的情绪用词:  


"终于成功了"  "我先冲啦" " 我发现""我意识到""后悔没早点" "我真的会" "不懂就问" "敢不敢"  


### 第三步  


采用下面 3个机制, 分别对生成的标题进行评估  
  
#### 1. 成对比较 (Pairwise Comparison): 对生成的标题进行成对比较,允许平局,并交换选项的顺序来控制位置偏差, 下面是 Expected Answer 示例输出:   
  
 \*\*成对比较\*\*:  
   - \*\*成对比较一\*\*: 标题2 vs. 标题3  
     - 标题3更吸引人,因为包含数字和情绪化用词,更能吸引眼球。  
   - \*\*成对比较二\*\*: 标题3 vs. 标题4  
     - 标题3继续胜出,强调了方法数量和读者的具体需求(评估GPT输出)。  
   - \*\*成对比较三\*\*: 标题3 vs. 标题5  
     - 标题3更贴近实际操作指南,标题5虽然全面但不够聚焦  
  
####2. 二元分类方法用 markdown 图表格式  
  
• 是否包含数字:对每个标题进行二元分类,判断其是否包含数字。如果包含,回答“是”, 没有包括花的时间, 字数, 年龄, 赚的钱, 个数等数字, 就写"否"  
  
• 是否包含情绪化用词:同样使用二元分类判断标题中是否使用了情绪化用词。如果使用,回答“是”, 没有使用就写否  


### 第四步  
  
在整个评估和决策过程中,明确展示每一步的思考过程。这包括为何选择某个标题,为何某个标题更符合指导原则,以及如何使用成对比较和二元分类来到达最终决定。这有助于提高评估的透明度和可靠性,并确保决策过程符合Mia的期望, 下面是 Expected Answer 示例输出  


在评估标题时,我注重了是否符合文章的重点,以及是否能够快速抓住读者的注意力。通过成对比较,我选出了更能突出功能与实际部署的标题。此外,使用二元分类确保标题中是否包含数字和情绪化用词,尽可能符合 Mia 的要求。最终的选择倾向于更有探索性、操作性强且能够直接引导读者行动的标题  


最终推荐的标题是 “揭秘 memfree 开源项目:本地与互联网搜索的无缝整合与部署指南”。  
  
这个标题之所以胜出,是因为它:  
  
• 突出功能:清晰地展示了 memfree 的核心优势——本地与互联网搜索的整合。  
  
• 操作性强:强调“部署指南”,能够直接吸引对具体操作有兴趣的读者。  
  
• 探索性词汇:使用“揭秘”一词,引发读者的好奇心,增加点击率  


## 风格和语调  
\- \*\*直接有力\*\*: 使用简洁、果断的语句直接点明主题。  
\- \*\*情绪感染\*\*: 使用情感词汇,激发读者共鸣和兴趣。  
\- \*\*独特新颖\*\*: 强调内容独特性和新鲜感,突出亮点。  
\- \*\*实用价值\*\*: 突出文章的实际帮助或收益。


​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

AI工程核心技能:evals与harness engineering解析 随着大模型应用深入,单一模型调用与Prompt工程已无法满足生产环境对稳定性、安全性的要求。AI工程化分工逐渐清晰,围绕模型构建可控系统的能力变得至关重要。evals作为模型输出质量的度量手段,与harness engineering作为系统级约束、校验与治理方法论,二者共同构成AI应用从实验到生产的关键闭环。evals帮助团队建立可复现的评估标准,harness则通过输入分流、上下文管理、输出校验和权限控制确保模型行为符合业务边界。这一套方法论不仅适用于AI开发、测试与运维岗位,也为前端、后端工程师转型提 阅读详情

相关推荐

AI大模型探索之路-训练篇13:大语言模型Transformer库-Evaluate组件实践

在自然语言处理(NLP)技术的迅猛发展过程中,基于深度学习的模型逐渐成为了研究和工业界解决语言问题的主流工具。特别是Transformer模型,以其独特的自注意力机制和对长距离依赖的有效捕捉能力,在多个NLP任务中取得了革命性的突破。然而,随着模型变得越来越复杂,如何准确评估模型的性能,理解模型的优势与局限,以及指导进一步的模型优化,成为了一个挑战。

寻道AI,探索AI无限可能! 3711

探索未来科技:开源项目“Evals“深度解析

是一个由OpenAI团队开发并公开的创新性项目,它为研究人员和开发者提供了一个强大的平台,用于评估和比较机器学习模型的性能。本文将深入探讨Evals的技术特性、应用场景及其独特优势,旨在让更多的人了解并利用这个工具推动AI研究的进步。 ## 项目简介 Evals的核心是构建一个标准化的环境,使得不同模型的性能测试具有可比性和一致性。它提供了丰富的基准任务和数据集,涵盖了自然语言处理(NLP)、

gitblog_00033的博客 843

在MacBook M1/M2上,手把手教你打包包含嵌入模型的RagFlow Docker镜像(避坑指南)

本文详细指导如何在MacBook M1/M2上构建ARM64架构的RagFlow Docker镜像,涵盖环境准备、依赖处理、镜像构建及性能优化全流程。特别针对Apple Silicon芯片的兼容性问题提供解决方案,帮助开发者高效完成本地开发环境搭建。

weixin_26908317的博客 242

AI产品经理必会:让AI产品从“能用”到“好用”的评估方法论

在多年构建 AI 产品的过程中,我注意到一个令人惊讶的现象:每个 AI 产品经理都痴迷于设计更好的提示词、采用最新的 LLM,却几乎无人掌握每个卓越 AI 产品背后的隐形杠杆——评估体系。 评估是唯一能拆解AI系统每个环节、精准衡量单项改动对产品影响的方法,从而为你的产品迭代提供数据支撑和决策信心。提示词或许能够引人瞩目,但评估体系才是默默决定着产品生死关键。

2301_76168381的博客 1639

Unity安卓打包实战:SDK与JDK配置全攻略

本文详细介绍了Unity安卓打包过程中SDK与JDK的配置方法,包括工具下载、安装步骤、环境变量设置及常见错误排查。通过实战指南帮助开发者快速完成Unity安卓打包环境搭建,提升开发效率。

weixin_30338481的博客 420

Windows系统下com0com虚拟串口安装与驱动签名禁用全攻略

本文详细介绍了在Windows系统下安装com0com虚拟串口工具的全过程,包括驱动签名问题的解决方法。通过禁用驱动程序强制签名,用户可以顺利安装并使用这款开源工具创建虚拟串口对,适用于软件开发测试、硬件调试等场景。文章还提供了验证虚拟串口功能的实用技巧和常见问题解决方案。

weixin_28720573的博客 389

Evals性能优化:大规模评估任务的并行处理策略

你是否在运行大规模LLM评估时遇到过任务耗时过长的问题?当评估样本量达到数万甚至数十万级别时,串行处理方式往往需要数小时甚至数天才能完成。Evals框架作为LLM评估的开源基准测试工具,提供了强大的并行处理能力,帮助用户显著提升评估效率。本文将深入解析Evals的并行处理机制,提供从环境配置到高级调优的全方位指南,助你轻松应对大规模评估任务。 读完本文,你将能够: - 理解Evals并行处理的核

gitblog_00458的博客 446

QGIS|如何将WGS84转换为CGCS 2000坐标系?

QGIS 3中如何将WGS84转换为国家2000大地坐标系? 今天来回答一位朋友在后台留言提出的问题:怎么将WGS84坐标转换为国家2000大地坐标系。 01工程坐标系 从地图窗口右下角的状态栏可以看到当前地图窗口的坐标系,即工程坐标系(Project CRS)。当前地图可以由多个图层组成,各种来源数据的坐标参照系(Layer CRS)并不一定相同,QGIS在绘制图层之前将根据工程坐标系进行动态坐标转换,然后显示在地图画布中。 因此,在处理空间数据的过程中,一定要特别注意...

QGISClass的博客 1万+

Awesome-GitHub-Repo:一次收藏 300 多个实用开源项目,从毕业设计到摸鱼神器全都有

找开源项目时,你是不是也遇到过这种情况:搜"毕业设计项目",打开十几个网页,一半链接失效,另一半全是英文描述,看完还是不知道哪个能跑起来。Awesome-GitHub-Repo 就是冲着这个痛点做的开源项目合集清单——它把 GitHub 上 300 多个高质量、有趣的开源项目收进一个仓库,每项都配了中文一句话说明,让你不翻英文文档也能判断值不值得点开。 ## 不按语言分类,按"你能拿它干什么"分

gitblog_00887的博客 200

【微知】关于GB200 NVL72服务器的一些信息?(36CPU72GPU;LPDDR5X 17T;HBM3e 13.5T;5代NVlink 1.8TB; 720P算力FP8;120Kw)

本文仅根据官网介绍分析,存在纰漏仅供参考。

技术札记 5397

Altium Concord Pro 的应用范围,安装,和使用范围

Altium Concord Pro 的应用范围,安装,和使用范围。保证满足两者软件的最低安装要求。 Altium Concord Pro 是配合Digapcb,和MCAD,Altium 和相应机械设计软件的基础和交换桥梁

hanzhaos的博客 1122

AIGC 应用工程师(5-10年)面试题与答案全解析(2026 前沿版)

AIGC 应用工程师面试题与答案全解析(2026 前沿版) 摘要 本文系统整理了 2026 年 AIGC 应用工程师岗位的核心面试内容,包含 19 大模块、68 道关键题目及 15+ 代码示例。内容覆盖: 岗位定位:强调工程落地能力(RAG、Agent、系统集成)与业务闭环思维 技术体系:从基础理论(Transformer、涌现能力)到前沿应用(MCP协议、多模态生成) 工程实践:包含推理优化、成本控制、安全合规等关键落地能力 评估体系:详细讲解 golden set 构建、LLM-as-judge 等评估

weixin_48053866的博客 821

PD详解 扩展消息——Source_Capabilities_Extended Message

PD的协议层分为控制消息,数据消息还有扩展消息,今天大师匈讲一下扩展消息中的source_cap_extended。这个消息在扩展消息中算是比较关键的东西。 扩展消息中的source_cap_extended 大师匈先上图,然后逐一解释; 上面的图表说了source_cap_ext中包含了哪些内容。 我们注意到在source_cap扩展消息中是以字节为单位的,并不是像source_cap中以一个object为单位,当然有注意到PD标准spec中说明的扩展消息的话,那里有说明,在header之后的字节

大师匈的博客 3521

AI Agent能力进化三阶段:从OpenClaw任务自动化到自主规划

AI Agent作为人工智能技术的重要分支,其核心原理是通过大语言模型(LLM)理解自然语言指令,并调用工具(Skill)执行任务。这一技术架构的价值在于将人类语言转化为可执行的操作,实现业务流程的自动化。在应用场景上,AI Agent正从简单的任务自动化向目标导向的自主规划演进。当前,以OpenClaw为代表的框架通过提供Harness(基础设施层)和Skill(工具)管理,降低了AI Agent的开发门槛,解决了“从0到1”的问题。然而,随着任务复杂度提升,AI Agent需要进化出动态规划、反思调整等

weixin_33691700的博客 334

软考嵌入式 第五讲 嵌入式Linux系统技术

5.1 inittab配置文件 Linux实时操作系统开机引导时首先启动内核,由内核检查和初始化硬件设备,载入设备的驱动程序模块,安装root文件系统,然后内核将启动一个名为init的进程,它是系统运行的第一个进程,进程号为1。在init运行完成并启动其他必要的后续进程后,系统开始运行,引导过程结束。 在任何时候,可以在文件inittab中添加新的记录项。重新检查inittab文件时,可以通过命令:init q/ Q使init进程立即重新读取并处理文件inittab。 5.1.1 inittab文件记录

Leon的博客 527

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Evals 到底在评什么?一文拆解 AI 评估的三种方法

成熟团队不会把 evals 当成上线前的一次性考试,而是把它放进完整循环里:从生产 traces 中发现失败模式,沉淀数据集和黄金样例,用 evals 比较 prompt、模型和系统设计改动,再通过 CI 门禁、灰度发布、线上监控和漂移检测持续回流。无参考答案评估器、用户反馈信号,以及其他适合生产环境的安全检查,都可以应用到实时流量上,用来确认生产环境中的质量是否与部署前看到的一致。无参考答案评估器的优势在于,它们可以应用到未见过的生产数据上,而基于参考答案的评估器始终需要一个预先定义好的参考回答。

weixin_45583158的博客 147

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

从定义到执行:Evals框架评估全流程解析

你是否在评估大语言模型(LLM)时遇到过流程混乱、指标不统一的问题?本文将带你深入了解Evals框架的核心实现原理,从EvalSpec定义到评估任务执行的完整流程,帮助你轻松掌握LLM评估的关键技术。读完本文后,你将能够: - 理解Evals框架的核心组件与数据结构 - 掌握评估任务的定义与注册方法 - 熟悉评估执行的全流程与关键步骤 - 学会如何自定义评估指标与报告结果 ## 核心概念:Eva

gitblog_00509的博客 583

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

【大模型理论篇】大模型能力评估、框架工具、评估指标、OpenAI Evals、大模型中文评测示例等

大模型评估、大模型测评、大模型能力评测、大模型评估框架、大模型评估工具、open ai evals、大模型中文评估、分类能力、阅读理解能力、知识抽取能力、表格数据理解能力

源泉的小广场 9843

改进 Skill Creator:如何测试、度量与优化 Agent Skills

Skill Creator测试优化指南摘要 本文介绍了改进Skill Creator的工具与方法,帮助非技术背景的领域专家验证和优化Agent Skills。主要内容包括: 两类Skill测试重点:能力扩展型需测试模型进步后是否冗余;偏好编码型需验证流程准确性。 Evals测试框架: 通过预设测试场景自动验证Skill效果 可捕获模型更新导致的质量回归 跟踪模型自身能力成长 Benchmark量化评估: 对比加载/不加载Skill的性能差异 提供通过率、响应时间和token消耗等指标 示例显示某PDF Sk

kazeMace的博客 1252

变革在即:为什么您现在就需要将大型语言模型融入系统与产品开发

有些问题看起来易于构想和展示原型,但将其发展成实际产品却极为艰难。

KevinDai007的博客 1368

OpenAI Evals框架的扩展实践:自定义评测任务的注册与结果分析

Evals通过装饰器来注册评测任务。任务的核心实现分为两类:(1) 基于提示模板的简单任务——继承等内置suite;(2) 完全自定义逻辑的任务——继承基类。# ===== 方式一:使用内置suite快速定义选择题评测 ====="""基于内置Match suite的自定义多选题评测。通过继承Match类,自动获得:- 精确匹配和模糊匹配逻辑- 标准化的准确率指标- 结果日志记录"""self,):"""将样本转换为模型输入的prompt。构造包含题目和选项的完整prompt,

lady_mumu的博客 4843

Evals用户手册:轻松构建自定义评估任务

Evals是一个用于评估大型语言模型(LLM)和LLM系统的开源框架,提供了丰富的基准测试工具和可扩展架构。本手册将指导您从零开始构建自定义评估任务,深入理解评估流程的每一个环节。 ### 1.1 核心组件与工作流程 Evals框架采用模块化设计,主要包含以下核心组件: ```mermaid flowchart TD A[数据集(JSONL)] -->|加载数据| B[评估类(Eva...

gitblog_01041的博客 595

Evals中的少样本学习评估:利用有限数据解决新任务

当你需要评估大语言模型(Large Language Model, LLM)在医疗诊断、法律分析等高风险领域的表现时,是否常面临标注数据稀缺的挑战?在实际应用中,许多专业领域往往只能提供5-10个高质量样本,却要求模型展现出稳定的泛化能力。Evals框架通过其精心设计的少样本学习(Few-Shot Learning)评估体系,为这一矛盾提供了系统化解决方案。本文将深入解析Evals如何利用有限数据

gitblog_01091的博客 832

OpenAI Evals:LLM 评估框架

OpenAI Evals是一个开源的LLM评估框架,用于测试大语言模型或基于LLM系统的表现。它提供现成的评估集,支持自定义评估逻辑,可在本地或OpenAI Dashboard运行。核心功能包括标准化评估流程、私有评估、结果导出和预提交检查。适用于开发者、工程师、研究人员等需要跟踪模型表现或验证输出质量的场景。安装简单,支持Python 3.9+,可通过pip或源码安装。该框架帮助用户高效评估模型质量,避免手动比对工作。

fenglingzi335的博客 343

Evals框架中的推荐系统评估:从准确率到多样性的完整指标指南

Evals是一个专门用于评估大语言模型和LLM系统的开源框架,提供了丰富的评估基准和指标系统。在推荐系统评估领域,Evals提供了全面的质量与多样性评估指标,帮助开发者科学衡量推荐算法的性能表现。 ## 🎯 推荐质量评估核心指标 在Evals框架中,推荐系统的质量评估主要基于以下几个核心指标: **准确率(Accuracy)** - 衡量推荐结果的整体正确率 **精确率(Precision

gitblog_00546的博客 514

Evals框架深度解析:从核心组件到实际应用

在大型语言模型(LLM)快速发展的今天,如何客观、全面地评估模型性能成为了开发者面临的重大挑战。传统的评估方法往往局限于特定任务和数据集,难以捕捉模型在真实世界中的表现。OpenAI的Evals框架应运而生,为LLM评估提供了一个灵活、可扩展的解决方案。 本文将深入解析Evals框架的核心组件、工作原理和实际应用,帮助读者快速掌握如何利用Evals进行LLM评估。读完本文后,您将能够: - 理...

gitblog_00592的博客 678
上一篇: 豆瓣评分7.9!AI大模型时代利器:LangChain入门指南
下一篇: 论 LLMs 如何解决长文本问题?
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值