Embeddings入门详解!手把手带你训练

什么是embeddings,有哪些主流的embeddings方法 一文了解:什么是embeddings,有哪些主流的embeddings方法 阅读详情

本期摘要

嵌入(Embeddings)是机器学习领域中的一个概念,主要用于将高维的数据转化为低维空间,以便于算法更好地处理和理解数据。嵌入通常用于将离散的、高维的特征转换为连续的、低维的向量表示。

本文将以经典的嵌入模型 word2vec 为例介绍其训练过程,embedding 过程,通过阅读,您将理解一段文本是如何转化为 n 维向量的。

01

word2vec

Word2Vec 是一种用于生成词嵌入的算法,它基于分布式假设,即假设上下文相似的单词在语义上也是相似的。Word2Vec 有两种主要的训练模型:连续词袋模型(Continuous Bag of Words,CBOW)和跳字模型(Skip-gram)
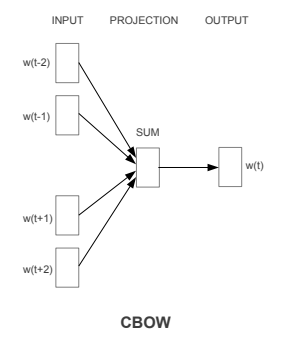
图片

**CBOW:**通过给定一个词的上下文单词,来预测中心词,模型的输入是上下文词的词向量,输出是中心词的词向量。CBOW 的训练目标是最大化预测中心词的概率,从而得到能够很好地表示上下文语境的词向量。
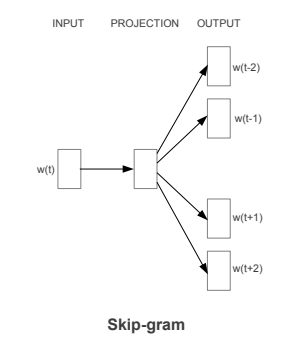
图片

Skip-gram:Skip-gram 的思想与 CBOW 相反,它通过给定一个中心词,来预测其周围的上下文词。模型的输入是中心词的词向量,输出是上下文词的词向量。Skip-gram 的训练目标是最大化预测上下文词的概率,从而得到能够很好地捕捉词语语义的词向量。

02

Embedding过程

训练好的word2vec模型有一张词表,词表中包含训练数据中所有单词所对应的词向量,当使用word2vec将句子转化为向量时,一种常见的方法是将句子中所有单词的词向量取平均或加权平均。这可以帮助将整个句子的语义信息编码到一个向量中。大致步骤如下

  1. 获取每个单词的词向量,将句子中的每个单词都映射到Word2Vec模型中的词向量空间,得到对应的词向量。

  2. 计算平均向量:将所有单词的词向量取平均,得到句子的平均向量。

假设目前有一个已经训练好的word2vec模型,模型的输入为“我喜欢苹果”,分词向量表如下。请注意这里的词向量维度为3,实际词表中的维度远远大于这个值。

单词词向量
我[0.2, 0.3, 0.5]
喜欢[0.4, 0.1, 0.8]
苹果[0.6, 0.7, 0.9]

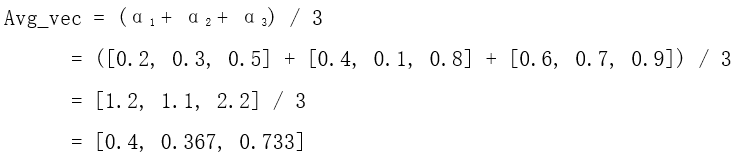
接下来我们使用词向量平均的方法,将这个句子转化为向量。设我的词向量为α1 ,喜欢的词向量为α2 ,苹果的词向量为α3
图片

这样,“我喜欢苹果” 这个句子就被转化为了一个向量 [0.4, 0.367, 0.733],其中每个维度代表了句子在对应语义维度上的平均值。这个向量可以用于表示句子的语义特征。

03

计算向量之间相似性

在计算向量之间的相似性时,常用的方法包括余弦相似度(Cosine Similarity)以及欧几里得距离(Euclidean Distance)

  • 余弦相似度衡量了两个向量之间的夹角,取值范围在-1到1之间。相似的向量夹角接近0度,余弦相似度接近1,表示相似性高;夹角接近180度,余弦相似度接近-1,表示相似性低;夹角为90度,余弦相似度接近0,表示两向量正交,无明显相似特征。

  • 欧几里得距离是计算两个向量之间的距离,值越小表示越相似,值越大表示越不相似。

以余弦相似度为例,假设我想要得到在向量数据库中与我的问题最接近的文本,首先我需要对我的问题做向量化,假设用word2vec向量化后的问题向量为β1 = [0.3, 0.7, 0.5],最接近的文本向量为β2 = [0.4, 0.6, 0.9]

1、首先对β1 以及 β2 做内积,以及分别取模
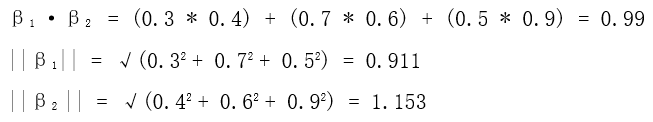
图片

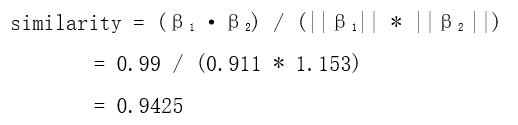
2、 然后使用余弦相似度公式计算β1 以及 β2 做相似度

图片

这个计算出的余弦相似度值接近于1,说明向量 β1 和向量 β2 在方向上非常相似,夹角很小。这表示向量 β1 和向量 β2 在某种意义上是相似的,具有一定的语义相关性。

04

word2vec模型的训练过程

之前提到模型词表中已经存储了词向量,因此我们句子可以被分词之后到词表中找到对应词的词向量做加权平均得到句子的向量表示,那么词表中的词向量是从哪来的?接下来我将介绍word2vec模型的训练过程,从而解释这个问题

1、准备数据

将文本分解为词语序列,构建词汇表,并为词汇表中的每个词分配初始的词向量。这些初始的词向量通常是随机的,这些随机初始化的词向量没有任何具体语义含义,它们只是作为模型训练的起点。随机初始化词向量的原因是,在开始训练之前,模型并不知道每个词汇的语义信息。通过随机初始化,模型有了一个初始状态,然后通过训练过程逐步调整这些词向量,使它们能够捕捉到词汇之间的语义关系。随机初始化的词向量可以是服从某种分布的随机数,比如均匀分布或正态分布。这些初始向量会在训练过程中逐渐调整,以使模型在预测上下文词汇时更准确。一个好的embedding模型拥有海量(GB,TB,PB)的文本作为训练数据,打个比方,同一个词出现的句子越多,在之后做embedding时越接近真实语义。

2、上下文,中心词对
图片

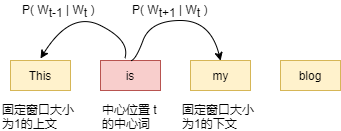
对于一段文本,从第一个词开始以固定的窗口大小对文本进行切分,计算每个词出现的概率,每个词会拥有两个概率表示,一个为作为中心词出现的概率,另一个为作为上下文时出现的概率对应的,我们用两个词向量表示词表中的每个词,一个表示该词作为中心词时,另一个表示该词作为上下文时。

3、计算概率分布

计算预测概率分布时使用了softmax函数。这个函数将模型的输出转化为概率分布,以便用于计算损失并进行优化。模型会根据输入的中心词或上下文词的词向量,计算每个词汇成为目标的概率。然后,使用softmax函数对这些概率进行归一化处理,确保它们形成一个合理的概率分布。这个概率分布表示给定上下文条件下,每个词汇成为中心词或上下文词的概率。这个分布会被用于计算损失函数(通常使用交叉熵损失),进而用于优化模型的参数,使得模型能够更好地预测实际的上下文或中心词。

在这里插入图片描述

假设词向量为:

  • Apple: [0.2, 0.4]
  • Banana: [0.5, 0.7]
  • Orange: [0.3, 0.6]

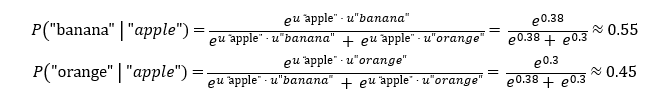
在Skip-gram模型中,我们要计算给定上下文词 “apple” 的情况下,每个词汇成为中心词的概率分布。我们可以使用 softmax 函数来计算这些概率。

首先计算内积
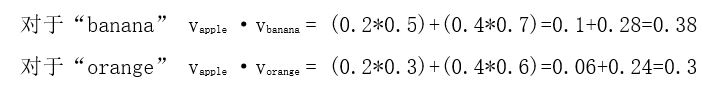
图片

使用softmax函数计算概率

图片

在以apple为上下文的情况下,“banana”和“orange”成为中心词的概率分布,从结果可以得知,“banana”成为中心词的概率比较高。

4、损失函数梯度更新

使用模型的输出概率分布和实际上下文或中心词汇,计算损失,通常使用交叉熵损失函数。使用损失函数计算模型的梯度,然后使用优化算法(如梯度下降)来更新词向量,使预测更接近实际。
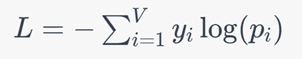
图片

其中V是词汇表大小,yi 是实际目标概率分布中词汇wi的概率(如果词汇是目标,则为1,否则为0),pi 是模型预测的概率分布中词汇wi的概率。使用损失函数的梯度来更新模型的参数,通常采用梯度下降等优化算法。目标是通过反向传播算法调整模型的参数,使得损失函数最小化。

5、迭代训练

重复上述步骤多次,迭代训练模型。随着训练的进行,词向量会逐渐调整以更好地捕捉词汇之间的语义关系。

训练自己的word2vec模型

详情请参阅Confluence word2vec模型训练

(https://confluence.digitalchina.com/x/XUHJAg)

05

总结

2013年Google员工Tomas Mikolov等人提出了word2vec。用于在计算机中处理和分析文本数据。这个过程涉及将文本中的单词、短语或句子转化为向量表示,使得计算机能够处理和比较文本信息。Word2Vec利用深度学习模型,通过预测上下文词汇来生成词向量,从而捕捉单词之间的语义关系。这种向量表示使得文本信息能够在计算机中进行数学计算和分析,为自然语言处理任务提供了基础。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Word Embeddings原理与Transformer实现详解 词嵌入(Word Embeddings)是自然语言处理中的核心技术,通过将离散词汇映射到连续向量空间,解决了传统one-hot编码的维度灾难和语义缺失问题。其核心原理是利用神经网络学习词汇的分布式表示,使得语义相似的单词在向量空间中距离相近。在工程实践中,Transformer架构通过Embedding层实现词汇编码,结合位置编码和缩放因子等技巧提升模型性能。典型应用包括文本分类、机器翻译等NLP任务,其中预训练Embedding的迁移学习和可视化分析是热门研究方向。针对阿拉伯语等复杂语言,采用词根词缀分离 阅读详情

相关推荐

jina-embeddings-v4

训练分为两阶段:对比学习训练(基础语义学习)和任务特化训练(任务优化)。推理时用户根据任务需求选择 LoRA 适配器,生成嵌入后计算相似性。架构基于 Qwen2.5-VL,扩展支持多向量输出。是一个多模态嵌入模型,基于。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 1657

Embeddings:是什么以及它们为何重要?

向量嵌入是一项与更广泛的大型语言模型领域相关的技术——ChatGPT 和 Bard and Claude 背后的技术。向量嵌入基于一个技巧:获取一段内容(在本例中为博客条目)并将该内容转换为浮点数数组。该数组的关键在于,无论内容有多长,它的长度始终相同。长度由您使用的嵌入模型定义 - 数组的长度可能是 300、1,000 或 1,536 个数字。思考这个数字数组的最好方法是将其想象为一个非常奇特的多维空间中的坐标。

xuejianxinokok的专栏 3212

LLM基础-什么是嵌入(Embeddings)

在自然语言处理(NLP)领域,Token Embeddings(标记嵌入)扮演着至关重要的角色。它不仅是语言模型的基础,更是连接人类语言与机器理解的桥梁。本文将深入探讨 Token Embeddings 的原理、生成过程、应用场景,以及它在现代语言模型中的重要性。

zg_hover的专栏 1259

自然语言处理中的embeddings

1. 背景 ​ 自2010年代初以来,嵌入一直是自然语言处理(NLP)的主流热词之一。将信息编码成低维向量表示,在现代机器学习算法中很容易集成,这在NLP的发展中起到了核心作用。嵌入技术最初集中在单词上,但很快就开始将注意力转移到其他形式上:从图结构,如知识库,到其他类型的文本内容,如句子和文档。 ​ 接下来,我们会从最初的one-hot开始,探索embddings在nlp领域的发展。 2. 概览 ​ 在embeddings技术出现以前,nlp领域应用较多的是以one-ho

u013596454的博客 3052

机器学习20:嵌入-Embeddings

嵌入(Embeddings)是一个相对低维的空间,我们可以将高维向量转换到其中。嵌入使得对大型输入(例如表示单词的稀疏向量)进行机器学习变得更加容易。理想情况下,嵌入通过将语义相似的输入紧密地放置在嵌入空间中来捕获输入的一些语义。嵌入可以在模型中学习和重用。

Jin_Kwok的博客 2513

从单体套件到智能组合:重新理解 SAP Business Suite 的企业管理新范式

企业数字化面临安全合规、系统集成、业务敏捷等复合挑战,SAP Business Suite提出模块化解决方案,整合Cloud ERP、AI、数据云和BTP平台,支持分阶段转型。其核心理念是通过"clean core"保持系统可升级性,将差异化需求通过标准扩展实现,避免核心系统技术债。该方案强调业务语义统一和嵌入式AI能力,使创新更可持续。案例显示这种模式已在超大规模企业落地验证。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 999

Jina Embeddings v4 的量化感知训练

蒸馏是一种以大带小的策略,通过用一个强大的大模型(教师模型)生成大量训练数据,来训练一个专为量化设计、结构更小的新模型(学生模型)。更重要的是,量化作为一种通用的数值优化手段,它不挑数据、不看场景、不依赖特定领域知识,适用于各类模型和应用场景。简单总结一下:四种方法都能实现向量压缩,但除了压缩向量外,还想同时获得更小、更快的模型,则需选择全量化感知训练(Full QAT) 或蒸馏,并承担更高的训练成本。虽然模型参数会有所调整,但模型权重的精度保持不变,因此模型整体的体积不会缩小,变化的只是输出向量的尺寸。

Jina AI 的博客 736

Frida实战:如何用adb快速连接网易mumu模拟器进行参数Hook(附常见CPU架构问题排查)

本文详细介绍了如何使用Frida和adb快速连接网易MuMu模拟器进行参数Hook,包括环境配置、架构适配、Frida-server部署及常见问题排查。特别针对CPU架构兼容性问题提供了实用解决方案,帮助开发者高效完成逆向调试任务。

weixin_29274969的博客 290

工具篇Flair之训练自己的Flair Embeddings

更多实时更新的个人学习笔记分享,请关注: 知乎:https://www.zhihu.com/people/yuquanle/columns 微信订阅号:AI小白入门 ID: StudyForAI Flair工具使用教程之如何训练自己的Flair Embeddings 教程地址:https://github.com/zalandoresearch/flair/blob/master/res...

AI小白入门的博客 1746

Zemax操作33--5倍激光扩束器

5倍扩束

lzy750750的博客 2934

汇川AM系列PLC玩转CNC:手把手教你用File模式读取G代码文件(附避坑指南)

本文详细介绍了如何使用汇川AM系列PLC的File模式读取G代码文件,涵盖从CAD设计到PLC配置的全流程。特别针对路径格式、文件类型等常见问题提供避坑指南,帮助工程师快速实现CNC加工的自动化控制。

weixin_33582311的博客 408

HuggingFace Text Embeddings Inference 快速入门指南

HuggingFace Text Embeddings Inference (TEI) 是一个高性能的文本嵌入推理服务,它能够帮助开发者快速部署和使用各种预训练的语言模型,包括文本嵌入模型、重排序模型和序列分类模型。该项目通过Docker容器提供开箱即用的服务,支持GPU加速,特别适合需要处理大规模文本嵌入计算的应用场景。 ## 环境准备 在开始使用TEI之前,需要确保你的系统满足以下要求: ...

gitblog_01051的博客 665

Windows系统3D Gaussian Splatting环境搭建全攻略:从零开始到成功运行

本文详细介绍了在Windows系统上搭建3D Gaussian Splatting环境的完整流程,包括CUDA 12.6安装、Anaconda环境配置、代码获取与依赖安装等关键步骤。针对Windows平台特有的环境配置问题,提供了实用的解决方案和常见错误排查方法,帮助开发者快速实现3D Gaussian Splatting的成功运行。

weixin_30832143的博客 454

Fast_Sentence_Embeddings入门教程:预训练词向量如何一键加载,GloVe、Word2Vec与FastText选哪个

**Fast_Sentence_Embeddings(简称 fse)是一个专为高速计算句子嵌入(Sentence Embeddings)而生的 Python 库**。它基于 Gensim 构建,能让你用一行代码一键加载 GloVe、Word2Vec、FastText 等预训练词向量,并在无需 GPU 的情况下,以每秒 30 万~50 万句的速度为海量文本生成句子向量,是 Transformer 类

gitblog_00941的博客 440

手把手教你用6轴IMU跑通LIO-SAM:参数配置与代码修改保姆级教程

本文提供了一套完整的6轴IMU适配LIO-SAM的解决方案,包括参数配置与代码修改的详细步骤。从理解6轴与9轴IMU的关键差异入手,逐步指导如何调整核心配置文件params.yaml、重构utility.h关键函数、优化mapOptimization.cpp的位姿融合逻辑,并给出编译验证与性能调优建议,帮助开发者快速实现6轴IMU在LIO-SAM中的稳定运行。

weixin_28717807的博客 357

html一号店项目代码,项目一号店素材(html模板)

【实例简介】【实例截图】【核心代码】oneShop├── css│ ├── ShopShow.css│ ├── base.css│ ├── load.css│ ├── logo.css│ ├── register.css│ └── style.css├── detail.html├── images│ ├── Thumbs.db│ ├── a_close.png│...

weixin_35390150的博客 4990

Stable Diffusion模型训练 — Embeddings(附Demo)

提到文本反演你可能会比较陌生,但它产出的模型类型Embeddings(词嵌入)一定是你出图过程里经常会使用到的,它是一种轻量、小巧的微调模型格式,文件名后缀一般为.pt(或.safetensor),每个Embeddings文件的大小在几KB到几百KB左右。为什么Embeddings文件这么小呢?

不诱于誉,不恐于诽,率道而行,端然正己。 2806

OBC_开环扫频波特图拟合操作流程(结合 Simulink)

摘要: 本文详细介绍了基于Simulink的开环扫频波特图测试与拟合流程,适用于电源/控制系统(如LLC/PFC)的小信号分析。主要内容包括:1)前期准备(测试点选择、信号范围设定);2)Simulink建模方法(信号注入、数据记录);3)两种扫频方式(逐频正弦/Chirp扫频)的实现;4)MATLAB数据处理(FFT分析、传递函数拟合);5)线性分析工具使用技巧。重点强调了激励信号幅值控制、稳态数据采集及模型验证方法,并提供完整MATLAB脚本示例。该流程可有效获取系统频域特性,为控制器设计提供可靠依据。

Sumerking的博客 234

从图像分类到Embeddings:tf_mixnet_l.in1k的3种官方用法详解

tf_mixnet_l.in1k 是 timm(PyTorch Image Models)提供的一款 MixNet 图像分类模型,在 ImageNet-1k 上完成预训练,仅 7.3M 参数、0.6 GMACs,轻量高效。本文面向新手,用一篇文章讲清楚它的 **3 种官方用法**:图像分类、特征图提取、图像 Embeddings,并解读 [config.json](https://link.git

gitblog_00998的博客 457

RT-DERT安卓部署教程

这个文档中的代码案例,实现了拍照和选图识别,两个功能,可以看效果图。UI做了美化:显示类别机和数量。代码下载地址:通过网盘分享的文件:android_rtdert.zip链接: https://pan.baidu.com/s/1k6e-d_lov1OPgUmit5i_cA?pwd=hpfi 提取码: hpfi–来自百度网盘超级会员v8的分享。

AIOT魔法师 196

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

RAG应用成功秘诀:Embeddings模型选择指南,提升大模型检索效果!

本文深入解析RAG框架中Embeddings模型的关键作用,指出检索上下文质量直接影响响应效果。文章系统介绍各类Embeddings(词、句子、文档、图像级)特点,详解选择最佳模型的核心考量因素,包括上下文窗口、维度、训练数据等,并推荐MTEB等基准工具,帮助开发者根据实际需求提升RAG系统性能和准确性。

weixin_55154866的博客 835

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Jina Embeddings V5 Omni Small模型微调与适配器训练:从零到一教程

Jina Embeddings V5 Omni Small是一款功能强大的多模态嵌入模型,支持文本、图像和音频等多种数据类型的嵌入生成。本教程将带你从零开始学习如何对该模型进行微调,并训练适用于不同任务的适配器,让你轻松掌握模型优化的核心技能。 ## 模型概述:为什么选择Jina Embeddings V5 Omni Small? Jina Embeddings V5 Omni Small模型

gitblog_01116的博客 816

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Jina Embeddings v4定制化开发指南

Jina Embeddings v4定制化开发指南 【免费下载链接】jina-embeddings-v4 项目地址: https://ai.gitcode.com/hf_mirrors/jinaai/jina-embedding...

gitblog_00332的博客 879

LLM基础模型系列:初识Embeddings

Embeddings会分为两个章节,前部分主要还是放在常规方法总结,后者主要放在神经网络技术。其实这个英文单词不难理解,就是将对象用数字标识描述。其实一直纠结是否要讲述这个话题,因为可深可浅。若要用一句话概括,就是给输入分配一个数字标识,可以是一个整数数值也可以是一个向量。不过最重要的目的是在模型训练的过程中能够高效且有效的学习参数。

2401_85379281的博客 943

预训练词嵌入Pretrained Word Embeddings

我们如何让机器理解文本数据?我们知道,机器在处理数字数据方面非常擅长,但如果我们把原始的文本数据提供给它们,它们的效果会很差。我们的想法是创建一个词的表征,捕捉它们的含义、语义关系和它们使用的不同类型的语境。这就是词语嵌入–文本的数字表示。而预训练的词嵌入是当今自然语言处理(NLP)领域的一个关键齿轮。但是,问题仍然存在–预训练的词嵌入是否给我们的NLP模型带来了额外的优势?这是一个你应该知道答案的重要问题。因此,在这篇文章中,我将对预训练词嵌入的重要性进行一些说明。我们还将比较预训练的词嵌入和从头开始学习

yeserumo的博客 1542

NLP中如何使用预训练的embeddings

接上一篇 在这个kernel中,我想说明在构建深度学习NLP模型时我是如何进行有意义的预处理的(meaningful preprocessing)。 我从两条黄金法则(golden rules)开始: 当您有预先训练好的嵌入(pre-trained embeddings)时,不要使用标准的预处理步骤,如词干(stemming)或删除词(stopword removal) 你们中的一些人在进行基...

czp_374的博客 1666
上一篇: 从零手搓中文大模型|Day04|模型参数配置和训练启动|我的micro模型跑起来啦!
下一篇: 开发RAG应用,你必须知道的7个Embedding模型
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值