从零手搓中文大模型|Day04|模型参数配置和训练启动|我的micro模型跑起来啦!

TensorFlow 2.9生产级升级指南:性能、量化与容错实战 TensorFlow作为主流深度学习框架,其版本演进直接影响AI模型在真实生产环境中的训练效率、部署稳定性与推理精度。理解tf.data性能优化原理、TFLite量化机制及分布式容错设计,是构建高可用AI系统的基础技术能力。这些能力直接决定OCR模型在边缘设备的长时间稳定运行、推荐系统A/B测试的低延迟响应,以及金融风控模型训练失败率的显著下降。本文聚焦TensorFlow 2.9这一面向生产就绪(production readiness)的关键版本,深入解析其在数据管道吞吐提升、移动端量化精度保障、多GP 阅读详情

今天我们来研究一下模型的配置。

litgpt使用的配置文件和transformers有点不太一样,它的仓库里提供了一些预训练所用的yaml配置文件样例[1]。这个主要用于需要自定义模型的场景。

另外litgpt也内置了一些huggingface上的现成模型[2],可以直接拿来使用。

训练配置文件

以下是我这次定义的一个配置文件。

内容有点多,但是还是都列举出来了,可以直接跳到后面对一些关键参数的解释。

# The name of the model to pretrain. Choose from names in ``litgpt.config``. Mutually exclusive with  
# ``model_config``. (type: Optional[str], default: null)  
model_name:microstories  
  
# A ``litgpt.Config`` object to define the model architecture. Mutually exclusive with  
# ``model_config``. (type: Optional[Config], default: null)  
model_config:  
name:microstories  
hf_config:{}  
scale_embeddings:false  
block_size:512  
padded_vocab_size:65024  
vocab_size:64798  
n_layer:6  
n_head:6  
n_query_groups:6  
n_embd:512  
head_size:48  
rotary_percentage:1.0  
parallel_residual:false  
bias:false  
norm_class_name:RMSNorm  
mlp_class_name:LLaMAMLP  
intermediate_size:768  
  
# Directory in which to save checkpoints and logs. If running in a Lightning Studio Job, look for it in  
# /teamspace/jobs/<job-name>/share. (type: <class 'Path'>, default: out/pretrain)  
out_dir:/home/puppyapple/Server/BigAI/Chinese_LLM_From_Scratch/Experiments/Output/pretrain/microstories  
  
# The precision to use for pretraining. Possible choices: "bf16-true", "bf16-mixed", "32-true". (type: Optional[str], default: null)  
precision:bf16-mixed  
  
# Optional path to a checkpoint directory to initialize the model from.  
# Useful for continued pretraining. Mutually exclusive with ``resume``. (type: Optional[Path], default: null)  
initial_checkpoint_dir:  
  
# Path to a checkpoint directory to resume from in case training was interrupted, or ``True`` to resume  
# from the latest checkpoint in ``out_dir``. An error will be raised if no checkpoint is found. Passing  
# ``'auto'`` will resume from the latest checkpoint but not error if no checkpoint exists.  
# (type: Union[bool, Literal["auto"], Path], default: False)  
resume:true  
  
# Data-related arguments. If not provided, the default is ``litgpt.data.TinyLlama``.  
data:  
# TinyStories  
class_path:litgpt.data.LitData  
init_args:  
data_path:Chinese_LLM_From_Scratch/Data/TinyStoriesChinese/processed_data  
split_names:  
-train  
-val  
  
# Training-related arguments. See ``litgpt.args.TrainArgs`` for details  
train:  
# Number of optimizer steps between saving checkpoints (type: Optional[int], default: 1000)  
save_interval:1000  
  
# Number of iterations between logging calls (type: int, default: 1)  
log_interval:1  
  
# Number of samples between optimizer steps across data-parallel ranks (type: int, default: 512)  
global_batch_size:512  
  
# Number of samples per data-parallel rank (type: int, default: 4)  
micro_batch_size:32  
  
# Number of iterations with learning rate warmup active (type: int, default: 2000)  
lr_warmup_steps:1000  
  
# Number of epochs to train on (type: Optional[int], default: null)  
epochs:  
  
# Total number of tokens to train on (type: Optional[int], default: 3000000000000)  
max_tokens:3000000000000  
  
# Limits the number of optimizer steps to run. (type: Optional[int], default: null)  
max_steps:  
  
# Limits the length of samples. Off by default (type: Optional[int], default: null)  
max_seq_length:512  
  
# Whether to tie the embedding weights with the language modeling head weights. (type: Optional[bool], default: False)  
tie_embeddings:true  
  
#   (type: Optional[float], default: 1.0)  
max_norm:1.0  
  
#   (type: float, default: 4e-05)  
min_lr:0.0  
  
# Evaluation-related arguments. See ``litgpt.args.EvalArgs`` for details  
eval:  
# Number of optimizer steps between evaluation calls (type: int, default: 1000)  
interval:2000  
  
# Number of tokens to generate (type: Optional[int], default: null)  
max_new_tokens:  
  
# Number of iterations (type: int, default: 100)  
max_iters:100  
  
# Whether to evaluate on the validation set at the beginning of the training  
initial_validation:false  
  
# Whether to evaluate on the validation set at the end the training  
final_validation:false  
  
# Optimizer-related arguments  
optimizer:  
class_path:torch.optim.AdamW  
  
init_args:  
#   (type: float, default: 0.001)  
lr:0.0005  
  
#   (type: float, default: 0.01)  
weight_decay:0.1  
  
#   (type: tuple, default: (0.9,0.999))  
betas:  
-0.9  
-0.95  
  
# How many devices/GPUs to use. Uses all GPUs by default. (type: Union[int, str], default: auto)  
devices:auto  
  
# How many nodes to use. (type: int, default: 1)  
num_nodes:1  
  
# Optional path to the tokenizer dir that was used for preprocessing the dataset. Only some data  
# module require this. (type: Optional[Path], default: null)  
tokenizer_dir:Chinese_LLM_From_Scratch/References/chatglm3-6b  
  
# The name of the logger to send metrics to. (type: Literal['wandb', 'tensorboard', 'csv'], default: tensorboard)  
logger_name:wandb  
  
# The random seed to use for reproducibility. (type: int, default: 42)  
seed: 42

model_config

model_config:  
  name:microstories  
hf_config:{}  
scale_embeddings:false  
block_size:512  
padded_vocab_size:65024  
vocab_size:64798  
n_layer:6  
n_head:6  
n_query_groups:6  
n_embd:512  
head_size:48  
rotary_percentage:1.0  
parallel_residual:false  
bias:false  
norm_class_name:RMSNorm  
mlp_class_name:LLaMAMLP  
intermediate_size: 768
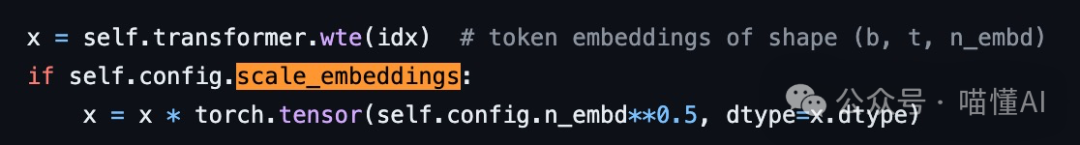
  • • scale_embeddings控制是否对embedding进行缩放。

scale_embedding

如果为True,那么在forward函数中会对embedding进行缩放。注意这个缩放和sefl-attention中的缩放不是一回事,不要弄混了。其实也有很多讨论关于这个地方这一步是否有必要的,目前看来似乎是区别不大,可以设置为False。

  • • transformer中的block_size,也就是max_seq_length。

  • • padded_vovab_size和vocab_size直接取自tokenizer。

  • • n_layer和n_head都是6,构建了一个6层6头的transformer。

  • • n_query_groups是6,这是GQA(Grouped-Query Attention)的一个参数,控制query的分组。当n_query_groups等于n_head时,其实就是MHA(Multi-Head Attention)。下面这个图比较直观:
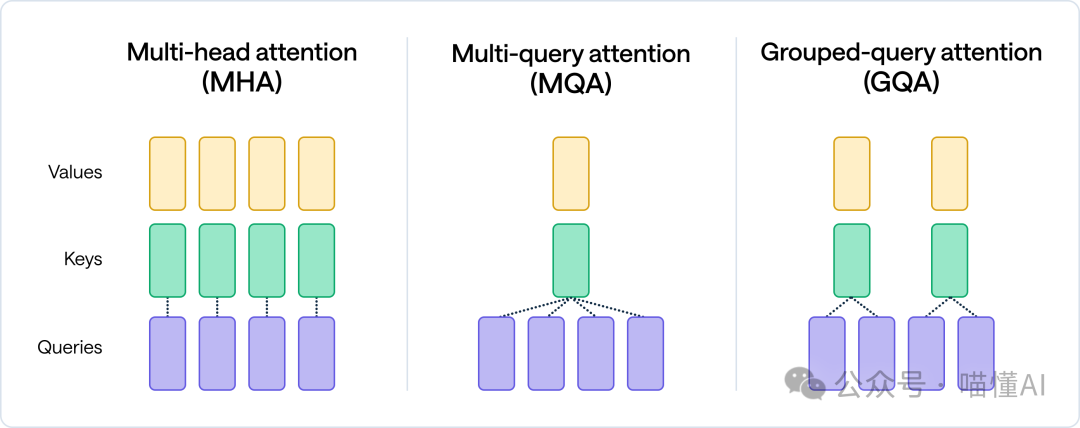
GQA

  • • 头的大小head_size是48,n_embd是512。

  • • rotary_percentage是1.0,这个是旋转编码(Rotary Position Embedding, RoPE)的有关参数,这里先不展开介绍了。

  • • parallel_residual是false,关于parallel residual和non-parallel residual的解释可以参考这个图:
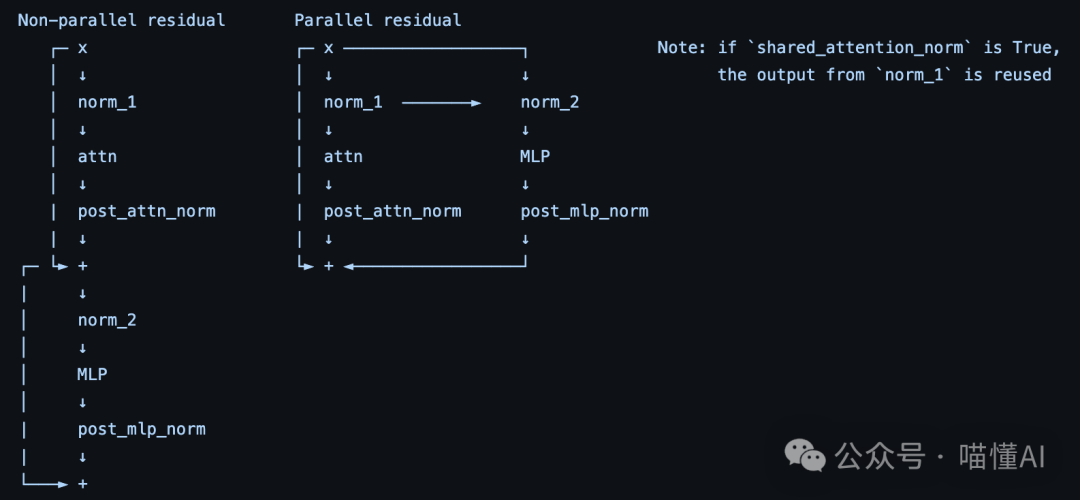
parallel_residual

  • • bias控制Linear层的bias是否存在,现在大多模型一般都是false。

  • • norm_class_name是RMSNorm,mlp_class_name是LLaMAMLP,具体可以参见litgpt里model.py[3]中的实现。

  • • intermediate_size是768,这个是上面的MLP中间层的大小。

按照上面的配置得到的模型参数量在44M左右,也就是只有0.044B的大小。

但根据微软的TinyStories[4]论文结论,10-80M级别的模型能在小故事生成这种简单的语言任务上达到不错的效果(依旧能说人话)。

其他参数

其余的都是一些训练的参数,比如batch_size,lr,weight_decay等等,这些都是比较常见的参数,不再赘述。

logger我这里选择的是wandb,可以直接在wandb上查看训练过程中的一些指标。

data设置成之前预处理好的数据集的路径(其中指定了加载数据所用的litdata的类名)

tokenizer_dir是选用的或者自己训练好的tokenizer的路径。

启动训练

litgpt pretrain --config Experiments/configs/microstories.yaml

预训练启动的命令非常简单,只需要指定上面的配置文件的路径即可。

不出意外的话模型就能开始训练了,可以在wandb上查看训练过程中的指标。

我的模型其实已经训练了一段时间,show一下训练过程中的图表:
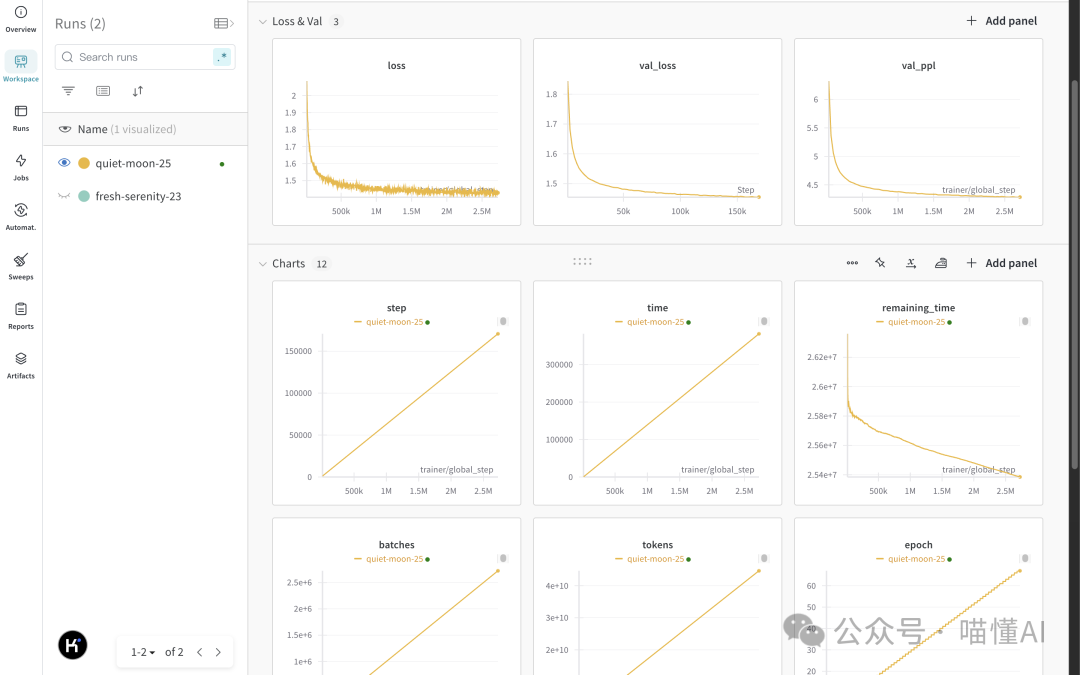
wandb

小结

    1. 详细介绍了litgpt的预训练模型配置文件。
  1. 2. 顺带解释了一些重要参数的原理。

  2. 3. 训练启动。

Day04的内容就到这了。积少才能成多,每次进步一点点就够了。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【信息科学与工程学】【数字孪生】【云计算】第十五篇 云计算领域数字孪生的核心数学模型01 ​功能​​关键算法/机制​​依赖组件​调度与扩缩容状态机循环、比例算法服务发现一致性哈希(IPVS)、DNS轮询存储绑定最佳匹配策略PV控制器自愈心跳检测、探针超时Node控制器、kubelet批处理任务Cron表达式解析CronJob控制器完整验证流程建议结合Prometheus监控​(资源指标)和Chaos Engineering工具​(故障注入)。代码实现细节可参考K8s源码中的模块。​节点信息快照机制​:减少锁争用,支持高速访问​无锁优先级队列。 阅读详情

相关推荐

【信息科学与工程学】计算机科学与自动化—第十五篇 云计算 11 算法篇02

但若第一个应用需求40GB/s,第二个10GB/s,总需求50GB/s>40GB/s,第一个得32GB/s,第二个得8GB/s,不公平。但若分区负载不均(分区1-2各有100任务/s,分区3-4各有50任务/s),A负责1-2(200/s),B负责3-4(100/s),仍均衡。任务 τi​ 的计算需求 Wi​(CPU周期),在频率 f 下执行时间 Ti​=Wi​/f,能耗 Ei​=Pdyn​⋅Ti​=Ceff​⋅V2⋅f⋅(Wi​/f)=Ceff​⋅V2⋅Wi​。若 Mneed​>Mi​,需使用远程显存。

weixin_49199313的博客 110

LitGPT: 高性能大语言模型的预训练、微调和部署工具

LitGPT为大语言模型的研究和应用提供了一个强大而灵活的工具。无论您是AI研究人员、开发者还是企业用户,LitGPT都能满足您在LLM领域的各种需求。通过其优化的性能、丰富的功能和活跃的社区支持,LitGPT正在推动大语言模型技术的快速发展和广泛应用。

m0_56734068的博客 1430

【信息科学与工程学】计算机科学与自动化 第二百三十三篇 凤凰架构01

编号类型领域系统软件/硬件或系统集成方案及系统架构模块子模块函数名称/算法名称算法的数学分析及计算机体系架构及数据结构与算法详细设计及参数列表及数值范围设计关联知识1共识算法分布式基石状态机复制架构:Proposer/Acceptor/Learner 多节点角色模型,基于操作转移(Operation Transfer)分布式共识PaxosPaxos 协议(Prepare/Promise/Accept/Accepted 两阶段)数学基础:多数派(Quorum)投票,基于鸽巢原理保证 W+R>N 时读写集合必有

weixin_49199313的博客 267

litgpt - 一站式的 LLM 开发和部署工具

litgpt专注于大型语言模型预训练、微调与部署的命令行工具,具有支持多种模型、先进技术优化、易用性与灵活性以及广泛应用场景等特点。通过LitGPT,用户可以高效地利用和定制大型语言模型,推动自然语言处理技术的发展和应用。

763

【信息科学与工程】【物理/化学科学和工程技术】知识体系01 力学基础13 微纳力学01

3. 经典双晶梁曲率公式(Timoshenko):κ=E12​h14​+4E1​E2​h13​h2​+6E1​E2​h12​h22​+4E1​E2​h1​h23​+E22​h24​6E1​E2​h1​h2​(h1​+h2​)ϵ0​​。2. 谐振曲线拟合:A(f)=(1−(f/f0​)2)2+(f/(f0​Q))2​A0​​,相位ϕ(f)=−arctan[1−(f/f0​)2f/(f0​Q)​]。

weixin_49199313的博客 102

【信息科学与工程学】【物理/化学和工程技术】第一百三十二篇 损伤学 系列二01 ——网络中的损伤学01

编号类型领域问题问题的详细数学分析参数列表及边界条件及范围及区间极限及边界条件及规则列表关联知识01机械损伤IP(骨干光缆)护套挤压+微弯导致附加损耗几何:光纤微弯半径R(z);结构:层绞式/中心束管;质量分布:护套密度;时间:长期蠕变;介质分布:土壤压强p(z);力学分布:护套弹性模量E、泊松比ν。微弯损耗α_micro ∝ ∫|d²R/dz²|² dz(Marcuse模型),R(z)由p(z)、E、ν通过梁弯曲理论确定。p∈[0,5] MPa,R∈[20mm,∞),ν≈0.4,E∈[1,3] GPa,埋

weixin_49199313的博客 123

探索未来文本智能:LitGPT – 高效预训练与微调的利器

在这个快速发展的自然语言处理领域,[ LitGPT ](https://github.com/Lightning-AI/lit-stablelm)为我们提供了一种全新的方式来利用和定制超过20个大型语言模型(LLMs)。借助LitGPT,无论是预训练、微调,还是部署,您都可以在自己的数据集上实现这一切,并体验前沿的技术优化。 ## 项目介绍 LitGPT 是一个基于命令行的工具,专为高效地交...

gitblog_00003的博客 1003

【信息科学与工程学】【数据中心】第三十二篇 云数据中心的计算/存储/网络的核心挑战01

状态方程: SOCk+1​=SOCk​−Qn​ik​Δt​;: 三相电流变换到αβ坐标系: iα​=32​​(ia​−21​ib​−21​ic​), iβ​=32​​(23​​ib​−23​​ic​). 计算瞬时有功功率p和无功功率q,经低通滤波器分离直流分量,反变换得基波电流,差值即为谐波指令。: 节点i的信念 bi​(xi​)=ϕi​(xi​)∏j∈N(i)​mji​(xi​), 消息 mij​(xj​)=∑xi​​ϕi​(xi​)ψij​(xi​,xj​)∏k∈N(i)\j​mki​(xi​).

weixin_49199313的博客 221

webassembly009 transformers.js 网页端侧推理

之前试用过两个网页端的神经网络框架,一个是,它相当与实现了一个网页端的简单的训练框架,另一个是onnx的网页端(),需要自己转换onnx模型用于推理。这里的相当于在网页端实现了transformer库。Transformers.js 在功能上等同于 Hugging Face 的 transformers python 库,这意味着您可以使用非常相似的 API 运行相同的预训练模型。(但是应该是不能训练的,毕竟训练需要的资源还是很多的。

ResumeProject的博客 1311

【信息科学与工程学】【制造工程】第三十六篇 机械工程与自动化101

本系统通过多模型集成、知识增强、主动学习和持续优化等关键技术,实现了高效、高质量的自动化文本语料标注。系统采用模块化设计,支持灵活扩展,能够处理不同类型的文本数据,适应多样的标注需求。

weixin_49199313的博客 973

【信息科学与工程学】计算机科学与技术——第七十七篇 系统架构设计02

编号类型模型配方企业资本运作的方法/规则/条件/依据及所有的步骤(​风险处理/异常处理/危机应对关联知识法律法规和裁决依据​​由发起人(通常是知名投资人、投行或产业资本)先设立一个只有现金、无实际业务的特殊目的收购公司(SPAC),通过IPO募集资金并在交易所上市。然后在规定时间内(通常24个月)寻找一家非上市公司进行合并(De-SPAC),使目标公司迅速实现上市,规避传统IPO的复杂流程和不确定性。1.:在开曼或特拉华注册空壳公司,注入少量种子资金。2.

weixin_49199313的博客 317

transformers.js在react项目中的案例(一)- 创建项目

初始化项目 src目录下保留index.js和app.js,其余文件删除即可。// 使用vscode打开,若未配置code命令,可以手动打开。在合适的目录创建react项目my-app。// 进入my-app目录。

m0_52553940的博客 814

前端大模型入门:Transformer.js 和 Xenova-引领浏览器端的机器学习变革

通过学会Transformer.js 和 Xenova系列模型,学会如何在网页中运行大模型吧

分享有趣的、贴近生活的CS知识 5972

从零手搓中文大模型|Day04|模型参数和训练启动|我的micro大模型预训练成功跑起来啦

配置得到一个44M(0.044B)的超micro大模型,已经成功开始燃烧🔥GPU,后面会更新一下训练情况。

puppyapple的博客 1102

7 series FPGAs Transceiver Wizard IP核使用和测试

学习FPGA一段时间了,前面一直没有系统的总结,这学期把在项目中用到的IP核和一些调试过程中遇到的问题总结一下发出来,坚持下去,一起进步! 今天总结一下的GTH核的使用和测试。 软件版本:Vivado 2017.4 IP核版本:7 Series FPGAs Transceivers Wizard (3.6) FPGA:xc7vx690tfft1927 实现功能: 四路光纤数据接收,由于GTX IP...

qq_39921762的博客 1万+

惯性导航原理(九)-INS的初始对准-初始姿态确定+双矢量定姿

文章目录INS的初始对准INS初始化静基座/静态粗对准静态粗对准—加速度计调平原理加速度计调平静态粗对准—陀螺罗盘思考初始对准的影响因素双矢量定姿原理静态解析粗对准—双矢量定姿静态解析粗对准(续)其它初始对准方法精对准动对准 INS的初始对准 INS的初始对准为初始化的一部分 INS初始化 初始位置: 给定(INS没有初始位置确定的能力,例如从GPS ) 初始速度: 零(静止状态)或给定 初始姿态: 初始对准(INS有能力自己测资态) 粗对准vs. 精对准 静止状态vs. 运动状态 重要性: 失之毫厘,谬

十八与她的博客 1万+

nodejs 实现加载 huggingface local embedding model 方法

1. 需要了解transformer js 项目,这是transformer 的js版本,nodejs server端用ts代码实现,无缝集成langchain的话,需要用这个版本。需要注意,transformer支持的模型是有清单的,参考项目下的scripts/support_models.py文件,很多中文模型都不支持,如bge-large-zh,是否配置后就可以,需要确认。3.transformer 项目要加载onnx模型,不能是pytoch模型,所以,翻山越岭,还要解决这一关。

gaohongfeng1的博客 4832

3D识别建模 — 基于ReconstructMe和EAGLE EYES SCANNER的实现

3D实体识别建模,作为3D打印反向工程的一个重要环节,今天就让我们利用ReconstructMe和EAGLE EYES SCANNER来了解一下。 第一步、软件和硬件准备就绪 ReconstructMe下载并安装 http://reconstructme.net/?wpdmdl=160 EAGLE EYES SCANNER直接将相应USB插入电脑接口即OK,之后在    中点击搜索“设备管理...

qq_40013290的博客 882

Transformers.js v2.6 现已发布

???? 新增了 14 种架构在这次发布中,我们添加了大量的新架构:BLOOM、MPT、BeiT、CamemBERT、CodeLlama、GPT NeoX、GPT-J、HerBERT、mBART、mBART-50、OPT、ResNet、WavLM 和 XLM。这将支持架构的总数提升到了 46 个!以下是一些示例代码以帮助你入门:文本生成(MPT 模型):import{pipeline}from...

Hugging Face 887

解决RocketMQ中@Bean配置DefaultMQProducer时的MQClientException问题

本文针对Spring Boot整合RocketMQ时,因在@Bean配置中手动调用DefaultMQProducer的start()方法而引发的MQClientException问题,深入剖析了其根本原因在于生命周期管理冲突。文章提供了简洁有效的解决方案——移除手动启动,让Spring容器自动管理,并给出了完整的配置示例与生产环境最佳实践。

rnn9storyteller的博客 690

9 硬件工程师笔面试高频知识考点真题解析——运算放大器

运算放大器(运放)摘要 运放是一种高增益、差分输入的模拟集成电路,具有虚短(线性区输入电压相等)和虚断(输入电流为零)特性,支持负反馈(线性放大)和开环/正反馈(饱和区比较)两种工作模式。关键特性包括高输入阻抗、低输出阻抗,理想运放参数(如无限增益)与实际参数(如有限带宽)的差异。 选型要点: 信号特性:直流/低频信号关注失调电压(Vos)、温漂;高频信号侧重带宽(GBW)和压摆率(SR)。 电源条件:单/双电源供电、电压范围及功耗需求(如电池设备需低静态电流)。 精度与噪声:微弱信号需低噪声运放,高精度场

XU157303764的博客 1677

Transformers.js 使用教程

Transformers.js 使用教程 项目介绍 Transformers.js 是一个基于 JavaScript 的开源库,旨在让开发者能够在浏览器中运行预训练的机器学习模型。这个项目由 Hugging Face 提供支持,使得前端开发者能够轻松地集成和使用各种先进的自然语言处理(NLP)模型。 项目快速启动 安装 首先,你需要通过 npm 安装 Transformers.js: npm in...

gitblog_00227的博客 582

vue2/3 - 详细实现内网使用离线百度地图功能,百度地图如何离线加载详细教程(内网部署及使用),在vue中无需网络离线使用百度地图相关功能,提供最新完整的瓦片资源下载及相关工具(示例代码,一键复制

vue,vue2,vue3,百度地图,离线使用百度地图,百度地图瓦片官方下载,vue内网使用百度地图离线无网络,断网情况下使用百度地图,vue离线百度地图教程,如何实现内网部署百度地图,无需联网离线使用,vue+ts实现离线百度地图 内网离线百度地图,如何在百度地图Vue项目中下载离线地图,百度离线地图加载不出来,百度地图离线使用不显示怎么办,怎么解决vue内网使用离线百度地图加载失败问题,vue实现离线地图+百度瓦片,vue引入百度离线地图,vue项目如何使用离线百度地图和自定义地图样式,百度离线地图的下

✅ 精选推荐文章 1万+

Web + Ai 实现图像识别(JS)

通过本教程,我们学习了如何使用 JavaScript 和 Transformers 库来实现图像对象检测的功能。我们使用了一个预训练的对象检测模型,并将其集成到网页中,通过简单的上传图片操作就能实现对象检测,并在图片上标注检测到的对象。这个示例展示了如何利用现有的工具和库来快速实现复杂的计算机视觉任务,为开发者提供了一种简单而有效的方法来处理图像数据。

mini_malism_的博客 2462

Claude Code 错误解决方案 使用策略拒绝 Usage Policy refusal

摘要:本文分析了Claude Code API请求被拒绝的问题,当违反Usage Policy时会显示错误提示。根因包括请求内容违规、模型敏感度差异或历史消息影响。解决方案包括修改请求措辞、切换至Sonnet 4.5模型或开启新会话。文章详细追踪了错误链路,提供了核心代码分析,并给出验证方法和最佳实践建议,帮助用户避免触发API拒绝机制。

多媒体编程、网络编程、系统编程、网络安全编程、驱动编程 990

用 CDS 作为 Referenced Data Source 开发 SAP Gateway OData 服务,一条更轻的 SEGW 路线

本文介绍了SAP Gateway项目中从传统手工建模到基于CDS View的现代化开发方式转变。主要内容包括: 传统方式需要在SEGW中手动创建Entity Type、Entity Set等元素,并在DPC_EXT中编写大量查询逻辑,存在模型层和业务逻辑重复表达的问题。 7.50版本后,SAP Gateway与ABAP CDS深度集成,可通过SEGW直接引用CDS View作为数据源,自动生成数据模型和SADL读取逻辑,支持完整的OData查询功能。 最佳实践建议通过Consumption View而非直接

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 707
上一篇: 上交2024最新-《动手学大模型》实战教程及ppt分享!
下一篇: Embeddings入门详解!手把手带你训练
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值