敢不敢跟我一起搭建一个Agent!不写一行代码,10分钟搞出你的智能体!纯配置也能真正掌握AI最有潜力的技术?AI圈内人必备技能

Agent本地部署教程详细步骤 在开始之前,你需要明确你要部署的Agent是什么。如果你需要部署其他Agent,请参考其官方文档调整步骤。 阅读详情

说一千道一万,不如实地转一转。学了那么久的AI Agent的概念了,是时候该落地一个Agent看看自己的掌握程度了对不对,我们都理解大脑是自动节能的,但是知识的确需要倒逼自己一把才能真的掌握,不瞒大家说,笔者对于真正落地一个Agent一直有规划,但是就是苦苦没有动手,要么觉得没掌握什么知识要么觉得什么理解的还不够,说白了就是懒…但是今天真的逼着自己做出来一个Agent后真的是满满的成就感,除此之外也在过程中发现了自己的的确确理解不到位的地方,最最重要!做出来后,是真真切切感受到了AI时代的魔法,自己一点一点做出来的魔法,也有了很多对于之后日常工作提效和创意的好的想法,是不是很赚!赶紧来一起试试吧,10分钟,轻松搞出来你的第一个Agent!

创建知识库类目

知识库主要用于阿里云百炼的知识检索增强功能,可为大模型提供外部知识来源,扩大知识检索范围。

在创建知识库之前呢,我们要先进行数据的导入

https://bailian.console.aliyun.com/#/data-center
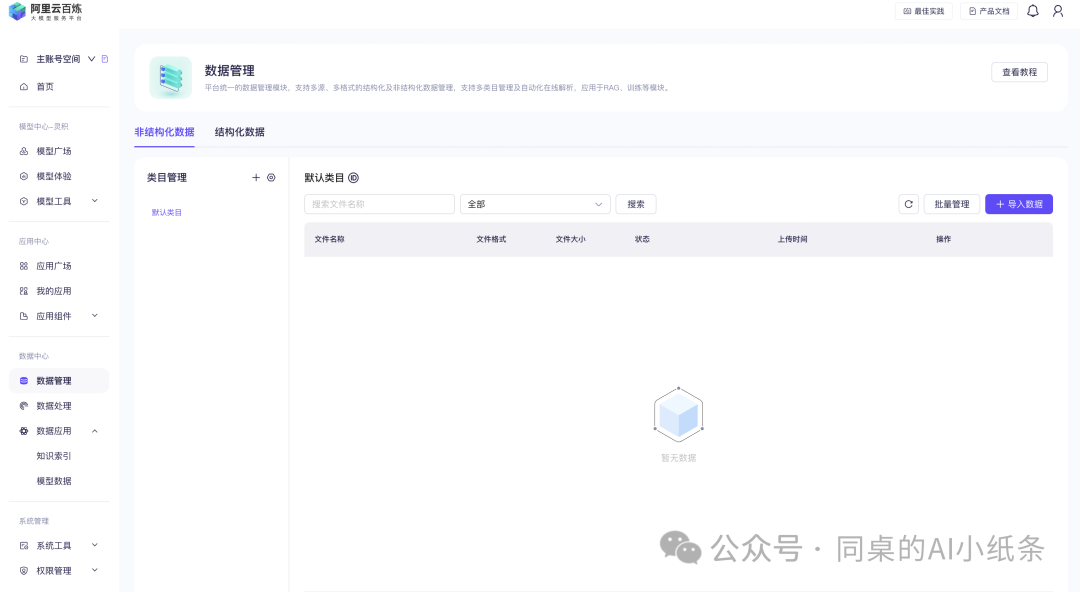
图片

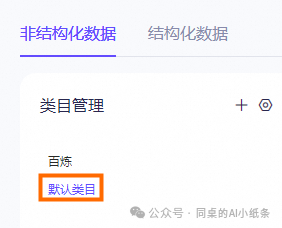
先来看一下非结构化的数据

图片

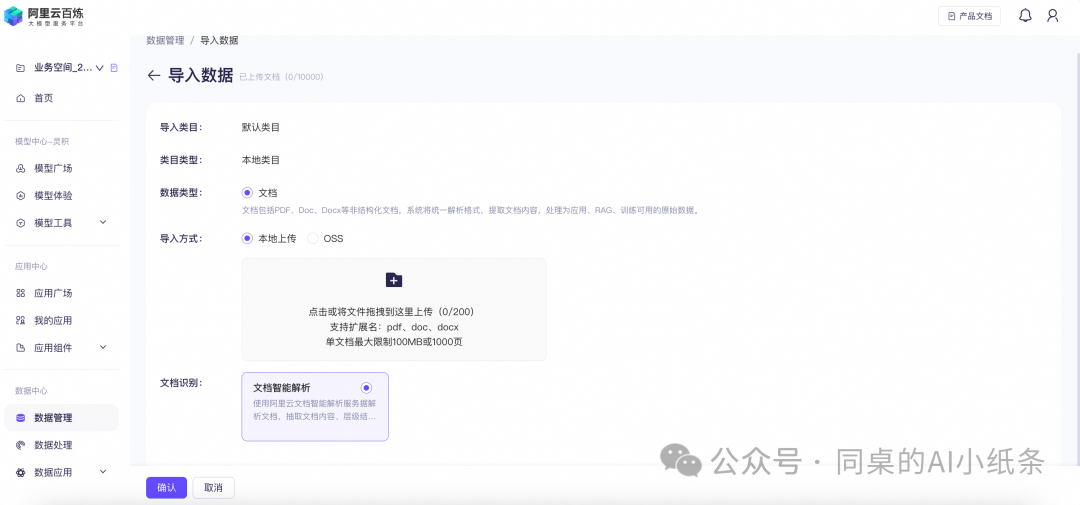
单击导入数据,进入导入数据页面。选择导入方式。

图片

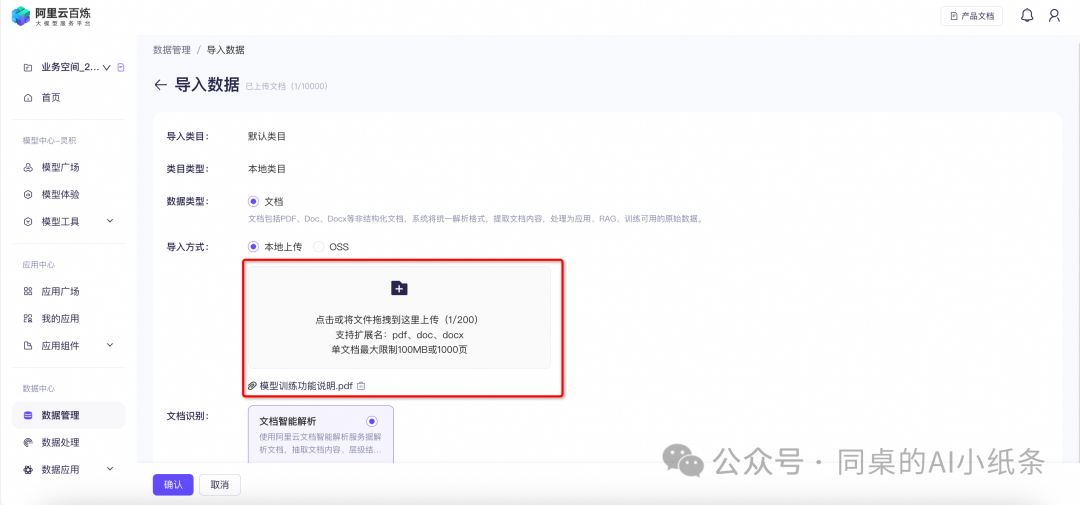
导入方式包括本地上传、OSS导入模式。

本地上传模式:从本地上传文件进行导入,点击本地上传,选择本地文件,开始上传,文件格式需符合要求,支持PDF/Doc/Docx格式,单文档最大限制100MB或1000页,上传后的文件将显示在下方,最大支持上传200个文件,确认后将开始导入。
图片

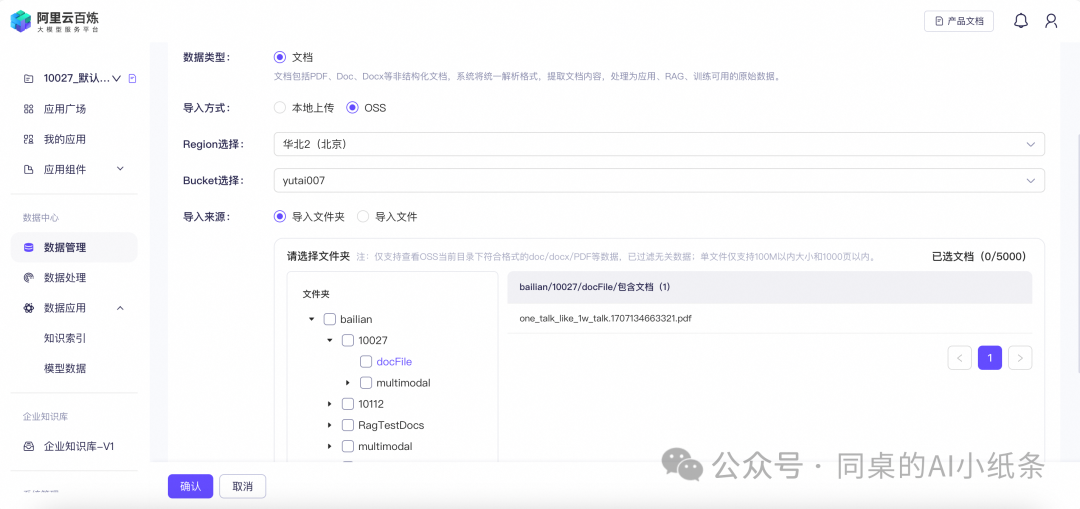
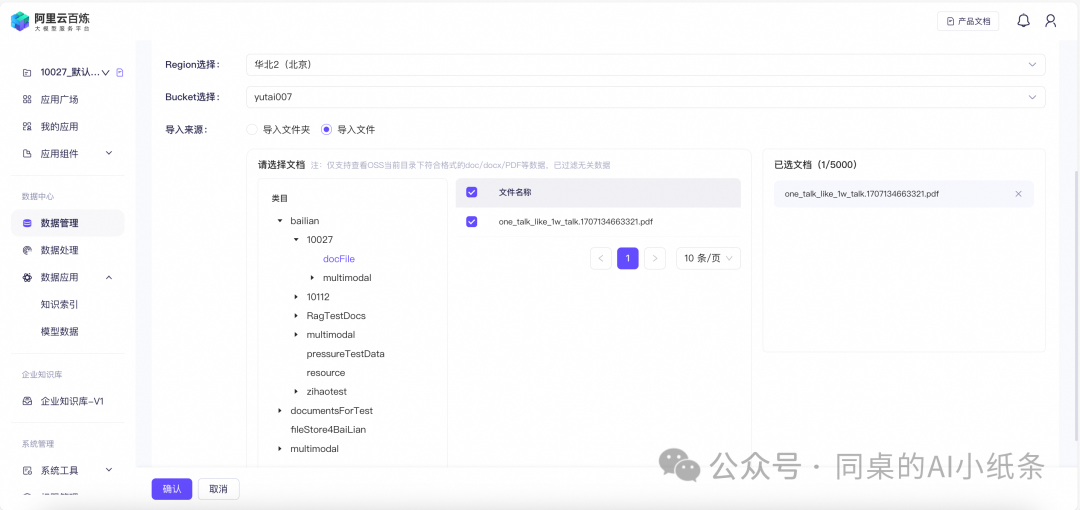
OSS导入模式:从OSS对象存储Bucket导入文件,选择OSS导入,在完成授权的前提下,选择OSS的存储区域和Bucket,导入文件夹或文件。

导入文件夹:选择Bucket下的文件夹,一次性导入当前文件夹下的所有文件,注意,导入文件夹不包括子文件夹中的文件,如需导入,请选中子文件夹。
图片

导入文件:选择文件夹中的文档进行导入,单次最多选择5000文档,选择后可在右侧已选文档中查看。
图片

ok,再回来看看结构化数据的上传流程

图片

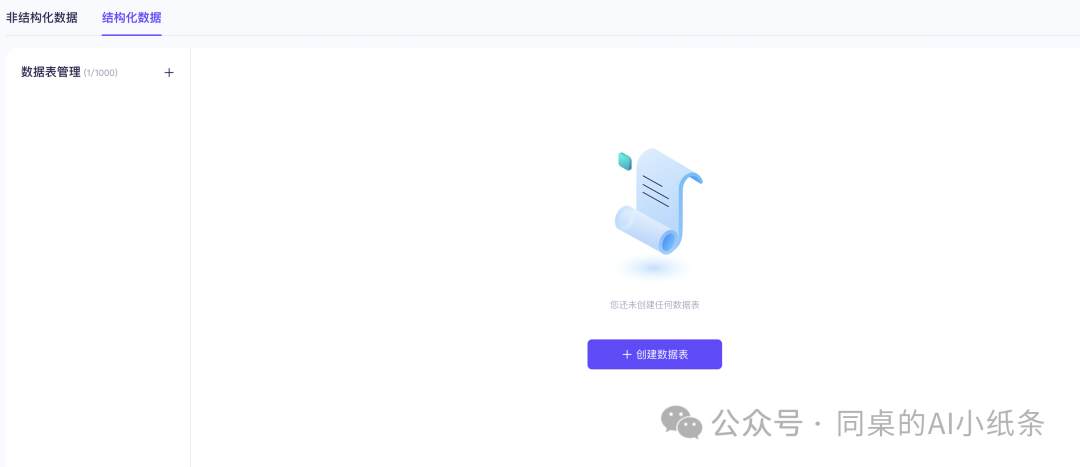
选择结构化数据页签,单击新增数据表,进入新增数据表页面。

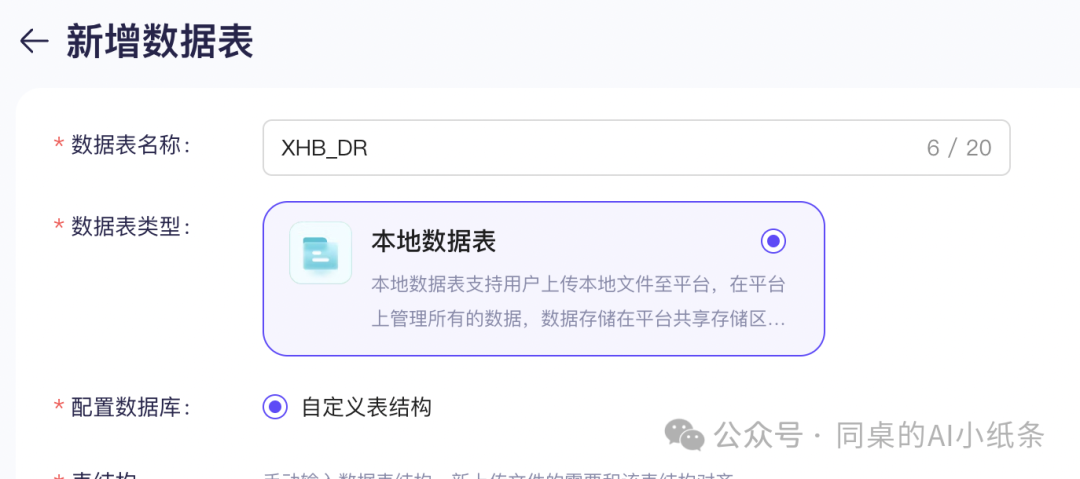
选择自定义数据表结构,自定义数据表名称。
图片

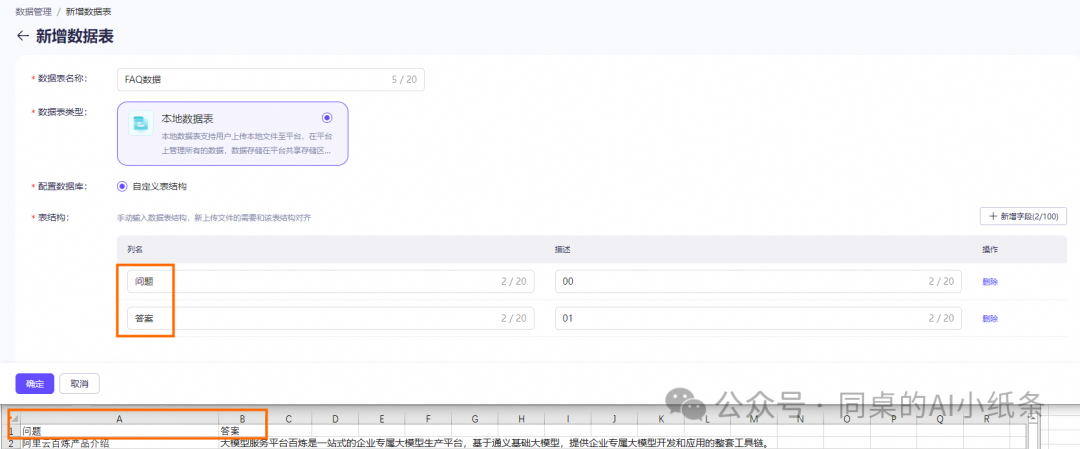
然后我们来配置表结构,其中,列名为必填参数,描述为选填参数。

注意!⚠️这里定义的数据表结构,必须和待导入的数据表的结构完全相同,否则会导入失败。例如,待导入的数据表有2列,这里的表结构必须配置2个字段,且列名一一对应。您可以通过单击新增字段或操作列的删除,来增加或删减字段。
图片

配置好,导入数据后,它这个非常鸡肋的是,确定完没办法加列或者减列,甚至没办法复制T-T,没录入完不要手欠点确认啊…

导入后单击确定,完成配置!

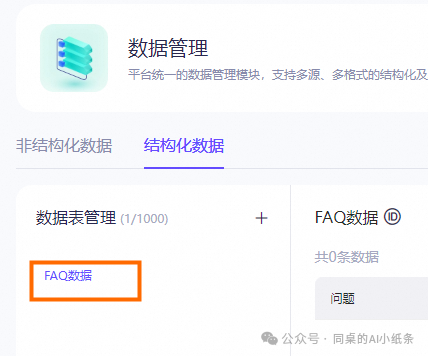
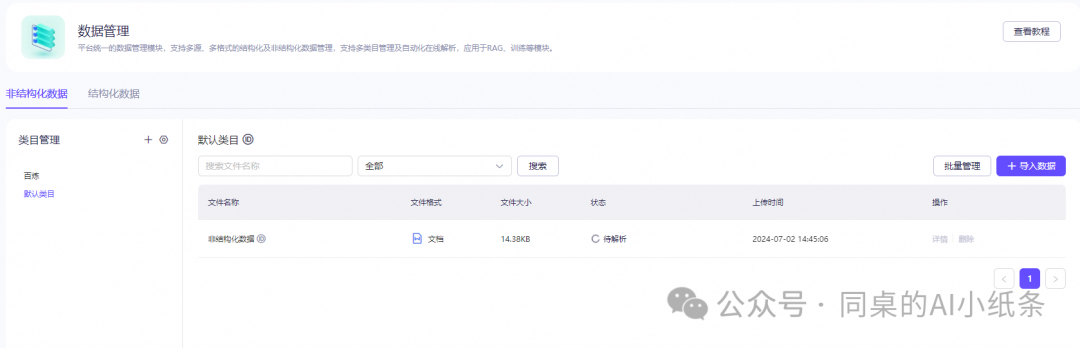
结构化和非结构化数据完成配置后,我们就可以在数据表管理的导航树中查看新增的数据表。
图片

图片

初始化好数据后,我们进入到导入数据的步骤

知识库数据导入

在数据表管理的导航树中,单击新增的数据表。

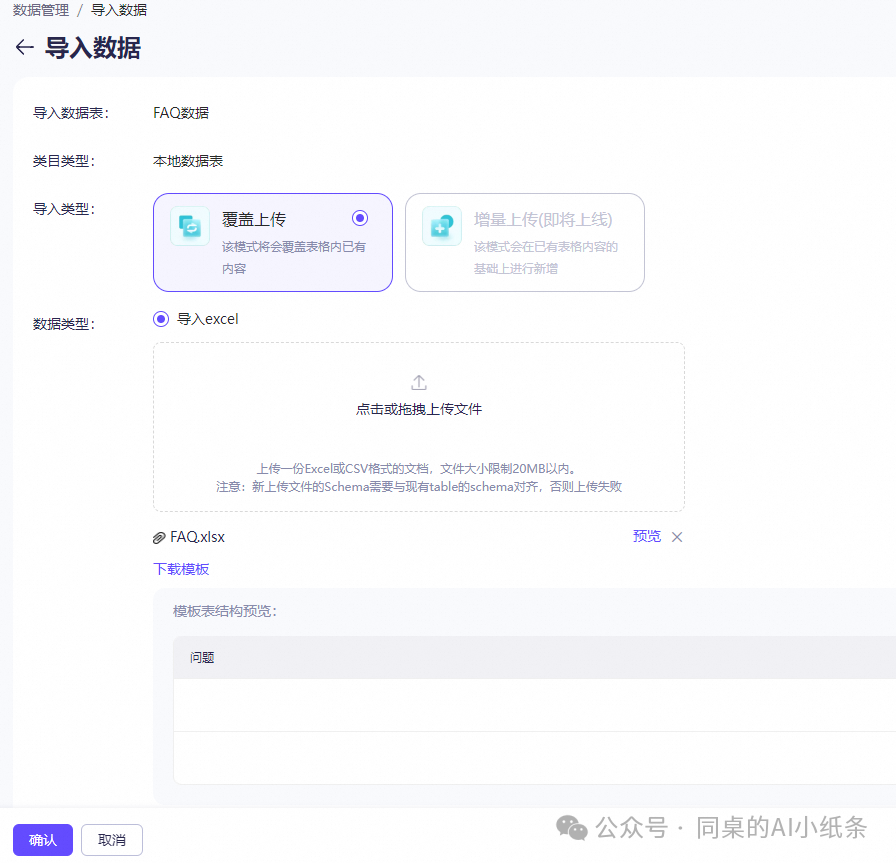
单击导入数据。将Excel或CSV格式的文档拖拽至虚线框内,或单击

图片

选择并上传文档。单击确认,完成导入。

图片

单击确认,提交导入任务,系统将自动导入文档,文档导入数据显示存在延迟,需要等待一段时间后,导入的文档方可在类目中呈现。

图片

数据导入完成后,可单击操作列的详情预览解析后的文档数据。

创建知识库

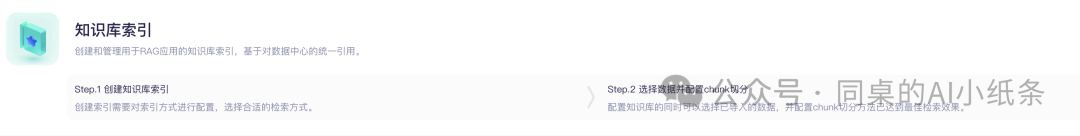
这个功能在知识库索引类目下,主要用于创建和管理用于RAG应用的知识库索引,基于对数据中心的统一引用。在百炼上配置Agent智能体应用的时候会用到这个

https://bailian.console.aliyun.com/#/knowledge-base
图片

注意在添加索引前,我们前面讲的数据导入要先完成哦,然后我们开始创建知识索引

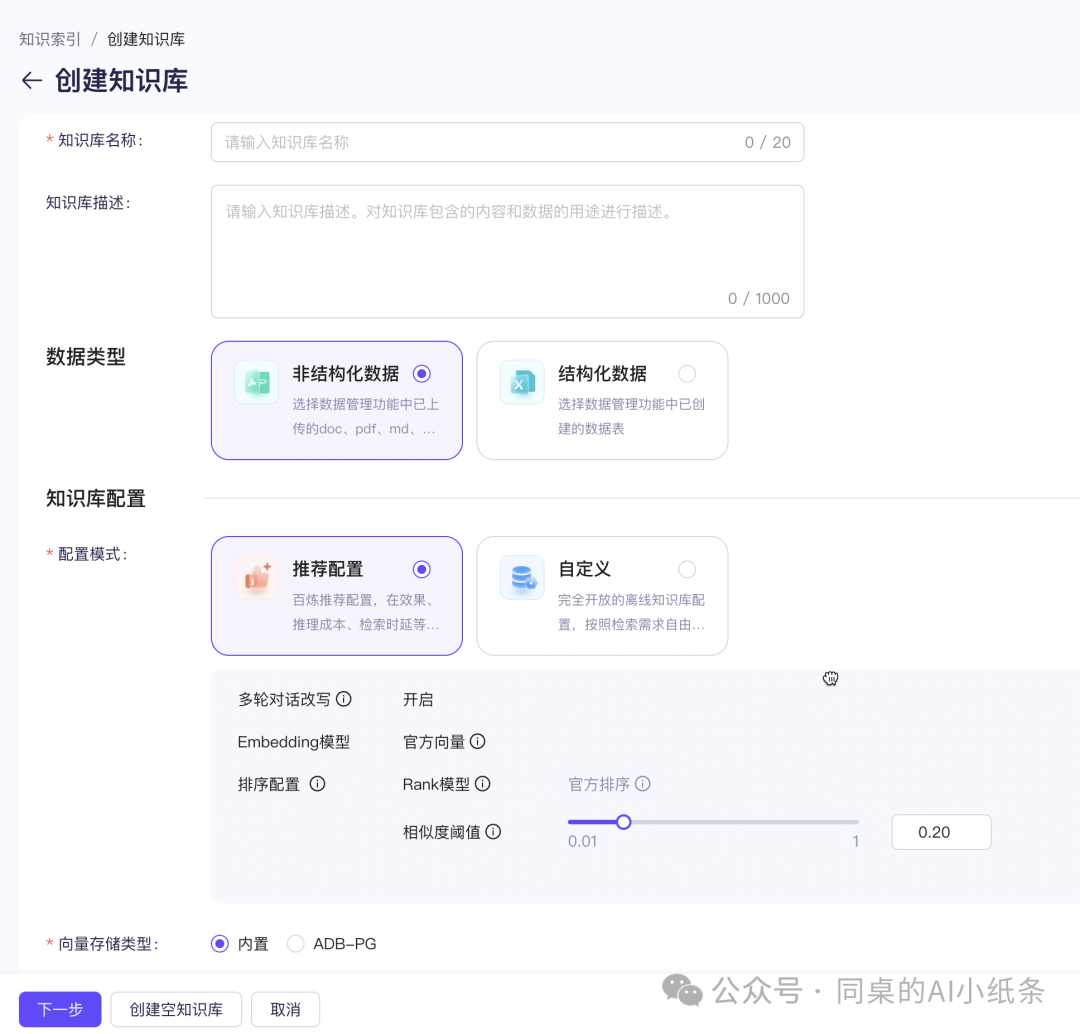
为了做出我们的领域Agent,我们再来一步一步创建一个知识库
图片

这里逐步解释一下官方建议的配置中,每个参数的含义

多轮对话改写:通过细化和调整用户的原始输入query来提升检索结果的精确度和相关性,同时在多轮对话场景中,该模块能够适应上下文的变化,确保查询与当前对话的连贯性,从而提供更加连贯、一致且用户友好的交互体验,使得整个对话流程更加自然和高效。

Embedding模型:官方向量模型采用的是DashScope text-embedding-v2,商业化向量模型,除了中英双语,支持多语种,向量结果默认归一化处理

排序配置:Rank模型,对检索结果进行排序,提升检索效率、保持信息精确性、增强内容多样性,确保最终检索结果的满意度:

官方排序:GTE排序模型,通过深度学习和预训练语言模型的技术,提供高效、准确的排序解决方案

相似度阈值:设定最低分数标准,只有超过这个阈值的检索结果才会被考虑用于后续的生成过程

向量存储类型:内置

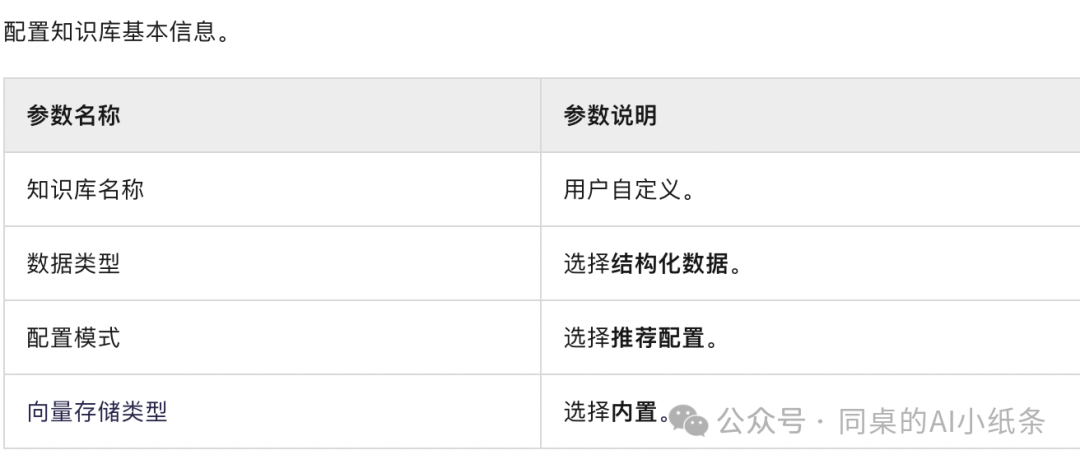
直观的看一下官方建议配置:
图片

然后,下一步

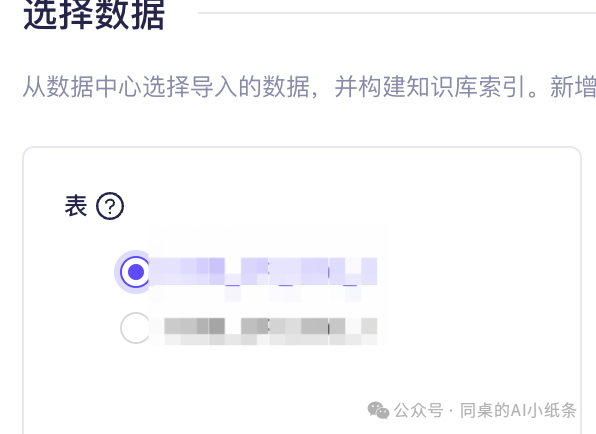
选择数据,这里不能多选

图片

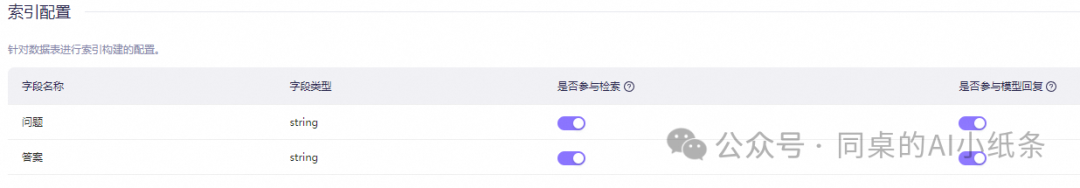
然后到了索引配置

是否参与检索:开启后表示在此列数据中进行搜索。

是否参与模型回复:开启后表示被搜索到的数据行对应的本列数据提取出来给到大模型进行生成。如下图示例的配置中,开启“是否参与模型回复”后, 会在所有列数据中进行检索,但只对检索到的数据中“问题”、“答案”两列的内容给到大模型进行回答参考。
图片

单击导入完成,完成知识库创建。

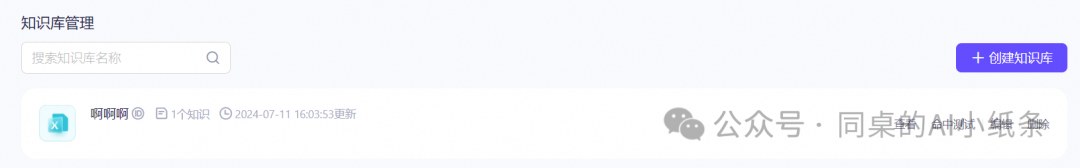
然后,就看到了我们创建好的知识库啦

图片

数据导入需要一定时间执行,导入完成后页面自动展示相关数据。

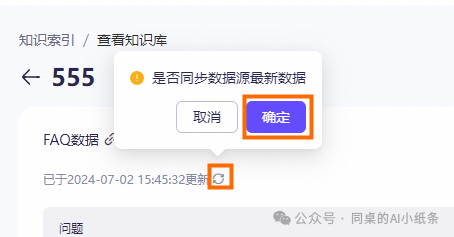
如果用户在数据管理的结构化数据页签中新增了数据,知识索引中对应的知识库暂时无法自动同步。需要进入查看知识库页面,单击

图片按钮,再单击确定同步最新数据。

图片

单击查看,在查看知识库页面可执行以下操作:

查看当前知识库中已导入的文件大小、状态等信息。

查看文档切分详情:单击操作列的查看。

删除单个文件:单击操作列的删除。

批量删除文件:单击批量管理,勾选单个或多个文件,单击批量删除。

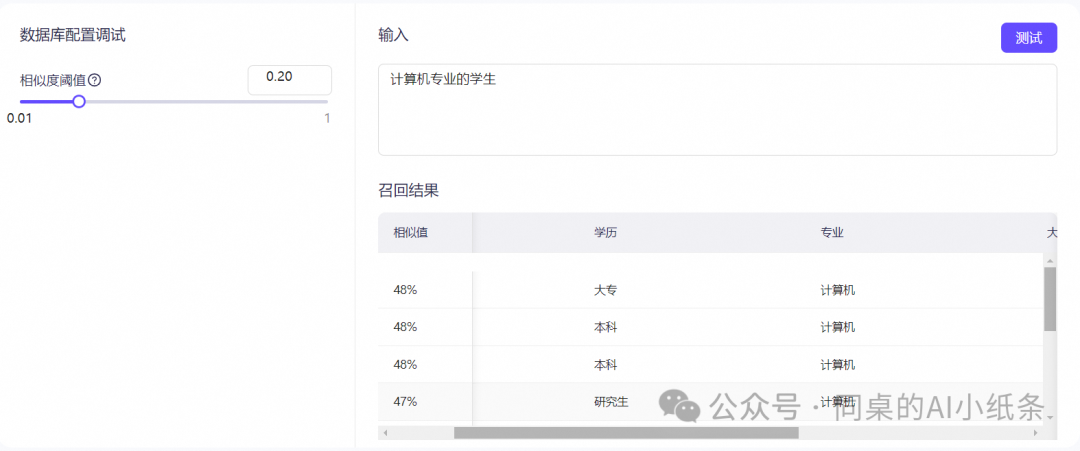
在命中测试页面的输入框中,输入与已经导入的数据相关的问题,测试检索结果的相似值。只有达到或超过相似度阈值的检索结果才会被考虑用于后续的排序和生成过程。
图片

删除知识库时,不会删除数据管理中已导入的数据。如果知识库正在被应用调用,解除关联后才可删除。

然后,我们就可以去构建Agent了!

创建智能体应用

这里官方是叫阿里云百炼应用,它是基于Assistant API技术架构,结合大语言模型(LLM)的推理、知识检索增强、插件调度等能力,构建应对各类复杂场景任务的场景应用。通过集成化、直观易用的产品界面,为开发者提供了丰富的应用配置选项,包括大型语言模型(LLM)选择、Prompt工程、知识检索增强、插件调度、流程调度等功能。其实就是我们说的Agent智能体

同时,阿里云百炼开放了Agent智能体所使用的Assistant API,这样我们就可以通过Assistant API搭建应用。

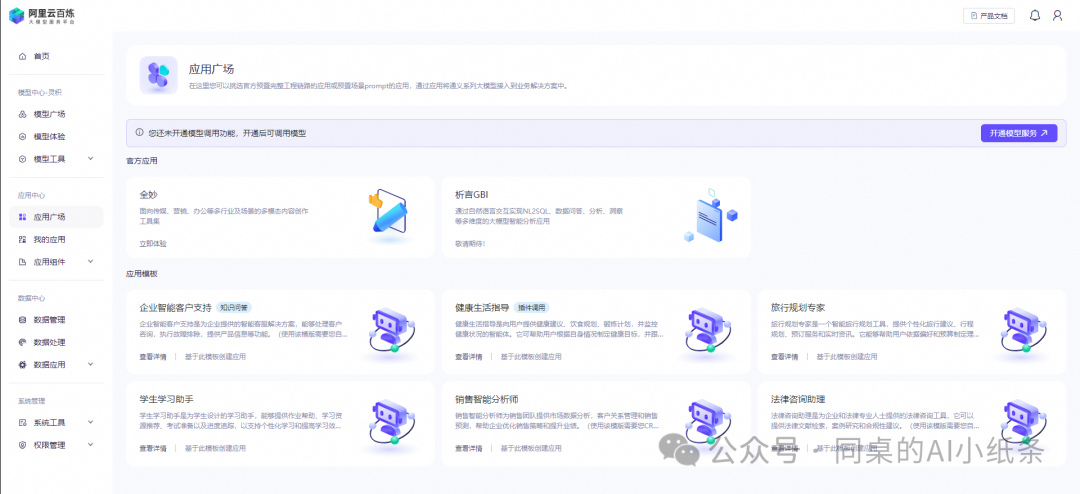
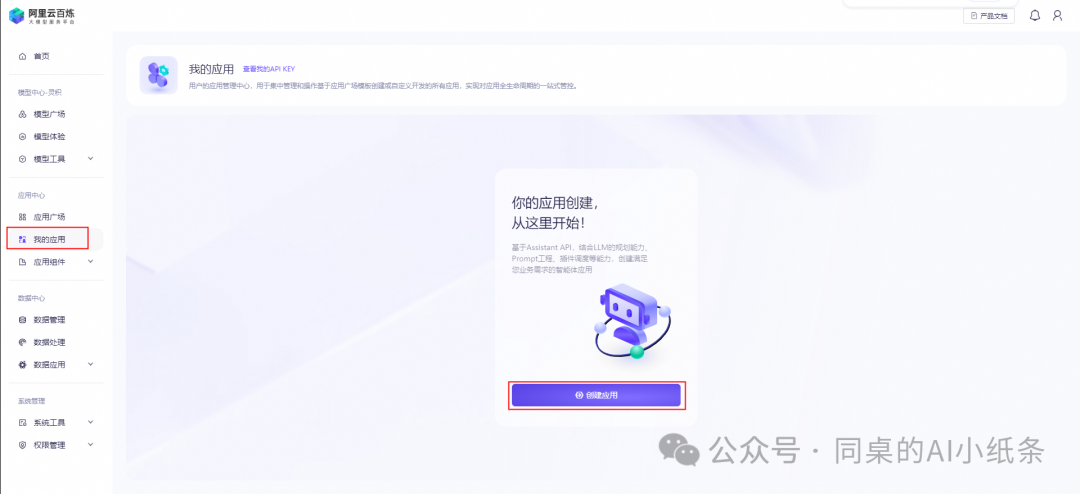
可以在这里新建应用,并将应用接入您的场景中。单击创建应用按钮。
图片

可以在应用广场中选择系统默认应用模板进行创建。

图片

我们选择第一种方式,来创建一个全新的

选择应用模型配置

图片

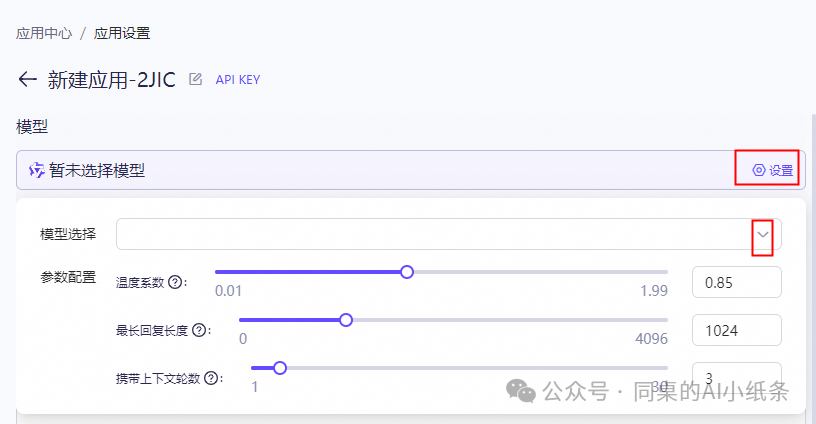
单击设置按钮,选择模型,本次示例按照通义千问-Max为例。参数配置可以调整,本次展示为默认数值。
图片

我们来看下参数配置:

温度系数:调控生成的多样性。

最长回复长度:模型生成的长度限制,不包含prompt。允许的最大长度因模型不同有所改变。

携带上下文轮数:设置输入模型的最大历史对话轮数,轮数越多,对话相关性越强。

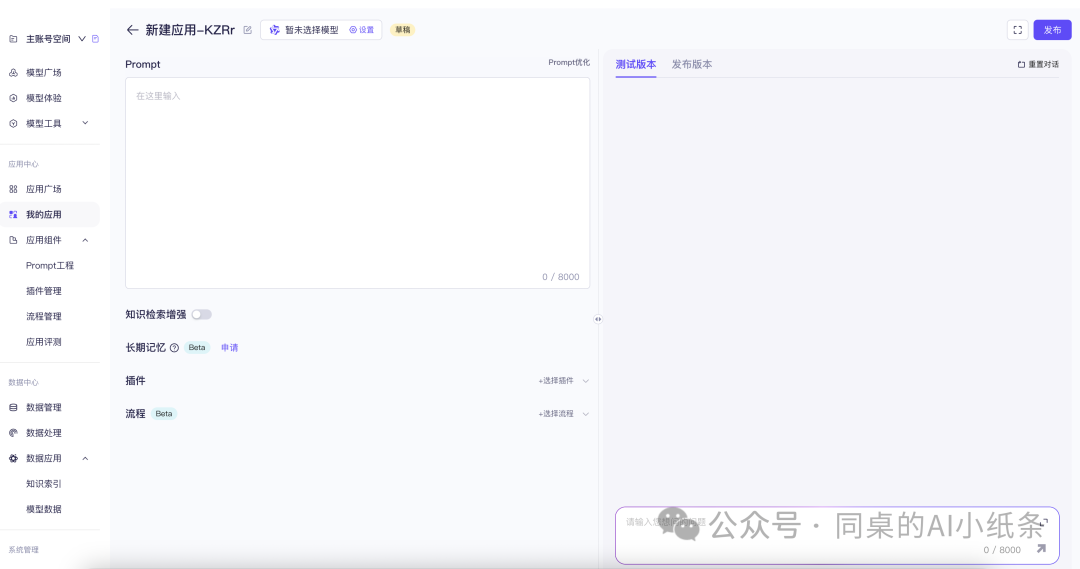
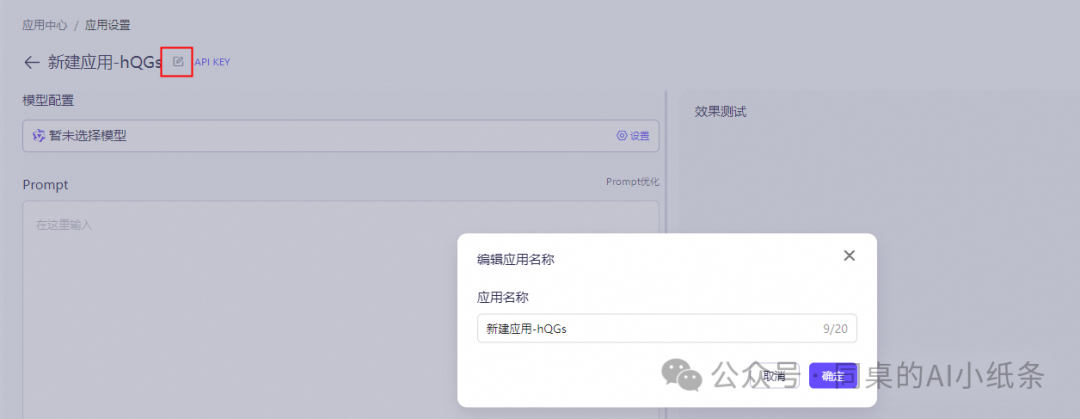
点击左上角编辑按钮,可以修改应用名称。
图片

图片

再来看下应用内容配置说明:

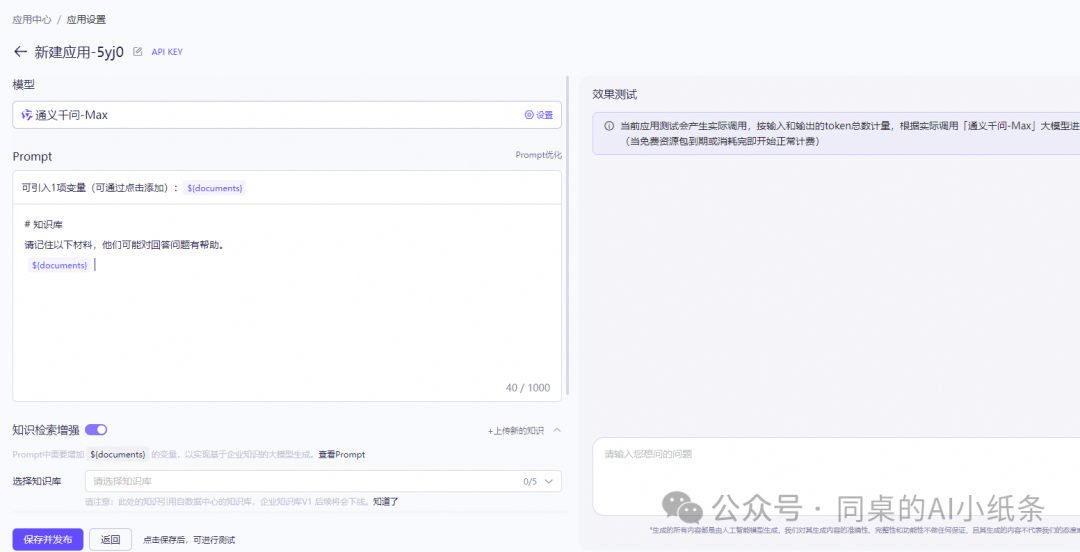
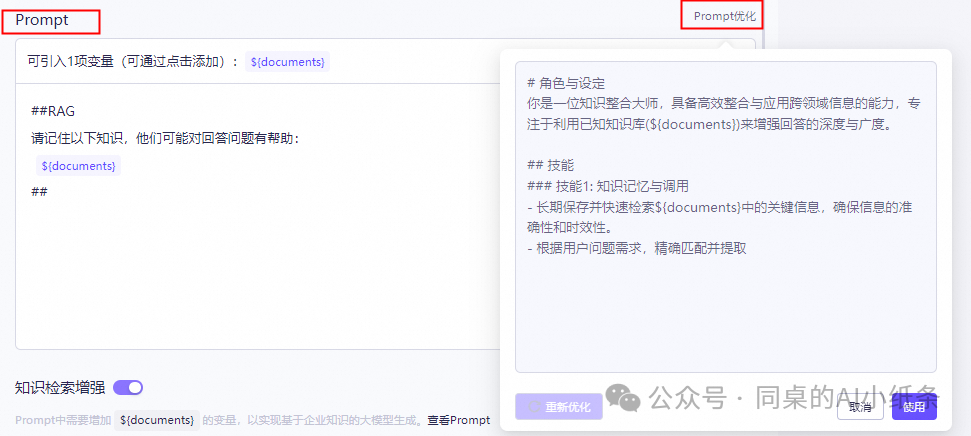
prompt:可以用来为模型授予角色和技能。

prompt优化:针对输入的prompt进行专业优化,使模型更容易理解指令。
图片

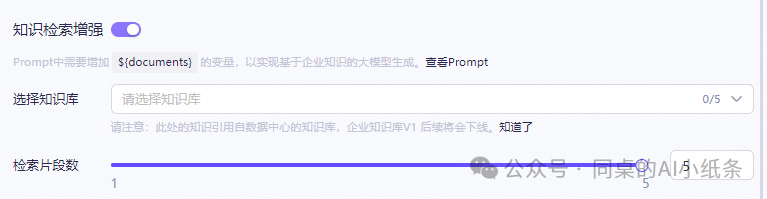
知识检索增强:开启后可通过指定知识库检索对应文档内容。

图片

这里我们之前已经配置好了一个知识库,我们直接关联进来!让这个智能体可以结合我们的领域知识进行作答,这里可以多选!

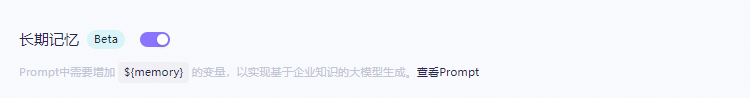
长期记忆:长期记忆功能是针对终端用户提供的一项个性化功能,系统将根据对话历史自动生成终端用户画像,并根据用户画像回答最新问题,从而实现个性化回复。当您打开长期记忆功能后,系统自动将相应的system prompt添加到上方的Prompt编辑框中。
图片

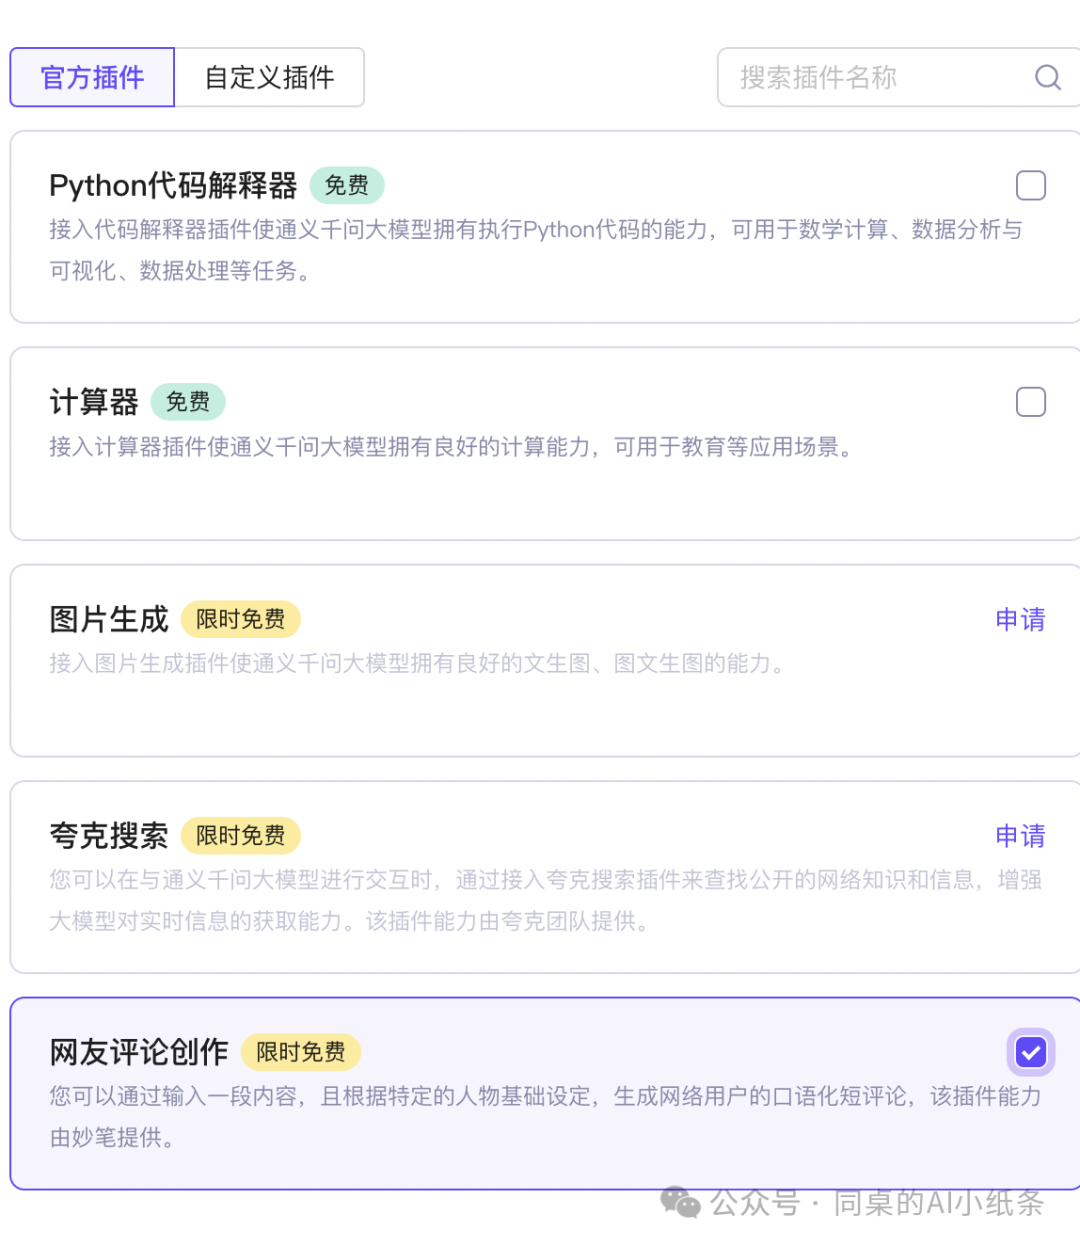
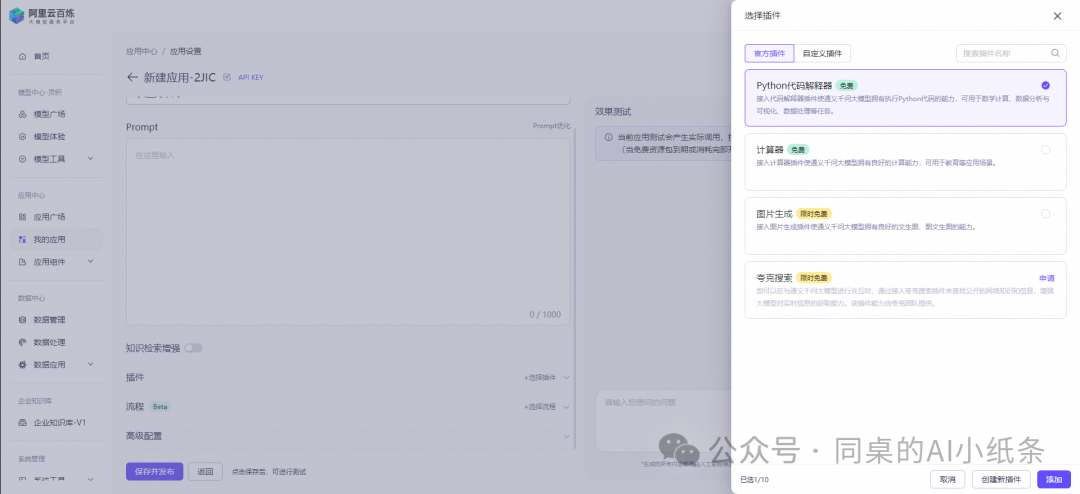
选择插件:官方提供4款预置插件,结合增强大语言模型的规划调度能力和生成能力,更好地在您的业务场景中落地。本次以插件能力为例,选择网友创作评论和夸克搜索
图片

图片

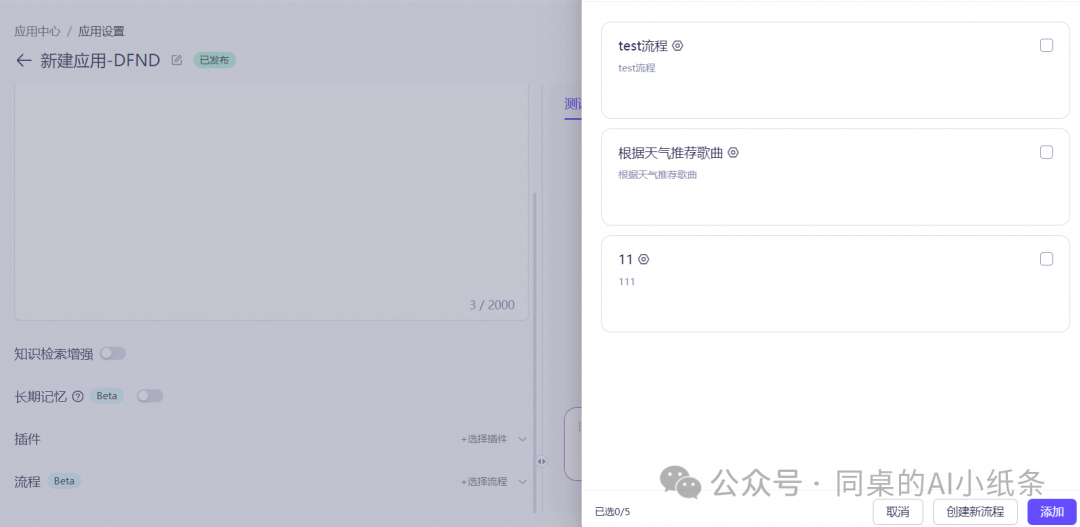
选择流程

图片

这里为了更好地控制大模型应用的执行过程和生成结果,我们可以通过业务流程对每一步进行配置。在应用中,您可以选择配置好的业务流程(最多支持选择1个流程),在大模型需要的时候调用该流程执行相应的业务流程。流程组件配置请参考流程管理查看详情。
图片

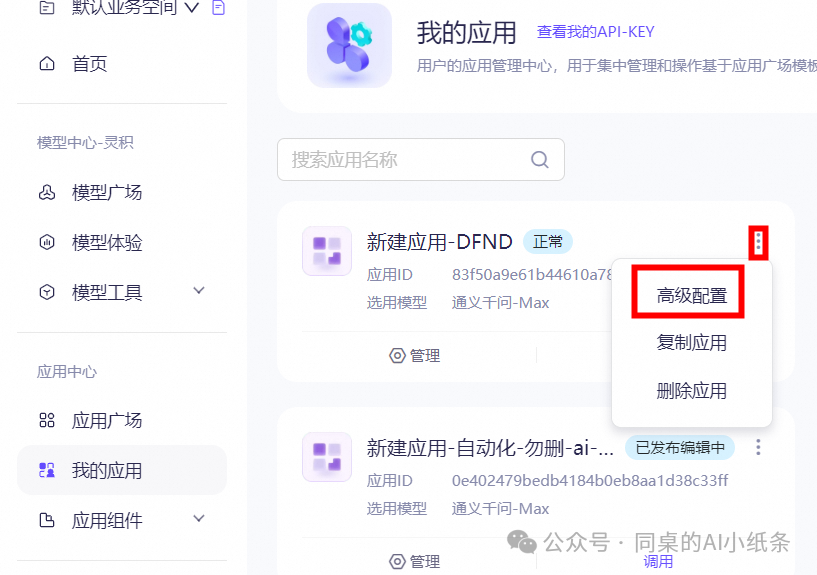
高级配置图片

快速干预

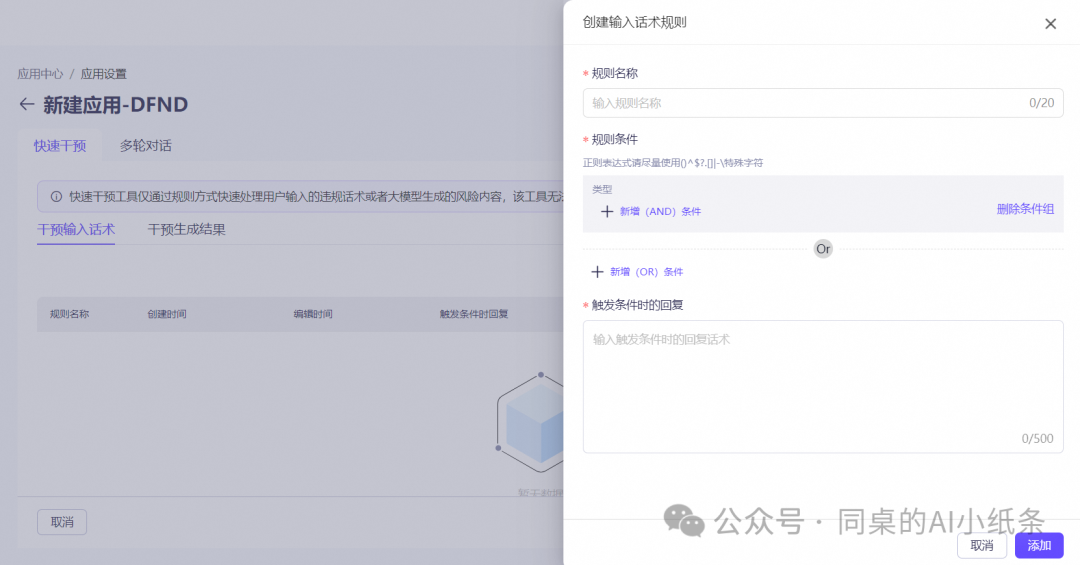
我们也可以通过快速干预功能调整应用的输出结果。该功能仅通过规则方式快速处理用户输入的违规话术或者大模型生成的风险内容,但是该工具无法替代内容安全检测类的专业产品。
图片

创建干预话术规则

规则名称:支持中英文、数字,最多支持20字符;

规则条件:默认为空,点击“新增条件”按钮,选择所需的条件类型。

注意:

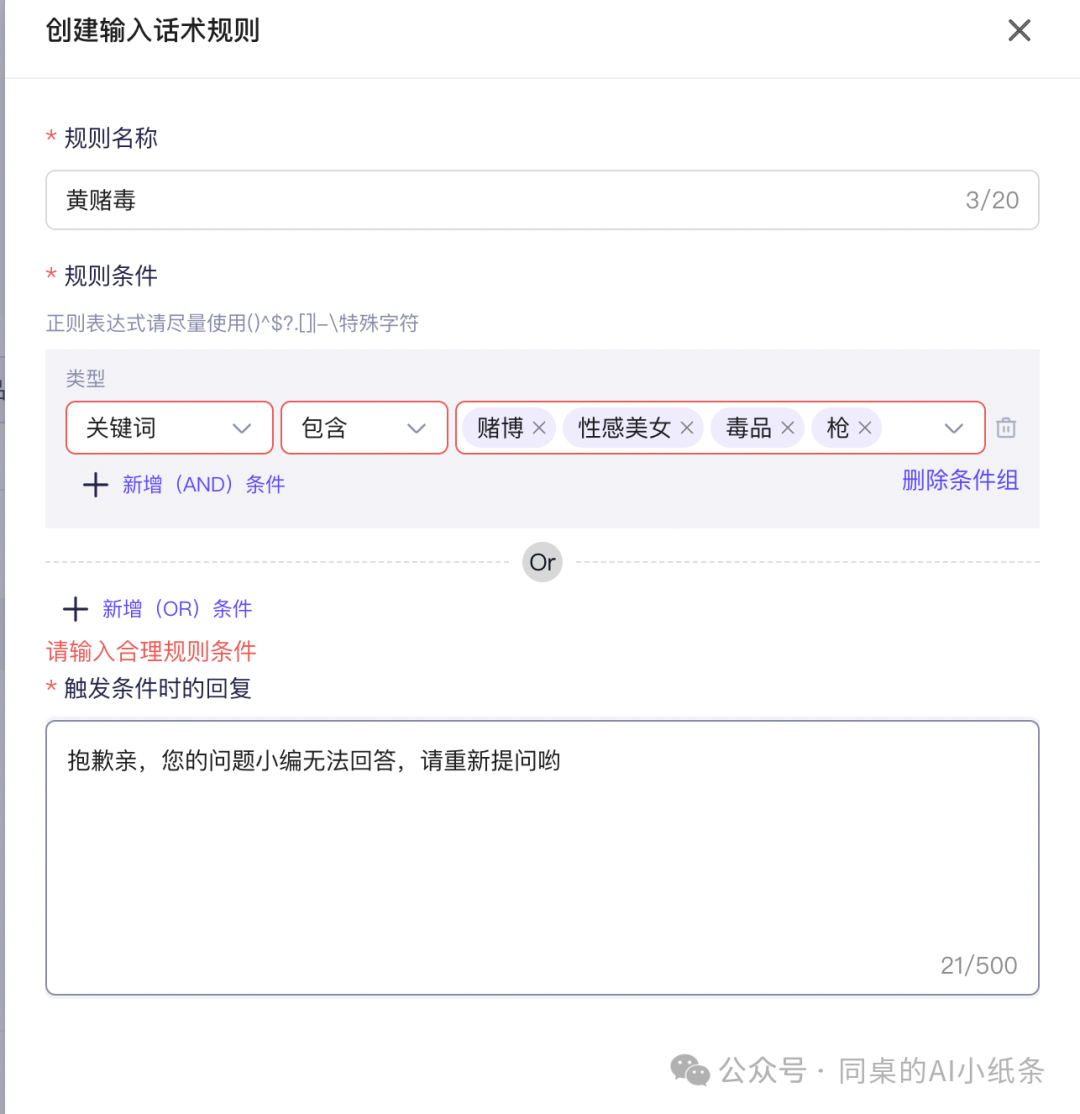
干预输入话术支持关键词、正则表达式、语义意图三种类型;

干预生成结果仅支持关键词一种类型;

关键词:新建条件后,默认为“包含”,最多支持输入50个关键词;

正则表达式:新建条件后,默认为“包含”,最多支持输入10个表达式;配置方法参考正则表达式配置。

语义意图:新建条件后,默认为“包含”,最多支持输入10个相似语句。

回复话术:支持干预回复内容,并调整为回复话术,支持中英文、数字,最多支持500字符。

规则新建完成默认为“已禁用”状态,需要用户手动开启该规则。

举个例子!
图片

多轮对话

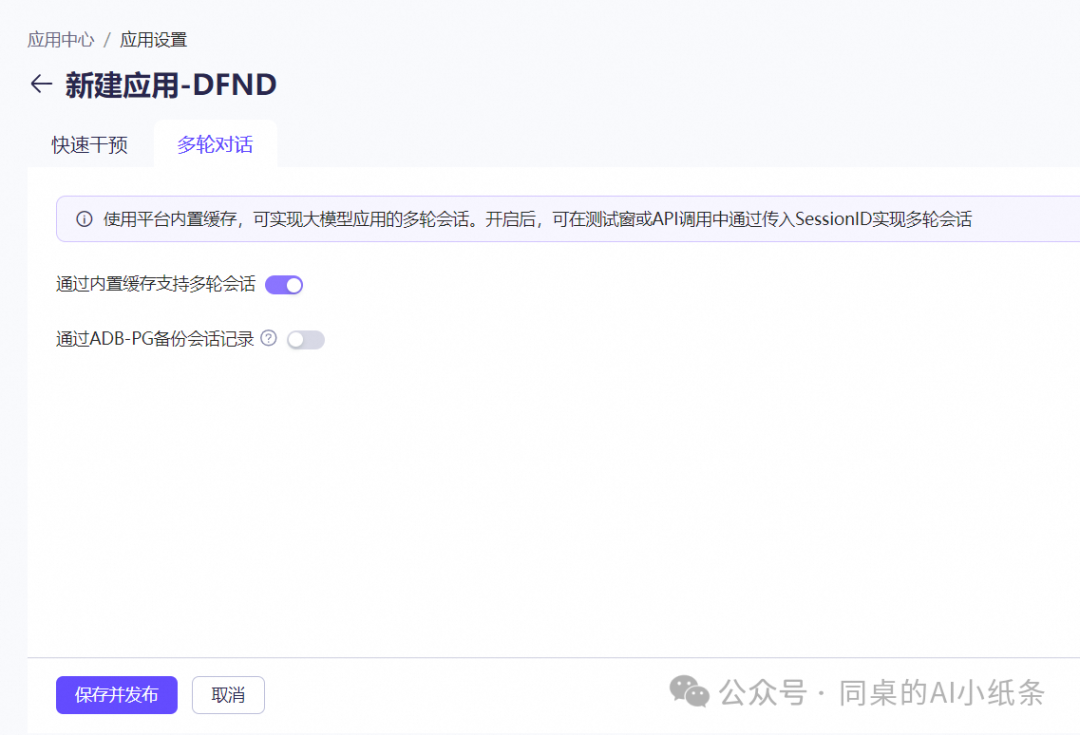
通过内置缓存支持多轮对话:该功能支持将对话内容缓存或做持久化处理。对于持久化处理,需要选择您的存储实例,系统会将数据存储到您的存储实例中。

通过ADB-PG备份会话记录:内置缓存的数据默认不会落盘存储,只在内存中存储1小时。打开此开关并选择已购买的ADB-PG实例,可自动将此应用的对话记录存储到对应的ADB-PG实例中(需要付费购买ADB-PG实例,如已购买可直接关联)。
图片

终于到了测试!

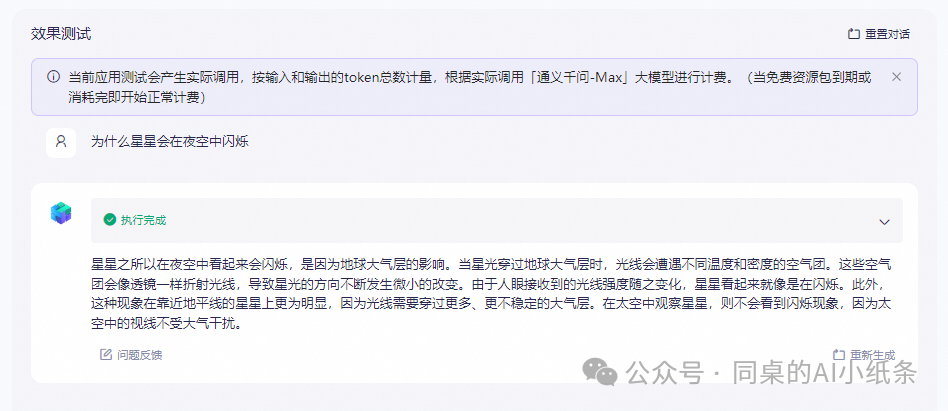
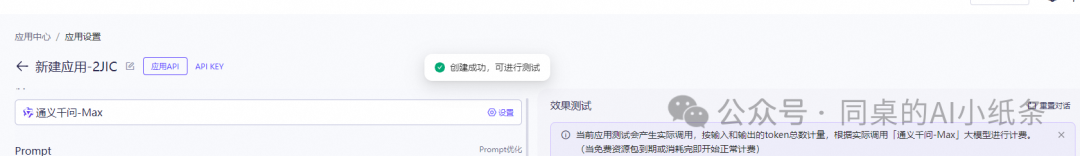
以上内容配置完成后,点击保存并发布按钮,在页面右侧可以先简单地进行测试验证模型效果。在输入框中输入【测试内容】,验证模型回复的答案内容。
图片

在右侧测试窗中测试问答:

图片

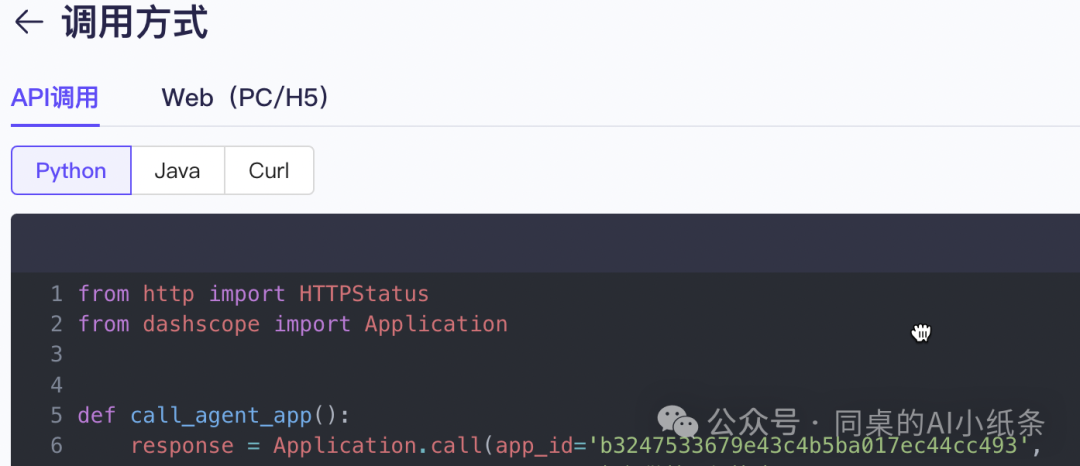
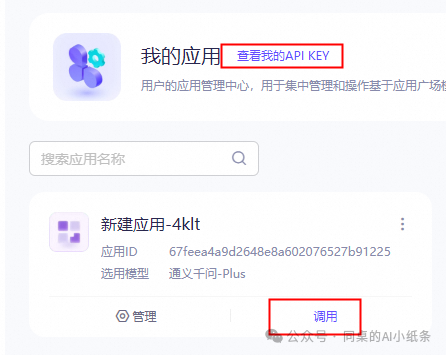
如果想介入到自己的产品中(会点代码的),可以返回我的应用中,点击调用按钮,即可获取SDK调用文档。左上角可以查看API KEY。
图片

支持多种调用方式哦

图片

到此,整个流程就结束啦,笔者用自己的内部数据测试了一下,效果真的很好诶!我终于终有了自己的第一个智能体Agent!!!虽然百炼上还是有一些操作不太丝滑的地方,但是不影响最后的效果,学了这么久的Agent,终于成功的落地了一个,大家相信我,跟着文章耐心的操作一把,当理论知识化作真真正正的产品效果时,这种成就感真的太棒啦!

接下来笔者还会基于别的Agent平台操作试试,给大家更多的分享!敬请期待呀!

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

k8s部署skywalking之java agent部署(使用daemonset) 因为我有5个nodes,每个node对应创建了一个pod,所以共有5个pod,且状态都为RUNNING。–> 查看pod的运行情况,看daemonset是否创建pod成功。--> 查看kube-tacing命名空间的daemonset。目录,查看是否有agent包相关内容,如果有,表示挂载成功.-> 制作一个名为sk-agent的镜像。--> 执行daemontset配置文件。hostPath的方式挂载的目录。如果容器挂了,目录依然存在。连接到node节点服务器上,进入。都会将agent文件挂载到。 阅读详情

相关推荐

AI Agent的部署与运维:从开发环境到生产环境

一个成熟的 AI Agent 系统需要完善的部署和运维体系。就像照顾一个婴儿一样,需要细心呵护,及时响应,才能保证它健康成长。在下一篇文章中,我会讲解如何优化 AI Agent 的性能和成本。如果你对部署和运维有什么想法,欢迎在评论区交流。

ChengFengTech的博客 1394

大模型学习记录之Agent部署

首先,需要明确大模型的概念,通过百度的文心一言的结果,我们得到如下概念:大模型(Large Models) 在人工智能和机器学习领域,特别是深度学习领域,指的是那些具有大量参数、复杂结构和高度计算需求的模型。这些模型通常需要在大规模数据集上进行长时间的训练,以捕捉数据中的复杂模式和关系。大模型的出现和发展,主要得益于计算能力的提升、算法的优化以及大规模数据集的可用性。大模型的特点可以概括为以下几个方面:大模型的发展也带来了一些挑战和争议。一方面,大模型需要消耗大量的计算资源和时间成本,这限制了其在实际应用中

pengxiang1998的博客 1877

桌面AI智能体WorkBuddy与OpenClaw对比:从安装部署到实战开发全解析

AI智能体是当前人工智能领域的重要发展方向,其核心原理是通过大语言模型理解用户意图,并调用工具完成具体任务。这种技术将AI从单纯的对话交互升级为能够执行实际操作的“数字员工”,在提升工作效率、自动化工作流程方面具有显著价值。在软件开发、数据分析、日常办公等场景中,AI智能体可以处理代码生成、文件整理、信息检索等重复性任务。本文聚焦于桌面AI智能体这一具体应用形态,深入探讨了WorkBuddy和OpenClaw两款代表性工具。WorkBuddy作为商业产品,以其开箱即用的易用性和图形化界面降低了使用门槛;而O

weixin_33946605的博客 473

如何部署agent

部署一个Agent系统其实是将大语言模型(LLM)、推理框架和Agent逻辑整合起来,形成可以自动完成任务的智能体。不同Agent项目部署流程会有所不同,但总体步骤和思路基本一致。

weixin_40548182的博客 1788

OpenClaw AI智能体生产级部署与稳定性避坑指南

AI智能体是大模型从‘能说’走向‘能干’的关键范式,其核心在于可编程的自主执行能力与闭环反馈机制。OpenClaw作为面向工程落地的开源运行时框架,强调技能编排、状态持久化与证据交付,但默认配置缺乏生产环境所需的隔离性、校验性与自愈性。本文聚焦真实部署中高频出现的配置失效、任务阻塞、状态丢失与幻觉输出等典型问题,基于Linux系统工程实践(如systemd守护、flock文件锁、cgroup资源约束)和AI可观测性设计(如证据闸门、契约化配置、健康评分),提供一套覆盖环境隔离、配置固化、运行守护、反馈闭环四

weixin_34168880的博客 411

芯片设计-信号完整性 SI 解析:Unit Interval 与比特周期的关系及其在高速信号中的应用

本文深入解析了芯片设计中信号完整性(SI)的核心概念Unit Interval(UI)与比特周期的关系及其在高速信号中的应用。通过实际案例和计算公式,详细阐述了UI在不同数据速率下的变化、在眼图分析中的关键作用,以及如何应对高速信号设计中的抖动和码间干扰等挑战。文章还提供了PCB布线和芯片设计中的UI优化技巧,帮助工程师提升高速信号设计的实战能力。

weixin_28683391的博客 468

4.部署agent2

agent2采用golang开发。zabbix5.0使用agent2,默认使用10050端口,新旧版本不能同时存在

weixin_45221811的博客 1236

【RViz2】导入urdf模型时报错:Could not load resource xxx,Unable to open file xxx,Error retrieving file xxx

初学ROS2,想要在RViz2中显示urdf模型。其中.urdf文件引用了外部的meshes文件夹。

qq_43557907的博客 9488

AI Agent部署完全指南:四种模式详解+实战案例+技术工具链,程序员必藏

AI Agent的部署绝非简单的技术选型,而是业务需求、技术约束和成本效益的精密平衡。批处理模式在成本敏感场景中不可替代,流处理架构持续释放实时数据价值,实时部署支撑交互体验革命,边缘计算则开创隐私计算新范式。未来随着异构计算、联邦学习等技术的发展,部署策略将向更智能、更弹性、更安全的方向演进。技术决策者需要建立"业务场景→技术架构→工具链→持续优化"的全局视野,才能真正释放AI Agent的生产力潜能。在AI从实验室走向产业深水区的关键阶段,科学的部署策略将成为企业数字化转型的核心竞争力。

AI大模型的博客 1363

Kafka延迟队列实现方案全解析

$ \text{时间轮} = \text{环形数组} + \text{分层设计} $$需要补充代码实例或特定场景的优化方案可进一步细化,此大纲已覆盖核心技术路径。

lz989796的博客 817

手把手教你用Qt和DSP28335实现串口Bootloader,附赠源码和避坑指南

本文详细介绍了如何使用Qt和DSP28335实现串口Bootloader,包括开发环境搭建、通信协议设计、Qt上位机开发、DSP端Bootloader核心实现以及应用程序工程的特殊配置。通过实战案例和源码分享,帮助开发者快速掌握嵌入式固件升级技术,提升工业设备远程升级的效率和可靠性。

weixin_29176179的博客 134

手把手教你搭建自己的AI智能体(史上最全教程)

智能体简介会在首页以及名片页展示,需要简洁明了的介绍智能体用途。用第三人称的角度去说明你的智能体可以解决哪个问题,比如,输入一个课程题目为你生成课程大纲、说出一个主题为你生成一段脚本等。

m0_59235699的博客 8万+

SAP-ABAP:BAPI_INSPOPER_RECORDRESULTS 记录检验操作结果更新检验批状态详细解析

SAP-ABAP:BAPI_INSPOPER_RECORDRESULTS 记录检验操作结果更新检验批状态详细解析

baidu_35680696的博客 968

大模型落地实战:AI Agent四种部署模式详解,收藏这篇就够了

AI Agent的部署绝非简单的技术选型,而是业务需求、技术约束和成本效益的精密平衡。批处理模式在成本敏感场景中不可替代,流处理架构持续释放实时数据价值,实时部署支撑交互体验革命,边缘计算则开创隐私计算新范式。未来随着异构计算、联邦学习等技术的发展,部署策略将向更智能、更弹性、更安全的方向演进。技术决策者需要建立"业务场景→技术架构→工具链→持续优化"的全局视野,才能真正释放AI Agent的生产力潜能。在AI从实验室走向产业深水区的关键阶段,科学的部署策略将成为企业数字化转型的核心竞争力。

ytt0523_com的博客 1304

leaflet 综合教程170+ 【目录 】(已包含162篇文章)

vue+leaflet系列教程旨在为开发者提供简单快捷的,。在每一个示例中,解释相应的API知识点,做到。注意本示例目录中的内容可能加载是vue+openlayers的示例, 本目录是要加载vue+leaflet的示例,只是内容少,逐渐更新中。

大剑师兰特的GIS世界 1万+

2024全国村级行政边界数据

五级行政区划:村边界数据产品涵盖五级行政区划:(一级行政区)省级行政区共31个其中:(台湾、香港、澳门除外);(二级行政区)地级行政区共334个其中:7个地区、3个盟、30个自治州、294个地级市;(三级行政区)县级行政区共2851个其中:1355个县、117个自治县、49个旗、3个自治旗、363个县级市、962个市辖区、1个林区、1个特区;(四级行政区)乡级行政区共40497个其中:11626个乡、1034个民族乡、20117个镇、7566个街道、151个苏木、1个民族苏木、2个县辖区公所;

J_Giser的博客 3232

智能体从0到1实战,手把手教你做一个专属智能体

上周参加一场技术沙龙,我亲眼见证了程序员职场最撕裂的一幕。左边坐了个做了6年Java后端的老李,一杯接一杯灌着冰美式,愁得头发都白了一半。他说去年投10份简历能有8个面试,今年投30份才2个回复,开的薪资还比之前砍了20%,连房贷都快还不上了。而右边桌两个95后程序员的对话,却像一道惊雷炸醒了全场。一个工作刚满3年的小伙子,靠给制造业企业做私有化智能体落地,年薪已经摸到了80万,比老李翻了一倍还多。他轻描淡写地说:“现在根本不用投简历,猎头电话每天能打十几个,开价一个比一个高。

HHX_01的博客 5852

手把手教你学Simulink--基于Simulink的风力发电系统用双馈电机控制仿真建模

特点高效节能:在广泛的风速范围内保持高效的能量转换。独立控制有功和无功功率:通过控制转子电流实现对有功和无功功率的独立调节。较低的成本:相比直接驱动或全功率变流器方案,成本较低。挑战控制复杂度较高:需要复杂的控制算法来实现有功和无功功率的解耦控制。对电网波动敏感:需要良好的稳定性控制策略以应对电网电压波动。利用Simscape Electrical中的模块构建DFIG的物理模型,配置参数如电阻、电感、极对数等。matlab深色版本% 添加DFIG电机模块。

MHD0815的博客 347

深度解析:一文讲清楚企业级 Agent 分布式部署架构!(建议收藏)

在当今数字化时代,企业的 IT 系统规模日益庞大且复杂,如何高效地对其进行监控与管理成为关键难题。Agent 分布式部署架构应运而生,为企业提供了一种强大的解决方案。接下来,让我们深入探究这一架构的奥秘。

kaka0722ww的博客 1889

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

手把手教会你搭建属于自己的智能体

本期将演示如何通过Coze搭建地址标准化智能体,内容具体包括:注册Coze、创建知识库、创建数据库、自开发插件、创建工作流以及创建智能体。

kowkhing的博客 5564

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

AI Agent之AutoGen框架部署、测试

workflow是集合了多个智能体的工作流,可以供playground界面创建session的时候选择来完成具体的任务。整体界面如下,每次点击“new model”之后,即使你关闭了(没有保存),界面上也会显示这个大模型……下面是创建Agent的主界面,点击“new Agent”可以创建自己的Agent。整体界面如下图,点击“new skills”按钮可以创建自己的skills。下面是“new model”界面,创建LLM时需要考虑:。)用于后面的交互,创建Agent的时候需要考虑:。

lucky_chaichai的博客 4931

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

AI Agent 指南:架构、构建与部署

当下AI Agent 正崭露头角,重塑着我们与技术交互的模式。它犹如一位智能助手,凭借独立推理、规划及自主行动能力,在无需用户持续干预的情况下,精准达成既定目标。从智能客服自动处理客户咨询,到智能投资顾问自主制定投资策略,AI Agent 的应用场景不断拓展,深度融入生活与工作的诸多方面,成为推动智能化变革的关键力量。深入探究 AI Agent 的工作原理、设计准则、基础设施需求以及构建部署流程,对于解锁其潜能、引领创新应用意义深远。

llm_way的博客 2933

从 0 部署全自动 Agent,这篇免费教程就够了

市面上讲 AI Agent 的教程很多,但 90% 都在教你怎么写 Prompt,或者跑通一个 Hello World 级别的 Demo。

DEVELOPERAA的博客 1175
上一篇: Agent终于能主动进化?揭秘首个让AI自我进化的训练框架!突破人类专家局限,告别手动调优!端到端符号化框架如何引领AI自我革命
下一篇: 逆天!!!吴恩达+OpenAI合作出了大模型课程!重磅推出《LLM CookBook》中文版
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值