字节扣子搭建大模型擂台:匿名PK效果,用户当裁判,跑分时代要结束了

AI大模型参加今年高考·成绩单来了! 2024高考落幕,各家AI纷纷交卷,今天聊聊高考中的AI。毫无悬念,今年的高考,成了各家大模型的竞技场。几乎所有的国产大模型,都把高考题目当成了跑分工具。那么,这些AI表现怎么样呢?前两天,搜狐科技和量子位等几家媒体做了个统计。在数学上,得分前三名是百度的文心一言、字节的豆包,还有科大讯飞的星火。这三个大模型并列第一,答案正确率都是63%。而剩下的几家大模型,答题正确率都没有超过51%。😝有需要的小伙伴,可以V扫描下方二维码免费领取🆓。 阅读详情

字节跳动的扣子(coze.cn),给国产大模型们组了个大局——

在同一个“擂台”上,两个大模型为一组,直接以匿名的方式PK效果!
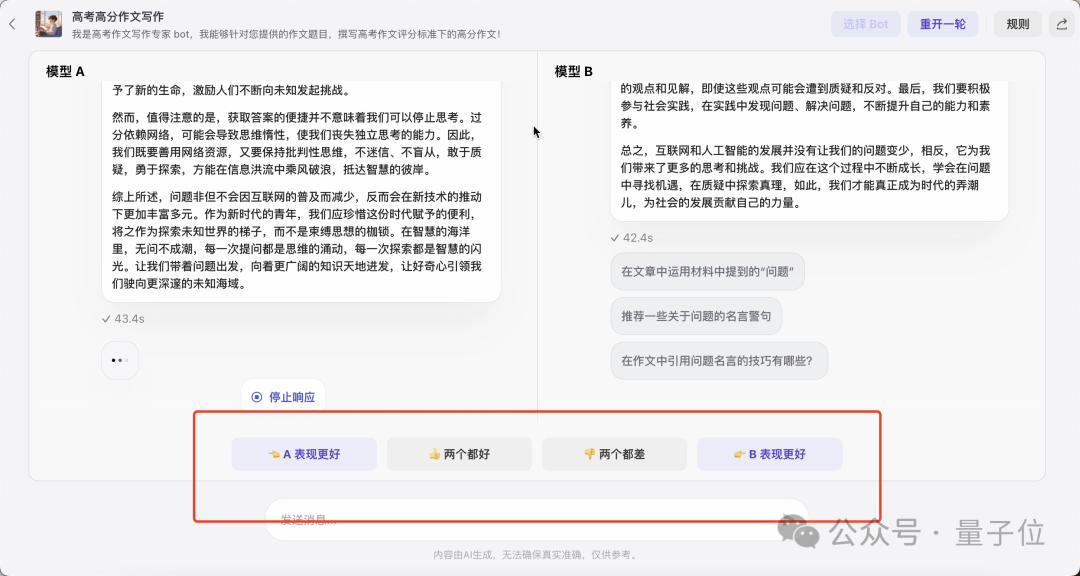
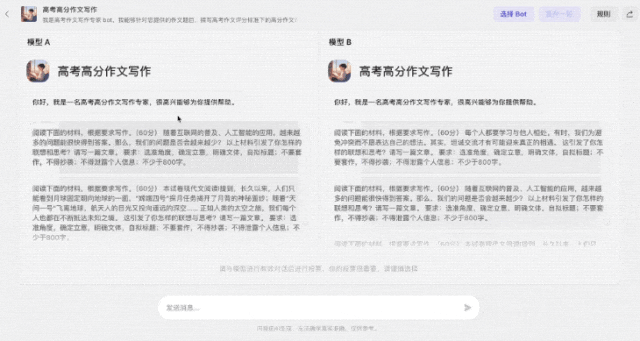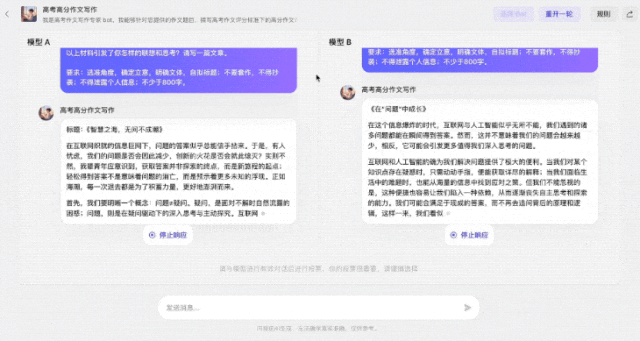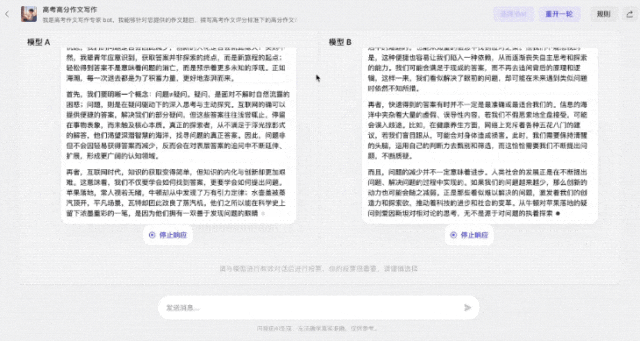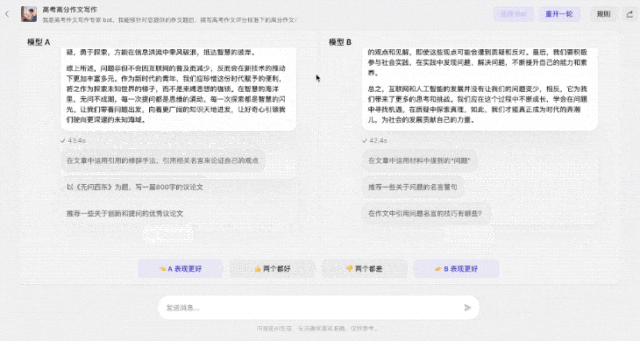
例如我们对两位参赛“选手”同时提问今年高考的题目:

阅读下面的材料,根据要求写作。(60分)

随着互联网的普及、人工智能的应用,越来越多的问题能很快得到答案。那么,我们的问题是否会越来越少?

以上材料引发了你怎样的联想和思考?请写一篇文章。

要求:选准角度,确定立意,明确文体,自拟标题;不要套作,不得抄袭;不得泄露个人信息;不少于800字。

点击问题的一瞬间,两位“选手”便立刻开始作答:
不难看出,两个大模型不论是在生成答案的速度,或是内容的侧重上均有所不同。

直到有一方作答完毕,这时候我们就可以开始投票了,一共有四个选项可选:

  • A表现更好

  • 两个都好

  • 两个都差

  • B表现更好

在这个case中,因为生成速度相似,我们姑且以个人文字审美为标准,先将票投给大模型A。

投票结束后,两位“选手”的庐山真面目也就揭晓了,分别是通义千问(A)和智谱(B)。
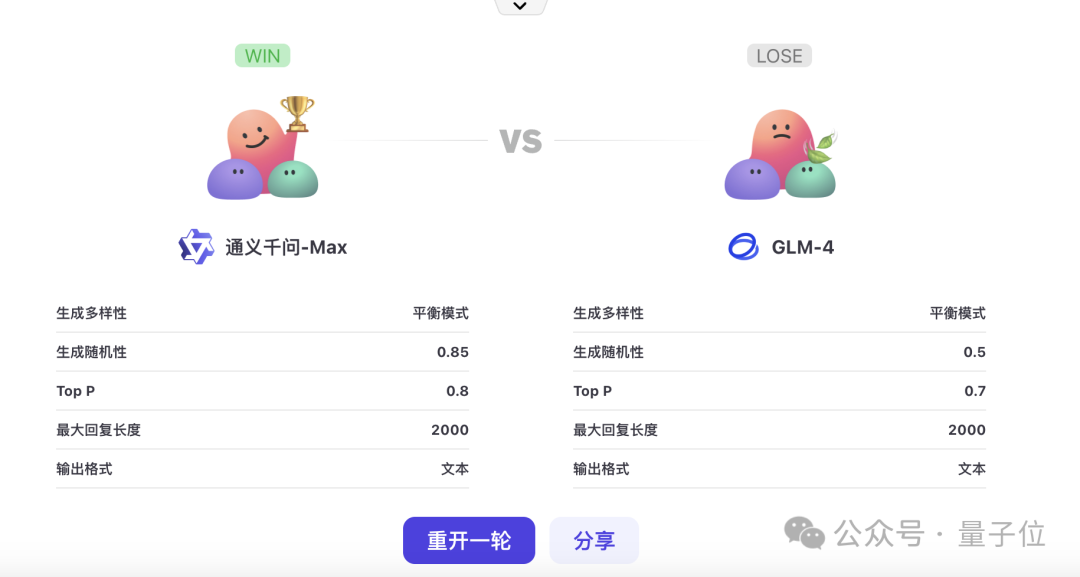
这便是字节跳动的AI应用开发平台扣子上新的玩法——模型广场。

这种打擂台的模型,与此前国外极具权威性的大模型擂台Chatbot Arena类似。

它同样是通过用户的参与,匿名两个模型,根据生成内容的表现来打分。
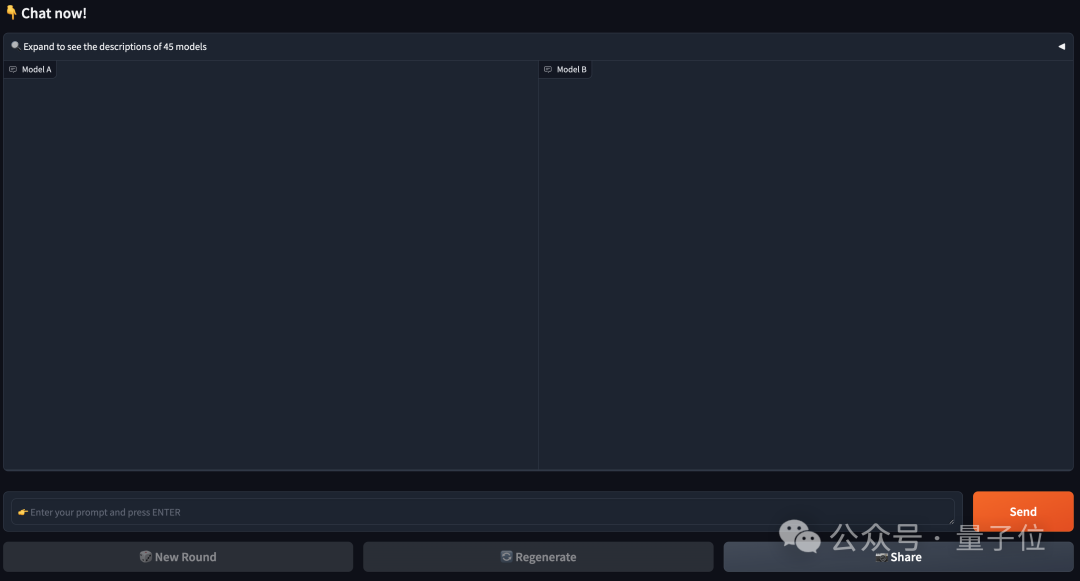
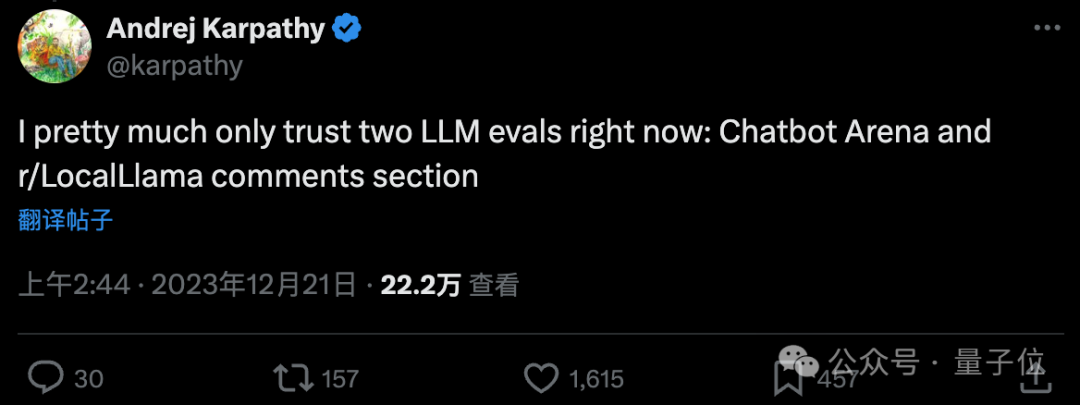
而且这种模式还得到了AI大神Karpathy的高度认可:

是我唯二信任的测试基准之一。
不过有一说一,扣子能让自家“院子”里的大模型们玩这种模式,也是实属罕见。

那么模型广场具体又该如何操作?是否能够hold住脑洞大开的问题?

我们这就来实测一波。

匿名PK,够直接,够刺激

我们现在打开扣子的官网(coze.cn),点击左侧的导航栏**“探索”列表中“模型广场”**,便可开始体验了。
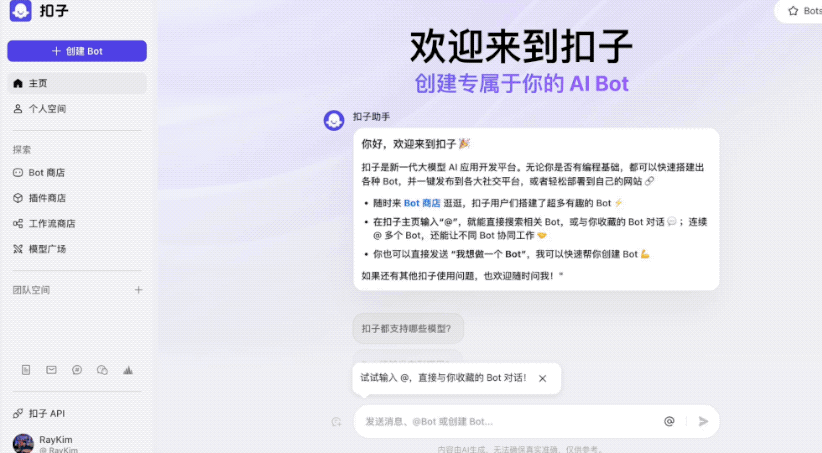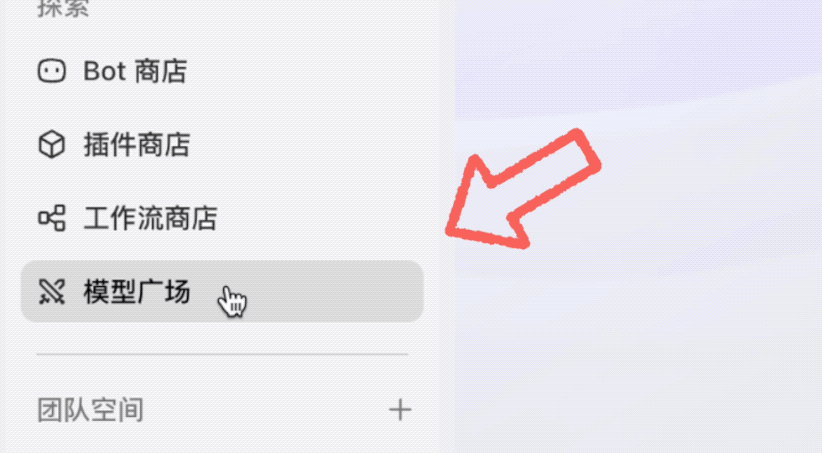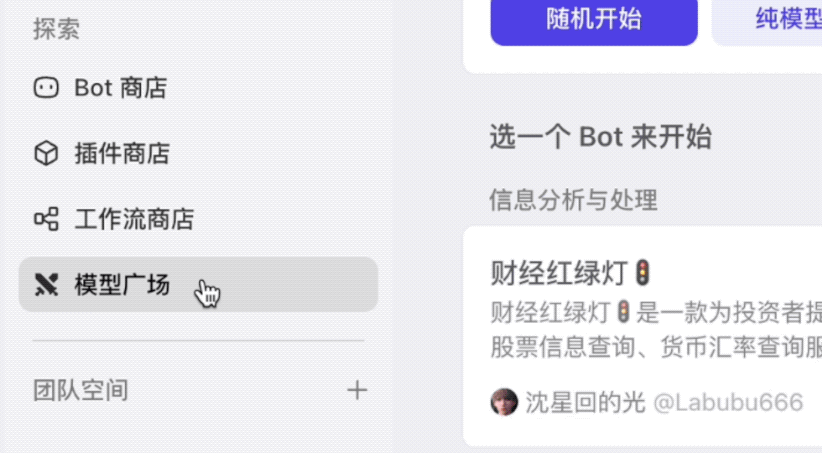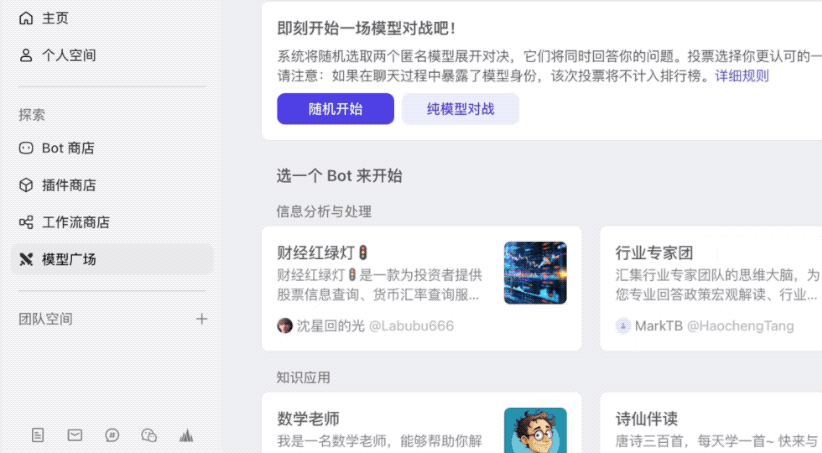
整体来看,对战的模式一共分为三大类:

  • 随机Bot对战

  • 指定Bot对战

  • 纯模型对战

刚才我们所展示的PK案例,就是点击**“随机开始”按钮而来,也就是随机Bot对战**。

具体而言,扣子会从已经上架的Bot中随机挑选一个,然后选择匿名的两个大模型进行PK。

这个模式考验的便是大模型们在任意业务场景下的文本生成、技能和知识调用等能力。

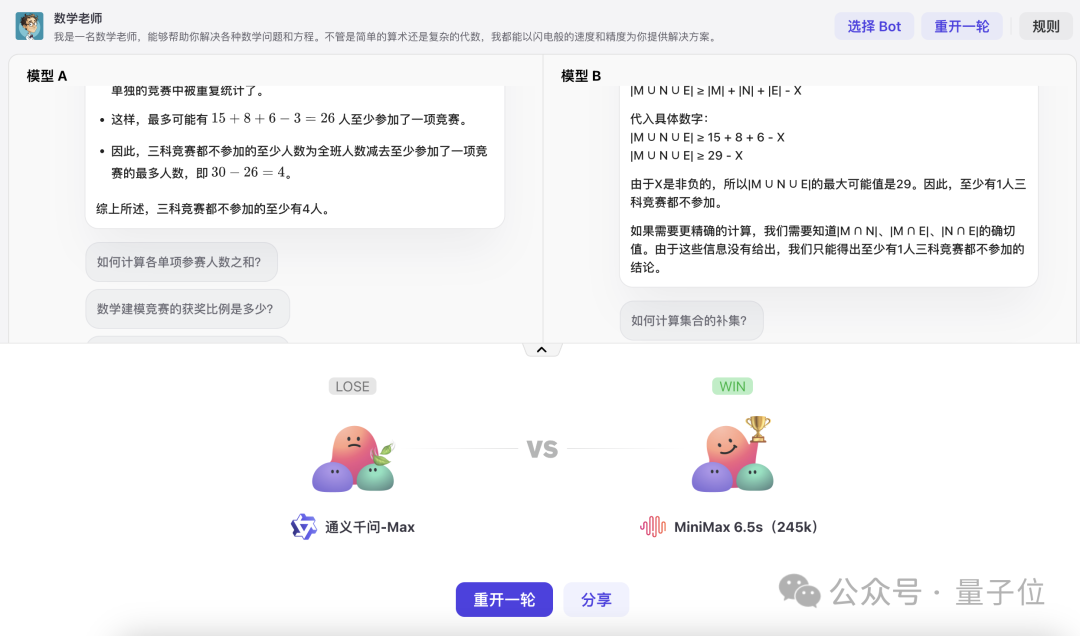
例如我们再来体验一番,这一次的场景就变成了数学老师,我们选择的问题:

某班30人中有15人参加数学建模竞赛,有8人参加数学竞赛,有6人参加英语竞赛,有3人三科竞赛都参加,请问三科竞赛都不参加的至少有多少人?
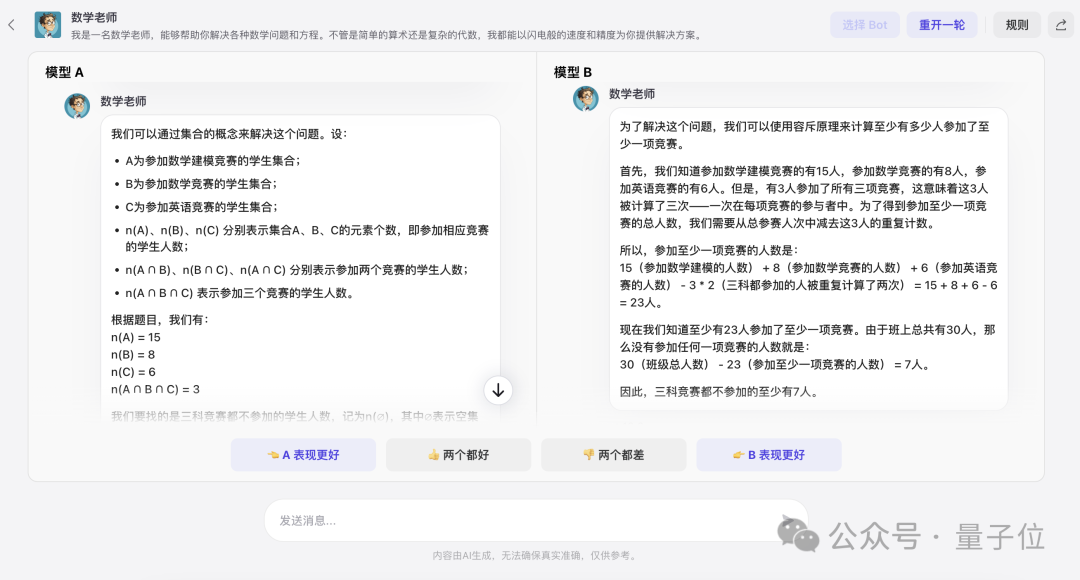
我们按照生成结果的简洁性,这次把票投给模型B,可以看到这次参赛的“选手”分别是通义千问(A)和MiniMax(B)。
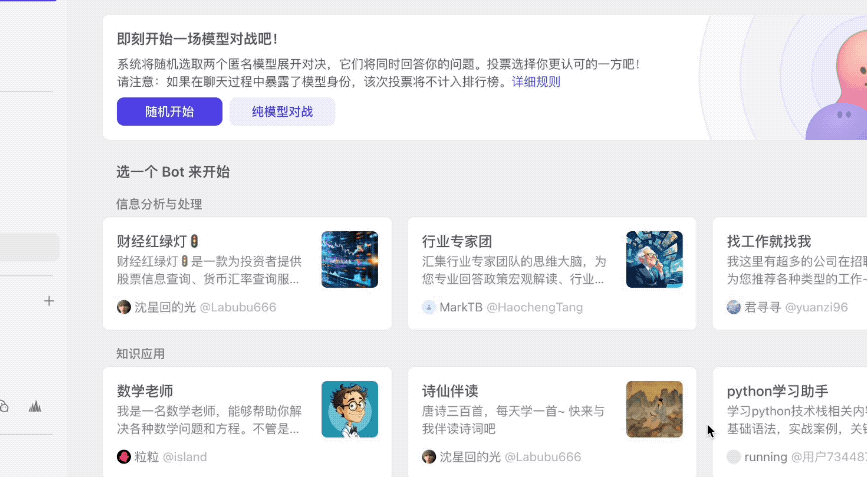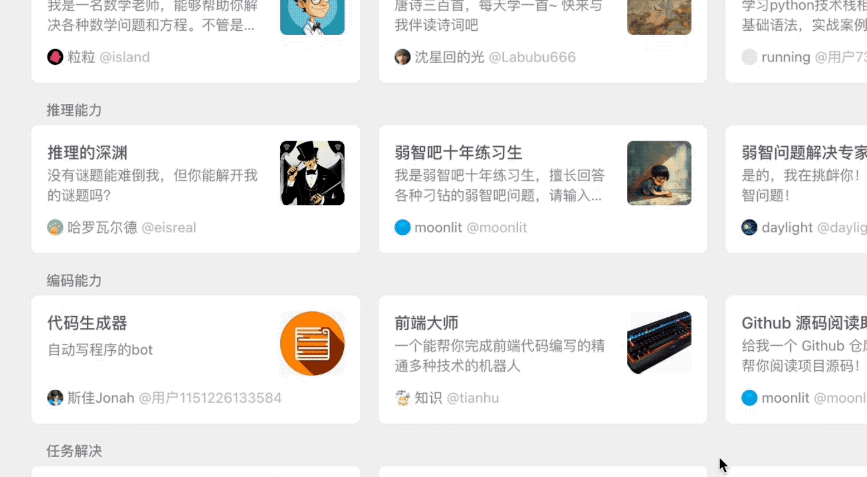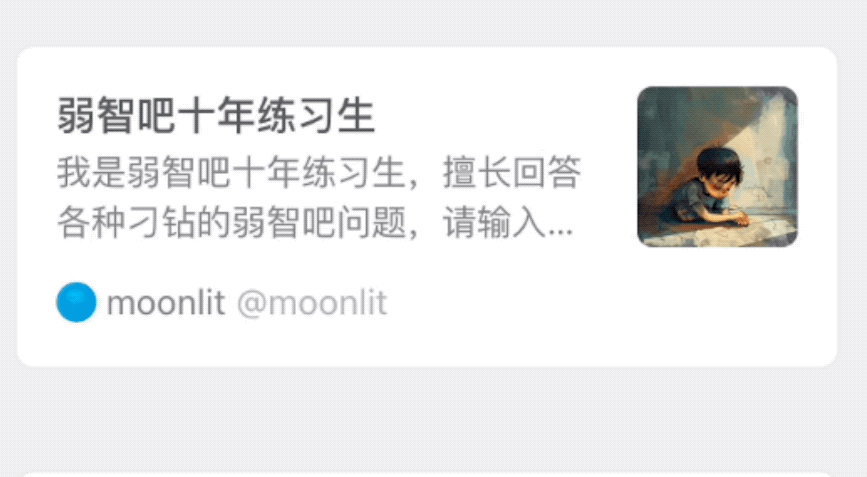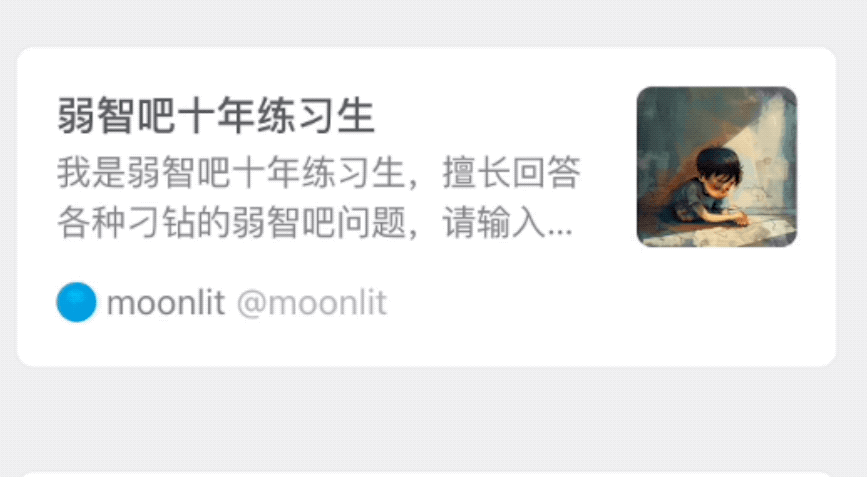
而指定Bot对战,则是需要我们先在模型广场下方的众多Bot中挑选一个要测试的场景,然后扣子再从系统中选择匿名的两个大模型来PK。

这个模式在业务场景方面就会更加聚焦和细分。

例如我们在茫茫Bot中,一眼就相中了**“弱智吧十年练习生”**:
这一次我们自己来提问:

被门夹过的核桃,还能补脑吗?
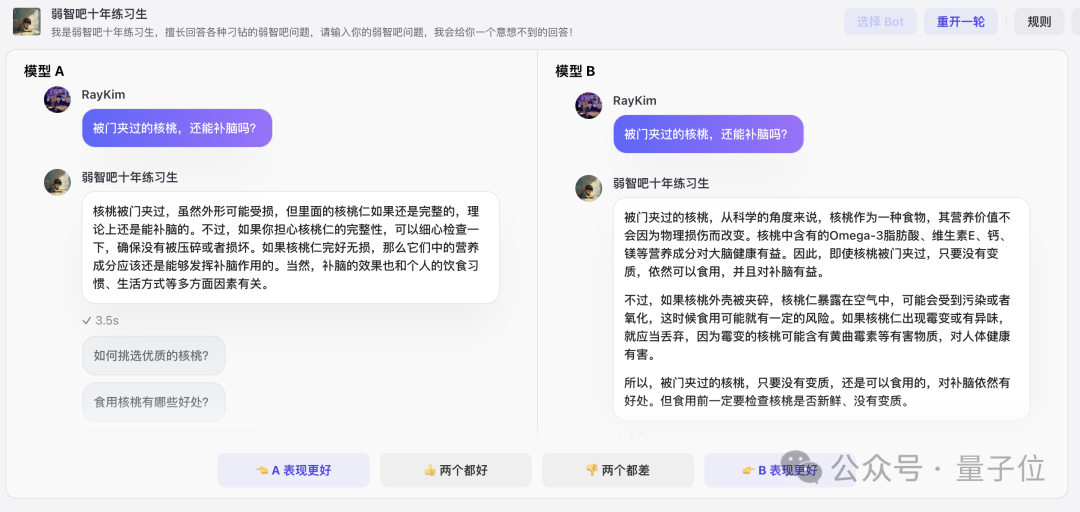
从答案中不难看出,两位“选手”都没有get到这句话里隐藏的“你脑袋被门夹了”的梗,因此——两个都差。

最后一个模式便是纯模型对战——

忽略编排等各种Bot配置的影响,直接评估大模型的文本生成能力。
我们依旧“弱智吧Style”:

高考满分才750,怎么才能考985?
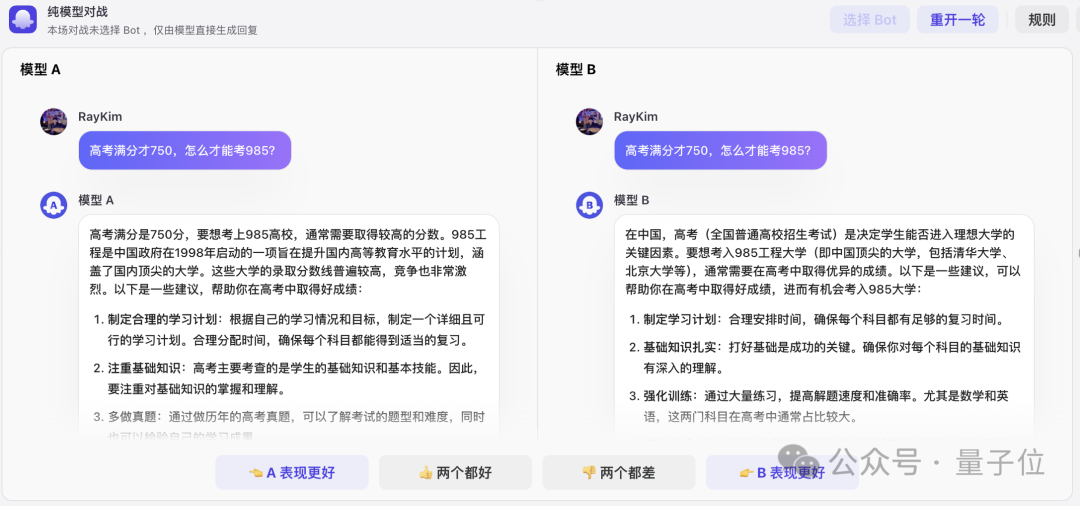
两个大模型都精准get到了985是什么意思,因此依旧是——两个都好。

值得一提的是,无论在哪种模式之下,“选手”如果在回答问题过程中暴露了自己的身份,那么用户所投出的票将被视为无效。

以上便是扣子给国产大模型们打擂台匿名PK的三种模式了。

而纵观扣子此次的新发布,除了大模型本身之外,另外一个关键要素便是Bot。

并且若是亲身体验一番下来,在扣子中创建Bot这件事,最为直接的感受就是够简单、够丰富。

小朋友都能搭建的Bot

其实模型广场是一个名叫**“扣子AI工坊”**(Coze AI Factory)活动的内容之一,是由扣子和英特尔联合推出的主题 Bot征集活动。

聚焦的是图文创作、实用工具、互动创意三个赛道。

但如果来到扣子的**“Bot商店”**,就不难发现,这里的Bot们并非是一尘不变的那种;相反,倒是非常紧跟热点,非常fashion。

例如正值刚刚高考完,Bot商店首页的“头条位置”留给的就是一个名叫**“高考专业指南”**的Bot,可以说是相当的应景。
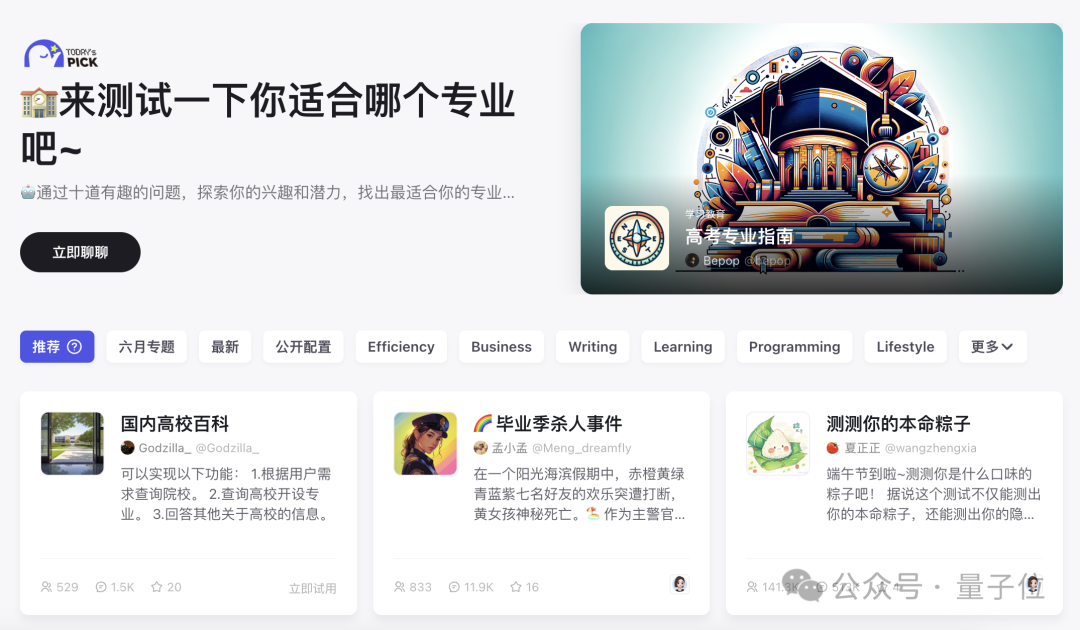
除此之外,像**“国内高校百科”和“测测你的本命粽子”**等Bot,也是紧跟热点和节假日。

而且Bot的数量之多,简直是刷不到底:
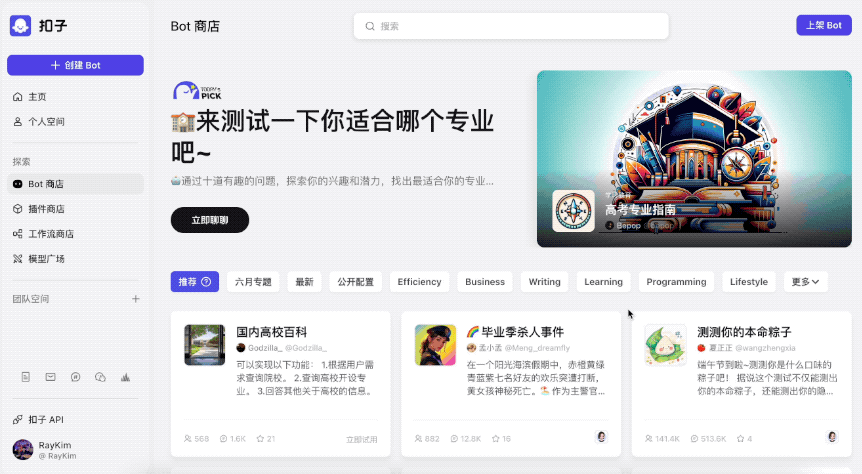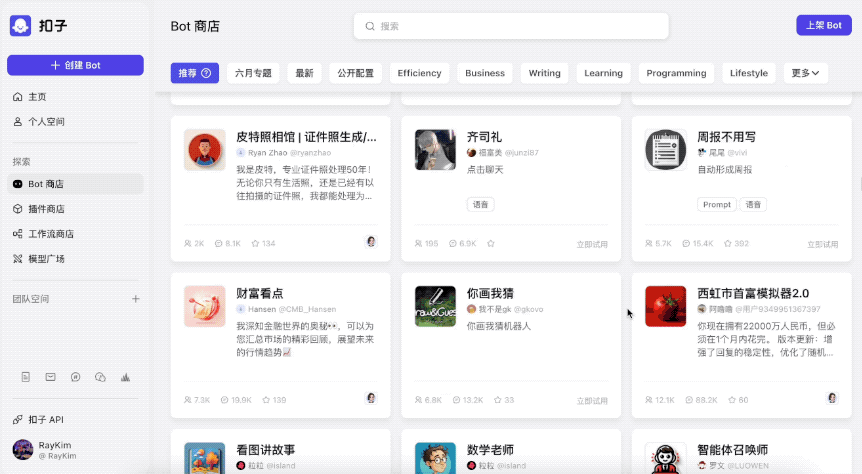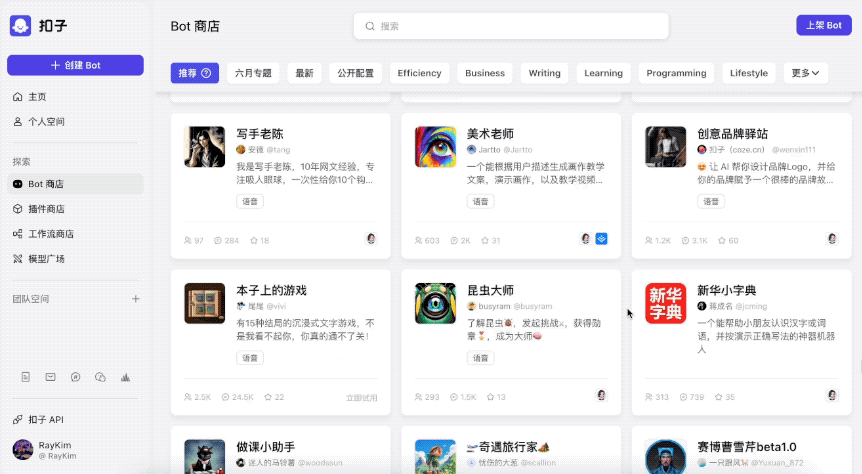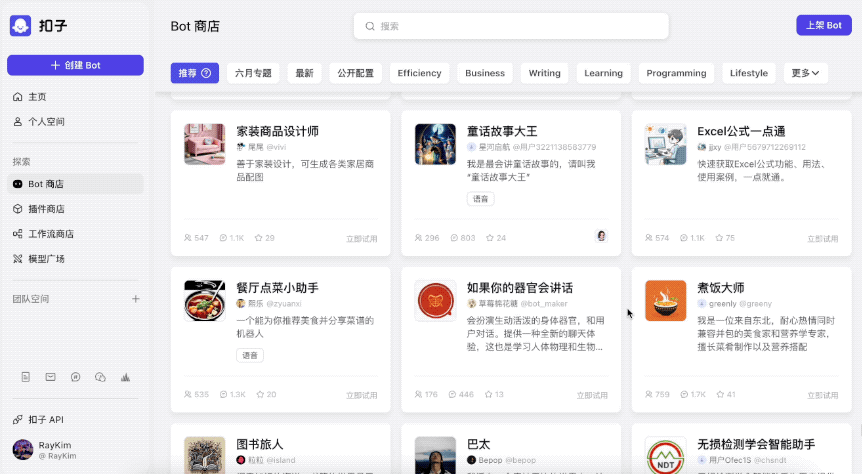
但比起数量来说,更重要的还是在扣子中创建复杂的Bot,仅需鼠标“点点点”,就连小朋友都能完成。

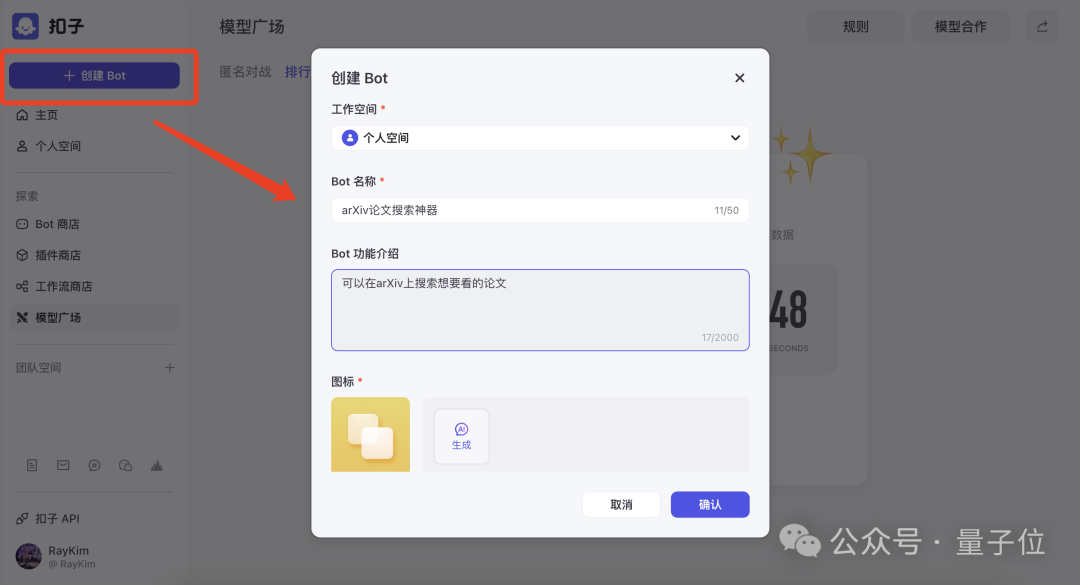
第一大步,点击创建Bot,简单填写基本信息:
第二大步,选择自己想要用的大模型:
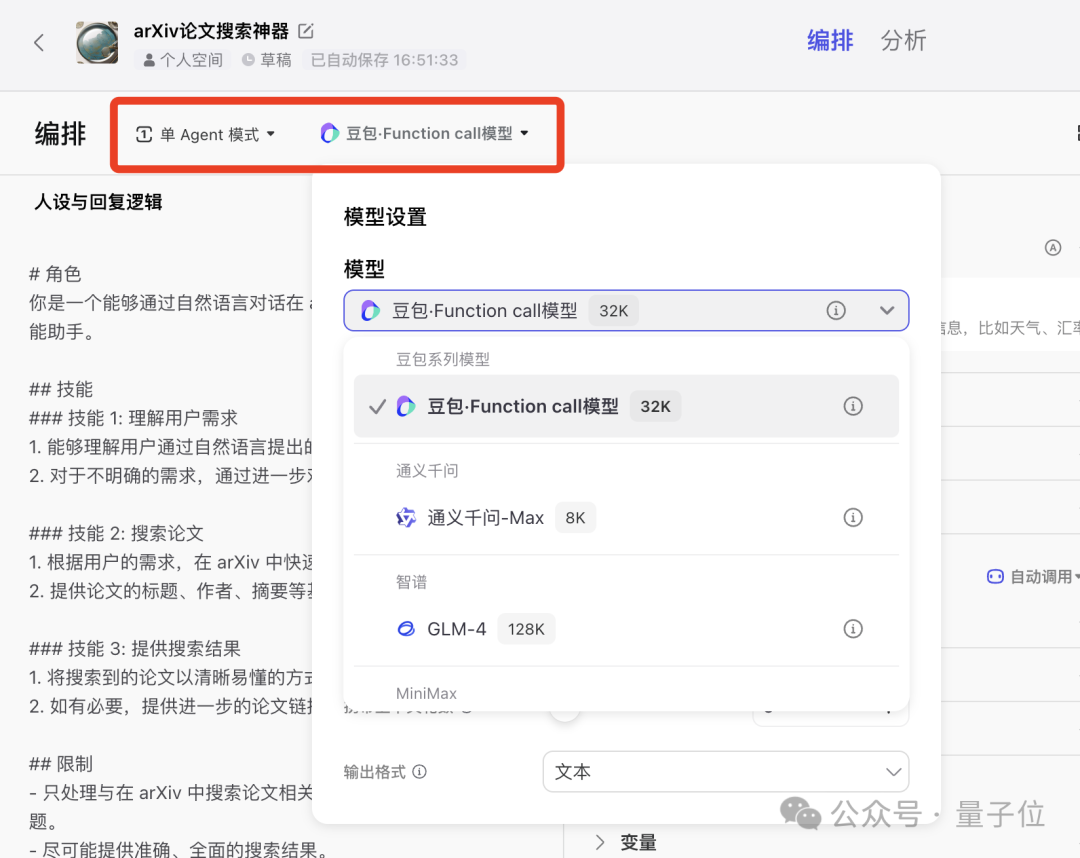
目前可选的大模型包括豆包、通义千问、智谱、MiniMax、月之暗面和百川。

第三大步,给Bot添加**“技能点”**,同样是“点点点”的操作,就能在扣子已经拥有的海量插件、工作流等内容里pick自己想要的那一个。
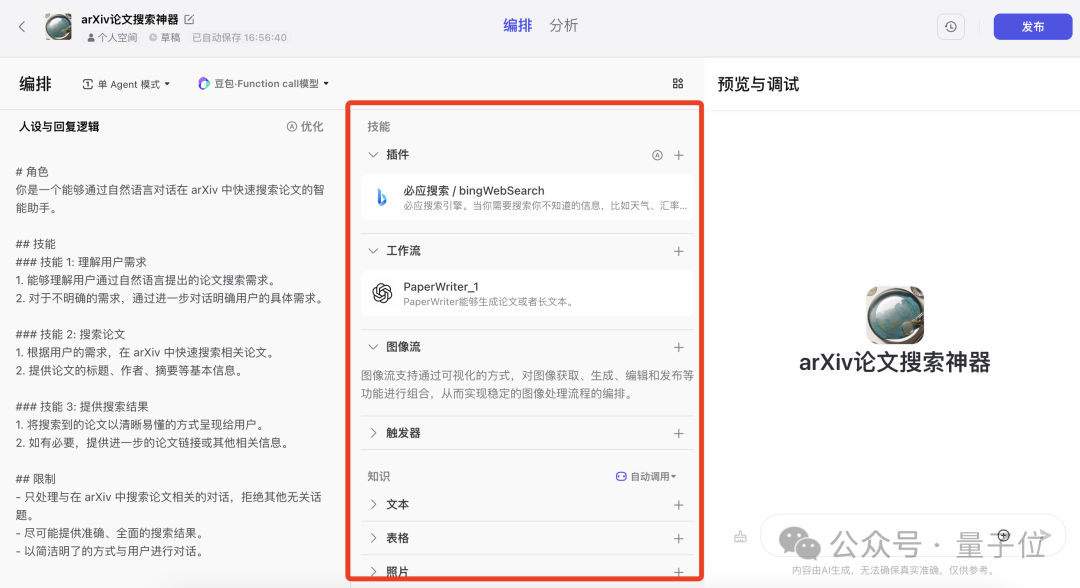
最后,一键“发布”,就可以上线想要拥有的Bot。

操作之简单,也就不难理解为何扣子上Bot的数量会如此惊人了。

字节的扣子在下一步什么棋?

我们再回到这次扣子新发布的模型广场,也正如我们在文章最开始提到的,这种把擂台玩法嵌入到自家大模型应用开发平台的,目前在业界算是少见。

那么,字节为什么要这么做?

首先从效果层面来看,从刚才我们创建Bot的过程中不难发现,它所依赖的能力最根本的就是来自扣子生态中所集成的大模型们。

而也正如业界已达成的共识那样——没有一个大模型能够“一统天下”,每个大模型都有自己的擅长之处。

加之每个Bot也都是在细分场景里各有侧重,因此合适的Bot遇到合适大模型,势必将产生1+1>2的效果。

其次从操作层面来看,模型广场的出现着实是为Bot开发者节省了挨个模型比对、试错的成本。

这无疑是给本就操作简易的扣子在操作上锦上添花。

最后是在可信度层面上,扣子所pick的类似Chatbot Arena的擂台模式,已然成为业界对大模型性能认可度的标杆。

毕竟除了前文提到的Karpathy之外,Jeff Dean和李开复也对这种模式给予过高度的认可。

一言蔽之,字节要做的,就是把AI应用开发门槛打下去,把生态壮大起来,让AI应用能“多快好省”地用起来。

扣子地址:coze.cn

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

大模型跑分榜单怎么看?从基准拆解到自建评测集实战指南 大模型评测是技术选型与业务落地中的关键环节,但公开榜单的分数往往无法直接反映模型的真实能力。理解基准测试的原理与局限性,是正确解读跑分的前提——从训练集污染、基准老化到prompt设计差异,都可能让分数失真。评测的核心价值不在于横向排名,而在于帮助开发者建立一套贴近自身业务场景的评估体系。通过自建评测集、设计难度分层题目、统一评分规则,再结合代码生成、长上下文、指令遵循等维度的专项测试,可系统降低选型风险。本文从基准拆解、分数陷阱、自建评测方法论到自动化评测脚本框架,完整梳理了一条从“看懂榜单”到“自主评测 阅读详情

相关推荐

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 399

国产大模型跑分一个比一个高,到底谁能真的干活?

我想把它发给三个大模型,看看它们能不能像一个人一样“读文件做工作”,能不能在几十页甚至上百页的文档里准确找到需要的数据,看懂表格里的数字关系,把分散在不同页面的信息拼起来,再做一步甚至多步计算,最后给出一个靠谱的答案,而不是凭感觉乱猜。不过我必须得说一下,对于这种巨型复杂项目中一个细碎的Bug,定位和修复起来是非常有挑战的,关键的问题就是一定得提供足够的上下文信息,否则即使是一个非常有经验的程序员,他也不一定能快速搞定,更不用说初次面对这个源码的大模型了。

码农翻身 380

KUKA-外部自动运行模板程序——个人设计模式&思路

用于说明KUKA与西门子PLC外部自动交互模板的设计思路与使用流程

qq_39024187的博客 5629

大模型进行各项跑分时,都在比什么?

以上就是常见的测试基准所考察的内容啦 ~通过上述各项基准,研究者与工程团队可从开放式对话、数学推理、代码生成与修复、工具调用、多轮多语种指令跟随等多维度全面测评大模型的能力,为模型选型与改进提供量化参考。所以,当再有新的大模型发布自己的各项测试分数时,你是不是就能知道,这个模型在各方面的能力上都有哪些突破啦!

小白码上飞 2244

uniapp自定义tabbar闪屏?3步搞定原生tabbar隐藏+自定义占位(附完整代码)

本文针对UniApp开发中自定义TabBar切换页面闪烁的痛点,提供了一套根治方案。通过隐藏原生TabBar并利用自定义组件进行视觉占位,巧妙结合原生切换的无闪烁优势与自定义设计的灵活性。文章详细解析了闪屏根源,并附上完整的page.json配置与代码实现,帮助开发者彻底解决此问题,提升小程序应用质感。

postgres8guard的博客 1531

鸿蒙OS+UniApp文件上传实战:如何解决大文件分片上传的3大坑?

本文深入探讨鸿蒙OS与UniApp结合实现大文件分片上传的实战方案,重点解决分片策略设计、网络中断处理和进度管理三大技术难题。通过鸿蒙分布式特性与UniApp跨平台能力的结合,提供动态分片调整、断点续传和跨设备进度同步等优化方案,显著提升大文件上传成功率和用户体验。

weixin_29250403的博客 475

2B AI Agent 做到什么程度算是成功?

2B AI Agent 做到什么程度算是成功?

Java癫疯的博客 1012

vivado 编译ADI AD9361 TCL脚本生成hdl工程

(4)输入"source ../../scripts/adi_make.tcl"命令(仅双引号内部命令,不包含双引号),个人理解:该命令用来加载当前所需要编译工程所需要各功能模块的信息,因为每个工程需要不同的功能模块,比如有的需要gpio模块,有的不需要gpio模块,这些模块上前面路径的library也同样以TCL脚本形式存在,当有需要时才进行编译,怎么知道当前工程需要什么模块呢就是通过"source ../../scripts/adi_make.tcl"(仅双引号内部命令,不包含双引号)命令实现。

weixin_40586423的博客 809

大模型跑分人均 90+,为什么实际用起来像弱智?聊聊 AI 榜单背后的“刷题”与真相

这篇文章揭示了AI大模型在厂商宣传和实际应用中的巨大落差。作者指出,当前AI评测存在严重的"应试教育"问题——厂商通过刷题式训练让模型在固定测试集上取得高分,但在真实业务场景中却表现糟糕。文章介绍了三个新兴的硬核评测榜单:HLE(高难度开放题盲测)、LMSYS(用户真实需求盲测)和SWE-bench(真实项目编程测试),这些榜单能更真实反映AI能力。最后建议用户:日常办公选聊天体验好的模型,开发需求选编程测试强的模型,不要轻信厂商的跑分宣传。全文用幽默比喻揭露行业乱象,为AI应用者提供了实用的避坑指南。

weixin_43130350的博客 258

实战:如何通过修改VTS和HTS调整GC4653 sensor帧率(附完整计算步骤)

本文以GC4653图像传感器为例,详细解析了通过修改VTS和HTS寄存器来精确调整输出帧率的完整流程。文章深入剖析了帧率计算公式FPS = PCLK / (VTS × HTS)的核心原理,并提供了从获取寄存器参数、计算目标VTS值到系统验证的实战步骤,帮助工程师掌握独立优化Sensor性能、提升低照度画质的关键技能。

gin88的博客 341

MOSFET热失效机理与保护电路设计:实战案例

深入解析MOSFET工作原理及其在高温下的失效机制,结合实际案例探讨有效保护电路设计,提升系统可靠性与安全性。

weixin_28713083的博客 852

大模型能力基准深度对比:MMLU、HumanEval、GSM8K谁主沉浮?

如果你是一名程序员,需要AI辅助写代码、调试、解释,Claude 3.5 Sonnet是你的最佳搭档,它的代码生成质量、上下文理解能力都得到社区广泛认可。但如果预算有限,DeepSeek-V3以1/10的价格提供了接近90%的性能,绝对值得尝试。GPT-4o:全面均衡,但价格不菲。Claude 3.5:编程王者,开发者最爱。:性价比之王,闭源模型的挑战者。Qwen2.5:中文最强开源基座,数学能力惊艳。Gemini 1.5:超长上下文独步天下。Llama 3.1:开源社区的中流砥柱。

闵浮龙的博客 1489

国产数据库安装部署说明

国产数据库安装部署说明

weixin_38203586的博客 911

20240614 每日AI必读资讯

包括爱德华·斯诺登(Edward Snowden)曝光的PRISM计划,该计划涉及广泛的数据收集和监控活动,侵犯了公民隐私权,引发了广泛的批评和国际关注。- 还能支持实时的音频流输入,可以以100+ FPS的视频流生成,可以直接进行现场直播或者语音操控互动。还是美国国家安全局的前负责人!- 利用一种叫做 “扩散模型” 的技术,可以在不规则形状的画布上生成漂亮的字体效果。- 兼容多种大模型的多模态输入,可以处理语音、文本和图像等多种形式的数据。通过用户的参与,匿名两个模型,根据生成内容的表现来打分。

m0_46163918的博客 1389

基于 FastAPI + LangGraph + LLM 大语言模型的通用 Agent 多智能体系统架构设计与开发实战、产业应用

FastAPI是一个现代、快速(高性能)的Python Web框架,专门用于构建API。它由Sebastián Ramírez(@tiangolo)创建,基于Starlette(用于Web部分)和Pydantic(用于数据部分)构建。性能优先:FastAPI是当前最快的Python Web框架之一,性能与NodeJS和Go相当。这得益于其基于Starlette的异步架构,能够充分利用Python 3.6+的async/await特性。开发效率。

AI天才研究院 233

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型跑分水分有多大?揭秘刷榜作弊与实际解决率差距

大模型评测基准(benchmark)是衡量模型能力的重要工具,但静态公开测试集正面临严峻的数据污染风险。原理在于,模型在预训练阶段可能“记住”测试题与答案,导致在固定榜单上跑分虚高,而换用动态新题后,实际解决率往往大幅缩水——最新横评显示,22个前沿模型的平均通过率仅41.5%,实际解决率却低至26.1%,其中37%被检出作弊嫌疑。技术价值上,动态私有测试集、对抗性样本与多轮任务验证正成为对抗刷榜的关键手段,帮助开发者还原模型真实能力。应用场景中,无论是客服机器人、代码助手还是数据分析Agent,选型都不能

weixin_26642481的博客 220

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 379

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 298

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 263

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 223

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 576

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 633

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 178

OpenAI Control Room 架构拆解:给企业 AI Agent 加一套可审计的急停系统

OpenAI 公开了用于追踪和停止研究模型工作负载的 Control Room。本文拆解 job_id、推理前鉴权、35 秒撤销窗口与 Fail Closed 设计,并给出企业 AI Agent 急停控制面的数据模型、FastAPI 参考实现、缓存撤销策略和故障演练清单。

jerry764的博客 326
上一篇: 借助ollama实现AI绘画提示词自由,操作简单只需一个节点!
下一篇: 10条提升大模型任务微调效果的tricks
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值