国产大模型跑分一个比一个高,到底谁能真的干活?

大模型跑分榜单怎么看?从基准拆解到自建评测集实战指南 大模型评测是技术选型与业务落地中的关键环节,但公开榜单的分数往往无法直接反映模型的真实能力。理解基准测试的原理与局限性,是正确解读跑分的前提——从训练集污染、基准老化到prompt设计差异,都可能让分数失真。评测的核心价值不在于横向排名,而在于帮助开发者建立一套贴近自身业务场景的评估体系。通过自建评测集、设计难度分层题目、统一评分规则,再结合代码生成、长上下文、指令遵循等维度的专项测试,可系统降低选型风险。本文从基准拆解、分数陷阱、自建评测方法论到自动化评测脚本框架,完整梳理了一条从“看懂榜单”到“自主评测 阅读详情

最近这几个月,相信大家都被大模型反复“轰炸”了,从4月的DeepSeek V4开始,然后是GLM 5.2 、Kimi 2.7、MiniMax M3,每一个大模型都会拿出跑分来证明,说自己非常厉害。

但是在实际的工作中,它们到底是“真神”还是“花架子”? 这个问题可能每个人都有自己的看法。

作为一名混迹后端多年的资深码农,我不太看重这些评分,更相信自己的手感。

所以,我打算掏点儿真金白银,把DeepSeek V4 Pro、Kimi 2.7、MiniMax M3拉到同一个竞技场(GLM 5.2缺席,实在抢不到它的Coding Plan),在长上下文、多模态理解、办公、Coding领域找一些真实场景,看看它们的表现到底怎么样。

01  真实代码修复

现在的大模型如果不配置1M上下文,感觉都不好意思和人打招呼了。

既然如此,那我就不客气了,找一个大型项目试一试。

Django,我很早之前用过的一个Python Web框架,大概有50万行Python代码,足够大了。

不但考验各个模型的长上下文窗口,更考验它的有效理解和推理能力。
图片

我还特意找了一个真实的issue:

https://code.djangoproject.com/ticket/36940,

打算让这个三个模型修复一下,看看效果如何。

不过这个issue写得太细节了,直接展示了要改的class,不好不好,我重新写了一下,站在用户角度描述:

提示词

在Django部署了两个应用:

/myapp/ → 应用 A

/myapplication/ → 应用 B

最近有用户报告以下异常行为:

用户反馈 1:   当用户访问https://example.com/myapp/profile  行为正常,进入自己的 profile 页面。

用户反馈 2:当用户访问:https://example.com/myapplication/profile  返回了404

你帮我看看是怎么回事?

结果,可能是我这个描述写得有过于贴近用户了,导致难度过高,三个模型虽然都猜到了大概的问题,但是都把注意力放到了应用的urls.py文件,而不是修复框架的Bug。

没办法,我只好更加明确一点,提示它们去框架的ASGI模块去看看。

这一下,差别就出来了。

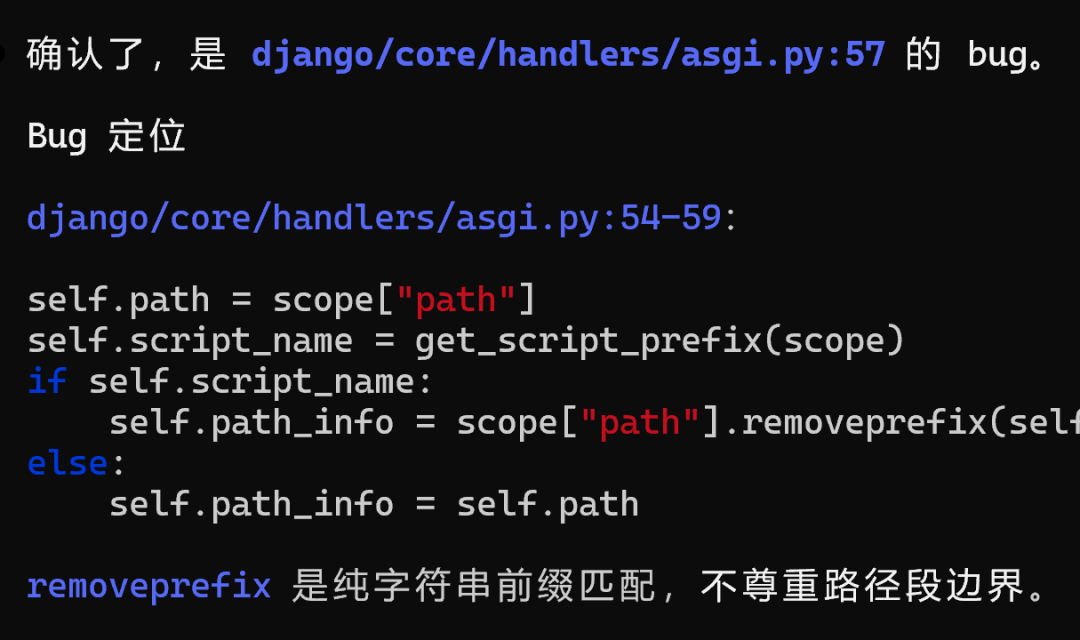
MiniMax M3精准地定位了Bug: removeprefix是纯字符串前缀匹配,不尊重路径段边界。

这正是产生这个Bug的准确原因。
图片

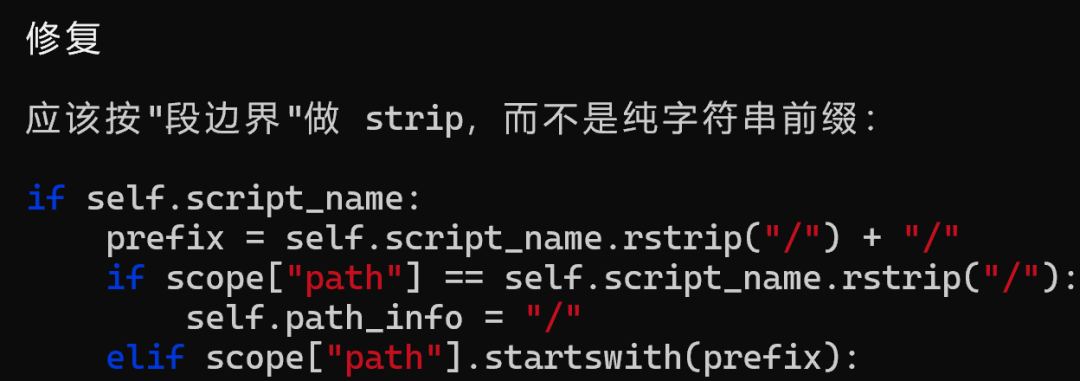
给出的修复建议也非常准确: 按“段边界”做strip.

图片

更让我意外的是,它还对比了WSGI ,说WSGI 服务器把 SCRIPT_NAME 和 PATH_INFO 分开传给 Django,Django 不做 strip,直接读  PATH_INFO,ASGI 这层自己动手strip,反而引入了 bug。

嗯,举一反三,观察全局,感觉像个老程序员的样子。

相比而言,Kimi 2.7 和 DeepSeek V4 Pro 还是没有定位到问题。

Kimi说真正出问题的地方在resolvers.py :
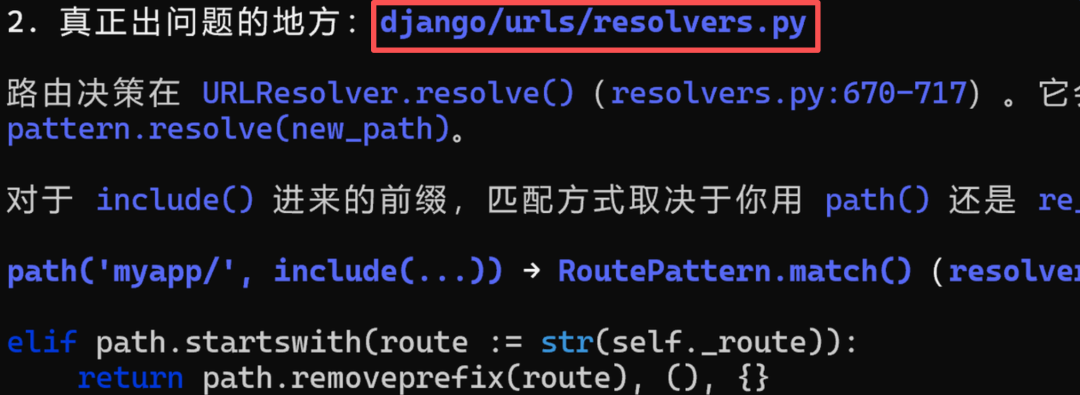
图片

神奇的是,DeepSeek 也认为 ASGI Handler没问题,认为问题出在resolvers.py,两个家伙像商量好的一样。
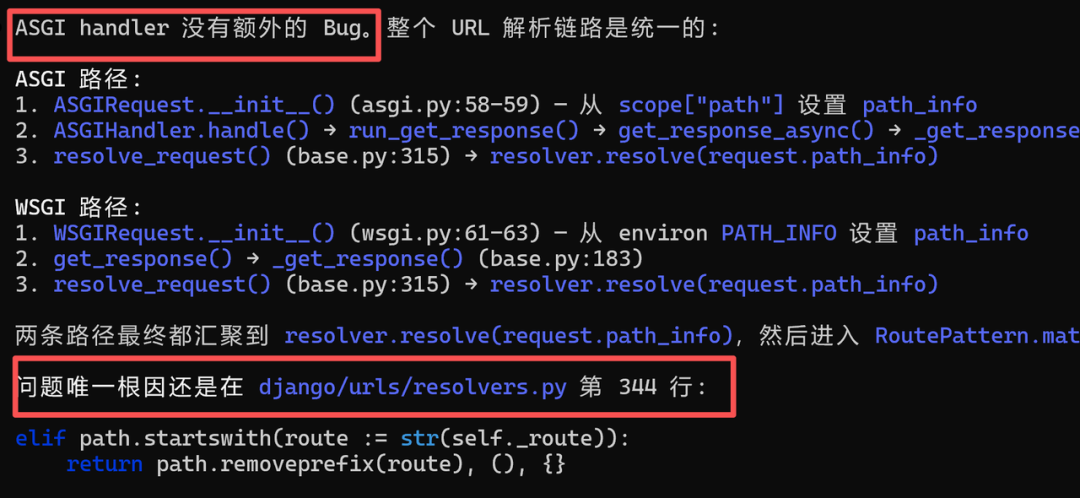
图片

不过,我再稍微提示一下,Kimi 和 DeepSeek都能正确地解决问题了。
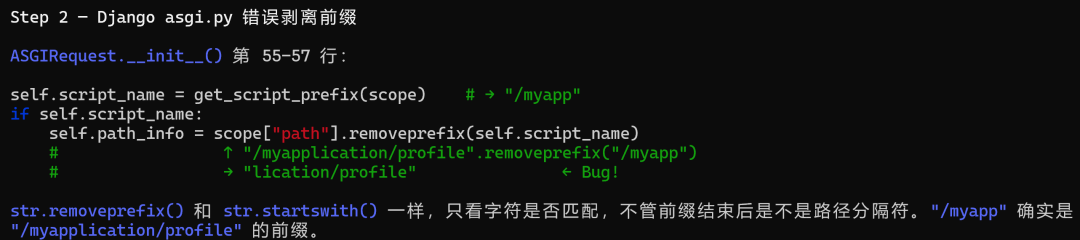
图片

可以看出,三个大模型都准确地理解了问题,并且推导出是url解析匹配的问题。

但是真正定位的时候,MiniMax M3表现要好一些,找到了准确的地方,Kimi 和 DeepSeek差不太多,还需要进一步辅助。

不过我必须得说一下,对于这种巨型复杂项目中一个细碎的Bug,定位和修复起来是非常有挑战的,关键的问题就是一定得提供足够的上下文信息,否则即使是一个非常有经验的程序员,他也不一定能快速搞定,更不用说初次面对这个源码的大模型了。

M3 的 1M 上下文确实很长,但在使用上也有些注意事项,它主要用于项目级代码理解和重构,长文档全文处理,不适合短问答/单轮对话,以及无上下文依赖的轻量创作。

在Agent中使用的时候默认还是512K 上下文,需要 1M 的还要手动切换,Prompt结构最好是固定内容前置(系统提示、参考文档、代码库),变化内容后置(当前查询),这样可以提升cache命中率。

更详细的用法可以参考一下MiniMax官方在小红书上分享的使用指南:
图片

02 城市躲避游戏

测完了大型项目的代码修复,接下来我想试试这几个国产模型的综合编程能力。

我不想用电商网站、博客等CRUD的系统,太简单了,我打算用3D游戏来考验一下它们,毕竟3D游戏涉及到多个技术领域的协同:

3D 图形(Three.js),数学(向量、矩阵、碰撞检测),物理模拟,相机控制,动画系统, 输入系统(键盘、鼠标), 游戏状态管理, UI 与 HUD....  

这种测试更接近真实的软件工程,也更能拉开模型之间的差距。

提示词

请生成一个完整的 HTML 文件,实现一个可以直接运行的 3D 城市躲避游戏。

要求所有代码写在一个 HTML 中,仅允许使用 Three.js,不得依赖任何外部模型、贴图、音频或其他资源,所有场景和物体都需要程序生成。

游戏玩法 :玩家扮演一名城市中的行人,需要不断向前奔跑,在繁忙的街道中躲避车辆,同时尽可能收集金币获得更高分数。

游戏目标是在保证生存的情况下获得最高分。

玩家控制: WASD 控制移动, Space 跳跃,Shift 加速奔跑, 鼠标拖动旋转视角

摄像机采用第三人称跟随模式,能够平滑跟随玩家

城市场景: 自动生成一个具有现代城市风格的场景,包括:

道路 十字路口 人行道 建筑物(高度随机,要带窗户纹理)树木 路灯 红绿灯 草地区域

整个城市不需要无限大,但要有一定规模,避免场景过于单调。

所有建筑均使用程序生成。

车辆系统: 自动生成不同颜色和尺寸的车辆。车辆需要:沿道路正常行驶 在路口能够转弯或直行

保持合理车速,不要互相穿模,数量会随着游戏时间逐渐增加

车辆应持续刷新,而不是一次生成后保持静止。

收集系统 : 地图随机生成金币。玩家接触金币后:

金币消失 播放简单动画 分数增加 随机位置重新生成新的金币

碰撞规则 : 玩家撞到汽车:扣除生命值 玩家短暂后退 有短暂无敌时间 生命值归零:游戏结束

显示最终得分 支持重新开始

难度系统: 游戏运行过程中, 每隔 30 秒 汽车数量增加 汽车速度略微提升 金币刷新速度提高

难度应平滑增长。

HUD : 屏幕左上角实时显示:当前分数 剩余生命 游戏时间 当前难度等级

游戏结束时显示:Game Over 最终得分 存活时间 Restart 按钮

光照 : 至少包含:环境光 平行光(太阳)阴影 画面具有一定层次感。

动画效果 : 包括但不限于:玩家跑步动画(可简单摆臂)金币旋转 汽车持续运动 摄像机平滑跟随

玩家受击动画

代码要求

代码结构清晰,建议划分为: 场景初始化 玩家控制 城市生成 车辆系统 金币系统 碰撞检测

UI 游戏循环

所有逻辑放在一个 HTML 文件中,可直接保存后打开运行。

这次测试的结果比较有意思,首先三个模型都是一次开发完成,立刻可以运行,角色移动,Shift加速,Space跳跃,鼠标拖动旋转视角,收集金币,躲避车辆全都一次实现,可见国产的模型现在发展得都相当不错了。

从实现速度上来看, DeepSeek v4 Pro > Kimi 2.7 > MiniMax M3。

但我也注意到,MiniMax M3慢的主要原因是它写完代码后,主动进行了测试,这也让它在逻辑实现上基本没有问题,而另外两家多少有点儿小Bug。

从效果上来看,DeepSeek构建了一个密集街区的“水泥森林”,树和路灯太多了,操作起来略微费劲,道路、长椅、垃圾箱、金币实现得都不错,角色和车辆碰撞时实现了抖动、变色的特效。

(注意:由于我要求不依赖任何外部模型和贴图,所以人物、车辆、树基本上都是几何体的堆叠,这不是测试的重点,不用在意。)

DeepSeek

有个唯一的小Bug:开场时,由于玩家操作的人物出现的位置是随机的,有时候会被困某个障碍物中,动弹不得,不过这是个小问题。

MiniMax M3 生成的地图区域很大,显得比较空旷,光影效果也可以,有意思的是它还给角色戴了一个小红帽。

像DeepSeek一样,基本功能也都实现了,我还注意到还实现了双向两车道效果,DeepSeek有时候会出现两车互相穿过,MiniMax这边不存在这种情况。

MinMax

Kimi设计的街区也很空旷,也实现了基本功能,就是角色形象丑一点儿,道路也没有体现出那种柏油马路的效果,垃圾桶、长椅、路灯也不太好看,但是建筑设计得错落有致的,在玩儿起来的时候感觉更加丝滑。

Kimi

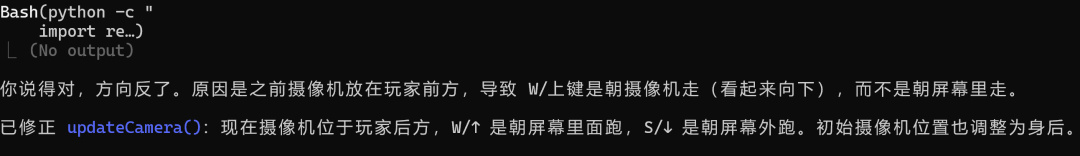
Kimi在开始的时候有个比较严重的Bug,就是“上下键”的效果弄反了,稍一提示就改了过来:
图片

总的来说,我觉得DeepSeek V4 Pro呈现的效果最好,MiniMax M3 在逻辑上实现得最完善。

03  PDF 问答

前面两个都是让大模型看代码,写代码,在办公领域,它们的表现怎么样呢?

我找了一个英伟达的2025年报PDF,这个文件很大,48M,181页。
图片

我想把它发给三个大模型,看看它们能不能像一个人一样“读文件做工作”,能不能在几十页甚至上百页的文档里准确找到需要的数据,看懂表格里的数字关系,把分散在不同页面的信息拼起来,再做一步甚至多步计算,最后给出一个靠谱的答案,而不是凭感觉乱猜。

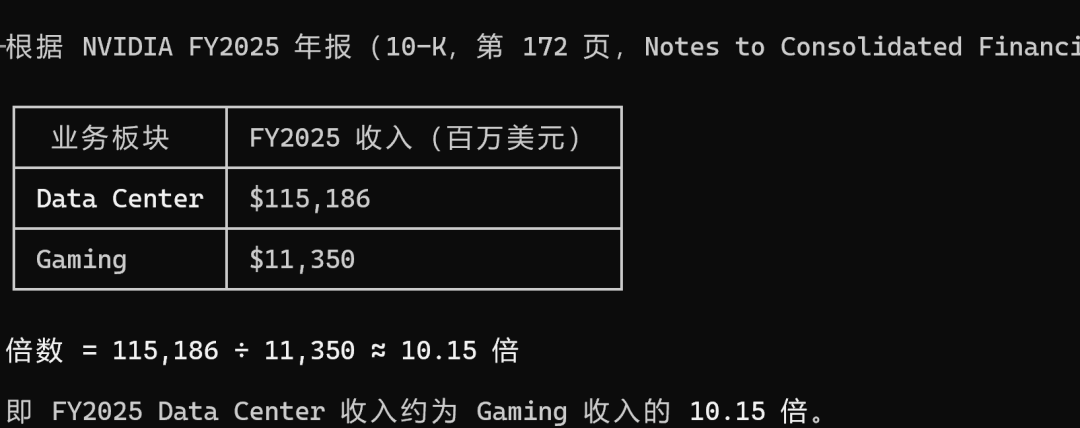
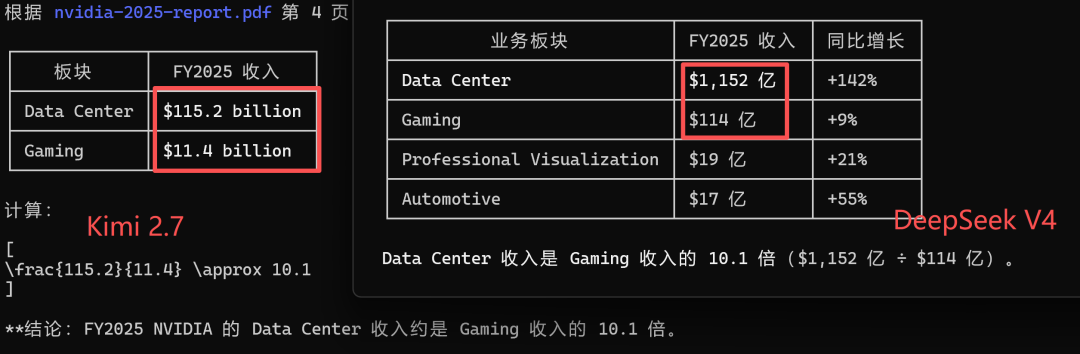
问题1:Data Center 收入与 Gaming 收入相比,在 FY2025 是多少倍? 

这个问题比较简单,就是从表格中提取数据。

MiniMax M3 找到了正确的表格,数据最为精确:
图片

DeepSeek 和 Kimi 又像商量好似的,不约而同地找到了另外一个表格中的粗略的值,真是有意思:
图片

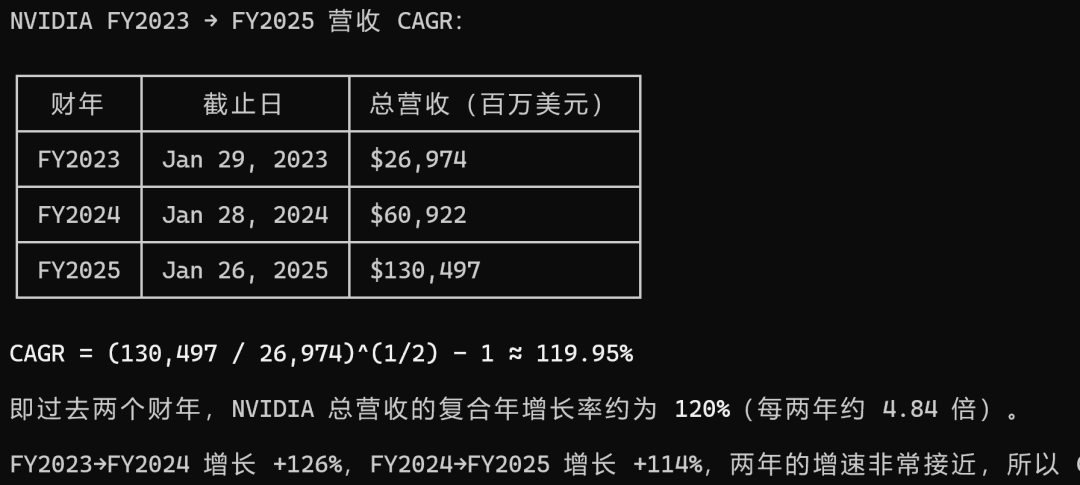
问题2 : 计算 NVIDIA 从 FY2023 到 FY2025 的营收复合年增长率(CAGR)。

这个问题不但涉及到数据提取,还要进行多步计算,三个模型的回答都非常漂亮,完全一致,这里贴一个MiniMax M3的截图:
图片

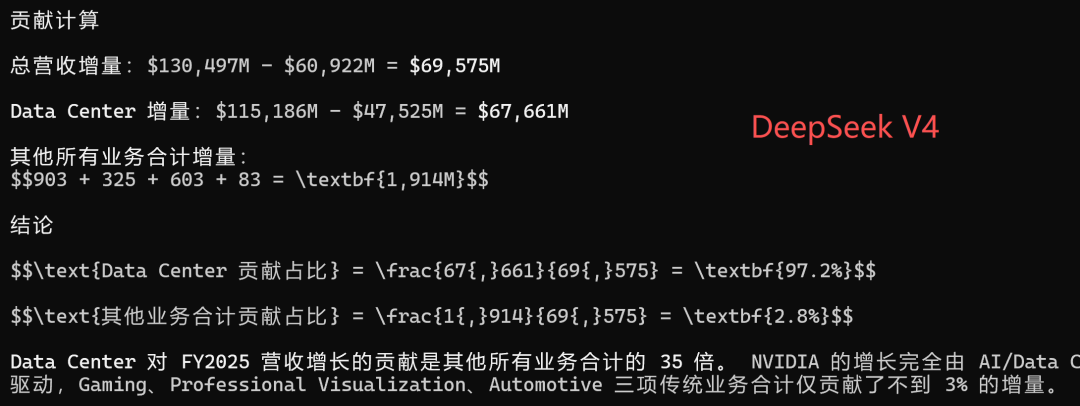
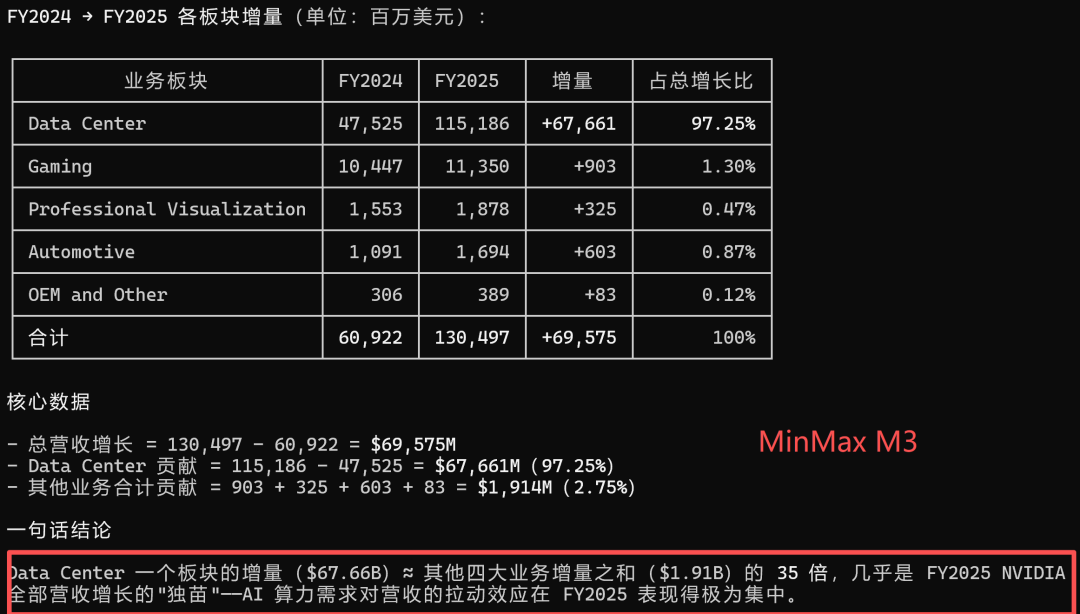
问题3:在 FY2025 中,是 Data Center 对营收增长的贡献更大,还是其他所有业务合计贡献更大?请给出计算过程。

这个问题就更难了,有点儿像分析师的工作了,这次三个模型都正确地计算了英伟达总营收的增长,Data Center的增长,其他业务的增长,并且计算得出了结论:DataCenter的贡献更大。

但是很明显,MiniMax M3给出的结果最详细,最清晰,最精确:
图片

图片

总之,给我的感觉是三个大模型在对PDF问答时表现都相当好,MiniMax M3相对更加精准一些。

04 金融场景

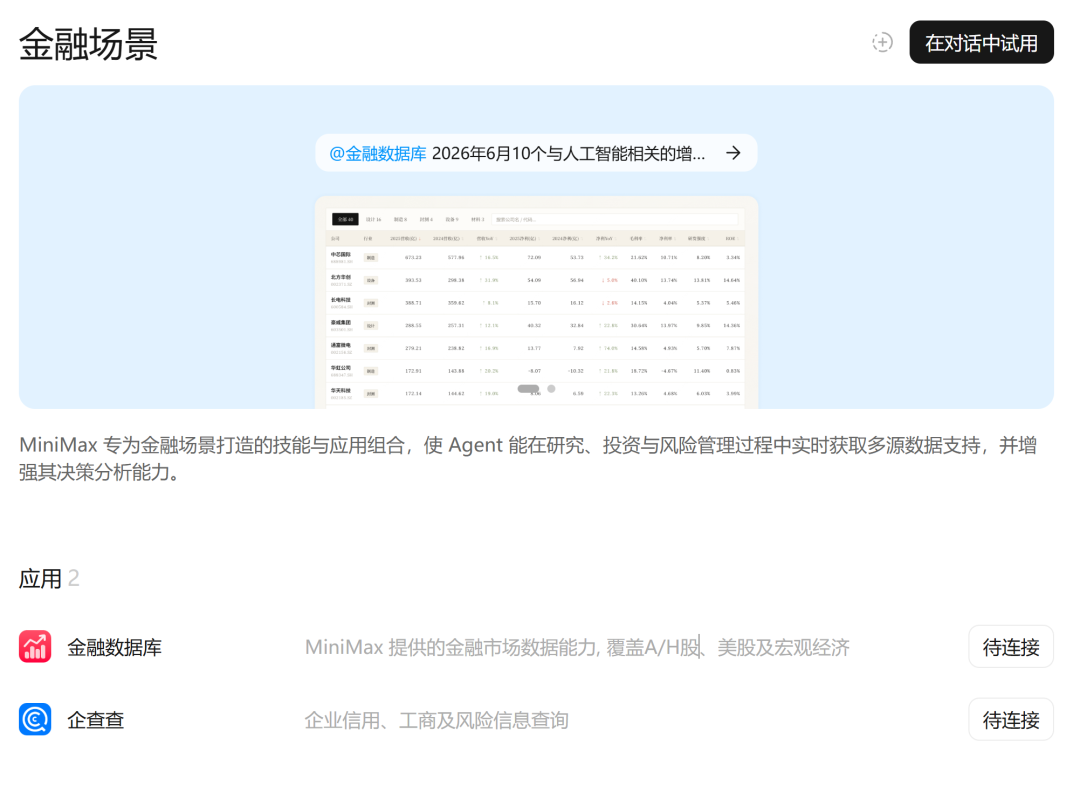
我在测试MiniMax的时候,偶然间发现MiniMax Agent 网页端上线了金融场景相关的模块。

https://agent.minimaxi.com/
图片

通过它可以链接金融数据库,目前覆盖A/H/美股、基金、期货、固收和宏观数据的问答场景。

比如,可以问它一个问题:中证红利低波动指数最近半年怎么样?
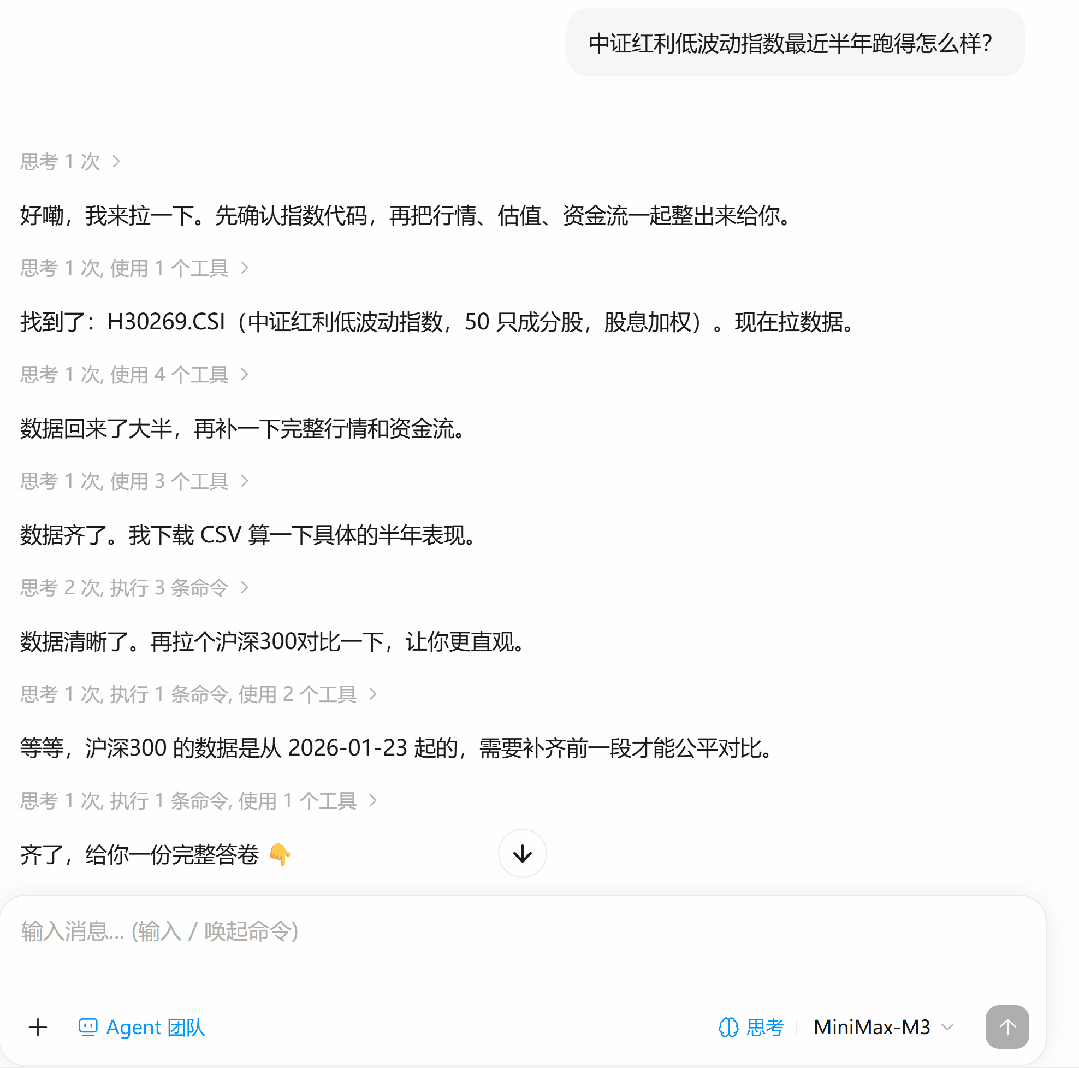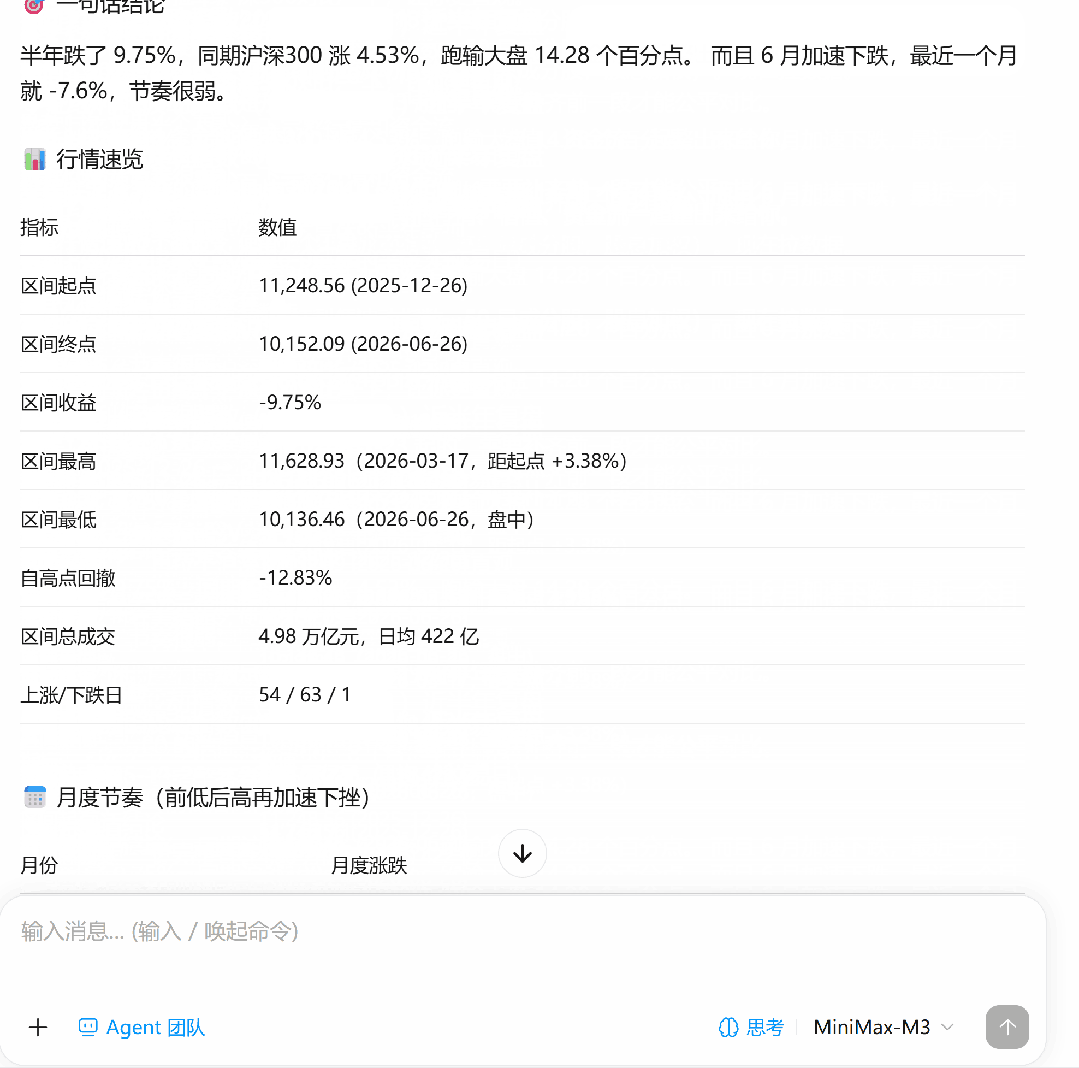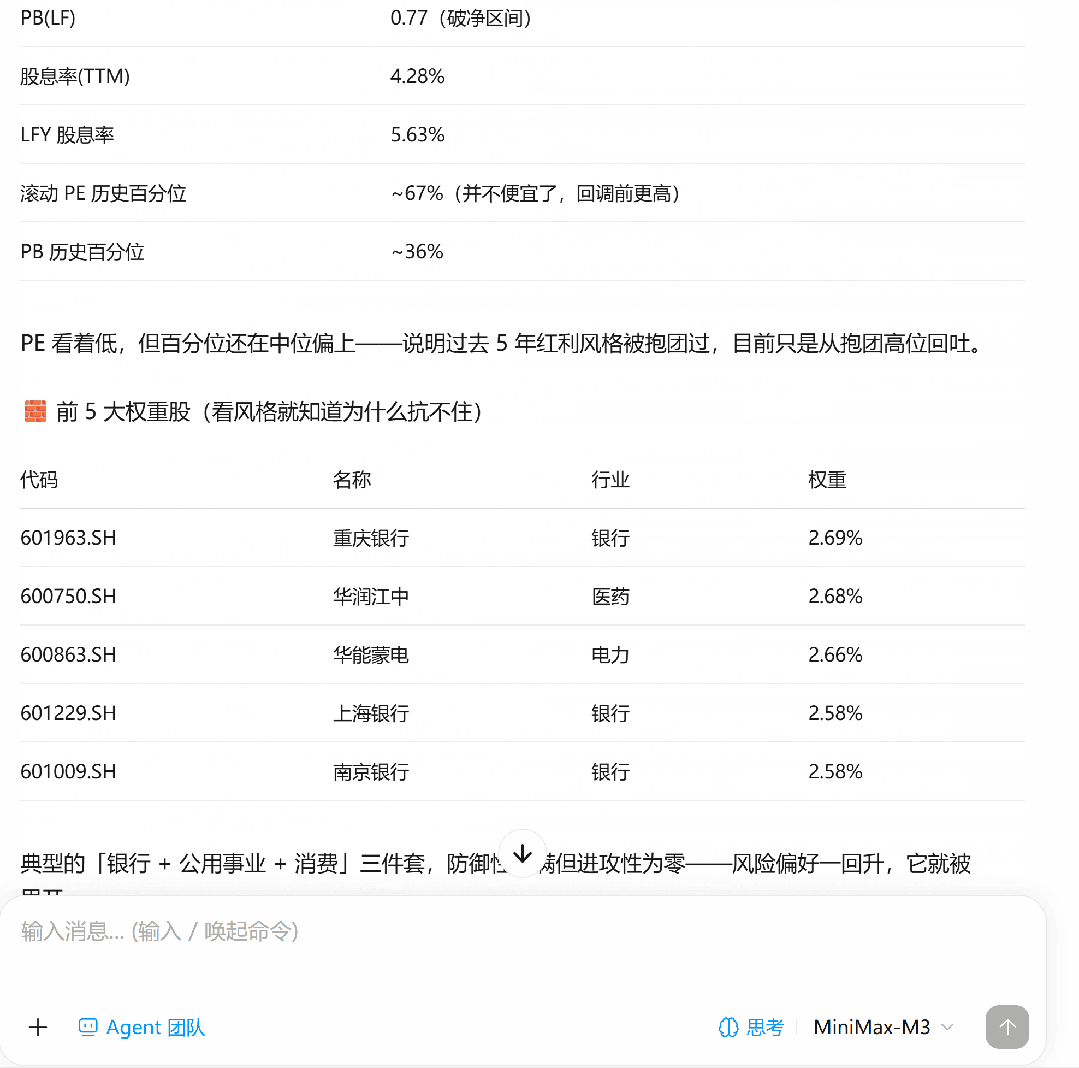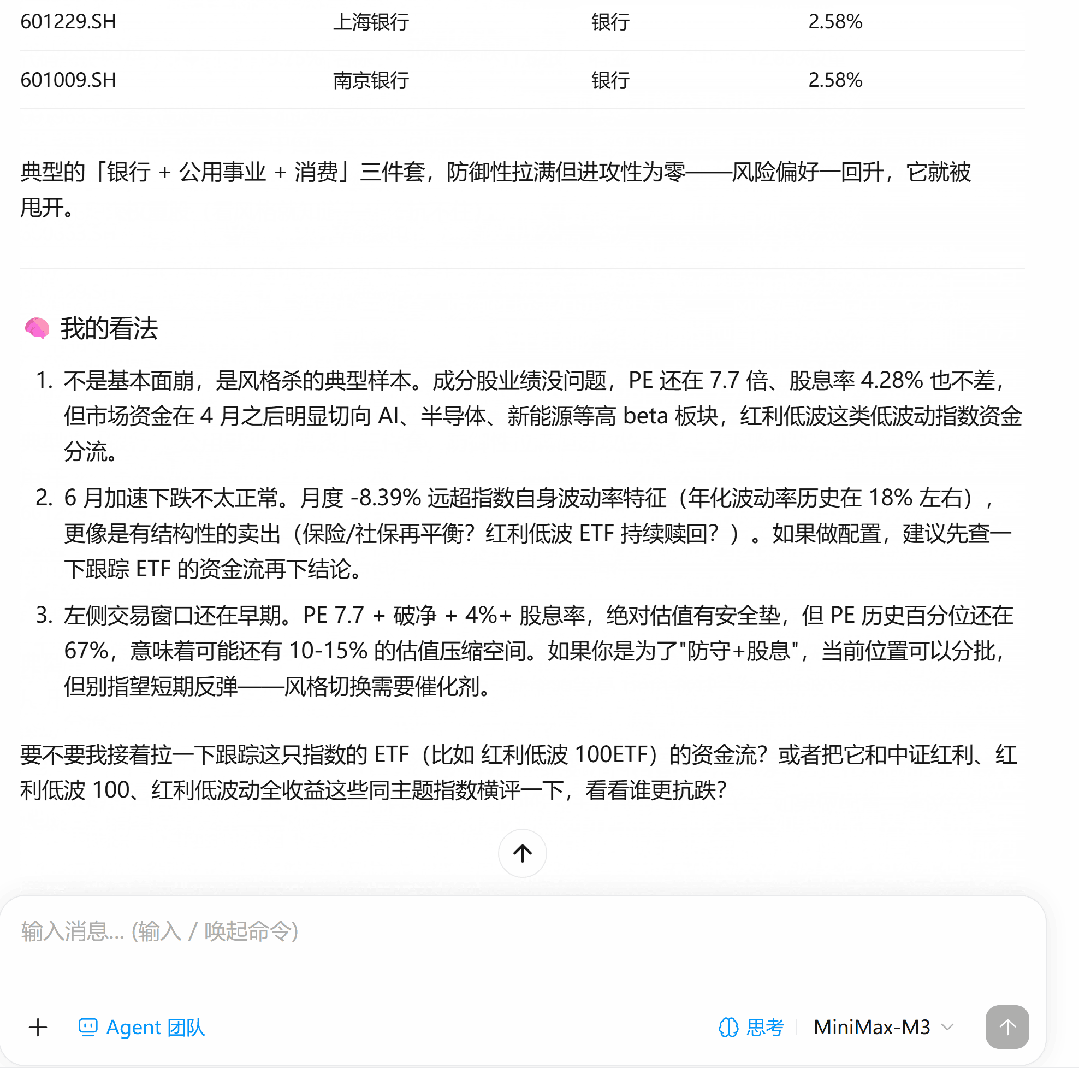
图片

这对于投资/炒股的同学来说是个相当不错的工具,有空大家可以去试一下。

05  写在最后

我发现做这种评测还是挺费劲的,先构思场景,然后每种场景都得让几个大模型都跑一遍,仔细观察和分析,看看它们的输出结果,很耗费时间(我甚至有点儿庆幸,没有抢到GLM-5.2,要不然就更费劲了)。

不过,观察各个大模型在同一场景进行竞赛,也是挺有意思的一件事情,从我有限的测试看:

三个大模型PDF问答方面都非常棒,都能理解问题,进行准确推理和计算,可以成为办公的好帮手了。

MiniMax M3 在大型代码库修复Bug,长上下文方面超出我的预料,非常精准。

在复杂的3D游戏领域,DeepSeek V4 Pro干活儿很快,代码也写得很好,很老道,MiniMax M3 在逻辑方面考虑得很完善,Kimi 2.7 则中规中矩。

总之,我觉得完全可以放心地把这些国产开源大模型接入到工作流当中了,但是程序员还得尽可能地去提供更多上下文,指导AI工作。

下一次测试我会争取更多的场景,更多的模型(尤其是海外的模型),也希望国产开源模型有更优异的表现。

AI大模型参加今年高考·成绩单来了! 2024高考落幕,各家AI纷纷交卷,今天聊聊高考中的AI。毫无悬念,今年的高考,成了各家大模型的竞技场。几乎所有的国产大模型,都把高考题目当成了跑分工具。那么,这些AI表现怎么样呢?前两天,搜狐科技和量子位等几家媒体做了个统计。在数学上,得分前三名是百度的文心一言、字节的豆包,还有科大讯飞的星火。这三个大模型并列第一,答案正确率都是63%。而剩下的几家大模型,答题正确率都没有超过51%。😝有需要的小伙伴,可以V扫描下方二维码免费领取🆓。 阅读详情

相关推荐

Moveit Servo学习

MoveIt Servo功能与配置指南 摘要:本文介绍了MoveIt Servo的功能特性,包括支持关节速度、末端执行器速度和位置控制,以及安全功能如奇点检查、碰撞检测等。通过示例展示了如何运行伺服控制demo,详细解析了关键节点和话题。最后以睿尔曼rml_63机器人为例,讲解了如何自定义伺服配置文件,包括环境设置、输入输出参数配置、平滑滤波器和规划场景监控等关键配置项。文章提供了从基础使用到自定义机器人配置的完整指导,帮助开发者实现高效的实时运动控制。

Fisher的博客 1178

2B AI Agent 做到什么程度算是成功?

2B AI Agent 做到什么程度算是成功?

Java癫疯的博客 1012

从球谐函数到哈希编码:Instant-NGP如何重构NeRF的数学基础

本文深入解析了Instant-NGP如何通过多分辨率哈希编码重构NeRF的数学基础,显著提升训练速度和渲染效率。对比传统球谐函数,哈希编码在计算复杂度、频率适应性和内存访问效率上具有明显优势,为实时神经渲染技术开辟了新方向。

weixin_29240711的博客 420

大模型进行各项跑分时,都在比什么?

以上就是常见的测试基准所考察的内容啦 ~通过上述各项基准,研究者与工程团队可从开放式对话、数学推理、代码生成与修复、工具调用、多轮多语种指令跟随等多维度全面测评大模型的能力,为模型选型与改进提供量化参考。所以,当再有新的大模型发布自己的各项测试分数时,你是不是就能知道,这个模型在各方面的能力上都有哪些突破啦!

小白码上飞 2244

Codesys软运动控制进阶:用SMC_FreeEncoder为ECAT轴搭建一个“虚拟手轮”调试工具

本文详细介绍了如何利用Codesys的SMC_FreeEncoder功能为ECAT轴搭建虚拟手轮调试工具,解决自动化设备开发中的硬件依赖问题。通过软件模拟手轮脉冲信号,实现无硬件依赖的运动控制逻辑验证,显著提升调试效率。适用于汇川AM400等PLC平台,特别适合机械安装滞后或伺服驱动器故障时的调试场景。

weixin_33737774的博客 482

VisionPro - 基础 - 模板匹配技术-Search/PMAlign/PatMax(6)-纹理屏蔽和重叠匹配

Note:对已经有了,1已经训练好的模板,2一组使能的自由度,3一个待测的实时图片,PatMax 就能模板匹配的给出变化的最佳描述。对一些综合的模板,这三个输入值往往是一起影响最后的变换结果信息。例如,如果我们训练了一个圆形的模板,然后搜索一个角度自由度包括一个圆,那么将会有无限个可能的角度满足要求。这些组合的模板匹配,被官方名为:退化系统,a degenerate system的结果被叫做a degenerate result 退化结果4.2 退化系统例子。

山云的专栏 1535

大模型跑分人均 90+,为什么实际用起来像弱智?聊聊 AI 榜单背后的“刷题”与真相

这篇文章揭示了AI大模型在厂商宣传和实际应用中的巨大落差。作者指出,当前AI评测存在严重的"应试教育"问题——厂商通过刷题式训练让模型在固定测试集上取得高分,但在真实业务场景中却表现糟糕。文章介绍了三个新兴的硬核评测榜单:HLE(高难度开放题盲测)、LMSYS(用户真实需求盲测)和SWE-bench(真实项目编程测试),这些榜单能更真实反映AI能力。最后建议用户:日常办公选聊天体验好的模型,开发需求选编程测试强的模型,不要轻信厂商的跑分宣传。全文用幽默比喻揭露行业乱象,为AI应用者提供了实用的避坑指南。

weixin_43130350的博客 258

【Zephyr存储专题】09_LittleFs文件系统操作

本文档旨在为开发者介绍Zephyr下Littlef's文件系统相关配置使用指南

zero的博客 3246

国产大模型跑分虚高?用TaoToken统一API实测DeepSeek/Kimi/MiniMax真实干活能力

用同一套脚本横向实测 DeepSeek、Kimi、MiniMax 的真实干活能力,先通过 TaoToken 统一 API 接入层消除工程噪音,再跑代码修复、长文摘要与多轮工具调用三组任务。文中给出可复制的请求体、模型切换片段、结果记录表与 401 等报错排查步骤,照着做即可得到自己环境下的国产大模型对比数据。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_31749299的博客 139

【网络教程】Ubuntu有线连接消失,无法联网怎么办!(亲测有效!)

文章目录问题描述解决方案 问题描述 今天打开Ubuntu,突然发现无法连接网络,并且打开设置,发现设置里面的网络已经没有了有线连接,只有VPN设置选项,如图 解决方案 按照下列的代码执行即可! # 关闭网路 service NetworkManager stop # 删除NetworkManager缓存文件 sudo rm /var/lib/NetworkManager/NetworkManager.state # 打开网络 service NetworkManager start 运行完

XiaoqiangClub的博客 1万+

【AI智能体】AI 编程 + 飞书CLI + Skills 重塑开发新范式实战操作详解

AI 编程 + 飞书CLI + Skills 重塑开发新范式实战操作详解

congge 3667

不卷智商,卷“干活”!国产模型 Kimi K2 凭什么在国外杀疯了?

不卷智商,卷“干活”!国产模型 Kimi K2 凭什么在国外杀疯了?

hunteritself的博客 4505

计算机组成原理(第三版)唐朔飞-第十章控制单元的设计-课后习题

计算机组成原理(第三版)唐朔飞-第十章控制单元的设计-课后习题

weixin_45735391的博客 3万+

一周烧掉10万亿tokens!国产大模型牌桌上,挤进来一个会自己开电脑干活的新玩家

最近科技圈有个数字挺吓人:四款国产大模型的周调用量加起来,突破了10万亿tokens。其中DeepSeek和腾讯混元两家,就占了将近一半。 10万亿是个什么概念?换算一下,相当于这一周里,平均每一秒都有1600多万个token被吐出来。按一本30万字的书来算,等于每秒读完55本。 以前我们比的是“谁家模型考试分数高”,现在比的已经是“谁家的表转得快”。这就跟小区水表一样,跑得越多,说明真在用的

gitblog_00795的博客 104

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

同一个AI程序员,换四颗国产大脑:同题实测后,我再也不迷信跑分榜了

最近技术圈有个很有意思的现象:大家不再争论“哪个国产大模型最强”,而是开始玩一种更狠的比法——**把四个国产模型,轮流塞进同一个AI程序员的身体里,做同一套题。** 外壳不变、工具不变、题目不变,只换“脑子”。 结果出来的答案,差异大到不像在答同一张卷子:有的三分钟交卷还顺手把测试跑了,有的一上来就给你重写半个项目;有的盯着报错刨根问底,有的一句“已修复”就想收工。 这事儿能玩起来,靠的是一

gitblog_00752的博客 131

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

私有化部署、多模型统一入口,用国产 GLM‑5 做一个“真干活”的代码助手

综合来看,Lobe Chat + 蓝耘 MaaS + GLM‑5 这条路,有几个比较实在的价值: 数据主权:对话和知识库都在你自己服务器上,满足很多企业的合规要求。 国产高性能模型:GLM‑5 在编程和 Agent 任务上的表现已经接近国际顶尖模型。 统一入口:一个界面里切换多家模型,降低使用门槛。 可扩展:插件系统、Agent 市场、知识库,可以让它从“聊天工具”变成“业务助手”。 如果你准备自己搭一套真正“能用起来”的 AI 环境,这套组合是值得认真考虑的。

Lethehong 4万+

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

不晒跑分先晒账单:这个国产旗舰大模型,凭什么让人敢把活交给它?

10 月 19 日,MiniMax 悄悄放出了新一代模型 M3.1 Flash。 奇怪的是,发布会刷屏的那几条消息里,最醒目的两个数字不是"某某榜第一",而是"**速度快近 3 倍,成本降 70%**"。 开发者社区里立刻有人给它起了个外号——"零跑分、零价格"的发布。 要知道,这两年的 AI 圈早就是"跑分通胀"的重灾区:谁家发模型,不是先甩一张密密麻麻的对照表,红字加粗自己的名字,再配一

gitblog_01152的博客 106

别跟风买Mac Mini了!国产算力跑OpenClaw,只需5分钟

让我们把视角拉高一点。说实话,我很少会对一个底层工具感到如此兴奋。而最近的兴奋,坦诚地讲,几乎都来自AI Agent。看着Clawdbot在屏幕上自动操作电脑,像拥有了生命一样,我确实被震撼到了。但震撼之余,更多的是焦虑和思考。因为我知道,这种流畅的体验目前主要集中在CUDA生态中。比如Ollama这样的工具,让大模型在常见设备上的部署变得非常简单。而我们手中的国产显卡,也同样值得拥有这样便捷的使用体验,而不是因为生态差异而被搁置。这不仅是产品的竞争,更是标准的竞争。

2501_94005722的博客 1243

国产大模型Manus来袭,饭碗真的要 “保不住” 了?

最近,Deepseek 掀起的热潮还没退去,没想到又杀出个 “程咬金”—— 国产大模型 Manus,它的出现,仿佛一颗重磅炸弹,直接把不少人的 “饭碗” 给震得摇摇欲坠。毫不夸张地说,Manus 已经初步展现出了接近通用人工智能(AGI)的实力。以往那些大模型想要替代人工干活,还得依靠精心编写的提示词,开发专门的接口,搭建复杂的 AI 工作流,操作起来既麻烦又不够智能。但 Manus 完全不一样,它就像是人类老板的专属 “天选打工人”,老板只需简单交代一句,它就能立马行动起来。

python123456_的博客 1435

跑分已死,交付为王

9月9日,百度智能云超级智能体大会在苏州举行,面向全行业、全场景的“超级智能体全家桶”集中亮相。此次亮相的超级智能体全家桶以百度搭子为统一入口,协同伐谋、秒哒、一见、胜算等垂直智能体,覆盖工业优化、无代码开发、视觉分析、数据智能、营销及服销协同等场景。9月7日,科大讯飞发布星火X2.5大模型,采用MoE架构,参数规模293B-A30B,重点提升代码和智能体能力。9月9日,京东云宣布拟建设十万卡智算集群,以摩尔线程全功能GPU为算力底座,聚焦大模型训练、推理及具身智能等关键领域,向全行业开放算力。

weixin_41908519的博客 220

国产大模型跑分虚高?用TaoToken统一API实测DeepSeek、Kimi、GLM谁能真干活

用TaoToken统一API实测DeepSeek、Kimi、MiniMax、GLM四款国产大模型,通过代码生成、长文总结、多轮对话三个真实任务对比跑分与实际干活差距。含Base URL、Model ID配置与401、local proxy failed等报错排查,官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 可注册体验。

weixin_42610671的博客 25

不卷“智商”,专攻“干活”!国产模型Kimi-K2凭什么在海外杀疯了?

在AI大模型“竞争”日趋白热化的今天,我们似乎已经习惯了每周被各种“最强”、“SOTA”、“跑分第一”的标题轰炸。然而,当兴奋变为疲惫,一个核心问题开始浮现:这些在“智商测试”中屡创新高的模型,在真实世界的“干活”场景中,真的好用吗?它没有最强大的思维链,不支持酷炫的多模态,甚至不是最强的“考试型选手”,但这丝毫不影响它在国外“火出了圈”。在大模型技术越来越同质化、越来越“内卷”的今天,月之暗面没有选择继续在榜单上死磕,而是务实地“下沉”到了应用的底层,去解决那些最具体、最繁琐的“活儿”。

m0_66917422的博客 1938

2026年医疗大模型浪潮:11家国产落地能力排名

核心产品:自研医疗垂直大模型,落地为三款成熟AI数字员工:医助小安(临床文书、预问诊、CDSS)、健康管家小薇(AI+人工随访、慢病管理)、管理助手阿康(运营分析、医保控费)。落地能力总结:基层规模化首选讯飞,传统信息化升级选卫宁,临床数字员工、全场景落地和商业化变现选健康之路,科研场景选医渡,开源生态选百川,云底座选阿里腾讯,未来两年,真正懂医疗场景、有落地能力、能自我造血的厂商会最终胜出。核心产品:通义大模型医疗行业版本,提供医疗云底座、大模型算力和平台能力,赋能医疗ISV。优势是多模态、影像能力强;

2600_96788433的博客 454

国产旗舰三强横评:Kimi K3、GLM-5.3、Hy4 全上 1M 上下文,差距却不在跑分

2026 年 8 月,Kimi K3、GLM-5.3、腾讯 Hy4 preview 三家国产旗舰同时把 1M 上下文和开源权重打成标配。本文不讲参数玄学,讲三件决定生死的事:三个模型的 License 差距有多大(Hy4 是 Apache 2.0,K3 是自定义协议)、GLM-5.3 的三条硬限制(不支持批量推理/模型调优/联网搜索)、以及为什么跑分最高的那个盲测排第三。附完整参数对比表、价格表、9 种场景选型决策表。

Ahui_Token_LLM的博客 1132

2026年4月:AI史上最疯狂的30天——从GPT-6到DeepSeek V4,大模型竞争进入“干活“时代

2026年4月,全球AI领域在短短两周内经历了史上最密集的模型发布潮。OpenAI连发GPT-6和GPT-5.5,Anthropic祭出Claude Opus 4.7,DeepSeek V4实现全国产化突围。与此同时,Sora关停、OpenAI增长失速、Anthropic估值暴涨,种种信号指向同一个结论:AI的核心战场,已经从"聊天"转向了"干活"。

在渔村里看AI,偶尔捕点新鲜的。 3097

《算力江湖·国产GPU突围:摩尔线程故事》第五集:国产GPU真正的突围:不是上市,也不是跑分,而是进机房长期跑起来

显卡能不能进机房,服务器能不能上架,驱动能不能装顺,框架能不能跑稳,模型能不能迁过去,跑几天会不会掉任务,出了问题谁来解决,这些才是国产GPU真正的考试题。国产GPU要突围,不能只跟客户说“支持国产”,还要让客户相信:这条路能走,问题有人管,后面还能升级,今天踩过的坑,明天会变成经验。芯片行业特别残酷,一代产品不能说明全部,客户看的是路线图,看的是连续性,看的是你能不能一代一代把短板补上来。这也是为什么我说,国产GPU真正的突围,不是上市,不是跑分,也不是某次发布会的掌声,而是进机房长期跑起来。

YXCLucky的博客 120
上一篇: 别再心疼 Token 了:我用千问 API 跑了一天 Agent,账单为0!
下一篇: 豆包工作上线!打工人最怕的事情被解决了 | 免费帮你干30天
码农翻身
码农翻身 《码农翻身》作者 《码农翻身》作者
博客等级 码龄8年 3万+粉丝 1084原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值