小白程序员必看:RAG让AI装上实时查资料外挂,轻松提升输出准确性!收藏学习必备!

基于PID算法的循迹小车 这一期为创客们带来基于PID算法的循迹小车制作 1.标准赛道示意图: (该赛道包含了:左直角、右直角、十字路口等路况) 2.灰度传感器安装示意图: (可根据实际情况调节各传感器之间的间距) 3.硬件原理图: 4.控制逻辑: 5.程序如下: #define leftA_PIN 7 #define leftB_PIN 6 #define left_Pwm_PIN 5 #define STBY... 阅读详情

RAG(Retrieval-Augmented Generation)技术通过结合信息检索和自然语言生成,有效提升AI模型性能。它如同为AI(如GPT、文心一言)配备实时查资料外挂,先从外部数据库或网页精准搜索信息,再将其转化为参考资料,最终生成准确答案。RAG的核心步骤包括检索、增强和生成,解决了AI记忆局限和输出不准确的问题。通过分块、语义编码、向量检索和带资料提问等流程,RAG使AI从依赖记忆的选手转变为依靠参考资料答题的可靠助手,广泛应用于聊天机器人、智能助理等领域。

用大白话解释一下,RAG 就是给 AI 生成模型(比如 GPT、文心一言)装了个 “实时查资料的外挂”:

1、先从外部数据库 / 网页里精准搜到相关信息

2、再用这些靠谱信息转换为可读的 “参考资料”

2、最后生成答案

既解决了 AI“记不住新东西、容易瞎编” 的问题,又让输出更准、更有依据

拆成 3 个核心步骤:

1、检索(Retrieval):AI 先当 “搜索引擎”—— 你问它 “2025 年 AI 产品经理岗位需求变化”,它不会直接瞎答,而是先去爬行业报告、招聘网站、权威文章,把和 “岗位需求” 相关的信息都捞出来;

2、增强(Augmented):这些捞出来的信息,就成了 AI 的 “临时知识库”—— 相当于考试前给它划了重点,让它不用靠自己 “过时的记忆” 答题;

3、生成(Generation):AI 再当 “文案整理师”—— 把搜到的重点信息整合、润色,用自然语言讲给你听,最后输出 “2025 年 AI 产品经理更看重 RAG 应用能力、数据分析能力,新增了跨部门协同要求” 这类具体答案。

对比普通 AI(没装 RAG)的区别:

普通 AI:靠训练时的 “老记忆” 答题,可能告诉你 “2023 年的需求”,甚至编不存在的要求;

RAG 增强 AI:靠 “实时检索 + 参考资料” 答题,答案又新又准,还能溯源(比如告诉你答案来自某平台的某报告)。

RAG 模型⼴泛应⽤于聊天机器⼈、智能助理、问答系统和其他需要实时信息的⾃然语⾔处理任务。底层原理如图:

图片

这个图就是 RAG 工作的 “完整流水线”,跟着以下步骤就能看懂:

第

一、图左上角的Knowledge base(知识库)是 RAG 的 “素材仓库”—— 比如你做 “Chat With Your Code”,仓库里存的就是所有代码文档(Documents)。

但整份文档太长,大模型读不下、也找不到细节,所以要做Chunking(分块):把长文档切成一小段一小段的Chunks(文本块)(对应图里步骤 2 的绿色方块)

这一步的核心是:把 “大资料” 拆成 “小信息便利贴”,为后续精准找资料打基础。

第

二、步骤 3 的Embedding Model(嵌入模型)是 RAG 的 “语义翻译机”:它会把每一个「Chunks」,以及你后续输入的「Query(用户提问)」,都转换成一串数字 —— 这串数字叫「Embeddings(嵌入向量)」(图里的「[0.12, 0.43, -0.51]」就是例子)。

为啥转数字?

计算机看不懂 “文字的意思”,但能通过 “向量的距离” 判断语义是否相近:

比如 “代码怎么运行” 和 “运行代码的步骤”,转成向量后距离很近;

而 “代码怎么运行” 和 “今天吃什么”,向量距离会很远。

第

三、步骤 4 的Vector Database(向量数据库),是 RAG 的 “语义保险柜”:它存的不是文字,是Embeddings(嵌入向量)+ 对应的Text Chunk(文本块原文)+Metadata(元数据,比如这个 Chunk 来自哪份文档),还会建Index(索引)方便快速搜。

图里的Embedding space(嵌入空间)是这些向量的 “数字地图”:每个点代表一个 Chunk 的向量。

当你的Query转成Query Vector(查询向量,图里橙色点)后,会在ANN Search space(近似最近邻搜索空间)里圈出红圈 —— 找到和它距离最近的Similar Vector(相似向量,蓝色点),对应的 Chunk 就是 “和问题最相关的资料”。

第

四、找到相关资料后,步骤 5 的Prompt Template(提示词模板)就登场了:模板里写着Answer this ‘Query’ Based on the the Following Context—— 翻译过来就是 “必须照着下面的参考资料(Context)回答我的问题”。

这里的Context,就是步骤 4 里找到的相似 Chunk。把 “你的 Query + 对应的 Context” 拼在一起,就成了给大模型的 “带资料的问题”。

第

五、最后一步步骤 6 的LLM(大语言模型,图里是 Llama-3),是 RAG 的 “最终答题者”:它拿到 “带资料的问题” 后,不会瞎编

因为提示词要求它基于 Context 回答,所以它会把 Context 里的信息整理成自然语言,生成准确的Final Response(最终回复)。

回复会传回步骤 7 的「ChatWithYourCode!」交互界面,你就能在「Ask anything…」框下看到精准回答了。

最后,用一句话总结 RAG 流程图逻辑:

通过“分块→语义编码→向量检索→带资料提问”流程,让大模型从 “靠记忆瞎编的选手”,变成 “拿着参考资料答题的靠谱考生”

——这就是 RAG 能让 AI 输出更准的核心。

最后

如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。

图片

现在的市场,已经用数据给程序员指明了方向:学AI大模型,就是冲刺高薪的最优解!

图片

看着身边越来越多的同行转型大模型、拿到高薪offer,很多人心里都动了心,但真正的难题来了:零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?

别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序员和小白!

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

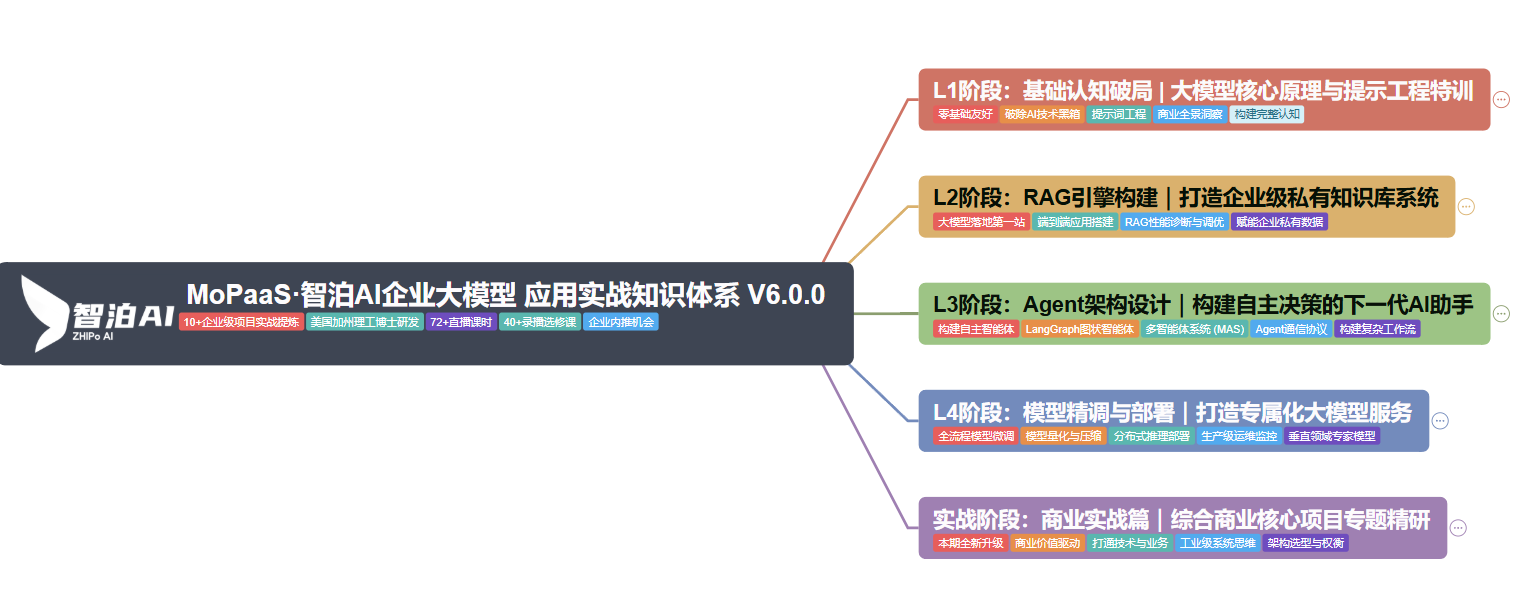
1、大模型系统化学习路线

在这里插入图片描述

2、大模型学习书籍&文档

在这里插入图片描述

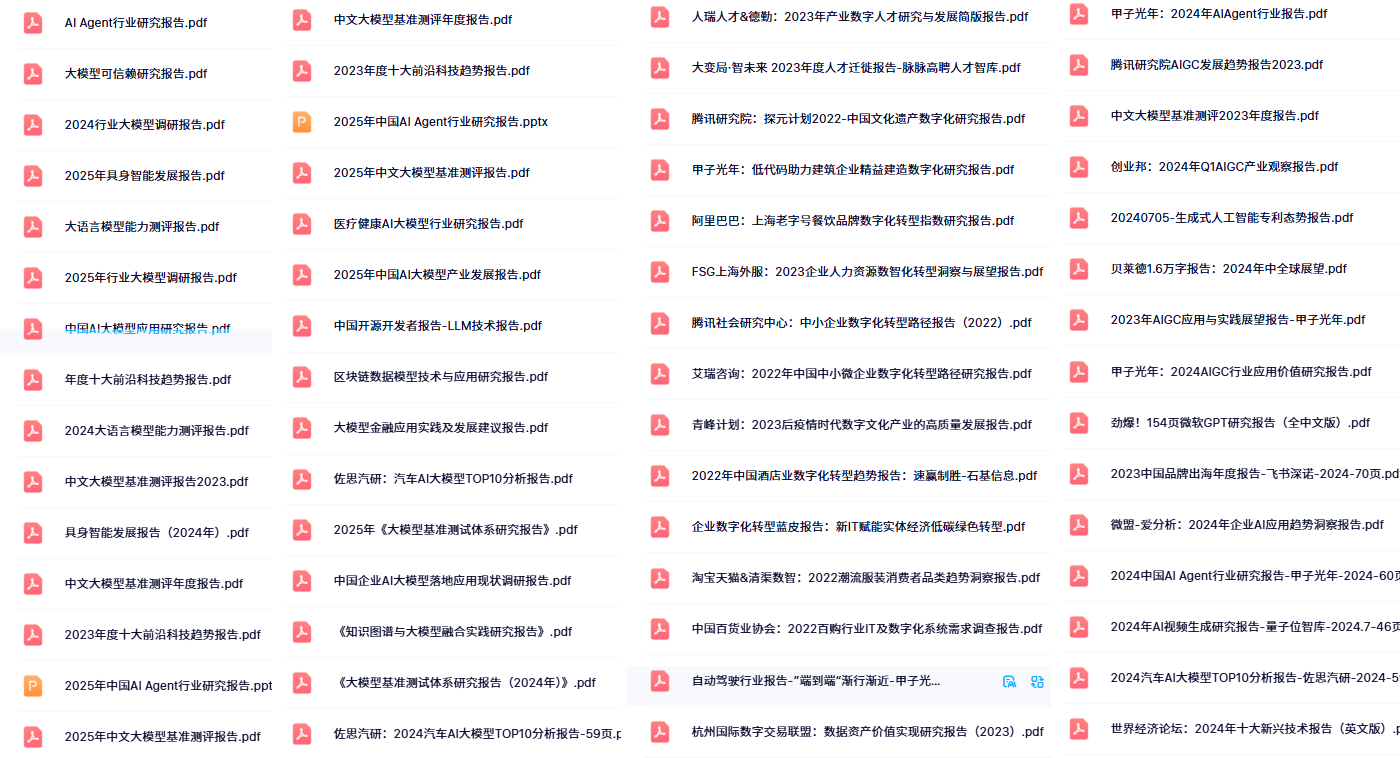
3、AI大模型最新行业报告

在这里插入图片描述

4、大模型项目实战&配套源码

img

5、大模型大厂面试真题

img

四阶段精细化学习规划(附时间节点,可直接照做)

结合上述资源,给大家整理了一份可直接落地的四阶段学习规划,总时长约2个月,小白可循序渐进,程序员可根据自身基础调整节奏,高效掌握大模型核心能力,快速实现从“入门”到“能落地、能面试”的跨越。

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

6、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

TI理想二极管在冗余电源中应用实例 深入探讨理想二极管如何提升冗余电源系统的效率与可靠性,通过实际应用案例展示其在电流隔离和自动切换中的优势,帮助工程师优化电源架构设计。 阅读详情

相关推荐

从零开始:用ADS 2023手把手教你设计2.4GHz Wi-Fi LNA(基于ATF-54143,附模型文件)

本文详细介绍了如何使用ADS 2023软件设计2.4GHz Wi-Fi频段的低噪声放大器(LNA),基于ATF-54143晶体管。内容涵盖模型导入、直流工作点确定、稳定性优化、噪声匹配等关键步骤,并提供可下载的模型文件包,帮助工程师快速掌握LNA设计技巧。

weixin_42531128的博客 323

小白程序员必看:用RAG给AI装上实时查资料外挂,轻松提升大模型输出质量!收藏起来学习!

RAG技术通过结合信息检索和自然语言生成,有效提升AI模型的性能和准确性。它如同为AI(如GPT)配备实时查资料的外挂,首先从外部数据库或网页精准检索相关信息,再将其转化为可读的参考资料,最后生成答案。RAG包含三个核心步骤:检索、增强和生成。普通AI依赖训练时的“老记忆”答题,可能提供过时或虚构的信息;而RAG增强的AI则通过实时检索和参考资料答题,确保答案的新鲜度和准确性,并能溯源。

youmaob的博客 383

使用mne包来对脑电数据进行预处理(一)

MNE(MNE-Python)是一个用于处理脑电(EEG)、磁图(MEG)和其他神经科学数据的Python库。它提供了丰富的功能,包括数据加载、预处理、分析和可视化,旨在帮助研究人员和神经科学家更轻松地进行脑电数据的处理和分析。在本文中,我们使用mne来对不同的格式的脑电数据集进行数据读取。

m0_71596228的博客 4306

收藏!用大白话秒懂RAG,给AI装上实时查资料外挂,小白也能轻松学会!

因为提示词要求它基于 Context 回答,所以它会把 Context 里的信息整理成自然语言,生成准确的Final Response(最终回复)。回复会传回步骤 7 的「ChatWithYourCode!」交互界面,你就能在「Ask anything…」框下看到精准回答了。最后,用一句话总结 RAG 流程图逻辑:通过“分块→语义编码→向量检索→带资料提问”流程,让大模型从 “靠记忆瞎编的选手”,变成 “拿着参考资料答题的靠谱考生”——这就是 RAG 能让 AI 输出更准的核心。

2301_76168381的博客 215

FPGA与GPU异构计算:重塑嵌入式AI的算力边界与场景定义

本文深入探讨了FPGA与GPU异构计算如何突破嵌入式AI的算力瓶颈。通过分析工业视觉、智能交通及航天等场景,阐述了FPGA负责高速数据采集与预处理,GPU专注复杂AI推理的协同模式,有效解决了传统单一架构在算力、功耗、接口和实时性上的挑战,为嵌入式AI应用提供了高效能解决方案。

spice的博客 486

Qt基础之十九:进程与QProcess

进程就是一个程序的执行实例,也就是正在运行的程序。对操作系统来说,进程就是一个担当分配系统资源CPU时间、内存的实体。在Qt 中,我们使用QProcess来表示一个进程。这个类可以允许我们的应用程序启动一个新的外部程序,并且与这个程序进行通讯。当外部程序开始启动时,QProcess的状态为Starting;外部程序已经启动时,QProcess的状态为Running,并发送started()信号;当外部层序退出了,QProcess的状态为NotRunning(初始状态),并发送finished()信号。

草上爬的博客 1万+

收藏!小白程序员必看:轻松掌握RAG技术,提升大模型准确性与实时性

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

zhixueyouke的博客 543

YOLOv11改进 | 特殊场景检测篇 | 低照度图像增强网络SCINet改进黑暗目标检测(全网独家首发)

本文给大家带来的改进机制是低照度图像增强网络SCINet,SCINet(自校正照明网络)是一种专为低光照图像增强设计的框架。它通过级联照明学习过程和权重共享机制来处理图像,优化了照明部分以提升图像质量。我将该网络集成在YOLOv11的主干上针对于图像的输入进行增强,同时该网络的并不会增加参数和计算量,基本和普通的网络结构保持一致,同时该结构支持自定义调节层数,来控制图像增强的效果 ,非常适合想要在黑夜目标检测领域发表文章的读者,该基本网络不会影响模型的速度。欢迎大家订阅我的专栏一起学习YOLO!

Snu77的博客 2207

大模型RAG技术详解:如何为AI装上“外挂大脑“!

RAG(检索增强生成)技术通过"检索先行,生成后"架构,解决大模型知识固化、实时性缺失问题。它从外部知识库检索相关信息,与问题结合后输入大模型生成答案,实现知识实时更新、支持私有数据、提升准确性和降低成本。RAG已在客服、法律、教育等领域展现潜力,未来将向多跳检索、跨文档推理等更高级能力发展。

2401_85343303的博客 708

KCP(快速可靠UDP)——用带宽换延迟的极致艺术

想象你是一个外卖平台的调度员。这就是KCP的本质——

本博客聚焦游戏开发技巧、创业实战心得及大学热门课程干货。这里既有技术深度,也有思维广度,无论你是开发者、创业者还是高校学子,都能在这里找到适合自己的成长之路! 205

CGAL 网格等高线计算

CGAL 网格等高线计算

dayuhaitang1的博客 452

【必学收藏】RAG+MCP实战:让AI助手拥有实时数据能力,小白也能轻松上手

RAG是一种AI框架,它将传统信息检索系统(如搜索引擎和数据库)的强大功能与擅长自然语言生成的AI模型相结合。简单来说,RAG就像是在写详细报告之前,先向图书馆员咨询信息一样。它能够为AI模型提供外部知识,让模型在回答问题时更加准确、实时且具有上下文意识。实时且准确的回答:通过检索最新的信息,RAG能够确保AI的回答基于最新的数据。减少“幻觉”:AI模型有时会生成一些看似合理但实际上并不存在的信息,这种现象被称为“幻觉”。RAG能够通过检索真实数据来减少这种情况的发生。上下文感知的答案。

qq_46094651的博客 1962

Vue3 - 强力解决前端下载二进制流pdf文件、下载成功后打开空白问题解决,或者获取PDF文件流,将blob对象转换成下载链接打开后一片空白(无论是否使用pdf插件下载,还是原生方法下载都完美解决)

vue3前端下载二进制流pdf文件,下载成功,打开空白问题解决,js下载PDF文件流,打开空白问题,VUE3 h5中的文件流下载和指定的url下载总结(解决下载后的pdf打开空白情况)pdfjs打开文件流空白,解决pdf文件流,预览全是空白页,pdf文件流,下载正常,但是预览全是空白页,前端JS获取PDF文件流,将blob对象转换成下载链接打开后一篇空白的问题,前端文件流下载后文件空白,前端下载文件流PDF文件显示空白 或 无法打开,在线预览PDF文件打不开白屏怎么办,前端axios请求二进制数据流转换生成

🏆 前端领域优质创作者 4620

提升 RAG 模型准确性的八大策略

RAG结合了生成式模型的语言理解能力和检索系统的内容回溯功能,是一种帮助解决复杂查询需求的有效方案。然而,要让 RAG 模型在实际场景中表现优异,还需要对其进行有针对性的优化。本文介绍了八种提升 RAG 模型准确性和召回率的实用策略,希望对从事相关工作的朋友有所帮助。在搜索查询的过程中,是一种非常有效的方式。首先,我们最大化召回率,即尽量多地获取与查询相关的内容;接下来,通过 Reranking 技术对这些内容重新排序,以优先展示最相关的结果。:两阶段优化能够兼顾召回率和准确性。

2401_85378759的博客 2552

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

程序员必看:一文搞懂RAG原理,给大模型装个“实时查资料外挂“(建议收藏)

RAG(检索增强生成)结合信息检索与生成技术,通过"检索-增强-生成"三步流程,让AI从外部数据库获取最新信息并生成答案,解决了AI"记不住新东西、容易瞎编"的问题。底层原理包括文档分块、语义编码、向量检索和构建带资料的问题,最终由大语言模型生成精准回答,广泛应用于聊天机器人、智能助理等场景。

m0_63171455的博客 696

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

RAG技术详解:给AI装个“实时查资料外挂“,告别胡言乱语,答案又新又准!

RAG(检索增强生成)是一种结合信息检索和生成的技术,通过检索外部信息、构建临时知识库、整合生成答案三个步骤,解决AI"记不住新东西、容易瞎编"的问题。其底层原理包括知识库分块、语义编码、向量检索和带资料提问等流程,使AI从"靠记忆瞎编"变为"拿着参考资料答题的靠谱考生",显著提高输出准确性和可靠性。

Trb201013的博客 810

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

RAG技术详解:给AI装个“实时查资料“的外挂,告别瞎编!

RAG技术结合信息检索与自然语言生成,为AI提供实时查资料能力,解决传统AI"记不住新东西、容易瞎编"的问题。通过知识库分块、语义编码、向量检索、构建带资料的提示词等步骤,让大模型从"靠记忆答题"转变为"拿着参考资料回答的靠谱考生",使输出更准确、有依据且可溯源,广泛应用于聊天机器人、智能助理等场景。

Gaga246的博客 735

必收藏!一篇吃透RAG到底是什么?(小白&程序员入门必备)

当我们需要衡量一个检索系统(或 RAG 的召回阶段)表现好坏时,“召回率”是一个最核心的度量标准。举个例子,系统里面 100 本关于产品使用手册的书,但是我发起检索之后系统回收了 60 本书,但是只有 50 本的内容跟产品使用手册有关系,那我们的召回率就是 60/50=83.33,相当于我们只找回来了 83 的知识,还有 17 的内容给遗漏了召回率越高,说明系统越"完整"——重要的信息不容易被漏掉。

EnjoyEDU的博客 2171

RAG技术深度解析:AI的’实时查资料外挂’,从检索到生成,打造靠谱的答题考生!

RAG是一种结合信息检索和自然语言生成的技术,通过检索、增强、生成三个步骤,给AI生成模型装上"实时查资料的外挂"。它先从外部数据库获取相关信息,构建临时知识库,最后基于这些信息生成准确答案。RAG解决了AI"记不住新东西、容易瞎编"的问题,通过分块、语义编码、向量检索等流程,使AI从"靠记忆瞎编"变成"拿着参考资料答题的靠谱考生"。

datian1234的博客 984

程序员必看!一文搞懂MCP、RAG、Agent,建议收藏学习

本文详细介绍了AI领域的三大核心技术:MCP作为"万能转换器"统一工具接口标准,解决大模型调用外部工具的难题;RAG通过知识检索增强生成,解决AI"幻觉"问题;Agent作为智能助理能主动理解任务并调用工具完成目标。三者协同工作形成"黄金三角",推动AI向更高级智能助手进化,为程序员和小白提供了理解AI发展趋势的关键视角。

weixin_72959097的博客 878

用Coze知识库+RAG技术,给AI装上「企业知识外挂」

企业知识库是培训咨询机构的核心竞争力,但这些内部资料往往无法被公开网络和大语言模型(LLM)获取。 如何让AI精准解答企业内部问题?关键在于用RAG技术为AI赋能!

xx_nm98的博客 1161

大模型不再胡说八道!RAG技术让AI变身可靠助手,程序员必学必收藏

RAG(检索增强生成)技术通过为AI提供外部知识库,解决大语言模型"幻觉"问题。它让AI像开卷考试一样先检索相关信息再生成答案,具有减少胡说八道、知识实时更新、保障隐私三大优势。适用于智能客服、企业知识库、内容创作和AI数字人等场景,使AI变得专属、可靠、有用,是程序员必备的实用技术。

datian1234的博客 1843

【必学收藏】RAG技术详解:让大模型具备“实时查资料“能力的医学应用指南

医学科研人员不一定要掌握 RAG 的所有技术细节,但理解它的原理和价值,可以更好地利用它并为科研和临床工作赋能。

AI大模型的博客 1227

收藏级干货:给大模型装上“外挂大脑“:RAG检索增强生成技术详解,小白也能轻松上手

RAG(检索增强生成)通过"检索先行,生成在后"的流程,从向量数据库检索相关信息后输入大模型生成答案,解决了大模型知识固化、实时性缺失和幻觉问题。其优势包括知识实时更新、支持私有知识、提升准确性和降低成本,已在多个领域展现潜力,是通往真正实用化AI的关键路径。

2401_85325726的博客 1009

告别RAG,拥抱AI Agent:大模型时代,程序员的终极外挂!

2025年将是Agent技术走向主流的关键年。Agent作为"自主智能体"而非简单聊天工具,具备感知-决策-执行闭环、工具调用和记忆进化能力,是程序员的"超级外挂"。开发者需进行认知升级和技能重构,学习提示词工程、目标拆解等新技能。推荐"大模型时代的Agent开发方法论"课程及相关资料,帮助开发者快速掌握Agent技术,抢占AI红利。

2401_85390073的博客 795

收藏!小白程序员必看:从RAG到Agentic RAG,轻松入门大模型进阶玩法

本文介绍了RAG技术如何通过检索资料降低AI幻觉问题,并引出升级版本Agentic RAG。传统RAG通过“先查资料再回答”的模式提升AI可靠性,但存在只检索一次的局限。Agentic RAG则引入智能体(Agent)概念,能理解、拆解任务并多次检索,更接近真正的AI助手。文章对比了两者在动态决策、检索次数、任务拆解等方面的差异,指出Agentic RAG是RAG的进化形态,代表了AI从简单问答向复杂任务执行的转变趋势。

2401_85375186的博客 1391
上一篇: 收藏!前端转AI避坑指南:我的7个月踩坑经历+真实offer秘籍
下一篇: AI Agent开发入门指南:小白也能掌握的收藏必备技能
冻感糕人~
博客等级 码龄3年 8926粉丝 2393原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值