


DeepAgents是LangChain生态下专为开发者打造的Python智能体框架,内置任务规划、工具调用、会话管理等核心能力,能让大模型具备“自主分析数据”的能力。本文不仅会手把手教你基于DeepAgents从零搭建MySQL数据分析助手,还会补充生产环境避坑技巧、性能优化方案,完整覆盖4大核心工具的实现注册、全流程部署,以及用Agent Chat UI做可视化调试,让新手也能轻松落地企业级数据分析场景。
1、核心优势:为什么选DeepAgents做数据分析?
相比传统的LLM调用方式,DeepAgents在数据分析场景下的优势堪称“降维打击”:
- 工具调用原生支持:无需手动封装调用逻辑,框架自带工具注册、参数自动解析能力,集成数据库、文件系统等工具仅需几行代码;
- 任务规划能力:通过System Prompt定义思维链(CoT),强制AI按“查表名→看表结构→写SQL→执行分析”的步骤执行,避免跳过关键环节导致分析出错;
- 会话与内存持久化:自动缓存工具调用结果、会话上下文,用户重复提问无需重复查库,既提升响应速度又减少数据库压力;
- 工作区隔离:每个会话对应独立文件目录,SQL结果保存、文件上传等操作互不干扰,尤其适合多用户协作的企业场景;
- 轻量化扩展(新增):基于LangGraph无缝对接LangChain生态所有组件(如不同LLM、向量库),无需重构代码即可替换底层模型。
2、企业级架构设计(4层架构+工具调用核心)
系统采用「会话级(Session-based)」分层架构,工具调用是贯穿全流程的核心逻辑,既保证灵活性又兼顾生产环境的稳定性。
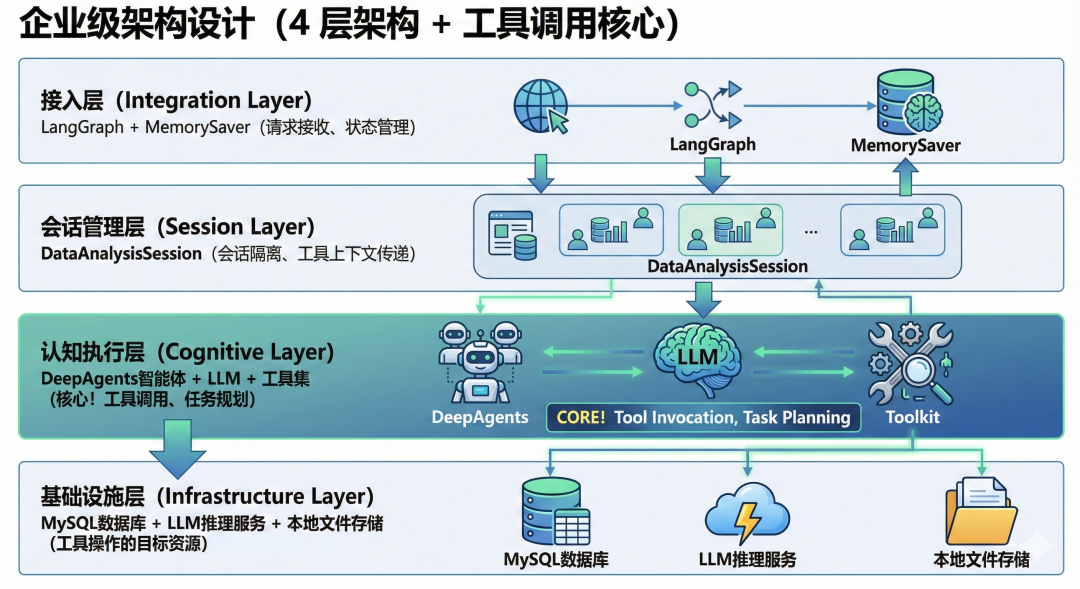
重点聚焦:认知执行层的工具调用设计
这是整个助手的“大脑”,工具调用的「定义-注册-执行-反馈」全流程都在此实现,设计时需遵循3个核心原则:
2.1 工具集设计原则
• 单一职责:每个工具只做一件事(如查表名、查结构、执行SQL),降低AI理解和调用的成本;
• 安全可控:内置权限校验(仅允许查询类SQL)、参数合法性校验(防注入),杜绝生产环境数据风险;
• 返回友好:统一返回文本/Markdown格式结果,既方便LLM解析,也便于用户直接查看;
• 性能兜底(新增):添加工具调用超时控制、重试机制,避免单次工具调用失败导致整个会话中断。
3、工具调用核心实现(代码块+逐行分析+避坑指南)
下面拆解4个核心工具的实现与注册——这是搭建助手的核心步骤,建议收藏对照代码实操,文末还补充了生产环境的性能优化技巧!
3.1 工具1:获取数据库所有表名(get_all_tables)
作用:让AI快速掌握数据库的表结构全貌,为后续筛选分析目标表打基础。
def get_all_tables() -> str:
    """Show all tables in the database"""
    try:
        conn = get_db_connection()  # 复用数据库连接函数,减少连接开销
        with conn.cursor() as cursor:
            cursor.execute(f"SHOW TABLES FROM {DB_NAME}")
            tables = cursor.fetchall()
            # 提取表名(适配DictCursor返回格式,新手避坑:避免直接取row[0]导致兼容问题)
            table_names = [list(row.values())[0] for row in tables]
            return f"Tables in {DB_NAME}:\n" + "\n".join(table_names)
    except Exception as e:
        return f"Error fetching tables: {str(e)}"
    finally:
        # 生产环境必加:确保连接关闭,避免数据库连接池耗尽
        if 'conn' in locals() and conn.open:
            conn.close()
代码分析+避坑指南:
• 连接复用:通过get_db_connection()统一管理连接,新手需注意该函数要配置连接池(如使用SQLAlchemy),避免高并发下创建过多连接;
• 结果格式化:返回清晰的列表格式,避免LLM解析复杂字典时出错;
• 异常处理:捕获数据库连接、查询错误,返回友好提示,防止程序崩溃(生产环境可额外添加日志记录)。
3.2 工具2:获取表结构定义(get_table_definition)
作用:让AI精准了解目标表的字段名、类型、注释,为生成正确SQL提供依据。
def get_table_definition(table_name: str) -> str:
    """Get the CREATE TABLE statement for a specific table"""
    try:
        # 核心安全校验:防止SQL注入(新手必看:表名仅允许字母、数字、点、下划线)
        if not table_name.isidentifier() and not table_name.replace('.', '').isidentifier():
            return f"Error: Invalid table name '{table_name}'"
        conn = get_db_connection()
        with conn.cursor() as cursor:
            # 执行SHOW CREATE TABLE,获取含注释的完整表结构
            cursor.execute(f"SHOW CREATE TABLE {DB_NAME}.{table_name}")
            result = cursor.fetchone()
            if result:
                return f"Table Definition for '{table_name}':\n{result['Create Table']}"
            return f"Table '{table_name}' not found."
    except Exception as e:
        # 生产环境优化:添加错误日志,便于排查问题
        logger.error(f"获取表结构失败:{str(e)}")
        return f"Error fetching table definition: {str(e)}"
    finally:
        if 'conn' in locals() and conn.open:
            conn.close()
代码分析+避坑指南:
• 注入防护:isidentifier()校验能杜绝table_name="user; DROP TABLE user;"这类恶意输入,新手切勿省略;
• 信息完整:返回CREATE TABLE语句包含主键、索引、字段注释,是AI生成正确SQL的关键;
• 日志补充(新增):生产环境需添加日志记录,方便定位“偶发的表结构查询失败”问题。
3.3 工具3:执行SQL查询(run_sql_query)
作用:AI生成分析SQL后,通过该工具安全执行并返回格式化结果(整个助手的核心工具)。
def run_sql_query(query: str) -> str:
    """Execute a SQL query and return results as markdown table"""
    try:
        # 核心安全限制:仅允许查询类SQL,杜绝删改操作(新手必守规则)
        allowed_prefixes = ["SELECT", "SHOW", "DESCRIBE", "EXPLAIN"]  # 新增EXPLAIN,支持SQL性能分析
        if not any(query.strip().upper().startswith(prefix) for prefix in allowed_prefixes):
            return "Error: Only SELECT, SHOW, DESCRIBE, EXPLAIN queries are allowed for analysis."
        conn = get_db_connection()
        with conn.cursor() as cursor:
            # 生产环境优化:添加SQL执行超时控制
            cursor.execute(query, timeout=30)
            results = cursor.fetchall()
            if not results:
                return "Query executed successfully. No results returned."
            # 结果格式化:转为Markdown表格,用户和LLM都易读
            df = pd.DataFrame(results)
            return df.to_markdown(index=False)
    except Exception as e:
        logger.error(f"SQL执行失败:{str(e)}")
        return f"Error executing SQL query: {str(e)}"
    finally:
        if 'conn' in locals() and conn.open:
            conn.close()
代码分析+避坑指南:
• 操作限制:新增EXPLAIN前缀支持,方便AI分析SQL性能,新手可根据业务扩展允许的前缀;
• 超时控制(新增):设置30秒执行超时,避免慢SQL阻塞整个会话;
• 结果优化:Pandas转Markdown解决了原始字典列表难以阅读的问题,是提升用户体验的关键。
3.4 工具4:执行Shell命令(run_shell_command)
作用:辅助数据预处理(如查看CSV文件、清理临时数据),扩展助手的能力边界。
def run_shell_command(command: str) -> str:
    """Execute a shell command and return stdout/stderr"""
    try:
        # 生产环境安全优化:限制可执行的命令范围
        safe_commands = ["ls", "cat", "grep", "head", "tail"]
        cmd_prefix = command.strip().split()[0]
        if cmd_prefix not in safe_commands:
            return f"Error: Only {', '.join(safe_commands)} commands are allowed."

        result = subprocess.run(
            command,
            shell=True,
            capture_output=True,
            text=True,
            timeout=60  # 超时控制:防止命令长时间阻塞
        )
        output = result.stdout
        error = result.stderr
        if error:
            return f"Output:\n{output}\n\nError:\n{error}"
        return output if output else "Command executed successfully (no output)."
    except Exception as e:
        logger.error(f"Shell命令执行失败:{str(e)}")
        return f"Error executing command: {str(e)}"
代码分析+避坑指南:
• 安全加固(新增):限制仅允许执行ls、cat等只读命令,杜绝rm、mv等危险操作,生产环境务必添加;
• 超时控制:60秒超时避免ping、find等命令无限阻塞;
• 输出完整:同时返回stdout和stderr,方便AI排查命令执行失败原因。
3.5 工具注册:将工具集成到DeepAgents智能体
工具定义完成后,需注册到DeepAgents智能体中,LLM才能自主调用。核心代码如下(新增注释说明新手易混点):
# 在DataAnalysisSession类的__init__方法中
def __init__(self, config: AppSessionConfig):
    # 新手避坑:先初始化工作区,确保目录存在
    self.workspace = self._init_workspace(config.workspace_base, config.session_id)
    self.model = self._init_llm()  # 初始化LLM(如通义千问、GPT-4)
    self.backend = FilesystemBackend(self.workspace)  # 绑定工作区后端

    # 系统提示词:明确工具调用流程(思维链引导,新手重点关注)
    system_prompt = """你是专业的MySQL数据分析助手,必须严格按以下步骤完成任务:
    1. 用write_todos拆解任务(如:1. 查所有表;2. 查用户表结构;3. 统计注册量);
    2. 用get_all_tables获取所有表名,筛选相关表;
    3. 用get_table_definition查看目标表结构(重点看字段注释);
    4. 用run_sql_query执行SQL(仅查询类),获取数据;
    5. 分析Markdown结果,生成自然语言总结。
    工具调用失败时,根据错误信息修正后重试(如表名错误、SQL语法错误)。
    """
    # 核心:注册工具到DeepAgents智能体
    self.agent = create_deep_agent(
        model=self.model,  # 已配置的LLM(如qwen3-coder)
        backend=self.backend,  # 文件系统后端(工作区访问)
        tools=[get_all_tables, get_table_definition, run_sql_query, run_shell_command],  # 工具列表
        system_prompt=system_prompt  # 思维链引导,避免AI跳步骤
    )

# 新增:工作区初始化函数(新手必加,避免目录不存在报错)
def _init_workspace(self, base_dir: str, session_id: str) -> str:
    workspace_dir = os.path.join(base_dir, session_id)
    os.makedirs(workspace_dir, exist_ok=True)
    return workspace_dir
代码分析+避坑指南:
• 工具注册:直接传入函数列表即可,DeepAgents会自动解析函数参数和注释,新手无需手动写调用格式;
• 思维链引导:System Prompt强制AI按步骤执行,避免“没查表结构就直接写SQL”的错误;
• 工作区初始化(新增):新手常忽略目录创建,导致工具执行时文件写入失败,该函数可提前规避。
4、工具调用工作流(从用户提问到结果返回)
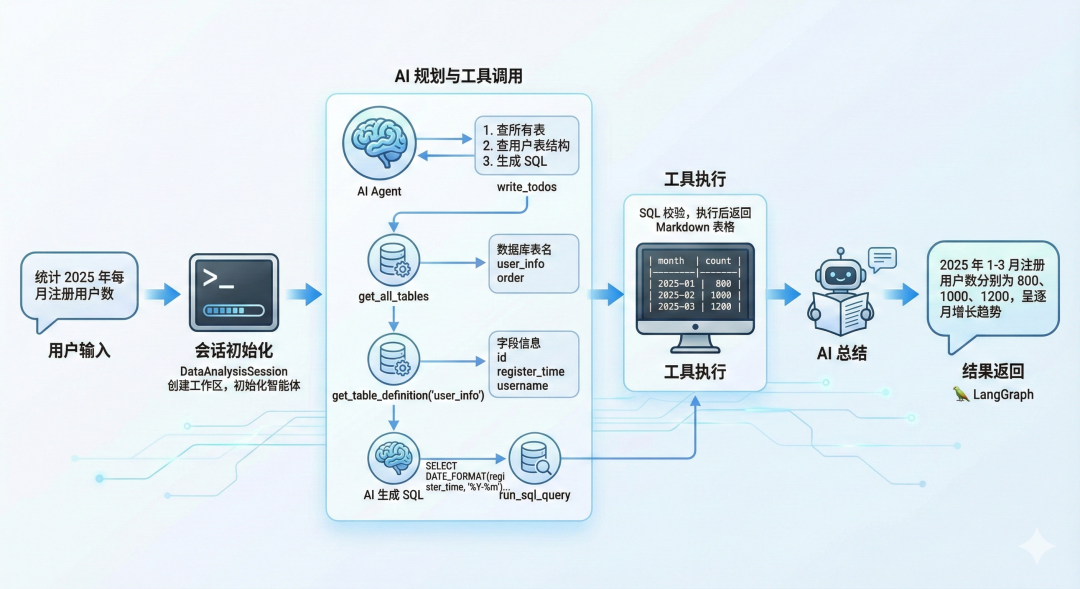
以用户提问“统计2025年每月注册用户数”为例,完整工作流如下(新增新手易懂的步骤说明):
- 用户输入:提交自然语言查询“统计2025年每月注册用户数”;
- 会话初始化:
DataAnalysisSession为该用户创建独立工作区,初始化智能体和LLM; - AI规划与工具调用(核心步骤):
• 步骤1:AI调用write_todos拆解任务,生成清晰的执行列表;
• 步骤2:AI调用get_all_tables,获取数据库中所有表名(如user_info、order);
• 步骤3:AI调用get_table_definition("user_info"),查看register_time等关键字段;
• 步骤4:AI生成统计SQL,调用run_sql_query执行(自动校验为SELECT类型);
• 步骤5:工具返回Markdown格式的统计结果,AI读取后生成自然语言总结; - 结果返回:LangGraph将AI总结返回给用户,整个流程无需人工干预。
5、手把手实操:从0到1搭建部署(新增生产环境配置)
第一步:环境准备(新手友好版)
# 1. 创建虚拟环境(避免依赖冲突)
python -m venv deepagents-env

# 2. 激活环境(Windows)
deepagents-env\Scripts\activate
# 激活环境(Mac/Linux)
source deepagents-env/bin/activate

# 3. 安装依赖(新增生产环境必备包:日志、连接池)
pip install pandas pymysql langchain-openai langgraph deepagents python-dotenv sqlalchemy loguru
第二步:核心配置修改(新增.env文件管理敏感信息)
# 1. 新建.env文件,存放敏感配置(避免硬编码)
# .env文件内容
DB_HOST="你的MySQL地址"
DB_USER="用户名"
DB_PASSWORD="密码"
DB_NAME="数据库名"
OPENAI_API_BASE="http://你的模型地址:端口/v1"
OPENAI_API_KEY="dummy"

# 2. 代码中读取配置(新手必学:保护敏感信息)
import os
from dotenv import load_dotenv
from loguru import logger

# 加载.env文件
load_dotenv()

# 数据库配置
DB_HOST = os.getenv("DB_HOST")
DB_USER = os.getenv("DB_USER")
DB_PASSWORD = os.getenv("DB_PASSWORD")
DB_NAME = os.getenv("DB_NAME")

# LLM配置
os.environ["OPENAI_API_BASE"] = os.getenv("OPENAI_API_BASE")
os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")

# 新增:数据库连接池配置(生产环境必加)
from sqlalchemy import create_engine
engine = create_engine(
    f"mysql+pymysql://{DB_USER}:{DB_PASSWORD}@{DB_HOST}/{DB_NAME}",
    pool_size=10,  # 连接池大小
    max_overflow=20,  # 最大溢出连接数
    pool_recycle=3600  # 连接回收时间,避免超时
)

# 重构get_db_connection函数(使用连接池)
def get_db_connection():
    try:
        conn = engine.connect()
        return conn
    except Exception as e:
        logger.error(f"数据库连接失败:{str(e)}")
        raise
第三步:本地测试(工具调用验证)
import asyncio

async def main():
    # 会话配置
    config = AppSessionConfig(
        session_id="test_session_001",
        workspace_base=os.path.join(os.getcwd(), "sessions")
    )
    session = DataAnalysisSession(config)

    # 测试查询(覆盖核心工具调用)
    query = "1. 显示数据库所有表;2. 查看user_info表结构;3. 统计2025年每月注册用户数"
    response = await session.send_message(query)

    # 打印结果(含工具调用过程和最终总结)
    for msg in response:
        print(msg.content)

if __name__ == "__main__":
    asyncio.run(main())
6、可视化调试:用Agent Chat UI对接智能体(新增调试技巧)
Agent Chat UI 是 LangChain 官方开发的基于 Next.js 的可视化聊天工具,专为LangGraph代理设计——新手不用写一行前端代码,就能直观看到工具调用流程,大幅降低调试难度!
6.1 Agent Chat UI 核心优势
- 可视化工具调用:清晰展示AI调用了哪些工具、参数是什么、返回结果如何,新手也能定位问题;
- 会话持久化:自动保存聊天记录,支持多轮对话上下文连贯;
- 错误排查:工具调用失败时,可查看完整错误日志,快速定位问题(如SQL语法错误、表名错误);
- 零代码对接:只需配置LangGraph服务地址,即可连接智能体;
- 多会话管理(新增):支持同时调试多个会话,对比不同参数下的工具调用效果。
6.2 部署与配置步骤(新手友好版)
第一步:安装Agent Chat UI
# 1. 克隆官方仓库(需提前安装Git)
git clone https://github.com/langchain-ai/agent-chat-ui.git
cd agent-chat-ui

# 2. 安装依赖(需提前安装Node.js 18+,新手建议用nvm管理版本)
npm install
第二步:配置LangGraph服务地址
- 打开Agent Chat UI配置文件:
agent-chat-ui/app/config.ts - 修改
langGraphEndpoint为你的LangGraph服务地址:
// agent-chat-ui/app/config.ts
export const config = {
    // 核心配置:对接你的LangGraph服务
    langGraphEndpoint: "http://localhost:22204",
    // 可选配置:设置API密钥(本地服务无需认证)
    apiKey: "dummy",
    // 自定义标题(新增):更贴合业务场景
    title: "DeepAgents MySQL数据分析助手",
    description: "基于DeepAgents的可视化数据分析工具(新手调试专用)",
};
第三步:启动LangGraph服务(后端)
# 确保已激活Python虚拟环境
langgraph dev --host 0.0.0.0 --port 22204 --reload  # 新增--reload,代码修改自动重启
第四步:启动Agent Chat UI(前端)
# 启动前端服务(默认端口3000)
npm run dev
第五步:开始可视化调试(新增新手调试技巧)
- 浏览器访问:
http://localhost:3000,进入聊天界面; - 输入测试查询(如“统计2025年每月注册用户数”),点击发送;
- 调试技巧:
• 右侧工具调用日志:展开每个步骤,查看工具参数和返回结果,若SQL执行失败,可直接复制SQL到数据库客户端验证;
• 清空会话:若上下文干扰调试,可点击右上角“清空会话”,重新测试;
• 导出日志:调试完成后,可导出工具调用日志,用于后续优化。
6.3 调试示例:查看工具调用详情
输入“统计2025年每月注册用户数”后,Agent Chat UI右侧会显示完整的工具调用链路:
1. 调用write_todos → 返回任务列表(查所有表→查user_info结构→统计注册数)
2. 调用get_all_tables → 返回表名列表(user_info、order、product)
3. 调用get_table_definition("user_info") → 返回含register_time字段的表结构
4. 调用run_sql_query → 返回Markdown格式的每月注册数统计结果
7、生产环境优化技巧(新增:新手落地必看)
- 连接池优化:使用SQLAlchemy连接池替代单次连接,避免高并发下数据库连接耗尽;
- 工具调用限流:给每个用户/会话设置工具调用次数上限(如单会话最多调用10次),防止恶意请求;
- 结果缓存:对相同SQL查询结果缓存5-10分钟,减少重复查询;
- 日志监控:用Loguru记录工具调用日志,结合ELK栈实现日志可视化,方便排查生产问题;
- 权限分级:给不同用户分配不同的表访问权限,避免敏感数据泄露。
总结:DeepAgents+Agent Chat UI的高效开发组合(新手重点)
- 核心能力:DeepAgents提供开箱即用的任务规划、工具调用能力,新手无需关注复杂的智能体架构,只需聚焦业务工具开发;
- 调试效率:Agent Chat UI可视化工具调用流程,让新手能快速定位“SQL写错、表名错误”等问题,大幅降低调试成本;
- 生产落地:补充的连接池、日志、权限控制等优化技巧,能让新手开发的助手直接适配企业级场景。
借助LangChain生态的这套方案,你可以用极低的成本搭建稳定、安全、可调试的MySQL数据分析助手——无论是新手练手,还是团队落地生产级应用,都是性价比极高的选择!收藏本文,跟着步骤实操,半小时就能跑通第一个数据分析案例~
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
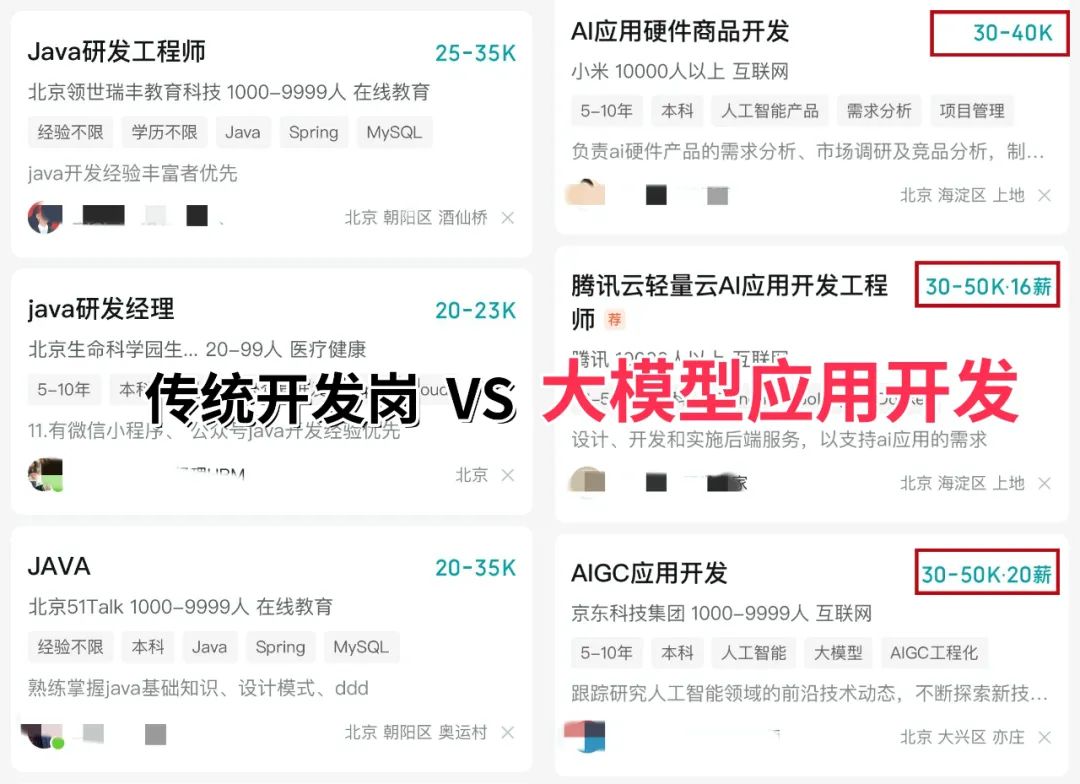
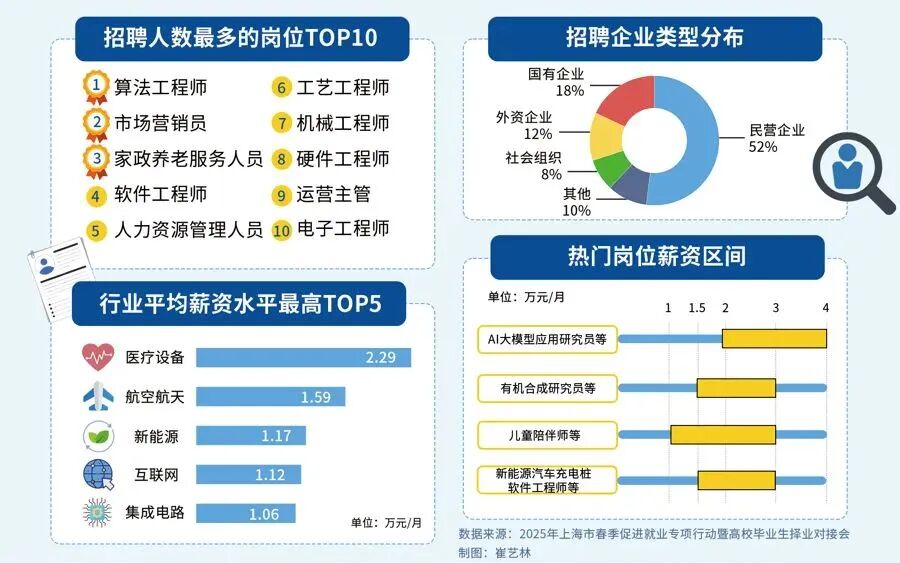
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。

👇👇扫码免费领取全部内容👇👇
最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
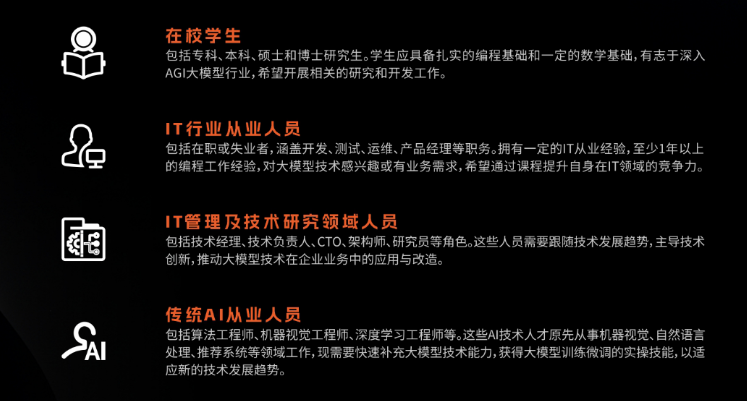
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
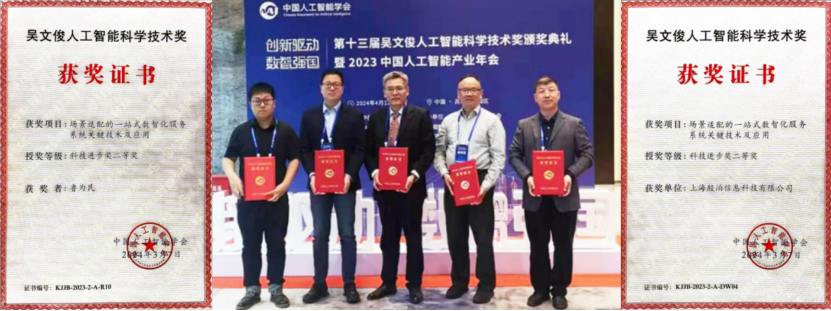
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2314


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


