


上下文工程是围绕LLM构建系统的学科,解决其上下文窗口限制。它由6个核心组件组成:Agents作为决策大脑、Query Augmentation增强查询、Retrieval连接知识库、Memory提供历史感、Prompting Techniques优化指令、Tools集成API。上下文工程是从提示者转变为架构师的过程,通过构建互联系统而非依赖更大模型来创建更可靠的AI应用。
什么是上下文工程?
每个使用大语言模型(LLM)构建应用的开发者都会遇到同样的瓶颈。你从一个强大的模型开始,它能够写作、总结、推理,表现出惊人的能力。但当你尝试将其应用到现实世界的问题时,裂缝就开始出现:
- 无法回答关于你私有文档的问题
- 不知道昨天发生的事件
- 当不知道答案时会自信地编造
问题的本质不在于模型的智能,而在于它从根本上是断开连接的。
这种隔离是其核心架构限制的直接结果:上下文窗口。上下文窗口是模型的活动工作内存——保存当前任务指令和信息的有限空间。每个字、数字、标点符号都会消耗这个窗口中的空间。就像白板一样,一旦满了,旧信息就会被擦除以为新指令腾出空间,重要细节可能会丢失。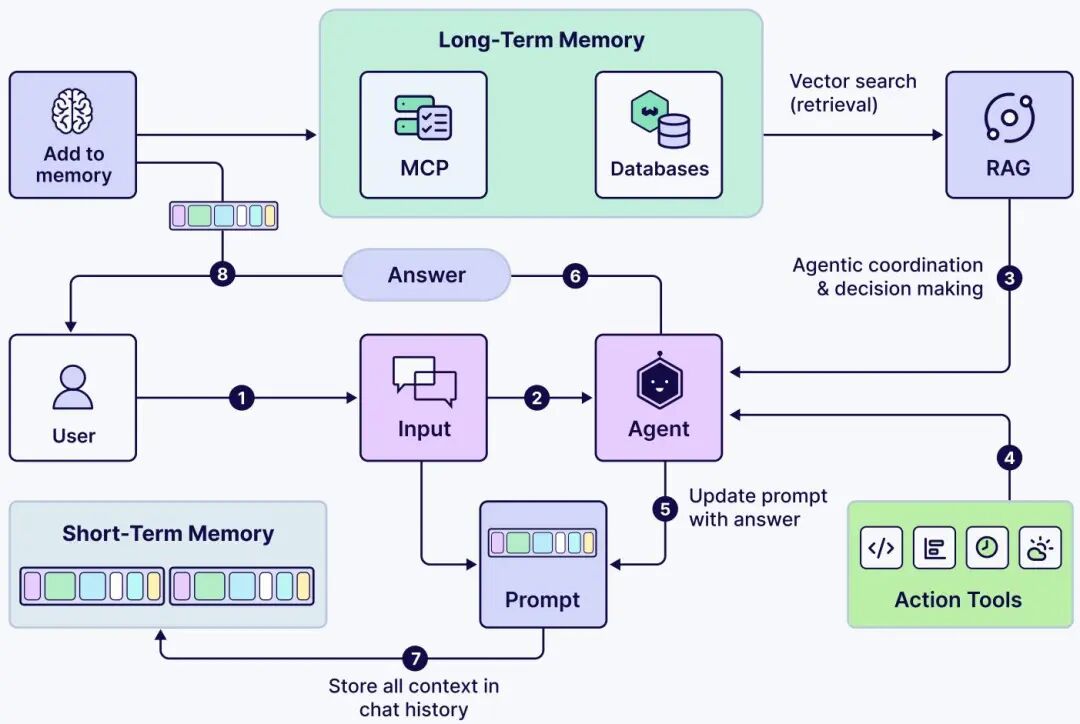
你无法仅通过编写更好的提示来修复这个根本限制。你必须围绕模型构建一个系统。这就是上下文工程。
核心组件
上下文工程由6个核心组件组成,每个组件解决LLM应用中的特定挑战:
1. Agents - 决策大脑
定义: 编排如何以及何时使用信息的决策系统。
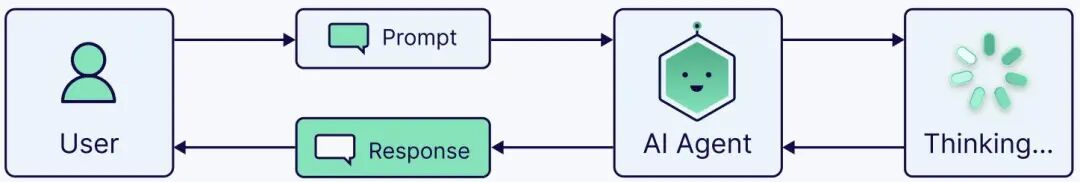
什么是Agent?
在大语言模型的上下文中,AI Agent是一个能够:
- 动态决策信息流: 基于学到的内容决定下一步做什么,而不是遵循预定路径
- 跨多次交互维护状态: 记住已完成的事情并使用历史信息指导未来决策
- 自适应使用工具: 从可用工具中选择并以未明确编程的方式组合它们
- 基于结果修改方法: 当一种策略不起作用时,可以尝试不同的方法
Agent架构类型
单Agent架构:
- 尝试自己处理所有任务
- 适用于中等复杂度的工作流
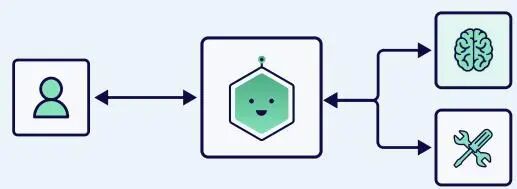
单Agent架构
多Agent架构:
- 在专门的Agent之间分配工作
- 允许复杂的工作流但引入协调挑战
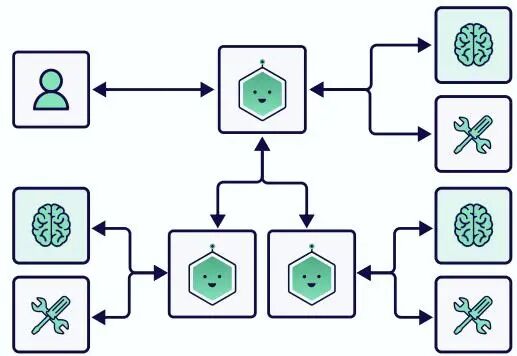
多Agent架构
上下文窗口的挑战
LLM具有有限的信息容量,因为上下文窗口一次只能容纳这么多信息。每次Agent处理信息时,它都需要做出关于:
- 哪些信息应该保持在上下文窗口中活跃
- 哪些应该外部存储并在需要时检索
- 哪些可以总结或压缩以节省空间
- 为推理和规划保留多少空间
常见的上下文错误类型
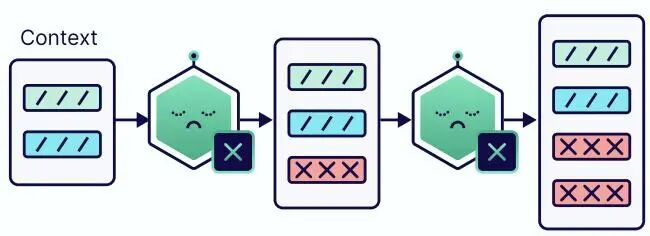
上下文污染(Context Poisoning):
- 错误或幻觉信息进入上下文
- 因为Agent重用和构建该上下文,这些错误会持续并复合
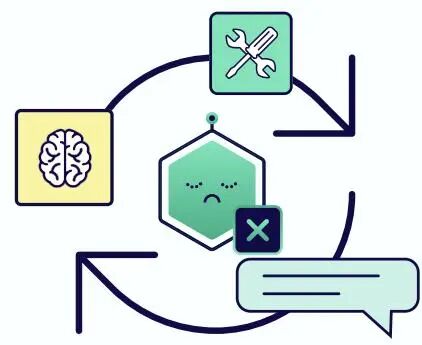
上下文干扰(Context Distraction):
- Agent被过多的过去信息(历史、工具输出、摘要)负担
- 过度依赖重复过去的行为而不是新鲜推理
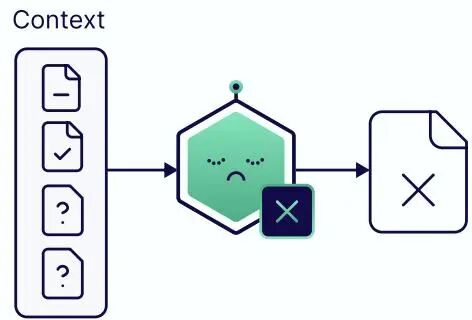
上下文混乱(Context Confusion):
- 不相关的工具或文档挤满上下文
- 分散模型注意力并导致使用错误的工具或指令
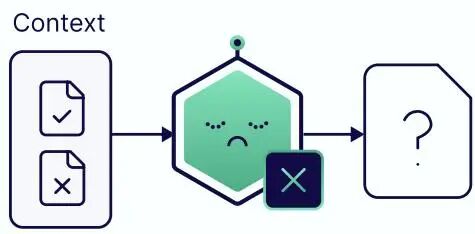
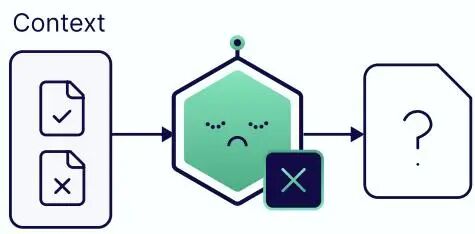
上下文冲突(Context Clash):
- 上下文中的矛盾信息误导Agent
- 使其陷入冲突假设之间
Agent的核心策略和任务
Agent能够有效编排上下文系统,因为它们能够以动态方式进行推理和决策:
- 上下文总结: 定期将累积的历史压缩成摘要以减少负担同时保留关键知识
- 质量验证: 检查检索的信息是否一致和有用
- 上下文修剪: 主动删除不相关或过时的上下文
- 自适应检索策略: 当初始尝试失败时重新制定查询、切换知识库或改变分块策略
- 上下文卸载: 将细节存储在外部并仅在需要时检索
- 动态工具选择: 只过滤和加载与任务相关的工具
- 多源综合: 组合来自多个源的信息,解决冲突并产生连贯的答案
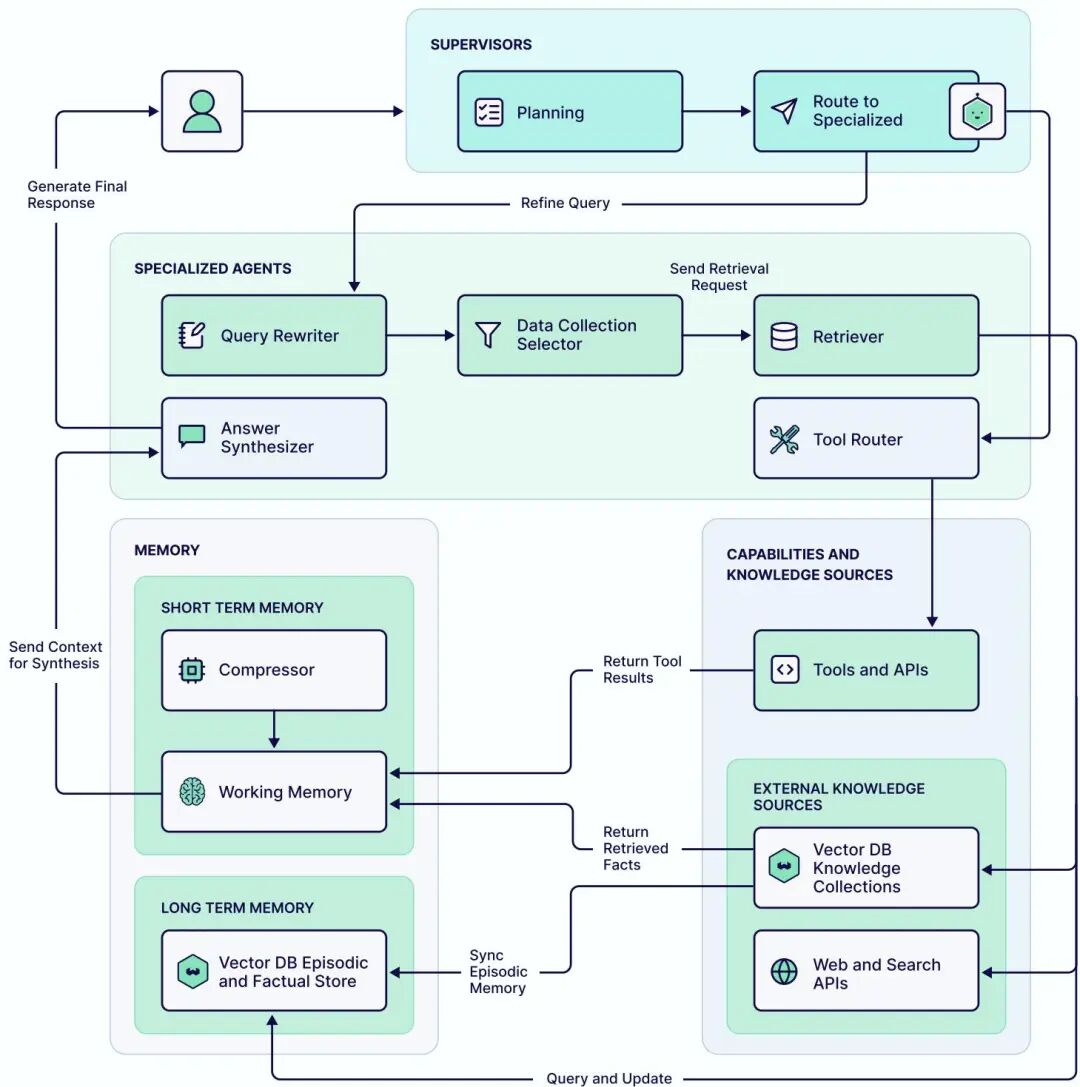
不同类型的Agent在上下文工程系统中的功能
2. Query Augmentation - 查询增强
定义: 将混乱、模糊的用户请求转换为精确、机器可读意图的艺术。
上下文工程中最重要的步骤之一是如何准备和呈现用户的查询。有两个主要问题需要考虑:
- 用户通常不以理想方式与聊天机器人交互
- 现实世界中的用户交互可能不清楚、混乱且不完整
- 需要实现处理所有类型交互的解决方案
- 管道的不同部分需要以不同方式处理查询
- LLM理解良好的问题可能不是搜索向量数据库的最佳格式
- 需要一种适合不同工具和步骤的查询增强方法
2.1 查询重写(Query Rewriting)
将原始用户查询转换为更有效的检索版本。
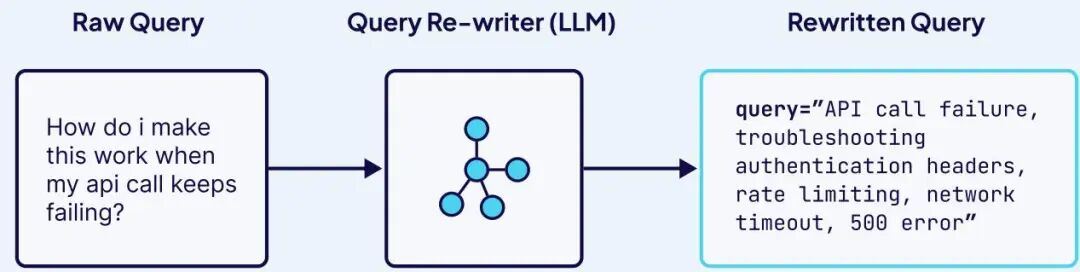
查询重写流程
工作原理:
- 重构不清楚的问题: 将模糊或形式不佳的用户输入转换为精确、信息密集的术语
- 上下文移除: 消除可能混淆检索过程的无关信息
- 关键词增强: 引入常见术语以增加匹配相关文档的可能性
2.2 查询扩展(Query Expansion)
从单个用户输入生成多个相关查询来增强检索。
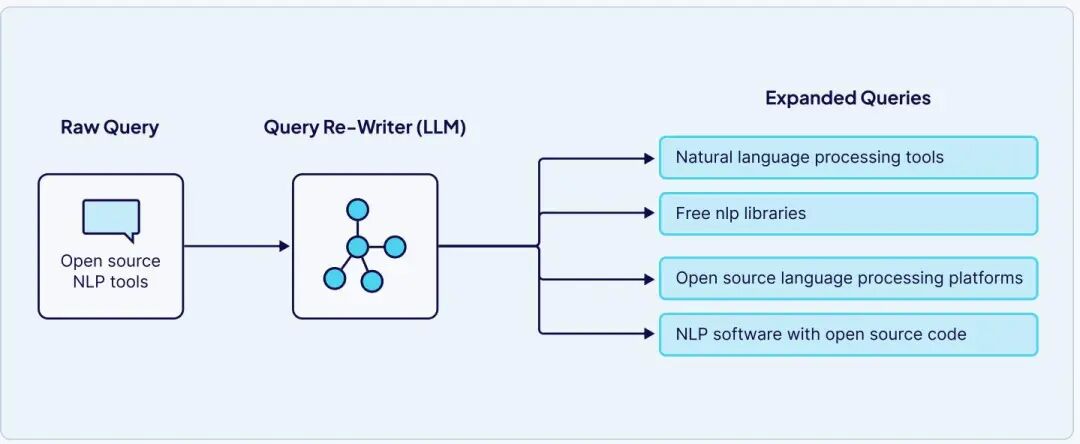
查询扩展流程
需要注意的挑战:
- 查询漂移: 扩展的查询可能偏离用户的原始意图
- 过度扩展: 添加过多术语可能降低精度
- 计算开销: 处理多个查询会增加系统延迟
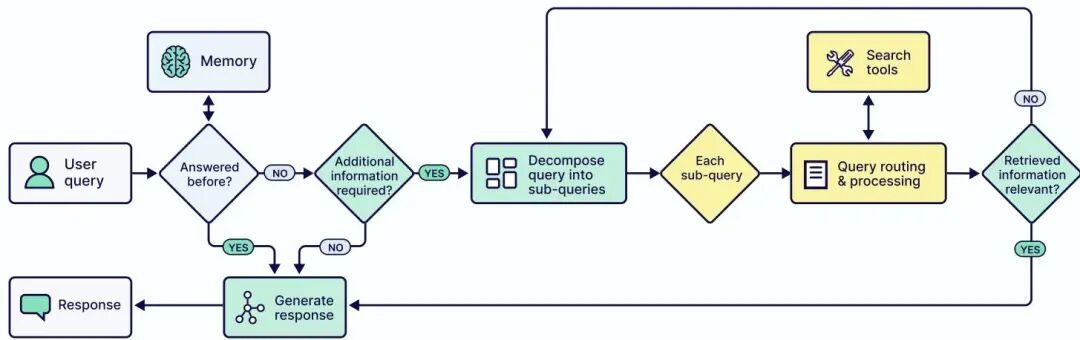
2.3 查询分解(Query Decomposition)
将复杂、多方面的问题分解为更简单、集中的子查询。
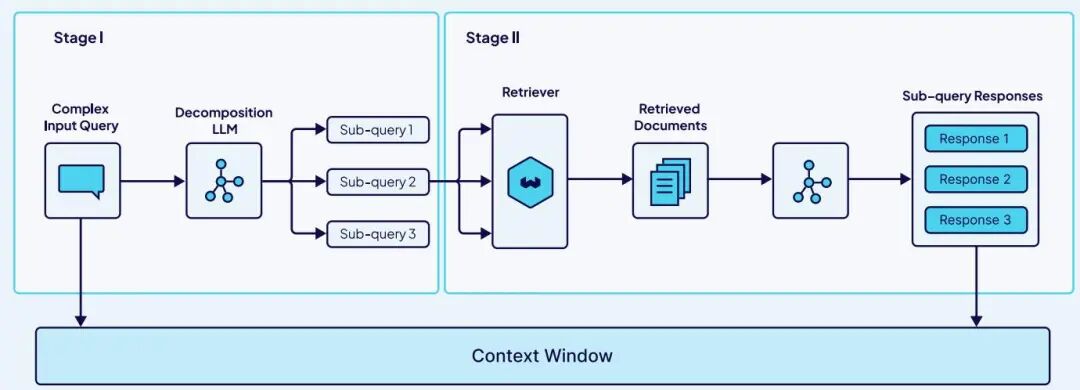
查询分解流程
过程包括两个主要阶段:
- 分解阶段: LLM分析原始复杂查询并将其分解为更小、集中的子查询
- 处理阶段: 每个子查询独立通过检索管道处理
2.4 查询Agent(Query Agents)
查询Agent是查询增强的最高级形式,使用AI Agent智能处理整个查询处理管道。
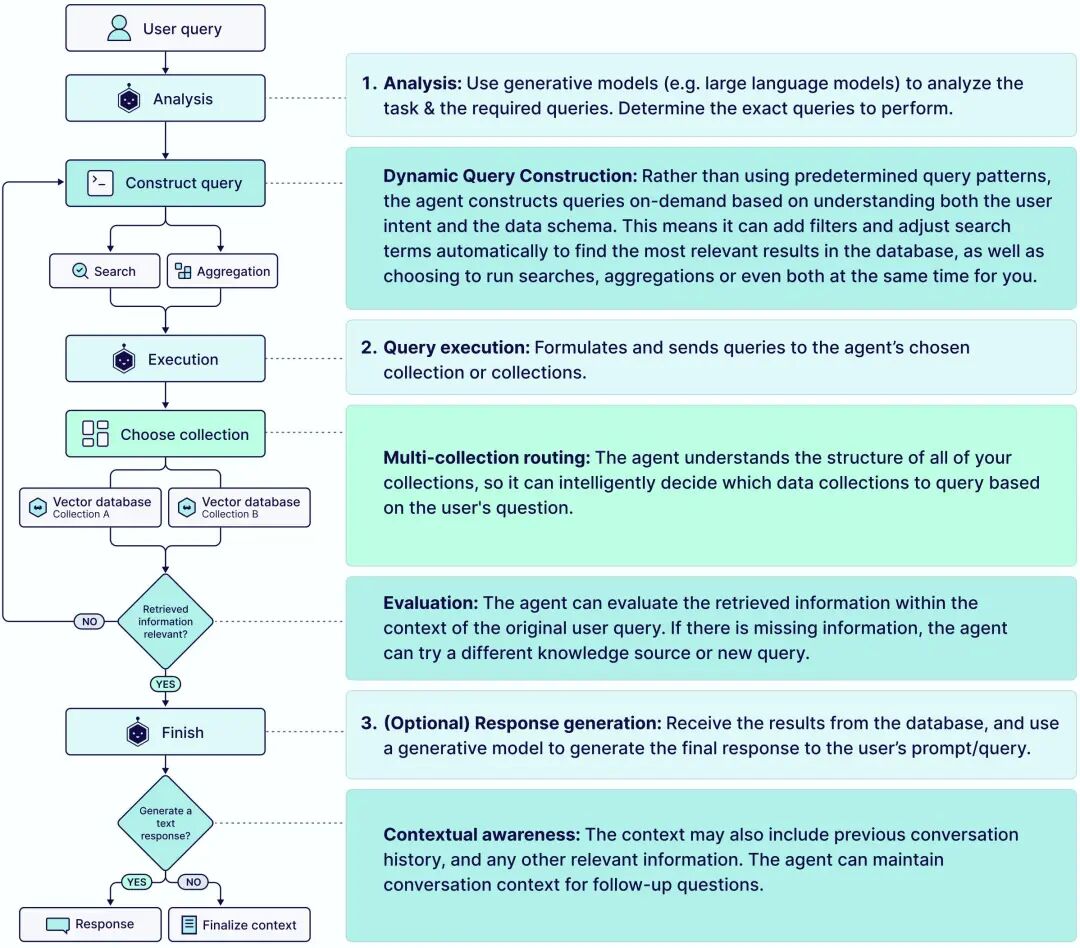
查询Agent架构
3. Retrieval - 检索系统
定义: 连接LLM到你的特定文档和知识库的桥梁。
LLM的能力取决于它能访问的信息。虽然LLM在海量数据集上训练,但它们缺乏对你特定私有文档和训练完成后创建的任何信息的了解。
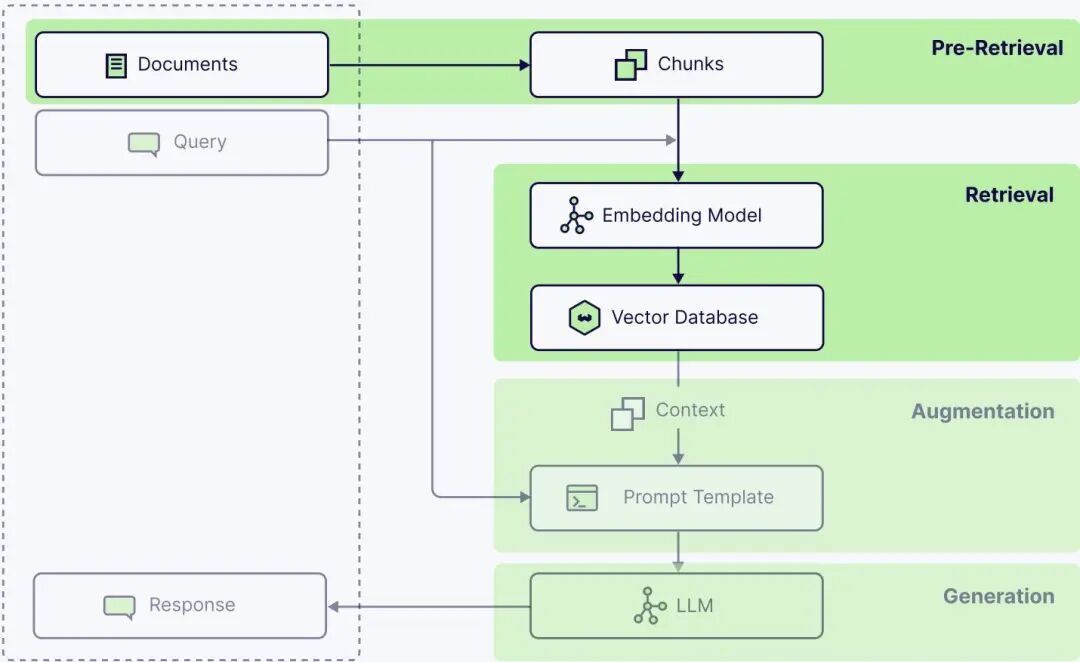
RAG架构
挑战: 原始文档数据集几乎总是太大而无法放入LLM有限的上下文窗口。我们必须找到完美的片段——包含用户查询答案的单个段落或部分。
为了使我们庞大的知识库可搜索,我们必须首先将文档分解为更小、可管理的部分。这个基础过程称为**分块(Chunking)**。
分块技术指南
分块是你为检索系统性能做出的最重要决定。
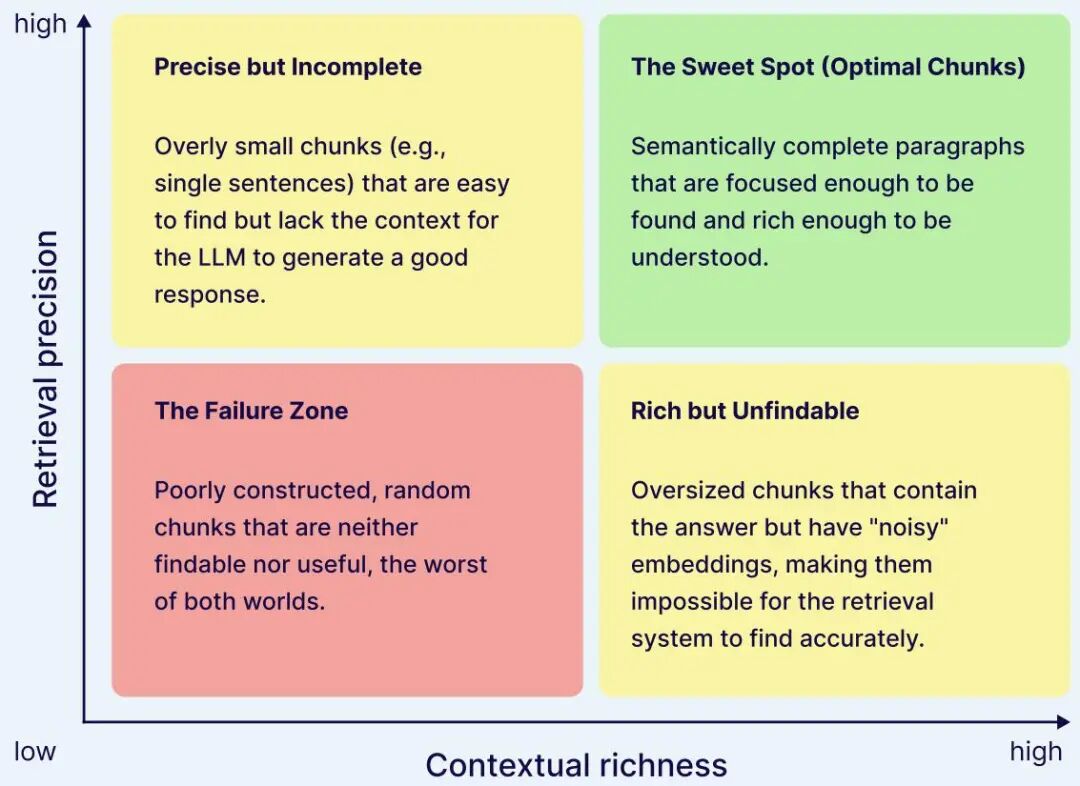
分块策略矩阵
设计分块策略时,必须平衡两个竞争优先级:
- 检索精度: 块需要小而专注于单个想法
- 上下文丰富性: 块必须足够大和自包含以便被理解
目标是找到"分块最佳点"——创建足够小以实现精确检索但足够完整以给LLM所需完整上下文的块。
简单分块技术
固定大小分块(Fixed-Size Chunking):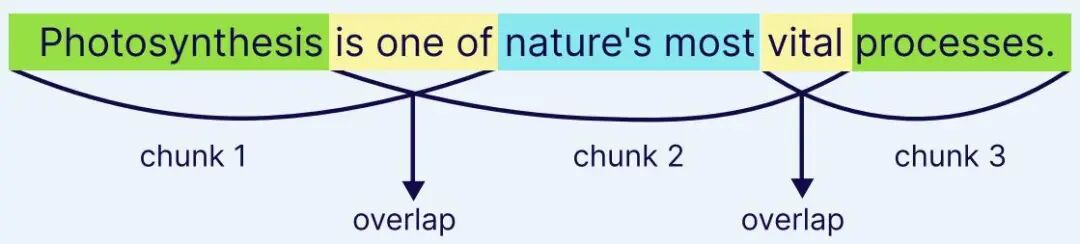
递归分块(Recursive Chunking):
- 使用优先级分隔符列表分割文本
- 尊重文档的自然结构
基于文档的分块(Document-Based Chunking):
- 使用文档的固有结构
高级分块技术
语义分块(Semantic Chunking):
- 基于含义而不是分隔符分割文本
基于LLM的分块(LLM-Based Chunking):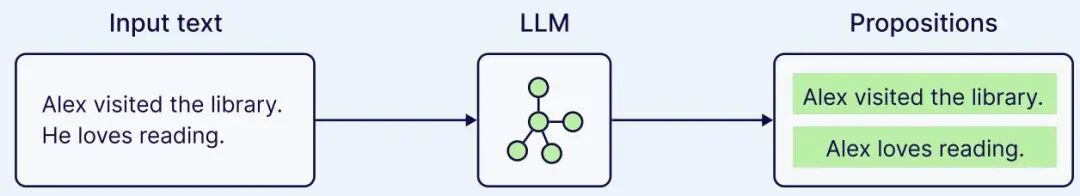
Agentic分块: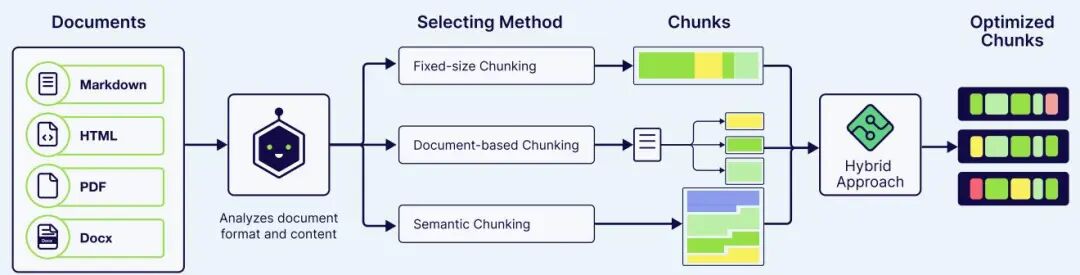
层次分块(Hierarchical Chunking):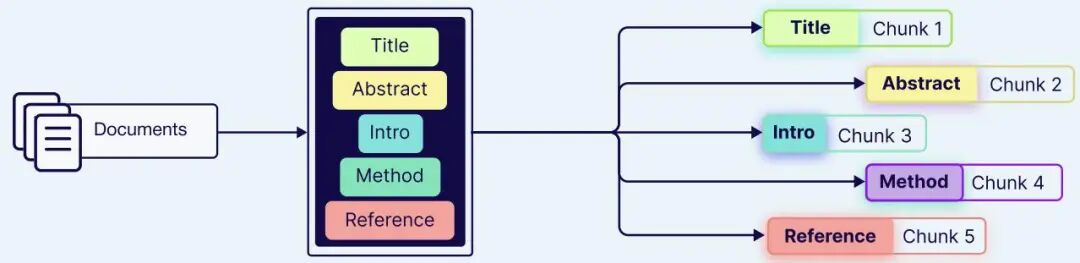
延迟分块(Late Chunking):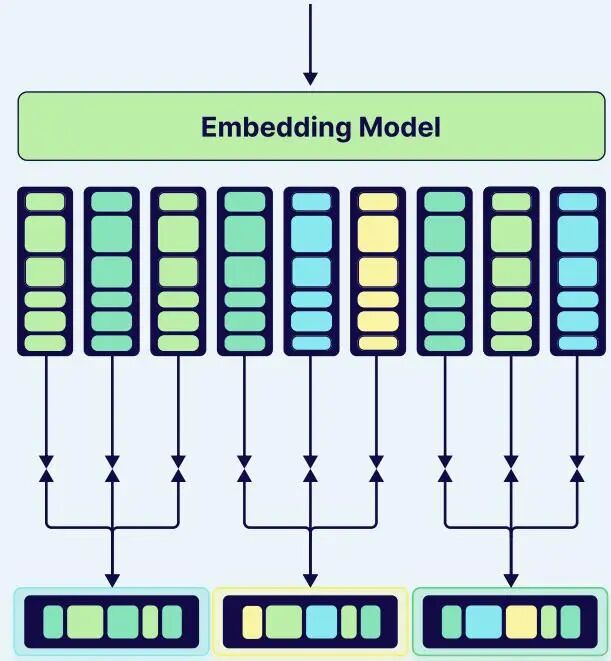
预分块 vs 后分块
预分块(Pre-Chunking):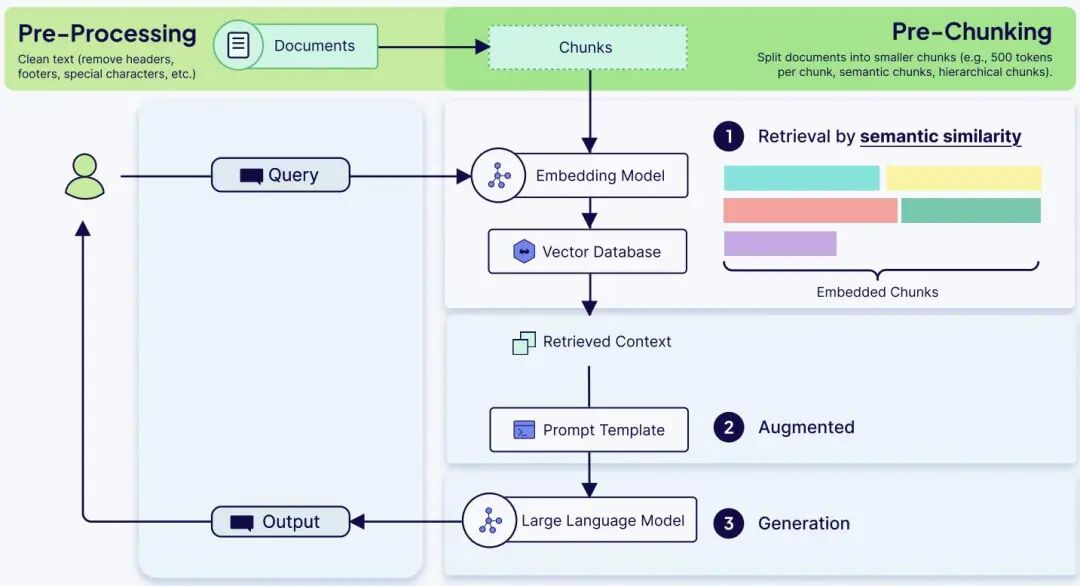
后分块(Post-Chunking):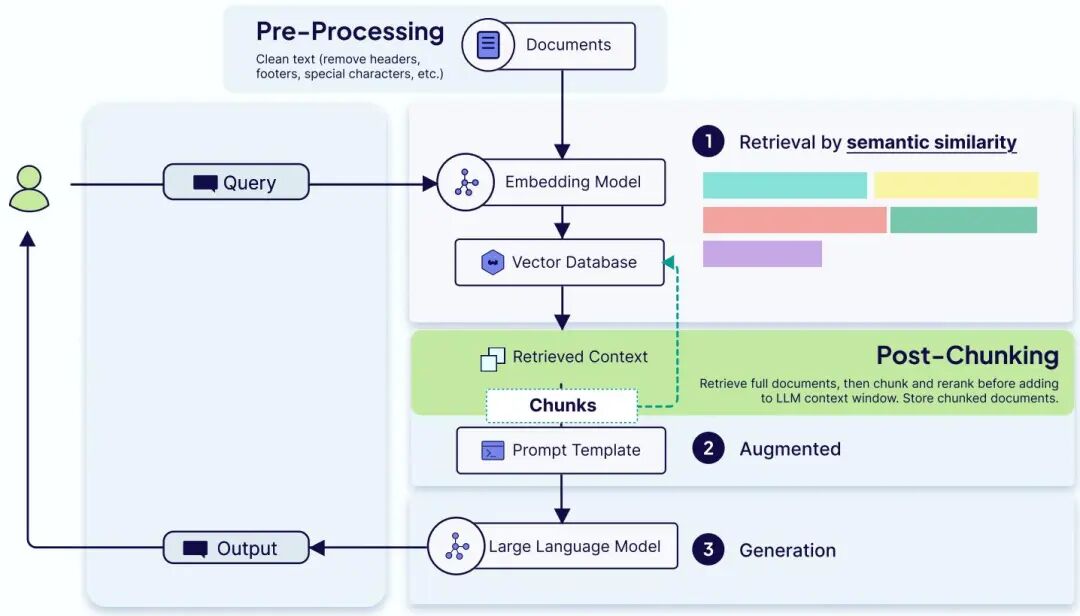
4. Prompting Techniques - 提示技巧
定义: 给出清晰、有效指令以引导模型推理的技能。
提示工程是设计、细化和优化给予大语言模型的输入(提示)以获得期望输出的实践。
经典提示技术
思维链(Chain of Thought, CoT):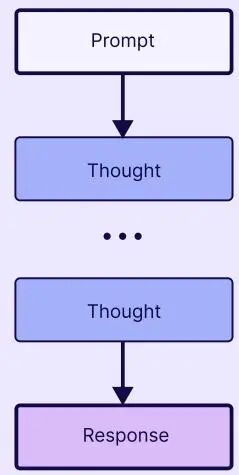
少样本提示(Few-Shot Prompting):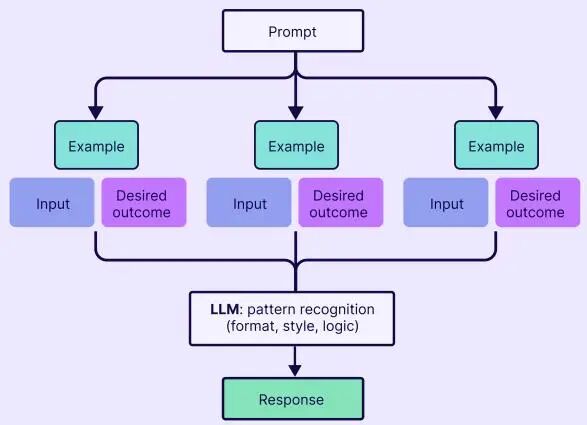
结合CoT和Few-shot:
结合CoT和Few-shot示例是一种强大的方式,可以同时指导模型的推理过程和输出格式,以获得最佳效率。
专业技巧 #1: 使思维链中的模型推理非常具体到你的用例。例如,你可以要求模型:
- 评估环境
- 重复任何相关信息
- 解释这些信息对当前请求的重要性
专业技巧 #2: 最大化效率并减少token数量,要求模型以"草稿"形式推理,每句话不超过5个单词。
这确保了模型的思考过程是可见的,同时减少了输出token数量。
高级提示策略
思维树(Tree of Thoughts, ToT):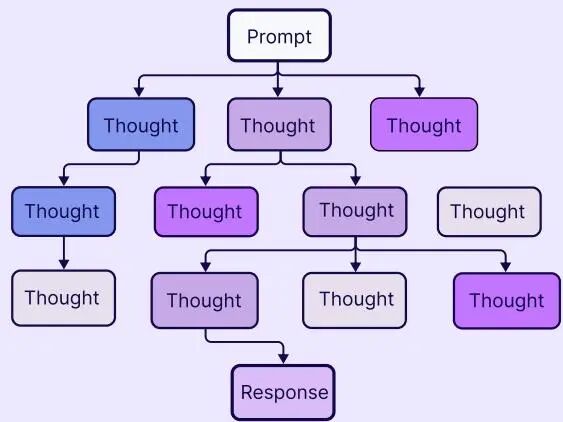
ReAct提示: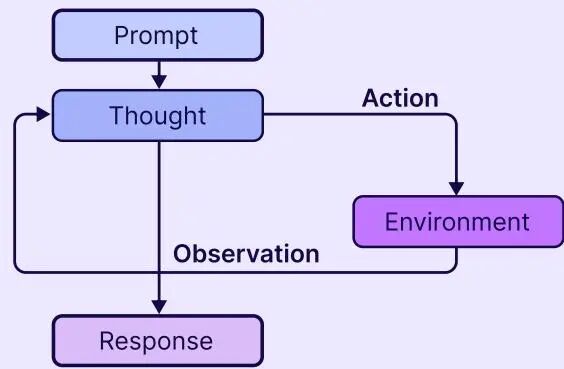
5. Memory - 记忆系统
定义: 给你的应用程序历史感和从交互中学习能力的系统。
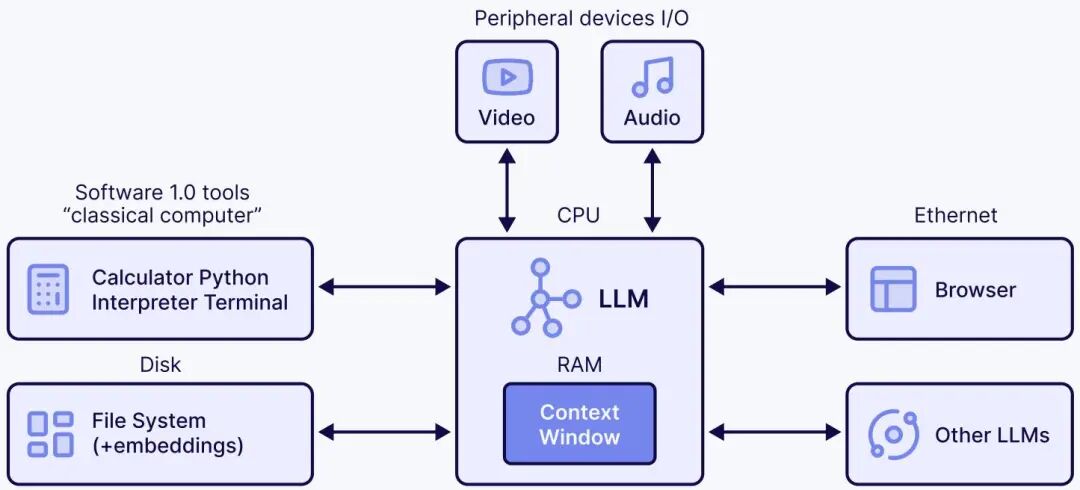
Karpathy的类比
Agent记忆的架构
在构建强大的Agent时,我们需要分层思考记忆,通常混合不同类型的记忆以获得最佳效果。
短期记忆:
短期记忆是Agent的即时工作空间。这是"现在",被塞入上下文窗口以推动即时决策和推理。这通过上下文学习实现,将最近的对话、操作或数据直接打包到提示中。
示例对话:
- 用户: “天气怎么样?”
- AI: “晴天,24°C”
- 用户: “我需要带夹克吗?”
- AI: “不需要,很暖和!”
因为受到模型token限制的约束,主要挑战是效率。诀窍是保持这个精简,以减少成本和延迟,同时不遗漏任何对下一步处理可能重要的细节。
长期记忆:
长期记忆超越了即时上下文窗口,将信息外部存储以便在需要时快速检索。这使Agent能够随着时间推移建立对其世界和用户的持久理解。它通常由检索增强生成(RAG)驱动,Agent查询外部知识库(如向量数据库)来提取相关信息。
这种记忆可以存储不同类型的信息,例如:
- 情节记忆: 存储特定事件或过去的交互
- 语义记忆: 保存一般知识和事实(可以是公司文档、产品手册或精选的领域知识库的信息,使Agent能够准确回答问题)
混合记忆设置:
实际上,大多数现代系统使用混合方法,将短期记忆的速度与长期记忆的深度相结合。一些高级架构甚至引入了额外的层:
- 工作记忆: 与特定多步骤任务相关信息的临时存储区。例如,如果Agent正在预订旅行,其工作记忆可能会保存目的地、日期和预算直到任务完成,而不会使长期存储混乱。
- 程序记忆: 这帮助Agent学习和掌握例程。通过观察成功的工作流程,Agent可以内化重复任务的步骤序列,使其随着时间推移变得更快、更可靠。
有效记忆管理的关键原则
修剪和细化: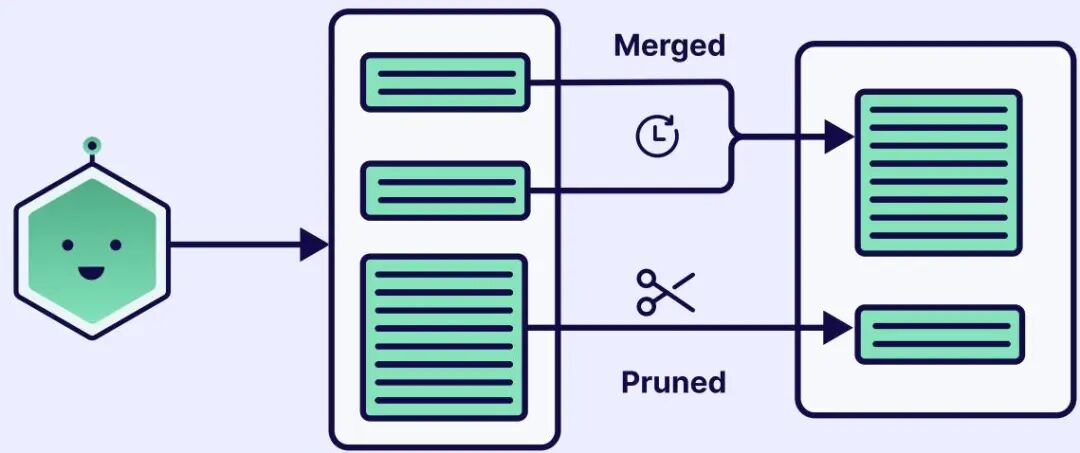
选择性存储: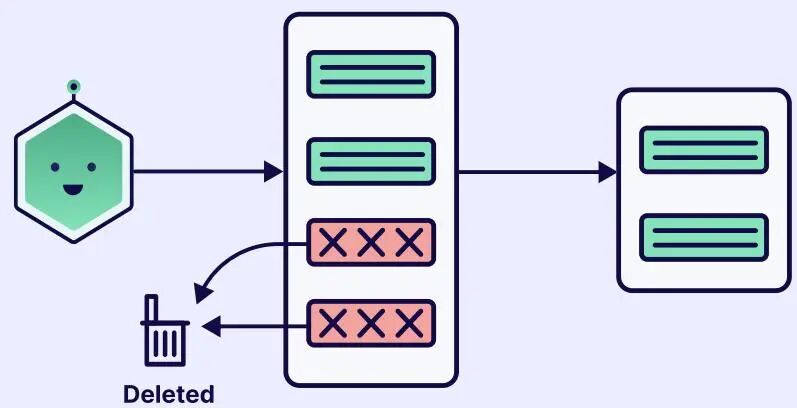
掌握检索的艺术: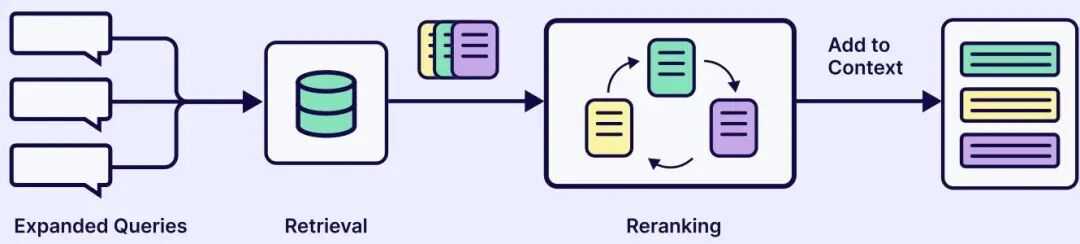
6. Tools - 工具集成
如果记忆给Agent自我意识,那么工具就是给它超能力的东西。
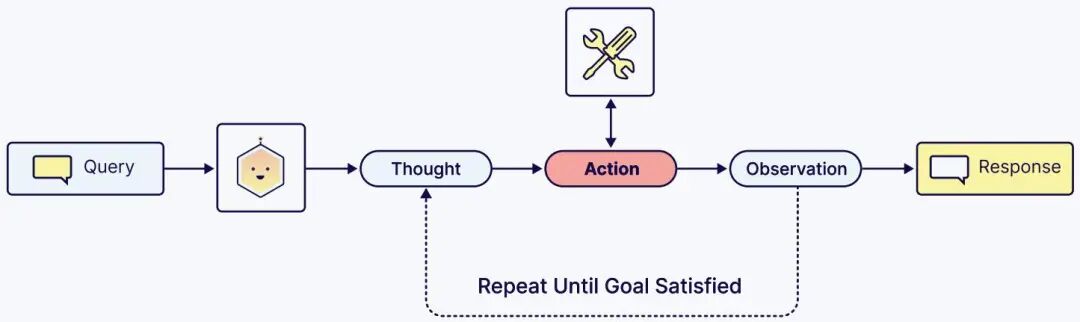
工具集成概念
从提示到行动的演变
使LLM具有工具使用能力的旅程经历了快速演变。最初,开发者试图通过传统的提示工程从LLM获得行动,通过诱导模型生成看起来像命令的文本。这很聪明但容易出错。
真正的突破是函数调用(Function Calling),也称为**工具调用(Tool Calling)**。这种能力现在已成为大多数模型的原生功能,允许LLM输出可以包含要调用的函数名称和要使用的参数的结构化JSON。
有了这个能力,就有很多可能性:
简单工具: 旅行Agent机器人可以使用search_flights工具,当用户询问"帮我找下周二去东京的航班"时,LLM不会猜测答案。它生成对你提供的函数的调用,进而查询真实的航空公司API。
工具链: 对于像"帮我计划一个周末去旧金山的旅行"这样的复杂请求,Agent可能需要将多个工具链在一起:find_flights、search_hotels和get_local_events。这需要Agent进行推理、规划并执行多步骤工作流程。
上下文工程在这里的工作是如何呈现这些工具。一个写得好的工具描述就像一个小型提示,指导模型,清楚地说明工具的作用、需要什么输入以及返回什么。
编排挑战
给Agent一个工具是容易的(大部分情况下)。让它可靠、安全和有效地使用该工具才是真正工作开始的地方。上下文工程的核心任务是编排,即在Agent推理使用哪个工具时管理信息流和决策制定。
这涉及在上下文窗口中发生的几个关键步骤。让我们使用Glowe(一个由我们的Elysia编排框架支持的护肤领域知识应用)作为运行示例来分解这些关键编排步骤:
1. 工具发现: Agent需要知道它拥有哪些工具。这通常通过在系统提示中提供可用工具及其描述的列表来完成。这些描述的质量非常关键。它们是Agent理解每个工具作用的唯一指南,使模型能够理解何时使用工具,更重要的是,何时避免使用它。
在Glowe中,我们在初始化每个新聊天树时配置一组专门的工具(步骤5)并提供精确的描述。
2. 工具选择和规划(思考): 面对用户请求时,Agent必须推理是否需要工具。如果需要,是哪一个?对于复杂任务,它甚至可能需要将多个工具链在一起,形成计划(例如,“首先,在网上搜索天气;然后,使用电子邮件工具发送摘要”)。
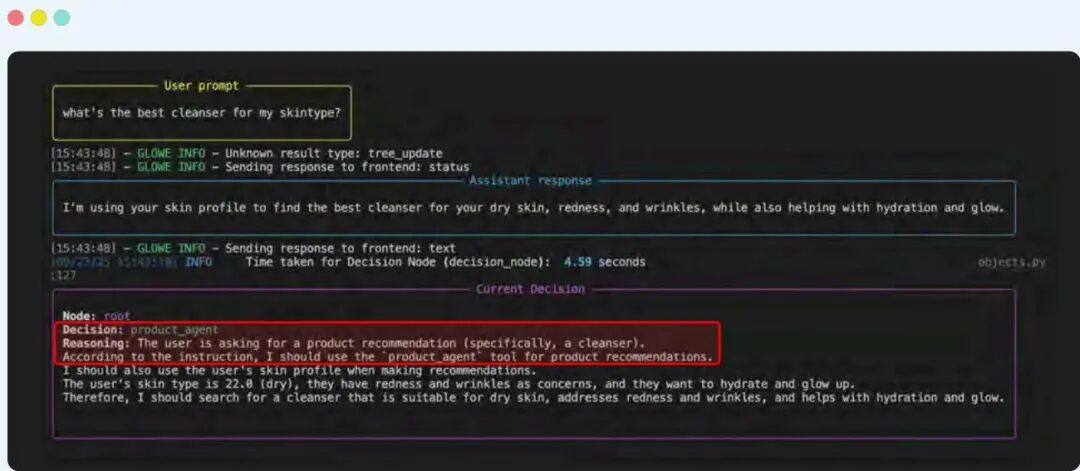
工具选择
在这里,决策Agent正确分析了传入的请求并选择了product_agent工具。
3. 参数制定(行动): 一旦选择了工具,Agent必须弄清楚传递什么参数给它。如果工具是get_weather(city, date),Agent需要从用户的查询中提取"旧金山"和"明天"并正确格式化它们。这也可以是带有使用工具所需信息的结构化请求或API调用。
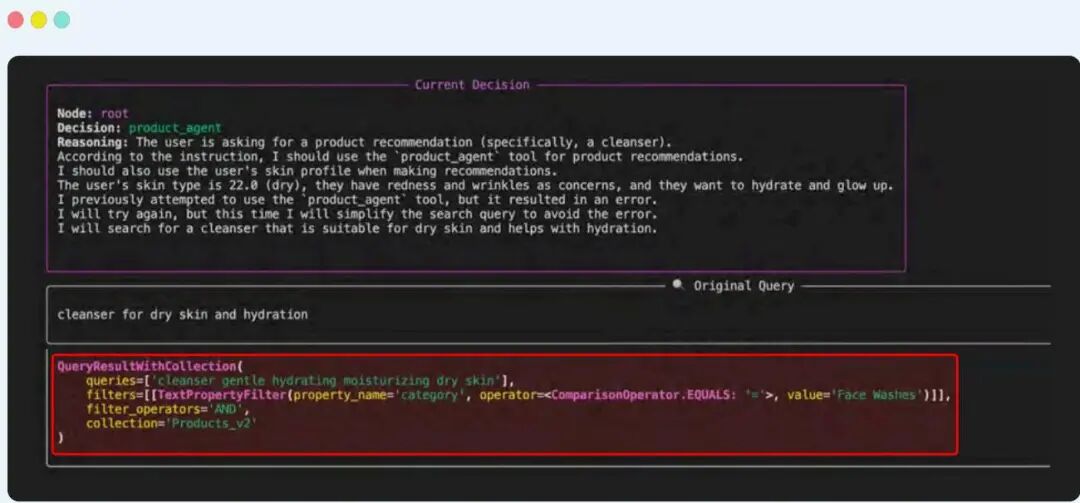
参数制定
在这种情况下,product_agent需要一个文本查询来搜索产品集合。注意Agent如何在生成初始导致错误的格式错误参数后自我修正(自我修复)(编排的另一个关键部分)。
4. 反思(观察): 执行工具后,输出(“观察”)被反馈到上下文窗口中。然后Agent反思这个输出以决定下一步。工具成功了吗?它产生了回答用户查询所需的信息吗?还是返回了需要不同方法的错误?
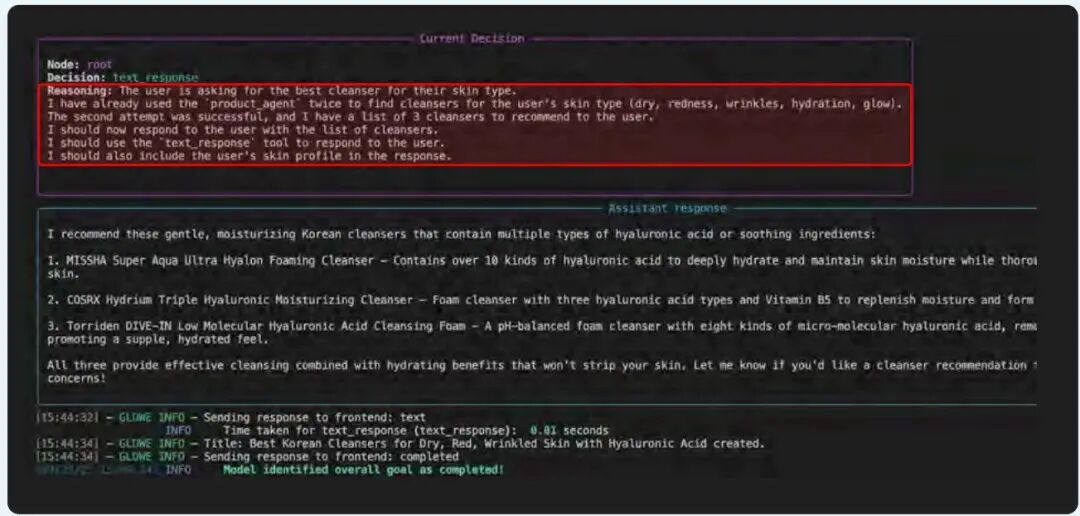
反思观察2
如你所见,编排通过这个强大的反馈循环发生,通常称为思考-行动-观察循环(Thought-Action-Observation Cycle)。
思考-行动-观察循环
这个循环构成了现代Agent框架(如Elysia)中的基本推理循环。Agent观察其行动的结果,并使用这些新信息来推动其下一个"思考",决定任务是否完成、是否需要使用另一个工具,或者是否应该向用户寻求澄清。
工具使用的下一个前沿
传统集成 vs MCP方法: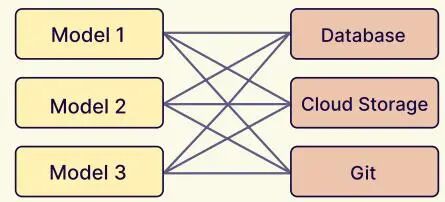
总结
上下文工程不仅仅是提示大语言模型、构建检索系统或设计AI架构。它是关于构建在各种用途和用户中可靠工作的互联、动态系统。
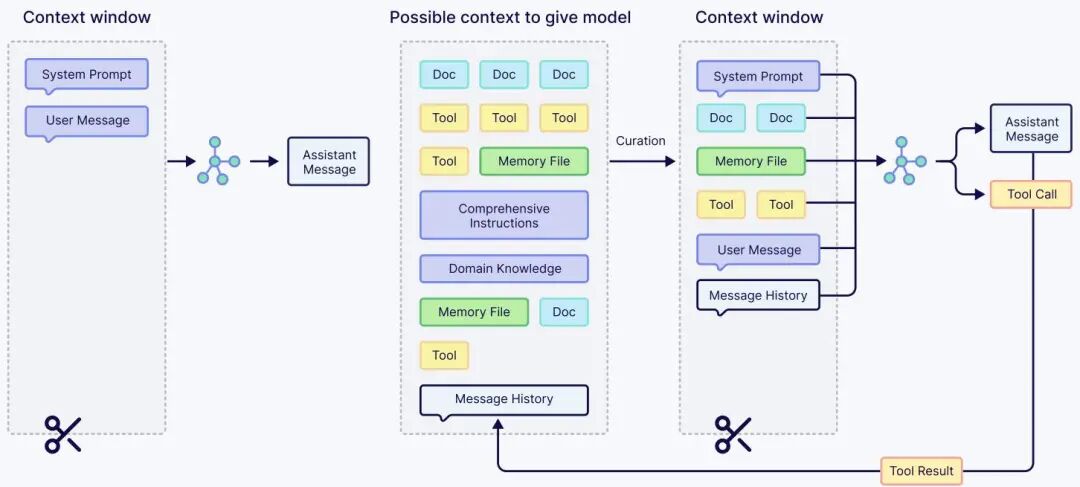
简单提示工程 vs 上下文工程
上下文工程由以下组件组成:
- Agents - 作为系统的决策大脑
- Query Augmentation - 将混乱的人类请求转换为可操作的意图
- Retrieval - 将模型连接到事实和知识库
- Memory - 给你的系统历史感和学习能力
- Tools - 给你的应用程序与实时数据和API交互的手
我们正在从与模型对话的提示者转变为构建模型生活世界的架构师。最好的AI系统不是来自更大的模型,而是来自更好的工程。
如何学习大模型 AI ?
如今技术圈降薪裁员频频爆发,传统岗位大批缩水,相反AI相关技术岗疯狂扩招,薪资逆势上涨150%,大厂老板们甚至开出70-100W年薪,挖掘AI大模型人才!
技术的稀缺性,才是你「值钱」的关键!
具备AI能力的程序员,比传统开发高出不止一截!有的人早就转行AI方向,拿到百万年薪!👇🏻👇🏻
是不是也想抓住这次风口,但卡在 “入门无门”?
- 小白:想学大模型,却分不清 LLM、微调、部署,不知道从哪下手?
- 传统程序员:想转型,担心基础不够,找不到适配的学习路径?
- 求职党:备考大厂 AI 岗,资料零散杂乱,面试真题刷不完?
别再浪费时间踩坑!2025 年最新 AI 大模型全套学习资料已整理完毕,不管你是想入门的小白,还是想转型的传统程序员,这份资料都能帮你少走 90% 的弯路
👇👇扫码免费领取全部内容👇👇
部分资料展示
一、 AI大模型学习路线图,厘清要学哪些
一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:大模型核心原理与Prompt
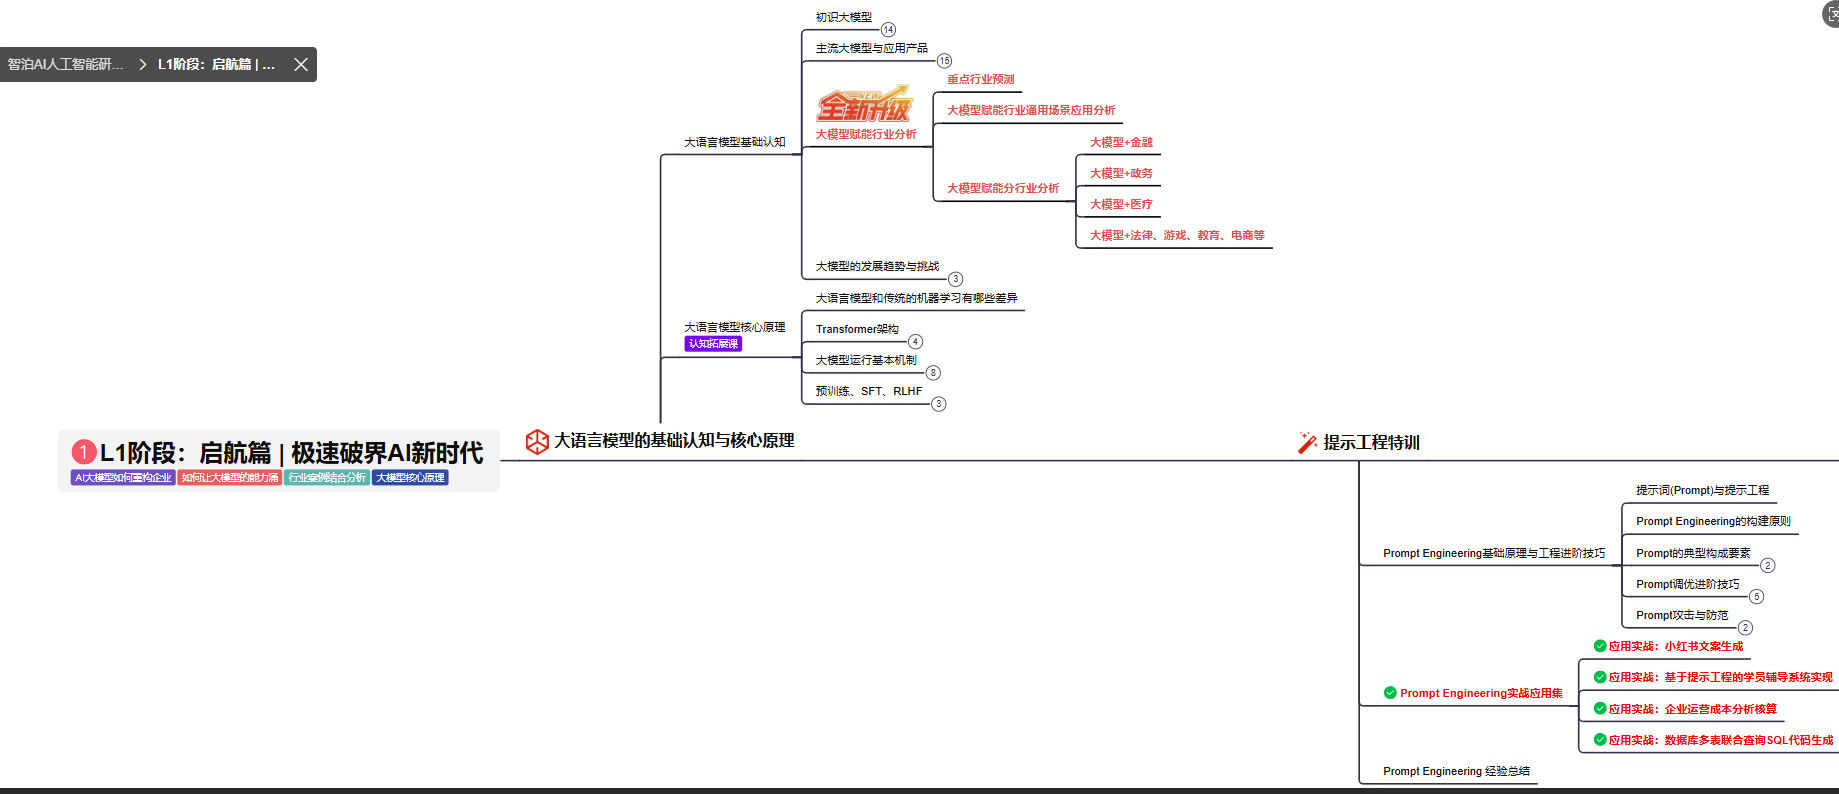
L1阶段: 将全面介绍大语言模型的基本概念、发展历程、核心原理及行业应用。从A11.0到A12.0的变迁,深入解析大模型与通用人工智能的关系。同时,详解OpenAl模型、国产大模型等,并探讨大模型的未来趋势与挑战。此外,还涵盖Pvthon基础、提示工程等内容。
目标与收益:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为AI应用开发打下坚实基础。
L2级别:RAG应用开发工程
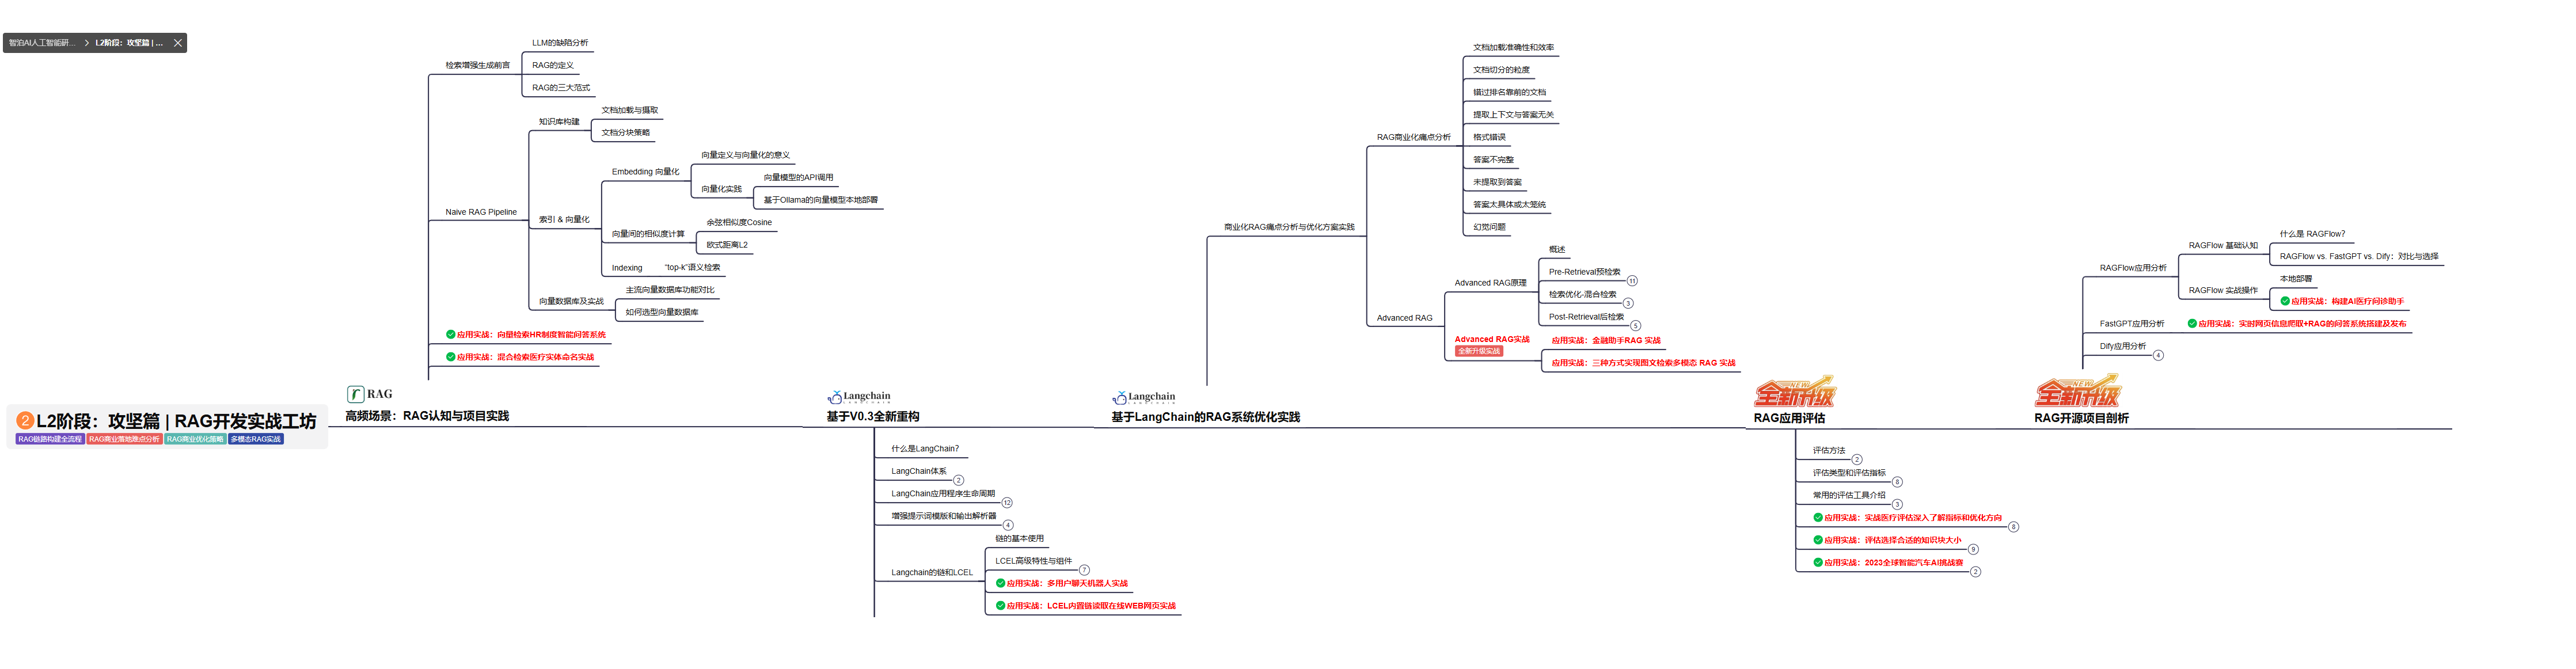
L2阶段: 将深入讲解AI大模型RAG应用开发工程,涵盖Naive RAGPipeline构建、AdvancedRAG前治技术解读、商业化分析与优化方案,以及项目评估与热门项目精讲。通过实战项目,提升RAG应用开发能力。
目标与收益: 掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
L3级别:Agent应用架构进阶实践
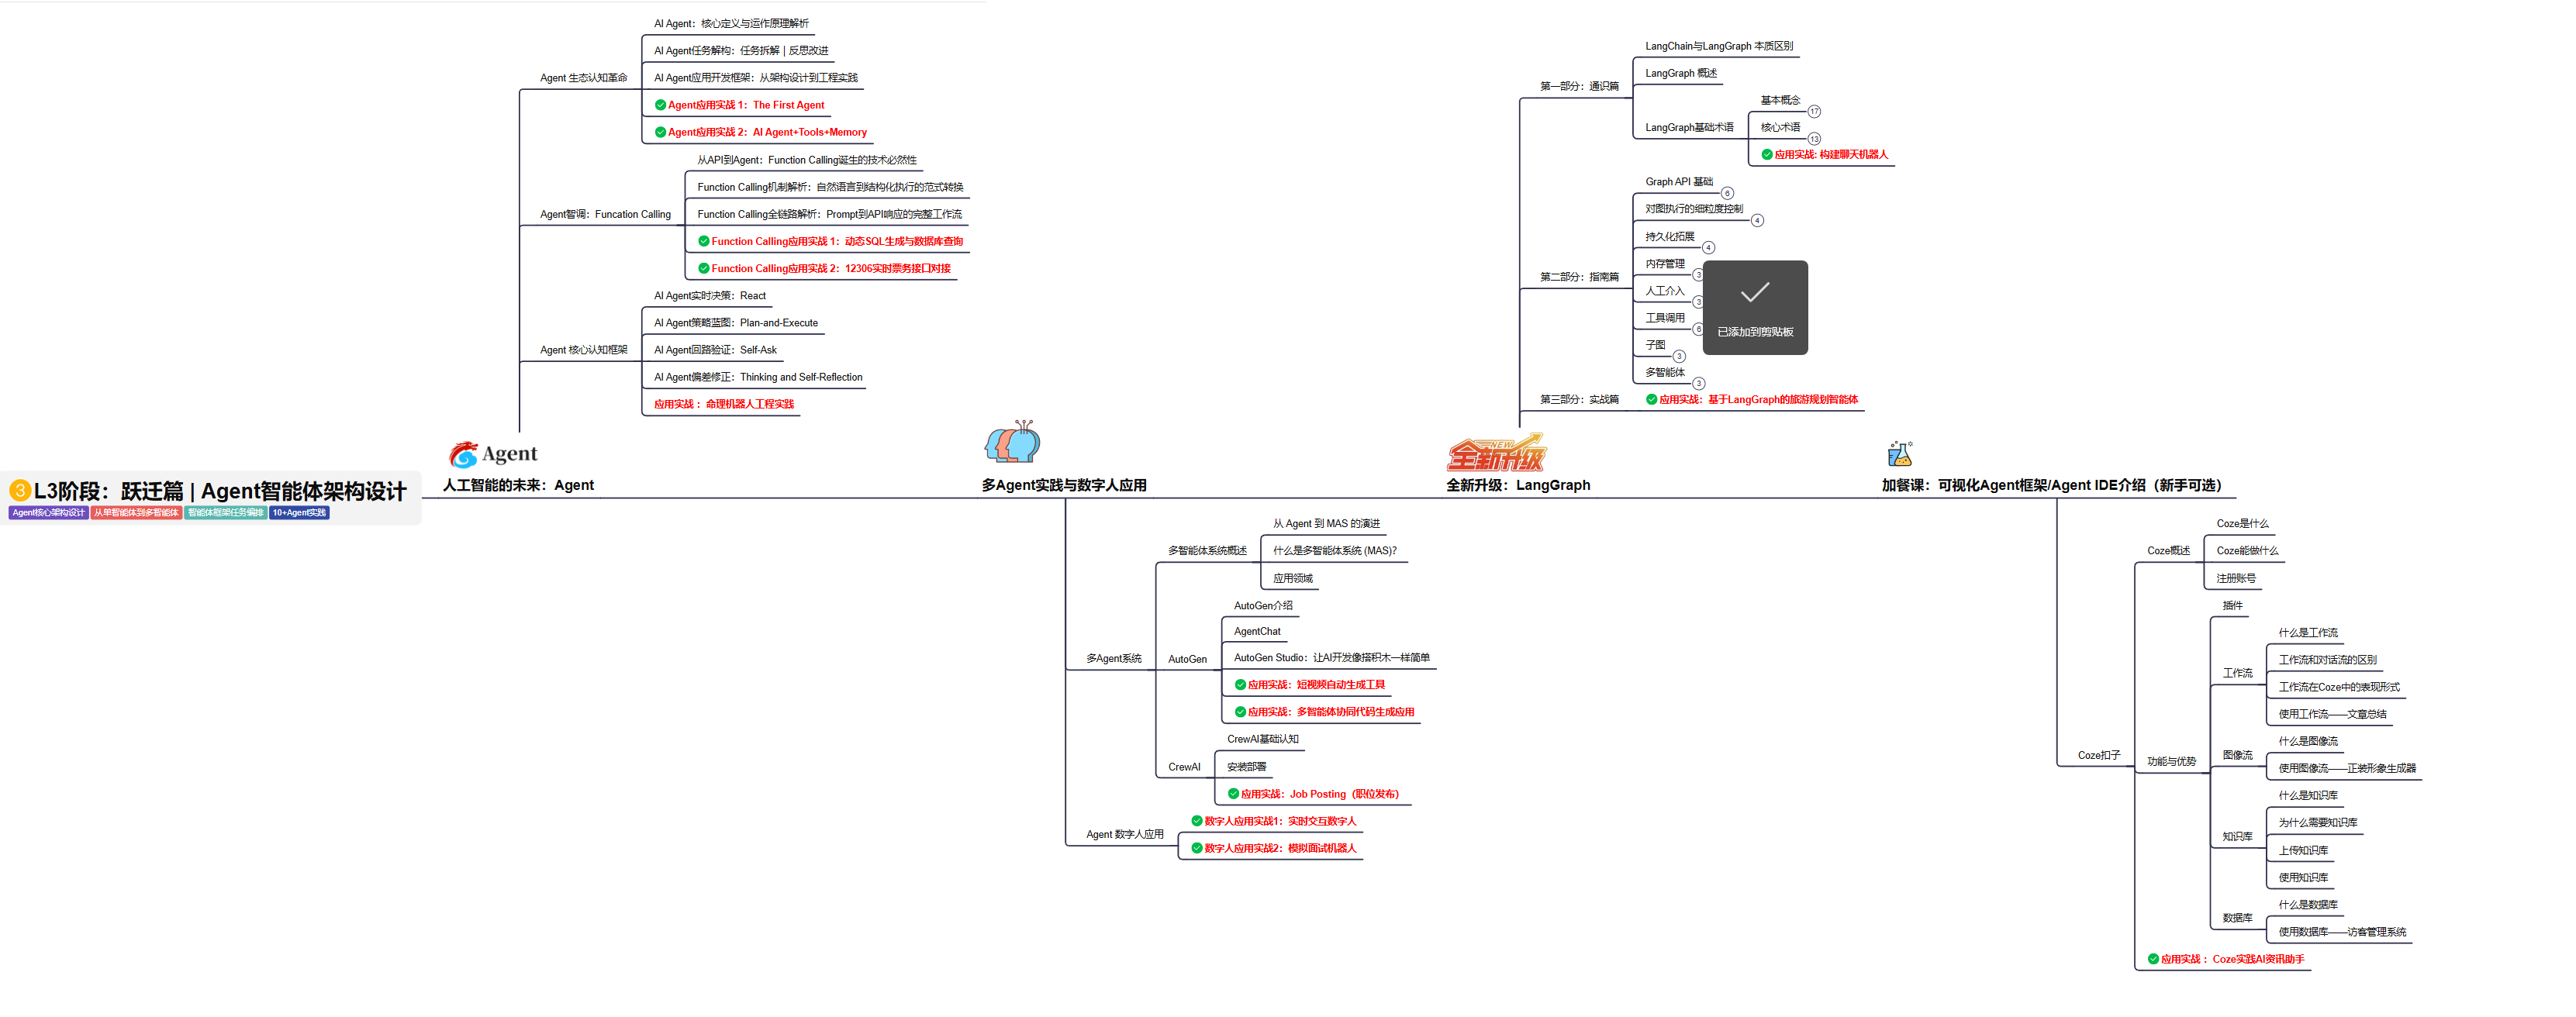
L3阶段: 将 深入探索大模型Agent技术的进阶实践,从Langchain框架的核心组件到Agents的关键技术分析,再到funcation calling与Agent认知框架的深入探讨。同时,通过多个实战项目,如企业知识库、命理Agent机器人、多智能体协同代码生成应用等,以及可视化开发框架与IDE的介绍,全面展示大模型Agent技术的应用与构建。
目标与收益:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
L4级别:模型微调与私有化大模型
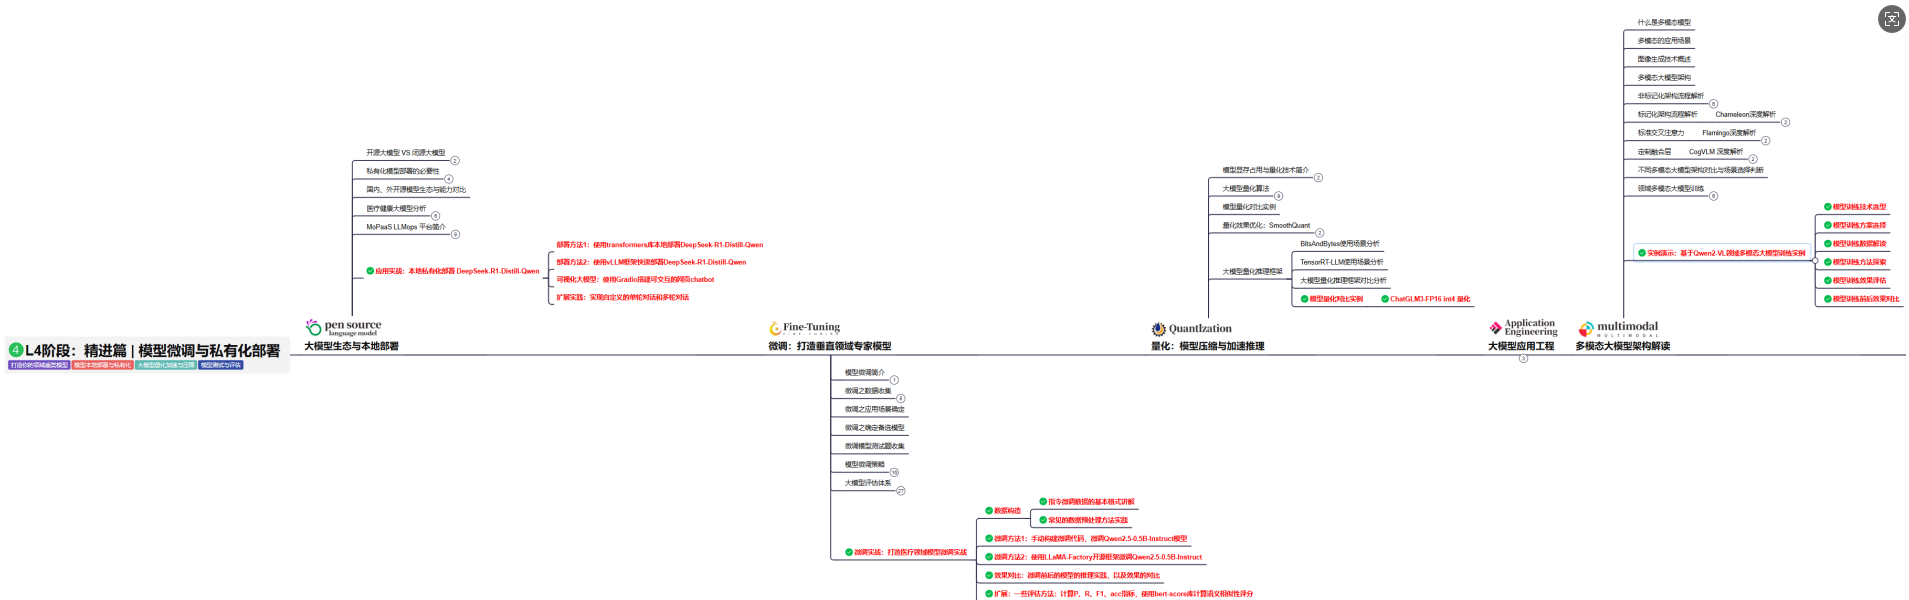
L4级别: 将聚焦大模型微调技术与私有化部署,涵盖开源模型评估、微调方法、PEFT主流技术、LORA及其扩展、模型量化技术、大模型应用引警以及多模态模型。通过chatGlM与Lama3的实战案例,深化理论与实践结合。
目标与收益:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
二、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

三、 大模型学习书籍&文档
收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

四、 AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

五、大模型大厂面试真题
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

六、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

适用人群

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 341


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


