


RAG(检索增强生成)技术通过结合外部知识库检索与大语言模型生成能力,有效解决了LLM在垂直领域知识缺失、幻觉问题和知识更新困难等挑战。本文详细介绍了RAG系统的构建流程,包括文档解析、分块、嵌入模型选择、索引构建、查询改写、混合检索和重排序等关键技术,并提供了评估方法和开发框架选择指南,帮助开发者构建高效、可靠的RAG应用。
一、为什么需要RAG
在大模型实际落地的时候,存在一些问题,主要集中在以下方面:
- 缺少垂直领域知识: 虽然大模型压缩了大量的人类知识,但在垂直场景上明显存在短板,需要专业化的服务去解决特定问题。
- 存在幻觉、应用有一定门槛: 在大模型使用上有一些幻觉、合规问题,没有办法很好地落地,配套工作不足,缺乏现成的方案来管理非结构化文本、进行测试、运营和管理等。
- 存在重复建设: 各业务孤立摸索,资产无法沉淀,存在低水平重复建设,对公司来说ROI低,不够高效。
- …
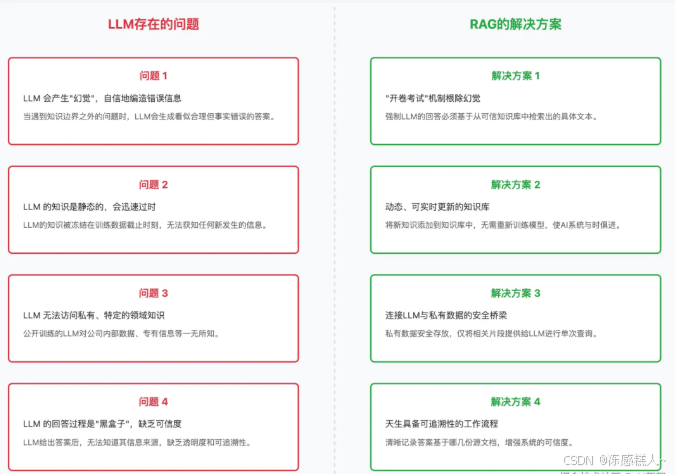
RAG的出现,标志着LLMs从静态知识库向动态、自适应系统转变的关键一步。LLMs在处理知识密集型任务时,其固有的静态知识限制(如幻觉和知识过时)促使业界寻求一种能够注入实时、外部和可验证信息的方法。RAG正是这种需求的直接产物,它作为一项重要的架构创新,弥合了预训练的静态知识与不断演进的现实世界信息之间的鸿沟。这种能力使得LLMs能够更好地应对不断变化的信息环境,并提供更可靠的响应。
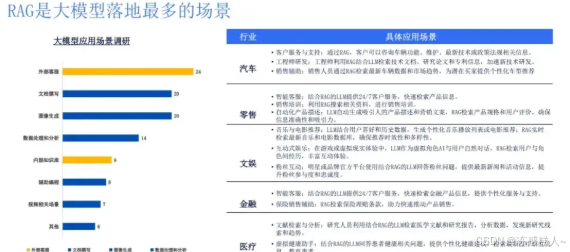
24年的ChatGLM的一次调研:
RAG的核心思想
- 定义:RAG是一种将外部知识库的检索(Retrieval)与大语言模型的生成(Generation)能力相结合的技术范式。
- 通俗比喻:让LLM“开卷考试”,而不是“闭卷考试”。在回答问题前,先去指定的资料库里查找相关信息,然后基于这些信息来组织和生成答案。
- 核心优势:
- 提升事实准确性:答案基于提供的上下文,有效减少幻觉。
- 知识动态更新:只需更新外部知识库,即可让模型掌握最新信息,成本远低于重新训练模型。
- 增强可信度与可解释性:可以展示答案的来源(引用),用户可以自行核实。
二、RAG核心组成与通用设计
一个完整的RAG系统通常包含两个核心流程:数据准备(离线)和推理检索(在线)。
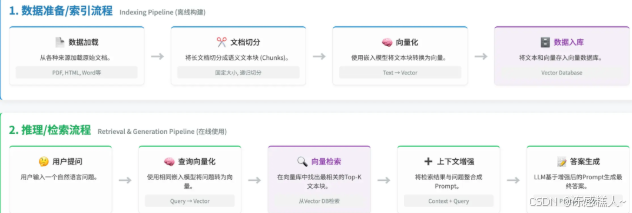
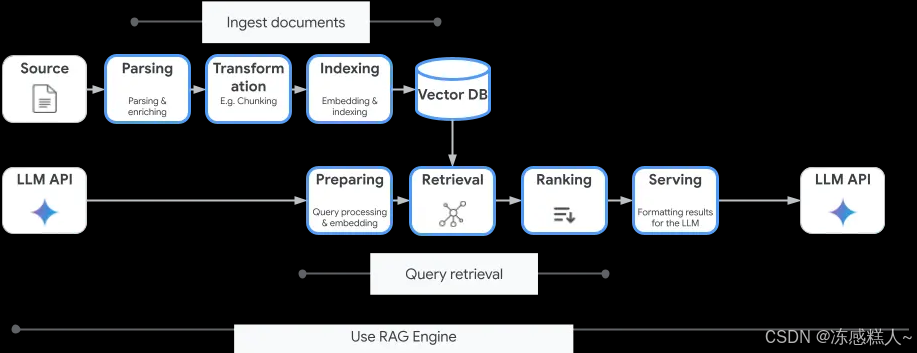
RAG的核心接口,RAAS,(Rag As a Service)提供的接口,当然平台能力更强的可以支持自定义模型、自定义分片等。但是核心就是构建和召回;
- 也可以参考Google 的 RAG API:https://cloud.google.com/vertex-ai/generative-ai/docs/model-reference/rag-api?hl=zh-cn#retrieval-query-api
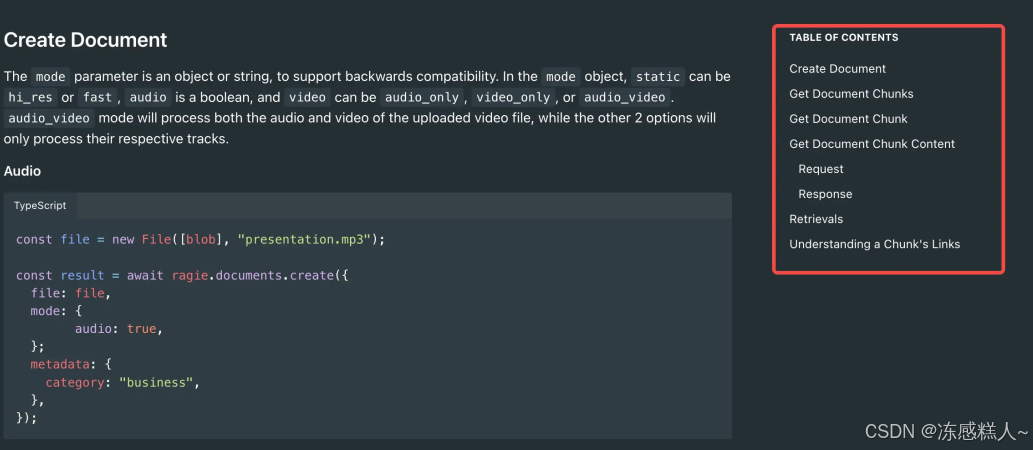
- 创建文档(构建索引), 架桥修路的感觉
- **格式要丰富,**文本、音频、视频; 数据清洗、预处理、切分
- 索引要好: 嵌入模型、元数据、分层索引、图;
- 理想轻快:速度要快、成本要低、效果要好;
- 速度和效果有个折中;
- 检索文档(使用索引),问题本质上是一个经典的**精确率(Precision)**与 召回率(Recall) 的权衡。
- 查询模糊性: 读者问:“我想找本关于那只蓝色鸟的书。”专家需要理解,读者指的是神话里的青鸟、一部叫《蓝鸟》的小说,还是一本关于蓝鸟生物习性的科普读物?(Query Transformation)
- 大海捞针: 专家定位到“鸟类科普”区,书架上有一百本关于鸟的书,其中几十本都提到了蓝色羽毛的鸟。专家需要快速浏览,找出专门讲“蓝鸟”的那几本,而不是讲“蓝孔雀”或“蓝鹦鹉”的书。(Re-ranking)
- 上下文碎片化: 专家发现,关于蓝鸟的栖息地在A书的第5章,它的食性在B书的第2章,它的迁徙路线在一张地图C上。他需要把这三份资料都找出来给读者,才能完整回答问题。(Context-Enriched Retrieval)
- 最佳数量: 专家是应该只拿最核心的一本书,还是把相关的十本书都拿过来?拿太多读者会晕,拿太少又怕信息不全。他需要做一个专业的判断。(Dynamic k)
三、一些优化RAG系统的方法
构建:Parsing解析
“垃圾进,垃圾出 (Garbage In, Garbage Out)
如果从一开始就无法准确、完整地从原始文件中提取信息并进行清洗,那么后续所有的努力(分块、嵌入、检索)都建立在一个摇摇欲坠的基础上。
这个阶段的任务不是简单地把文件里的字“抠”出来,而是要模拟人类阅读文档的方式,理解其结构、清理无关信息,并处理非文本内容。
解决方案:使用能够理解文档视觉布局和文档对象模型 (DOM) 的现代解析工具。核心工具推荐:
- unstructured.io:一个强大的开源库,能将 PDF、HTML、Word 等文档解析成一系列带有类型标签的“元素”(如 Title, NarrativeText, ListItem, Table)。这是目前业界的首选之一。
- LlamaParse:由 LlamaIndex 团队开发,专门针对复杂 PDF 进行优化,尤其擅长提取嵌入式表格和复杂布局。
- PyMuPDF:一个更底层的库,提供了精细控制 PDF 元素提取的能力,适合需要高度定制化的场景。
- LangExtract:Google 开发的一个 Python 库,用于从非结构化文本中提取结构化信息。它利用大语言模型(LLMs)来识别和组织文本中的关键信息,并能精确定位提取内容在原文中的位置。
这里也可以训练一些文档布局模型,参考:https://www.textin.com/
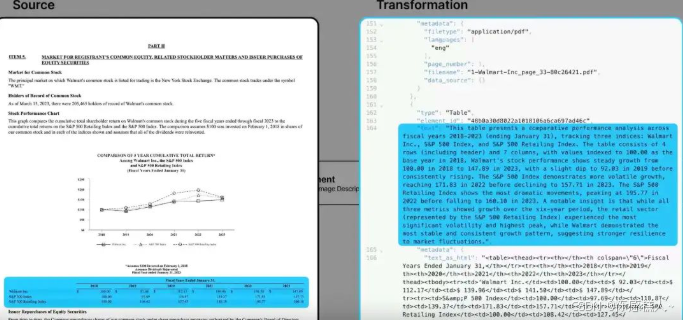
| 类别 (Category) | 技巧/策略 (Technique/Strategy) | 核心问题 (Core Problem) | 解决方案与核心操作 (Solution & Key Action) |
|---|---|---|---|
| 按文件类型加载 | 处理 PDF 文件 | PDF 可能是扫描件,纯文本提取会失败或为空。 | 区分文本型与扫描型 。对扫描件必须使用 OCR (光学字符识别) 引擎来提取文字。 |
| 处理 HTML/网页 | 网页包含大量导航栏、广告等无关噪声,会干扰核心内容。 | **去除样板代码 (Boilerplate Removal)**。专注于提取 <main>, <article> 等核心内容标签,剔除噪声。 | |
| 处理结构化数据 (CSV/JSON) | 原始数据行(如 Laptop,999)对语言模型不友好,缺乏语义。 | 转化为自然语言 。将每行数据转换成一个完整的句子(例如:“产品是 Laptop,价格是 999”)。 | |
| 通用预处理 | 精细化文本清洗 | 提取出的文本存在格式错误、乱码或 OCR 识别错误。 | 规范化文本 。去除多余空白/换行;修复编码问题;修正常见的 OCR 错误(如 ‘1’ vs ‘l’)。 |
| 表格转化 | 语言模型无法直接理解表格的二维结构关系。 | 转化为 Markdown 格式 。将表格数据转换为 LLM 在训练中熟悉的 Markdown 语法,以保留其结构。 | |
| 图像/图表处理 | 图表、流程图中的关键信息是视觉的,无法被文本模型检索。 | **图像转文本 (Image-to-Text)**。使用多模态模型 (如 GPT-4V) 为图片生成详细的文字描述,并将其注入到文本流中。 | |
| 元数据绑定 | 孤立的文本块缺乏上下文,导致无法追溯来源和进行有效过滤。 | 为每个块附加“身份证” 。绑定来源信息(文件名、页码)、结构信息(章节)、时间信息(创建日期)等元数据。 |
构建:Chunk切分
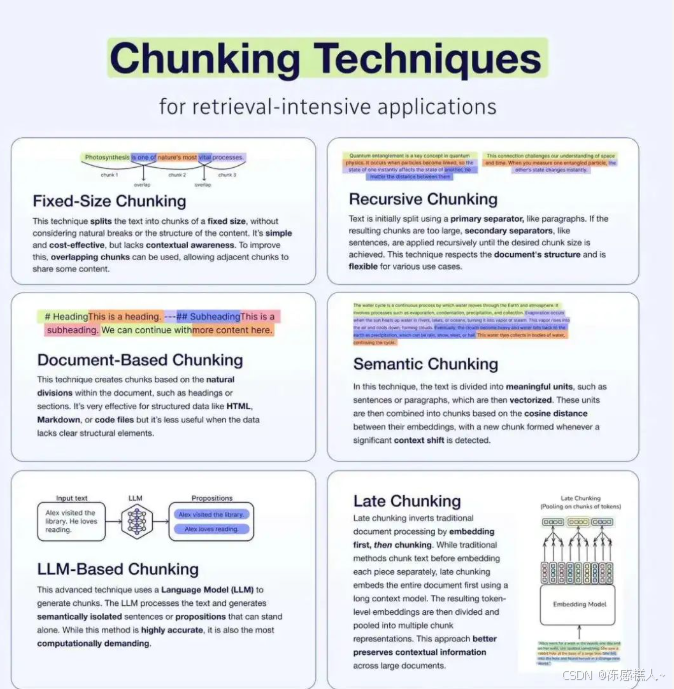
| 分段方式 | 工作原理 | 比喻 |
|---|---|---|
| 固定长度 (Fixed-Size) | 按固定字符数(如1000个字符)切分,一刀切。 | 一个蒙着眼睛的工人,用一把尺子量长度,到地方就用剪刀剪开,不管剪到的是什么。 |
| 递归字符 (Recursive) | 优先按段落、再按句子、最后按单词切分,试图保持句子完整。 | 一个有基本规则的工人,他会优先沿着段落的缝隙剪,如果不行再沿着句号剪。 |
| Agentic Chunking | 一个LLM Agent顺序阅读文本,每读一小段就自己判断:“这段话的意思说完了吗?它是一个独立完整的知识点吗?” 然后再决定是继续读下去,还是在这里切一刀。 | 一位学识渊博的图书管理员 ,他会完整阅读一个章节或段落,理解其核心思想后,用一张书签精准地标记出一个独立、完整的知识单元。每做一个切分决策,都需要调用一次LLM API,成本和耗时都太高; |
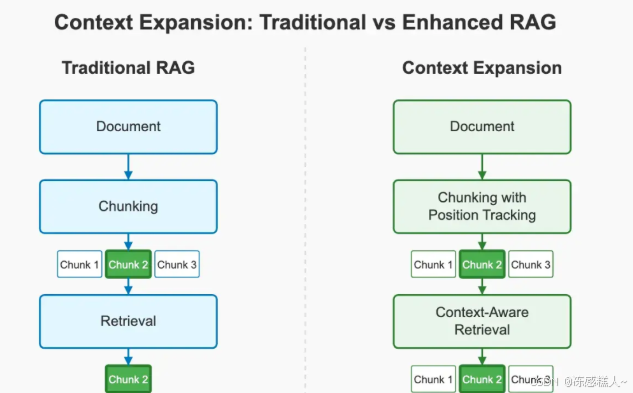
线上主流还是递归分段为主,保持段落的长度256~1024 个字符,看场景: 线上一般也会配合Context Expand。
- 对于需要精确、事实性回答的场景(如Q&A):倾向于使用更小的尺寸,如 256-512。
- 对于需要更丰富上下文、进行总结或推理的场景(如分析报告):倾向于使用更大的尺寸,如 512-1024。
可以自己跑评估脚本,在相同的Context长度下,什么字符扩大几个窗口可以达到最好的效果。比如context总长度在10000的时候,chunk多少合适,expand几个窗口合适。
实验表明,512的块大小在忠实度(Faithfulness)和相关性(Relevancy)上表现最佳。在嵌入模型选择上,LLM-Embedder在性能上与更大的bge-large相当,但模型尺寸小得多,是性能和效率的绝佳平衡点。
https://arxiv.org/pdf/2407.01219#page=9.46
构建:嵌入模型
所有涉及到模型的肯定都要考虑下性能RT、效果:
如何选择一个Embeding模型:https://weaviate.io/blog/how-to-choose-an-embedding-model
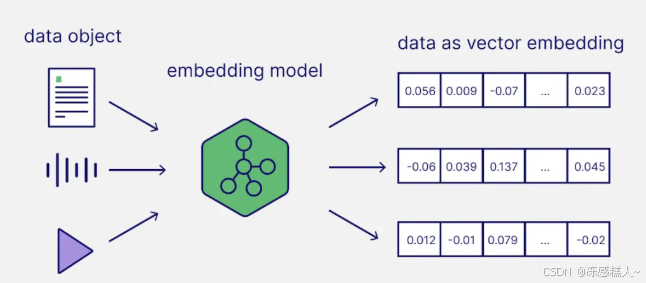
| 决策因素 (Decision Factor) | 核心问题 (Key Question) | 推荐做法 (Recommended Action) |
|---|---|---|
| 1. 性能与准确率 (Performance & Accuracy) | 模型能否精准理解语义,找到最相关的信息? | 查阅MTEB排行榜 。重点关注与RAG最相关的“检索(Retrieval)”任务得分,选择排名靠前的模型。 |
| 2. 成本 (Cost) | 我的预算是多少?是选择一次性硬件投入还是持续性API支出? | 快速验证/原型阶段 :使用API模型(如OpenAI, Cohere)。生产环境/长期项目:优先考虑开源模型(如BGE)以控制总成本。 |
| 3. 领域适应性 (Domain Specificity) | 我的知识库是否包含大量专业术语(如医疗、法律、金融)? | 优先选择可微调的开源模型 。对模型进行领域微调(Fine-tuning)是解决专业领域问题的最有效方法。 |
| 4. 语言支持 (Language Support) | 我的应用需要支持哪些语言?是否需要跨语言搜索? | 单一语言应用 :选择该语言的顶尖模型(如中文选BGE-zh)。多语言/跨语言应用:选择专门的多语言模型。 |
| 5. 速度与延迟 (Speed & Latency) | 用户查询的实时响应速度要求有多高? | 在满足性能要求的前提下,选择能提供可接受延迟的模型。可以在性能和速度间做权衡(如large vs. small模型)。 |
| 6. 隐私与控制权 (Privacy & Control) | 我的数据是否敏感?能否发送给第三方服务商处理? | 处理敏感数据 (如个人信息、企业机密、政府文件)时,必须选择可自托管的开源模型。 |
Embeding模型选择的路径:
- 从开源开始: 对于大多数正式项目,建议从一个顶级的开源模型开始,例如 BGE 系列。它在性能和成本之间取得了绝佳的平衡。 隐私安全性、速度和延迟、领域特性、成本、效果通过开源都可以做到非常好的地步。
- MTEB榜单: 访问 Hugging Face MTEB Leaderboard,查看最新的模型排名和性能数据。
- 建立自己的评估集: 公开榜单是通用参考,但无法完全代表你的特定场景。建立一个小的、能代表你核心业务问题的评估集,用它来测试不同模型的实际效果,这是最可靠的方法。
- 考虑微调: 如果通用模型在你的专业领域表现不佳,不要轻易放弃。投入资源对一个优秀的开源模型进行微调,往往能带来惊人的性能提升,是通往专业级RAG应用的必经之路。
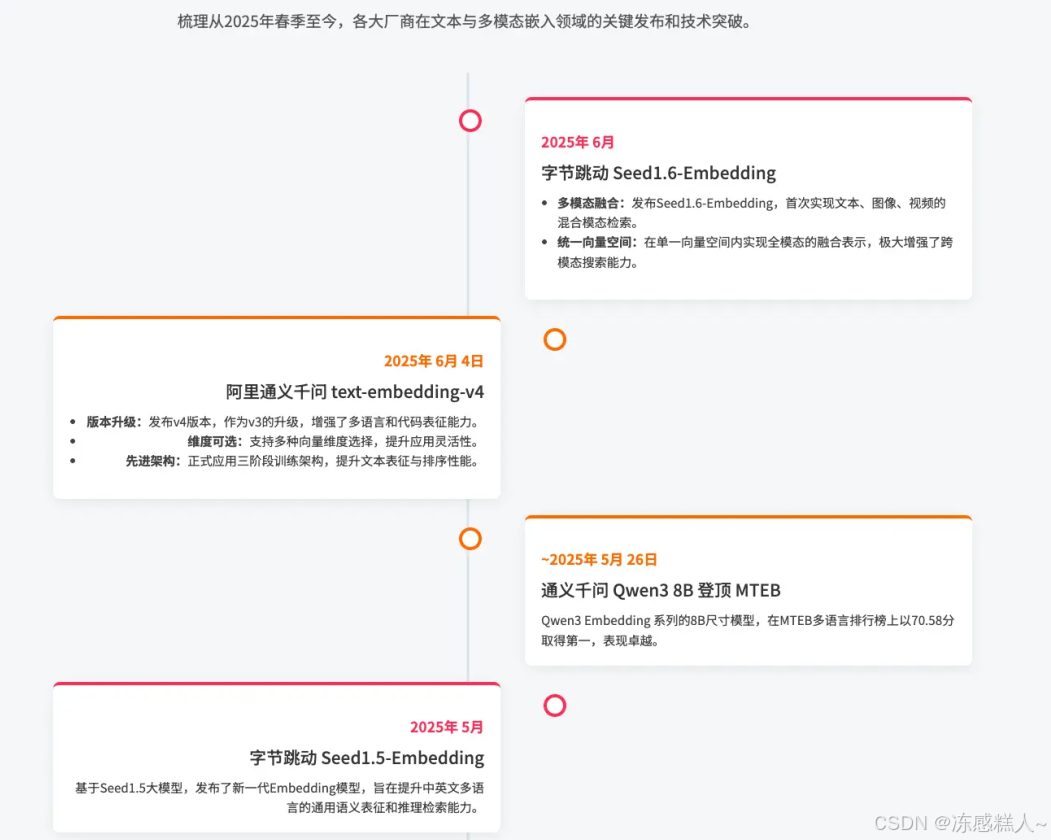
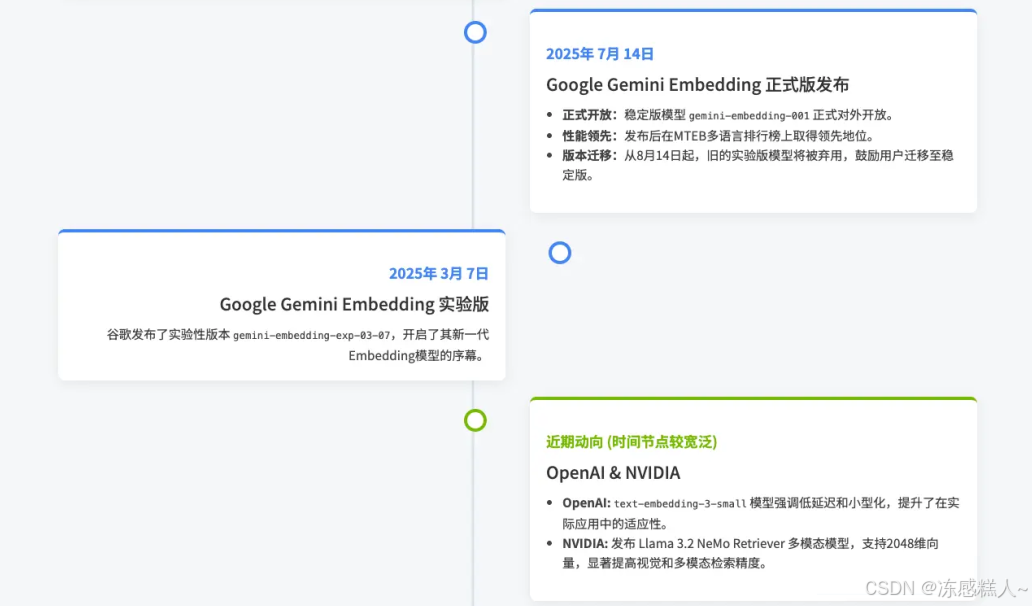
为什么近期大厂都在做Embedding模型?
如果说大型语言模型(LLM)是AI时代的“大脑”,那么Embedding模型就是连接这个“大脑”与现实世界海量信息的“神经网络”和“感官系统”。大厂们意识到,谁掌握了最高效、最精准的Embedding技术,谁就控制了AI应用落地的“咽喉要道”。
大厂们集体下场“卷”Embedding模型,是一场围绕AI时代核心基础设施的“圈地运动”。它们不仅仅是在竞争一个技术工具,更是在争夺未来十年AI生态的主导权、话语权和商业入口。而“刷榜”则是这场激烈竞争中,最耀眼的“广告牌”和最直接的“战报”。
-
战略层面:抢占AI生态的“入口”和“基础设施”:Embedding是构建几乎所有高级AI应用的第一步。一旦开发者习惯了你的Embedding模型,极大概率会继续使用你生态中的LLM、向量数据库和云服务,形成强大的生态锁定。它正在成为AI原生时代的基础设施,控制了它,就等于控制了信息的表示和流动方式。
-
应用层面:RAG爆发成为直接催化剂:RAG是目前公认的LLM企业落地最佳路径。而RAG系统的核心瓶颈在于检索(Retrieval)的质量,检索质量又几乎完全取决于Embedding模型的性能。优化Embedding这个RAG系统的“发动机”,能带来立竿见影的效果提升。
-
商业层面:“卖铲子”的稳定生意:在AI的“淘金热”中,提供Embedding模型就像是“卖铲子和牛仔裤”——高频、刚需。无论是通过API按量收费,还是通过开源模型吸引用户上云,都能产生持续且稳定的现金流,是一门清晰的商业模式。
-
技术层面:构建“护城河”和“数据飞轮”:顶级的Embedding模型需要海量高质量的训练数据和深厚的训练经验,这构成了强大的技术护城河。更多用户使用模型,就能收集到更多真实世界的数据,用于迭代优化,形成自我强化的数据飞轮,让强者恒强。
当然感觉算法同学也很喜欢自己训练模型,Embeding模型的进步还是比较快的。
构建:Indexing
在RAG的构建(Indexing)阶段,我们的目标不仅仅是存储信息,更是以一种“机器友好”的方式理解和重构信息。简单的分段处理保证了知识的“原子性”,而深度加工则在此基础上,构建了知识之间的“关联性”和“层次性”,为后续的检索和生成环节提供了质量极高的“弹药”。
核心思想:从“原始文本”到“结构化知识”
基础分段处理的是“原始文本块”,而深度加工旨在从这些文本块中提炼出“结构化知识单元”。这些单元可以是任何形式,只要它比原始文本更精炼、更具指向性。
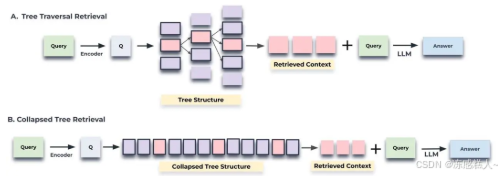
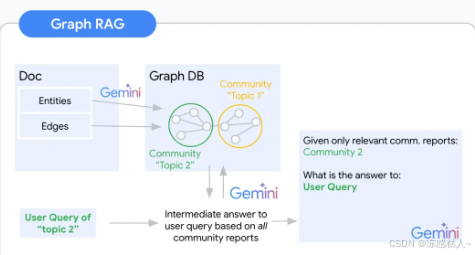
在实践中,并不需要一开始就实现所有复杂的加工技术。一个务实的优化路径是:
- 起点: 从高质量的基础分段开始,配合一个顶级的Embedding模型。
- 第一步优化: 引入提取QA对。这是投入产出比最高的一项深度加工,能快速提升核心问答场景的效果。
- 针对性优化:
- 如果你的RAG系统主要处理长文档,且用户经常需要总结或在文档中导航,那么构建摘要树是你的首选。
- 如果你的应用需要回答“谁和谁是什么关系”这类复杂问题,那么投入资源构建知识图谱将是你的“杀手锏”。
- 精细化优化: 当你对检索的精准度有极致要求时,可以尝试命题化分块。
| 加工技术 | 核心思想 | 解决的关键问题 | 适用场景与特点 |
|---|---|---|---|
| 提取QA对 | 将陈述性文本转化为问答形式针对其中的关键信息点,自动生成“问题-答案”对。然后将这些QA对与原始文本块关联,或者直接将问题(Question)作为被索引的内容。 | 提升与用户自然语言问题的匹配度 | 事实密集型文档,实现相对简单,效果立竿见影。 |
| 构建摘要树 | 对知识进行层级化、由粗到精的概括为长文档构建一个从上到下的层级摘要结构。L0 (顶层): 整篇文档的摘要。L1 (中层): 每个章节的摘要。L2 (底层): 每个小节或段落的摘要,甚至可以是原始文本块。 所有这些摘要和原始块都通过层级关系链接起来。 | 长文档导航困难,上下文丢失 | 结构化长文档(书籍、报告),支持多粒度查询。 |
| 构建知识图谱 | 提取实体和关系,建立知识网络从文本中提取出实体(Entities)、关系(Relations)和属性(Attributes),并将它们组织成一个图结构(主语-谓语-宾语的三元组)。例如,从“埃隆·马斯克创立了SpaceX”中提取出 (埃隆·马斯克) -[创立了]-> (SpaceX)。 | 无法回答复杂、多跳的关联性问题 | 知识关联性强的领域,功能强大但实现复杂度最高。 |
| 命题化分块 | 将文本分解为最小的、独立的事实单元。用LLM将文本分解成一系列独立的、原子化的事实陈述(Propositions)。例如,将“Model Y是特斯拉最畅销的电动车,于2020年开始交付”分解为:Model Y是特斯拉的一款电动车。Model Y是特斯拉最畅销的车型。Model Y于2020年开始交付。 | 文本块中信噪比低,语义焦点被稀释 | 信息密度高的文本,能显著提升向量检索的精确性。 |
这里数据库层面:
- HoloGress:可以同时存储关系型数据以及向量数据库;SQL查询和向量召回;
- OpenSearch:同时支持向量召回和关键词召回;
召回:Query改写
论文:https://arxiv.org/pdf/2407.01219
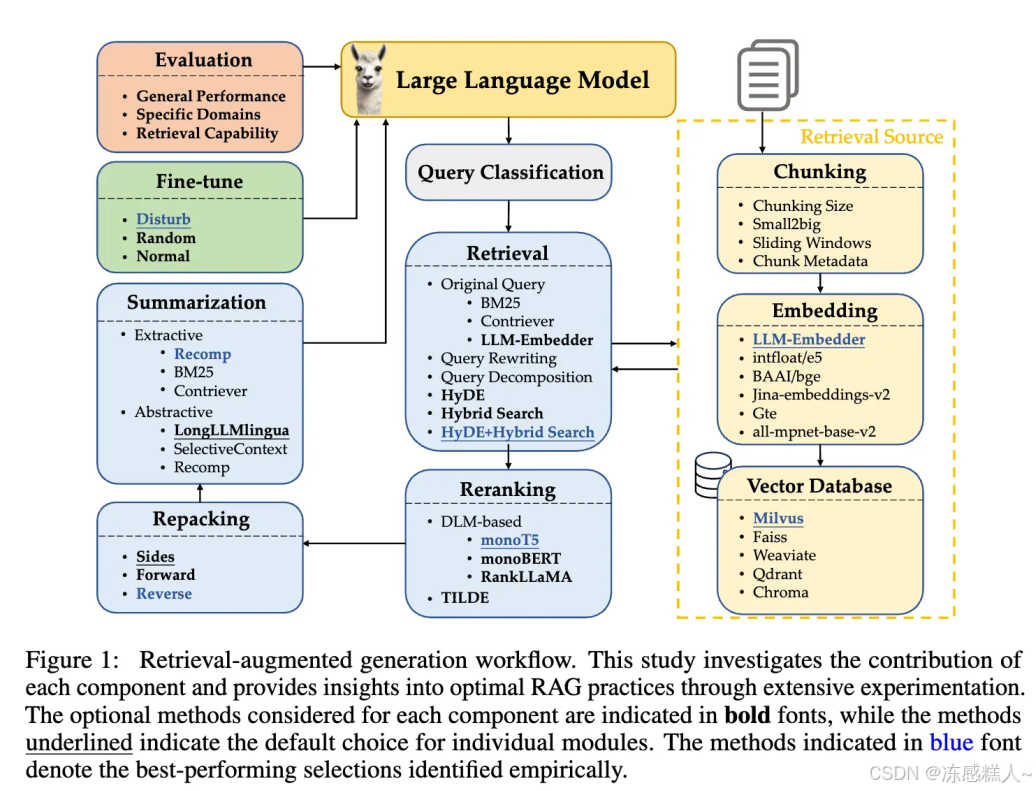
用户的问题可能是模糊的、复杂的、或使用了与文档不同的词汇,改写就是为了生成一个或多个对搜索引擎更友好的查询。解决用户原始问题与知识库文档之间可能存在的表述不一致或信息不足的问题。
- 多路查询(Multi-Query):让LLM将用户的单个复杂问题分解成多个角度的子问题,然后分别对这些子问题进行检索,最后合并结果。这能有效提升召回的全面性。
- 退步提示(Step-Back Prompting):引导LLM从具体问题回退到更高层次的概念性问题,同时对两者进行检索,可以获得更丰富的上下文。
- HyDE(Hypothetical Document Embeddings):先让LLM针对用户问题生成一个“假设性”的答案,然后用这个假想答案的向量去检索文档。这种方法通常能更好地捕捉到问题的核心语义。
- HyDE的核心思想是:在向量空间中,“答案”与“答案”之间的语义相似度,比“问题”与“答案”之间的相似度更高。因此,它先将你的“问题”(Query)变成一个“伪答案”(Hypothetical Document),再用这个伪答案去寻找真正的答案。
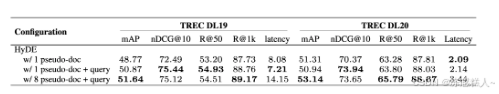
- 但是,只用伪答案可能会丢失原始问题中的一些精确意图。因此,一个更优化的做法是将两者结合。将单个伪文档和原始Query结合(
w/ 1 pseudo-doc + query)的配置,在两个测试集上的nDCG@10指标都明显高于仅使用伪文档的配置。不是越多越好:生成8个伪文档虽然性能也不错,但延迟大幅增加,得不偿失。
查询扩展: 让LLM为原始问题生成一系列相关的同义词、下位词或相关概念,扩展查询的覆盖面。用户问“AI裁员”,LLM可以扩展为“人工智能对就业市场的影响”、“自动化导致的岗位缩减”、“科技行业的人员结构调整”等,然后将这些关键词加入到原始查询中。主要解决 “词汇不匹配” 的问题。用户用的词和文档里的词可能不一样。
| 策略 | 优缺点 | 权衡点 (Trade-off) | 适用场景 |
|---|---|---|---|
| 多路查询 (深入细节) | Pros:显著提升信息全面性 (Recall)Cons:增加LLM调用成本和延迟 | 成本/延迟 vs. 信息完整度 | 对比类问题 (A vs. B)多主题问题 (涉及多人、多地、多概念) |
| 退步提示 (高维视角) | Pros:极大增强答案深度和洞察力Cons:可能引入过于宽泛的信息 | 答案深度 vs. 信息相关性 | 技术/科学问题 (需要引用原理) 故障排查 (从现象到本质) |
| HyDE (假设答案) | Pros:有效提升检索相关性 (Relevance)Cons:严重依赖LLM初始生成的质量,可能被误导 | 高相关性 vs. 被初始幻觉带偏的风险 | 零样本问答 (对领域不熟) 问题简短、抽象 |
| 查询扩展 (纠正问题) | Pros:提高对不规范输入的鲁棒性Cons:可能改变用户原意,或引入噪音 | 召回全面性 vs. 查询精准度 | 口语化/非正式提问****错别字或术语不当 |
召回:混合检索(多路召回)
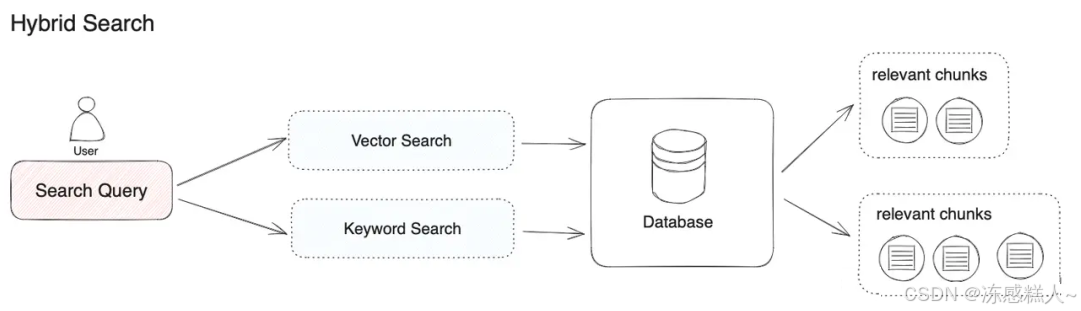
混合检索的核心思想是结合两种不同类型的检索技术的优势,以实现比单一技术更优越的检索效果。具体来说,它融合了:
- 稀疏检索(Sparse Retrieval): 以传统的关键词匹配为基础,如 BM25 算法。它的优势在于能精确匹配关键词和术语,对于包含特定实体或专业名词的查询非常有效。
- 稠密检索(Dense Retrieval): 以基于深度学习的向量嵌入为基础,如论文中推荐的 LLM-Embedder 模型。它的优势在于能理解查询的语义和意图,即使关键词不完全匹配,也能找到意思相近的内容。
通过结合两者的长处,既能保证关键词的精确匹配,又能捕捉语义上的相关性,从而全面提升检索结果的准确率和召回率。
计算公式: Sh = α · Ss + Sd
Sh是最终的混合检索相关性分数。Ss是经过归一化的稀疏检索(BM25)分数。Sd是经过归一化的稠密检索(向量相似度)分数。α是一个超参数,用于控制稀疏检索的权重,是调优的关键。
实验结果表明,当α设置为0.3时,混合检索在各项指标上综合表现最好。这说明在LLM-Embedder和BM25的组合中,给予稠密检索更高的权重,同时用稀疏检索作为补充,是最佳策略。
混合检索还可以与另一种查询增强技术HyDE(生成假设性文档)结合。实验表明,HyDE + Hybrid Search的组合是所有检索方法中的性能王者,在TREC DL19上的nDCG@10分数达到了73.34,是所有配置中的最高分。但它也带来了最高的计算延迟。对答案质量要求极高,可以容忍更高延迟的离线分析、报告生成等任务。可以考虑使用HyDE + Hybrid Search。
混合检索是一个强大且值得默认采用的检索策略,可以在性能上对系统不产生影响的情况下,仍然能够提升检索的效果。
召回:重排序(Re-ranking)
初步检索为了速度和召回率,可能会返回一些不那么相关的文档。重排序的作用就是利用更精确但计算更密集的模型,对这一小批候选文档(例如前50或100篇)进行重新打分和排序,确保最相关的信息被优先提供给后续的大语言模型
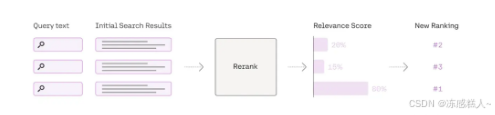
两种类型的Rerank模型:
- 基于深度语言模型的重排序 (DLM Reranking):核心思想:这类方法将重排序视为一个分类任务。它们将“查询”和“待排序的文档”拼接在一起作为输入,然后让一个深度语言模型来判断该文档与查询是否相关(例如,预测输出为 “true” 或 “false” 的概率)。最后根据这个相关性概率对文档进行排序。
- 基于查询似然性的重排序 (TILDE Reranking):核心思想:TILDE(Term-In-Last-Decoder-output-space Expansion)是一种追求极致效率的方法。它不直接计算查询和文档的整体相关性,而是预先计算出每个查询词(term)在文档中出现的可能性(log probabilities),在排序时只需将查询中所有词的似然性分数相加即可,速度极快。
绝大多数都属于“基于深度语言模型(DLM-based)”的方法,在Rerank这个环节,我们处理的通常只是初步检索返回的几十个候选文档,而不是整个知识库,因此这个计算开销在很多场景下是完全可以接受的。
关于如何选择一个合适的Rerank模型:
- 对于大多数项目(尤其是初创项目):
- 从
**BAAI/bge-reranker-large**开始。它是在性能、成本和灵活性之间取得了最佳平衡的开源模型,足以满足绝大多数高质量RAG的需求。
- 当性能遇到瓶颈或需要更广泛的语言支持时:
- 评估
**Cohere Rerank API**。如果预算允许,它提供的顶尖性能和易用性是解决问题的最快途径。
- 当部署成本是首要考虑因素时:
- 可以降级使用
**BAAI/bge-reranker-base**。它比large版本更小、更快,虽然性能略有下降,但性价比极高。
| 模型系列/服务 | 主要优势 | 适用场景 | 注意事项 |
|---|---|---|---|
BGE Reranker 系列 (如 bge-reranker-large, bge-reranker-base) | 开源首选,性能强大 :在MTEB榜单上长期名列前茅,特别是large版本。中英双语支持好:对中文和英文的排序效果都经过了大量验证。商业友好:通常采用Apache 2.0许可证。 | 1. 需要高质量开源方案的团队。2. 应用场景主要涉及中/英文。3. 有能力自行部署和维护模型。 | 需要根据硬件资源选择large(效果最好)或base(更轻量)版本。 |
Cohere Rerank API (如 rerank-english-v3.0, rerank-multilingual-v3.0) | 业界顶尖性能 :通常被认为是性能天花板,效果极佳。简单易用:通过API调用,无需关心部署和维护。强大的多语言支持:multilingual版本支持超过100种语言。 | 1. 对性能有极致要求的项目。2. 需要支持多种语言的全球化应用。3. 希望快速集成,不愿投入运维成本的团队。 | 这是一个付费商业服务,成本会随使用量增加。 |
| Voyage AI Rerank API | 新兴的强大API :在榜单上表现优异,性能可与Cohere媲美。针对性优化:提供不同领域的优化模型。API形式,方便集成。 | 1. 寻求Cohere之外的高性能商业API替代方案。2. 希望尝试在特定领域(如金融、法律)有优化的模型。 | 同样是付费商业服务。 |
其他开源模型 (如 jina-reranker, mxbai-embed-large) | 提供多样化选择 :在特定任务或语言上可能有奇效。社区活跃:不断有新的模型涌现。 | 1. 当BGE等模型无法满足特定需求时(如特定小语种)。2. 喜欢探索和实验最新技术的开发者。 | 性能和稳定性可能参差不齐,需要自行在业务数据上进行充分测试。 |
召回:重打包(Repacking)
LLM在处理长上下文(long context)时,对位于上下文开头和结尾部分的信息注意力最高、利用得最好,而对放在中间部分的信息则容易忽略或“忘记”。
即使我们已经通过Reranking找到了最相关的文档,如果随意地将它们拼接起来,最重要的信息可能会不幸地落在LLM的“注意力盲区”里,从而影响最终生成答案的质量。Document Repacking 的目的就是通过策略性地排布文档顺序,将最关键的信息放在LLM最“舒适”的位置。
三种不同的文档排布策略:
**forward**(正向): 按照重排序后的相关性分数从高到低排列。这意味着最相关的文档放在上下文的最前面。**reverse**(反向): 按照相关性分数从低到高排列。这意味着最相关的文档被放在上下文的最后面,紧邻着用户的问题。**sides**(两侧): 这是一个受“迷失在中间”理论启发的策略,它将最相关的文档放在上下文的开头和结尾,而将次要的文档放在中间。
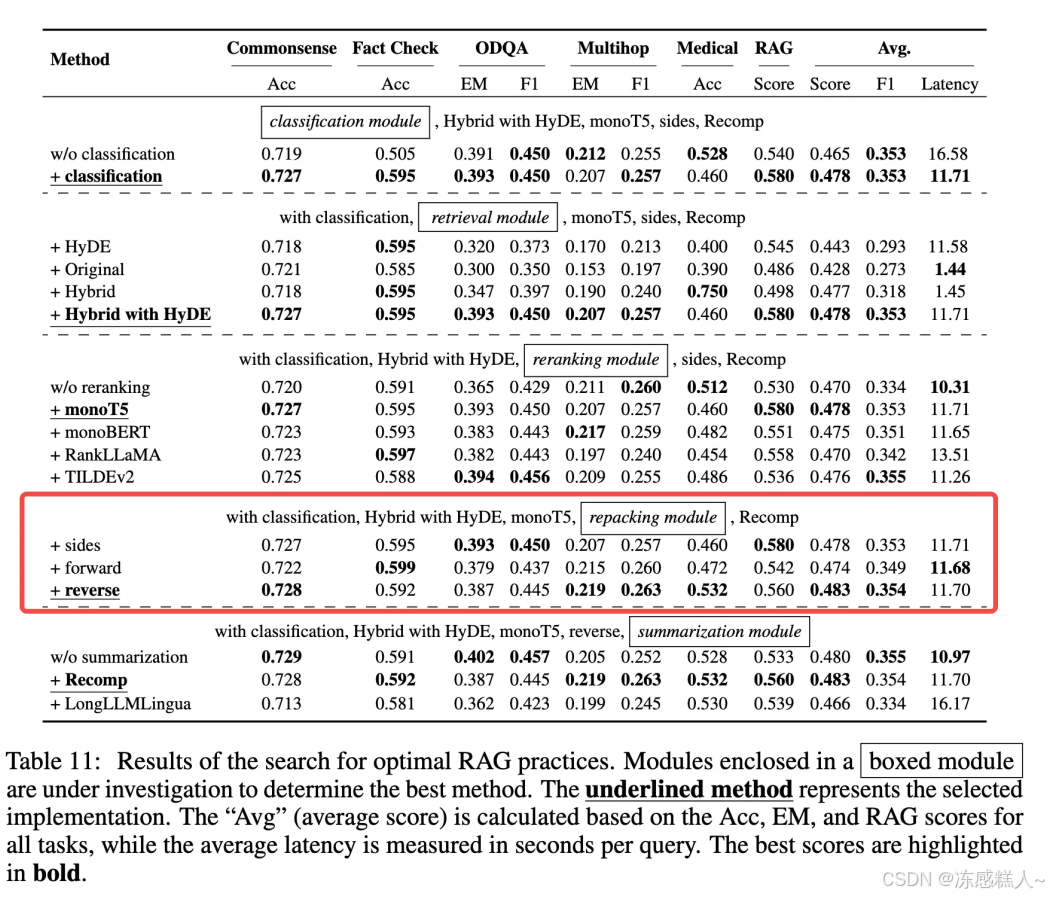
将最相关的文档放在上下文的最末尾,使其最接近最终的生成指令或问题,对LLM的性能提升最大。这可能是因为模型在生成答案时,会最优先关注离它“最近”的上下文信息。
四、端到端的评估
常用评估框架:RAGAS、ARES、TruLens等,它们可以从答案的忠实度(Faithfulness)、相关性(Relevance)、上下文精度(Context Precision)等多个维度对RAG系统进行打分。
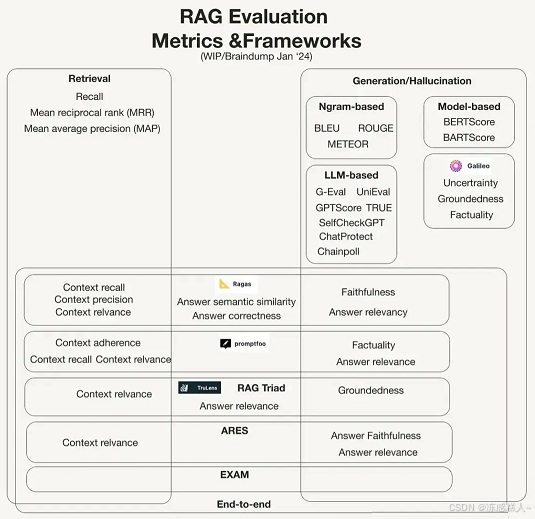
关于为什么使用Ragas作为评估框架?它主要有两大优点:https://www.ragas.io/
- 灵活性高(可自定义):
- 评估模型随便换:你可以指定任何大语言模型(开源的、商业的都行)来当“裁判”打分。
- Embedding模型随便换:你可以换成自己系统正在用的 Embedding 模型,让评估更公平。
- 结果好用(易分析、易展示):
- 方便导出:评估分数能一键变成
Pandas表格,方便保存和分析。 - 方便作图:有了表格,就能轻松画出各种对比图,直观地看出哪个方案更好。
可用指标:https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/
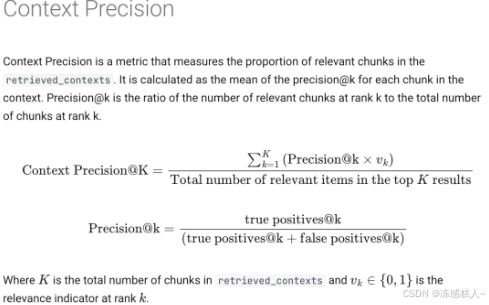
精确度和召回率通常是相互制约、此消彼长的。
- 想提高精确度? 把搜索条件设得非常严格。结果是返回的东西很少,但都很准。缺点是可能会漏掉很多相关的。(就像用一个非常小的渔网,只能捞到特定大小的鱼,但肯定不会捞到垃圾,同时也错过了湖里其他大小的目标鱼)。
- 想提高召回率? 把搜索条件设得非常宽松。结果是返回了一大堆东西,确保所有相关的都在里面了。缺点是也包含了很多不相关的垃圾。(就像用一张巨大无比、网眼又密的渔网,把湖里所有目标鱼都捞上来了,但也捞上来了整片湖的水草)。
一个优秀的检索系统需要在精确度和召回率之间找到一个理想的平衡点,既要保证结果相关性高(高精确度),又要保证没有遗漏关键信息(高召回率)。
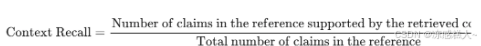
评估一般的核心流程:
- 准备数据:准备好
问题和标准答案。 - 运行系统:用你的 RAG 回答问题,并记下
答案和引用的原文。 - 自动打分:把上面两步的东西扔给 RAGAS,让它自动评分。
- 分析优化:看分数,哪里分低就优化哪里。
一个模拟的数据集表格:
| question_id | question (问题) | ground_truth_answer (标准答案) | ground_truth_context_ids (标准上下文ID) | generated_answer (模型生成答案) | retrieved_context_ids (模型检索到的上下文ID) |
|---|---|---|---|---|---|
eval_001 | RAG是什么? | RAG,全称Retrieval-Augmented Generation,是一种结合了检索器和生成器的AI模型架构。它首先从知识库中检索相关文档,然后将这些文档作为上下文,指导生成器产出更准确、更具事实性的答案。 | ["doc_rag_definition"] | RAG是一种先进的AI技术,它通过先搜索信息再回答问题的方式工作,能有效减少模型幻觉。 | ["doc_rag_definition"] |
# 使用 Hugging Face datasets 库创建 Dataset 对象
dataset = Dataset.from_dict(ragas_data)


# --- 运行评估 ---
# 定义我们想要使用的评估指标列表
# 注意:answer_correctness 和 context_recall 都需要 ground_truth
metrics_to_evaluate = [
    faithfulness,          # 忠实度:答案是否基于上下文
    answer_relevancy,      # 答案相关性:答案是否与问题相关
    context_precision,     # 上下文精确率:检索到的上下文是否都相关
    context_recall,        # 上下文召回率:是否检索到了所有必要的上下文来回答问题
    answer_correctness,    # 答案正确性:答案与标准答案的匹配程度
]

print("🚀 开始运行 Ragas 评估...")
# 使用 ragas.evaluate 函数执行评估
# Ragas 会自动使用 OPENAI_API_KEY 调用 LLM 进行打分
result = evaluate(
    dataset=dataset,
    metrics=metrics_to_evaluate,
)

print("✅ 评估完成!")


# --- 展示和分析结果 ---
# 将评估结果转换为 Pandas DataFrame 以便清晰地展示
df_results = result.to_pandas()
print("\n📊 评估结果分析:")
print(df_results)

# 保存结果到 CSV 文件
df_results.to_csv("ragas_evaluation_results.csv", index=False)
print("\n💾 结果已保存到 ragas_evaluation_results.csv")
五、经典论文
部分解读:https://mp.weixin.qq.com/s/HrZB4qNga69ePxJvcRiHTA
RAG技术虽然在2020年正式提出,但其早期提案和研究可追溯到2017年至2019年 。
- 2020年:RAG正式诞生(Lewis等人),密集神经检索、端到端检索-生成架构、检索感知预训练以及超越问答的应用开始涌现 。
- 2021年:研究重点转向提升生成质量 。
- 2022年:RAG系统开始进行规模化和专业化发展 。
- 2023年:RAG与LLMs的结合日益紧密,研究兴趣显著增长 。
- 2024年:RAGRAPH等新进展出现,将RAG扩展到图数据领域 。
- 2025年:当前研究方向正转向Agent系统、推理、记忆和多模态 。
| 类别 | 核心文献 (Publication Details) | 核心贡献与价值 (Core Contribution & Significance) |
|---|---|---|
| 奠基与综述 | ||
| RAG范式奠基之作 | “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” Patrick Lewis, et al. (Facebook AI, 2020) arXiv:2005.11401 | 思想 :正式提出RAG框架,将检索器与生成器端到端结合,先检索再生成。 价值:定义了RAG的基本形态(Retrieve then Read),是该领域的开山之作。 |
| RAG领域权威综述 | “Retrieval-Augmented Generation for Large Language Models: A Survey” Yunfan Gao, et al. (2023) arXiv:2312.10997 | 思想 :系统梳理RAG发展,划分为朴素、高级和模块化三个阶段。 价值:提供RAG演进路径和技术全景的清晰框架,是理解RAG现状和趋势的权威参考。 |
| 高级RAG与自适应方法 | ||
| 高级RAG与自适应方法 | “Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection” Akari Asai, et al. (UW & Google, 2023) arXiv:2310.11511 | 思想 :引入“反思令牌”,让LLM能自适应判断是否需要检索、评估检索结果,并通过自我批判提升答案质量。 价值:将RAG从固定流水线转变为动态、智能的决策过程,是迈向更自主AI的标志性工作。 |
| 高级RAG与自适应方法 | “Corrective Retrieval Augmented Generation (CRAG)” Shi-Qi Yan, et al. (2024) arXiv:2401.15884 | 思想 :引入轻量级“检索评估器”,根据评估结果触发不同知识获取策略来修复不完美的检索。 价值:提供一套优雅的“纠错”机制,通过动态调整增强RAG鲁棒性,减少幻觉。 |
| 检索与索引优化 | ||
| 检索优化经典方法 | “HyDE: Precise Zero-Shot Dense Retrieval without Relevance Labels” Luyu Gao, et al. (2022) arXiv:2212.10496 | 思想 :先让LLM据问题生成“假设性”答案,再用该答案的向量进行检索,以弥合语义鸿沟。 价值:解决了用户查询与文档的“语义鸿沟”问题,是提升检索准确率的经典零样本优化技巧。 |
| 结构化RAG | “RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval” Sivan Parmar, et al. (2024) arXiv:2401.18059 | 思想 :对文本进行递归聚类和摘要,构建分层的“摘要树”知识库,以匹配不同抽象程度的查询。 价值:提出创新的分层索引方法,使检索能匹配不同粒度的信息需求,显著提升复杂问题的检索效果。 |
| 图增强RAGhttps://mp.weixin.qq.com/s/sZs9pauYMsgiGt6eKic6_w | “From Local to Global: A GraphRAG Approach to Query-Focused Summarization” Darren Edge, et al. (Microsoft, 2024) arXiv:2404.16130 | 思想 :通过LLM预构建文档知识图谱并分层摘要,整合社区摘要以处理“全局性”问题。 价值:将RAG的能力从局部事实检索扩展到对整个语料库的宏观洞察,解决了传统RAG难以胜任的综合性分析任务。 |
| 工程实践与评估 | ||
| RAG系统评估框架 | “Ragas: Automated Evaluation of Retrieval Augmented Generation” Shahul Es, et al. (2023) arXiv:2309.15217 | 思想 :提出一个无需人工标注的自动化评估框架,从忠实度、答案相关性等多维度评估RAG系统。 价值:为衡量和优化RAG系统提供了科学的“标尺”,是RAG工程实践中不可或缺的量化工具。 |
| RAG最佳实践探索 | “Searching for Best Practices in Retrieval-Augmented Generation” Jingyu Liu, et al. (Meta AI, 2024) arXiv:2407.01219 | 思想 :通过大量实验,系统性地研究和组合现有的RAG技术环节,寻找性能与效率的最佳实践。 价值:为RAG的实际部署提供了宝贵的工程实践指导,帮助开发者在复杂的RAG工作流中做出明智选择。 |
六、开发者框架与产品
- https://www.ragie.ai/
- https://github.com/infiniflow/ragflow
- https://github.com/HKUDS/LightRAG
开发者框架
LLamaIndex:一个专门为连接 LLM 与您的私有数据而设计的“数据框架”,核心使命是解决数据处理的各种难题:如何高效地摄取(Ingest)、**索引(Index)和查询(Query)**各种复杂的数据。
LangChain:是一个功能极其全面的、用于开发由语言模型驱动的应用程序的通用框架
Haystack (by deepset AI):Haystack 的工作方式主要是通过构建管道 (Pipelines)。一个管道就像一条流水线,数据在其中被一系列组件 (Components) 按顺序处理,主要应用场景就是RAG。
📎OReilly Guide - RAG_in_production_with_Haystack-FINAL.pdf
| 方面 | LangChain | Haystack | LlamaIndex |
|---|---|---|---|
| 核心哲学 | 通用瑞士军刀 :一个无所不包的、用于构建任何LLM应用的通用框架。 | 工业流水线 :一个用于构建生产级、流程明确、易于维护的LLM应用的编排框架。 | 数据研发中心 :一个以数据为中心、专注于高级数据摄取、索引和查询的RAG框架。 |
| 主要优势 | 最庞大的生态系统 ,强大的Agent构建能力,极高的通用性。 | 生产级稳健性 ,流程**明确透明 (Explicit)**,组件解耦和替换方便。 | 最强的数据处理能力 ,海量数据连接器,前沿的RAG算法。 |
| 学习曲线 | 陡峭 。功能非常多,抽象层次也多,对于新手可能需要较长时间才能掌握。 | 中等 。概念清晰,但需要显式地构建管道,结构化强。 | 入门简单 。高级API非常简洁,可以快速上手。但高级功能同样复杂。 |
| 最佳应用场景 | **智能代理 (Agents)**,需要与多种外部工具/API交互的复杂应用,快速原型验证。 | 生产级的RAG系统 ,需要高可靠性、可维护性和组件灵活性的企业级应用。 | 数据密集的RAG系统 ,处理复杂、多样化的数据源,探索高级RAG策略。 |
| “魔法” vs “明确” | 早期版本“魔法”感较强(封装过深),LCEL使其变得非常明确。 | 非常明确 ,管道的每一步都清晰可见,几乎没有“魔法”。 | 高级API有“魔法”感(封装了复杂逻辑),但内部组件可定制。 |
- 选择 LangChain 如果…
- 你的核心需求是构建一个**智能代理 (Agent)**,它需要与各种外部工具(如Google搜索、WolframAlpha、公司内部API)进行交互。
- 你需要最大范围的集成,不想自己手写任何连接代码。
- 你构建的应用不局限于RAG,可能包含更复杂的逻辑和工具使用。
- 你不介意花更多时间学习,以换取最强大的通用性和灵活性。
- 选择 Haystack 如果…
- 你的目标是构建一个稳定、可维护、可用于生产环境的RAG系统。
- 你和你的团队非常看重代码的清晰度和流程的透明度。
- 在你的项目中,未来可能会需要轻松地替换底层的大模型或向量数据库。
- 选择 LlamaIndex 如果…
- 你的项目最大的挑战在于数据——数据源非常多样化(PDF、PPT、Notion、数据库等)。
- 你想快速搭建一个RAG原型,并对各种高级的、前沿的RAG算法进行实验和评估。
- 你追求的是RAG领域的深度和极致性能。
开源产品
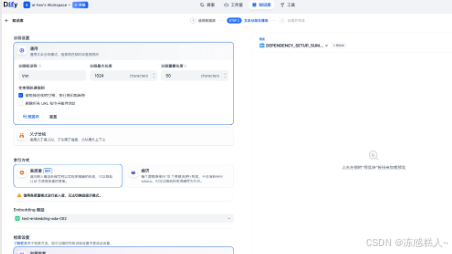
Dify: 一个功能极其强大且成熟的LLM应用开发平台,支持通过可视化编排快速构建包括RAG在内的各类AI应用。
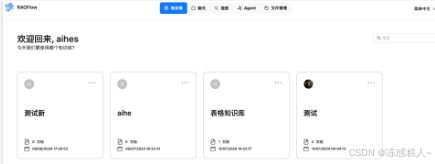
- RAGFlow by infiniflow:一个专注于深度文档理解的开源RAG引擎。擅长深度文档理解,使用基于模板的分块,与Infinity Database无缝集成,支持GraphRAG,并为可扩展性而设计 。
- AnythingLLM: 一个主打私有化和安全的桌面端/服务器端RAG解决方案,让您可以安全地与自己的文档聊天。
- MegaParse + quivr: 一个设计精美的开源RAG平台,旨在帮助用户存储和检索非结构化信息。
| 产品 | 核心定位 | 易用性(非技术人员) | 灵活性/定制性 | 最佳场景 |
|---|---|---|---|---|
| Dify.ai | 一站式LLM应用开发平台 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | 功能最全面的通用平台,适合大多数场景 |
| FastGPT | 生产级知识库问答 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | 对性能和可靠性要求高的企业级知识库 |
| AnythingLLM | 私有化、安全的文档问答 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | 严格数据隐私、团队内部或个人使用 |
| Quivr | 设计驱动的“第二大脑” | ⭐⭐⭐⭐ | ⭐⭐⭐ | 注重UI/UX,个人信息管理 |
| LlamaIndex/LangChain | 开发者框架 | ⭐⭐ | ⭐⭐⭐⭐⭐ | 需要深度定制和完全代码控制的开发者 |
- 如果您想快速体验和搭建一个功能完整的RAG应用,推荐从 Dify.ai 或 FastGPT 开始。它们都提供了非常平滑的上手体验和强大的功能。
- 如果您最关心的是数据安全和隐私,希望所有东西都跑在自己的电脑或服务器上,AnythingLLM 是最简单的选择。
- 如果您本身是开发者,希望构建一个高度定制化的产品,那么基于 LlamaIndex 或 LangChain 从代码层面开始会给予您最大的自由度。
商业产品
- TextIn 是合合信息旗下的品牌,专注于智能文字识别和文档处理领域长达16年。 它为全球用户提供一个智能文档处理云平台,核心产品围绕智能图像处理、文字表格识别以及文档内容的结构化提取,旨在显著提升企业业务处理的效率。
| 框架 | 核心定位 | 解决的问题 |
|---|---|---|
| PaddleOCR | 底层OCR引擎 | “看清”图片里的文字,特别是中英文。 |
| Unstructured.io | 中层解析框架 | “看懂”文档的段落、标题、表格等结构。 |
| Camelot | 专用工具 | “看懂”并抽取PDF里的复杂表格。 |
| LlamaIndex | 上层应用框架 | “串联”所有工具,连接数据与LLM,构建RAG应用。 |
- Jina AI:Jina AI 提供了一整套开源框架和云端服务,帮助开发者轻松构建和部署能够理解文本、图片、音频、视频等多种数据类型的复杂AI搜索和生成应用。
- 可以查看排行:https://huggingface.co/mteb
Milvus:是目前全球最流行、最领先的开源向量数据库
| 产品 | 核心定位 | 部署模式 | 最佳应用场景 |
|---|---|---|---|
| Milvus | 大规模、高性能 的开源向量数据库 | 开源,可自托管/云服务 | 千亿级向量、多模态搜索、对性能和扩展性要求高的生产环境 |
| Weaviate | AI原生 的开源向量数据库 | 开源,可自托管/云服务 | 需要内置向量化、混合搜索、图查询的场景 |
| Qdrant | 高性能、高效率 的开源向量数据库 | 开源,可自托管/云服务 | 对性能、内存占用和复杂过滤有极致要求的场景 |
| Pinecone | 完全托管 的商业向量数据库 | 商业SaaS | 追求极致易用性、免运维、快速上线的团队 |
| pg_vector | PostgreSQL的向量扩展 | 开源,自托管 | 业务数据与向量数据需要紧密结合的中小型应用 |
| Elasticsearch | 搜索引擎 的向量能力 | 开源,可自托管/云服务 | 以文本搜索为核心,用向量增强的复杂语义搜索 |
| Chroma | 轻量级嵌入式 向量数据库 | 开源,嵌入式/客户端-服务器 | 快速原型验证、教学、Jupyter Notebook、小型项目 |
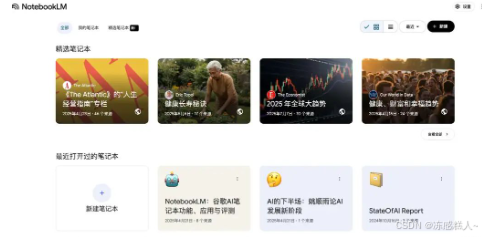
- NotebookLM: 是由 Google 开发的一款个人化AI研究和写作助手,它能将您提供的文档、笔记和网页等资料变成一个专属的知识库,并只根据这些资料来回答您的问题、生成摘要和启发新想法。
- RAG-as-a-Service:是一个非常热门且快速增长的领域。许多公司认识到,虽然RAG(检索增强生成)的理念很简单,但要搭建一个生产级别的、稳定、高效的RAG系统却非常复杂,涉及文档解析、分块、嵌入、向量存储、检索、重排(Rerank)、提示词工程等多个环节。因此,一系列产品应运而生,旨在将整个RAG流程打包成一个简单易用的服务。用户只需上传数据,就能获得一个可以进行对话或查询的API端点。
| 产品 | 类别 | 核心优势 | 最适合的场景 |
|---|---|---|---|
| Vectara | 专业RAG平台 | 端到端全托管,自研模型效果好,零配置 | 快速原型验证,追求高精度和低幻觉的中小企业 |
| Cohere | 专业RAG平台 | 顶级的Rerank模型,极大提升检索质量 | 对答案质量有极致要求,愿意优化RAG流程的开发者 |
| Amazon Bedrock | 大型云平台 | 与AWS生态无缝集成,安全合规 | AWS的现有企业客户 |
| Vertex AI Search | 大型云平台 | 谷歌搜索技术加持,多模态支持 | 需要处理网站、多模态数据,或信任谷歌技术的企业 |
… 等等各种基于上述RAG应用场景的变种,客服、知识问答、记忆。
七、总结
检索增强生成(RAG)已不仅仅是一项补充性技术,它更是将大模型从一个通用的“知识大脑”转变为能够解决特定领域问题的“专家系统”的核心桥梁。它通过“开卷考试”的模式,从根本上解决了LLM在知识时效性、领域深度和事实准确性上的固有缺陷,为AI在企业中的规模化落地铺平了最关键的一段路。
构建一个卓越的RAG系统,并非单一技术的突破,而是一场贯穿数据处理全流程的系统工程。加载、切分、索引、嵌入、召回等,其中的每一个环节都充满了性能、成本与效果之间的权衡,不存在一劳永逸的“银弹”,只有最适合特定场景的最佳实践。
另外要认识到,没有度量,就没有优化。以RAGAS为代表的评估框架,使我们能够量化地评估RAG系统在忠实度、相关性和准确性上的表现。这是区分一个Demo与一个Production-ready产品的关键所在。
当前RAG的生态系统已经百花齐放,为开发者提供了从底层框架(如LlamaIndex, LangChain)到开箱即用的开源产品(如Dify, RAGFlow),再到全托管的商业服务(RAG-as-a-Service)的丰富选择。这意味着无论技术背景如何,无论是个人开发者还是大型企业,都能找到适合自己的切入点,参与到这场游戏中。
最后,RAG还在继续发展,它正与Agent深度融合,向多模态领域延伸,并逐渐成为更复杂AI系统中不可或缺的记忆与推理基石。掌握RAG,不仅是掌握一项技术,更是掌握了在AI时代将信息转化为价值的关键钥匙。
八、如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


九、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


十、大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

2、大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

适用人群

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 717


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


