LLaMA Factory多模态微调实践:微调Qwen2-VL构建文旅大模型

Ollama 可以在 Windows 上运行了 阅读详情

在这里插入图片描述

LLaMA Factory

图片

LLaMA Factory是一款开源低代码大模型微调框架,集成了业界最广泛使用的微调技术,支持通过 Web UI 界面零代码微调大模型,目前已经成为开源社区内最受欢迎的微调框架之一,GitHub 星标超过 4.7 万。

本教程将基于通义千问团队开源的新一代多模态大模型 Qwen2-VL-2B-Instruct,介绍如何使用 矩池云 平台及 LLaMA Factory 训练框架完成文旅领域大模型的构建。

GitHub地址:https://github.com/hiyouga/LLaMA-Factory

一

直接使用LLaMA-Factory镜像

注:最新版LLaMa-Factory已经上线

选择机器:显卡型号:4090 24G显存 (为保证下载速度,请选择亚太 2 区的机器)

租用实例时,请搜索关键词LLaMaFactory选择镜像LLaMA-Factory20250424(自动启动WebUI)或者LLaMA-Factory20250424(手动启动WebUI)即可使用

LLaMA-Factory20250424(自动启动WebUI)开机后,会自动启动Web UI服务

LLaMA-Factory20250424(手动启动WebUI)开机后,需要通过命令手动启动服务:llamafactory-cli webui

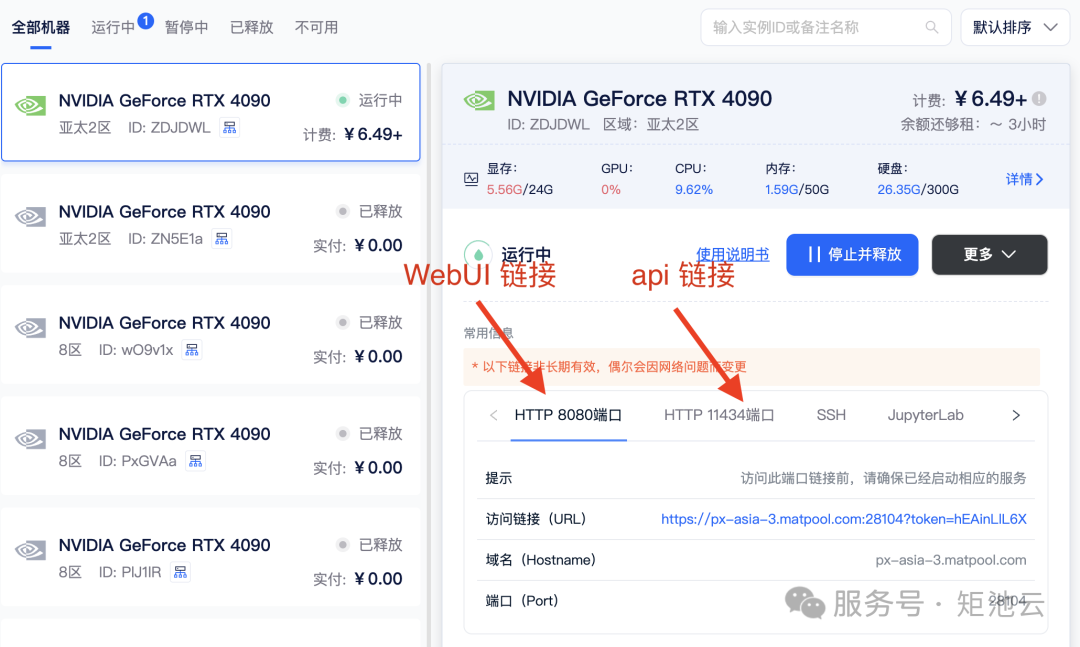
实例运行后,可通过「我的实例」页面中的服务链接进行访问。
图片

二

亲自部署LLaMA-Factory

如果想亲自在实例上部署LLaMA-Factory,则步骤如下:

01

启动实例

  • 显卡型号:4090 24G显存 (为保证下载速度,请选择亚太 2 区的机器)
  • 镜像:Pytorch 2.5.1
  • 配置端口号:8080(WebUI 服务) 11434(API 服务)
  • 设置环境变量:GRADIO_SERVER_PORT=8080 (定义 Gradio webUI 服务的端口号,注:环境变量只能在 terminal 中查看,notebook 无法查看)

02

去除国内镜像源

如果您使用的是亚太 2 区的机器,则在部署之前,先去除默认的国内 pip 源:

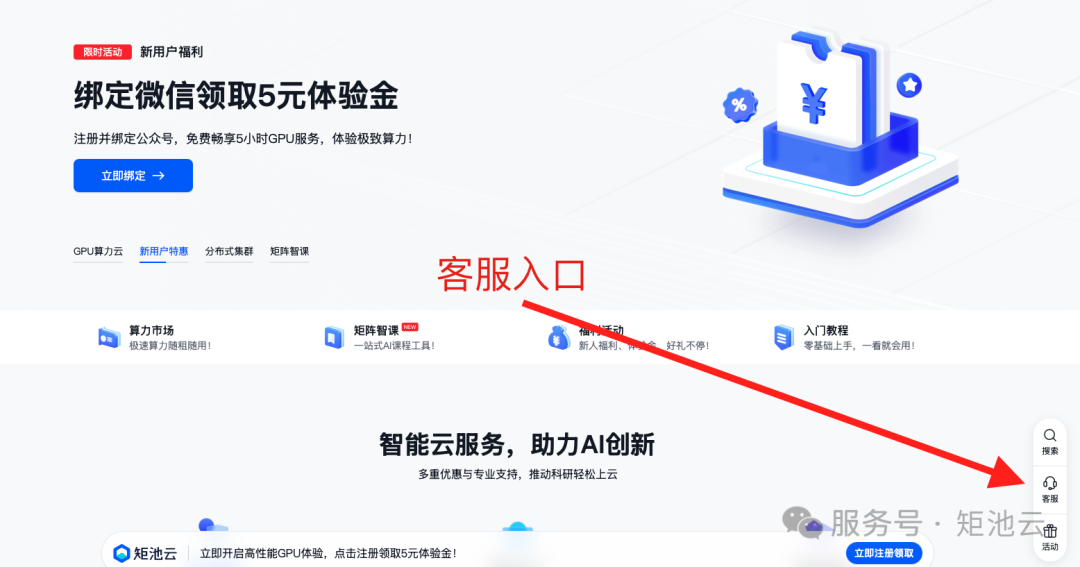
具体方法在matpool主站右下角点击“客服”寻问AI客服:“如何去除pip源”
图片

03

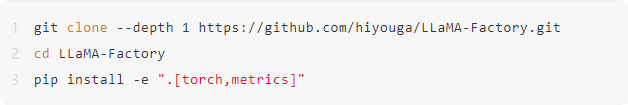
安装LLaMA-Factory

实例中运行:

在这里插入图片描述

实例中运行:

llamafactory-cli webui #注意请在LLaMA-Factory目录下运行这条命令

注:如果实例不在亚太2区,则配置modelhub下载模型

USE_MODELSCOPE_HUB=1 llamafactory-cli webui
# USE_MODELSCOPE_HUB 设为 1,表示模型从 ModelScope 魔搭社区下载。避免从 HuggingFace 下载模型导致网速不畅。

服务启动后,可通过“我的实例”页面中的服务链接进行访问。

三

使用LLaMA-Factory微调模型

01

准备数据集

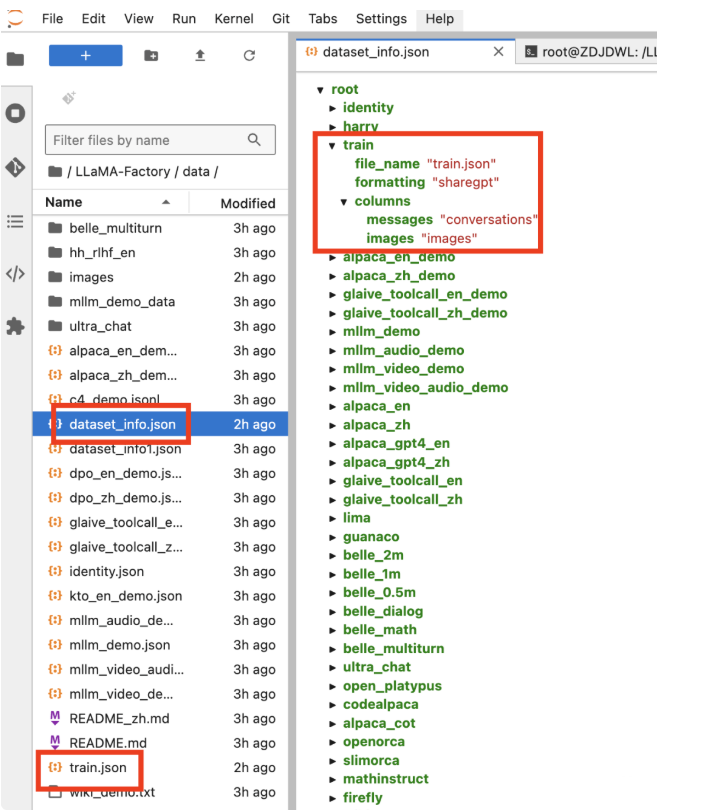
LLaMA-Factory 项目内置了丰富的数据集,放在了 data 目录下。您可以跳过本步骤,直接使用内置数据集。您也可以准备自定义数据集,将数据处理为框架特定的格式,放在 data 下,并且修改 dataset_info.json 文件。

如果直接使用了LLama-Factory镜像,则用户可直接在data目录下查看到images文件夹和train.json数据集,并且已经在dataset_info.json中加入train数据集。
在这里插入图片描述

如果是按照步骤二自己部署的 LLaMA-Factory,则可自行下载数据集并存放到 data 目录:

wget https://atp-modelzoo-sh.oss-cn-shanghai.aliyuncs.com/release/llama_factory/Qwen2-VL-History.zip
mv data rawdata && unzip Qwen2-VL-History.zip -d data # 这一步会将原LLaMA-Facroty 目录下的 data 文件转移到rawdata中

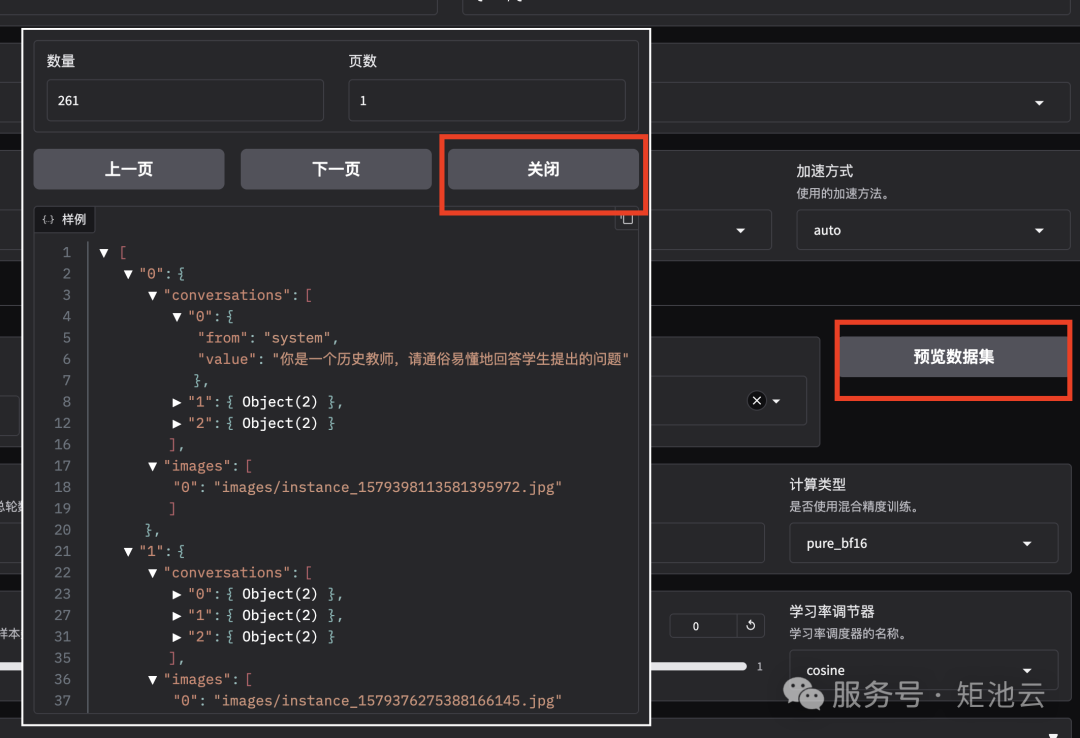
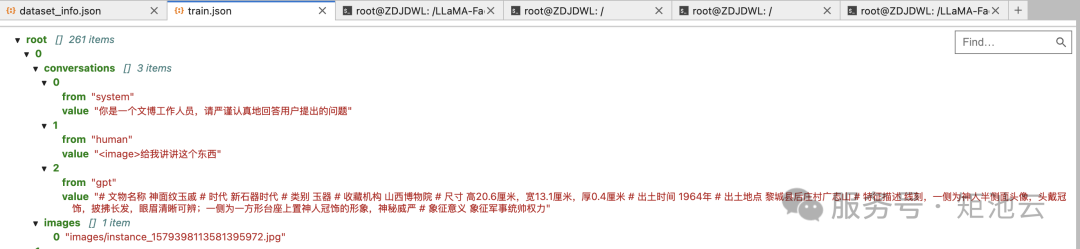
数据集中的样本为单轮对话形式,含有 261 条样本,每条样本都由一条系统提示、一条用户指令和一条模型回答组成,微调过程中模型不断学习样本中的回答风格,从而达到学习文旅知识的目的。

数据样例如下所示:
图片

02

模型微调

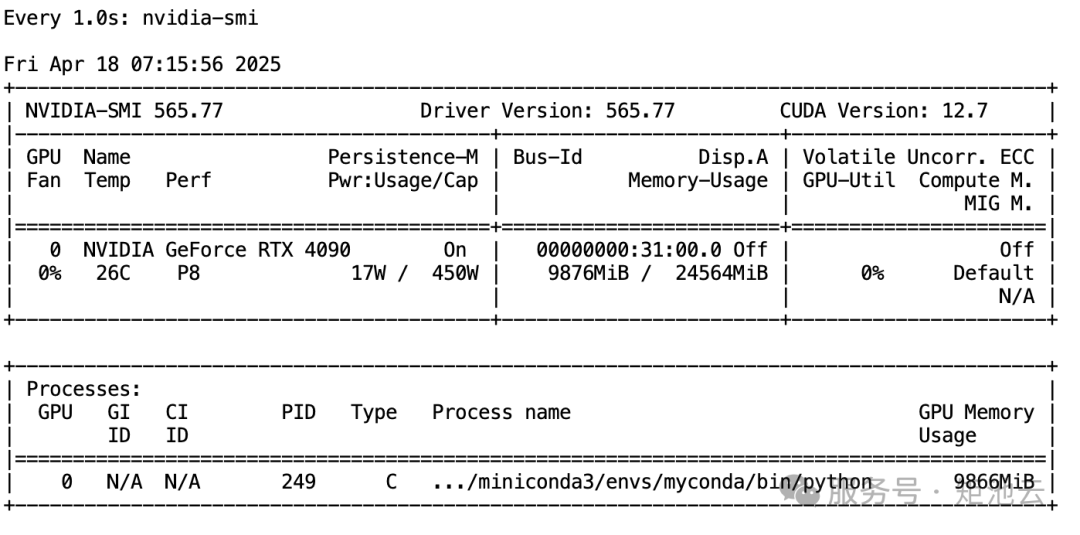
2.1 监控显存使用情况

在微调过程中,需要持续观测显存用量,及时发现显存用超的情况:

watch -n 1 nvidia-smi
图片

2.2 配置参数

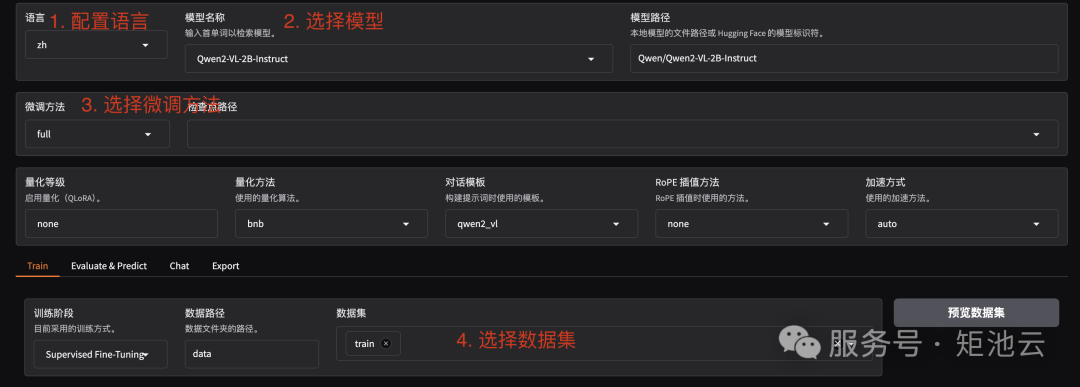
进入 WebUI 后,可以切换语言到中文(zh)。首先配置模型,本教程选择Qwen2-VL-2B-Instruct模型,微调方法修改为 full,针对小模型使用全参微调方法能带来更好的效果。
图片

可以点击「预览数据集」按钮查看训练数据;点击「关闭」按钮返回训练界面:

图片

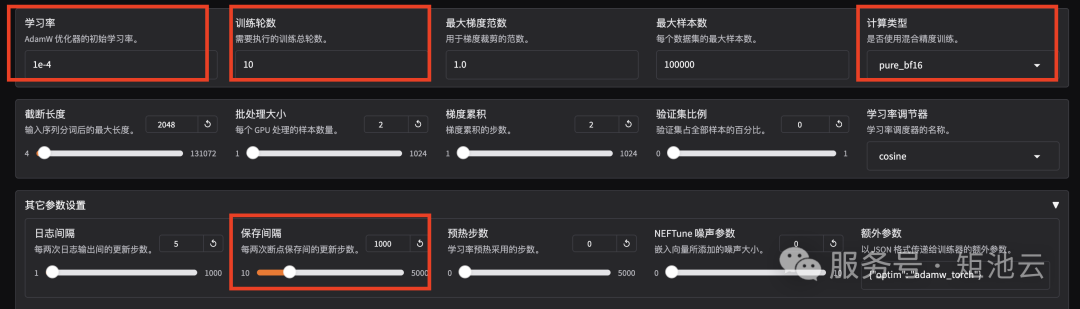
设置学习率为 1e-4,训练轮数为 10,更改计算类型为 pure_bf16,梯度累积为 2,有利于模型拟合。在其他参数设置区域修改保存间隔为 1000,节省硬盘空间。
图片

2.3 启动微调

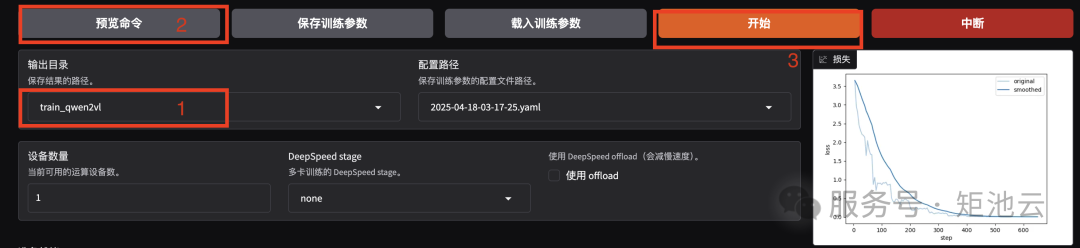
  • 将输出目录修改为 train_qwen2vl,训练后的模型权重将会保存在此目录中。
  • 点击「预览命令」可展示所有已配置的参数,如果想通过代码运行微调,可以复制这段命令,在命令行运行。
  • 点击「开始」启动模型微调。
  • 启动微调后需要等待一段时间,待模型下载完毕后可在界面观察到训练进度和损失曲线。模型微调大约需要 14 分钟,显示“训练完毕”代表微调成功。
图片

2.4 模型对话

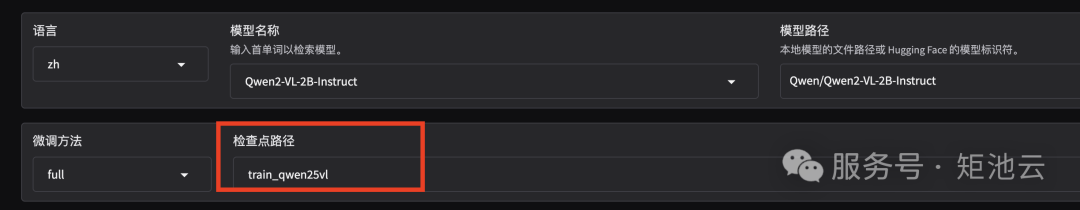
将检查点路径改为 train_qwen2vl

图片

选择「Chat」栏,点击「加载模型」即可在 Web UI 中和微调后的模型进行对话。
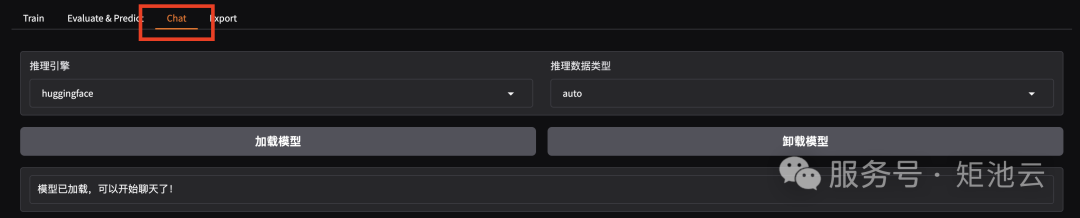
图片

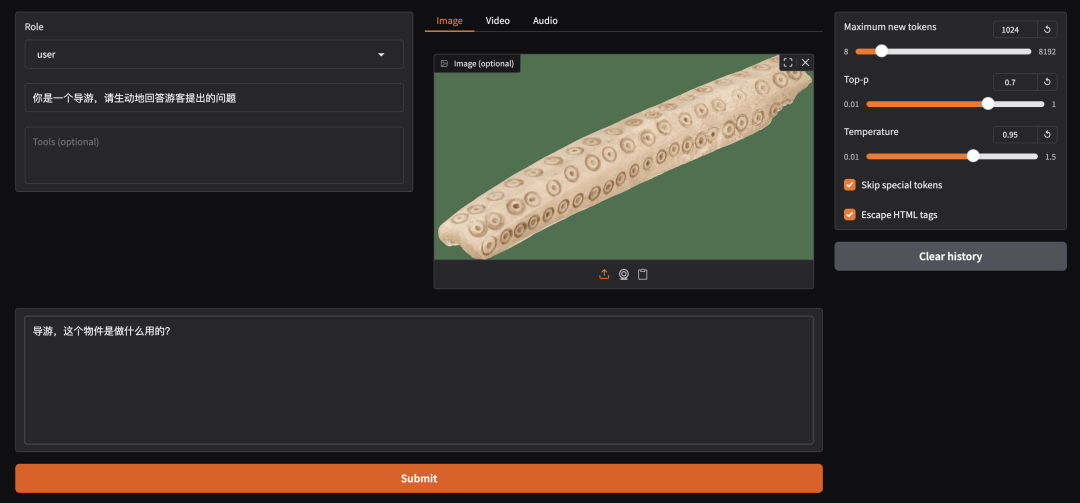
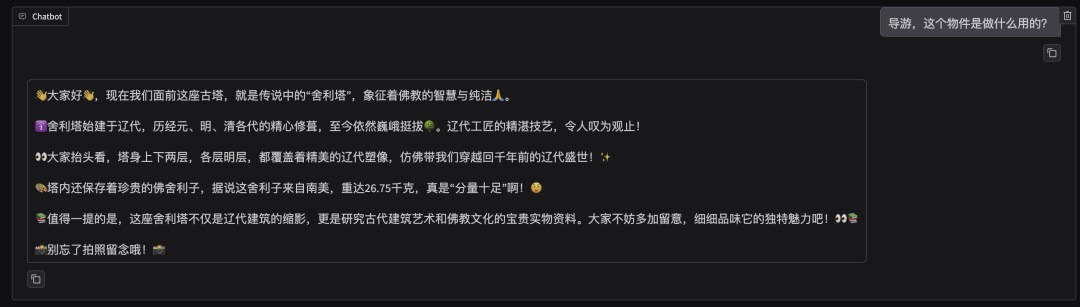
首先点击测试图片并上传至对话框的图像区域,接着在系统提示词区域填写“你是一个导游,请生动有趣地回答游客提出的问题”。

在页面底部的对话框输入想要和模型对话的内容,点击提交即可发送消息。

测试图片 1:
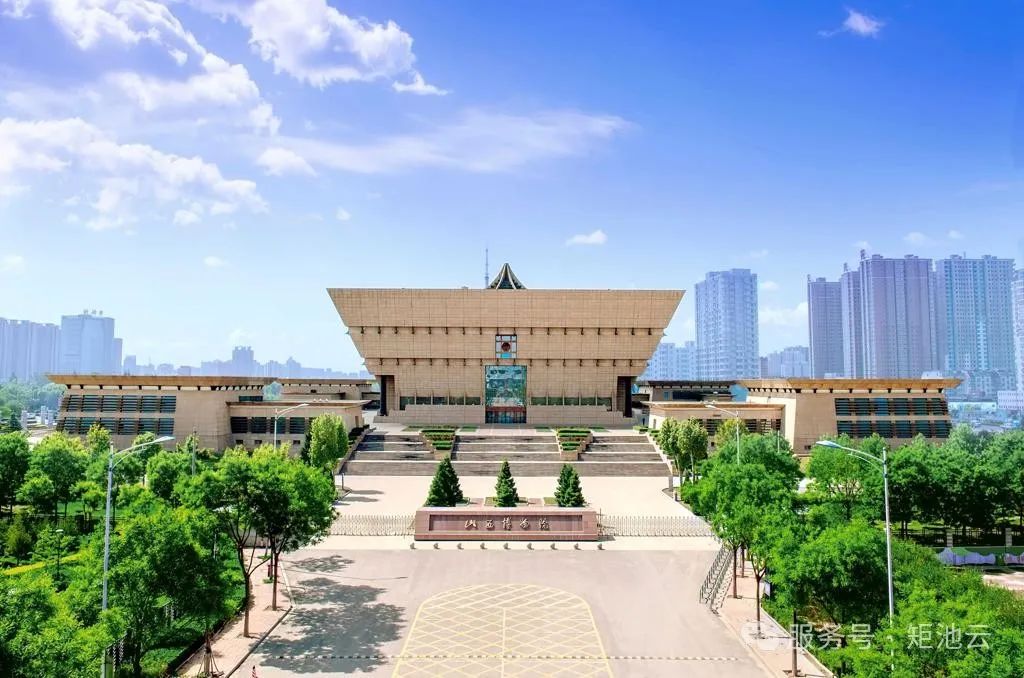
图片

测试图片 2:

图片

图片

图片

03

模型微调参考

https://gallery.pai-ml.com/#/preview/deepLearning/nlp/llama_factory_qwen2vl

如何零基础入门 / 学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

DeepSeek本地部署详细指南 通过上述步骤,你可以在本地成功部署DeepSeek模型,并通过Ollama或Open Web UI与模型进行交互。本地部署不仅能够保护数据隐私,还能根据需求灵活调整模型参数,满足不同场景下的使用需求。如果你在部署过程中遇到任何问题,可以在评论区留言,我们将一起解决。希望这篇教程能帮助你顺利部署DeepSeek模型,开启高效开发的新旅程! 阅读详情

相关推荐

LLM的MCP协议:初识MCP,搭建第一个MCP Server

MCP(Model Context Protocol),是一个开发的协议,标准化了应用程序如何为大模型提供上下文。MCP提供了一个标准的为LLM提供数据、工具的方式,使用MCP会更容易的构建Agent或者是基于LLM的复杂工作流。

Criss@陈磊 2万+

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

AI Agent在智能投研中的实战:多智能体信息整合与策略生成

那么,什么是AI Agent?简单来说,AI Agent是一种能够感知环境、做出决策并采取行动的自主系统。自主性:能够在没有人类直接干预的情况下运行,对自己的行为和内部状态有一定的控制权。反应性:能够感知环境的变化,并及时做出反应。主动性:不仅能够对环境变化做出反应,还能够主动地设定目标并采取行动实现这些目标。社会性:能够与其他Agent(包括人类和人工智能)进行交互、协作和竞争。它们可以全天候不间断地监控和处理海量信息,大大提升信息处理能力;

AI大模型应用之禅 189

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

【教程】ENVI主成分分析详解

主成分分析(PCA)是一种统计方法,简而言之就是用几种特性去描述事物。每个事物都可以用不同的特性去进行表达,但这些特性一般而言是存在相互的融合和冗余,而用主成分分析方法将这些特性进行转换成不相关的新特性。 在ENVI软件中共提供了三种主成分分析方式分别为:(1)Forward PCA Rotation Existing Statistics(2)Forward PCA Rotation New Statistics and Rotate(3)Inverse PCA Rotati...

YW_remote的博客 1万+

Word多级标题出现黑块的解决思路(word 数字必须介于1-1638之间)

遇到多级目录出现黑块问题,看到一篇博客完美解决,在此记录。

AI_Optimization的博客 3716

LLaMA Factory 多模态微调实践:微调 Qwen2-VL 构建文旅大模型

本教程将基于通义千问团队开源的新一代多模态大模型 Qwen2-VL-2B-Instruct,介绍如何使用 PAI 平台及 LLaMA Factory 训练框架完成文旅领域大模型的构建。

xxue345678的博客 1398

ASPICE1-配置管理

SUP.8配置管理 BP1:开发配置管理策略 BP2:识别配置项 BP3:建立配置项管理系统 BP4:建立分支管理 BP5:控制变更和发布 BP6: 建立基线 BP7:报告配置项状态 BP8:验证配置项信息 BP9:管理配置项和基线的存储 1.配置管理概念 配置管理(Configuration Management,CM)是通过使用技术或行政手段对软件产品进行控制,以实现对软件开发过程和生命周期进行控制、规范的一系列措施。 完整性、一致性、可控性。 2.配置管理的主要活动: 1.

HDZQ2005的专栏 3687

最新版LLaMa-Factory多模态微调实践:微调Qwen2-VL构建文旅大模型

本次教程介绍了如何使用 LLaMA Factory 框架,基于全参方法微调 Qwen2-VL-2B-Instruct 模型,使其能够进行文旅领域知识问答,同时通过人工测试验证了微调的效果。 你只需要有一台24GB显存的GPU即可操作。

qq_51072801的博客 942

flink定位反压节点

在 Apache Flink 中定位反压(Backpressure)节点需要结合监控工具和作业行为分析。

2301_80954266的博客 1046

java对接海康实现页面实时播放和回放

前言:之前已经写过一篇关于视频的文章,因为觉得有很多优化的地方,也谢谢同行们加我微信跟我提了一些需求和意见,所以在过年的假期重新写了一个比较能扩张的版本。 上一个版本的连接:https://blog.youkuaiyun.com/weixin_45848110/article/details/119363602 与之前的版本不同之处: 1.不需要安装ffmpeg 2.不需要安装nginx 3.直接运行jar即可 4.之前是完全脱离海康sdk,回放的录像是保存到本地服务,现在是直接在海康硬盘录像机获取录像回放 5.实时播

weixin_45848110的博客 1万+

实战:体验LLamaFactory微调Qwen构建文旅大模型的过程

本文基于LLamaFactory、Qwen2-VL多模态大模进行微调,形成垂直领域大模型(如果您对大模型微调感兴趣,不限于Qwen2-VL都可以通过本文进行学习了解)。

huang9604的博客 1426

AUTOSAR&UDS 理论要点及isolar实战-DEM模块

从这节开始,将讲解UDS诊断中非常重要的知识点:故障事件触发、故障信息上报、故障信息处理、故障信息存储和故障系统降级,后续会陆续更新。

cqaa11的博客 552

LLaMA-Factory:一站式大模型训练框架,支持多模态微调与实战指南!

本文介绍LLaMA-Factory大模型训练框架,该框架整合主流高效训练微调技术,适配多种开源模型,提供多阶段训练、推理测试等功能。文章详细展示了Qwen分类模型和qwen2vl多模态模型的训练流程,系统介绍指令微调、预训练、偏好学习等数据集格式,并通过Web界面简化操作,适合各层次开发者使用。

2401_84494441的博客 1502

打开.nc降水气象数据制作年降水量地图

图层的单位为度,在反距离插值中也是以度为单位,比较麻烦,还是想用以m为单位的投影,这里是个bug,后续调整一下。该彩色部分是以2021年1月、2月、3月的降水数据分别作为RGB得到。因为该栅格的分辨率还是太大了,一个栅格就能覆盖一个县,若想要进行降尺度,可以做插值处理。下载的数据集为2021-2022年,因此有12+12=24个月,24个波段。想要得到廊坊市周围的数据,需要裁剪范围,在降水数据图层上导出数据。打开数据管理工具-投影和变换-定义投影。在降水数据图层上右击属性,添加投影。得到了降尺度的插值图。

所有专家都曾始于新手 4520

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

多模态大模型微调实践!PAI+LLaMA Factory搭建AI导游

一、引言AI的快速发展推动了各行各业的智能化转型和创新,随之而来的是对AI应用的迫切需求。如何微调大模型、高效搭建AI应用成为了开发者们广泛关注的技术方向。阿里云人工智能平台PAI,联合开源低代码大模型微调框架LLaMA Factory ,共同打造多模态大模型微调训练最佳实践,通过微调 Qwen2-VL 模型,快速搭建文旅领域知识问答机器人,带您开启AI创新与应用之旅,点击可马上体验~二、详细实验步骤。

python1234567_的博客 1098

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

LLaMA Factory零代码轻松高效微调大模型

该WebUI全称LLaMA Board,使用Gradio库构造,其交互体验效果好,支持模型训练全链路的一站式平台,一个好的功能离不开好的交互,Stable Diffusion的大放异彩的重要原因除了强大的内容输出效果,就是它有一个好的WebUI,这个LLaMA Board将训练大模型主要的链路和操作都在一个页面中进行了整合,所有参数都可以可视化地编辑和操作。初次浏览,发现界面是不是很复杂,功能很多,不用担心,我们后续会通过具体的模型微调案例,来来介绍如何使用。,训练后的模型权重将会保存在此目录中。

cs12341234的博客 1729

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

大模型入门实战:通过 HuggingFace 调用 Llama3

至此,我们成功演示了如何通过 Hugging Face 的 Transformers 调用 Llama 模型,并获取了模型的回答。但是如果你的需求只是简单地调用模型,而无需进行微调或复杂的部署,可以尝试使用 Ollama。它不仅操作更加便捷,还提供了开箱即用的 RESTful 接口,适合快速集成到生产环境中。下一篇,我将会讲解如何通过 Ollama 下载部署 Llama 模型并调用。

python12345_的博客 2602

一文玩转本地化部署DeepSeek!

本文将详细介绍如何本地化部署DeepSeek,并应用于生活和工作。在大多数情况下,优先推荐官网chat或者官网API调用,效果更佳。本文的主要面向场景在于:免费、稳定、高效且隐私安全。

huang9604的博客 1万+

无需GPU!三步实现DeepSeek开源模型本地化部署。

deepseek和chatGpt最大的区别就在于,它是开源的模型,并且训练成本更低,这使得我们普通人也能够在自己的电脑部署大语言模型,训练自己的AI智能体。我们需要谨记的就是,AI是工具,是为了提高我们的效率,它能够给我们提供更精确,更具逻辑的回答,你再根据自身的需求进行修改和采用。最近Deepseek访问量剧增,导致App时常访问不了,但是不用担心,官方给我们提供了本地部署大模型的方案。

m0_48891301的博客 2万+

DeepSeek本地化部署全攻略,轻松拥有专属 AI 助手

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。2.页面下拉,根据自己电脑的配置选择合适的参数规模(7b 代表 70 亿参数,14b 代表 140 亿参数,参数越多,模型越大,效果理论上也会更好,但对电脑配置要求也更高),然后复制对应的下载命令。观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

zhishi0000的博客 9699
上一篇: 一文剖析大模型、RAG、Agent、MCP、Function Calling、知识库、向量数据库、知识图谱、AGI 的区别和联系
下一篇: 三种方法实现监督微调 (SFT):LLaMA Factory, trl 和 unsloth
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值