


一、私有化智能体应用
在本专栏的前面文章基于Spring AI MCP实现了本地 ChatBI 问答应用,本文还是依据该场景,采用 LangChain + vLLM + Qwen3-32B + MCP 技术栈构建该流程,整体过程如下图所示:

实现效果如下所示:

实验所使用依赖的版本如下:
torch==2.6.0
transformers==4.51.3
modelscope==1.23.1
vllm==0.8.4
mcp==1.9.2
openai==1.75.0
langchain==0.3.25
langchain-openai==0.3.18
langgraph==0.4.7
pymysql==1.0.3
二、vLLM 部署 Qwen3-32B
使用 modelscope 下载 Qwen3-32B 模型到本地:
modelscope download --model="Qwen/Qwen3-32B" --local_dir Qwen3-32B
vLLM 读取模型启动API服务。
export CUDA_VISIBLE_DEVICES=0,1

vllm serve "Qwen3-32B" \
  --host 0.0.0.0 \
  --port 8060 \
  --dtype bfloat16 \
  --tensor-parallel-size 2 \
  --cpu-offload-gb 0 \
  --gpu-memory-utilization 0.8 \
  --max-model-len 8126 \
  --api-key token-abc123 \
  --enable-prefix-caching \
  --enable-reasoning \
  --reasoning-parser deepseek_r1\
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --trust-remote-code
关键参数说明:
- •
export CUDA_VISIBLE_DEVICES=0,1:指定所使用的GPU。 - •
dtype: 数据类型,其中bfloat16,16位浮点数,适合NVIDIA A100等设备。 - •
tensor-parallel-size:Tensor并行的数量,当多GPU分布式推理时使用,建议和GPU的数量一致。 - •
cpu-offload-gb:允许将部分模型权重或中间结果卸载到CPU的内存中,单位为GB。,模拟GPU内存扩展,如果部署的模型大于了显存大小可以设置该参数,但是推理速度会大大下降。 - •
gpu-memory-utilization:设置GPU内存利用率的上限。 - •
max-model-len:允许模型最大处理的Token数,该参数越大占用显存越大。 - •
enable-prefix-caching:启用前缀缓存减少重复计算。 - •
enable-reasoning:启用思考推理能力。 - •
reasoning-parser deepseek_r1:指定推理解析器。 - •
enable-auto-tool-choice:启用 function call 模式。 - •
tool-call-parser hermes:设置 function call 的解析器。

显存占用情况:

如果启动显存不足,可适当调整 gpu-memory-utilization 和 max-model-len 参数,或通过 cpu-offload-gb 将部分模型权重卸载到内存中。
启动成功后,可通过 /v1/models 接口可查看模型列表:
curl http://127.0.0.1:8060/v1/models -H "Authorization: Bearer token-abc123"

测试API交互,思考模式:
curl http://127.0.0.1:8060/v1/chat/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer token-abc123" \
    -d '{
        "model": "Qwen3-32B",
        "messages": [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "你是谁"}
        ]
    }'
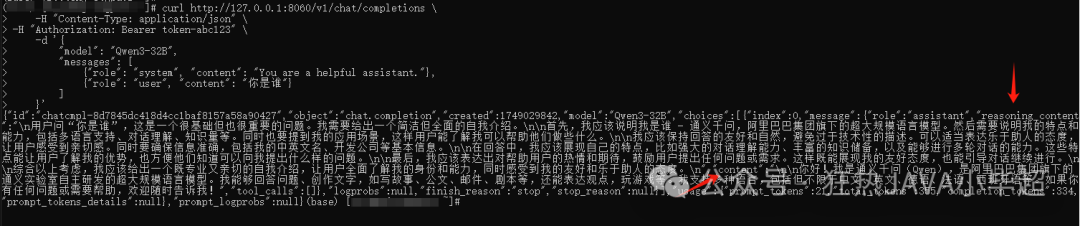
非思考模式测试:
curl http://127.0.0.1:8060/v1/chat/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer token-abc123" \
    -d '{
        "model": "Qwen3-32B",
        "messages": [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "你是谁/no_think"}
        ]
    }'

三、构建DB MCP Server
在 MCP Server 端,依据上面图片的规划,包括三个 MCP Tool ,分别是 获取所有可用的表名:get_all_tables、根据表名获取:Schema get_table_schema、执行SQL:run_sql ,交互协议选择 SSE 模式。
首先实现数据库操作,这里仅仅做了数据库的交互,实际使用你应考虑很多性能细节的优化:
utils_db.py
import pymysql

defget_conn():
    return pymysql.connect(
        host="127.0.0.1",
        port=3306,
        database="langchain",
        user="root",
        password="root",
        autocommit=True
    )

defquery(sql):
    conn = get_conn()
    cursor = conn.cursor()
    cursor.execute(sql)
    columns = [column[0] for column in cursor.description]
    res = list()
    for row in cursor.fetchall():
        res.append(dict(zip(columns, row)))
    cursor.close()
    conn.close()
    return res
db_mcp_server.py
import json

from mcp.server.fastmcp import FastMCP
import utils_db

mcp = FastMCP("DB Mcp Server")
all_tables_sql = "SELECT TABLE_NAME, TABLE_COMMENT FROM INFORMATION_SCHEMA.TABLES WHERE TABLE_SCHEMA = 'langchain'"
schema_sql = """
SELECT COLUMN_NAME, DATA_TYPE, COLUMN_COMMENT FROM INFORMATION_SCHEMA.COLUMNS
WHERE TABLE_SCHEMA = 'langchain' AND TABLE_NAME = '{table}'
"""


@mcp.tool()
defget_all_tables() -> str:
    """获取所有可用的表名"""
    return json.dumps(utils_db.query(all_tables_sql), ensure_ascii=False)


@mcp.tool()
defget_table_schema(table_names: list[str]) -> str:
    """根据表名获取Schema"""
    table_schema = []
    for table in table_names:
        schemas = utils_db.query(schema_sql.format(table=table))
        schemas = ", \n".join([f"{s['COLUMN_NAME']} {s['DATA_TYPE']} COMMENT {s['COLUMN_COMMENT']}"for s in schemas])
        table_schema.append(f"{table} ({schemas})")
    return"\n\n".join(table_schema)


@mcp.tool()
defrun_sql(sql: str) -> str:
    """执行SQL查询数据,一次仅能执行一句SQL!"""
    try:
        return json.dumps(utils_db.query(sql), ensure_ascii=False)
    except Exception as e:
        returnf"执行SQL错误:{str(e)} ,请修正后重新发起。"


if __name__ == "__main__":
    mcp.settings.port = 6030
    mcp.run("sse")
启动 MCP Server 服务:

四、Langchain 构建 MCP Client Agent 智能体
官方关于 MCP 的集成介绍文档:
https://langchain-ai.github.io/langgraph/agents/mcp/
实现过程:
import os, config

os.environ["OPENAI_BASE_URL"] = "http://127.0.0.1:8060/v1"
os.environ["OPENAI_API_KEY"] = "token-abc123"
from langchain_mcp_adapters.client import MultiServerMCPClient
from langgraph.prebuilt import create_react_agent
from langgraph.checkpoint.memory import InMemorySaver
import asyncio
from colorama import Fore, Style, init

asyncdefmain():
    client = MultiServerMCPClient(
        {
            "db": {
                "url": "http://127.0.0.1:6030/sse",
                "transport": "sse",
            }
        }
    )
    tools = await client.get_tools()
    checkpointer = InMemorySaver()
    agent = create_react_agent(
        "openai:Qwen3-32B",
        tools,
        checkpointer=checkpointer
    )
    config = {
        "configurable": {
            "thread_id": "1"
        }
    }
    whileTrue:
        question = input("请输入问题:")
        ifnot question:
            continue
        if question == "q":
            break
        asyncfor chunk in agent.astream(
                {
                    "messages": [
                        {
                            "role": "user",
                            "content": question
                        }
                    ]
                },
                config=config,
                stream_mode="updates"
        ):
            if"agent"in chunk:
                content = chunk["agent"]["messages"][0].content
                tool_calls = chunk["agent"]["messages"][0].tool_calls
                if tool_calls:
                    for tool in tool_calls:
                        print(Fore.YELLOW, Style.BRIGHT, f">>> Call MCP Server: {tool['name']} , args: {tool['args']}")
                else:
                    print(Fore.BLACK, Style.BRIGHT, f"LLM: {content}")
            elif"tools"in chunk:
                content = chunk["tools"]["messages"][0].content
                name = chunk["tools"]["messages"][0].name
                print(Fore.GREEN, Style.BRIGHT, f"<<< {name} : {content}")


if __name__ == '__main__':
    asyncio.run(main())
运行智能体,开始测试。
四、智能体问答测试
提问:当前的用户数,以及工作组清单

提问:工作组 A 下的人,都有哪些角色
可以看到执行过程,当发现错误后,能够及时的纠正,进而得到正确的结果:

提问:role1 下的有哪些人

如何零基础入门 / 学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 468


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


