24个Transformer模型高效魔改变体盘点,无bug拿来即用!

transformer的各种变体 https://mp.weixin.qq.com/s/iuuRS_M3cYm0DXFkZGjjBg 1 Transformer-XL 论文标题: Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context 收录会议: ACL 2019 论文链接: https://arxiv.org/abs/1901.02860 代码链接: https://github.com/kimiyoung/transformer-xl 上. 阅读详情

目前我们对Transformer模型的研究已经很全面了,关于它的复现成果也非常多,但都比较零散,不成系统,而且缺乏对Transformer改进变体的详细梳理,这对我们改模型写代码很不友好。

所以我今天特地帮大家整理了Transformer各组件的魔改方法以及创新思路,每种方法的来源论文以及复现代码都放上了,代码超级简洁,相信能给同学们提供不少灵感。

篇幅原因,论文和代码只做简单介绍,就不详细展示了,需要的同学看文末

精确注意力

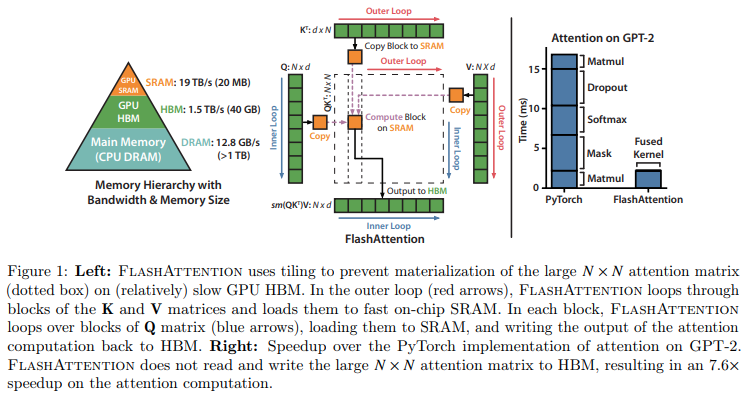
论文:FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness

「简介:」 FlashAttention是一种新的算法,它使得Transformer模型(一种广泛用于自然语言处理的深度学习模型)在处理长文本序列时能够更快且更节省内存。这个算法通过优化GPU内存的使用来减少内存读写次数,从而提高了计算效率。实验结果表明,使用FlashAttention训练的模型不仅训练速度更快,而且能够处理更长的文本序列,提高了模型的性能和能力。
通过持久内存增强自注意力机制

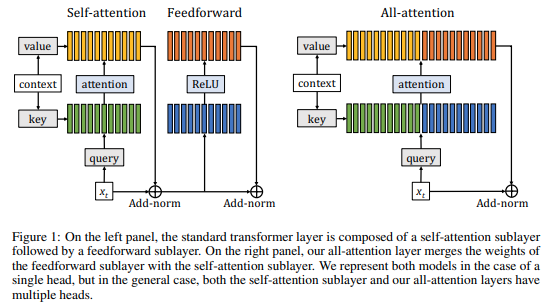
论文:Augmenting Self-attention with Persistent Memory

「简介:」 论文介绍了一种新的模型,它仅由注意力层组成,用于增强自注意力机制。传统的Transformer网络包含两个连续的模块:前馈层和自注意力层。自注意力层允许网络捕捉长期依赖关系,通常被认为是Transformer成功的关键因素。基于这一直觉,作者提出了一种新模型,该模型通过增加持久内存向量来增强自注意力层,这些向量在前馈层中起到了类似的作用。由于有了这些向量,可以在不降低Transformer性能的情况下去除前馈层。评估结果显示,该模型在标准的字符级和单词级语言建模基准测试中带来了好处。
记忆transformer

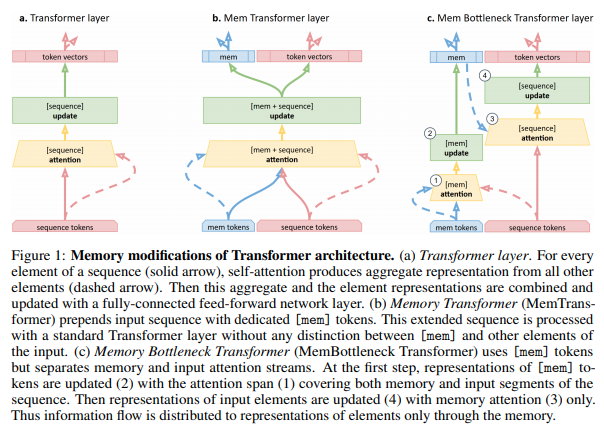
论文:Memory Transformer

「简介:」 作者描述了一种名为Memory Transformer的模型,它通过增加可训练的记忆组件来改进传统的Transformer模型。这种记忆增强的神经网络(MANNs)能够学习简单的算法,如复制或反转,并且可以通过反向传播成功地训练在从问答到语言建模的多样化任务上,其性能超越了复杂度相当的RNN和LSTM。在这个工作中,作者提出了对Transformer基线的几种扩展:(1)增加记忆标记来存储非局部表示;(2)为全局信息创建记忆瓶颈;(3)用专门的层控制记忆更新。
改善自注意力的规范化

论文:Transformers without Tears: Improving the Normalization of Self-Attention

「简介:」 论文介绍了三种改进Transformer模型训练的方法。第一种是使用预规范化残差连接,可以不用预热直接用大学习率训练。第二种是用一个参数进行ℓ2规范化,这样可以训练得更快,效果也更好。第三种是固定词嵌入的长度,这也有助于提高性能。这些改进在小资源语言对上的实验表明,它们能够提高模型的收敛速度和翻译质量。但在大资源语言对上,预规范化可能会降低性能。

均方根层归一化

论文:Root Mean Square Layer Normalization

「简介:」 RMSNorm是一种新的层归一化方法,它通过计算输入的根均方值来进行归一化。这种方法与传统的LayerNorm相比,具有更简单的计算过程,因此更高效。RMSNorm能够提供与LayerNorm相当的性能,同时减少模型的运行时间。实验表明,在多个任务和网络架构上,RMSNorm的性能与LayerNorm相当,但运行时间减少了7%~64%。

GLU变体改进Transformer

论文:GLU Variants Improve Transformer

「简介:」 论文介绍了门控线性单元(GLU)的变体,它们通过使用不同的非线性(甚至是线性)函数来替代传统的sigmoid函数。作者在Transformer模型的前馈子层中测试了这些GLU变体,并发现其中一些变体比通常使用的ReLU或GELU激活函数能够提升模型的质量。

ReLU²

论文:Primer: Searching for Efficient Transformers for Language Modeling

「简介:」 本文介绍了一种更高效的变压器模型——Primer,它通过在自注意力机制中进行简单的修改来减少训练成本。实验显示,Primer能够在不同计算规模下提升性能,并且在大规模参数配置下显著降低训练成本。例如,Primer在5亿参数的T5架构上将训练成本降低了4倍。此外,Primer能够在不同的代码库中使用,无需额外调整就能加速训练。

显式稀疏Transformer

论文:Explicit Sparse Transformer: Concentrated Attention Through Explicit Selection

「简介:」 论文提出了一种名为显式稀疏 Transformer(Explicit Sparse Transformer)的新模型,旨在解决自注意力机制在提取上下文中不相关信息时可能遇到的问题。通过显式选择最相关的片段,该模型能够提高对全局上下文的注意力集中度。在一系列自然语言处理和计算机视觉任务上的实验结果表明,显式稀疏 Transformer在模型性能上具有优势。

对话式注意力

论文:Talking-Heads Attention

「简介:」 本文介绍了一种称为“对话式注意力”的多头部注意力变体,它在softmax操作之前和之后引入了跨注意力头维度的线性投影。这种方法只增加了少量额外参数和适度的额外计算量,但在遮盖语言建模任务上取得了更好的困惑度,同时在迁移学习到语言理解和问答任务时也获得了更高的质量。

多查询注意力

论文:Fast Transformer Decoding: One Write-Head is All You Need

「简介:」 本文提出了一种称为多查询注意力的变体,它通过在所有不同的注意力“头”之间共享键和值,大幅减小了这些张量的大小,从而降低了增量解码的内存带宽需求。实验证明,这种模型确实可以更快地解码,并且与基线相比只有轻微的质量下降。

注意力上的注意力

论文:Attention on Attention for Image Captioning

**「简介:」**本文提出了一种新的注意力机制,称为注意力上的注意力(AoA),用于改善图像字幕生成。这种机制帮助解码器更好地理解注意力结果与查询之间的相关性,从而减少误导性结果。将AoA应用于图像字幕模型后,该模型在MS COCO数据集上达到了新的最优性能。

通过重新排序子层来改进Transformer

论文:Improving Transformer Models by Reordering their Sublayers

「简介:」 论文研究了Transformer网络中子层的不同排序对性能的影响。通过实验发现,改变自注意力和前馈子层的顺序可以在某些情况下提高模型的表现。提出了一种新的排列方式,称为三明治Transformer,它在一些语言建模任务上表现出了更好的性能,并且没有增加额外的参数、内存或训练时间。但是,这种新的排序方式并不适用于所有任务,因此需要进一步研究任务特定的子层排序以获得更好的结果。

Macaron Net

论文:Understanding and Improving Transformer From a Multi-Particle Dynamic System Point of View

「简介:」 论文从多粒子动态系统的角度提出了对Transformer架构的新理解,将其数学上解释为一种数值常微分方程(ODE)求解器。通过这种视角,作者提出用Strang-Marchuk分裂方案替代Lie-Trotter分裂方案,以降低局部截断误差,并设计出一种新的网络结构——Macaron Net。实验结果表明,Macaron Net在监督和非监督学习任务上都优于传统的Transformer模型。

T5的简化相对位置编码

论文:Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer

「简介:」 论文通过引入一个统一的框架,将所有基于文本的语言问题转换为文本到文本的格式,探索了自然语言处理(NLP)中迁移学习技术的全景。通过系统研究比较了预训练目标、架构、无标签数据集、迁移方法和其它因素在数十个语言理解任务上的表现。结合从探索中获得的洞见和大规模“Colossal Clean Crawled Corpus”数据,我们在摘要、问答、文本分类等多个基准测试中取得了最先进的结果。

残差注意力

论文:RealFormer: Transformer Likes Residual Attention

「简介:」 本文提出了RealFormer,这是一种简单通用的技术,用于创建残差注意力层Transformer网络,它在包括掩码语言建模、GLUE、SQuAD、神经机器翻译、WikiHop、HotpotQA、自然问题和OpenKP等广泛的任务上显著优于传统的Transformer及其变体(如BERT、ETC等)。

增强递归

论文:ERNIE-Doc: A Retrospective Long-Document Modeling Transformer

「简介:」 本文提出了ERNIE-Doc,一种基于递归Transformer的文档级语言预训练模型。通过回顾性馈送机制和增强的递归机制,ERNIE-Doc能够捕获完整文档的上下文信息,并且具有更长的有效上下文长度。作者通过一个额外的文档感知的段重排目标来预训练ERNIE-Doc,以明确学习段落之间的关系。在英文和中文的文档级任务上进行了各种实验,ERNIE-Doc在WikiText-103上将困惑度的语言建模结果提高到了16.8。

门控残差

论文:Stabilizing Transformers for Reinforcement Learning

「简介:」 由于自注意力架构能有效地整合长时序信息和大规模数据,在NLP领域取得了突破性的成功。这种能力也可用于部分可观察的强化学习(RL)领域,但标准的Transformer架构很难优化。作者提出了对原始Transformer进行修改,以提高其稳定性和学习速度。这种修改后的架构名为Gated Transformer-XL(GTrXL),在具有挑战性的记忆环境中超过了LSTMs,并在多任务DMLab-30基准套件上取得了最先进的成绩。

ALiBi 位置嵌入

论文:TRAIN SHORT, TEST LONG: ATTENTION WITH LINEAR BIASES ENABLES INPUT LENGTH EXTRAPOLATION

「简介:」 本文探讨了Transformer模型如何处理比训练时更长的序列。研究发现,通过改变位置表示方法,模型能够实现外推。作者提出了一种新的、更高效的位置表示方法——带线性偏差的注意力(ALiBi)。这种方法不需要添加位置嵌入到词嵌入中,而是通过对注意力分数施加与距离成比例的惩罚来引入位置信息。实验表明,使用ALiBi训练的模型能够在较短的序列上训练,并成功外推到更长的序列,同时训练速度更快,内存使用更少。

夹层范数

论文:CogView: Mastering Text-to-Image Generation via Transformers

「简介:」 本文提出了CogView,一个具有40亿参数的Transformer模型,结合了VQ-VAE标记器,用以解决通用领域中的文本到图像生成问题。这个问题不仅需要一个强大的生成模型,还需要跨模态理解能力。作者还展示了针对各种下游任务的微调策略,例如风格学习、超分辨率、文本-图像排名和时尚设计,以及稳定预训练的方法,例如消除NaN损失。

ResiDual架构

论文:ResiDual: Transformer with Dual Residual Connections

「简介:」 论文提出了一种新的Transformer架构——ResiDual,它结合了Post-LN和Pre-LN的连接方式,避免了各自的局限性。理论上,ResiDual避免了梯度消失问题;实证上,它在多个机器翻译任务中表现优于Post-LN和Pre-LN。因此,ResiDual可以作为AI模型的基础架构。

Normformer

论文:NormFormer: Improved Transformer Pretraining with Extra Normalization

「简介:」 Pre-LayerNorm Transformer在预训练中遇到了梯度幅度不匹配的问题,可以通过添加归一化和缩放操作来解决。这增加了微小的计算成本,但显著提高了预训练和下游任务性能。对于 GPT3-Medium 架构,添加 NormFormer 可以更快达到最佳性能,并显著提高零样本性能。对于掩码语言建模,NormFormer 平均提高了 GLUE 性能。

余弦相似注意力

论文:Query-Key Normalization for Transformers

「简介:」 低资源语言翻译是一个具有挑战性但社会价值高的NLP任务。在最近针对这一设置调整Transformer规范化的工作基础上,作者提出了QKNorm,一种修改注意力机制的规范化技术,使得softmax函数不易受到任意饱和的影响,同时不牺牲表达能力。具体来说,作者在将查询和键矩阵相乘之前,沿着头部维度对它们应用ℓ2规范化,然后用一个可学习的参数进行放大,而不是除以嵌入维度的平方根。

遗忘因果掩码

论文:Towards Better Few-Shot and Finetuning Performance with Forgetful Causal Language Models

「简介:」 本文提出了一种提高大型语言模型性能的简单方法,即在训练时随机掩盖一些过去的词汇。这种方法被称为遗忘因果掩码(FCM),它可以帮助模型更好地学习语言表示,从而在少样本学习和微调任务上取得更好的效果。

动态位置偏差

论文:CrossFormer: A Versatile Vision Transformer Hinging on Cross-scale Attention

「简介:」 作者提出了跨尺度嵌入层(CEL)和长短距离注意力(LSDA)。一方面,CEL将每个嵌入与不同尺度的多个补丁混合,为自注意力模块本身提供跨尺度特征。另一方面,LSDA将自注意力模块分为短距离和长距离两个部分,这不仅降低了计算负担,而且还保持了嵌入中的小尺度和大尺度特征。通过上述两种设计,作者实现了跨尺度注意力。此外,作者提出了一种动态位置偏差,使流行的相对位置偏差适用于可变大小的图像。依靠跨尺度注意力模块,作者构建了一个通用的视觉架构,称为CrossFormer,它适应可变大小的输入。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

transformer变体 1. Introduction  在这篇博客,我们详细的介绍了transformer的结构,也介绍了transformer还存在的问题,接着本篇文章将会介绍关于transformer的多种改进,让我们了解一下更加丰富多彩的transformer结构。 2.各种变体 2.1 Universal transformers(UT)  提出于2018年,是transformer的后续工作,它的提出是为了解决transformer固有的非图灵完备性及缺少conditional computation的问题。  UT与 阅读详情

相关推荐

【翻译】大型 Transformer 模型推理优化

通过使用更少的 GPU 设备和更少的 GPU 内存来减少模型的内存占用;通过降低所需的 FLOPs 数量来降低所需的计算复杂度;减少推理延迟并加快运行速度。可以使用多种方法使推理在内存中更便宜或/和在时间上更快。应用各种并行性以在大量 GPU 上扩展模型。模型组件和数据的智能并行性使运行数万亿个参数的模型成为可能。内存卸载将暂时未使用的数据卸载到 CPU 并在以后需要时读回它们。这有助于减少内存使用,但会导致更高的延迟。智能批处理策略;

PiPiQ_Blog的博客 1450

【Transformer】Transformer及其变体网络介绍

本文介绍了Transformer的结构和算法流程,并介绍了其变体网络,包括Reformer、Linformer等。

Henry_Zhao10的博客 4032

24 家国内大模型面经及考点总结!

这段时间面试了很多家,也学到了超级多东西。楼主这边背景是做基座预训练算法端为主的,对框架端和RL的内容有一定了解(面试能凑合),对于后端的知识比如ML compiler,kernel,cuda相关的了解就比较浅了(问到觉大概率挂)。硬件几乎不太懂。大模型这方向真的卷,面试时好多新模型,新paper疯狂出,东西出的比我读的快。Research岗位对工程也有要求,工程端也需要了解模型。感觉比较硬核的岗位,尤其初创公司都是对好几个点都有要求的(应用,模型,框架,底层后端,硬件)。

2401_86435672的博客 1337

24个Transformer模型高效魔改变体盘点,无bug拿来即用

FlashAttention是一种新的算法,它使得Transformer模型(一种广泛用于自然语言处理的深度学习模型)在处理长文本序列时能够更快且更节省内存。这个算法通过优化GPU内存的使用来减少内存读写次数,从而提高了计算效率。实验结果表明,使用FlashAttention训练的模型不仅训练速度更快,而且能够处理更长的文本序列,提高了模型的性能和能力。

学姐带你玩AI的博客 1万+

【CS224n】(lecture9)Transformer的变体

学习总结 Transformer 的进一步改进可能在于以下几个方向: 0.1 理论分析 Transformer 的架构已被证明能够支持具有足够参数的大规模训练数据集。许多工作表明,Transformer 具有比 CNN 和 RNN 更大的容量,因此具有处理大量训练数据的能力。当 Transformer 在足够的数据上进 行训练时,它通常比 CNN 或 RNN 具有更好的性能。一个直观的解释是 Transformer 对数据结构的先验假 设很少,因此比 CNN 和 RNN 更灵活。然而,理论原因尚不清楚,我们

发现问题,并解决问题,批判性思维 2964

Transformer实战(24)——通过数据增强提升Transformer模型性能

数据增强是一种简单而有效的方法,能够通过扩充和多样化训练数据,显著提升 Transformer 模型在自然语言处理 (Natural Language Processing, NLP) 任务中的性能,尤其在数据稀缺或多样性不足的场景下具有重要价值。本文首先介绍了数据增强的基本概念及其在深度学习中提高模型准确性的重要性,然后分析了字符级、词级和句子级三种不同粒度的数据增强方法,并以 IMDb 情感分类任务为例,使用 nlpaug 库演示了多种数据增强技术的具体实现,提升模型表现。

盼小辉丶的博客 3122

别再魔改Transformer了!这24个高效变体代码直接抄,附避坑指南

本文深入解析24个经过实战验证的Transformer高效变体,提供从代码复现到生产部署的全链路解决方案。涵盖注意力机制优化、结构重构和记忆增强等核心变体,并分享工业级集成方案、性能调优技巧及领域适配法则,帮助开发者避免常见陷阱,提升模型效率与稳定性。

weixin_30251829的博客 368

PyTorch生成式人工智能(24)——使用PyTorch构建Transformer模型

相较于传统模型,如循环神经网络 (RNN),Transformer 的优势在于能够理解输入和输出序列中元素之间的关系,在大语言模型 (如 ChatGPT 和 DeepSeek) 的发展中起到了关键作用,为了从零开始构建 Transformer,首先探讨自注意力机制,包括查询 (query)、键 (key) 和值 (value) 向量,以及缩放点积注意力 (SDPA)。将层归一化和残差连接集成到多头注意力层中,并与前馈层结合,构建编码器层,堆叠编码器层构建编码器,还将实现 Transformer 中的解码器。

盼小辉丶的博客 2万+

Transformer组件魔改实战指南:从理论到代码的24个高效变体

本文深入解析Transformer架构的24种高效变体改造方案,涵盖注意力机制、前馈层和归一化等核心组件的创新实践。通过FlashAttention、多查询注意力等内存优化技术,以及GLU变体、动态门控等结构改进,显著提升模型计算效率和性能表现。实战代码示例展示如何实现这些魔改技术,助力开发者构建更高效的Transformer模型。

weixin_30381317的博客 489

深度学习实战24-人工智能(Pytorch)搭建transformer模型,真正跑通transformer模型,深刻了解transformer的架构

大家好,我是微学AI,今天给大家讲述一下人工智能(Pytorch)搭建transformer模型,手动搭建transformer模型,我们知道transformer模型是相对复杂的模型,它是一种利用自注意力机制进行序列建模的深度学习模型。相较于 RNN 和 CNN,transformer 模型更高效、更容易并行化,广泛应用于神经机器翻译、文本生成、问答等任务。

微学AI的博客 6158

信号完整性分析学习--16--传输线效应

传输线效应 说到传输线效应,大多数人都会想到一个经验法则,那就是: “当互连线的长度大于1/6倍的信号上升时间的空间延伸时,互连线就体现出传输线效应。” 上升时间越小越容易体现传输线效应。 由此可见,同一根互连线,它是否体现传输线效应,要看它要传输什么样的信号。下图所示,一根延时为15ps的互连线,当它传输上升时间为60ps的信号时就会体现传输线效应;当它传输上升时间为180ps的信号时就不体现传输线效应。

qq_29476769的博客 7277

【大模型微调】24-基于Transformer的微调过程:详细说明Transformer模型的微调步骤

本文将详细阐述基于Transformer的微调过程,包括数据准备、模型选择、参数调整及训练策略等关键步骤,旨在为研究人员和从业者提供一个系统化的操作指南。通过深入了解微调的各个环节,读者将能够更有效地利用Transformer模型解决实际问题。

rengang66的博客 1033

芯片设计-信号完整性 SI 解析:Unit Interval 与比特周期的关系及其在高速信号中的应用

本文深入解析了芯片设计中信号完整性(SI)的核心概念Unit Interval(UI)与比特周期的关系及其在高速信号中的应用。通过实际案例和计算公式,详细阐述了UI在不同数据速率下的变化、在眼图分析中的关键作用,以及如何应对高速信号设计中的抖动和码间干扰等挑战。文章还提供了PCB布线和芯片设计中的UI优化技巧,帮助工程师提升高速信号设计的实战能力。

weixin_28683391的博客 468

系统盘点! 各类深度学习模型及原理!

1 正文深度学习方法利用神经网络模型进行高级模式识别和自动特征提取,近年来在数据挖掘领域成果显著。常用模型有除了基础的DNN,还有RNN、LSTM、GRU、CNN、Attention和Mix混合模型等。相较于复杂特征工程的机器学习,深度学习模型只需数据预处理、网络结构设计和超参数调整,即可输出预测结果。深度学习算法能自动学习时序数据中的模式和趋势,对复杂非线性模式有很好的表达能力。在应用时,需考虑数据平稳性和周期性,选择合适的模型和参数,进行训练和测试,并进行调优和验证。2 深度学习算法概览。

xzp740813的博客 2115

Comsol 管道导波裂纹检测:从建模到求解的完整流程解析

本文详细解析了使用Comsol Multiphysics进行管道导波裂纹检测的完整仿真流程。从几何建模、材料定义、物理场设置到网格划分与求解后处理,系统阐述了如何构建高保真虚拟模型以模拟导波与裂纹的相互作用。重点分享了激励信号设置、频散效应处理及参数化扫描等实战技巧,旨在帮助工程师与研究人员高效优化无损检测方案,降低实验成本。

weixin_29207439的博客 74

HFSS学习笔记——Vivaldi天线仿真(一)

Vivaldi 天线HFSS仿真,HFSS中指数曲线绘制及曲面绘制。

and_future的博客 1万+

注意力机制24种高效涨点的魔改方法

CenterMask是一种高效实例分割方法,它结合了FCOS检测器和注意力引导掩膜分支,提高了检测性能。文章还改进了VoVNetV2主干网络,提高了性能。CenterMask和CenterMask-Lite分别针对大型和小型模型进行设计,CenterMask实现了38.3%的性能,超过了所有以前的最先进方法,同时速度更快。既不用人为设计规则,又能把老方法全面比下去,显存省一半,训练跑得更快,还能一眼看出模型学了啥。为了让大家能够紧跟领域前沿,掌握最新的研究思路和方法,用到自己的文章中,给大家准备了。

2501_91695603的博客 323

XGBoost原生接口和Sklearn接口参数详解

XGBoost原生接口和Sklearn接口参数详解

算法工程师 2654

顶级SCI优化!极光优化Transformer-LSTM多变量时序预测原理并带模型对比!附Matlab代码

今天,给大家讲解为什么利用Transformer实现预测模型没有解码层?是不是模型不对等问题!并推出一期利用24年新算法PLO优化Transformer-LSTM模型,并提供模型对比、柱状图、雷达图、二维散点图等多图,非常容易吸引审稿人!

QSJIQIXUEXI的博客 3753

Python爬虫实战:基于最新技术栈的政府招标采购数据抓取与分析

对于企业、研究人员和数据分析师来说,能够高效地获取这些数据意味着可以获得宝贵的商业洞察和市场先机。随着反爬技术的不断升级和网站结构的日益复杂,传统的爬虫方法已经难以满足需求。我们将采用Selenium、Playwright等现代浏览器自动化工具,结合Scrapy框架和异步请求库,构建一个能够应对各种反爬措施的强大爬虫系统。Playwright是微软开发的浏览器自动化工具,支持Chromium、WebKit和Firefox,比Selenium更快速、更稳定。

2201_76125261的博客 1312

基于ArduPilot的旋翼式无人机飞行器开发系列(二,学习路线)

一,热爱 作为一名耿直的技术男,在这里我只想说一句,热爱是可持续学习的第一要素,也只有热爱才能让你坚持到最后。 至于最后能得到什么,只有你自己知道。常说书中自有颜如玉,书中自有黄金屋。如果你是为了颜如玉,我相信大多数颜如玉做不了你的红颜知己。如果是为了黄金屋,当你持续投入时间和金钱却看不到回报的时候,相信退堂鼓早已隆隆作响。 我给自己的信条就是为当下努力工作,为将来持续学习。当前飞控行业并没有爆发,如果想赚块钱,去互联网汽车,去VR/AR吧,去元宇宙吧。 那么我热爱...

从0到1,突破自己 1670

又一篇视觉Transformer综述来了!

点击上方“CVer”,选择加"星标"置顶重磅干货,第一时间送达最近 Transformer在CV领域真的"杀疯了",很多CV垂直方向出现了不少工作。其中非...

阿木寺的博客 8631

【WorkBuddy专栏52】Codex与WorkBuddy生态适配、用户争夺与未来走向(下)

【WorkBuddy专栏52】Codex与WorkBuddy在中国大陆的发展——生态适配、用户争夺与未来走向(下)

AI人人懂 679

时间序列预测实战(十九)魔改Informer模型进行滚动长期预测(科研版本,结果可视化)

在之前的文章中我们已经讲过Informer模型了,但是呢官方的预测功能开发的很简陋只能设定固定长度去预测未来固定范围的值,当我们想要发表论文的时候往往这个预测功能是并不能满足的,所以我在官方代码的基础上增添了一个滚动长期预测的功能,这个功能就是指我们可以第一次预测未来24个时间段的值然后我们像模型中填补 24个值再次去预测未来24个时间段的值(填补功能我设置成自动的了无需大家手动填补),这个功能可以说是很实用的,这样我们可以准确的评估固定时间段的值,当我们实际使用时可以设置自动爬取数据从而产生实际效用。

Snu77的博客 1万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

ECCV'24 | 23FPS!超越所有3D检测!港理工ScatterFormer:高效的体素序列处理Transformer...

本次分享我们邀请到了香港理工大学助理教授(研究)何晨杭为大家详细介绍他们团队ECCV2024的工作:ScatterFormer。如果您有相关工作需要分享,欢迎文末联系我们。ScatterFormer: Efficient Voxel Transformer with Scattered Linear Attention论文:https://arxiv.org/pdf/2401.00912代码:ht...

3D视觉工坊 486

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

如何免费找回QQ空间历史说说:GetQzonehistory 完整导出指南

十年前的QQ空间说说,你还能找得回来吗?网页版只能往前翻最近几页,更早的记忆已经翻不到界面里了。GetQzonehistory 是一个免费的 Python 工具,可以把你QQ空间的历史说说、转发、评论批量导出,并把说说里的图片一并下载,让空间记忆完整留在本地。 ## 🔍 原理速览:它凭什么能取回全部说说 工具的思路很直接:**模拟扫码登录**QQ空间网页版,先把「历史消息列表」逐页拉下来(里

gitblog_00297的博客 501

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

上一篇: 上海交大<动手学大模型>大模型教程已经next level!
下一篇: 举个例子给大家讲下transformer的输入输出细节及其他
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值