


了解如何使用 Elastic 的 LLM Inference API 处理职位描述,并运行双重混合搜索来找到最适合你简历的职位。
在本文中,我们将介绍以下主题:
- 使用 Elastic Web Crawler 抓取职位列表并将其索引到 Elastic Cloud。感谢我的同事 Jeff Vestal 向我展示如何操作!
- 使用 Elastic Azure OpenAI Inference Endpoint 作为摄取管道的一部分,使用 GPT-4o 处理职位列表。
- 使用 semantic_text 工作流嵌入简历并处理输出。
- 执行双层混合搜索,根据你的简历找到最合适的工作。
理论用例
以下是用例的想法。假设我是 Elastic 等公司的人力资源部门,我有几个职位空缺和一个人才库。我可能想通过自动将人才库中的简历与可用的职位空缺进行匹配来使我的工作更轻松。我使用 Elastic 平台实现了这一点,并将我的旧简历放入其中。
这些职位空缺显然与我的简历最相关:
1.  Top 3 Jobs for Han

3.  Job Title:
4.  Principal Technical Marketing Engineer, Search

6.  Description:
7.  Drive technical go-to-market strategies for Elasticsearch
8.  and generative AI, create and maintain demo environments, develop
9.  content and training for field teams, influence product roadmaps, and
10.  represent Elastic at industry events.
11.  --------------------------
12.  Job Title:
13.  Search - Search Inference - Software Engineer II

15.  Description:
16.  As a Software Engineer II on the Search Inference team
17.  at Elastic, you will develop and enhance search workflows by integrating
18.  performant, scalable, and cost-efficient machine learning model inference
19.  into Elasticsearch and Kibana, collaborating in a remote-first,
20.  cross-functional team environment.
21.  --------------------------
22.  Job Title:
23.  Search - Extract and Transform - Software Engineer II

25.  Description:
26.  As a Software Engineer II on the Search Extract and Transform team,
27.  you will enhance search components, collaborate on scalable and
28.  secure solutions, and optimize performance indicators while
29.  contributing to Elasticsearch, Kibana, and other connectors.
30.  --------------------------
你知道吗,这些都是意想不到的好选择。第一个选择听起来与我过去几个月所做的事情非常相似(实际上有点怪异),而第二个和第三个选择可能源于我的简历中塞满了搜索和机器学习用例。
让我们深入了解一下这是如何做到的!

本文实现的是双重混合搜索,利用 LLM 将简历和职位描述分别转化为两类数据 —— 一组核心能力和一组要求,然后进行匹配,同时将简历与理想候选人简历进行匹配。
先决条件
你需要一个 Elastic Cloud 部署和一个 Azure OpenAI 部署才能继续使用本笔记本。有关更多详细信息,请参阅此 readme。如果你在个人计算机上继续操作,请确保在继续操作之前安装了 docker 桌面!
如果你使用的是 Linux 系统,则安装成功后你可能会看到以下内容:
1.  View build details: docker-desktop://dashboard/build/desktop-linux/desktop-linux/icqfo62fhdfinlgz3swcrd8p8

3.  What's Next?
4.    1. Sign in to your Docker account → docker login
5.    2. View a summary of image vulnerabilities and recommendations → docker scout quickview
6.  2db5e5e71b10f1cd772864c039661dfb4eadb3d116b0e95145c918b52e900a90
抓取 Elastic 的职位列表
首先要做的是安装 Elastic 爬虫。创建一个新的项目文件夹,进入其中,然后运行以下命令来克隆 repo、构建 docker 镜像并运行它。
1.  git clone https://github.com/elastic/crawler.git
2.  cd crawler
3.  docker build -t crawler-image . && docker run -i -d --name crawler crawler-image
完成后,转到 crawler/config/ 并创建一个名为 elastic-job.yml 的新文件。粘贴以下代码片段,并填写你的 Elastic Cloud 端点和 API 密钥。如果你愿意,可以更改 output_index 设置。这是存储抓取的 Web 内容的索引。我已将其设置为 elastic-job。
1.  domains:
2.    - url: https://jobs.elastic.co
3.      seed_urls:
4.        - https://jobs.elastic.co/jobs/department/customer-success-group
5.        - https://jobs.elastic.co/jobs/department/engineering
6.        - https://jobs.elastic.co/jobs/department/finance-it-operations
7.        - https://jobs.elastic.co/jobs/department/human-resources
8.        - https://jobs.elastic.co/jobs/department/legal
9.        - https://jobs.elastic.co/jobs/department/marketing
10.        - https://jobs.elastic.co/jobs/department/sales-field-operations
11.      crawl_rules:
12.        - policy: allow
13.          type: begins
14.          pattern: /jobs/
15.  output_sink: elasticsearch
16.  output_index: elastic-job
17.  max_crawl_depth: 2
18.  elasticsearch:
19.    host: <YOUR ELASTIC CLOUD ENDPOINT>
20.    port: "9243"
21.    api_key: <YOUR ELASTIC CLOUD API KEY>
22.    bulk_api:
23.      max_items: 5
现在将 elastic-job.yml 复制到你的 docker 容器中。
1.  cd crawler
2.  docker cp config/elastic-job.yml crawler:/app/config/elastic-job-finder.yml
验证域名(我们的网络爬虫的目标):
docker exec -it crawler bin/crawler validate config/elastic-job.yml
你应该会收到以下消息:
Domain https://jobs.elastic.co is valid
这样,我们就可以开始了。开始爬行!
docker exec -it crawler bin/crawler crawl config/elastic-job.yml
如果一切顺利,你应该会在 Kibana 上的 elastic-job 索引中看到 104 个职位描述。太棒了!

截至 2024 年 9 月 13 日的 Elastic 职位空缺,内容摘自 jobs.elastic.co
处理职位空缺
现在我们已经将职位空缺编入索引,是时候将它们处理成更有用的形式了。打开你的 Kibana 控制台,并为你的 Azure OpenAI LLM 创建推理端点。
1.  PUT _inference/completion/azure_openai_gpt4o_completion
2.  {
3.      "service": "azureopenai",
4.      "service_settings": {
5.          "api_key": <YOUR AZURE OPENAI API KEY>,
6.          "resource_name": <YOUR AZURE OPENAI RESOURCE NAME>,
7.          "deployment_id": <YOUR AZURE OPENAI DEPLOYMENT ID>,
8.          "api_version": "2024-06-01"
9.      }
10.  }
我们可以利用这个推理端点来创建包含 LLM 处理步骤的提取管道。现在让我们定义该管道:
1.  PUT _ingest/pipeline/llm_gpt4o_job_processing
2.  {
3.    "processors": [
4.      {
5.        "script": {
6.          "source": """
7.          ctx.requirements_prompt = 'Extract all key requirements from the job description as a list of bulleted points. Do not return notes or commentary. Do not return any text that is not a key requirement. Be as complete and comprehensive as possible: ' + ctx.body
8.          """
9.        }
10.      },
11.      {
12.        "inference": {
13.          "model_id": "azure_openai_gpt4o_completion",
14.          "input_output": {
15.            "input_field": "requirements_prompt",
16.            "output_field": "requirements"
17.          }
18.        }
19.      },
20.      {
21.        "remove": {
22.          "field": "requirements_prompt"
23.        }
24.      },
25.      {
26.        "script": {
27.          "source": """
28.          ctx.ideal_resume_prompt = 'Write the resume of the ideal candidate for this job role. Be concise and avoid fluff. Focus on skills and work experiences that closely align with what the job description is asking for: ' + ctx.body
29.          """
30.        }
31.      },
32.      {
33.        "inference": {
34.          "model_id": "azure_openai_gpt4o_completion",
35.          "input_output": {
36.            "input_field": "ideal_resume_prompt",
37.            "output_field": "ideal_resume"
38.          }
39.        }
40.      },
41.      {
42.        "remove": {
43.          "field": "ideal_resume_prompt"
44.        }
45.      },
46.      {
47.        "script": {
48.          "source": """
49.          ctx.descriptor_prompt = 'Describe the job role in no more than 1 sentence. Be concise and efficient, focusing on maximum information density: ' + ctx.body
50.          """
51.        }
52.      },
53.      {
54.        "inference": {
55.          "model_id": "azure_openai_gpt4o_completion",
56.          "input_output": {
57.            "input_field": "descriptor_prompt",
58.            "output_field": "descriptor"
59.          }
60.        }
61.      },
62.      {
63.        "remove": {
64.          "field": "descriptor_prompt"
65.        }
66.      }
67.    ]
68.  }
我们正在使用 LLM 为我们的数据创建三个新字段。
- 要求:这是对相关职位的核心能力和要求的文本描述。我们将对其进行分块和嵌入。稍后,我们作为输入传递的简历将被处理成一组核心能力(core competencies)。这些核心能力将与此字段匹配。
- 理想简历:这是该职位假设的 “理想候选人” 的简历。我们也将对其进行分块和嵌入。我们传递的简历将与此理想简历匹配。
- 描述符:这是对职位及其内容的一句话描述。这将使我们能够在稍后快速解释搜索结果。
每个 LLM 处理步骤都有三个部分:
- 脚本(script)处理器将使用存储在正文字段中的职位描述构建提示。提示将存储在其自己的字段中。
- 推理(inference)处理器将在提示上运行 LLM,并将输出存储在另一个字段中。
- 删除(remove)处理器,一旦 LLM 推理结束,它将删除提示字段。
一旦我们定义了处理器,我们就需要一个嵌入模型。导航到 Analytics -> Machine Learning -> Trained Models,然后单击三角形部署按钮部署 elser_model_2_linux-x86_64。

单击三角形按钮部署 Elser。这将使用 ML 节点,因此请确保你的 Elastic Cloud 部署允许自动扩展 ML 节点。
模型部署完成后,运行以下命令创建名为 elser_v2 的推理端点:
1.  PUT _inference/sparse_embedding/elser_v2
2.  {
3.    "service": "elser",
4.    "service_settings": {
5.      "num_allocations": 1,
6.      "num_threads": 4
7.    }
8.  }
部署嵌入模型后,让我们定义一个名为 elastic-job-requirements-semantic 的新索引。我们将对 requirements 和 ideal_resume 字段进行分块和嵌入,因此将它们设置为 semantic_text 并将 inference_id 设置为 elser_v2。
1.  PUT elastic-job-requirements-semantic
2.  {
3.    "mappings": {
4.      "properties": {
5.        "requirements": {
6.          "type": "semantic_text",
7.          "inference_id": "elser_v2"
8.        },
9.        "ideal_resume": {
10.          "type": "semantic_text",
11.          "inference_id": "elser_v2"
12.        }
13.      }
14.    }
15.  }
设置完成后,让我们运行重新索引(reindex)操作来处理我们的职位描述并在 elastic-job-requirements-semantic 中索引结果。通过将大小设置为 4,我们确保每次处理 4 个文档的批次,这在 LLM API 因任何原因失败时为我们提供了一定的安全性:
1.  POST _reindex?slices=auto&wait_for_completion=false
2.  {
3.    "source": {
4.      "index": "elastic-jobs",
5.      "size": 4
6.    },
7.    "dest": {
8.      "index": "elastic-job-requirements-semantic",
9.      "pipeline": "llm_gpt4o_job_processing"
10.    }
11.  }
执行重新索引,并观察处理后的文档如何填满 elastic-job-requirements-semantic 索引!

elastic-job-requirements-semantic 索引中的新 requirements 字段及其分块嵌入。
控制台将为你提供一个 task_id,你可以使用以下命令检查重新索引的状态:
GET _tasks/EUgmrdCKS2aAVZC-Km_mVg:26927998
一旦工作完成,我们就可以进行最后一步!
设置简历搜索
在这一步,我们将转到 Python 环境。在你的项目目录中,创建一个 .env 文件并使用以下值填充它:
1.  ELASTIC_ENDPOINT=<YOUR ELASTIC ENDPOINT>
2.  ELASTIC_API_KEY=<YOUR ELASTIC API KEY>
3.  ELASTIC_INDEX_NAME=<YOUR ELASTIC INDEX NAME>
4.  AZURE_OPENAI_KEY_1=<AZURE OPEN AI API KEY>
5.  AZURE_OPENAI_KEY_2=<AZURE OPEN AI API KEY>
6.  AZURE_OPENAI_REGION=<AZURE OPEN AI API REGION>
7.  AZURE_OPENAI_ENDPOINT=<AZURE OPEN AI API ENDPOINT>
现在将你的简历添加到目录中。 .pdf 文件效果最好。由于我害羞,我不会在这里发布我的简历。
运行以下命令安装依赖项(Elasticsearch 和 OpenAI):
pip install elasticsearch==8.14.0 openai==1.35.13 llama-index==0.10.55
并创建一个包含两个类的python脚本:LlamaIndexProcessor 调用 SimpleDirectoryReader 来加载本地文档,AzureOpenAIClient 提供了一种方便的方法来调用gpt-4o。
1.  import traceback
2.  import uuid
3.  import os
4.  from elasticsearch import Elasticsearch, helpers
5.  from openai import AzureOpenAI
6.  from dotenv import load_dotenv
7.  from llama_index.core import SimpleDirectoryReader
8.  import pickle
9.  load_dotenv()
10.  '''
11.  Load a pdf documnent using LlamaIndex's SimpleDirectoryReader
12.  '''
13.  class LlamaIndexProcessor:
14.      def __init__(self):
15.          pass

17.      def load_documents(self, directory_path):
18.          '''
19.          Load all documents in directory
20.          '''
21.          reader = SimpleDirectoryReader(input_dir=directory_path)
22.          return reader.load_data()
23.      def load_document(self, filepath):
24.          return SimpleDirectoryReader(input_files=[filepath]).load_data()

26.  '''
27.  Azure OpenAI LLM Class
28.  '''
29.  class AzureOpenAIClient:
30.      def __init__(self):
31.          self.client = AzureOpenAI(
32.              api_key=os.environ.get("AZURE_OPENAI_KEY_1"),
33.              api_version="2024-06-01",
34.              azure_endpoint=os.environ.get("AZURE_OPENAI_ENDPOINT")
35.          )
36.      def generate(self, prompt, model="gpt-4o", system_prompt=""):
37.          response = self.client.chat.completions.create(
38.              model=model,
39.              messages=[
40.                  {"role": "system", "content": system_prompt},
41.                  {"role": "user", "content": prompt}
42.              ],
43.              max_tokens=4096
44.          )
45.          return response.choices[0].message.content

47.  LLM = AzureOpenAIClient()
48.  llamaindex_processor=LlamaIndexProcessor()
现在是时候搜索工作了!运行此代码以加载你的简历:
1.  documents=llamaindex_processor.load_document('resume.pdf')
2.  resume=documents[0].to_dict()['text']
让我们通过以下提示(prompt)来生成你的简历的核心竞争力:
1.  competencies_prompt='''
2.  Analyze the given resume and extract key skills, competencies, and qualifications. Generalize and categorize the information into broad, widely applicable terms. Present each item on a new line without numbering or bullets.

4.  Avoid quoting directly from the resume. Instead, distill the information into generalized, transferable skills and competencies. Focus on:

6.  General industry segments or fit
7.  Technical skills and areas of expertise
8.  Soft skills and interpersonal abilities
9.  Professional competencies and responsibilities
10.  Industry-specific knowledge
11.  Educational background and qualifications
12.  Types of relevant experience
13.  Omit any explanatory text, categorization labels, or additional commentary. Each line should contain a single, distinct generalized skill or competency derived from the resume content.
14.  '''

16.  competencies=LLM.generate(resume, system_prompt=competencies_prompt)
对于我的简历来说,这是生成的能力块:
1.  Machine learning engineering
2.  Full-stack development
3.  AI systems design and deployment
4.  Team leadership
5.  Productivity solutions
6.  AI integration with developer tools
7.  Real-time code analysis and generation
8.  AI customer service solutions
9.  ...
10.  ...
现在,初始化 Python Elasticsearch 客户端:
1.  try:
2.      es_endpoint = os.environ.get("ELASTIC_ENDPOINT")
3.      es_client = Elasticsearch(
4.          es_endpoint,
5.          api_key=os.environ.get("ELASTIC_API_KEY")
6.      )
7.  except Exception as e:
8.      es_client = None
让我们定义一个查询!
寻找工作
现在是时候使用双重混合搜索了(double hybrid search) - 我称之为双重,因为我们将分别在不同的字段上进行两次混合搜索:
1.  es_query={
2.    "retriever": {
3.      "rrf": {
4.        "rank_window_size":20,
5.        "retrievers": [
6.          {
7.            "standard": {
8.              "query": {
9.                "nested": {
10.                  "path": "requirements.inference.chunks",
11.                  "query": {
12.                    "sparse_vector": {
13.                      "inference_id": "elser_v2",
14.                      "field": "requirements.inference.chunks.embeddings",
15.                      "query": competencies
16.                    }
17.                  },
18.                  "inner_hits": {
19.                    "size": 2,
20.                    "name": "requirements.body",
21.                    "_source": [
22.                      "requirements.inference.chunks.text"
23.                    ]
24.                  }
25.                }
26.              }
27.            }
28.          },
29.          {
30.            "standard": {
31.              "query": {
32.                "nested": {
33.                  "path": "ideal_resume.inference.chunks",
34.                  "query": {
35.                    "sparse_vector": {
36.                      "inference_id": "elser_v2",
37.                      "field": "ideal_resume.inference.chunks.embeddings",
38.                      "query": resume
39.                    }
40.                  },
41.                  "inner_hits": {
42.                    "size": 2,
43.                    "name": "ideal_resume.body",
44.                    "_source": [
45.                      "ideal_resume.inference.chunks.text"
46.                    ]
47.                  }
48.                }
49.              }
50.            }
51.          }
52.        ]
53.      }
54.    },
55.    "size": 20
56.  }
有两个 rrf.retriever 组件。第一个将 competencies 进行嵌入生成并对 requirements 字段进行混合搜索。第二个将resume 本身进行嵌入生成,并对 ideal_resume 字段进行混合搜索。运行搜索,让我们看看我们得到了什么!
1.  search_results = es_client.search(index="elastic-job-requirements-semantic", body=es_query)

3.  total_hits = search_results['hits']['total']['value']

5.  for hit in search_results['hits']['hits']:
6.      print(f"Job Title: {hit['_source']['title']}")
7.      print(f"Description: {hit['_source']['descriptor']}")
8.      print('--------------------------')
结果在文章开头,所以在这里复制它可能有点奇怪。
这样,我们就完成了!
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

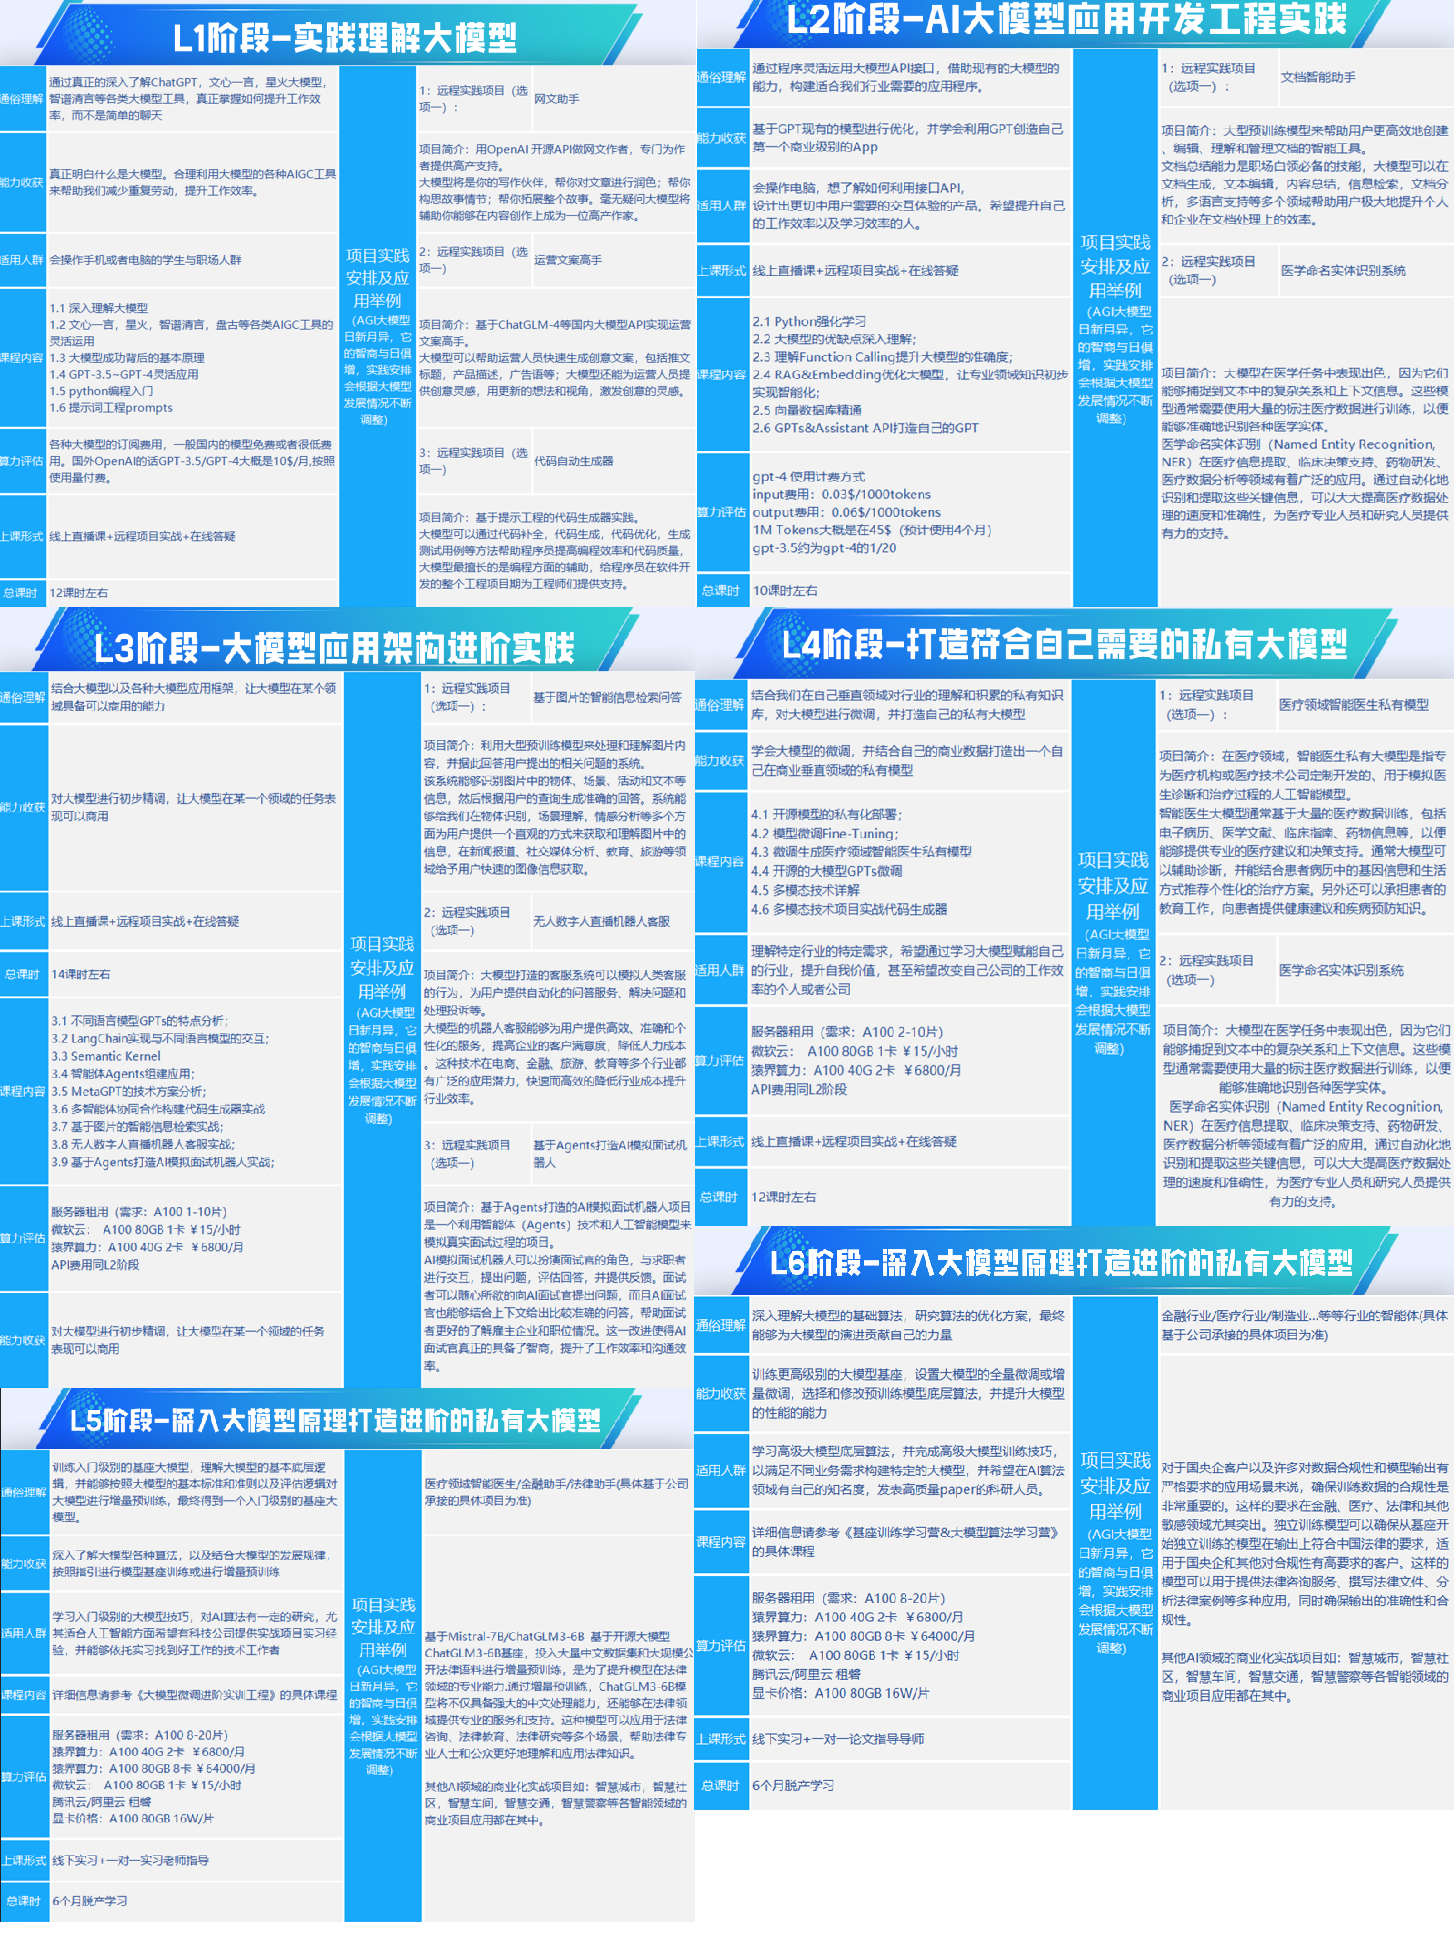
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
三、AI大模型经典PDF籍
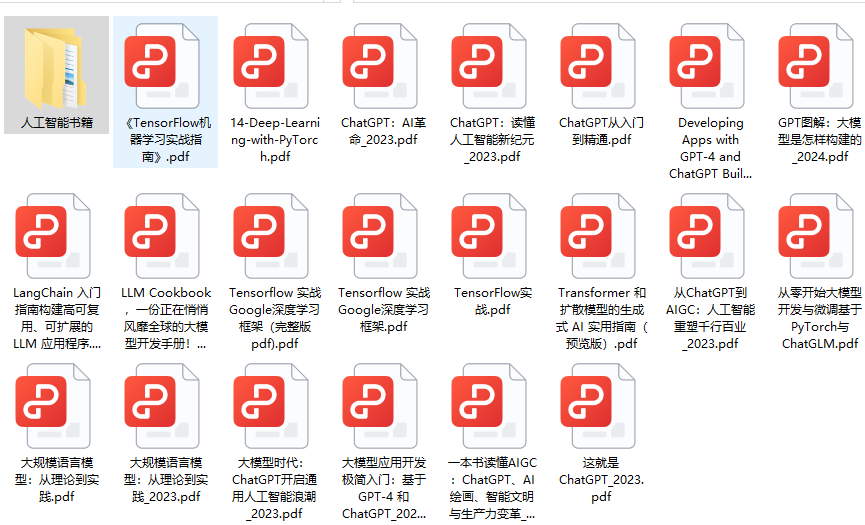
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 439


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


